TFLite-, ONNX-, CoreML- und TensorRT-Export
Diese Anleitung erklärt, wie du ein trainiertes YOLOv5-Modell aus PyTorch in verschiedene Bereitstellungsformate wie ONNX, TensorRT und CoreML exportierst.
Vor dem Start#
Klone das Repository und installiere requirements.txt in einer Python>=3.8.0-Umgebung, einschließlich PyTorch>=1.8. Modelle und Datensätze werden automatisch aus dem neuesten YOLOv5-Release heruntergeladen.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
Der Anhang des YOLOv5-Colab-Notebooks enthält ein TensorRT-Exportbeispiel (GPU erforderlich). 
Unterstützte Exportformate#
Die YOLOv5-Inferenz wird offiziell in 12 Formaten unterstützt:
- Exportiere nach ONNX oder OpenVINO, um die CPU-Leistung um bis zu das Dreifache zu steigern. Siehe CPU-Benchmarks.
- Exportiere nach TensorRT, um die GPU-Leistung um bis zu das Fünffache zu steigern. Siehe GPU-Benchmarks.
| Format | export.py --include | Modell |
|---|---|---|
| PyTorch | - | yolov5s.pt |
| TorchScript | torchscript | yolov5s.torchscript |
| ONNX | onnx | yolov5s.onnx |
| OpenVINO | openvino | yolov5s_openvino_model/ |
| TensorRT | engine | yolov5s.engine |
| CoreML | coreml | yolov5s.mlpackage |
| TensorFlow SavedModel | saved_model | yolov5s_saved_model/ |
| TensorFlow GraphDef | pb | yolov5s.pb |
| TensorFlow Lite | tflite | yolov5s.tflite |
| TensorFlow Edge TPU | edgetpu | yolov5s_edgetpu.tflite |
| TensorFlow.js | tfjs | yolov5s_web_model/ |
| PaddlePaddle | paddle | yolov5s_paddle_model/ |
Benchmarks#
Die folgenden Benchmarks wurden mit einem Colab Pro und dem YOLOv5-Tutorial-Notebook ausgeführt. So kannst du sie reproduzieren:
python benchmarks.py --weights yolov5s.pt --imgsz 640 --device 0Colab Pro mit V100-GPU#
benchmarks: weights=/content/yolov5/yolov5s.pt, imgsz=640, batch_size=1, data=/content/yolov5/data/coco128.yaml, device=0, half=False, test=False
Checking setup...
YOLOv5 🚀 v6.1-135-g7926afc torch 1.10.0+cu111 CUDA:0 (Tesla V100-SXM2-16GB, 16160MiB)
Setup complete ✅ (8 CPUs, 51.0 GB RAM, 46.7/166.8 GB disk)

Benchmarks complete (458.07s)
                   Format      mAP50-95  Inference time (ms)
0                 PyTorch        0.4623                10.19
1             TorchScript        0.4623                 6.85
2                    ONNX        0.4623                14.63
3                OpenVINO           NaN                  NaN
4                TensorRT        0.4617                 1.89
5                  CoreML           NaN                  NaN
6   TensorFlow SavedModel        0.4623                21.28
7     TensorFlow GraphDef        0.4623                21.22
8         TensorFlow Lite           NaN                  NaN
9     TensorFlow Edge TPU           NaN                  NaN
10          TensorFlow.js           NaN                  NaN
Colab Pro mit CPU#
benchmarks: weights=/content/yolov5/yolov5s.pt, imgsz=640, batch_size=1, data=/content/yolov5/data/coco128.yaml, device=cpu, half=False, test=False
Checking setup...
YOLOv5 🚀 v6.1-135-g7926afc torch 1.10.0+cu111 CPU
Setup complete ✅ (8 CPUs, 51.0 GB RAM, 41.5/166.8 GB disk)

Benchmarks complete (241.20s)
                   Format      mAP50-95  Inference time (ms)
0                 PyTorch        0.4623               127.61
1             TorchScript        0.4623               131.23
2                    ONNX        0.4623                69.34
3                OpenVINO        0.4623                66.52
4                TensorRT           NaN                  NaN
5                  CoreML           NaN                  NaN
6   TensorFlow SavedModel        0.4623               123.79
7     TensorFlow GraphDef        0.4623               121.57
8         TensorFlow Lite        0.4623               316.61
9     TensorFlow Edge TPU           NaN                  NaN
10          TensorFlow.js           NaN                  NaN
Ein trainiertes YOLOv5-Modell exportieren#
Dieser Befehl exportiert ein vortrainiertes YOLOv5s-Modell in die Formate TorchScript und ONNX. yolov5s.pt ist das Modell der Größe „small“, das zweitkleinste verfügbare Modell. Weitere Optionen sind die vortrainierten Checkpoints yolov5n.pt, yolov5m.pt, yolov5l.pt und yolov5x.pt sowie deren P6-Varianten, zum Beispiel yolov5s6.pt, oder dein eigener Checkpoint aus einem benutzerdefinierten Training, zum Beispiel runs/train/exp/weights/best.pt.
python export.py --weights yolov5s.pt --include torchscript onnxFüge --half hinzu, um Modelle mit FP16-halber Genauigkeit und kleineren Dateigrößen zu exportieren.
Ausgabe:
export: data=data/coco128.yaml, weights=['yolov5s.pt'], imgsz=[640, 640], batch_size=1, device=cpu, half=False, inplace=False, train=False, keras=False, optimize=False, int8=False, dynamic=False, simplify=False, opset=12, verbose=False, workspace=4, nms=False, agnostic_nms=False, topk_per_class=100, topk_all=100, iou_thres=0.45, conf_thres=0.25, include=['torchscript', 'onnx']
YOLOv5 🚀 v6.2-104-ge3e5122 Python-3.8.0 torch-1.12.1+cu113 CPU

Downloading https://github.com/ultralytics/yolov5/releases/download/v6.2/yolov5s.pt to yolov5s.pt...
100% 14.1M/14.1M [00:00<00:00, 274MB/s]

Fusing layers...
YOLOv5s summary: 213 layers, 7225885 parameters, 0 gradients

PyTorch: starting from yolov5s.pt with output shape (1, 25200, 85) (14.1 MB)

TorchScript: starting export with torch 1.12.1+cu113...
TorchScript: export success ✅ 1.7s, saved as yolov5s.torchscript (28.1 MB)

ONNX: starting export with onnx 1.12.0...
ONNX: export success ✅ 2.3s, saved as yolov5s.onnx (28.0 MB)

Export complete (5.5s)
Results saved to /content/yolov5
Detect:          python detect.py --weights yolov5s.onnx
Validate:        python val.py --weights yolov5s.onnx
PyTorch Hub:     model = torch.hub.load('ultralytics/yolov5', 'custom', 'yolov5s.onnx')
Visualize:       https://netron.app/
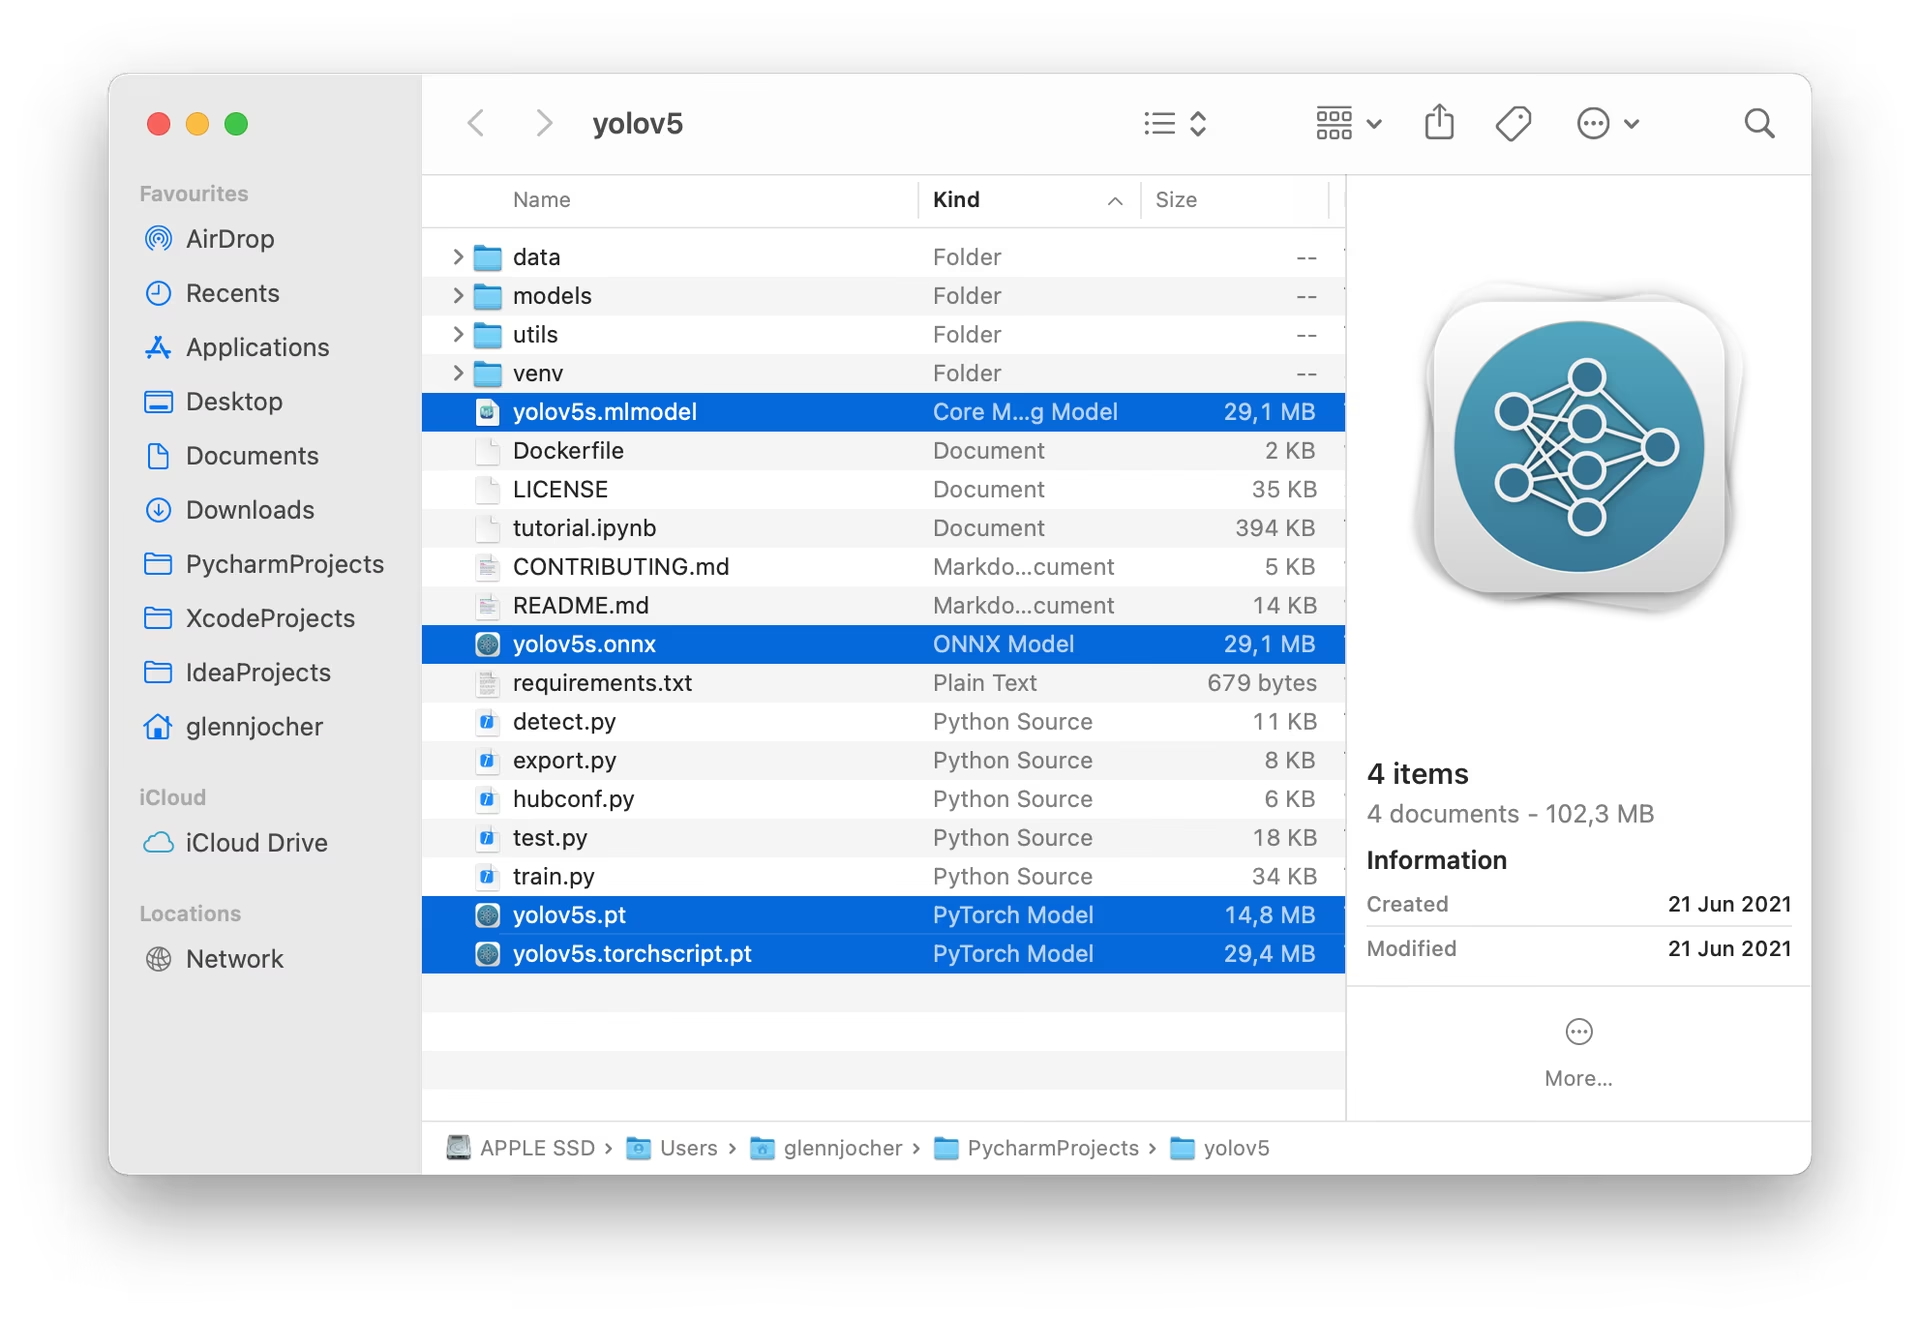
Die exportierten Modelle werden neben dem ursprünglichen PyTorch-Modell gespeichert:
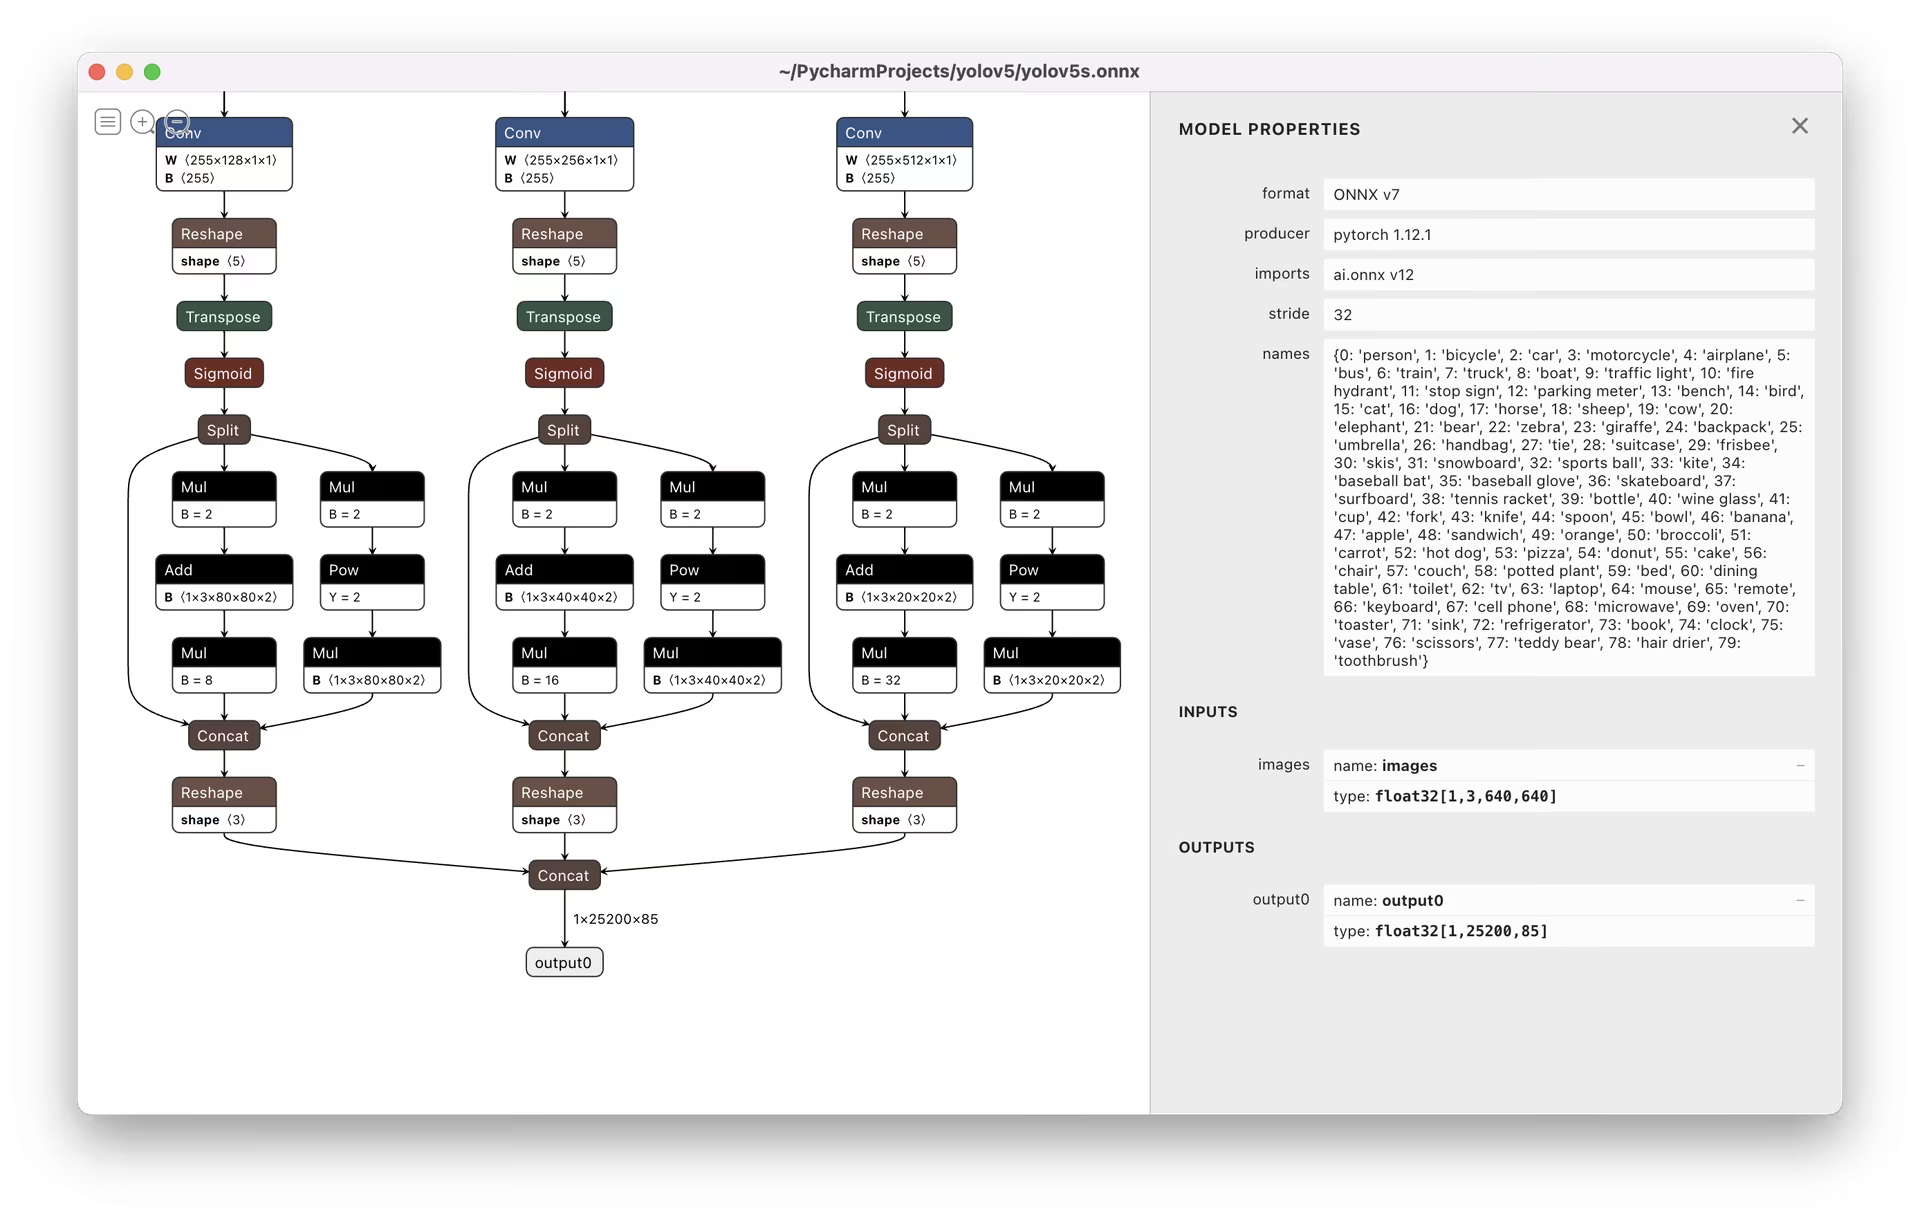
Zur Visualisierung exportierter Modelle empfehlen wir den Netron Viewer:
Beispiele zur Verwendung exportierter Modelle#
detect.py führt Inferenz mit exportierten Modellen aus:
python detect.py --weights yolov5s.pt             # PyTorch
python detect.py --weights yolov5s.torchscript    # TorchScript
python detect.py --weights yolov5s.onnx           # ONNX Runtime or OpenCV DNN with --dnn
python detect.py --weights yolov5s_openvino_model # OpenVINO
python detect.py --weights yolov5s.engine         # TensorRT
python detect.py --weights yolov5s.mlpackage      # CoreML (macOS only)
python detect.py --weights yolov5s_saved_model    # TensorFlow SavedModel
python detect.py --weights yolov5s.pb             # TensorFlow GraphDef
python detect.py --weights yolov5s.tflite         # TensorFlow Lite
python detect.py --weights yolov5s_edgetpu.tflite # TensorFlow Edge TPU
python detect.py --weights yolov5s_paddle_model   # PaddlePaddle
val.py führt die Validierung exportierter Modelle aus:
python val.py --weights yolov5s.pt             # PyTorch
python val.py --weights yolov5s.torchscript    # TorchScript
python val.py --weights yolov5s.onnx           # ONNX Runtime or OpenCV DNN with --dnn
python val.py --weights yolov5s_openvino_model # OpenVINO
python val.py --weights yolov5s.engine         # TensorRT
python val.py --weights yolov5s.mlpackage      # CoreML (macOS only)
python val.py --weights yolov5s_saved_model    # TensorFlow SavedModel
python val.py --weights yolov5s.pb             # TensorFlow GraphDef
python val.py --weights yolov5s.tflite         # TensorFlow Lite
python val.py --weights yolov5s_edgetpu.tflite # TensorFlow Edge TPU
python val.py --weights yolov5s_paddle_model   # PaddlePaddle
Verwende PyTorch Hub mit exportierten YOLOv5-Modellen:
import torch

# Model
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s.pt")
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s.torchscript")  # TorchScript
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s.onnx")  # ONNX Runtime
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s_openvino_model")  # OpenVINO
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s.engine")  # TensorRT
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s.mlpackage")  # CoreML (nur macOS)
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s_saved_model")  # TensorFlow SavedModel
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s.pb")  # TensorFlow GraphDef
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s.tflite")  # TensorFlow Lite
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s_edgetpu.tflite")  # TensorFlow Edge TPU
model = torch.hub.load("ultralytics/yolov5", "custom", "yolov5s_paddle_model")  # PaddlePaddle

# Images
img = "https://ultralytics.com/images/zidane.jpg"  # oder Datei, Path, PIL, OpenCV, numpy, Liste

# Inference
results = model(img)

# Results
results.print() # oder .show(), .save(), .crop(), .pandas() usw.OpenCV-DNN-Inferenz#
Inferenz mit OpenCV und ONNX-Modellen:
python export.py --weights yolov5s.pt --include onnx

python detect.py --weights yolov5s.onnx --dnn # detect
python val.py --weights yolov5s.onnx --dnn # validateC++-Inferenz#
Beispiele für die YOLOv5-OpenCV-DNN-C++-Inferenz mit exportierten ONNX-Modellen:
- https://github.com/Hexmagic/ONNX-yolov5/blob/master/src/test.cpp
- https://github.com/doleron/yolov5-opencv-cpp-python
Beispiele für die YOLOv5-OpenVINO-C++-Inferenz:
- https://github.com/dacquaviva/yolov5-openvino-cpp-python
- https://github.com/UNeedCryDear/yolov5-seg-opencv-onnxruntime-cpp
TensorFlow.js-Inferenz im Webbrowser#
Unterstützte Umgebungen#
Ultralytics bietet verschiedene sofort einsatzbereite Umgebungen, in denen wichtige Abhängigkeiten wie CUDA, cuDNN, Python und PyTorch bereits installiert sind, damit du direkt mit deinen Projekten loslegen kannst.
- Kostenlose GPU-Notebooks:


- Google Cloud: GCP-Schnellstartanleitung
- Amazon: AWS-Schnellstartanleitung
- Azure: AzureML-Schnellstartanleitung
- Docker: Docker-Schnellstartanleitung

Projektstatus#

Dieses Badge zeigt an, dass alle GitHub-Actions von YOLOv5 für die kontinuierliche Integration (CI) erfolgreich durchlaufen. Diese CI-Tests prüfen gründlich die Funktionalität und Leistung von YOLOv5 in verschiedenen wichtigen Bereichen: Training, Validierung, Inferenz, Export und Benchmarks. Sie gewährleisten einen konsistenten und zuverlässigen Betrieb unter macOS, Windows und Ubuntu. Die Tests werden alle 24 Stunden sowie bei jedem neuen Commit ausgeführt.
Häufig gestellte Fragen#
Verwende ONNX oder OpenVINO für die Bereitstellung auf der CPU, wo sie bis zu dreimal schneller als PyTorch laufen, und TensorRT für NVIDIA-GPUs, wo es bis zu fünfmal schneller läuft. CoreML ist für Apple-Geräte gedacht, während TensorFlow Lite und Edge TPU auf Android und Coral-Hardware abzielen.
Füge
--halfhinzu. Für die halbe Genauigkeit ist bei den meisten Formaten eine GPU erforderlich. Übergib deshalb auch--device 0. CoreML ist die Ausnahme und kann FP16 auf einer CPU exportieren.Ja. Füge
--dynamichinzu. Bei ONNX-Exporten werden dynamische Achsen für Batchgröße, Höhe und Breite aktiviert und der Trace wird auf der CPU erstellt. Lass deshalb--device 0weg. Bei TensorRT-Exporten bleibt die Bildgröße fest und nur die Batch-Dimension variiert: Sie benötigen weiterhin--device 0, und--batch-sizelegt die größte Batchgröße fest, die die Engine akzeptiert.Übergib die exportierte Datei an
detect.py --weights,val.py --weightsodertorch.hub.load("ultralytics/yolov5", "custom", "yolov5s.onnx"). YOLOv5 wählt anhand der Dateiendung das passende Backend aus.


Kommentare
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.