TFLite-Modell für die Bereitstellung exportieren (veraltet)#
Ab Ultralytics 8.4.83 wurde das eigenständige Exportformat tflite entfernt und durch das einheitliche Format Google LiteRT ersetzt. LiteRT (Lite Runtime) ist die nächste Generation und der neue Name für TensorFlow Lite. Es exportiert dasselbe .tflite-Modell und unterstützt nun die Bereitstellung auf Mobilgeräten, eingebetteten und Edge-Geräten sowie in Browsern in einem einzigen Format.
format="tflite" funktioniert weiterhin, gibt aber eine Warnung zur veralteten Nutzung aus und exportiert stattdessen ein LiteRT-Modell. Verwende künftig format="litert". Aktuelle Exportanweisungen und Optionen findest du in der LiteRT-Exportanleitung.
Für die Bereitstellung von Computer-Vision-Modellen auf Edge-Geräten oder eingebetteten Geräten wird ein Format benötigt, das eine reibungslose Leistung gewährleistet.
Das frühere TensorFlow-Lite- oder TFLite-Exportformat optimierte Ultralytics YOLO26-Modelle für Aufgaben wie Objekterkennung und Bildklassifizierung in Edge-Anwendungen. Diese Anleitung beschreibt weiterhin den früheren TFLite-Bereitstellungskontext. Verwende für neue Exporte LiteRT.
Warum wurde TFLite für den Export verwendet?#
TensorFlow Lite, kurz TFLite, wurde im Mai 2017 von Google als Teil des TensorFlow-Frameworks eingeführt. Es war ein quelloffenes Deep-Learning-Framework für die Inferenz auf dem Gerät, auch bekannt als Edge Computing. Es stellte Entwicklern Werkzeuge zur Ausführung trainierter Modelle auf Mobilgeräten, eingebetteten und IoT-Geräten sowie herkömmlichen Computern bereit.
TensorFlow Lite unterstützte zahlreiche Plattformen, darunter Embedded Linux, Android, iOS und Mikrocontroller (MCUs). Mit TFLite exportierte Modelle konnten Anwendungen lokal und offline ausführen.
Wichtige Merkmale von TFLite-Modellen#
TFLite-Modelle bieten zahlreiche wichtige Funktionen für maschinelles Lernen direkt auf dem Gerät. Damit können Entwickler ihre Modelle auf Mobilgeräten, eingebetteten Geräten und Edge-Geräten ausführen:
-
Optimierung für die Ausführung auf dem Gerät: TFLite ist für maschinelles Lernen direkt auf dem Gerät optimiert. Durch die lokale Verarbeitung von Daten werden Latenzen verringert, der Datenschutz wird verbessert, da keine personenbezogenen Daten übertragen werden, und die Modellgröße wird reduziert, um Speicherplatz zu sparen.
-
Unterstützung mehrerer Plattformen: TFLite ist mit zahlreichen Plattformen kompatibel und unterstützt Android, iOS, Embedded Linux und Mikrocontroller.
-
Unterstützung verschiedener Programmiersprachen: TFLite ist mit verschiedenen Programmiersprachen kompatibel, darunter Java, Swift, Objective-C, C++ und Python.
-
Hohe Leistung: Hardwarebeschleunigung und Modelloptimierung sorgen für eine hervorragende Leistung.
Gemessene Leistung (historisch)#
Diese Ergebnisse wurden mit dem Ultralytics-Flutter-Plugin 0.6.8 und LiteRT 2.1.5 unter Android 16/API 36 auf einem Xiaomi 17 mit 12 GB LPDDR5X-Speicher erfasst. Der 3-nm- Snapdragon 8 Elite Gen 5 (SM8850) verfügt über eine Qualcomm-Oryon-CPU mit 8 Kernen (2 Prime-Kerne mit bis zu 4.6 GHz und 6 Performance-Kerne mit bis zu 3.62 GHz), eine Adreno-GPU und eine Hexagon-NPU. In diesen Tabellen werden die früheren onnx2tf-INT8-TFLite-Dateien mit den getesteten litert-torch-Exporten verglichen, die im Zuge der Migration geprüft wurden. Die veröffentlichten Dateien wurden anschließend mit den standardisierten Exporten überschrieben. Diese Zahlen beschreiben daher nicht die aktuellen Bytes der v0.6.6-Datei. Aktuelle Messwerte findest du in den LiteRT-Leistungstabellen.
Beide Formate wurden nacheinander im selben GPU-Testlauf und mit den angezeigten Eingabegrößen ausgeführt. Jede Zelle zeigt die Gesamtzeit (Vorverarbeitung + Inferenz + Nachverarbeitung) und darunter die Aufteilung nach Phasen. Native Protokolle bestätigten, dass beide Formate den vollständigen Graphen über LiteRT OpenCL (LITERT_CL) auf der Adreno-GPU ausführten.
| Modell | Aufgabe | Größe (Pixel) | Frühere onnx2tf INT8 TFLite (ms) | Kandidat w8a32 LiteRT (ms) |
|---|---|---|---|---|
| YOLO26n | Detect | 640 | 14.0 1.8 / 8.1 / 4.2 | 13.5 1.9 / 8.1 / 3.5 |
| YOLO26n-seg | Segment | 640 | 30.1 1.9 / 20.3 / 8.0 | 28.6 1.8 / 20.1 / 6.7 |
| YOLO26n-sem | Semantisch | 640 | 26.4 1.9 / 16.4 / 8.1 | 32.9 1.8 / 23.0 / 8.2 |
| YOLO26n-cls | Klassifizieren | 224 | 3.5 0.9 / 2.2 / 0.4 | 3.2 1.0 / 2.2 / 0.1 |
| YOLO26n-pose | Pose | 640 | 17.4 2.4 / 9.9 / 5.1 | 14.0 1.9 / 9.3 / 2.8 |
| YOLO26n-obb | OBB | 640 | 13.9 3.0 / 8.3 / 2.7 | 13.0 2.9 / 7.9 / 2.3 |
Im selben Migrationslauf wurden auch die Quantisierungsformate für YOLO26n detect verglichen. Die Inferenzzeit ist die vergleichbare, vom Format abhängige Kennzahl:
| Android-Format | GPU-Inferenz (ms) | GPU-Kompilierung |
|---|---|---|
| onnx2tf INT8 (früheres TFLite) | 8.6 | ja |
| LiteRT w8a32 (Kandidat) | 8.4 | ja |
LiteRT INT8 (quantize=8) | 11.0 | ja |
| LiteRT FP32 | 8.8 | ja |
LiteRT w8a16 (quantize="w8a16") | CPU-Ausweichbetrieb | nein |
In diesem Testlauf fiel w8a16 auf die CPU zurück und benötigte insgesamt etwa 660 ms, gegenüber etwa 17 ms bei den GPU-Formaten. Diese Ergebnisse waren ausschlaggebend für die Veröffentlichung von w8a32. Die Kompatibilität mit Delegaten und die Leistung hängen jedoch vom Gerät und der Laufzeitversion ab. Führe Benchmarks auf dem Zielgerät aus und prüfe in den Laufzeitprotokollen, welcher Beschleuniger verwendet wird.
Bereitstellungsoptionen für TFLite#
Bevor wir uns das Beispiel für den Export mit dem LiteRT-Ersatz ansehen, klären wir zunächst, wie TFLite-Modelle üblicherweise eingesetzt werden.
TFLite bietet verschiedene Optionen für die Bereitstellung von Modellen für maschinelles Lernen direkt auf dem Gerät, darunter:
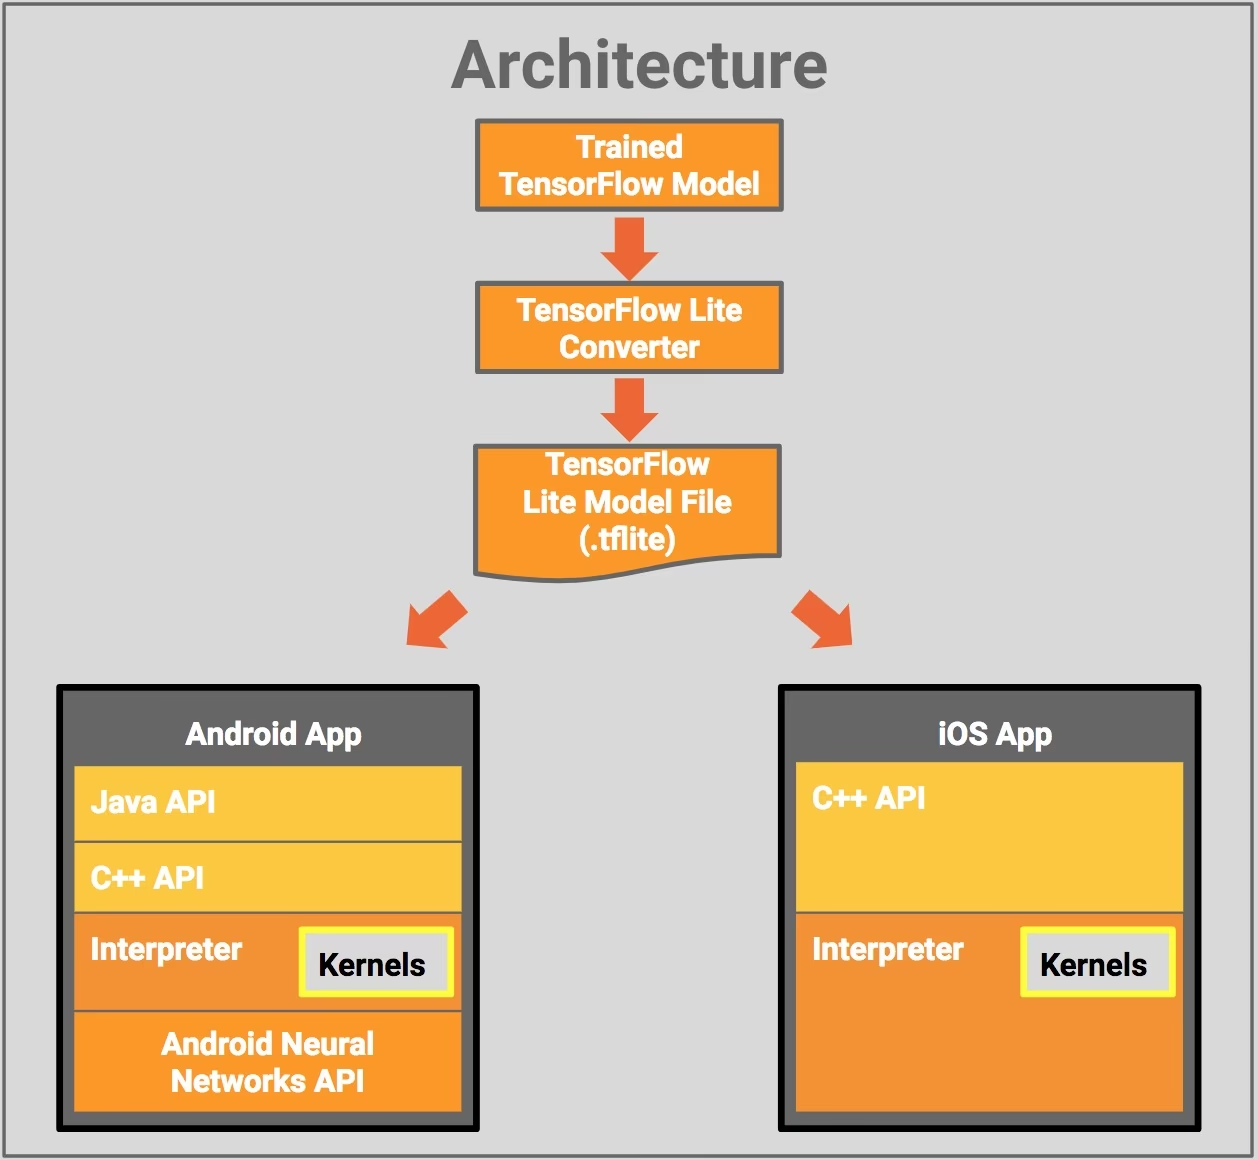
- Bereitstellung mit Android und iOS: Android- und iOS-Anwendungen mit TFLite können kamerabasierte Edge-Streams und Sensordaten analysieren, um Objekte zu erkennen und zu identifizieren. TFLite bietet außerdem native iOS-Bibliotheken in Swift und Objective-C. Das folgende Architekturdiagramm zeigt, wie ein trainiertes Modell mit TensorFlow Lite auf Android- und iOS-Plattformen bereitgestellt wird.
-
Einsatz mit Embedded Linux: Wenn die Inferenz auf einem Raspberry Pi mit der Ultralytics-Anleitung die Geschwindigkeitsanforderungen deines Anwendungsfalls nicht erfüllt, kannst du ein exportiertes TFLite-Modell verwenden, um die Inferenz zu beschleunigen. Außerdem lässt sich die Leistung mit einem Coral-Edge-TPU-Gerät weiter steigern.
-
Bereitstellung auf Mikrocontrollern: TFLite-Modelle lassen sich auch auf Mikrocontrollern und anderen Geräten mit nur wenigen Kilobyte Speicher bereitstellen. Die Kernlaufzeit benötigt auf einem Arm Cortex M3 nur 16 KB und kann viele einfache Modelle ausführen. Sie benötigt weder ein Betriebssystem noch Standardbibliotheken für C oder C++ oder eine dynamische Speicherzuweisung.
TFLite-Export durch LiteRT ersetzen#
Verwende für neue Exporte LiteRT, um dein Modell zu konvertieren. Die resultierende Modelldatei behält die Dateierweiterung .tflite.
Installation#
Führe zum Installieren der erforderlichen Pakete Folgendes aus:
# Install the required package for YOLO26
pip install ultralytics
Ausführliche Anweisungen und bewährte Vorgehensweisen zur Installation findest du in unserer Installationsanleitung von Ultralytics. Falls bei der Installation der für YOLO26 erforderlichen Pakete Probleme auftreten, findest du Lösungen und Tipps in unserer Anleitung zu häufigen Problemen.
Verwendung#
Alle Ultralytics YOLO26-Modelle sind so ausgelegt, dass sie sofort exportiert werden können. Dadurch lassen sie sich problemlos in deinen bevorzugten Bereitstellungsablauf integrieren. In der vollständigen Liste der unterstützten Exportformate und Konfigurationsoptionen findest du die passende Konfiguration für deine Anwendung.
Das ersetzende LiteRT-Format unterstützt die Modi Export, Predict und Validate. Exportiere dein Modell und lade anschließend das exportierte .tflite-Modell, um Inferenz auszuführen oder seine Genauigkeit zu überprüfen.
from ultralytics import YOLO

# Ein YOLO26-Modell laden
model = YOLO("yolo26n.pt")

# Modell ins LiteRT-Format exportieren
model.export(format="litert", imgsz=640) # für die Klassifizierung imgsz=224 verwendenfrom ultralytics import YOLO
# Das exportierte TFLite-Modell laden
model = YOLO("yolo26n.tflite")
# Inferenz ausführen
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Das exportierte TFLite-Modell laden
model = YOLO("yolo26n.tflite")
# Die Genauigkeit anhand des COCO8-Datensatzes validieren
metrics = model.val(data="coco8.yaml")Exportargumente#
| Argument | Typ | Standard | Beschreibung |
|---|---|---|---|
format | str | 'litert' | Zielformat des exportierten Modells, das die Kompatibilität mit verschiedenen Bereitstellungsumgebungen festlegt. |
imgsz | int oder tuple | 640 | Gewünschte Bildgröße für die Modelleingabe. Kann eine Ganzzahl für quadratische Bilder oder ein Tupel (height, width) für bestimmte Abmessungen sein. |
quantize | int oder str | None | Quantisierungsgenauigkeit: 8 (statisches INT8, INT8-Gewichte + INT8-Aktivierungen; benötigt Kalibrierung data/fraction), 'w8a16' (statisch, INT8-Gewichte + INT16-Aktivierungen; benötigt Kalibrierung data/fraction), 'w8a32' (dynamisches INT8, INT8-Gewichte + FP32-Aktivierungen; keine Kalibrierung erforderlich) oder 32/nicht festgelegt (FP32). FP16 wird nicht separat exportiert – ein FP32-Modell wird auf GPU-Delegaten automatisch mit FP16 ausgeführt. Ersetzt die veralteten Flags half/int8. |
batch | int | 1 | Gibt die Batchgröße für die Inferenz des Exportmodells oder die Höchstzahl der Bilder an, die das exportierte Modell gleichzeitig im predict-Modus verarbeiten kann. |
data | str | None | Pfad zur YAML-Datei des Datensatzes, die für die Quantisierung erforderlich ist; bei der Klassifizierung wird stattdessen ein Datensatzverzeichnis oder der Name eines integrierten Datensatzes verwendet. Wenn die Angabe bei quantize=8 oder 'w8a16' fehlt, wählt Ultralytics den standardmäßigen Kalibrierungsdatensatz für die Modellaufgabe aus. |
fraction | float, int oder list | 1.0 | Kalibrierungsteilstichprobe als Verhältnis, Bildanzahl oder [train, val, test]-Verhältnisse/-Anzahlen. Bei Listen mit zwei Elementen bleibt test vollständig erhalten, während 0 es überspringt. |
device | str | None | Gibt das Gerät für den Export an: CPU (device=cpu), MPS für Apple-Chips (device=mps). |
Weitere Informationen zum Exportvorgang findest du auf der Ultralytics-Dokumentationsseite zum Export.
Exportierte YOLO26-TFLite-Modelle bereitstellen#
Nachdem du dein Ultralytics-YOLO26-Modell in das LiteRT-Format exportiert hast, kannst du das resultierende .tflite-Modell bereitstellen. Als ersten Schritt zur Ausführung eines TFLite-Modells empfehlen wir die Methode YOLO("model.tflite"), die im vorherigen Codebeispiel zur Verwendung beschrieben ist. Ausführliche Anweisungen zur Bereitstellung deiner TFLite-Modelle in verschiedenen anderen Umgebungen findest du in den folgenden Ressourcen:
-
Android: Eine Kurzanleitung zur Integration von TensorFlow Lite in Android-Anwendungen mit einfachen Schritten zum Einrichten und Ausführen von Modellen für maschinelles Lernen.
-
iOS: Diese ausführliche Anleitung für Entwickler beschreibt die Integration und Bereitstellung von TensorFlow-Lite-Modellen in iOS-Anwendungen und bietet Schritt-für-Schritt-Anweisungen und Ressourcen.
-
Beispiele von Anfang bis Ende: Diese Seite bietet einen Überblick über verschiedene TensorFlow-Lite-Beispiele. Sie zeigt praktische Anwendungen und Anleitungen, die Entwicklern helfen, TensorFlow Lite in Projekten für maschinelles Lernen auf Mobilgeräten und Edge-Geräten einzusetzen.
Zusammenfassung#
Diese Anleitung beschreibt weiterhin den früheren TFLite-Bereitstellungsablauf. Verwende für neue Exporte LiteRT, um .tflite-Modelle für Edge-Computing-Umgebungen zu erstellen.
Weitere Informationen zur Verwendung findest du in der offiziellen TFLite-Dokumentation.
Wenn du mehr über weitere Ultralytics-YOLO26-Integrationen erfahren möchtest, findest du auf unserer Seite mit Integrationsanleitungen viele hilfreiche Informationen und Einblicke.
Häufig gestellte Fragen#
Verwende für einen neuen Export das LiteRT-Format. Installiere zunächst das erforderliche Paket mit:
pip install ultralyticsExportiere dein Modell anschließend mit dem folgenden Codebeispiel:
from ultralytics import YOLO

# Ein YOLO26-Modell laden
model = YOLO("yolo26n.pt")

# Modell ins LiteRT-Format exportieren
model.export(format="litert", imgsz=640)  # für die Klassifizierung imgsz=224 verwenden
Wenn du die CLI verwendest, kannst du dies mit folgendem Befehl erledigen:
yolo export model=yolo26n.pt format=litert imgsz=640 # use imgsz=224 for classificationWeitere Informationen findest du in der Ultralytics-Exportanleitung.
TensorFlow Lite (TFLite) ist ein quelloffenes Framework für Deep Learning, das für die Inferenz auf dem Gerät entwickelt wurde. Dadurch eignet es sich besonders für die Bereitstellung von YOLO26-Modellen auf Mobilgeräten, eingebetteten Geräten und IoT-Geräten. Zu den wichtigsten Vorteilen gehören:
- Optimierung für die Ausführung auf dem Gerät: Latenzen verringern und den Datenschutz verbessern, indem Daten lokal verarbeitet werden.
- Plattformkompatibilität: Unterstützt Android, iOS, Embedded Linux und MCUs.
- Leistung: Nutzt Hardwarebeschleunigung, um Geschwindigkeit und Effizienz des Modells zu optimieren.
Weitere Informationen findest du in der TFLite-Anleitung.
Ja, du kannst YOLO26-TFLite-Modelle auf einem Raspberry Pi ausführen, um die Inferenz zu beschleunigen. Exportiere zunächst wie oben beschrieben dein Modell in das LiteRT-Format. Führe das Modell anschließend mit einem Werkzeug wie dem TensorFlow Lite Interpreter auf deinem Raspberry Pi aus.
Für weitere Optimierungen kannst du Coral Edge TPU verwenden. Ausführliche Schritte findest du in unserer Anleitung zur Bereitstellung auf Raspberry Pi und in der Anleitung zur Edge-TPU-Integration.
TFLite unterstützt die Bereitstellung auf Mikrocontrollern mit begrenzten Ressourcen: Die Kernlaufzeit benötigt auf einem Arm Cortex M3 nur 16 KB Speicher und kann viele einfache Modelle ausführen. YOLO26-Modelle sind jedoch in der Regel zu groß für den begrenzten Speicher typischer Mikrocontroller. Daher eignen sich Einplatinencomputer, Mobilgeräte oder dedizierte Beschleuniger besser für YOLO26.
Die Anleitung zu TFLite Micro für Mikrocontroller hilft dir beim Einstieg.
TensorFlow Lite ist mit zahlreichen Plattformen kompatibel und ermöglicht die Bereitstellung von YOLO26-Modellen auf vielen Geräten, darunter:
- Android und iOS: Native Unterstützung durch die TFLite-Bibliotheken für Android und iOS.
- Embedded Linux: Ideal für Einplatinencomputer wie Raspberry Pi.
- Mikrocontroller: Geeignet für MCUs mit begrenzten Ressourcen.
Weitere Informationen zu den Bereitstellungsoptionen findest du in unserer ausführlichen Anleitung zur Bereitstellung.
Wenn beim Export von YOLO26-Modellen nach LiteRT Fehler auftreten, helfen häufig folgende Maßnahmen:
- Paketkompatibilität prüfen: Stelle sicher, dass du kompatible Versionen von Ultralytics,
litert-torchundai-edge-litertverwendest. Weitere Informationen findest du in unserer Installationsanleitung. - Modellunterstützung: Prüfe anhand der Exportdokumentation von Ultralytics, ob das jeweilige YOLO26-Modell den LiteRT-Export unterstützt.
- Probleme mit der Quantisierung: Wenn du INT8-Quantisierung verwendest, stelle sicher, dass der Pfad zu deinem Datensatz im Parameter
datakorrekt angegeben ist.
Weitere Tipps zur Fehlerbehebung findest du in unserem Leitfaden zu häufigen Problemen.
- Paketkompatibilität prüfen: Stelle sicher, dass du kompatible Versionen von Ultralytics,