Tipps für optimale Trainingsergebnisse mit YOLOv5
Dieser Leitfaden erklärt, wie du mit YOLOv5 die besten mAP- und Trainingsergebnisse erzielst.
Meistens lassen sich gute Ergebnisse erzielen, ohne Modelle oder Trainingseinstellungen zu ändern, sofern dein Datensatz groß genug und gut beschriftet ist. Wenn die Ergebnisse zunächst nicht zufriedenstellend sind, kannst du möglicherweise einige Schritte zur Verbesserung unternehmen. Wir empfehlen jedoch immer, zuerst mit allen Standardeinstellungen zu trainieren, bevor du Änderungen in Betracht ziehst. So legst du eine Vergleichsbasis für die Leistung fest und erkennst Bereiche mit Verbesserungspotenzial.
Wenn du Fragen zu deinen Trainingsergebnissen hast, stelle möglichst viele Informationen bereit, damit du eine hilfreiche Antwort erhältst. Dazu gehören Ergebnisdiagramme (Trainingsverluste, Validierungsverluste, P, R, mAP), die PR-Kurve, die Konfusionsmatrix, Trainingsmosaike, Testergebnisse und Bilder mit Datensatzstatistiken wie labels.png. All diese Dateien befinden sich in deinem Verzeichnis project/name, normalerweise unter yolov5/runs/train/exp.
In den folgenden Abschnitten geht es um die wichtigsten Faktoren, die die Trainingsergebnisse von YOLOv5 beeinflussen.
Datensatz#
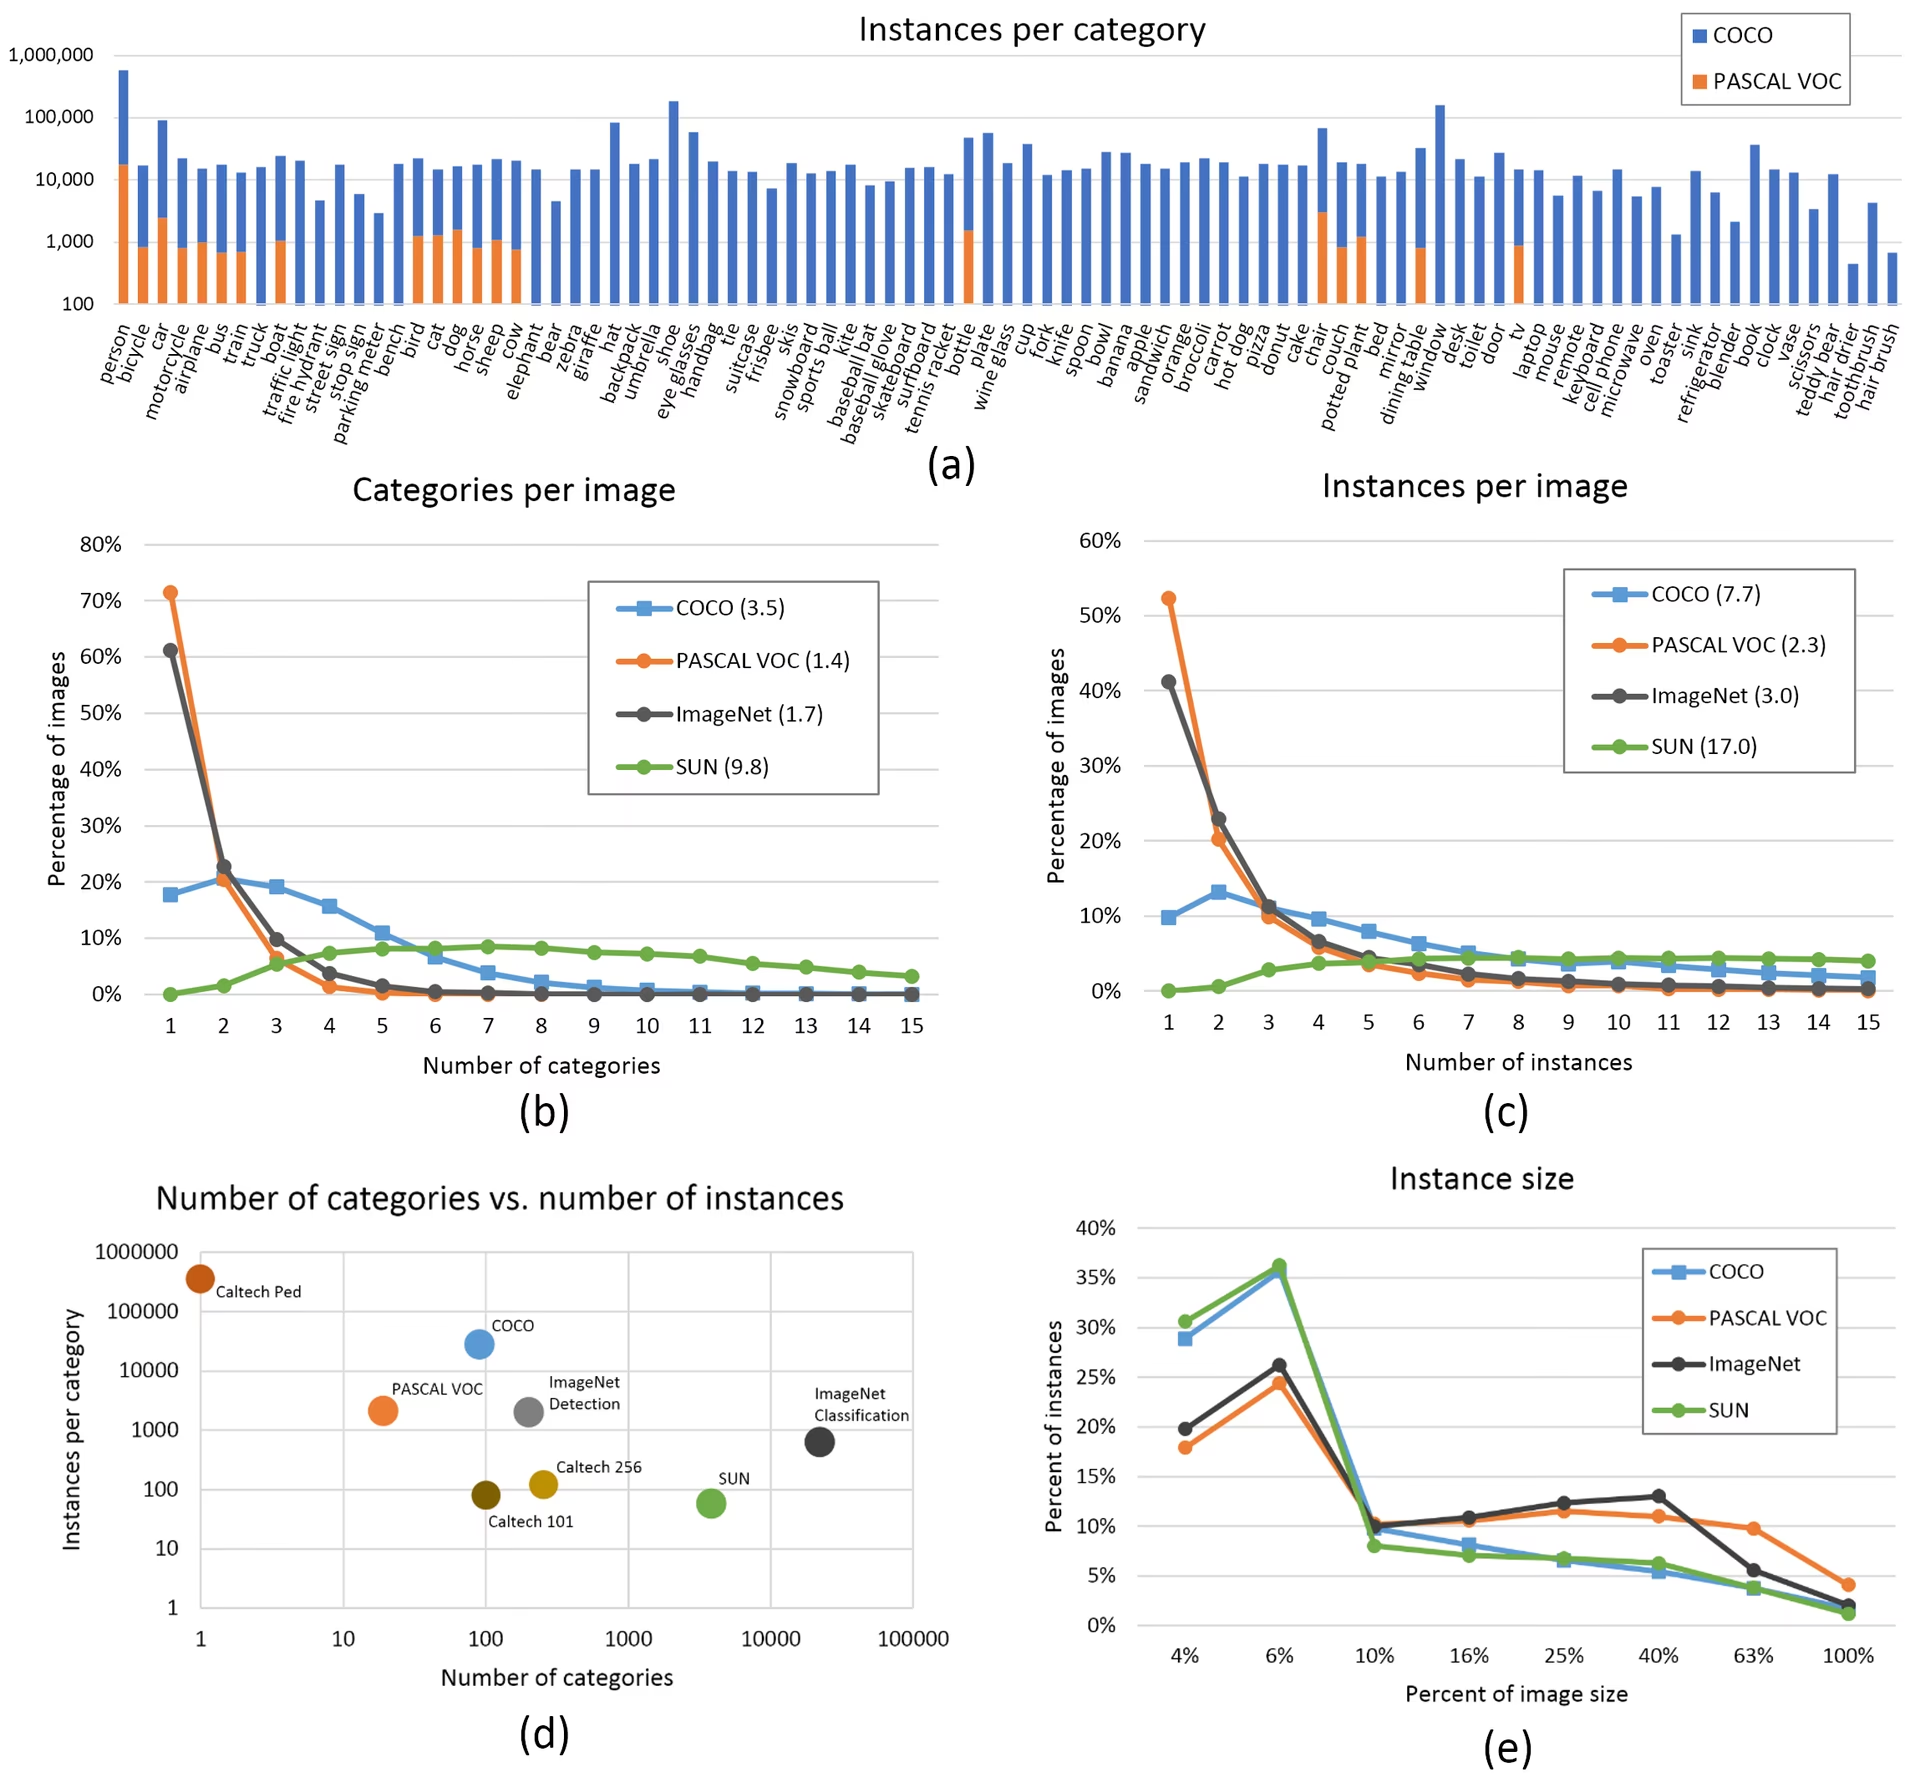
- Bilder pro Klasse. Empfohlen werden ≥ 1500 Bilder pro Klasse
- Instanzen pro Klasse. Empfohlen werden ≥ 10000 Instanzen (gelabelte Objekte) pro Klasse
- Bildvielfalt. Die Bilder müssen repräsentativ für die Einsatzumgebung sein. Für Anwendungen in der Praxis empfehlen wir Bilder zu verschiedenen Tageszeiten, aus unterschiedlichen Jahreszeiten, bei unterschiedlichem Wetter und Lichtverhältnissen, aus verschiedenen Blickwinkeln und unterschiedlichen Quellen (aus dem Internet gesammelt, vor Ort aufgenommen, mit verschiedenen Kameras) usw.
- Konsistenz der Labels. Alle Instanzen aller Klassen in allen Bildern müssen gelabelt sein. Unvollständiges Labeling funktioniert nicht.
- Genauigkeit der Labels. Die Labels müssen jedes Objekt eng umschließen. Zwischen einem Objekt und seinem Begrenzungsrahmen darf kein Abstand sein. Kein Objekt darf ohne Label bleiben.
- Sorgfältige Aufteilung in Trainings- und Validierungsdaten. Achte darauf, dass Bilder aus Validierungs- und Testdaten nicht im Trainingsdatensatz vorkommen, damit die Metriken nicht zu optimistisch ausfallen. Die Klassenverteilungen sollten in den jeweiligen Teilmengen ähnlich sein.
- Labels überprüfen. Sieh dir zu Beginn des Trainings die
train_batch*.jpg-Mosaike an, um zu prüfen, ob deine Labels korrekt aussehen. - Hintergrundbilder. Hintergrundbilder enthalten keine Objekte und werden einem Datensatz hinzugefügt, um falsch-positive Ergebnisse (FP) zu reduzieren. Wir empfehlen, etwa 0–10 % Hintergrundbilder zu verwenden, um falsch-positive Ergebnisse (FPs) zu reduzieren (COCO enthält zum Vergleich 1000 Hintergrundbilder, also 1 % der Gesamtmenge). Für Hintergrundbilder sind keine Labels erforderlich.
Modellauswahl#
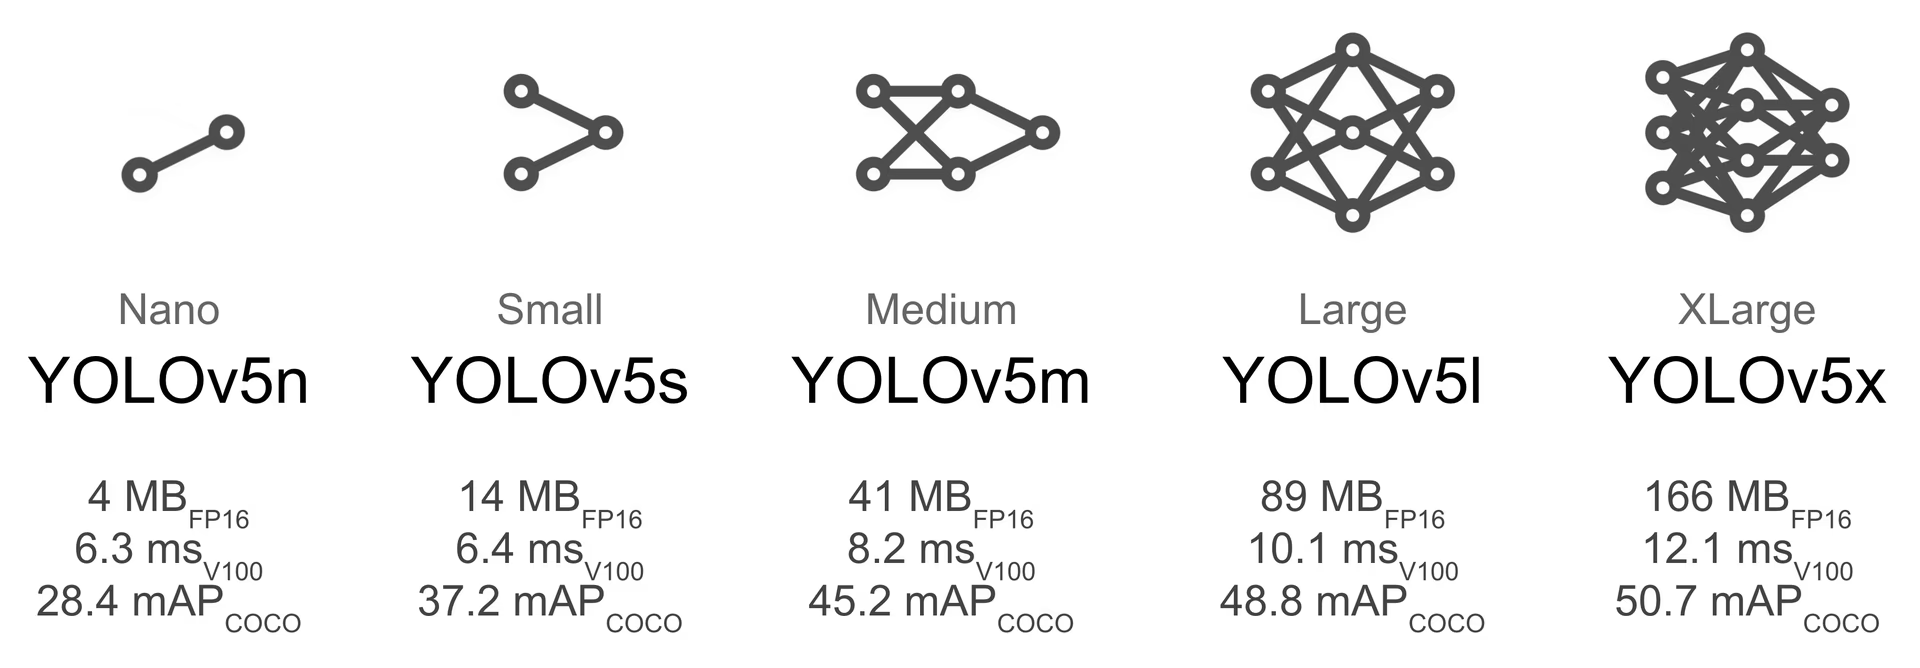
Größere Modelle wie YOLOv5x und YOLOv5x6 erzielen fast immer bessere Ergebnisse, haben aber mehr Parameter, benötigen beim Training mehr CUDA-Speicher und laufen langsamer. Für die Bereitstellung auf Mobilgeräten empfehlen wir YOLOv5s/m, für die Cloud YOLOv5l/x.
-
Mit vortrainierten Gewichten beginnen. Empfohlen für kleine bis mittelgroße Datensätze (z. B. VOC, VisDrone, GlobalWheat). Gib den Modellnamen für das Argument
--weightsan. Modelle werden automatisch aus der neuesten YOLOv5-Version heruntergeladen.python train.py --data custom.yaml --weights yolov5s.pt python train.py --data custom.yaml --weights yolov5m.pt python train.py --data custom.yaml --weights yolov5l.pt python train.py --data custom.yaml --weights yolov5x.pt python train.py --data custom.yaml --weights custom_pretrained.pt -
Von Grund auf beginnen. Empfohlen für große Datensätze (z. B. COCO, Objects365, OIv6). Gib die YAML-Datei der gewünschten Modellarchitektur zusammen mit einem leeren Argument
--weights ''an:python train.py --data custom.yaml --weights '' --cfg yolov5s.yaml python train.py --data custom.yaml --weights '' --cfg yolov5m.yaml python train.py --data custom.yaml --weights '' --cfg yolov5l.yaml python train.py --data custom.yaml --weights '' --cfg yolov5x.yaml
Trainingseinstellungen#
Bevor du etwas änderst, trainiere zuerst mit den Standardeinstellungen, um eine Ausgangsbasis für die Leistung zu erhalten. Eine vollständige Liste der Einstellungen für train.py findest du im Argumentparser von train.py.
- Epochen. Beginne mit 300 Epochen. Wenn das Modell frühzeitig überangepasst wird, kannst du die Epochenzahl verringern. Tritt nach 300 Epochen keine Überanpassung auf, trainiere länger, zum Beispiel 600 oder 1200 Epochen.
- Bildgröße. COCO wird mit der nativen Auflösung
--img 640trainiert. Wegen der großen Zahl kleiner Objekte im Datensatz kann das Training mit höheren Auflösungen wie--img 1280jedoch Vorteile bringen. Enthält ein benutzerdefinierter Datensatz viele kleine Objekte, profitiert er vom Training mit nativer oder höherer Auflösung. Die besten Inferenzergebnisse erhältst du mit derselben--img, die auch beim Training verwendet wurde. Wenn du beispielsweise mit--img 1280trainierst, solltest du Tests und Erkennung ebenfalls mit--img 1280durchführen. - Batch-Größe. Verwende die größtmögliche
--batch-size, die deine Hardware unterstützt. Kleine Batch-Größen führen zu schlechten Statistiken bei der Batch-Normalisierung und sollten vermieden werden. Mit--batch-size -1kannst du automatisch die optimale Batch-Größe für deine GPU auswählen. - Lernrate. Der standardmäßige Lernratenplan funktioniert in den meisten Fällen gut. Für eine schnellere Konvergenz kannst du das Flag
--cos-lrverwenden, um einen Lernratenplan mit Kosinus-Abnahme zu aktivieren. Dabei wird die Lernrate im Verlauf der Epochen schrittweise entsprechend einer Kosinuskurve verringert. - Datenerweiterung. YOLOv5 bietet verschiedene Verfahren zur Datenerweiterung, etwa Mosaik, bei dem mehrere Trainingsbilder kombiniert werden. Passe die Stärke der Datenerweiterung über den Hyperparameter
mosaicin deiner Datei--hypan, um das Training zu stabilisieren. - Hyperparameter. Die Standard-Hyperparameter findest du in hyp.scratch-low.yaml. Wir empfehlen, zuerst mit den Standard-Hyperparametern zu trainieren, bevor du Änderungen in Betracht ziehst. Generell verringert eine Erhöhung der Hyperparameter für die Datenerweiterung die Überanpassung und verzögert sie. Dadurch sind längere Trainingsläufe und ein höherer endgültiger mAP möglich. Eine Verringerung der Verstärkungshyperparameter für Verlustkomponenten wie
hyp['obj']hilft, die Überanpassung bei den jeweiligen Verlustkomponenten zu reduzieren. Eine automatische Methode zur Optimierung dieser Hyperparameter findest du in unserem Tutorial zur Hyperparameter-Evolution. - Training mit gemischter Genauigkeit. YOLOv5 aktiviert automatisch Automatic Mixed Precision (AMP), sobald eine unterstützte GPU erkannt wird. Das beschleunigt das Training und senkt den Speicherbedarf, ohne die Modellgenauigkeit zu beeinträchtigen.
- Training mit mehreren GPUs. Wenn du mehrere GPUs hast, starte das DistributedDataParallel-Training mit
python -m torch.distributed.run --nproc_per_node 4 train.py ... --device 0,1,2,3, um die Trainingszeit deutlich zu verkürzen. - Früher Abbruch. Mit
--patience 50kannst du das Training beenden, wenn sich die Validierungsmetriken 50 Epochen lang nicht verbessern. So sparst du Zeit und beugst Überanpassung vor.
Fortgeschrittene Optimierungsverfahren#
- Transferlernen. Beginne bei spezialisierten Datensätzen mit vortrainierten Gewichten und frieren optional Schichten ein, indem du
--freezeverwendest, um das Modell an deine spezifische Aufgabe anzupassen. - Modellpruning. Erwäge nach dem Training, dein Modell zu beschneiden, um redundante Gewichte auf null zu setzen und dabei nur wenig Genauigkeit einzubüßen. Setze das Modell anschließend mit einer Laufzeitumgebung ein, die Sparsität unterstützt, um Geschwindigkeitssteigerungen zu erzielen.
- Modell-Ensemble. Trainiere für kritische Anwendungen mehrere Modelle mit unterschiedlichen Konfigurationen und kombiniere ihre Vorhersagen, um die Genauigkeit zu verbessern.
- Testzeiterweiterung. Aktiviere TTA während der Inferenz mit
--augment, um die Vorhersagegenauigkeit zu verbessern. Dazu werden Vorhersagen aus gespiegelten und skalierten Versionen des Eingabebildes zusammengeführt.
Weiterführende Lektüre#
Wenn du mehr erfahren möchtest, ist Karpathys A Recipe for Training Neural Networks ein guter Ausgangspunkt. Der Beitrag enthält Trainingsideen, die sich auf viele Bereiche des ML übertragen lassen.
Viel Erfolg, und lass uns wissen, wenn du noch Fragen hast.
Häufig gestellte Fragen#
Dein Modell könnte überanpassen, wenn der Trainingsverlust weiter sinkt, während der Validierungsverlust zu steigen beginnt. Beobachte den Validierungs-mAP-Wert: Wenn er stagniert oder sinkt, während sich der Trainingsverlust weiter verbessert, ist das ein Zeichen für Überanpassung. Zu den möglichen Lösungen gehören mehr Trainingsdaten, stärkere Datenerweiterung oder Regularisierung.
Die optimale Batch-Größe hängt vom GPU-Speicher ab. Größere Batch-Größen liefern im Allgemeinen bessere Statistiken bei der Batch-Normalisierung und sorgen für ein stabileres Training. Verwende die größtmögliche Batch-Größe, die deine Hardware ohne Speichermangel bewältigt. Mit
--batch-size -1kannst du die optimale Batch-Größe für deine Konfiguration automatisch ermitteln.Um das Training zu beschleunigen, kannst du Folgendes versuchen: mehrere GPUs mit DDP verwenden, deinen Datensatz mit
--cachezwischenspeichern und die Batchgröße optimieren (auf unterstützten GPUs wird die gemischte Genauigkeit automatisch aktiviert). Ziehe auch eine kleinere Modellvariante wie YOLOv5s in Betracht, wenn absolute Genauigkeit nicht entscheidend ist.


Kommentare
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.