Inferencia segura para subprocesos con modelos YOLO
Para ejecutar inferencias de Ultralytics YOLO de forma segura en varios subprocesos de Python, crea una instancia independiente del modelo YOLO dentro de cada subproceso, en lugar de compartir una instancia entre ellos. Compartir un único modelo provoca condiciones de carrera que corrompen su estado interno y generan resultados impredecibles, porque el módulo threading de Python ejecuta los subprocesos simultáneamente sobre el mismo objeto. Esta guía explica por qué falla el uso compartido, muestra el patrón seguro por subproceso y presenta el decorador ThreadingLocked para los casos en los que tengas que compartir una instancia.
Ve directamente a por qué falla compartir un modelo, al patrón seguro para subprocesos o al decorador ThreadingLocked.
Ver: Cómo realizar inferencias seguras para subprocesos con modelos Ultralytics YOLO en Python | Multihilo 🚀
Introducción a los subprocesos de Python#
Los hilos de Python permiten que tu programa ejecute varias operaciones de forma concurrente. Sin embargo, el bloqueo global del intérprete de Python (GIL) hace que solo se pueda ejecutar bytecode de Python en un hilo a la vez.
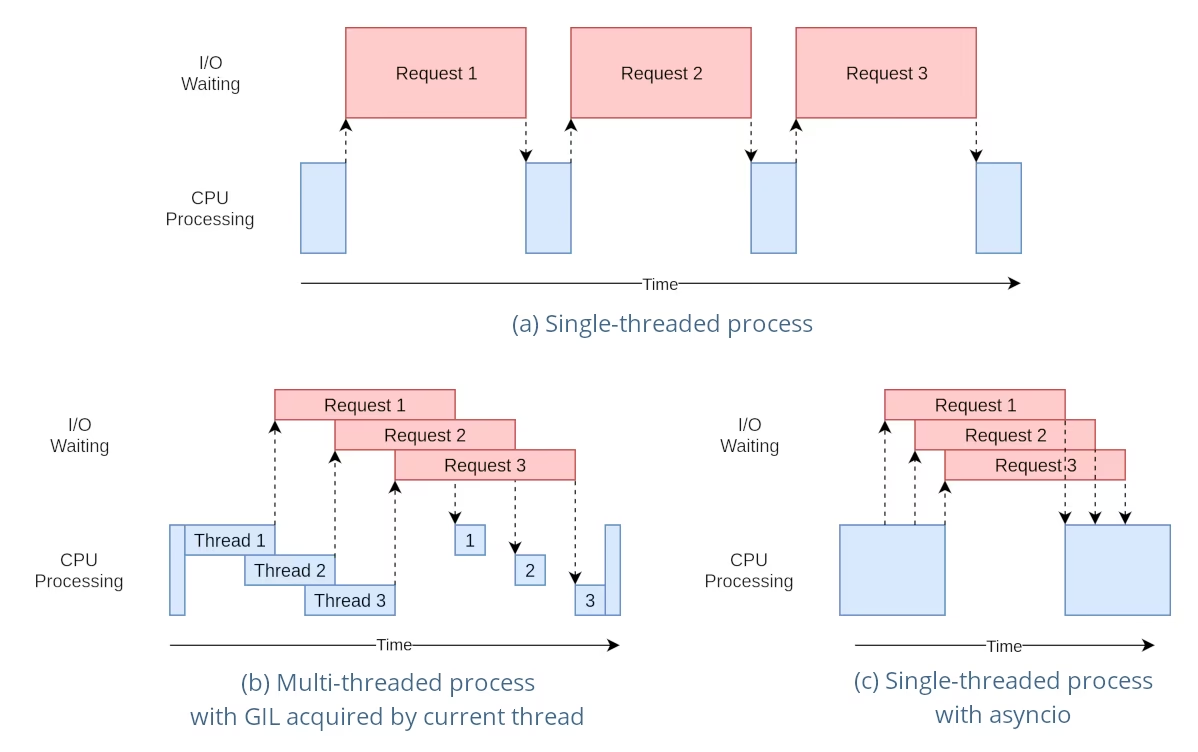
Aunque pueda parecer una limitación, los subprocesos pueden proporcionar concurrencia, sobre todo en operaciones limitadas por la E/S o al utilizar operaciones que liberan el GIL, como las que realizan las bibliotecas C subyacentes de YOLO.
El peligro de compartir instancias de modelos#
Crear una instancia de un modelo YOLO fuera de los subprocesos y compartirla entre varios puede provocar condiciones de carrera, en las que el estado interno del modelo se modifica de forma incoherente debido a accesos simultáneos. Esto resulta especialmente problemático cuando el modelo o sus componentes mantienen un estado que no está diseñado para ser seguro para subprocesos.
Ejemplo no seguro para subprocesos: una sola instancia de modelo#
Al utilizar subprocesos en Python, es importante reconocer los patrones que pueden provocar problemas de concurrencia. Esto es lo que debes evitar: compartir una única instancia del modelo YOLO26 entre varios subprocesos.
# # Inseguro: compartir una única instancia de modelo entre subprocesos
from threading import Thread

from ultralytics import YOLO

# # Crear una instancia del modelo fuera del subproceso
shared_model = YOLO("yolo26n.pt")

def predict(image_path):
    """Predicts objects in an image using a preloaded YOLO model, take path string to image as argument."""
    results = shared_model.predict(image_path)
    # Procesa los resultados

# # Iniciar subprocesos que comparten la misma instancia de modelo
Thread(target=predict, args=("image1.jpg",)).start()
Thread(target=predict, args=("image2.jpg",)).start()
En el ejemplo anterior, ambos hilos comparten shared_model. Cada llamada a predict conserva sus propios argumentos, como conf, iou y imgsz, pero las llamadas que utilizan el mismo predictor se ejecutan de una en una, protegidas por su bloqueo, por lo que los hilos apenas obtienen paralelismo. El estado que reside en la instancia, como el estado del tracker, los vocabularios set_classes de YOLOE o los prompts de SAM, FastSAM y YOLOE, sigue compartiéndose entre todos los hilos, así que asigna a cada hilo su propia instancia para esos casos.
Ejemplo seguro: una instancia dedicada por subproceso#
Puedes utilizar varias instancias de modelo independientes siempre que cada subproceso sea propietario de su instancia y no la comparta nunca con otro subproceso. No importa que las instancias de abajo se creen antes de iniciar los subprocesos: el único patrón inseguro es compartir una instancia entre subprocesos:
# # Seguro: cada subproceso utiliza su propia instancia de modelo dedicada
from threading import Thread

from ultralytics import YOLO

# # Crear un modelo por subproceso
model_1 = YOLO("yolo26n.pt")
model_2 = YOLO("yolo26n.pt")

def predict(model, image_path):
    """Runs prediction on an image using a specified YOLO model, returning the results."""
    results = model.predict(image_path)
    # Procesa los resultados

# # Cada subproceso utiliza una instancia de modelo independiente y dedicada
Thread(target=predict, args=(model_1, "image1.jpg")).start()
Thread(target=predict, args=(model_2, "image2.jpg")).start()
Como cada subproceso trabaja con su propia instancia dedicada, no hay un estado de modelo compartido que los subprocesos puedan corromper. Crear la instancia del modelo dentro de cada subproceso, como se muestra a continuación, es simplemente la forma más sencilla de garantizar que nunca se comparta una instancia por accidente.
Inferencia segura para subprocesos#
Para realizar inferencias seguras para subprocesos, crea una instancia de un modelo YOLO independiente dentro de cada subproceso. Así te aseguras de que cada subproceso tenga su propia instancia aislada del modelo y eliminas el riesgo de condiciones de carrera.
Ejemplo seguro para subprocesos#
Así puedes crear una instancia de un modelo YOLO dentro de cada subproceso para ejecutar inferencias en paralelo de forma segura:
# # Seguro: crear una única instancia de modelo dentro de cada subproceso
from threading import Thread

from ultralytics import YOLO

def thread_safe_predict(image_path):
    """Predict on an image using a new YOLO model instance in a thread-safe manner; takes image path as input."""
    local_model = YOLO("yolo26n.pt")
    results = local_model.predict(image_path)
    # Procesa los resultados

# Inicia subprocesos, cada uno con su propia instancia del modelo
Thread(target=thread_safe_predict, args=("image1.jpg",)).start()
Thread(target=thread_safe_predict, args=("image2.jpg",)).start()
En este ejemplo, cada subproceso crea su propia instancia de YOLO. Así se evita que un subproceso interfiera con el estado del modelo de otro y se garantiza que cada uno realice inferencias de forma segura, sin interacciones inesperadas con los demás.
Uso del decorador ThreadingLocked#
Ultralytics proporciona un decorador ThreadingLocked que puedes utilizar para garantizar que las funciones se ejecuten de forma segura para subprocesos. Este decorador utiliza un bloqueo para garantizar que solo se ejecute la función decorada en un subproceso cada vez.
from ultralytics import YOLO
from ultralytics.utils import ThreadingLocked

# # Crear una instancia del modelo
model = YOLO("yolo26n.pt")

# # Aplicar el decorador a la función de predicción para que sea segura para subprocesos
@ThreadingLocked()
def thread_safe_predict(image_path):
    """Thread-safe prediction using a shared model instance."""
    results = model.predict(image_path)
    return results

# # Ahora puedes llamar a esta función de forma segura desde varios subprocesos
El decorador ThreadingLocked resulta especialmente útil cuando necesitas compartir una instancia de modelo entre subprocesos, pero quieres garantizar que solo un subproceso pueda acceder a ella cada vez.
Compartir una instancia de modelo bloqueada ahorra memoria frente a cargar un modelo en cada subproceso, pero reduce la concurrencia porque los subprocesos se serializan al usar el bloqueo y esperan su turno. Elige el patrón por subproceso si tienes memoria disponible y quieres el máximo paralelismo; recurre a ThreadingLocked cuando la memoria del modelo sea el factor limitante.
Conclusión#
Al utilizar modelos YOLO con threading de Python, asigna a cada subproceso su propia instancia de modelo dedicada y no compartas nunca una instancia entre subprocesos. Crear el modelo dentro del subproceso que lo utiliza es la forma más sencilla de garantizarlo, evitar condiciones de carrera y mantener la fiabilidad de las tareas de inferencia.
Para escenarios más avanzados y para optimizar aún más el rendimiento de las inferencias multiproceso, plantéate utilizar el paralelismo basado en procesos con multiprocessing o una cola de tareas con procesos de trabajo dedicados.
Preguntas frecuentes#
Para evitar condiciones de carrera al usar modelos Ultralytics YOLO en un entorno Python con varios hilos, crea una instancia independiente del modelo YOLO en cada hilo. Así, cada hilo tiene su propia instancia aislada del modelo y se evitan modificaciones simultáneas del estado del modelo.
Ejemplo:
from threading import Thread from ultralytics import YOLO def thread_safe_predict(image_path): """Predict on an image in a thread-safe manner.""" local_model = YOLO("yolo26n.pt") results = local_model.predict(image_path) # Procesa los resultados Thread(target=thread_safe_predict, args=("image1.jpg",)).start() Thread(target=thread_safe_predict, args=("image2.jpg",)).start()Para ejecutar inferencias de modelos YOLO multiproceso de forma segura en Python, sigue estas prácticas recomendadas:
- Crea instancias de modelos YOLO dentro de cada subproceso en lugar de compartir una sola instancia entre varios subprocesos.
- Utiliza el módulo
multiprocessingde Python para el procesamiento en paralelo y evitar problemas relacionados con el bloqueo global del intérprete (GIL). - Ten en cuenta que las bibliotecas C subyacentes de YOLO (PyTorch, OpenCV) liberan automáticamente el GIL durante los cálculos intensivos, por lo que los subprocesos pueden seguir ejecutando inferencias simultáneamente.
- Si te preocupa el consumo de memoria, plantéate utilizar el decorador
ThreadingLockedpara las instancias de modelos compartidas.
Ejemplo de creación de instancias de modelo segura para subprocesos:
from threading import Thread

from ultralytics import YOLO

def thread_safe_predict(image_path):
    """Runs inference in a thread-safe manner with a new YOLO model instance."""
    local_model = YOLO("yolo26n.pt")
    results = local_model.predict(image_path)
    # Procesa los resultados

# # Iniciar varios subprocesos
Thread(target=thread_safe_predict, args=("image1.jpg",)).start()
Thread(target=thread_safe_predict, args=("image2.jpg",)).start()
Para obtener más información, consulta la sección sobre inferencias seguras para subprocesos.
Cada subproceso debería tener su propia instancia de modelo YOLO para evitar condiciones de carrera. Cuando se comparte una sola instancia de modelo entre varios subprocesos, los accesos simultáneos pueden provocar un comportamiento impredecible y modificar el estado interno del modelo. Al utilizar instancias independientes, garantizas el aislamiento entre subprocesos, lo que hace que tus tareas multiproceso sean fiables y seguras.
Para obtener instrucciones detalladas, consulta las secciones Ejemplo no seguro para subprocesos: una sola instancia de modelo y Ejemplo seguro para subprocesos.
El bloqueo global del intérprete (GIL) de Python solo permite que un subproceso ejecute bytecode de Python cada vez, lo que puede limitar el rendimiento de las tareas multiproceso limitadas por la CPU. Sin embargo, puedes conseguir concurrencia en operaciones limitadas por la E/S o en procesos que utilizan bibliotecas que liberan el GIL, como las bibliotecas C subyacentes de YOLO. Para mejorar el rendimiento, plantéate utilizar el paralelismo basado en procesos con el módulo
multiprocessingde Python.Para obtener más información sobre los subprocesos en Python, consulta la sección Introducción a los subprocesos de Python.
Sí, utilizar el módulo
multiprocessingde Python es más seguro y, a menudo, más eficiente para ejecutar inferencias de modelos YOLO en paralelo. El paralelismo basado en procesos crea espacios de memoria independientes, evita el bloqueo global del intérprete (GIL) y reduce el riesgo de problemas de concurrencia. Cada proceso funciona de forma independiente con su propia instancia de modelo YOLO.


Comentarios12
Haz una pregunta, comparte tus resultados o ayuda a otra persona.
amani784
I used a YOLOv8 model optimized with TensorRT on an AWS machine with a Tesla T4 GPU to detect people in multiple videos. The model is loaded once per process using an initializer function. To improve performance, I parallelized the video processing using 4 processes from the multiprocessing module, where each process handles one video and performs inference using model.predict() on frames sampled at regular intervals. However, this approach led to a decrease in overall performance, with slower processing time per frame and reduced FPS. Is this normal, and if not, what is the solution?
warptengood
I have a few questions:
- Does the rules about thread-safety apply in the same way to TensorRT/ONNX inference of YOLO?
- Should I have the shared model for all threads when using TensorRT YOLO? (In case the answer for the 1st question is 'No'.)
- Is it true that it is better to have
streamparameter to be set toFalsewhen performing inference on TensorRT (inpredict()) - How
torch.cuda.Stream()affects the performance of multi-threading/multi-processing when used onpredict()/track()functions? - Should I have any sort of warm up for TensorRT inference before utilizing a model in any thread/process? (Like making inference on dummy input)
P.S: I want to thank all the Ultralytics team for their kindness and open-mindedness when it comes to help and support their community. You guys are always eager to help. And I don't care if it is some AI agent that's replying or a real person, I am very grateful for you for what you guys doing :D
 Glenn JocherUltralytics
@KenesYerassyl Thank you for your great questions about thread safety with TensorRT/ONNX models. Let me address each one:
-
Yes, the thread-safety principles apply similarly to TensorRT/ONNX models, but with important distinctions. TensorRT engines have their own memory management which can introduce additional concurrency concerns.
-
For TensorRT models, it's generally safer to use separate engine instances per thread or use a thread locking mechanism like our
ThreadingLockeddecorator. TensorRT engines maintain internal state during inference that can cause issues with concurrent access. -
Setting
stream=Falsefor TensorRT inference is often beneficial as it ensures complete processing of each input before handling another, which can help avoid resource conflicts in multi-threaded environments. -
Using
torch.cuda.Stream()with multi-threading can improve performance by allowing parallel execution of CUDA operations across different streams. However, you need to carefully manage synchronization points to prevent race conditions. Each thread should ideally use a separate CUDA stream. -
Yes, warming up TensorRT models is highly recommended. The first inference typically takes longer due to CUDA context initialization and memory allocations. Running inference on a dummy input before deploying in production or multi-threaded environments ensures consistent performance.
Thank you for your kind words about our team! We're committed to supporting the community with helpful resources and guidance.
-
Thank you very much for such a comprehensive reply!
mrbulb
Hello, is there any example code that uses Python's multiprocessing for YOLO model inference?
 Paula DerrengerUltralytics
@mrbulb for using Python's multiprocessing with YOLO model inference, you should instantiate a separate YOLO model within each process to avoid race conditions. This ensures each process has its own isolated model instance. For detailed guidance, please refer to our Thread-Safe Inference with YOLO Models page. If you need a specific code example, feel free to ask!
farrostaufiqur
how to use results differently for each thread?
- Paula DerrengerUltralytics
To use results differently for each thread, ensure each thread instantiates its own YOLO model instance. This prevents race conditions and ensures thread safety. For more details, please refer to our Thread-Safe Inference with YOLO Models guide.
ghost
Hello. Thanks for the info. I have a question, If I run in two terminals the same python script, but to two different videos, both processes still suffer from GIL ?
- Glenn JocherUltralytics
@cawilchesp running the same Python script in two separate terminals for different videos won't suffer from GIL issues, as each process has its own Python interpreter and memory space. This effectively bypasses the GIL, allowing true parallel execution. For more details, you can check out our guide on thread-safe inference: https://docs.ultralytics.com/guides/yolo-thread-safe-inference/.
abysshal
So what is the best practice for single-threaded processing with asyncio? For example, gunicron+gevent+flask is used to deal with highly concurrent requests, and only one Yolo model instance will be created in each worker process. Here we do not handle threads manually, we only provide the predict function for callback from gevent. Then will the predict function of the same model instance be called again on the next request when it is not completed due to an I/O wait operation on the current request? How we handle this safely? Does it matter if cpu of gpu is used for inference?
- Glenn JocherUltralytics(editado)
@abysshal when using an asynchronous server like Gunicorn with Gevent and Flask, you're dealing with a cooperative multitasking environment. In such an environment, the context switches occur at well-defined points, typically I/O operations or explicit yield points. This means that your predict function will not be preempted in the middle of execution by another request unless it hits an I/O wait or a yield.
Here's how you can handle this safely:
-
Single Model Instance: Since you're creating only one YOLO model instance per worker process, you need to ensure that the predict function is designed to be re-entrant. This means that if the function is called again while a previous call is waiting for I/O, it should not cause any conflicts or unexpected behavior.
-
Asyncio Compatibility: If you're using asyncio, you should ensure that the predict function and any other code that might run concurrently are compatible with asyncio's event loop. This means using
awaitfor I/O-bound operations and ensuring that any libraries you use within the predict function are also compatible with asyncio. -
Thread Safety: Even though you're not manually handling threads, the underlying implementation of some libraries (like PyTorch) may use threads for certain operations. A single Ultralytics
YOLOmodel instance is not thread-safe, so do not share one instance across threads. Use one instance per thread or worker, or wrap the shared call with theThreadingLockeddecorator (see the thread-safe inference guide). -
Resource Locking: If there are shared resources that need to be accessed or modified during the predict function, you should use appropriate locking mechanisms to prevent race conditions. However, in an async environment, you should use async-compatible locks like
asyncio.Lock. -
CPU vs. GPU Inference: The choice between CPU and GPU can affect performance but should not affect the thread safety or the async behavior of your application. However, if you're using a GPU, you need to ensure that the library you're using for YOLO supports concurrent model inference on the GPU without conflicts.
-
Testing: Test your application under load to ensure that it behaves correctly with concurrent requests. You can use tools like
locustorab(Apache Bench) to simulate high concurrency and check for any race conditions or deadlocks.
In summary, when using Gunicorn with Gevent and Flask, you should ensure that your predict function is re-entrant and compatible with asyncio, use async-compatible locks if necessary, and test your application under load. The choice of CPU or GPU should not affect the thread safety of your application, but you should ensure that your YOLO model library supports concurrent inference on your chosen hardware.
1 -