Guía paso a paso para entrenar modelos YOLO26 con IBM Watsonx
Las soluciones de visión artificial escalables necesitan una infraestructura para los datos, el entrenamiento y la implementación. IBM Watsonx es una plataforma de IA y datos que facilita el desarrollo, la implementación y la gestión de modelos de IA. Abarca todo el ciclo de vida de la IA y se integra con los servicios de IBM Cloud.
Puedes entrenar modelos Ultralytics YOLO26 con IBM Watsonx. Es una buena opción para empresas interesadas en el entrenamiento eficiente de modelos, el ajuste fino para tareas específicas y la mejora del rendimiento de los modelos mediante herramientas robustas y una configuración intuitiva. Esta guía explica cómo entrenar YOLO26 con IBM Watsonx, desde la configuración del entorno hasta la evaluación de los modelos entrenados.
¿Qué es IBM Watsonx?#
Watsonx es la plataforma en la nube de IBM, diseñada para la IA generativa comercial y los datos científicos. Los tres componentes de IBM Watsonx —watsonx.ai, watsonx.data y watsonx.governance— se combinan para crear una plataforma de IA integral y fiable que puede acelerar proyectos de IA destinados a resolver problemas empresariales. Ofrece herramientas para crear, entrenar e implementar modelos de aprendizaje automático, y facilita la conexión con diversas fuentes de datos.
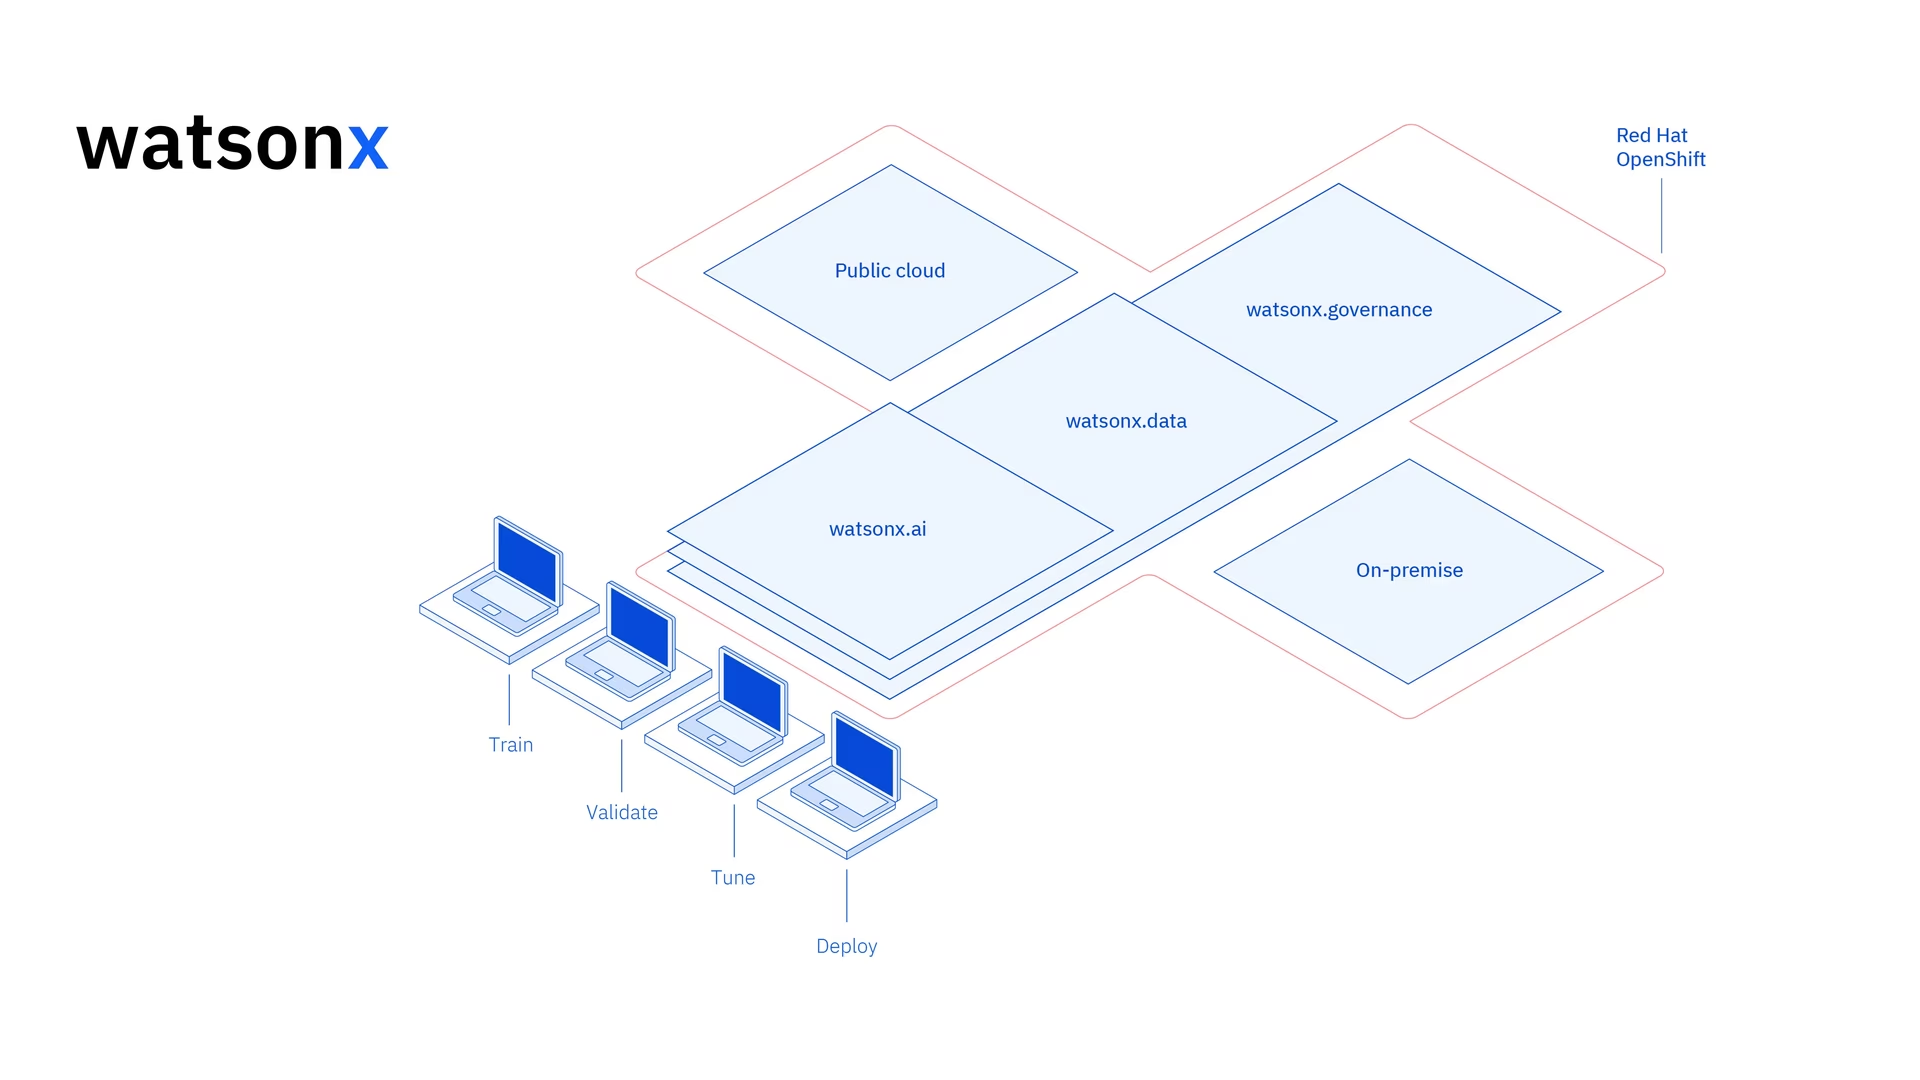
Su interfaz y sus funciones de colaboración facilitan el desarrollo, la gestión y la implementación de modelos. IBM Watsonx ofrece aplicaciones de visión artificial, análisis predictivo, procesamiento del lenguaje natural y otras áreas de la IA.
Características principales de IBM Watsonx#
IBM Watsonx consta de tres componentes principales: watsonx.ai, watsonx.data y watsonx.governance. Cada componente abarca un aspecto diferente de la IA y la gestión de datos.
Watsonx.ai#
Watsonx.ai ofrece herramientas para desarrollar IA y proporciona acceso a modelos personalizados compatibles con IBM, a modelos de terceros como Llama 3 y a los propios modelos Granite de IBM. Incluye Prompt Lab para experimentar con instrucciones para IA y Tuning Studio para mejorar el rendimiento de los modelos con datos etiquetados. Además, ofrece herramientas completas para automatizar el ciclo de vida de los modelos de IA y conectarlos con diversas API y bibliotecas.
Watsonx.data#
Watsonx.data admite implementaciones tanto en la nube como en instalaciones locales. Su consola intuitiva ofrece acceso centralizado a los datos de distintos entornos y facilita su exploración mediante SQL estándar. Optimiza las cargas de trabajo con motores de consultas eficientes como Presto y Spark, acelera la obtención de información con una capa semántica basada en IA, incluye una base de datos vectorial para mejorar la relevancia en IA y admite formatos de datos abiertos para compartir fácilmente datos analíticos y de IA.
Watsonx.governance#
Watsonx.governance facilita el cumplimiento normativo al identificar automáticamente los cambios regulatorios y aplicar las políticas. Vincula los requisitos con los datos internos de riesgos y proporciona fichas de datos de IA actualizadas. La plataforma ayuda a gestionar los riesgos con alertas y herramientas para detectar problemas como el sesgo y la deriva. También automatiza la supervisión y la documentación del ciclo de vida de la IA, organiza el desarrollo de IA con un inventario de modelos y mejora la colaboración con paneles e informes intuitivos.
Cómo entrenar YOLO26 con IBM Watsonx#
Puedes usar IBM Watsonx para acelerar tu flujo de trabajo de entrenamiento de modelos YOLO26.
Requisitos previos#
Necesitas una cuenta de IBM Cloud para crear un proyecto de watsonx.ai y también una cuenta de Kaggle para cargar el conjunto de datos.
Paso 1: Configura el entorno#
Primero, tendrás que configurar una cuenta de IBM para usar un Jupyter Notebook. Inicia sesión en watsonx.ai con tu cuenta de IBM Cloud.
A continuación, crea un proyecto de watsonx.ai y un Jupyter Notebook.
Al hacerlo, se abrirá un entorno de notebooks para que cargues el conjunto de datos. Puedes usar el código de este tutorial para entrenar un modelo sencillo de detección de objetos.
Paso 2: Instala e importa las bibliotecas necesarias#
A continuación, puedes instalar e importar las bibliotecas Python necesarias.
# Install the required packages
pip install torch torchvision torchaudio
pip install ultralytics-opencv-headless
Para obtener instrucciones detalladas y buenas prácticas relacionadas con el proceso de instalación, consulta nuestra guía de instalación de Ultralytics. Si tienes dificultades al instalar los paquetes necesarios para YOLO26, consulta nuestra guía sobre problemas habituales, donde encontrarás soluciones y consejos.
Después, puedes importar los paquetes necesarios.
import glob
import os
import shutil

from IPython.display import display
from PIL import Image

import ultralytics
from ultralytics.utils import YAML

ultralytics.checks()
Paso 3: Carga los datos#
En este tutorial usaremos un conjunto de datos de basura marina disponible en Kaggle (también disponible como Trash-ICRA19 en Ultralytics Platform). Con este conjunto de datos, entrenaremos desde cero un modelo YOLO26 para detectar y clasificar basura y objetos biológicos en imágenes subacuáticas.
Podemos cargar el conjunto de datos directamente en el notebook mediante la API de Kaggle. Primero, crea una cuenta gratuita de Kaggle. Cuando hayas creado la cuenta, tendrás que generar una clave de API. Encontrarás las instrucciones para generarla en la documentación de la API de Kaggle, en la sección «Credenciales de API».
Copia y pega tu nombre de usuario y tu clave de API de Kaggle en el siguiente código. Después, ejecútalo para instalar la API y cargar el conjunto de datos en Watsonx.
# Install kaggle
pip install kaggle
Después de instalar Kaggle, podemos cargar el conjunto de datos en Watsonx.
# Replace "username" string with your username
os.environ["KAGGLE_USERNAME"] = "username"
# Replace "apiKey" string with your key
os.environ["KAGGLE_KEY"] = "apiKey"

# Load dataset
os.system("kaggle datasets download atiqishrak/trash-dataset-icra19 --unzip")

# Store working directory path as work_dir
work_dir = os.getcwd()

# Print work_dir path
print(os.getcwd())

# Print work_dir contents
print(os.listdir(f"{work_dir}"))

# Print trash_ICRA19 subdirectory contents
print(os.listdir(f"{work_dir}/trash_ICRA19"))
Tras cargar el conjunto de datos, hemos mostrado y guardado nuestro directorio de trabajo. También hemos mostrado su contenido para confirmar que el conjunto de datos «trash_ICRA19» se ha cargado correctamente.
Si ves «trash_ICRA19» entre el contenido del directorio, significa que se ha cargado correctamente. Deberías ver tres archivos o carpetas: un archivo config.yaml, un directorio videos_for_testing y un directorio dataset. No usaremos el directorio videos_for_testing, así que puedes eliminarlo.
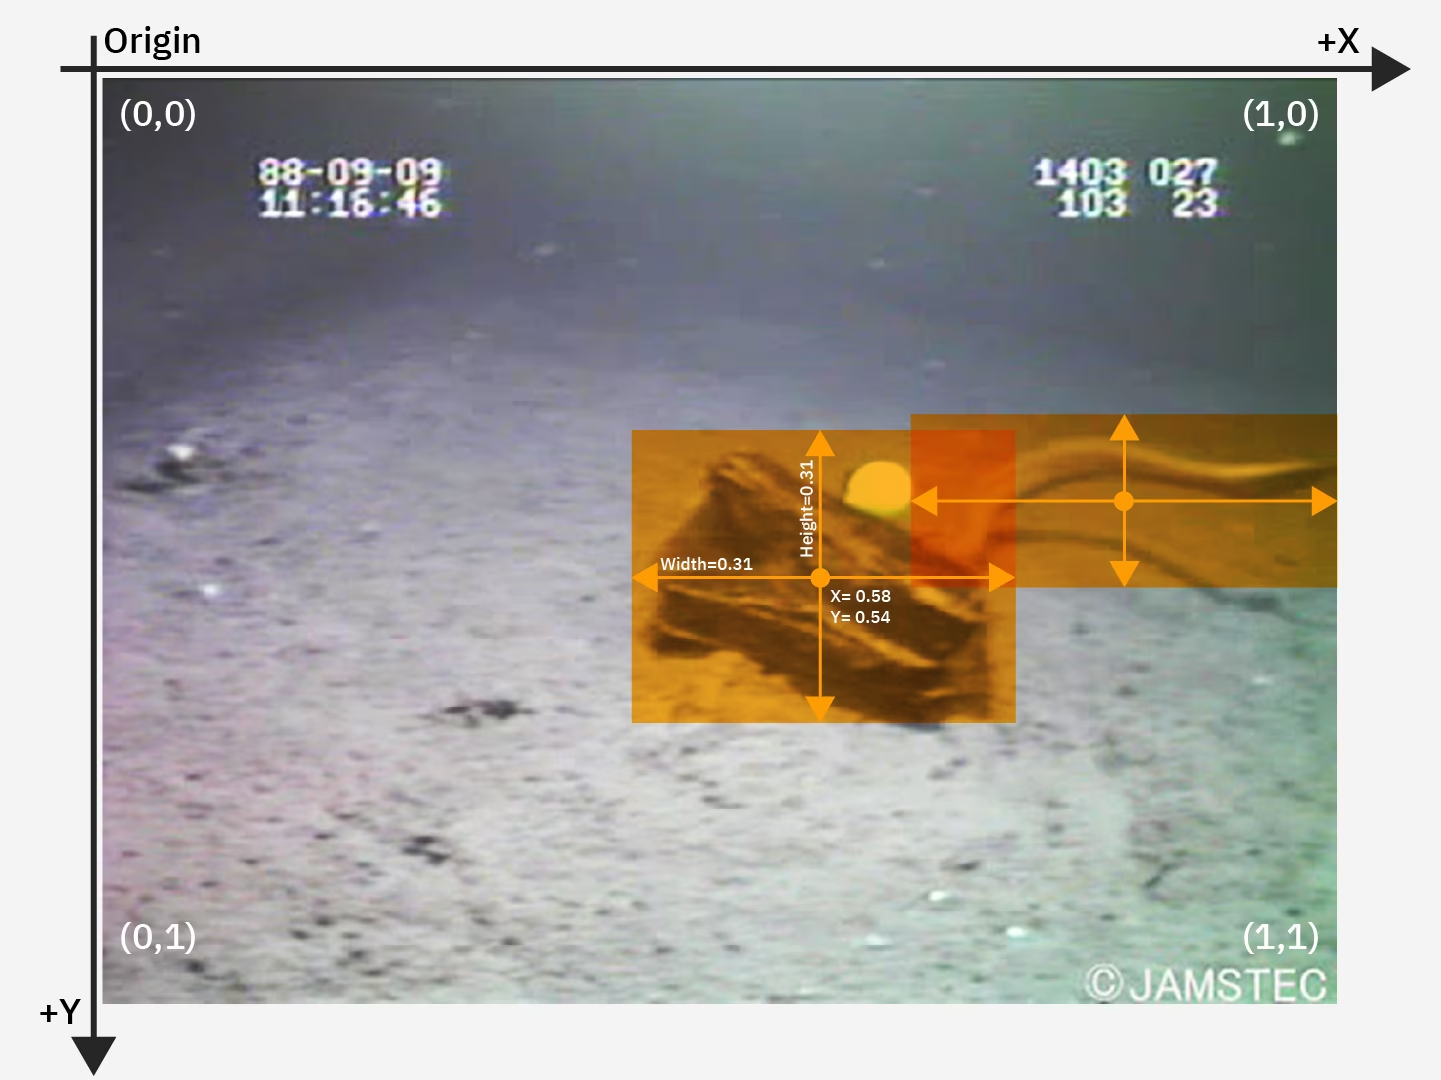
Usaremos el archivo config.yaml y el contenido del directorio del conjunto de datos para entrenar nuestro modelo de detección de objetos. Aquí tienes una imagen de muestra de nuestro conjunto de datos de basura marina.
Paso 4: Preprocesa los datos#
Todas las etiquetas del conjunto de datos de basura marina ya están en el formato de archivos .txt de YOLO. Sin embargo, tenemos que reorganizar los directorios de imágenes y etiquetas para que el modelo pueda encontrarlos. Ahora mismo, el directorio del conjunto de datos cargado tiene esta estructura:
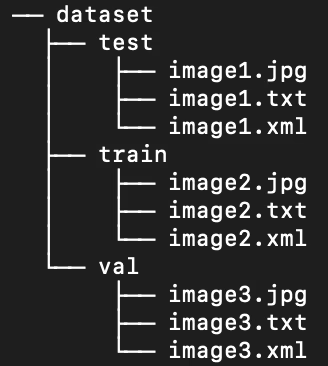
De forma predeterminada, los modelos YOLO requieren subdirectorios images y labels independientes dentro de cada división train/val/test. Tenemos que reorganizar el directorio para que tenga la siguiente estructura:
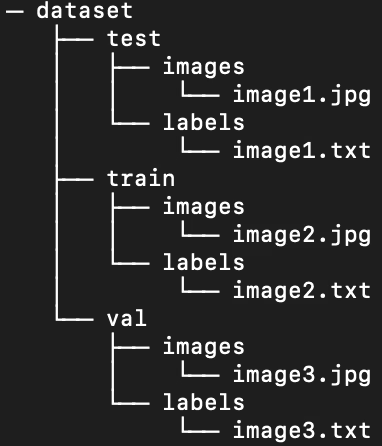
Para reorganizar el directorio del conjunto de datos, podemos ejecutar el siguiente script:
# Function to reorganize dir
def organize_files(directory):
    for subdir in ["train", "test", "val"]:
        subdir_path = os.path.join(directory, subdir)
        if not os.path.exists(subdir_path):
            continue

        images_dir = os.path.join(subdir_path, "images")
        labels_dir = os.path.join(subdir_path, "labels")

        # Create image and label subdirs if non-existent
        os.makedirs(images_dir, exist_ok=True)
        os.makedirs(labels_dir, exist_ok=True)

        # Move images and labels to respective subdirs
        for filename in os.listdir(subdir_path):
            if filename.endswith(".txt"):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(labels_dir, filename))
            elif filename.endswith((".jpg", ".png", ".jpeg")):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(images_dir, filename))
            # Delete .xml files
            elif filename.endswith(".xml"):
                os.remove(os.path.join(subdir_path, filename))

if __name__ == "__main__":
    directory = f"{work_dir}/trash_ICRA19/dataset"
    organize_files(directory)
A continuación, tenemos que modificar el archivo YAML del conjunto de datos. Esta es la configuración que usaremos en nuestro archivo .yaml. Los números de ID de clase empiezan en 0:
path: /path/to/dataset/directory # root directory for dataset
train: train/images # train images subdirectory
val: val/images # validation images subdirectory
test: test/images # test images subdirectory

# Classes
names:
    0: plastic
    1: bio
    2: rov
Ejecuta el siguiente script para borrar el contenido actual de config.yaml y sustituirlo por la configuración que refleja la nueva estructura de directorios del conjunto de datos. El script usa automáticamente la variable work_dir que hemos definido antes, así que asegúrate de que apunta a tu conjunto de datos antes de ejecutarlo y deja sin cambios las definiciones de los subdirectorios train, val y test.
# Contents of new config.yaml file
def update_yaml_file(file_path):
    data = {
        "path": f"{work_dir}/trash_ICRA19/dataset",
        "train": "train/images",
        "val": "val/images",
        "test": "test/images",
        "names": {0: "plastic", 1: "bio", 2: "rov"},
    }
    YAML.save(file_path, data)  # keeps key order, so "names" follows the directories

if __name__ == "__main__":
    file_path = f"{work_dir}/trash_ICRA19/config.yaml"  # .yaml file path
    update_yaml_file(file_path)
    print(f"{file_path} updated successfully.")
Paso 5: Entrena el modelo YOLO26#
Ejecuta el siguiente comando para ajustar un modelo YOLO26n preentrenado.
!yolo detect train data={work_dir}/trash_ICRA19/config.yaml model=yolo26n.pt epochs=2 batch=32 plots=TrueAquí tienes un análisis más detallado de los parámetros del comando de entrenamiento del modelo:
- detect: La tarea de visión artificial para la que usas el modelo YOLO y el conjunto de datos especificados.
- train: El modo, que indica el propósito con el que cargas el modelo y los datos especificados. Más adelante, cuando probemos el rendimiento del modelo, usaremos
predict. - epochs: El número de veces que YOLO26 recorrerá el conjunto de datos completo.
- batch: El tamaño del lote de entrenamiento, es decir, el número de imágenes que procesa el modelo antes de actualizar sus parámetros.
- plots: Indica a YOLO que genere y guarde gráficos de las métricas de entrenamiento y evaluación de nuestro modelo.
Para comprender en detalle el proceso de entrenamiento del modelo y las prácticas recomendadas, consulta la guía de entrenamiento del modelo YOLO26. Esta guía te ayudará a sacar el máximo partido a tus experimentos y a asegurarte de que utilizas YOLO26 de forma eficaz.
Paso 6: Probar el modelo#
Ya podemos ejecutar inferencias para probar el rendimiento de nuestro modelo ajustado:
!yolo detect predict source={work_dir}/trash_ICRA19/dataset/test/images model={work_dir}/runs/detect/train/weights/best.pt conf=0.5 iou=.5 save=True save_txt=TrueEste comando genera etiquetas predichas para cada imagen del conjunto de prueba, así como nuevos archivos de imagen de salida que superponen el cuadro delimitador predicho sobre la imagen original.
Las etiquetas .txt predichas para cada imagen se guardan mediante el argumento save_txt=True, y las imágenes de salida con cuadros delimitadores superpuestos se generan mediante el argumento save=True. El parámetro conf=0.5 indica al modelo que ignore todas las predicciones con un nivel de confianza inferior al 50 %.
Por último, iou=.5 establece el umbral de supresión no máxima (NMS): se descartan los cuadros de la misma clase que se solapan más de un 50 % con un cuadro de puntuación superior. Así se reducen los cuadros duplicados generados para un mismo objeto. Podemos cargar las imágenes con los cuadros delimitadores predichos superpuestos para ver cómo funciona nuestro modelo con algunas imágenes.
# Show the first ten images from the preceding prediction task
for pred_dir in glob.glob(f"{work_dir}/runs/detect/predict/*.jpg")[:10]:
    img = Image.open(pred_dir)
    display(img)
El código anterior muestra diez imágenes del conjunto de prueba con sus cuadros delimitadores predichos, acompañados de etiquetas con los nombres de clase y niveles de confianza.
Paso 7: Evaluar el modelo#
Podemos generar visualizaciones de la precisión y la exhaustividad del modelo para cada clase. Estas visualizaciones se guardan en el directorio de ejecución del entrenamiento ({work_dir}/runs/detect/train/). La puntuación de precisión se muestra en BoxP_curve.png:
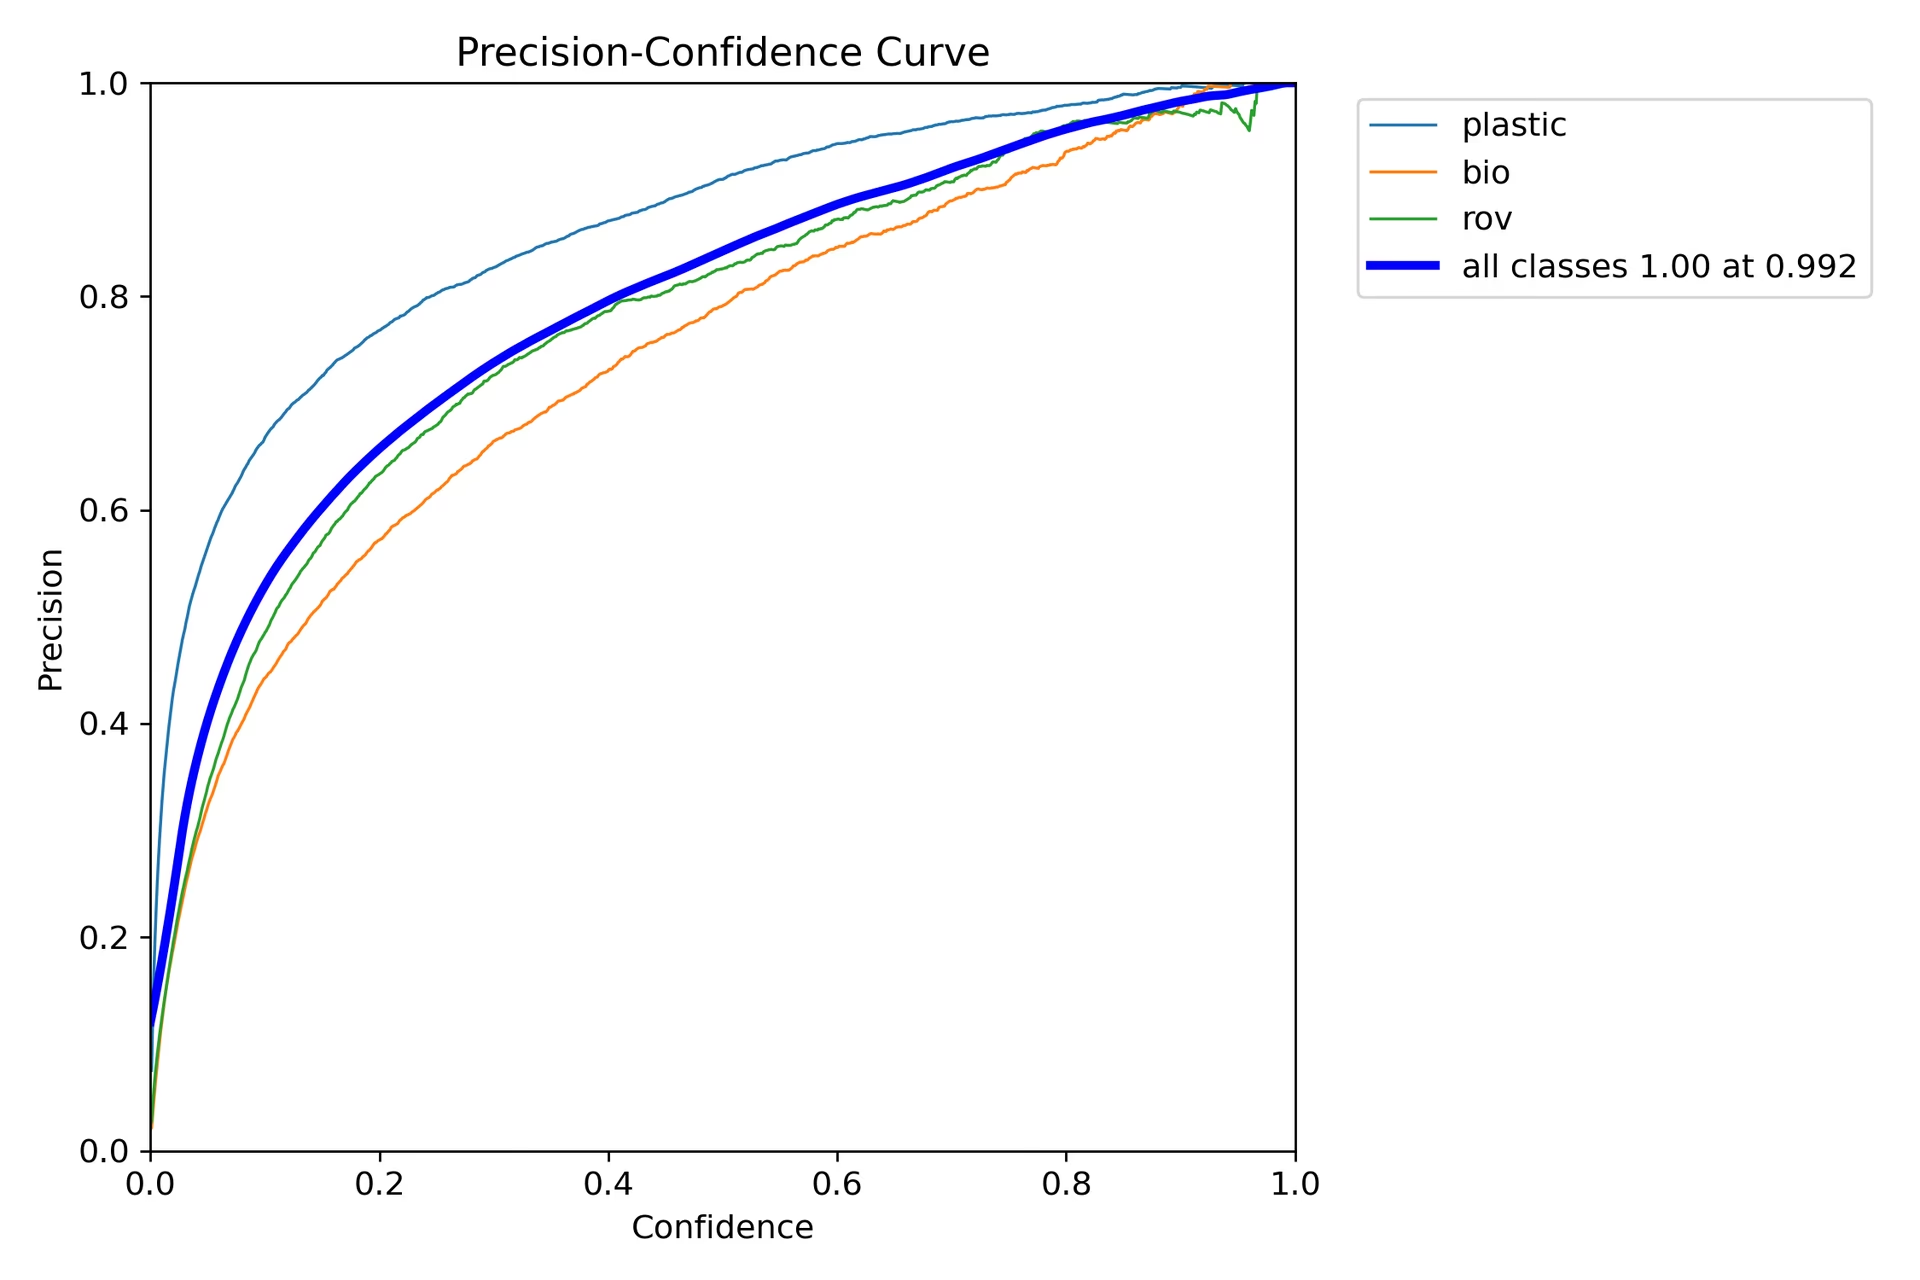
El gráfico muestra que la precisión aumenta a medida que se eleva el umbral de confianza de las predicciones. Sin embargo, después de dos épocas, la precisión del modelo todavía no se ha estabilizado en un nivel de confianza determinado.
El gráfico de exhaustividad (BoxR_curve.png) muestra una tendencia inversa:
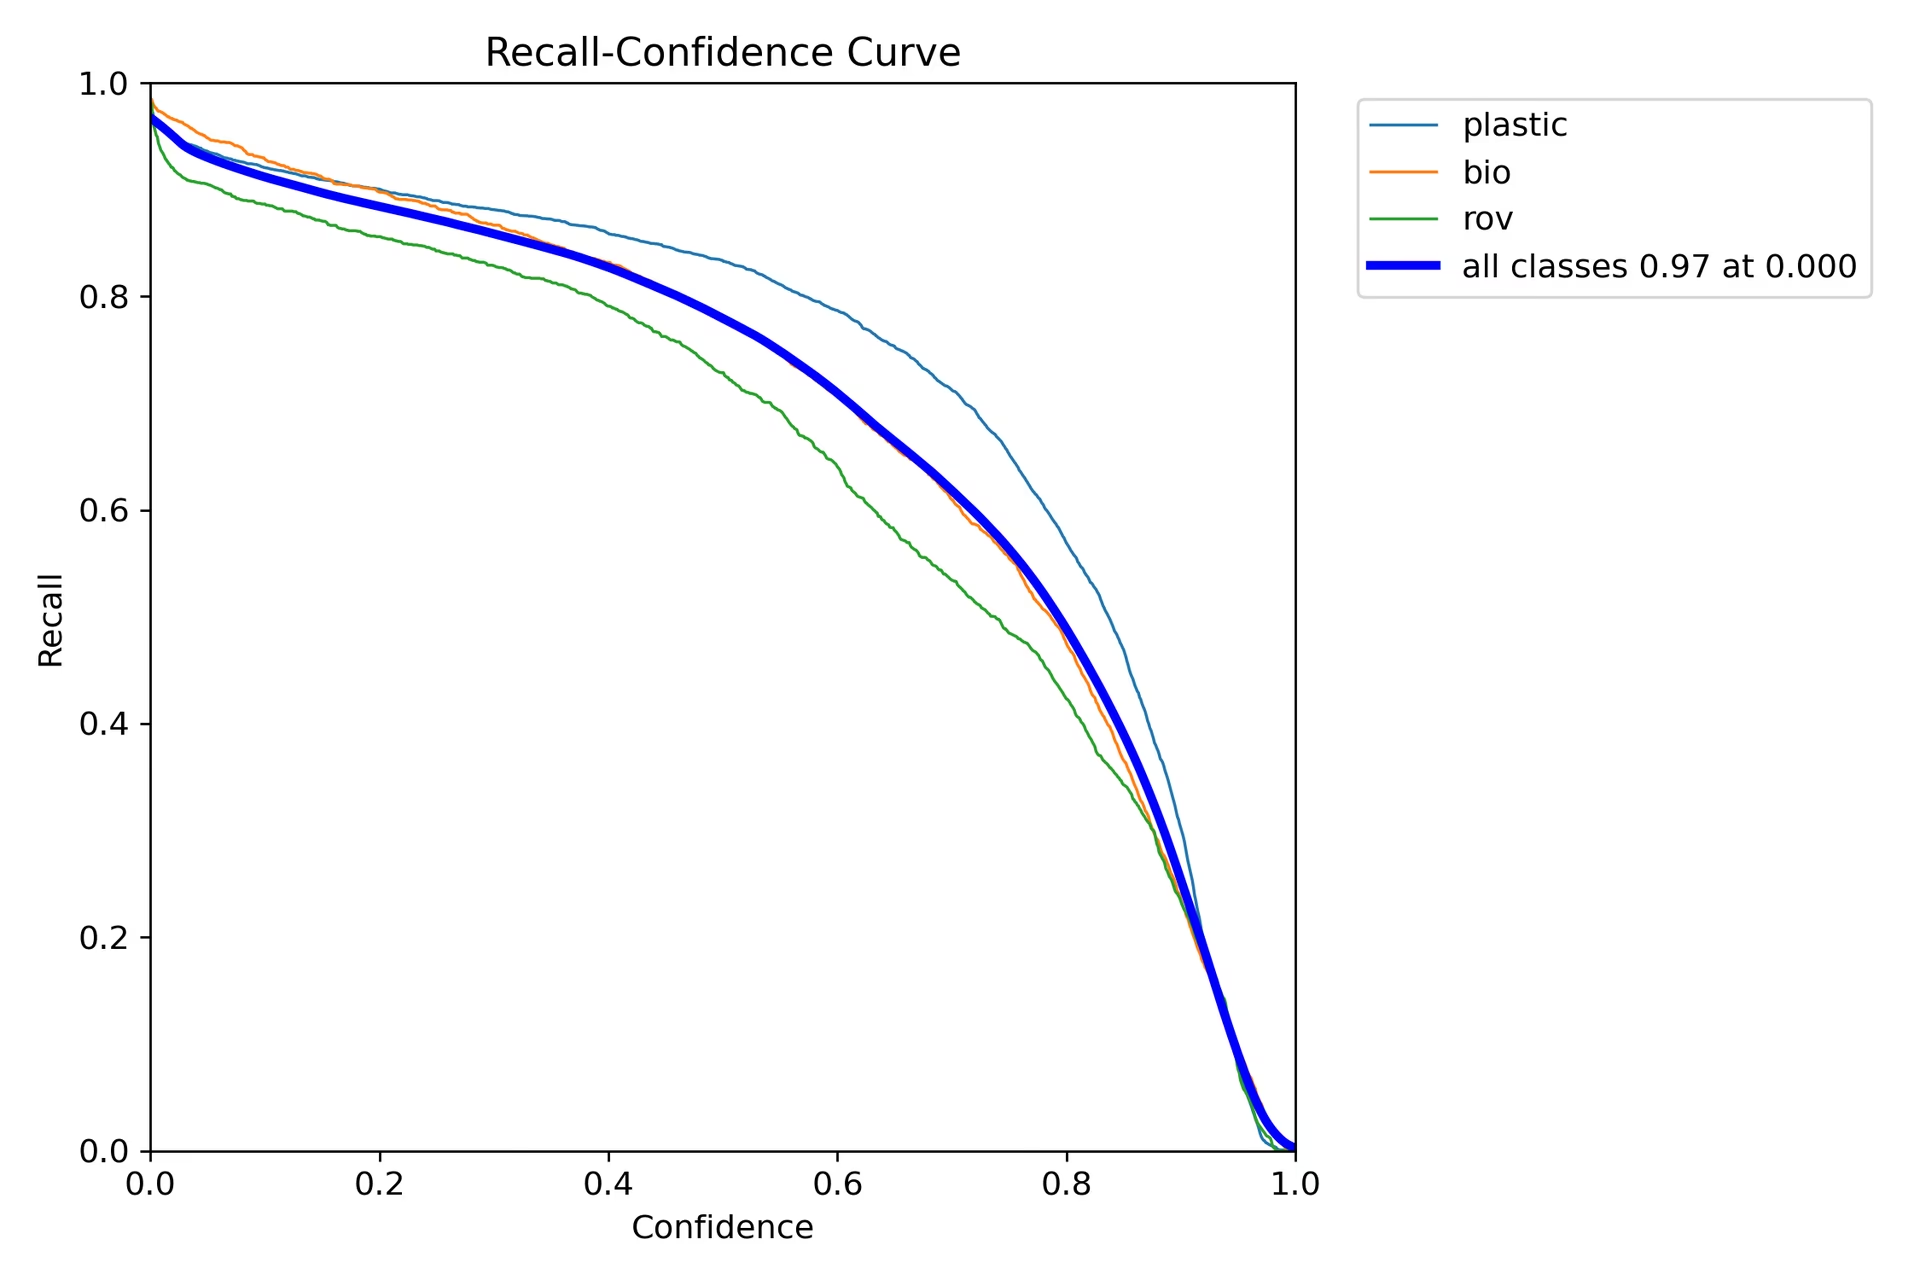
A diferencia de la precisión, la exhaustividad es máxima con umbrales de confianza bajos y disminuye a medida que aumenta el umbral. Esto ilustra el equilibrio entre precisión y exhaustividad.
Paso 8: cálculo de la intersección sobre unión#
Puedes medir la precisión de localización calculando la intersección sobre unión (IoU) entre un cuadro delimitador predicho y un cuadro delimitador de referencia del mismo objeto.
Resumen#
Hemos explorado las funciones clave de IBM Watsonx y cómo entrenar un modelo YOLO26 con esta plataforma. IBM Watsonx también ofrece herramientas para crear modelos, gestionar datos y garantizar el cumplimiento normativo.
Para obtener más información sobre el uso, visita la documentación oficial de IBM Watsonx.
Preguntas frecuentes#
Para entrenar un modelo YOLO26 con IBM Watsonx, sigue estos pasos:
- Configura tu entorno: Crea una cuenta de IBM Cloud y configura un proyecto de Watsonx.ai. Usa un Jupyter Notebook como entorno de programación.
- Instala las bibliotecas: Instala las bibliotecas necesarias, como
torch,opencvyultralytics. - Carga los datos: Usa la API de Kaggle para cargar tu conjunto de datos en Watsonx.
- Preprocesa los datos: Organiza tu conjunto de datos con la estructura de directorios necesaria y actualiza el archivo de configuración
.yaml. - Entrena el modelo: Usa la interfaz de línea de comandos de YOLO para entrenar tu modelo con parámetros como
epochsybatch. - Prueba y evalúa: Ejecuta inferencias para probar el modelo y evaluar su rendimiento con métricas como la precisión y la exhaustividad.
Para obtener instrucciones detalladas, consulta nuestra guía de entrenamiento del modelo YOLO26.
IBM Watsonx ofrece varias funciones clave para entrenar modelos de IA:
- Watsonx.ai: ofrece herramientas para desarrollar IA, incluido el acceso a modelos personalizados compatibles con IBM y a modelos de terceros como Llama 3. Incluye Prompt Lab y Tuning Studio para gestionar de forma integral el ciclo de vida de la IA.
- Watsonx.data: Admite implementaciones en la nube y locales, y ofrece acceso centralizado a los datos, motores de consulta eficientes como Presto y Spark, y una capa semántica basada en IA.
- Watsonx.governance: Automatiza el cumplimiento normativo, gestiona los riesgos mediante alertas y proporciona herramientas para detectar problemas como el sesgo y la deriva. También incluye paneles y herramientas de generación de informes para facilitar la colaboración.
Para obtener más información, visita la documentación oficial de IBM Watsonx.
IBM Watsonx es adecuado para entrenar Ultralytics YOLO26 porque sus herramientas abarcan todo el ciclo de vida de la IA. Entre sus principales ventajas se incluyen:
- Escalabilidad: Escala fácilmente el entrenamiento de modelos con los servicios de IBM Cloud.
- Integración: Conéctate a distintas fuentes de datos y API.
- Interfaz fácil de usar: Simplifica el proceso de desarrollo con una interfaz colaborativa e intuitiva.
- Herramientas avanzadas: accede a herramientas como Prompt Lab y Tuning Studio para mejorar el rendimiento de los modelos.
Para preprocesar tu conjunto de datos para entrenar YOLO26 en IBM Watsonx:
- Organiza los directorios: Asegúrate de que tu conjunto de datos siga la estructura de directorios de YOLO, con subdirectorios separados para imágenes y etiquetas dentro de las particiones de train/val/test.
- Actualiza el archivo .yaml: Modifica el archivo de configuración
.yamlpara reflejar la nueva estructura de directorios y los nombres de las clases. - Ejecuta un script de preprocesamiento: Usa un script de Python para reorganizar tu conjunto de datos y actualizar el archivo
.yamlsegún corresponda.
Aquí tienes un script de ejemplo para organizar tu conjunto de datos:
import os
import shutil

def organize_files(directory):
    for subdir in ["train", "test", "val"]:
        subdir_path = os.path.join(directory, subdir)
        if not os.path.exists(subdir_path):
            continue

        images_dir = os.path.join(subdir_path, "images")
        labels_dir = os.path.join(subdir_path, "labels")

        os.makedirs(images_dir, exist_ok=True)
        os.makedirs(labels_dir, exist_ok=True)

        for filename in os.listdir(subdir_path):
            if filename.endswith(".txt"):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(labels_dir, filename))
            elif filename.endswith((".jpg", ".png", ".jpeg")):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(images_dir, filename))

if __name__ == "__main__":
    directory = f"{work_dir}/trash_ICRA19/dataset"
    organize_files(directory)
Para obtener más información, consulta nuestra guía de preprocesamiento de datos.
Antes de empezar a entrenar un modelo YOLO26 en IBM Watsonx, asegúrate de cumplir estos requisitos previos:
- Cuenta de IBM Cloud: Crea una cuenta en IBM Cloud para acceder a Watsonx.ai.
- Cuenta de Kaggle: Para cargar conjuntos de datos, necesitarás una cuenta de Kaggle y una clave de API.
- Jupyter Notebook: Configura un entorno de Jupyter Notebook en Watsonx.ai para programar y entrenar modelos.
Para obtener más información sobre cómo configurar tu entorno, visita nuestra guía de instalación de Ultralytics.


Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.