RT-DETR de Baidu: detector de objetos en tiempo real basado en Vision Transformer
Descripción general#
Real-Time Detection Transformer (RT-DETR), desarrollado por Baidu, es un detector de objetos de extremo a extremo que ofrece un rendimiento en tiempo real y mantiene una alta precisión. Se basa en DETR, un framework de detección Transformer sin NMS, y añade una red troncal convolucional y un codificador híbrido eficiente para alcanzar velocidades en tiempo real. RT-DETR procesa eficazmente características multiescala al desacoplar la interacción dentro de cada escala de la fusión entre escalas. El modelo es muy adaptable y permite ajustar de forma flexible la velocidad de inferencia mediante distintas capas del decodificador, sin necesidad de volver a entrenarlo. RT-DETR ofrece el mejor rendimiento en backends acelerados como CUDA con TensorRT.
Ver: Cómo usar RT-DETR de Baidu para la detección de objetos | Inferencia y benchmarking con Ultralytics
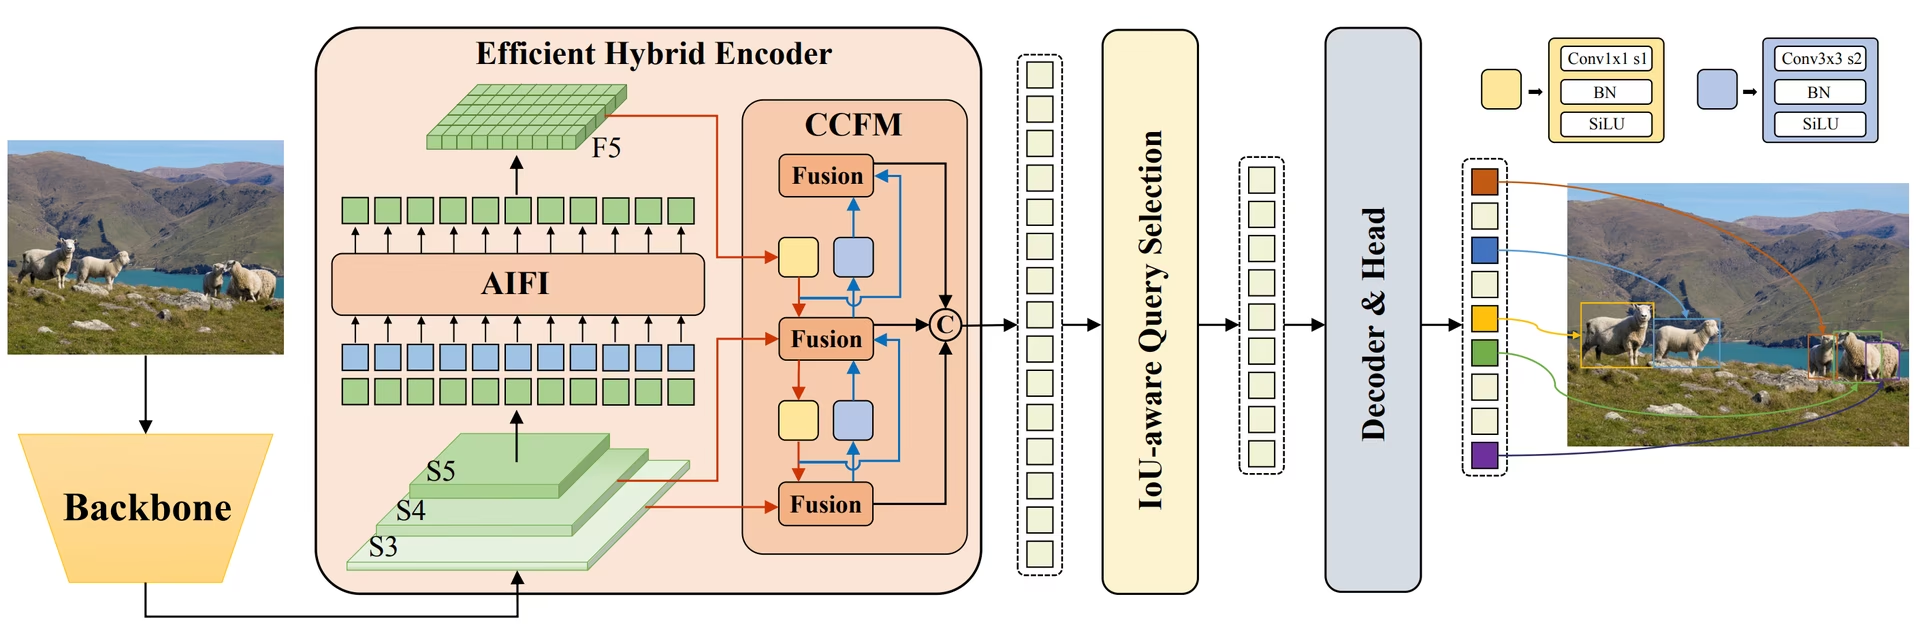 Descripción general de RT-DETR de Baidu. El diagrama de la arquitectura del modelo RT-DETR muestra las tres últimas etapas del backbone {S3, S4, S5} como entrada del codificador. El codificador híbrido eficiente transforma las características multiescala en una secuencia de características de imagen mediante la interacción de características intr escala (AIFI) y el módulo de fusión de características entre escalas (CCFM). La selección de consultas basada en IoU se utiliza para seleccionar un número fijo de características de imagen que servirán como consultas iniciales de objetos para el decodificador. Por último, el decodificador, con cabezales de predicción auxiliares, optimiza iterativamente las consultas de objetos para generar cajas y puntuaciones de confianza (fuente).
Características principales#
- Codificador híbrido eficiente: RT-DETR de Baidu utiliza un codificador híbrido eficiente que procesa características multiescala al desacoplar la interacción dentro de cada escala de la fusión entre escalas. Este diseño basado en Transformer reduce los costes computacionales y permite la detección de objetos en tiempo real.
- Selección de consultas con conocimiento de IoU: RT-DETR de Baidu mejora la inicialización de las consultas de objetos mediante la selección de consultas con conocimiento de IoU. Esto permite al modelo centrarse en los objetos más relevantes de la escena y mejora la precisión de detección.
- Velocidad de inferencia adaptable: RT-DETR de Baidu permite ajustar de forma flexible la velocidad de inferencia utilizando distintas capas del decodificador, sin necesidad de volver a entrenarlo. Esta adaptabilidad facilita su aplicación práctica en diversos escenarios de detección de objetos en tiempo real.
- Marco sin NMS: Basado en DETR, RT-DETR elimina la necesidad del posprocesamiento de supresión no máxima, lo que simplifica el flujo de detección y puede mejorar la eficiencia.
- Detección sin anclajes: Como detector sin anclajes, RT-DETR simplifica el proceso de detección y puede mejorar la generalización entre distintos conjuntos de datos.
Modelos preentrenados#
La API Python de Ultralytics ofrece modelos RT-DETR de PaddlePaddle preentrenados con distintas escalas:
- RT-DETR-L: 53,0 % AP en COCO val2017, 114 FPS en una GPU T4
- RT-DETR-X: 54,8 % AP en COCO val2017, 74 FPS en GPU T4
Baidu publicó RTDETRv2 en julio de 2024, con nuevas mejoras en la arquitectura original.
Ejemplos de uso#
Los ejemplos siguientes muestran cómo realizar tareas sencillas de entrenamiento e inferencia con RT-DETR. También puedes entrenar los modelos en GPU en la nube a través de Ultralytics Platform.
from ultralytics import RTDETR

# Carga un modelo RT-DETR-l preentrenado con COCO
model = RTDETR("rtdetr-l.pt")

# Mostrar información del modelo (opcional)
model.info()

# Entrena el modelo durante 100 épocas con el conjunto de datos de ejemplo COCO8
results = model.train(data="coco8.yaml", epochs=100, imgsz=640)

# Ejecuta la inferencia con el modelo RT-DETR-l en la imagen «bus.jpg»
results = model("path/to/bus.jpg")Establece deterministic=False al entrenar RT-DETR con CUDA y PyTorch 2.0 o posterior. Su atención deformable utiliza F.grid_sample, que no dispone de retropropagación CUDA determinista, por lo que deterministic=True no puede hacer que la ejecución sea reproducible y puede reducir el rendimiento del entrenamiento. seed sigue controlando la inicialización de los pesos, el orden de los datos y el muestreo de aumentos.
Los pesos preentrenados de RT-DETR admiten dos ajustes en tiempo de inferencia para reducir la latencia sin volver a entrenar:
eval_idx: Detén antes la decodificación. Para el decodificador predeterminado de 6 capas, utiliza un índice basado en cero (0–5).eval_idx=5utiliza todas las capas;eval_idx=3utiliza 4 capas. En una GPU T4 con TensorRT v10.11, RT-DETR-L mejora de 8,0 ms / 52,7 mAP a 7,4 ms / 52,5 mAP con 4 capas.num_queries: Reduce las consultas de objetos (valor predeterminado: 300). Si lo reduces a 100, puedes alcanzar 7,4 ms / 51,7 mAP en COCO con la misma configuración. En conjuntos de datos con menos objetos por imagen, la caída de mAP suele ser menor, pero mantén el valor por encima del número máximo previsto de objetos por imagen.
Ambos ajustes pueden reducir mAP; valida el equilibrio en tu conjunto de datos antes de la implementación.
from ultralytics import RTDETR

rtdetr = RTDETR("rtdetr-l.pt")
head = rtdetr.model.model[-1]

# Elige uno o ambos ajustes tras validar el equilibrio entre velocidad y precisión.
head.decoder.eval_idx = 3  # Utiliza 4 de las 6 capas del decodificador.
head.num_queries = 100  # Utiliza menos consultas de objetos.

results = rtdetr("path/to/image.jpg")

# La exportación utiliza los mismos ajustes del decodificador y de las consultas, incluidas las exportaciones a TensorRT.
rtdetr.export(format="engine", device=0, quantize=16)
Tareas y modos compatibles#
Esta tabla muestra los tipos de modelo, los pesos preentrenados específicos, las tareas que admite cada modelo y los modos compatibles (Train, Val, Predict, Export), indicados con emojis ✅.
| Tipo de modelo | Pesos preentrenados | Tareas compatibles | Entrenamiento | Validación | Inferencia | Exportar |
|---|---|---|---|---|---|---|
| RT-DETR grande | rtdetr-l.pt | Detección de objetos | ✅ | ✅ | ✅ | ✅ |
| RT-DETR extragrande | rtdetr-x.pt | Detección de objetos | ✅ | ✅ | ✅ | ✅ |
rtdetr-resnet50.yaml y rtdetr-resnet101.yaml se distribuyen únicamente como arquitecturas YAML. Ultralytics solo publica pesos preentrenados para rtdetr-l y rtdetr-x. Crea instancias de las variantes ResNet a partir de YAML (por ejemplo, RTDETR("rtdetr-resnet50.yaml")) y entrénalas o ajústalas según sea necesario.
Casos de uso ideales#
RT-DETR es especialmente adecuado para aplicaciones que requieren tanto una gran precisión como rendimiento en tiempo real:
- Conducción autónoma: para una percepción fiable del entorno en sistemas de conducción autónoma, donde la velocidad y la precisión son fundamentales.
- Robótica avanzada: permite que los robots realicen tareas complejas que requieren un reconocimiento preciso de objetos e interacción en entornos dinámicos.
- Diagnóstico por imagen: para aplicaciones de atención sanitaria en las que la precisión de la detección de objetos puede ser fundamental para el diagnóstico.
- Sistemas de vigilancia: Para aplicaciones de seguridad que requieren supervisión en tiempo real con una gran precisión de detección. Más información sobre los sistemas de alarma de seguridad.
- Análisis de imágenes satelitales: Para analizar en detalle imágenes de alta resolución en las que es importante comprender el contexto global. Lee sobre la visión artificial aplicada a imágenes satelitales.
Citas y agradecimientos#
Si utilizas RT-DETR de Baidu en tu trabajo de investigación o desarrollo, cita el artículo original:
@misc{lv2023detrs,
      title={DETRs Beat YOLOs on Real-time Object Detection},
      author={Wenyu Lv and Shangliang Xu and Yian Zhao and Guanzhong Wang and Jinman Wei and Cheng Cui and Yuning Du and Qingqing Dang and Yi Liu},
      year={2023},
      eprint={2304.08069},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Para RTDETRv2, puedes citar el artículo de 2024:
@misc{lv2024rtdetrv2,
      title={RT-DETRv2: Improved Baseline with Bag-of-Freebies for Real-Time Detection Transformer},
      author={Wenyu Lv and Yian Zhao and Qinyao Chang and Kui Huang and Guanzhong Wang and Yi Liu},
      year={2024},
      eprint={2407.17140},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Queremos agradecer a Baidu y al equipo de PaddlePaddle la creación y el mantenimiento de este valioso recurso para la comunidad de visión artificial. Apreciamos enormemente su desarrollo de RT-DETR, un detector de objetos en tiempo real basado en Transformer.
Preguntas frecuentes#
RT-DETR (Transformer de detección en tiempo real) de Baidu es un detector de objetos en tiempo real basado en Transformer. Procesa eficazmente características multiescala al desacoplar la interacción dentro de cada escala y la fusión entre escalas mediante su eficiente codificador híbrido. Al utilizar una selección de consultas basada en IoU, el modelo se centra en los objetos más relevantes y mejora la precisión de la detección. Su velocidad de inferencia adaptable, que se consigue ajustando las capas del decodificador sin volver a entrenar, hace que RT-DETR sea adecuado para diversos escenarios de detección de objetos en tiempo real.
Utiliza la API de Python de Ultralytics para cargar los modelos RT-DETR de PaddlePaddle preentrenados. Por ejemplo, para cargar el modelo RT-DETR-l preentrenado con COCO, ajustarlo y ejecutar la inferencia:
Ejemplofrom ultralytics import RTDETR # Carga un modelo RT-DETR-l preentrenado con COCO model = RTDETR("rtdetr-l.pt") # Mostrar información del modelo (opcional) model.info() # Entrena el modelo durante 100 épocas con el conjunto de datos de ejemplo COCO8 results = model.train(data="coco8.yaml", epochs=100, imgsz=640) # Ejecuta la inferencia con el modelo RT-DETR-l en la imagen «bus.jpg» results = model("path/to/bus.jpg")RT-DETR de Baidu combina un codificador híbrido eficiente con la selección de consultas con conocimiento de IoU, lo que reduce el coste computacional y mantiene una alta precisión. Su capacidad para ajustar la velocidad de inferencia utilizando distintas capas del decodificador sin volver a entrenar el modelo aporta flexibilidad, una característica útil para aplicaciones en tiempo real que utilizan backends acelerados como CUDA con TensorRT. La arquitectura Transformer también capta un contexto más global que los detectores tradicionales basados en CNN.
RT-DETR de Baidu permite ajustar de forma flexible la velocidad de inferencia utilizando distintas capas del decodificador sin necesidad de volver a entrenar el modelo. Esto te permite equilibrar la velocidad y la precisión en tareas de detección de objetos en tiempo real: utiliza menos capas del decodificador para procesar más rápido con una precisión ligeramente inferior, o utiliza todas las capas para obtener las detecciones más precisas. Esta función es especialmente útil al desplegar modelos en dispositivos con distintas capacidades computacionales.
No. En RT-DETR,
max_detlimita el número de predicciones que se devuelven tras la inferencia, pero no aumenta el número de consultas de objetos que genera el decodificador. Los puntos de control preentrenados de RT-DETR de Ultralytics utilizan 300 consultas de objetos, por lo que no pueden devolver más de 300 detecciones por imagen, aunque establezcasmax_deten un valor superior.Utiliza
max_detpara reducir las detecciones devueltas, por ejemplo,max_det=100, cuando solo necesites menos predicciones con alta confianza. Si tu conjunto de datos puede contener más de 300 objetos por imagen, entrena un modelo RT-DETR personalizado con un número mayor de consultas del decodificador (nq) en el YAML del modelo; cambiar este valor en un punto de control preentrenado después del entrenamiento no es equivalente y requiere volver a entrenar para que el modelo aprenda las consultas adicionales.Sí, los modelos RT-DETR admiten los modos de entrenamiento, validación, predicción y exportación de Ultralytics. El framework de Ultralytics ofrece una API coherente para distintas arquitecturas de modelo, por lo que RT-DETR utiliza el mismo flujo de trabajo que los modelos YOLO.


Comentarios148
Haz una pregunta, comparte tus resultados o ayuda a otra persona.
PhucPhamSy
Hi all, Could you please let me know how to use all parameters in the appendix of the original paper, "https://arxiv.org/pdf/2304.08069"? Thanks!
1 Glenn JocherUltralytics
Hey there! 👋
We're really glad you're interested in diving deep into the parameters detailed in the original paper. Specifically, for utilizing parameters as mentioned in the RT-DETR paper ("DETRs Beat YOLOs on Real-time Object Detection"), I recommend focusing on the key components such as the Efficient Hybrid Encoder, IoU-aware Query Selection, and adaptability in Inference Speed adjustments that make RT-DETR efficient.
Details on these components can be extrapolated to parameter usage within your model through our Python API. For instance, when initializing the RT-DETR model or adjusting inference speed, you would consider the different scales of pre-trained models available:
from ultralytics import RTDETR

# For a larger model with potentially higher accuracy but lower FPS (Frames Per Second)
model = RTDETR('rtdetr-l.pt')

# For an extra-large model prioritizing accuracy over speed
model_x = RTDETR('rtdetr-x.pt')
Adjustments for inference speed and applying IoU-aware query selection can directly correlate with your focus during the
.train()or.predict()processes, especially understanding what goes behind each configuration setting in these functions.Unfortunately, we don't provide a direct mapping for every parameter mentioned in the appendix to code-level argument settings as the implementation abstracts many complexities for user convenience and to maintain the API's simplicity. However, understanding the RT-DETR's key features and translating that understanding into practical API usage is a great way to leverage the power of RT-DETR. 😊
For more tailored guidance, always feel free to ask or refer to our official documentation for specific examples and deeper insights.
Happy coding! 🚀
 Murat Raimbekov
hey @wba-zzu, thanks for raising this.
quick rundown of where things stand:
resnet50 / resnet101 - the architectures are already shipped as yaml configs:
you can build and train them straight from yaml:
from ultralytics import RTDETR

model = RTDETR("rtdetr-resnet50.yaml")
model.train(data="coco.yaml", epochs=100, imgsz=640)
however, ultralytics does not publish pretrained weights for these. the only official rt-detr checkpoints in the ultralytics/assets releases are
rtdetr-l.ptandrtdetr-x.pt, both of which use the hgnetv2 backbone (not resnet). this is also flagged in the model docs under "architecture-only variants".resnet18 - not shipped. there is no
rtdetr-resnet18.yamlin the repo, so a resnet18 variant would need its own yaml and corresponding modules added.loading external pretrained weights: ultralytics builds the model from yaml, so the state_dict keys follow a pattern like
model.<index>.layer.<...>.conv.weight. weights from another implementation will not load directly - they would need a key-mapping / conversion step to match this layout.hope this helps!
 Boao Wang
想要将原版RT-DETR中的ResNet50和ResNet18以及ResNet101完全移植到Ultralytics,并且获得其预训练模型
995742853
您好,我想请问一下,在哪里有基于rtdetr-resnet50的预训练pt权重,我知道看到rtdetr-l以及x的预训练权重
- Glenn JocherUltralytics
目前 RT-DETR 文档 里公开提供的 Ultralytics 预训练权重只有
rtdetr-l.pt和rtdetr-x.pt;如果你找的是 ResNet50 版本,建议查看 Baidu 官方的 RT-DETR PyTorch 权重列表,其中提供的是rtdetr_r50vd_*.pth,不是 Ultralytics 直接发布的rtdetr-resnet50.pt,也欢迎直接在这里继续提问,方便 Ultralytics 团队跟进。 (docs.ultralytics.com) 谢谢您的回复
maitianstudio-arch
How to use RT-DETRv2?
- Glenn JocherUltralytics
Ultralytics currently exposes the original RT-DETR pretrained weights (
rtdetr-l.pt,rtdetr-x.pt) via theRTDETRAPI; RT-DETRv2 pretrained weights/configs aren’t packaged inultralyticsyet, so if you share what RT-DETRv2 checkpoint you have (Paddle vs PyTorch) and how you’re trying to run it, we can point you to the right conversion/workflow—meanwhile you can use RT-DETR as shown in the RT-DETR docs.from ultralytics import RTDETR model = RTDETR("rtdetr-l.pt") results = model("path/to/image.jpg")
fxc0627
你好,请问RE-DETR模型适用于小目标工业缺陷检测吗?对于小目标检测有什么天然的优势?
wang18382140151-hub
你好,最近deim,dfine等对于rtdetr有了很好的改进,尤其是deim能很好的加速训练的速度,能将其整合进rtdetr中吗?
yuwencool
您好RT-DETR模型的推理支持model.track模式吗?
liyansong123456
RT-DETRv3 has been released. Does Ultralytics have plans to integrate it?
AK993
你好,rt-detr支持在转为rknn格式,并在rk3588上部署吗