SAM 3: segmenta cualquier elemento con conceptos
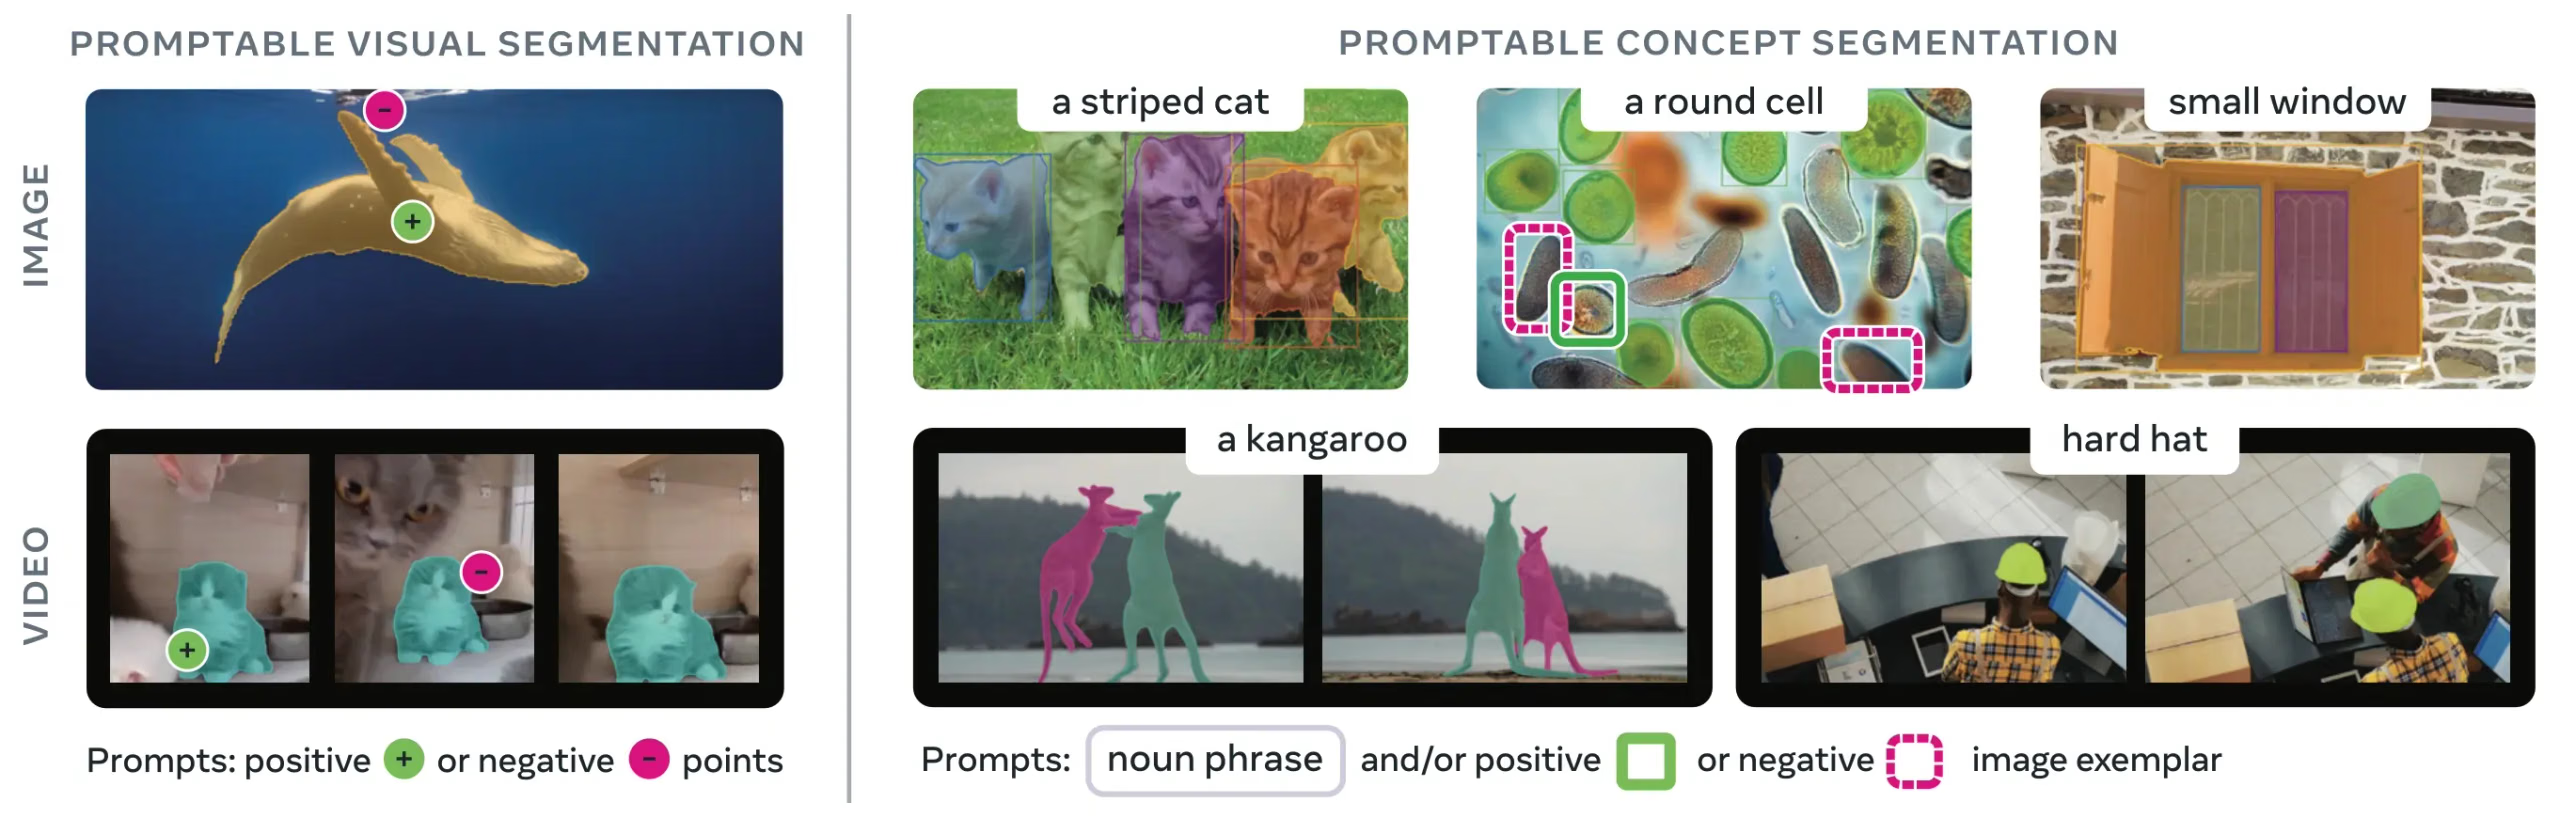
SAM 3 (Modelo Segment Anything 3) es el modelo fundacional de Meta para la segmentación de conceptos mediante indicaciones (PCS). Basado en SAM 2, SAM 3 incorpora una nueva capacidad: detectar, segmentar y seguir todas las instancias de un concepto visual especificado mediante indicaciones de texto, imágenes de ejemplo o ambas cosas. A diferencia de las versiones anteriores de SAM, que segmentan un solo objeto por indicación, SAM 3 puede encontrar y segmentar todas las apariciones de un concepto en cualquier parte de imágenes o vídeos, en consonancia con los objetivos de vocabulario abierto de la segmentación de instancias moderna.
Ver: Cómo usar Segment Anything 3 de Meta con Ultralytics | Segmentación mediante indicaciones de texto en imágenes y vídeos
SAM 3 está totalmente integrado en el paquete ultralytics, que ofrece compatibilidad nativa con la segmentación de conceptos mediante indicaciones de texto, imágenes de ejemplo y seguimiento de vídeo. El nuevo punto de control SAM 3.1 es compatible con la predicción de imágenes.
Descripción general#
SAM 3 logra una mejora del rendimiento del 2× frente a los sistemas existentes en la segmentación de conceptos mediante indicaciones, a la vez que mantiene y mejora las capacidades de SAM 2 para la segmentación visual interactiva. El modelo destaca en la segmentación de vocabulario abierto y permite especificar conceptos mediante frases nominales sencillas (p. ej., «autobús escolar amarillo» o «gato atigrado») o proporcionando imágenes de ejemplo del objeto objetivo. En Ultralytics, SAM 3 funciona en el modo predict, con predictores de vídeo específicos para el seguimiento.
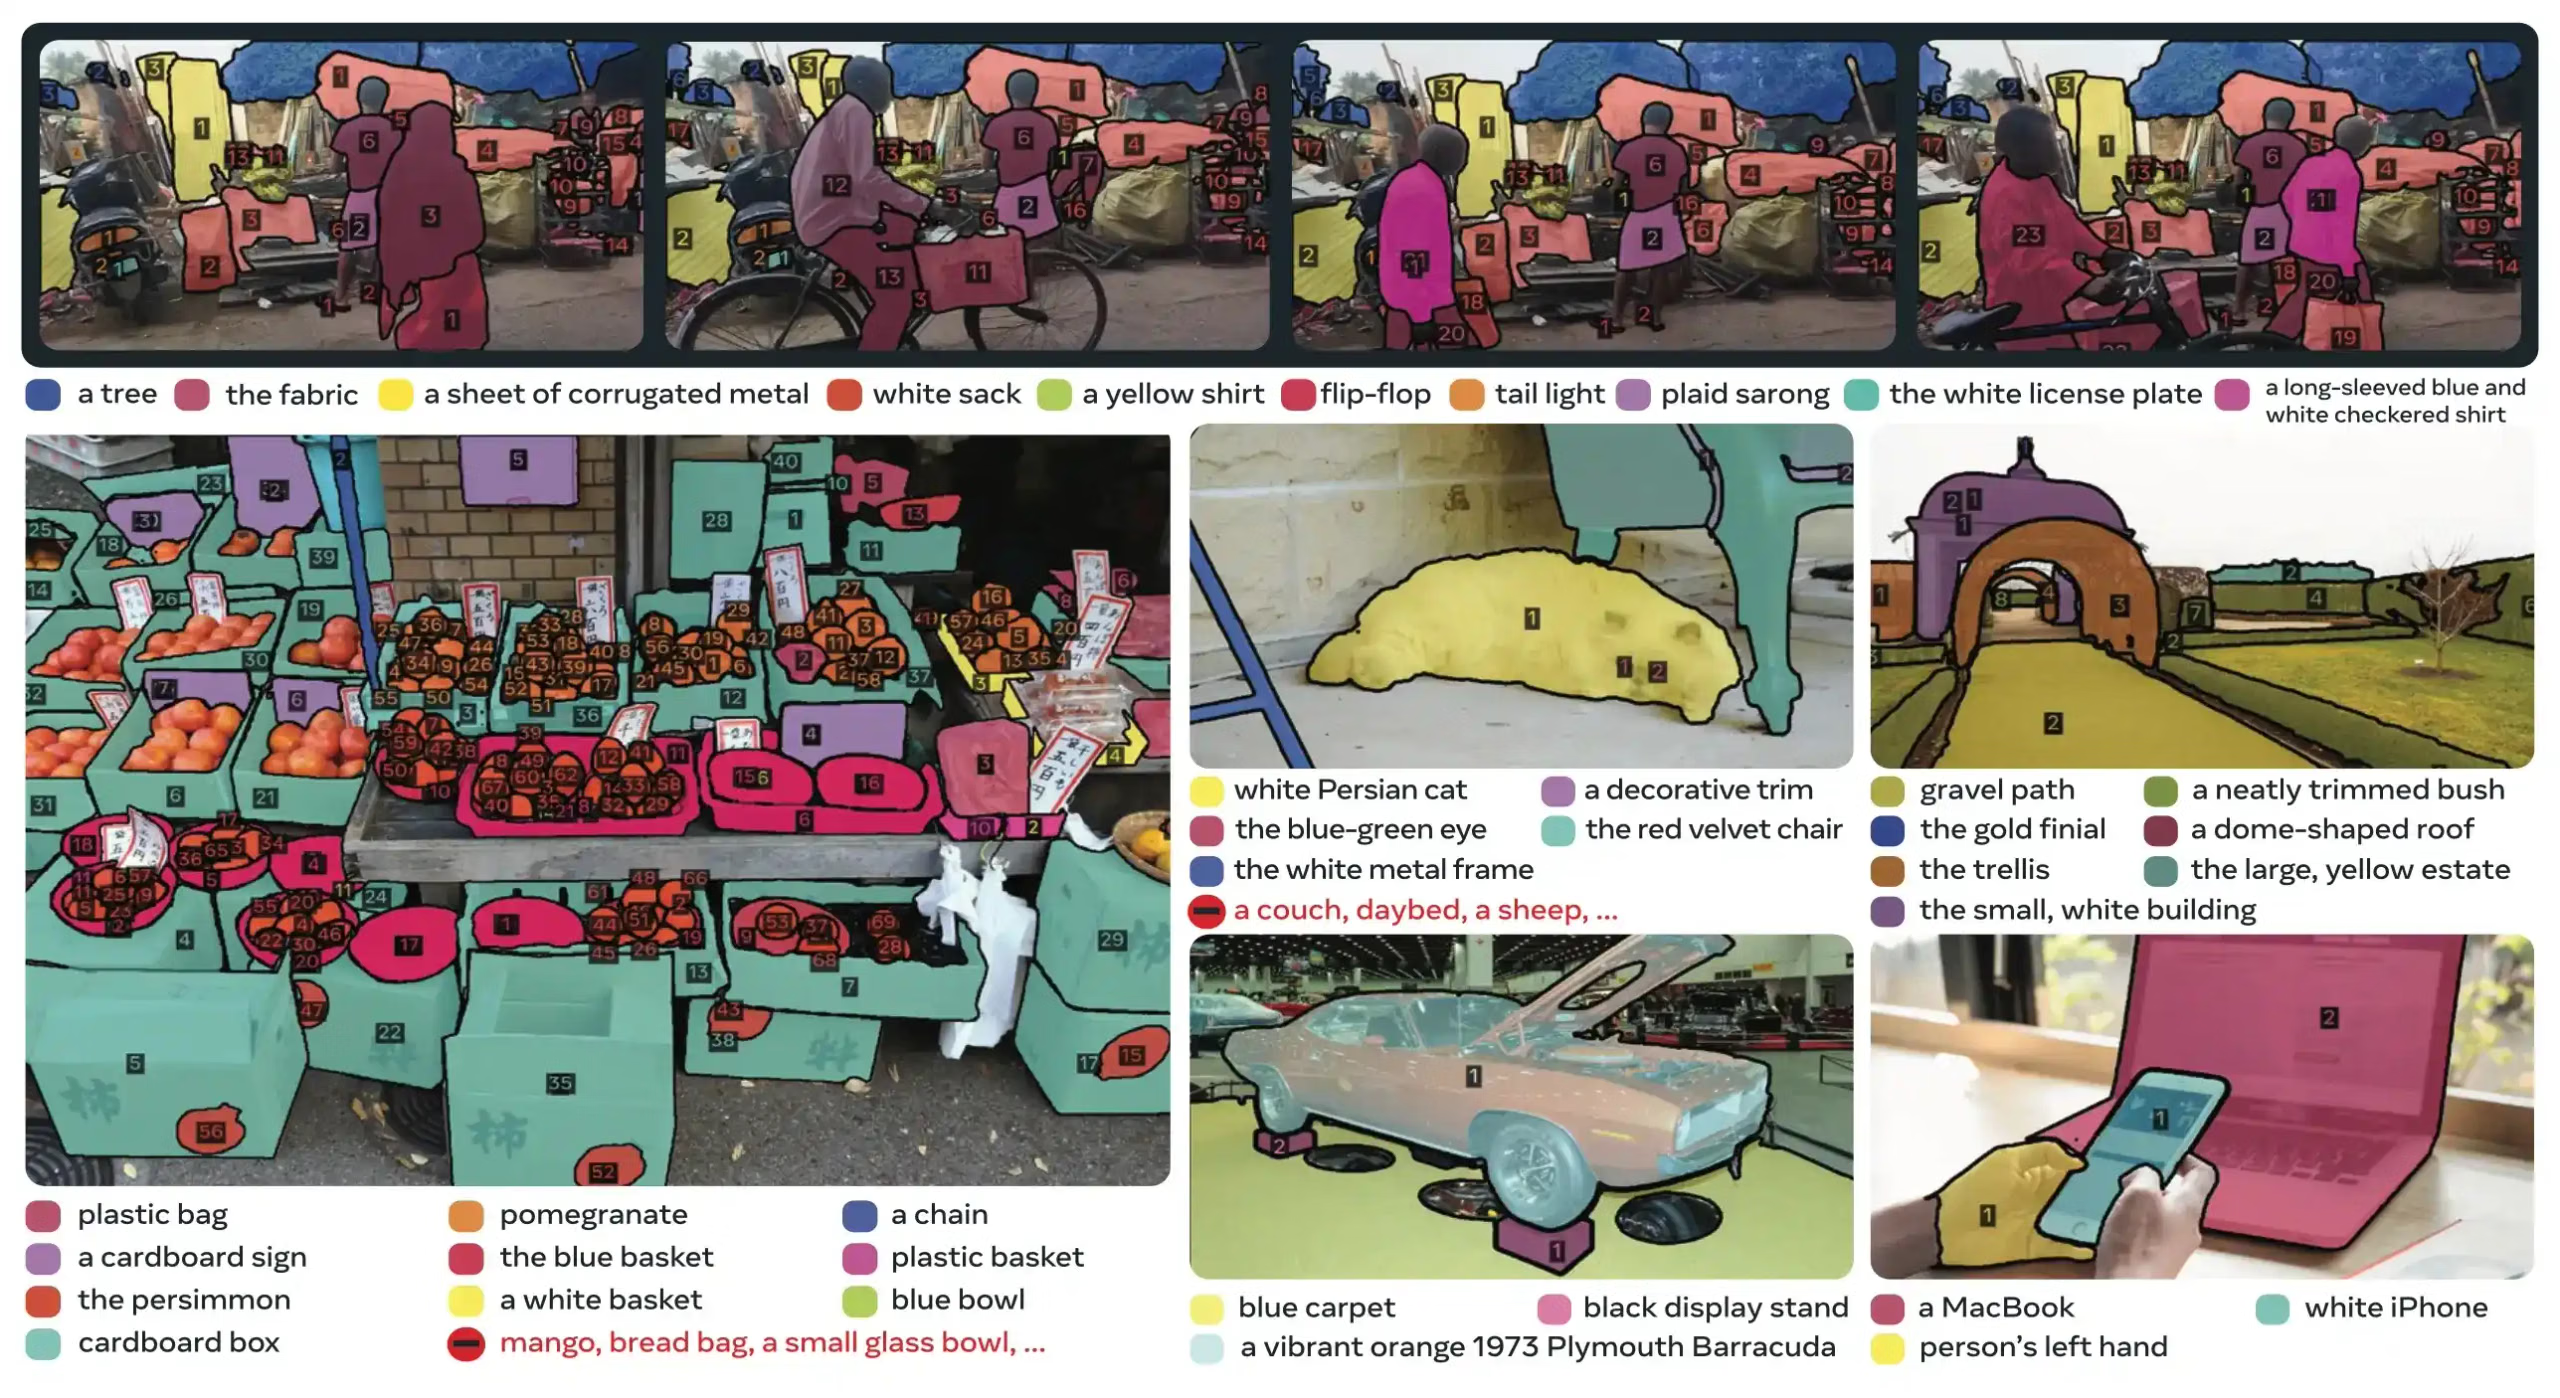
¿Qué es la segmentación de conceptos mediante indicaciones (PCS)?#
La tarea PCS recibe como entrada una indicación de concepto y devuelve máscaras de segmentación con identidades únicas para todas las instancias de objetos coincidentes. Las indicaciones de concepto pueden ser:
- Texto: frases nominales sencillas como «manzana roja» o «persona con sombrero», similares a las del aprendizaje de cero ejemplos
- Imágenes de ejemplo: cuadros delimitadores alrededor de objetos de ejemplo (positivos o negativos) para una generalización rápida
- Combinadas: texto e imágenes de ejemplo a la vez para un control preciso
Esto difiere de las indicaciones visuales tradicionales (puntos, cuadros y máscaras), que segmentan una única instancia de objeto concreta, como se popularizó con la familia SAM original.
Métricas clave de rendimiento#
| Métrica | Logro de SAM 3 |
|---|---|
| AP de máscaras sin entrenamiento previo en LVIS | 47.0 (frente al mejor resultado anterior de 38.5; mejora del +22 %) |
| Referencia SA-Co | 2× mejor que los sistemas existentes |
| Velocidad de inferencia (GPU H200) | 30 ms por imagen con más de 100 objetos detectados |
| Rendimiento en vídeo | Casi en tiempo real para ~5 objetos simultáneos |
| Referencia MOSEv2 VOS | 60.1 J&F (+25.5 % respecto a SAM 2.1, +17 % respecto al estado del arte anterior) |
| Refinamiento interactivo | +18.6 CGF1 de mejora tras 3 indicaciones con imágenes de ejemplo |
| Diferencia respecto al rendimiento humano | Alcanza el 88 % del límite inferior estimado en SA-Co/Gold |
Para contextualizar las métricas de los modelos y las ventajas e inconvenientes en producción, consulta análisis de evaluación de modelos y métricas de rendimiento de YOLO.
SAM 3.1#
SAM 3.1, publicado por Meta el 27 de marzo de 2026, es un nuevo punto de control de SAM 3 que añade Object Multiplex, un método de memoria compartida para el seguimiento de varios objetos en vídeo. En lugar de procesar cada objeto seguido de forma independiente, SAM 3.1 agrupa los objetos en bloques de capacidad fija y los procesa conjuntamente; según Meta, esto supone una aceleración de ~7× con 128 objetos en una sola GPU H100. El detector de imágenes y la cabeza interactiva basada en indicaciones de puntos conservan la arquitectura de SAM 3.
| Evaluación comparativa | Métrica | SAM 3 | SAM 3.1 |
|---|---|---|---|
| SA-Co/VEval SA-V (prueba) | cgF1 | 30.3 | 30.5 |
| SA-Co/VEval YT-Temporal-1B (prueba) | cgF1 | 50.8 | 52.9 |
| SA-Co/VEval SmartGlasses (prueba) | cgF1 | 36.4 | 36.3 |
| MOSEv1 (validación) | J&F | 78.4 | 79.6 |
| DAVIS17 (validación) | J&F | 92.2 | 92.7 |
| SA-V (prueba) | J&F | 84.4 | 85.1 |
| YTVOS19 (validación) | G | 89.7 | 89.3 |
| MOSEv2 (validación) | J&Ḟ | 60.3 | 62.3 |
Ultralytics carga el punto de control de SAM 3.1 (sam3.1_multiplex.pt) en los predictores de imágenes de SAM 3: SAM("sam3.1_multiplex.pt") para indicaciones de puntos y cuadros, y SAM3SemanticPredictor para indicaciones de texto e imágenes de ejemplo. El seguimiento de vídeo Object Multiplex aún no es compatible, así que sigue usando sam3.pt con SAM3VideoPredictor y SAM3VideoSemanticPredictor.
Arquitectura#
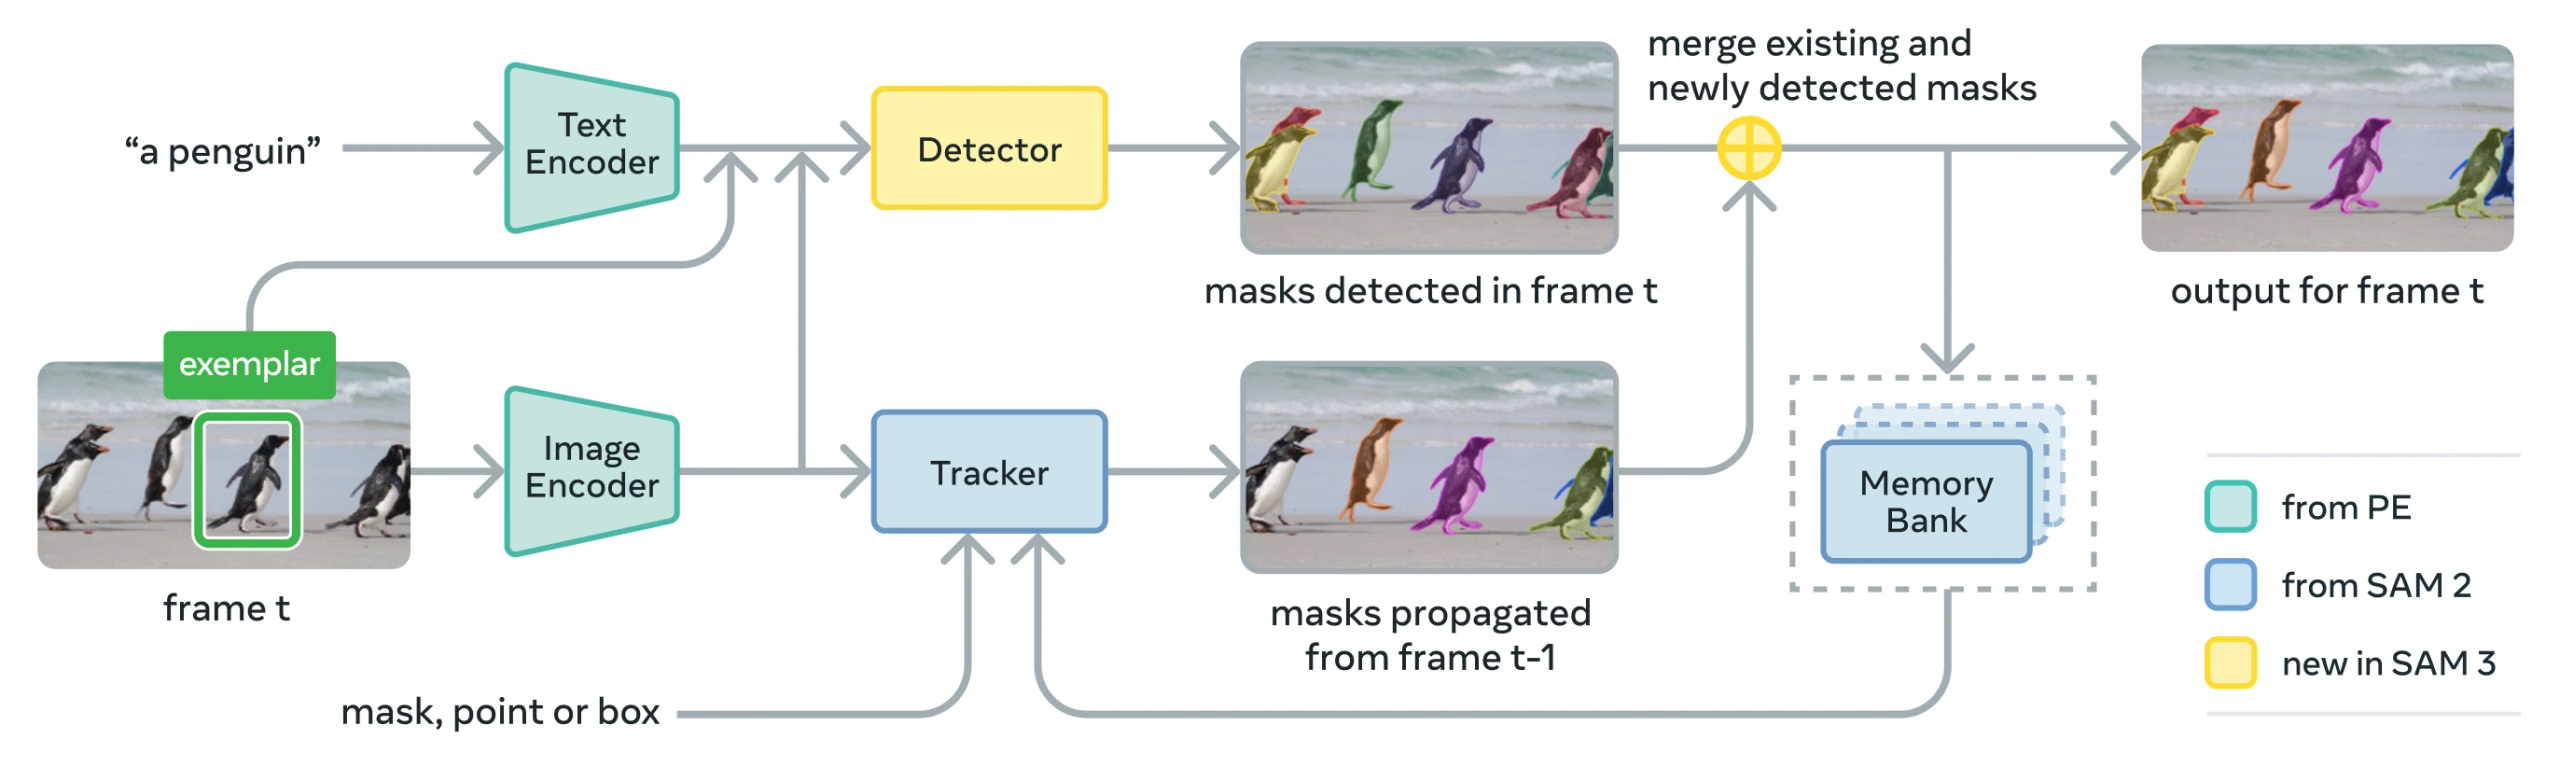
SAM 3 consta de un detector y un seguidor que comparten una red troncal visual Perception Encoder (PE). Este diseño desacoplado evita conflictos entre tareas y permite tanto la detección a nivel de imagen como el seguimiento a nivel de vídeo, con una interfaz compatible con el uso de Python y el uso de la CLI de Ultralytics.
Componentes principales#
-
Detector: arquitectura basada en DETR para la detección de conceptos a nivel de imagen
- Codificador de texto para indicaciones de frases nominales
- Codificador de imágenes de ejemplo para indicaciones basadas en imágenes
- Codificador de fusión para condicionar las características de la imagen según las indicaciones
- Nueva cabeza de presencia que desacopla el reconocimiento («qué») de la localización («dónde»)
- Cabeza de máscaras para generar máscaras de segmentación de instancias
-
Seguidor: Segmentación de vídeo basada en memoria, heredada de SAM 2
- Codificador de indicaciones, decodificador de máscaras y codificador de memoria
- Banco de memoria para almacenar la apariencia de los objetos entre fotogramas
-
Token de presencia: token global aprendido que predice si el concepto objetivo está presente en la imagen o el fotograma y mejora la detección al separar el reconocimiento de la localización.
Innovaciones clave#
- Reconocimiento y localización desacoplados: La cabeza de presencia predice globalmente la presencia del concepto, mientras que las consultas de propuestas se centran únicamente en la localización, lo que evita objetivos contrapuestos.
- Indicaciones unificadas de conceptos y visuales: Admite tanto PCS (indicaciones de conceptos) como PVS (indicaciones visuales, como los clics y los cuadros de SAM 2) en un único modelo.
- Refinamiento interactivo con ejemplos: Los usuarios pueden añadir ejemplos de imagen positivos o negativos para refinar los resultados de forma iterativa; el modelo generaliza a objetos similares, en lugar de limitarse a corregir instancias individuales.
- Desambiguación temporal: Utiliza puntuaciones de detección de masklets y vuelve a solicitar indicaciones periódicamente para gestionar oclusiones, escenas abarrotadas y fallos de seguimiento en vídeo, de acuerdo con las prácticas recomendadas de segmentación de instancias y seguimiento.
Conjunto de datos SA-Co#
SAM 3 se entrena con Segment Anything with Concepts (SA-Co), el conjunto de datos de segmentación más grande y diverso de Meta hasta la fecha, que va más allá de referencias habituales como COCO y LVIS.
Datos de entrenamiento#
| Componente del conjunto de datos | Descripción | Escala |
|---|---|---|
| SA-Co/HQ | Datos de imágenes de alta calidad anotados por personas mediante un motor de datos de 4 fases | 5,2 M de imágenes, 4 M de frases nominales únicas |
| SA-Co/SYN | Conjunto de datos sintético etiquetado por IA sin intervención humana | 38 M de frases nominales, 1,4 mil millones de máscaras |
| SA-Co/EXT | 15 conjuntos de datos externos enriquecidos con negativos difíciles | Varía según la fuente |
| SA-Co/VIDEO | Anotaciones de vídeo con seguimiento temporal | 52,5 mil vídeos, 24,8 mil frases nominales únicas |
Datos de evaluación comparativa#
La referencia de evaluación SA-Co contiene 214 mil frases únicas en 126 mil imágenes y vídeos, lo que ofrece más de 50 veces más conceptos que las referencias existentes. Incluye:
- SA-Co/Gold: 7 ámbitos, con triple anotación para medir los límites del rendimiento humano
- SA-Co/Silver: 10 ámbitos, con una única anotación humana
- SA-Co/Bronze y SA-Co/Bio: 9 conjuntos de datos existentes adaptados a la segmentación de conceptos
- SA-Co/VEval: referencia de vídeo con 3 ámbitos (SA-V, YT-Temporal-1B, SmartGlasses)
Innovaciones en el motor de datos#
El motor de datos escalable de SAM 3, con intervención humana y del modelo, consigue duplicar el rendimiento de anotación mediante:
- Anotadores de IA: Los modelos basados en Llama proponen diversas frases nominales, incluidos negativos difíciles
- Verificadores de IA: Los LLM multimodales ajustados verifican la calidad y exhaustividad de las máscaras con un rendimiento casi humano
- Minería activa: Centra el esfuerzo humano en casos difíciles en los que la IA falla
- Basado en ontología: Utiliza una amplia ontología fundamentada en Wikidata para abarcar conceptos
Instalación#
Instala o actualiza el paquete ultralytics:
pip install -U ultralyticsA diferencia de otros modelos de Ultralytics, los pesos de SAM 3 (sam3.pt) no se descargan automáticamente. Primero debes solicitar acceso a los pesos del modelo en la página del modelo SAM 3 en Hugging Face y, una vez aprobado, descargar sam3.pt desde esa página. Coloca el archivo sam3.pt descargado en tu directorio de trabajo o especifica la ruta completa al cargar el modelo.
El acceso a los pesos de SAM 3.1 (sam3.1_multiplex.pt) también está restringido en la página del modelo SAM 3.1. Pasa sam3.1_multiplex.pt en cualquier lugar donde los ejemplos de imágenes de abajo utilicen sam3.pt.
Si recibes el error anterior durante la predicción, significa que tienes instalado el paquete clip incorrecto. Instala el paquete correcto clip con el siguiente comando:
pip uninstall clip -y
pip install git+https://github.com/ultralytics/CLIP.git
Cómo usar SAM 3: versatilidad en la segmentación de conceptos#
SAM 3 admite tareas de segmentación de conceptos con indicaciones (PCS) y de segmentación visual con indicaciones (PVS) mediante distintas interfaces de predictor:
Tareas y modelos compatibles#
| Tipo de tarea | Tipos de indicaciones | Salida |
|---|---|---|
| Segmentación de conceptos (PCS) | Texto (frases nominales), ejemplos de imagen | Todas las instancias que coinciden con el concepto |
| Segmentación visual (PVS) | Puntos, cuadros, máscaras | Una única instancia de objeto (estilo SAM 2) |
| Refinamiento interactivo | Añade o elimina ejemplos o clics de forma iterativa | Segmentación refinada con mayor precisión |
Ejemplos de segmentación de conceptos#
Segmentación con indicaciones de texto#
Encuentra y segmenta todas las instancias de un concepto mediante una descripción de texto. Las indicaciones de texto requieren la interfaz SAM3SemanticPredictor.
from ultralytics.models.sam import SAM3SemanticPredictor

# Inicializa el predictor con la configuración
overrides = {
    "conf": 0.25,
    "task": "segment",
    "mode": "predict",
    "model": "sam3.pt",
    "quantize": 16,  # Usa FP16 para acelerar la inferencia
    "save": True,
}
predictor = SAM3SemanticPredictor(overrides=overrides)

# Configura la imagen una sola vez para varias consultas
predictor.set_image("path/to/image.jpg")

# Realiza consultas con varias indicaciones de texto
results = predictor(text=["person", "bus", "glasses"])

# Funciona con frases descriptivas
results = predictor(text=["person with red cloth", "person with blue cloth"])

# Realiza una consulta con un único concepto
results = predictor(text=["a person"])
Segmentación con ejemplos de imagen#
Usa cuadros delimitadores como indicaciones visuales para encontrar todas las instancias similares. También requiere SAM3SemanticPredictor para la coincidencia basada en conceptos.
from ultralytics.models.sam import SAM3SemanticPredictor

# Inicializa el predictor
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "model": "sam3.pt", "quantize": 16, "save": True}
predictor = SAM3SemanticPredictor(overrides=overrides)

# Configura la imagen
predictor.set_image("path/to/image.jpg")

# Proporciona ejemplos de cuadros delimitadores para segmentar objetos similares
results = predictor(bboxes=[[480.0, 290.0, 590.0, 650.0]])

# Varios cuadros delimitadores como ejemplos de un mismo concepto visual
results = predictor(bboxes=[[539, 599, 589, 639], [343, 267, 499, 662]])
Inferencia basada en características para mejorar la eficiencia#
Extrae las características de imagen una vez y reutilízalas en varias consultas de segmentación para mejorar la eficiencia.
import cv2

from ultralytics.models.sam import SAM3SemanticPredictor
from ultralytics.utils.plotting import Annotator, colors

# Inicializa los predictores
overrides = {"conf": 0.50, "task": "segment", "mode": "predict", "model": "sam3.pt", "verbose": False}
predictor = SAM3SemanticPredictor(overrides=overrides)
predictor2 = SAM3SemanticPredictor(overrides=overrides)

# Extrae las características del primer predictor
source = "path/to/image.jpg"
predictor.set_image(source)
src_shape = cv2.imread(source).shape[:2]

# Configura el segundo predictor y reutiliza las características
predictor2.setup_model()

# Realiza inferencias con las características compartidas y una indicación de texto
masks, boxes = predictor2.inference_features(predictor.features, src_shape=src_shape, text=["person"])

# Realiza inferencias con las características compartidas y una indicación de cuadro delimitador
masks, boxes = predictor2.inference_features(predictor.features, src_shape=src_shape, bboxes=[[439, 437, 524, 709]])

# Visualiza los resultados
if masks is not None:
    masks, boxes = masks.cpu().numpy(), boxes.cpu().numpy()
    im = cv2.imread(source)
    annotator = Annotator(im, pil=False)
    annotator.masks(masks, [colors(x, True) for x in range(len(masks))])

    cv2.imshow("result", annotator.result())
    cv2.waitKey(0)
Segmentación de conceptos en vídeo#
Sigue conceptos en todo el vídeo mediante cuadros delimitadores#
Detecta y sigue instancias de objetos a través de los fotogramas del vídeo mediante indicaciones de cuadros delimitadores.
from ultralytics.models.sam import SAM3VideoPredictor

# Crea el predictor de vídeo
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "model": "sam3.pt", "quantize": 16}
predictor = SAM3VideoPredictor(overrides=overrides)

# Sigue objetos mediante indicaciones de cuadros delimitadores
results = predictor(source="path/to/video.mp4", bboxes=[[706.5, 442.5, 905.25, 555], [598, 635, 725, 750]], stream=True)

# Procesa y muestra los resultados
for r in results:
    r.show()  # Muestra el fotograma con las máscaras de segmentación
Sigue conceptos mediante indicaciones de texto#
Sigue todas las instancias de los conceptos especificados mediante texto a través de los fotogramas del vídeo.
from ultralytics.models.sam import SAM3VideoSemanticPredictor

# Inicializa el predictor semántico de vídeo
overrides = {
    "conf": 0.25,
    "task": "segment",
    "mode": "predict",
    "imgsz": 640,
    "model": "sam3.pt",
    "quantize": 16,
    "save": True,
}
predictor = SAM3VideoSemanticPredictor(overrides=overrides)

# Sigue conceptos mediante indicaciones de texto
results = predictor(source="path/to/video.mp4", text=["person", "bicycle"], stream=True)

# Procesa los resultados
for r in results:
    r.show()  # Muestra el fotograma con los objetos seguidos

# Alternativa: realiza el seguimiento con indicaciones de cuadros delimitadores
results = predictor(
    source="path/to/video.mp4",
    bboxes=[[864, 383, 975, 620], [705, 229, 782, 402]],
    labels=[1, 1],  # Etiquetas positivas
    stream=True,
)
Indicaciones visuales (compatibilidad con SAM 2)#
SAM 3 mantiene la compatibilidad total con versiones anteriores para las indicaciones visuales de SAM 2 en la segmentación de un solo objeto:
La interfaz básica SAM funciona exactamente igual que SAM 2 y segmenta únicamente el área específica indicada mediante indicaciones visuales (puntos, cuadros o máscaras).
from ultralytics import SAM

model = SAM("sam3.pt")

# Indicación de un único punto: segmenta el objeto en una ubicación concreta
results = model.predict(source="path/to/image.jpg", points=[900, 370], labels=[1])
results[0].show()

# Varios puntos: segmenta un único objeto con varias indicaciones de puntos
results = model.predict(source="path/to/image.jpg", points=[[400, 370], [900, 370]], labels=[1, 1])

# Indicación de cuadro: segmenta el objeto dentro de un cuadro delimitador
results = model.predict(source="path/to/image.jpg", bboxes=[100, 150, 300, 400])
results[0].show()Al usar SAM("sam3.pt") con indicaciones visuales (puntos/cuadros/máscaras), segmentarás solo el objeto concreto de esa ubicación, igual que con SAM 2. Para segmentar todas las instancias de un concepto, usa SAM3SemanticPredictor con indicaciones de texto o de ejemplos, como se muestra arriba.
Pruebas de rendimiento#
Segmentación de imágenes#
SAM 3 logra resultados de vanguardia en varias pruebas de referencia, incluidos conjuntos de datos del mundo real como LVIS y COCO para segmentación:
| Evaluación comparativa | Métrica | SAM 3 | Mejor resultado anterior | Mejora |
|---|---|---|---|---|
| LVIS (cero disparos) | AP de máscaras | 47.0 | 38.5 | +22.1% |
| SA-Co/Gold | CGF1 | 65.0 | 34,3 (OWLv2) | +89.5% |
| COCO (cero disparos) | AP de cuadros | 53.5 | 52.2 (T-Rex2) | +2.5% |
| ADE-847 (segmentación semántica) | mIoU | 14.7 | 9.2 (APE-D) | +59.8% |
| PascalConcept-59 | mIoU | 59.4 | 58.5 (APE-D) | +1.5% |
| Cityscapes (segmentación semántica) | mIoU | 65.1 | 44.2 (APE-D) | +47.3% |
Explora opciones de conjuntos de datos para experimentar rápidamente en conjuntos de datos de Ultralytics.
Rendimiento de la segmentación de vídeo#
SAM 3 mejora notablemente los resultados de SAM 2 y de los modelos anteriores de vanguardia en pruebas de referencia de vídeo, como DAVIS 2017 y YouTube-VOS:
| Evaluación comparativa | Métrica | SAM 3 | SAM 2.1 L | Mejora |
|---|---|---|---|---|
| MOSEv2 | J&F | 60.1 | 47.9 | +25.5% |
| DAVIS 2017 | J&F | 92.0 | 90.7 | +1.4% |
| LVOSv2 | J&F | 88.2 | 79.6 | +10.8% |
| SA-V | J&F | 84.6 | 78.4 | +7.9% |
| YTVOS19 | J&F | 89.6 | 89.3 | +0.3% |
Adaptación con pocos ejemplos#
SAM 3 se adapta a nuevos dominios con pocos ejemplos, algo relevante para los flujos de trabajo de IA centrada en los datos:
| Evaluación comparativa | AP con 0 ejemplos | AP con 10 ejemplos | Mejor resultado anterior (10 ejemplos) |
|---|---|---|---|
| ODinW13 | 59.9 | 71.6 | 67.9 (gDino1.5-Pro) |
| RF100-VL | 14.3 | 35.7 | 33.7 (gDino-T) |
Eficacia del refinamiento interactivo#
Las indicaciones basadas en conceptos con ejemplos de SAM 3 convergen mucho más rápido que las indicaciones visuales:
| Indicaciones añadidas | Puntuación CGF1 | Mejora frente a solo texto | Mejora frente a la referencia PVS |
|---|---|---|---|
| Solo texto | 46.4 | referencia | referencia |
| +1 ejemplo | 57.6 | +11.2 | +6.7 |
| +2 ejemplos | 62.2 | +15.8 | +9.7 |
| +3 ejemplos | 65.0 | +18.6 | +11.2 |
| +4 ejemplos | 65.7 | +19.3 | +11.5 (meseta) |
Precisión del recuento de objetos#
SAM 3 ofrece recuentos precisos al segmentar todas las instancias, un requisito habitual en el recuento de objetos:
| Evaluación comparativa | Precisión | MAE | frente al mejor MLLM |
|---|---|---|---|
| CountBench | 95.6% | 0.11 | 92.4% (Gemini 2.5) |
| PixMo-Count | 87.3% | 0.22 | 88.8% (Molmo-72B) |
Comparación entre SAM 3, SAM 2 y YOLO#
Aquí comparamos las capacidades de SAM 3 con las de SAM 2 y los modelos YOLO26:
| Capacidad | SAM 3 | SAM 2 | YOLO26n-seg |
|---|---|---|---|
| Segmentación de conceptos | ✅ Todas las instancias a partir de texto/ejemplos | ❌ No compatible | ❌ No compatible |
| Segmentación visual | ✅ Una sola instancia (compatible con SAM 2) | ✅ Una sola instancia | ✅ Todas las instancias |
| Capacidad de cero disparos | ✅ Vocabulario abierto | ✅ Indicaciones geométricas | ❌ Conjunto cerrado |
| Refinamiento interactivo | ✅ Ejemplos y clics | ✅ Solo clics | ❌ No compatible |
| Seguimiento de vídeo | ✅ Varios objetos con identidades | ✅ Varios objetos | ✅ Varios objetos |
| AP de máscaras LVIS (cero disparos) | 47.0 | N/D | N/D |
| MOSEv2 J&F | 60.1 | 47.9 | N/D |
| Velocidad (GPU, ms/im) | 2921 | 857 | 8.4 |
| Tamaño del modelo | 3.45 GB | 162 MB (base) | 6.4 MB |
Velocidad medida en una NVIDIA RTX PRO 6000 con torch==2.9.1 y ultralytics==8.4.19.
Conclusiones clave:
- SAM 3: la mejor opción para segmentar conceptos con vocabulario abierto y encontrar todas las instancias de un concepto mediante indicaciones de texto o ejemplos
- SAM 2: la mejor opción para segmentar interactivamente un único objeto en imágenes y vídeos mediante indicaciones geométricas
- YOLO26: la mejor opción para segmentar en tiempo real a gran velocidad, con inferencia de extremo a extremo opcional sin NMS, exportable a muchos formatos para su implementación en GPU, CPU y dispositivos periféricos
- YOLOE: Ideal para la detección y segmentación en tiempo real con vocabulario abierto mediante indicaciones de texto o visuales
Comparación de SAM frente a YOLO#
Comparamos SAM 3, SAM 2, SAM, MobileSAM y FastSAM con los modelos de segmentación YOLO de Ultralytics (YOLOv8, YOLO11, YOLO26) en cuanto a tamaño, parámetros y velocidad de inferencia en GPU:
| Modelo | Tamaño (MB) | Parámetros (M) | Velocidad (GPU) (ms/im) |
|---|---|---|---|
| Meta SAM-b | 375 | 93.7 | 1306 |
| Meta SAM2-b | 162 | 80.8 | 857 |
| Meta SAM2-t | 78.1 | 38.9 | 668 |
| Meta SAM3 | 3450 | 473.6 | 2921 |
| MobileSAM | 40.7 | 10.1 | 605 |
| FastSAM-s con backbone YOLOv8 | 23.7 | 11.8 | 55.9 |
| Ultralytics YOLOv8n-seg | 6.7 (515 veces más pequeño) | 3.4 (139.1 veces menos) | 17.4 (167 veces más rápido) |
| Ultralytics YOLO11n-seg | 5.9 (585 veces más pequeño) | 2.9 (163.1 veces menos) | 12.6 (231 veces más rápido) |
| Ultralytics YOLO26n-seg | 6.4 (539 veces más pequeño) | 2.7 (175.2 veces menos) | 8.4 (347 veces más rápido) |
Esta comparación muestra las diferencias considerables de tamaño y velocidad entre las variantes de SAM y los modelos de segmentación YOLO. Aunque SAM ofrece capacidades únicas de segmentación automática, los modelos YOLO, en particular YOLOv8n-seg, YOLO11n-seg y YOLO26n-seg, son mucho más pequeños, rápidos y eficientes desde el punto de vista computacional.
Pruebas realizadas en una NVIDIA RTX PRO 6000 con 96 GB de VRAM mediante torch==2.9.1 y ultralytics==8.4.19. Para reproducir esta prueba:
from ultralytics import ASSETS, SAM, YOLO, FastSAM

# Perfilar SAM3, SAM2-t, SAM2-b, SAM-b, MobileSAM
for file in ["sam_b.pt", "sam2_b.pt", "sam2_t.pt", "mobile_sam.pt", "sam3.pt"]:
    model = SAM(file)
    model.info()
    model(ASSETS)

# Perfilar FastSAM-s
model = FastSAM("FastSAM-s.pt")
model.info()
model(ASSETS)

# Perfilar modelos YOLO
for file_name in ["yolov8n-seg.pt", "yolo11n-seg.pt", "yolo26n-seg.pt"]:
    model = YOLO(file_name)
    model.info()
    model(ASSETS, nms=False)  # Cabezal sin NMS de YOLO26; no hace nada con YOLOv8/YOLO11
Métricas de evaluación#
SAM 3 introduce nuevas métricas diseñadas para la tarea PCS, que complementan medidas conocidas como la puntuación F1, la precisión y la exhaustividad.
F1 con clasificación condicionada (CGF1)#
La métrica principal combina localización y clasificación:
CGF1 = 100 × pmF1 × IL_MCC
Donde:
- pmF1 (F1 macro positiva): mide la calidad de la localización en ejemplos positivos
- IL_MCC (coeficiente de correlación de Matthews a nivel de imagen): mide la precisión de la clasificación binaria («¿está presente el concepto?»)
¿Por qué estas métricas?#
Las métricas AP tradicionales no tienen en cuenta la calibración, lo que dificulta el uso práctico de los modelos. Al evaluar solo las predicciones con una confianza superior a 0,5, las métricas de SAM 3 exigen una buena calibración y reproducen los patrones de uso reales en los bucles interactivos de predicción y seguimiento.
Ablaciones e ideas clave#
Impacto del cabezal de presencia#
El cabezal de presencia separa el reconocimiento de la localización y ofrece mejoras significativas:
| Configuración | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| Sin presencia | 57.6 | 0.77 | 74.7 |
| Con presencia | 63.3 | 0.82 | 77.1 |
El cabezal de presencia aporta una mejora de +5.7 en CGF1 (+9.9 %), principalmente al mejorar la capacidad de reconocimiento (IL_MCC +6.5 %).
Efecto de los negativos difíciles#
| Negativos difíciles por imagen | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| 0 | 31.8 | 0.44 | 70.2 |
| 5 | 44.8 | 0.62 | 71.9 |
| 30 | 49.2 | 0.68 | 72.3 |
Los negativos difíciles son esenciales para el reconocimiento de vocabulario abierto y mejoran IL_MCC un 54.5 % (0.44 → 0.68).
Escalado de los datos de entrenamiento#
| Fuentes de datos | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| Solo externos | 30.9 | 0.46 | 66.3 |
| Externos + sintéticos | 39.7 | 0.57 | 70.6 |
| Externos + alta calidad | 51.8 | 0.71 | 73.2 |
| Los tres | 54.3 | 0.74 | 73.5 |
Las anotaciones humanas de alta calidad ofrecen grandes mejoras frente a usar únicamente datos sintéticos o externos. Para obtener información sobre las prácticas de calidad de los datos, consulta recopilación y anotación de datos.
Aplicaciones#
La capacidad de segmentación de conceptos de SAM 3 permite nuevos casos de uso:
- Moderación de contenidos: encuentra todas las instancias de tipos de contenido específicos en bibliotecas multimedia
- Comercio electrónico: segmenta todos los productos de un tipo concreto en imágenes de catálogo y facilita la anotación automática
- Diagnóstico por imagen: Identifica todas las apariciones de tipos de tejido específicos o anomalías
- Sistemas autónomos: sigue todas las instancias de señales de tráfico, peatones o vehículos por categoría
- Analítica de vídeo: cuenta y sigue a todas las personas que llevan prendas específicas o realizan determinadas acciones
- Anotación de conjuntos de datos: anota rápidamente todas las instancias de categorías de objetos poco frecuentes
- Investigación científica: cuantifica y analiza todas las muestras que cumplen criterios específicos
Agente SAM 3: razonamiento lingüístico ampliado#
SAM 3 se puede combinar con modelos de lenguaje grandes multimodales (MLLM) para responder a consultas complejas que requieren razonamiento, de forma similar a sistemas de vocabulario abierto como OWLv2 y T-Rex.
Rendimiento en tareas de razonamiento#
| Evaluación comparativa | Métrica | Agente SAM 3 (Gemini 2.5 Pro) | Mejor resultado anterior |
|---|---|---|---|
| ReasonSeg (validación) | gIoU | 76.0 | 65.0 (SoTA) |
| ReasonSeg (prueba) | gIoU | 73.8 | 61.3 (SoTA) |
| OmniLabel (validación) | AP | 46.7 | 36.5 (REAL) |
| RefCOCO+ | Acc | 91.2 | 89.3 (LISA) |
Ejemplos de consultas complejas#
El agente SAM 3 puede responder a consultas que requieren razonamiento:
- «Personas sentadas que no sostienen una caja de regalo en las manos»
- «El perro más cercano a la cámara que no lleva collar»
- «Objetos rojos más grandes que la mano de la persona»
El MLLM propone a SAM 3 consultas sencillas en forma de sintagmas nominales, analiza las máscaras obtenidas y repite el proceso hasta obtener el resultado deseado.
Limitaciones#
SAM 3 tiene las siguientes limitaciones:
- Complejidad de las frases: funciona mejor con sintagmas nominales sencillos; las expresiones referenciales largas o el razonamiento complejo pueden requerir la integración de un MLLM
- Gestión de la ambigüedad: algunos conceptos siguen siendo intrínsecamente ambiguos (p. ej., «ventana pequeña», «habitación acogedora»)
- Requisitos computacionales: Es más grande y lento que los modelos de detección especializados, como YOLO
- Alcance del vocabulario: se centra en conceptos visuales atómicos; el razonamiento composicional es limitado sin la ayuda de un MLLM
- Conceptos poco frecuentes: el rendimiento puede disminuir con conceptos muy poco frecuentes o detallados que no estén bien representados en los datos de entrenamiento
Cita#
@misc{carion2025sam3,
  title         = {SAM 3: Segment Anything with Concepts},
  author        = {Nicolas Carion and Laura Gustafson and Yuan-Ting Hu and Shoubhik Debnath and Ronghang Hu and Didac Suris and Chaitanya Ryali and Kalyan Vasudev Alwala and Haitham Khedr and Andrew Huang and Jie Lei and Tengyu Ma and Baishan Guo and Arpit Kalla and Markus Marks and Joseph Greer and Meng Wang and Peize Sun and Roman R{\"a}dle and Triantafyllos Afouras and Effrosyni Mavroudi and Katherine Xu and Tsung-Han Wu and Yu Zhou and Liliane Momeni and Rishi Hazra and Shuangrui Ding and Sagar Vaze and Francois Porcher and Feng Li and Siyuan Li and Aishwarya Kamath and Ho Kei Cheng and Piotr Doll{\'a}r and Nikhila Ravi and Kate Saenko and Pengchuan Zhang and Christoph Feichtenhofer},
  year          = {2025},
  eprint        = {2511.16719},
  archivePrefix = {arXiv},
  primaryClass  = {cs.CV},
  url           = {https://arxiv.org/abs/2511.16719}
}
Preguntas frecuentes#
Meta publicó SAM 3 el 19 de noviembre de 2025 y su integración en el paquete
ultralyticses completa, con compatibilidad para la predicción de imágenes y el seguimiento de vídeo mediante predictores específicos.Sí. SAM 3 está totalmente integrado en el paquete Python de Ultralytics e incluye segmentación de conceptos, indicaciones visuales al estilo de SAM 2 y seguimiento de varios objetos en vídeo. SAM 3 y SAM 3.1 también impulsan la función de anotación inteligente de Ultralytics Platform, donde SAM 3.1 es el modelo predeterminado y puedes anotar imágenes con solo unos clics. En conjuntos de datos de detección con entre 1 y 200 clases, SAM 3 Text y SAM 3.1 Text también generan anotaciones automáticamente a partir de los nombres de tus clases, y la clasificación de modelos VLM compara su precisión con la de los modelos de lenguaje y visión.
Sí, para la predicción de imágenes. Carga
sam3.1_multiplex.pten todos los ejemplos de imágenes de esta página en los que se usesam3.pt:SAM("sam3.1_multiplex.pt")para indicaciones de puntos y cuadros, ySAM3SemanticPredictorpara indicaciones de texto y ejemplos. El seguimiento de vídeo con Object Multiplex aún no es compatible, así que sigue usandosam3.ptcon los predictores de vídeo. Consulta SAM 3.1 para ver las pruebas comparativas de Meta.PCS es una nueva tarea introducida en SAM 3 que segmenta todas las instancias de un concepto visual en una imagen o un vídeo. A diferencia de la segmentación tradicional, que se centra en una instancia concreta de un objeto, PCS encuentra todas las apariciones de una categoría. Por ejemplo:
- Indicación de texto: «autobús escolar amarillo» → segmenta todos los autobuses escolares amarillos de la escena
- Ejemplo de imagen: encuadra un perro → segmenta todos los perros de la imagen
- Combinado: «gato atigrado» + cuadro de ejemplo → segmenta todos los gatos atigrados que coincidan con el ejemplo
Característica SAM 2 SAM 3 Tarea Un objeto por indicación Todas las instancias de un concepto Tipos de indicaciones Puntos, cuadros, máscaras + Frases de texto, ejemplos de imágenes Capacidad de detección Requiere un detector externo Detector de vocabulario abierto integrado Reconocimiento Solo basado en geometría Reconocimiento visual y de texto Arquitectura Solo rastreador Detector + rastreador con un cabezal de presencia Rendimiento sin ejemplos No aplicable (requiere indicaciones visuales) 47,0 AP en LVIS, el doble de rendimiento en SA-Co Refinamiento interactivo Solo clics Clics + generalización a partir de ejemplos SAM 3 mantiene la compatibilidad con las indicaciones visuales de SAM 2 y añade capacidades basadas en conceptos.
SAM 3 se entrena con el conjunto de datos Segment Anything with Concepts (SA-Co):
Datos de entrenamiento:
- 5,2 M de imágenes con 4 M de frases nominales únicas (SA-Co/HQ): anotaciones humanas de alta calidad
- 52,5 mil vídeos con 24,8 mil frases nominales únicas (SA-Co/VIDEO)
- 1,4 mil millones de máscaras sintéticas en 38 M de frases nominales (SA-Co/SYN)
- 15 conjuntos de datos externos enriquecidos con negativos difíciles (SA-Co/EXT)
Datos de referencia:
- 214 mil conceptos únicos en 126 mil imágenes/vídeos
- 50 veces más conceptos que los conjuntos de referencia existentes (p. ej., LVIS tiene ~4 mil conceptos)
- Anotación triple en SA-Co/Gold para medir los límites del rendimiento humano
Esta escala y diversidad sustentan la generalización sin ejemplos de SAM 3 a conceptos de vocabulario abierto.
SAM 3 y YOLO26 se adaptan a casos de uso diferentes:
Ventajas de SAM 3:
- Vocabulario abierto: segmenta cualquier concepto mediante indicaciones de texto, sin necesidad de entrenamiento
- Sin ejemplos: funciona de inmediato con categorías nuevas
- Interactivo: el refinamiento basado en ejemplos se generaliza a objetos similares
- Basado en conceptos: encuentra automáticamente todas las instancias de una categoría
- Precisión: 47,0 AP en segmentación de instancias sin ejemplos en LVIS
Ventajas de YOLO26:
- Velocidad: inferencia muchísimo más rápida, con un cabezal opcional de extremo a extremo sin NMS
- Eficiencia: modelos 539 veces más pequeños (6,4 MB frente a 3,45 GB)
- Eficiencia de recursos: funciona en dispositivos periféricos y móviles
- Tiempo real: optimizado para implementaciones en producción
Recomendación:
- Usa SAM 3 para una segmentación flexible de vocabulario abierto cuando necesites encontrar todas las instancias de conceptos descritos mediante texto o ejemplos
- Usa YOLO26 para implementaciones de alta velocidad en producción cuando las categorías se conocen de antemano
- Usa SAM 2 para la segmentación interactiva de un solo objeto con indicaciones geométricas
SAM 3 está diseñado para frases nominales sencillas (p. ej., «manzana roja», «persona con sombrero»). Para consultas complejas que requieren razonamiento, combina SAM 3 con un MLLM como SAM 3 Agent:
Consultas sencillas (SAM 3 nativo):
- «autobús escolar amarillo»
- «gato atigrado»
- «persona con sombrero rojo»
Consultas complejas (SAM 3 Agent con MLLM):
- «Personas sentadas que no estén sujetando una caja de regalo»
- «El perro más cerca de la cámara que no lleve collar»
- «Objetos rojos más grandes que la mano de la persona»
SAM 3 Agent alcanza 76,0 gIoU en la validación de ReasonSeg (frente al anterior mejor resultado de 65,0, una mejora del 16,9 %) al combinar la segmentación de SAM 3 con las capacidades de razonamiento de los MLLM.
En la prueba de referencia SA-Co/Gold con triple anotación humana:
- Límite inferior humano: 74,2 CGF1 (anotador más conservador)
- Rendimiento de SAM 3: 65,0 CGF1
- Logro: 88 % del límite inferior humano estimado
- Límite superior humano: 81,4 CGF1 (anotador más permisivo)
SAM 3 logra un rendimiento sólido, cercano a la precisión humana, en la segmentación de conceptos de vocabulario abierto. La diferencia se concentra sobre todo en conceptos ambiguos o subjetivos (p. ej., «ventana pequeña», «habitación acogedora»).


Comentarios105
Haz una pregunta, comparte tus resultados o ayuda a otra persona.
 Glenn JocherUltralytics(editado)
SAM 3 looks like a big step forward for open-vocabulary segmentation, and it is now supported natively in
ultralytics. This page covers text, exemplar and video prompts; thesam3.ptweights are gated and must be requested from Meta on Hugging Face first.Feel free to drop questions or comments for the team below!
7koolfox
Incredible, when you think it’s available for use?
2- Glenn JocherUltralytics(editado)
SAM 3 is available now in
ultralytics: runpip install -U ultralyticsand see this page for usage. Thesam3.ptweights must be requested from Meta first. Abdulhady-WITCo
Appreciate the effort, and can't wait for your implementation. It's resource heavy already but I'm sure your optimisation will make a difference. Best of luck.
- Glenn JocherUltralytics(editado)
Thanks for the kind words—most of the credit goes to the Meta SAM team and the Ultralytics community. SAM 3 is now available in
ultralytics, and this page covers exactly those trade-offs, so you can balance its open-vocabulary power against lighter options like YOLO26 or SAM 2 on your hardware.
mishaogui
sam3如何把預訓練模型導出onnx進行推理,目前官方好像還不支持導出,求導出和推理。
1- Glenn JocherUltralytics(editado)
目前
ultralytics里 SAM 3 只支持predict/track推理,还没有提供把sam3.pt导出 ONNX 的官方流程(yolo export主要面向 YOLO 等可部署导出管线的模型);建议先按 SAM 3 使用文档 用 PyTorch 方式部署推理。如果你的目标是 ONNX 部署分割(固定类别/已知类别),更推荐直接用可导出的 YOLO26 分割 并参考 Export 模式;若你这边是“必须 SAM3→ONNX”的需求,麻烦在 Ultralytics 新建 Issue 说明场景并附上
yolo checks和最小复现脚本,方便我们评估支持路径。
tomer196
Hi, thanks for the great work. I am trying to use sam3.1. Is it supported? I tried using sam3.1 weights, and it seems to work, but each frame the objects get new IDs. Am I doing something wrong? Thanks
- Glenn JocherUltralytics(editado)
SAM 3.1 is supported for image prediction: load
sam3.1_multiplex.ptwherever the image examples usesam3.pt(SAM("sam3.1_multiplex.pt")for point and box prompts,SAM3SemanticPredictorfor text and exemplar prompts). Object Multiplex video tracking is not supported yet, so usesam3.ptwithSAM3VideoPredictororSAM3VideoSemanticPredictor. For stable identities across frames, run a video predictor on the full video rather than image inference frame-by-frame, since per-frame inference assigns fresh IDs each time. See the SAM 3 docs and the SAM predictor reference, and if you’re already doing that please drop a minimal repro plusyolo checksoutput here so the team can take a closer look.
yccckid
你好,我测试下来输入的常见的类别的提示词(包括一些限定词)都是可以分割的。不过提示词输入得越多确实MLLM时间会更长,sam分割倒是挺快的。你说的这个“ 只有在单点(正负样本)和掩码提示(精细化粗糙掩码)是会出现分割源码出现零碎和空洞现象 ”是在分割什么物体?物体的表面纹理是不是比较sparsely textured?怎么解决的?谢谢
On Thu, 23 Apr 2026 at 09:11, Yiwang2333 @.***> wrote:
我之前使用MLLM与SAM3结合起来成为SAM 3 Agent进行测试并没有发现分割的掩码出现空洞问题,他们都是完整的,只不过会出现分割不了提示词中的内容,而且耗时这方面会增加,这也正常。只有在单点(正负样本)和掩码提示(精细化粗糙掩码)是会出现分割源码出现零碎和空洞现象
— Reply to this email directly, view it on GitHub https://github.com/orgs/ultralytics/discussions/22441?email_source=notifications&email_token=APKLLPPMDYK4F36HG6B3BOL4XFUUJA5CNFSNUABIM5UWIORPF5TWS5BNNB2WEL2ENFZWG5LTONUW63SDN5WW2ZLOOQXTCNRWG43TCMBVUZZGKYLTN5XKOY3PNVWWK3TUUVSXMZLOOSWGM33PORSXEX3DNRUWG2Y#discussioncomment-16677105, or unsubscribe https://github.com/notifications/unsubscribe-auth/APKLLPKUZ2OAWS3Y672TETD4XFUUJAVCNFSM6AAAAACJTVH7HGVHI2DSMVQWIX3LMV43URDJONRXK43TNFXW4Q3PNVWWK3TUHMYTMNRXG4YTANI . You are receiving this because you commented.Message ID: @.*** com>
- Glenn JocherUltralytics
这种情况更像是
SAM("sam3.pt")的视觉提示分割问题而不是概念分割本身:单点或粗掩码在细长边界、低对比度或稀疏纹理目标上更容易出现碎片和空洞,通常可通过增加正负点、改用更紧的框提示,或直接用SAM3SemanticPredictor做文本/示例提示来改善,相关用法见 SAM 3 文档;如果你愿意,也欢迎把一张示例图和最小复现代码直接发在这个讨论里,我们可以按你的具体 case 看看。 Yiwang2333
其实我也想把示例和代码文件展示出来,但是可能我太蠢了不知道怎么发在这个讨论中,我已急哭😭
- Glenn JocherUltralytics
没关系,直接发在这里就可以:图片可直接拖到评论框上传,代码按 GitHub Markdown 写法 用代码块贴出;如果文件太大,就先发一个最小复现示例,只保留
model初始化、输入图像、提示词和实际输出即可,例如:from ultralytics import SAM model = SAM("sam3.pt") results = model.predict("test.jpg", points=[900, 370], labels=[1]) print(results[0].masks.data.shape if results[0].masks is not None else None)如果暂时不方便传图,也可以先把异常现象和文字版输出贴出来,我们继续帮你看。
一、单点分割 import numpy as np import torch from PIL import Image from sam3.model_builder import build_sam3_image_model from sam3.model.sam3_image_processor import Sam3Processor
device = "cuda" if torch.cuda.is_available() else "cpu" sam3_pt_path = "sam3_model/sam3.pt"
model = build_sam3_image_model( bpe_path=None, checkpoint_path=sam3_pt_path, device=device, enable_inst_interactivity=True, load_from_HF=False, ) processor = Sam3Processor(model) model.eval()
pil_image = Image.open("test.jpg").convert("RGB") inference_state = processor.set_image(pil_image)
正样本(1) + 负样本(0),点数与标签一一对应
point_coords = np.array([ [900.0, 370.0], # 前景点:点在目标上 [800.0, 400.0], # 背景点:点在要排除的区域 ]) point_labels = np.array([1, 0])
masks, scores, logits = model.predict_inst( inference_state, point_coords=point_coords, point_labels=point_labels, multimask_output=True, ) best = masks[int(np.argmax(scores))] mask_np = best.cpu().numpy() if isinstance(best, torch.Tensor) else np.asarray(best) print(mask_np.shape)
二、交互式细化 import numpy as np import torch from PIL import Image from sam3.model_builder import build_sam3_image_model from sam3.model.sam3_image_processor import Sam3Processor
device = "cuda" if torch.cuda.is_available() else "cpu" sam3_pt_path = "sam3_model/sam3.pt"
model = build_sam3_image_model( bpe_path=None, checkpoint_path=sam3_pt_path, device=device, enable_inst_interactivity=True, load_from_HF=False, ) processor = Sam3Processor(model) model.eval()
pil_image = Image.open("test.jpg").convert("RGB") inference_state = processor.set_image(pil_image)
若需要文本提示(与 demo 一致):
inference_state = processor.set_text_prompt(state=inference_state, prompt="your english prompt")
init_x = 900.0 init_y = 370.0 refinement_points = [[910.0, 380.0], [920.0, 360.0]] refinement_labels = [1, 0]
all_points = [[init_x, init_y]] + refinement_points all_labels = [1] + refinement_labels
masks, scores, logits = model.predict_inst( inference_state, point_coords=np.array(all_points), point_labels=np.array(all_labels), multimask_output=True, ) best = masks[int(np.argmax(scores))] mask_np = best.cpu().numpy() if isinstance(best, torch.Tensor) else np.asarray(best) print(mask_np.shape)
测试使用的是同一张图片,分割的内容是图中汽车,在单点分割和交互式细化中正负样本点结合使用会出现分割车辆边缘出现参差不齐零碎现象
- Glenn JocherUltralytics
感谢把代码贴出来,这更像是交互式点提示的行为而不是“汽车”这个类别本身:车窗反光、轮胎空隙和细长边界会让负点一旦靠近车身就容易把掩码边缘切碎或挖空,而且
multimask_output=True返回的最高分候选也不一定是最平滑的那个;建议先把负点移到目标外更远的位置、在断裂边缘补几个正点,或直接改用框/示例提示,如果你的目标是稳定分割整辆车,SAM3SemanticPredictor的文本/示例提示通常比稀疏点提示更稳,相关接口可参考 SAM 3 文档里的视觉提示与概念分割说明。 感谢您的回答,我还有一个问题,就是文本提示分割时,文本提示词可以对多张图片起作用,能做输入一个文本可以对所有图片进行分割,这一个功能已经实现。 但是有一个我实在是难以实现,就是比如有多张图片A、B、C、D...,在纯框选示例提示分割下,能不能做到只在A图上进行框选,然后进行纯框选示例提示分割时可以对A、B、C、D...多张图片进行分割呢。也就是实现一批图片中,只在一张图片上进行框选就能进行所有图片的分割,类似于图片搜索一样,在一批图片中随机挑一张图片,在这张挑选的图片中框选出汽车然后所有图片中的汽车都能被分割出来(类似在一批图片中框选后搜索出有汽车的图片进行分割)。我不知道这个功能是否能做到。 目前我使用的方法是在框选时将框选的目标进行切块,然后拼接在每一张待搜索图片上,最后根据拼接图片中的小目标切块进行示例提示分割,来实现一张图中框选能对所有图片进行分割,不过这种方法的效果有些一般,有时候分割不到东西或者是遗漏一些需要分割的目标。 还有一种方法是评论区向我提供的思路,将几何特征缓存下来,然后再另一张图片上应用这个几何特征,参考https://github.com/leon0514/trt-sam3,但是这位先生也提到了效果不好,目前我也正在尝试实现这种方法。 或者是理解在单图时框选示例提示分割到底在做什么,然后将这个行为重复作用于其他图片,这样是否也能实现呢?
- Glenn JocherUltralytics
目前原生
SAM3SemanticPredictor还不支持“在 A 图框一次,然后直接对 B/C/D 这类独立图片做纯示例检索+分割”;bboxes示例提示是作用在当前set_image()的那张图上,而文档里的inference_features()也是复用同一张图的特征、不是跨图迁移,所以更可靠的做法还是先用文本提示或检索/检测筛出候选图,再逐张做 SAM 3 分割,接口细节可参考 SAM3SemanticPredictor 参考。 好的,谢谢您的回复
shspc
ultralytics支持从其他图像中抽取特征作为视觉提示吗
在SAM3中
- Glenn JocherUltralytics
目前公开接口里,SAM 3 支持用
SAM3SemanticPredictor的bboxes做 exemplar 式视觉提示,也支持用inference_features()复用已提取特征,但文档里的用法主要是对当前图像做特征复用,不是直接把“另一张图像”的特征当作 prompt 传入;你可以先参考 SAM 3 文档 和 predictor API,如果你的目标是跨图像 exemplar prompting,欢迎把最小复现流程贴在这里,团队会继续看。 aoaoy288-oss
想知道,sam3是否能导成ONNX等格式
ZePequeno25
gostei bastante da para integrar diferentes modelos
SWTZJD
想请问SAM3最低支持的python版本和pytorch版本
- Glenn JocherUltralytics
欢迎直接把环境信息贴在这里,团队会看到;按目前公开信息,
SAM 3自ultralytics>=8.3.237起已集成,而ultralytics的基础要求是 Python>=3.8、PyTorch>=1.8,所以SAM 3目前至少按这组版本起步,参考 SAM 3 文档 和 Ultralytics PyPI 安装说明。 (docs.ultralytics.com)
cyt1990cyt1990-dev
运行环境为:Ultralytics 8.4.21 Python-3.11.8 torch-2.5.1+cu121 CUDA:0 (NVIDIA GeForce RTX 4070, 12282MiB) 运行使用掩码提示的概念分割的示例程序报错如下:WARNING imgsz=[640] must be multiple of max stride 14, updating to [644] Traceback (most recent call last): File "C:\Users\admin\PycharmProjects\PythonProject\testMasks.py", line 12, in results = predictor(source=img_path, masks=[rough]) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\engine\predictor.py", line 225, in call return list(self.stream_inference(source, model, *args, **kwargs)) # merge list of Results into one ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\utils_contextlib.py", line 36, in generator_context response = gen.send(None) ^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\engine\predictor.py", line 330, in stream_inference preds = self.inference(im, *args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 205, in inference return self.prompt_inference(im, bboxes, points, labels, masks, multimask_output) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 236, in prompt_inference return self._inference_features(features, *prompts, multimask_output) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 814, in _inference_features pred_masks, pred_scores, _, _ = self.model.sam_mask_decoder( ^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\nn\modules\module.py", line 1736, in _wrapped_call_impl return self._call_impl(*args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\nn\modules\module.py", line 1747, in _call_impl return forward_call(*args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\modules\decoders.py", line 334, in forward masks, iou_pred, mask_tokens_out, object_score_logits = self.predict_masks( ^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\modules\decoders.py", line 398, in predict_masks src = src + dense_prompt_embeddings ~~~~^~~~~~~~~~~~~~~~~~~~~~~~~ RuntimeError: The size of tensor a (46) must match the size of tensor b (161) at non-singleton dimension 3
运行代码如下所示: import cv2 import numpy as np from ultralytics.models.sam import SAM3Predictor
predictor = SAM3Predictor(overrides=dict(task="segment", mode="predict", model="sam/sam3.pt")) img_path = "测试图片/测试图片1/Out.jpg" rough = cv2.imread("测试图片/测试图片1/rough.jpg", cv2.IMREAD_GRAYSCALE) rough = (rough > 0).astype(np.uint8)
results = predictor(source=img_path, masks=[rough]) for result in results: annotated_img = result.plot() cv2.imshow("SAM with Mask Prompt", annotated_img) cv2.waitKey(0) cv2.destroyAllWindows()
图片Out.jpg,rough.jpg是大小为4024*3036,位深度为8的灰度图片
- Glenn JocherUltralytics
感谢补充代码,这个报错看起来不是图片分辨率本身的问题,而是
SAM3Predictor走masks=提示时出现了特征尺寸不匹配;按 SAM 3 文档 当前概念分割应使用SAM3SemanticPredictor配合text或示例bboxes,而SAM("sam3.pt")/SAM3Predictor主要是单对象视觉提示流程。若你在最新版本下仍需要masks提示,请新开一个 issue 并附上yolo checks输出、完整文本回溯和最小可复现脚本,方便我们确认这是否是 SAM 3 的一个 bug。
max-dev-14
I'd compared facebook/sam3 and ultralytics/sam3. I set up both the models for inference as follow: imgsz=1008, half=True, conf=0.5 and prompts = [ "person", "car", "truck", "tractor", "building", "combine harvester", "power lines", "clear sky", "trees", "crop field", "harvested field", "grassy field", "dark frame edges", "farm lane", "windrow" ] I'd attached scripts I used for inference: ul-sam3.py - ultralytics/sam3 inference. fb-sam3.py - facebook/sam3 inference.
I expected that there would be the same results of inference on the same videos and paramteres above. But I'd got different segments, as it can be seen on the screens below (there are original frame to the left, facebook/sam3 segmentation on the middle and ultralytics/sam3 segmentation to the right).
Can someone explain me why it's happened like this?
- Glenn JocherUltralytics
Thanks for raising it here — exact parity with
facebookresearch/sam3isn’t expected, because the Ultralytics integration uses its own SAM 3 predictor path for resizing/preprocessing and postprocessing, so matchingimgsz,half,conf, and prompts alone won’t guarantee identical masks; see the SAM 3 docs and the predictor reference. If you’d like us to check whether this is a bug rather than an implementation difference, please open a new issue with a minimal reproducible example, confirm both runs use the samesam3.pt, and includeyolo checksplus the full text outputs from both scripts.