YOLOv10: detección de objetos integral en tiempo real
YOLOv10, lanzado en mayo de 2024 y desarrollado sobre el paquete de Python de Ultralytics por investigadores de la Universidad de Tsinghua, introduce un nuevo enfoque para la detección de objetos en tiempo real que aborda las deficiencias del posprocesamiento y de la arquitectura del modelo presentes en versiones anteriores de YOLO. Al eliminar la supresión no máxima (NMS) y optimizar diversos componentes del modelo, YOLOv10 logró un rendimiento sólido con una reducción significativa de la sobrecarga computacional en el momento de su lanzamiento. Su diseño integral sin NMS fue pionero en un enfoque que se ha seguido desarrollando en YOLO26.
Ver: Cómo entrenar YOLOv10 con el conjunto de datos SKU-110k mediante Ultralytics | Conjunto de datos para comercios
Descripción general#
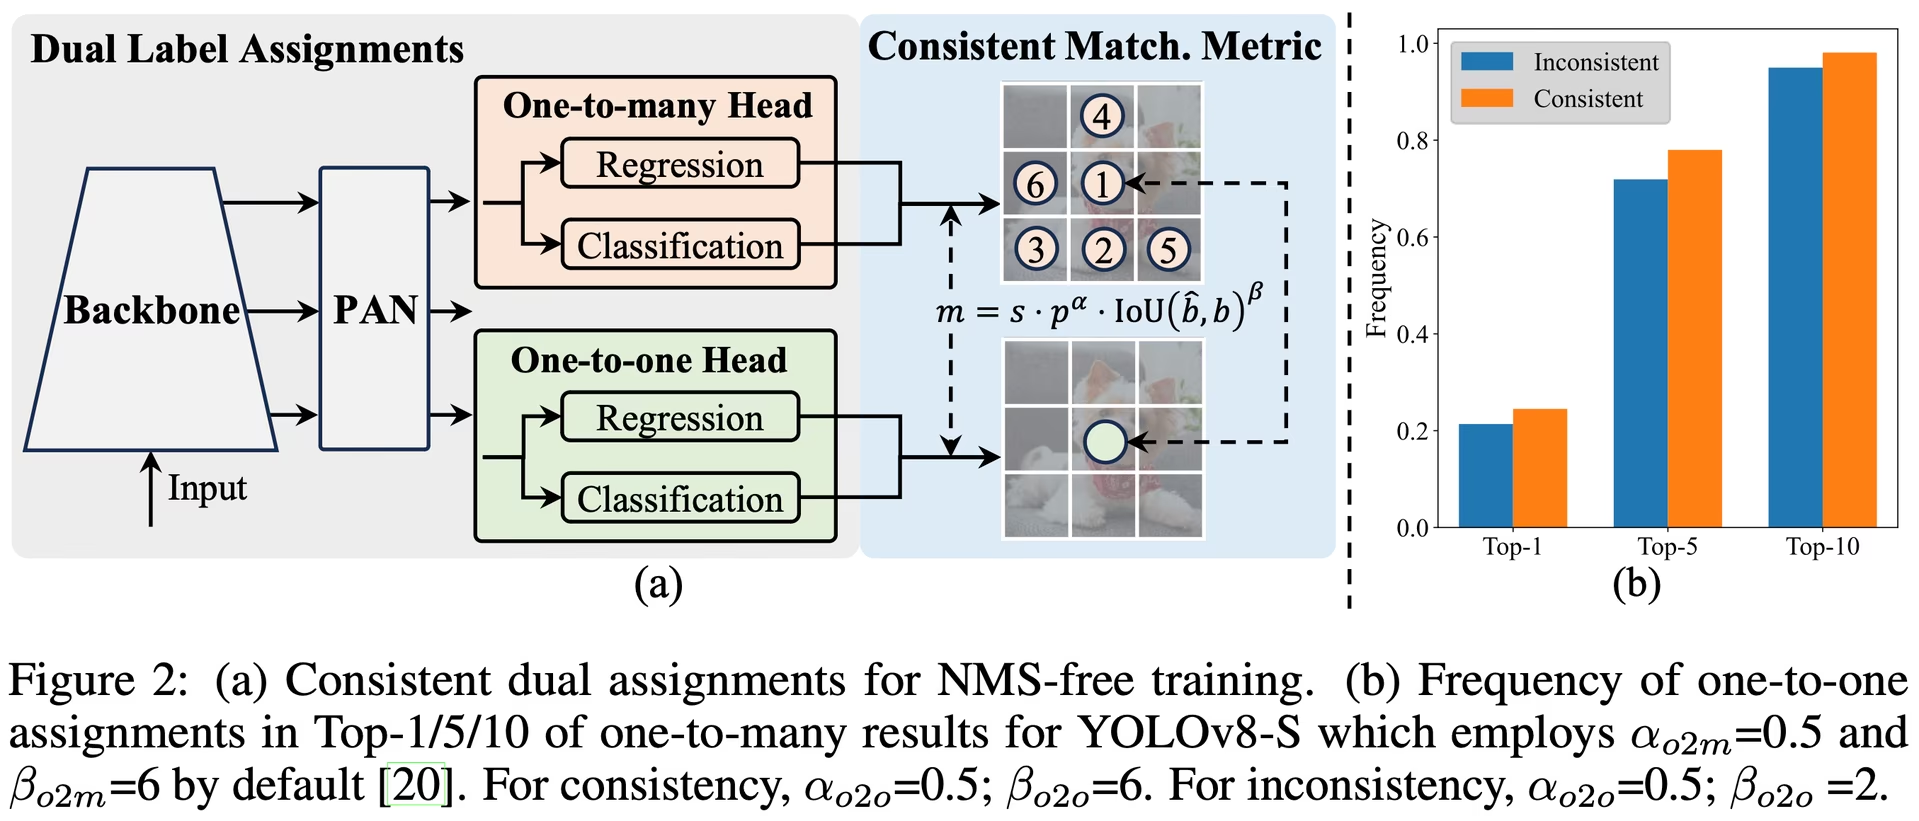
La detección de objetos en tiempo real busca predecir con precisión las categorías y posiciones de los objetos en imágenes con baja latencia. La serie YOLO ha estado a la vanguardia de esta investigación gracias a su equilibrio entre rendimiento y eficiencia. Sin embargo, la dependencia de NMS y las ineficiencias arquitectónicas han impedido alcanzar un rendimiento óptimo. YOLOv10 aborda estos problemas introduciendo asignaciones duales coherentes para entrenar sin NMS y una estrategia integral de diseño de modelos que impulsa la eficiencia y la precisión.
Arquitectura#
La arquitectura de YOLOv10 aprovecha las ventajas de los modelos YOLO anteriores e incorpora varias innovaciones clave. La arquitectura del modelo consta de los siguientes componentes:
- Backbone: Se encarga de la extracción de características. El backbone de YOLOv10 utiliza una versión mejorada de CSPNet (red parcial entre etapas) para optimizar el flujo del gradiente y reducir la redundancia computacional.
- Cuello: El cuello está diseñado para agregar características de distintas escalas y pasarlas a la cabeza. Incluye capas PAN (red de agregación de rutas) para fusionar eficazmente características multiescala.
- Cabeza de asignación uno a muchos: Genera varias predicciones por objeto durante el entrenamiento para proporcionar abundantes señales de supervisión y mejorar la precisión del aprendizaje.
- Cabezal uno a uno: genera una única predicción óptima por objeto durante la inferencia para eliminar la necesidad de NMS, lo que reduce la latencia y mejora la eficiencia.
Características principales#
- Entrenamiento sin NMS: utiliza asignaciones duales coherentes para eliminar la necesidad de NMS y reducir la latencia de inferencia.
- Diseño integral del modelo: optimización exhaustiva de varios componentes desde las perspectivas de la eficiencia y la precisión, incluidos cabezales de clasificación ligeros, submuestreo desacoplado espacial y por canales, y diseño de bloques guiado por el rango.
- Capacidades mejoradas del modelo: incorpora convoluciones con kernels grandes y módulos parciales de autoatención para mejorar el rendimiento sin un coste computacional significativo.
Variantes del modelo#
YOLOv10 ofrece modelos de distintas escalas para adaptarse a las necesidades de diferentes aplicaciones:
- YOLOv10n: versión nano para entornos con recursos extremadamente limitados.
- YOLOv10s: versión pequeña que equilibra velocidad y precisión.
- YOLOv10m: versión mediana para uso general.
- YOLOv10b: versión equilibrada con mayor anchura para lograr más precisión.
- YOLOv10l: versión grande para lograr más precisión a costa de un mayor consumo de recursos computacionales.
- YOLOv10x: versión extragrande para obtener la máxima precisión y rendimiento.
Rendimiento#
En el momento de su lanzamiento, YOLOv10 superó a las versiones anteriores de YOLO y a otros modelos de última generación en precisión y eficiencia. Por ejemplo, YOLOv10s es 1,8 veces más rápido que RT-DETR-R18, con un AP similar en el conjunto de datos COCO, y YOLOv10b tiene un 46 % menos de latencia y un 25 % menos de parámetros que YOLOv9-C con el mismo rendimiento.
Latencia medida con TensorRT FP16 en una GPU T4.
| Modelo | Tamaño de entrada | APval50-95 | FLOPs (G) | Latencia (ms) |
|---|---|---|---|---|
| [YOLOv10n][1] | 640 | 38.5 | 6.7 | 1.84 |
| [YOLOv10s][2] | 640 | 46.3 | 21.6 | 2.49 |
| [YOLOv10m][3] | 640 | 51.1 | 59.1 | 4.74 |
| [YOLOv10b][4] | 640 | 52.5 | 92.0 | 5.74 |
| [YOLOv10l][5] | 640 | 53.2 | 120.3 | 7.28 |
| [YOLOv10x][6] | 640 | 54.4 | 160.4 | 10.70 |
Metodología#
Asignaciones duales coherentes para el entrenamiento sin NMS#
YOLOv10 utiliza asignaciones duales de etiquetas, que combinan estrategias de uno a muchos y de uno a uno durante el entrenamiento para garantizar una supervisión completa y una implementación integral eficiente. La predicción y la validación de Ultralytics utilizan de forma predeterminada la cabeza de uno a muchos con NMS; establece nms=False para seleccionar la cabeza sin NMS. La métrica de correspondencia coherente alinea la supervisión de ambas estrategias y mejora la calidad de las predicciones durante la inferencia.
Diseño integral del modelo orientado a la eficiencia y la precisión#
Mejoras de eficiencia#
- Cabezal de clasificación ligero: reduce la carga computacional del cabezal de clasificación mediante convoluciones separables en profundidad.
- Submuestreo desacoplado espacial y por canales: desacopla la reducción espacial y la modulación de canales para minimizar la pérdida de información y el coste computacional.
- Diseño de bloques guiado por el rango: adapta el diseño de los bloques a la redundancia intrínseca de cada etapa para garantizar un uso óptimo de los parámetros.
Mejoras de precisión#
- Convolución de kernel grande: amplía el campo receptivo para mejorar la capacidad de extracción de características.
- Autoatención parcial (PSA): incorpora módulos de autoatención para mejorar el aprendizaje de representaciones globales con una sobrecarga mínima.
Experimentos y resultados#
YOLOv10 se evaluó con pruebas de referencia estándar, como COCO. En el momento de su lanzamiento, todas las variantes mejoraban el equilibrio entre latencia y precisión respecto a las versiones anteriores de YOLO y otros detectores contemporáneos.
Comparaciones#
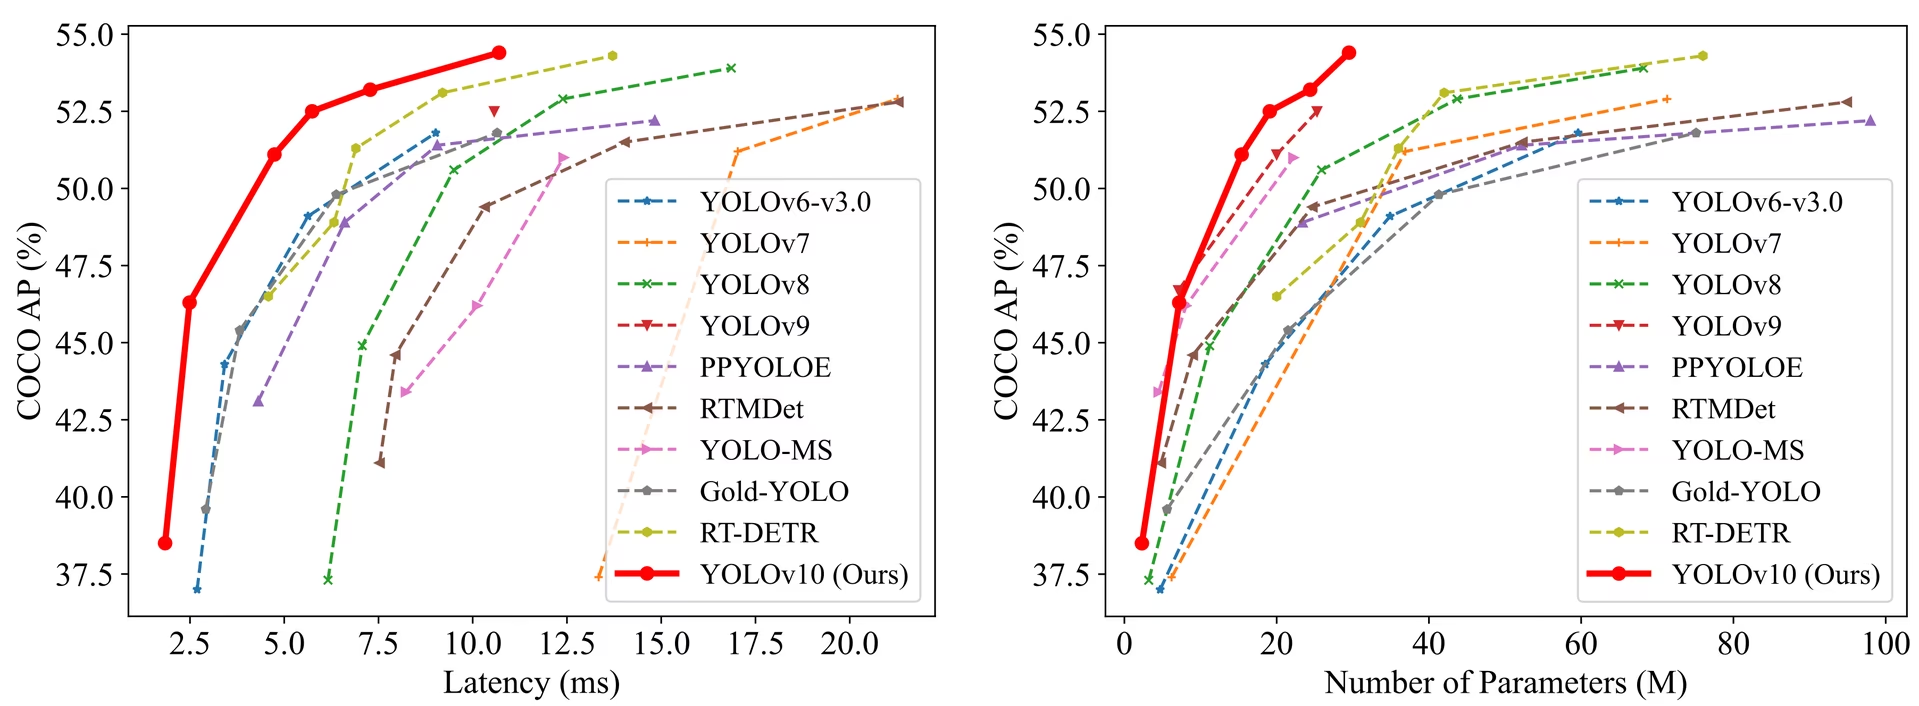
En comparación con otros detectores de vanguardia:
- YOLOv10s / x son 1,8× / 1,3× más rápidos que RT-DETR-R18 / R101 con una precisión similar
- YOLOv10b tiene un 25 % menos de parámetros y una latencia un 46 % menor que YOLOv9-C con la misma precisión
- YOLOv10l / x superan a YOLOv8l / x por 0,3 AP / 0,5 AP con 1,8× / 2,3× menos parámetros
Las cifras siguientes son las que se indican en el artículo de YOLOv10 y se han medido según su propio protocolo, por lo que no son directamente comparables con los valores de las páginas de modelos de Ultralytics:
| Modelo | Parámetros (M) | FLOPs (G) | mAPval50-95 | Latencia (ms) | Latencia en la pasada hacia delante (ms) |
|---|---|---|---|---|---|
| YOLOv6-3.0-N | 4.7 | 11.4 | 37.0 | 2.69 | 1.76 |
| Gold-YOLO-N | 5.6 | 12.1 | 39.6 | 2.92 | 1.82 |
| YOLOv8n | 3.2 | 8.7 | 37.3 | 6.16 | 1.77 |
| YOLOv10n | 2.3 | 6.7 | 38.5 | 1.84 | 1.79 |
| YOLOv6-3.0-S | 18.5 | 45.3 | 44.3 | 3.42 | 2.35 |
| Gold-YOLO-S | 21.5 | 46.0 | 45.4 | 3.82 | 2.73 |
| YOLOv8s | 11.2 | 28.6 | 44.9 | 7.07 | 2.33 |
| YOLOv10s | 7.2 | 21.6 | 46.3 | 2.49 | 2.39 |
| RT-DETR-R18 | 20.0 | 60.0 | 46.5 | 4.58 | 4.49 |
| YOLOv6-3.0-M | 34.9 | 85.8 | 49.1 | 5.63 | 4.56 |
| Gold-YOLO-M | 41.3 | 87.5 | 49.8 | 6.38 | 5.45 |
| YOLOv8m | 25.9 | 78.9 | 50.6 | 9.50 | 5.09 |
| YOLOv10m | 15.4 | 59.1 | 51.1 | 4.74 | 4.63 |
| YOLOv6-3.0-L | 59.6 | 150.7 | 51.8 | 9.02 | 7.90 |
| Gold-YOLO-L | 75.1 | 151.7 | 51.8 | 10.65 | 9.78 |
| YOLOv8l | 43.7 | 165.2 | 52.9 | 12.39 | 8.06 |
| RT-DETR-R50 | 42.0 | 136.0 | 53.1 | 9.20 | 9.07 |
| YOLOv10l | 24.4 | 120.3 | 53.2 | 7.28 | 7.21 |
| YOLOv8x | 68.2 | 257.8 | 53.9 | 16.86 | 12.83 |
| RT-DETR-R101 | 76.0 | 259.0 | 54.3 | 13.71 | 13.58 |
| YOLOv10x | 29.5 | 160.4 | 54.4 | 10.70 | 10.60 |
Los valores de parámetros y FLOPs corresponden al modelo fusionado tras model.fuse(), que combina las capas Conv y BatchNorm y elimina el cabezal auxiliar de detección uno a muchos. Los puntos de control preentrenados conservan la arquitectura completa de entrenamiento y pueden mostrar cifras más altas.
Ejemplos de uso#
También puedes entrenar modelos en GPU en la nube a través de Ultralytics Platform. Para hacer predicciones sobre imágenes nuevas con YOLOv10:
from ultralytics import YOLO

# Carga un modelo YOLOv10n preentrenado
model = YOLO("yolov10n.pt")

# Detectar objetos en una imagen
results = model("image.jpg")

# Muestra los resultados
results[0].show()
Para entrenar YOLOv10 con un conjunto de datos personalizado:
from ultralytics import YOLO

# Carga el modelo YOLOv10n desde cero
model = YOLO("yolov10n.yaml")

# Entrenar el modelo
model.train(data="coco8.yaml", epochs=100, imgsz=640)
Tareas y modos compatibles#
La serie de modelos YOLOv10 ofrece diversos modelos, cada uno optimizado para la detección de objetos. Las variantes cubren distintos presupuestos computacionales y requisitos de precisión.
| Modelo | Nombres de archivo | Tareas | Entrenamiento | Validación | Inferencia | Exportar |
|---|---|---|---|---|---|---|
| YOLOv10 | yolov10n.pt yolov10s.pt yolov10m.pt yolov10b.pt yolov10l.pt yolov10x.pt | Detección de objetos | ✅ | ✅ | ✅ | ✅ |
Exportar YOLOv10#
Debido a las nuevas operaciones introducidas con YOLOv10, actualmente no son compatibles todos los formatos de exportación que ofrece Ultralytics. La tabla siguiente enumera los formatos a los que Ultralytics ha convertido YOLOv10 correctamente. Se aceptan solicitudes de incorporación de cambios que añadan compatibilidad con otros formatos de exportación.
| Formato de exportación | Compatibilidad con la exportación | Inferencia del modelo exportado | Notas |
|---|---|---|---|
| TorchScript | ✅ | ✅ | Formato estándar de modelo PyTorch. |
| ONNX | ✅ | ✅ | Ampliamente compatible para la implementación. |
| OpenVINO | ✅ | ✅ | Optimizado para hardware Intel. |
| TensorRT | ✅ | ✅ | Optimizado para GPU NVIDIA. |
| CoreML | ✅ | ✅ | Limitado a dispositivos Apple. |
| TF SavedModel | ✅ | ✅ | Formato estándar de modelo de TensorFlow. |
| TF GraphDef | ✅ | ✅ | Formato heredado de TensorFlow. |
| TF Edge TPU | ✅ | ✅ | Específico para dispositivos Edge TPU de Google. |
| LiteRT | ✅ | ✅ | Optimizado para móviles, sistemas integrados y navegadores (LiteRT.js). |
| PaddlePaddle | ✅ | ✅ | Popular en China; con menor compatibilidad a escala global. |
| NCNN | ✅ | ✅ | Optimizado para dispositivos móviles e integrados. |
Conclusión#
En el momento de su lanzamiento, YOLOv10 impulsó la detección de objetos en tiempo real al eliminar el posprocesamiento NMS y rediseñar los componentes del modelo para mejorar tanto la eficiencia como la precisión. Su enfoque sin NMS fue pionero en la detección de objetos integral en la familia YOLO. YOLO26, el modelo más reciente de Ultralytics, amplía este enfoque con un rendimiento mejorado e inferencia sin NMS.
Citas y agradecimientos#
Queremos agradecer a los autores de YOLOv10 de la Universidad Tsinghua su exhaustiva investigación y sus importantes contribuciones al framework de Ultralytics:
@inproceedings{wang2024yolov10,
  title={YOLOv10: Real-Time End-to-End Object Detection},
  author={Wang, Ao and Chen, Hui and Liu, Lihao and Chen, Kai and Lin, Zijia and Han, Jungong and Ding, Guiguang},
  booktitle={Advances in Neural Information Processing Systems},
  doi = {10.52202/079017-3429},
  url = {https://proceedings.neurips.cc/paper_files/paper/2024/file/c34ddd05eb089991f06f3c5dc36836e0-Paper-Conference.pdf},
  volume={37},
  pages={107984--108011},
  year={2024}
}
Para obtener información detallada sobre la implementación, las innovaciones arquitectónicas y los resultados experimentales, consulta el artículo de investigación de YOLOv10 y el repositorio de GitHub del equipo de la Universidad Tsinghua.
Preguntas frecuentes#
YOLOv10, desarrollado por investigadores de la Universidad de Tsinghua, introduce varias innovaciones clave en la detección de objetos en tiempo real. Elimina la necesidad de supresión no máxima (NMS) mediante asignaciones duales coherentes durante el entrenamiento y optimiza los componentes del modelo para reducir la sobrecarga computacional.
Ejecuta inferencias con la API de Python de Ultralytics o la interfaz de línea de comandos (CLI). A continuación se muestran ejemplos de predicción con YOLOv10 en imágenes nuevas:
Ejemplofrom ultralytics import YOLO # Carga el modelo YOLOv10n preentrenado model = YOLO("yolov10n.pt") results = model("image.jpg") results[0].show()Para ver más ejemplos de uso, visita la sección Ejemplos de uso.
YOLOv10 ofrece varias variantes de modelo para adaptarse a distintos casos de uso:
- YOLOv10n: Adecuado para entornos con recursos extremadamente limitados
- YOLOv10s: Equilibra velocidad y precisión
- YOLOv10m: Uso general
- YOLOv10b: Mayor precisión con una anchura superior
- YOLOv10l: Gran precisión a costa de más recursos computacionales
- YOLOv10x: Máxima precisión y rendimiento
Cada variante está diseñada para distintas necesidades computacionales y requisitos de precisión, lo que las hace versátiles para una gran variedad de aplicaciones. Consulta la sección Variantes del modelo para obtener más información.
YOLOv10 se entrena con asignaciones duales coherentes, de modo que su cabezal uno a uno genera una única predicción óptima por objeto, lo que elimina la necesidad de aplicar la supresión no máxima (NMS) durante la inferencia. La predicción y la validación de Ultralytics usan por defecto el cabezal uno a muchos con NMS; establece
nms=Falsepara seleccionar el cabezal sin NMS y omitir el paso de NMS. Para obtener una explicación detallada, consulta la sección Asignaciones duales coherentes para el entrenamiento sin NMS.YOLOv10 admite varios formatos de exportación, como TorchScript, ONNX, OpenVINO y TensorRT. Sin embargo, actualmente no admite todos los formatos de exportación que ofrece Ultralytics debido a sus nuevas operaciones. Para consultar los formatos admitidos y las instrucciones de exportación, visita la sección Exportar YOLOv10.
En el momento de su lanzamiento, YOLOv10 superó a las versiones anteriores de YOLO y a otros modelos de última generación tanto en precisión como en eficiencia. Por ejemplo, YOLOv10s es 1,8 veces más rápido que RT-DETR-R18 con un AP similar en el conjunto de datos COCO. YOLOv10b presenta un 46 % menos de latencia y un 25 % menos de parámetros que YOLOv9-C con el mismo rendimiento. En la sección Comparaciones encontrarás pruebas de rendimiento detalladas.


Comentarios188
Haz una pregunta, comparte tus resultados o ayuda a otra persona.
 Glenn JocherUltralytics(editado)
I'm super excited about the groundbreaking work on YOLOv10 by the researchers at Tsinghua University. Just a week ago, @pderrenger and I had the privilege of presenting YOLO to ML graduate students at Tsinghua University in Shenzhen, and I was thoroughly impressed by their enthusiasm and expertise.
Now, seeing the remarkable advancements in real-time object detection with YOLOv10, I'm thrilled to collaborate with the Tsinghua team to officially bring YOLOv10 support to the Ultralytics Python package soon. The innovative approach to NMS-free training and holistic model design optimizations demonstrates their commitment to pushing the boundaries of what's possible.
Stay tuned for the official release of YOLOv10 support in the Ultralytics package, and get ready to experience the incredible capabilities of this revolutionary real-time object detector!
38jameslahm
Thank you so much for your great support for YOLOv10! We are truly grateful for your efforts to bring YOLOv10 to the Ultralytics package. ❤️
2
heynewyeah
您好。如果我想在训练结束后,以last.pt的模型权重继续训练(因为还未收敛),有什么办法能获取last epoch的优化器状态吗,用于继续训练。或者有什么其他方法能够完成继续训练吗?
alephpi(editado)
from ultralytics import YOLO

# Load a model
model = YOLO("path/to/last.pt")  # load a partially trained model

# Resume training
results = model.train(resume=True)
Anser1
Hello, I'm sorry to disturb you. I want to conduct the training for the segmentation task based on YOLOv10, but I found that there seems to be no YAML structure file for the segmentation model. What should I do?
zlj127
Does YOLOv10 have the pose function? Currently, I have only found a pre-trained model for gestures under the GitHub of the Hagrid dataset, but it is still used for detection.
- Glenn JocherUltralytics(editado)
@zlj127 YOLOv10 currently focuses on object detection tasks and does not include built-in pose estimation functionality. For pose/keypoint estimation, we recommend using YOLO26 which offers integrated support for pose estimation along with detection, segmentation, and classification. See the YOLO26 Pose documentation for implementation details and code examples.
ok,thank you
- Glenn JocherUltralytics(editado)
@zlj127 you're welcome! For pose estimation tasks, we recommend using YOLO26 which offers integrated support. Let us know if you need help getting started with the Pose documentation.
gniqeh
It is important to configure the correct threshold of dual label assignments in the paper. But how can we change the threshold in yolov10 of ultralytics module?
Es importante configurar el umbral correcto de asignaciones de etiquetas duales en el documento. pero ¿cómo podemos cambiar el umbral en yolov10 del módulo ultralytics?
- Glenn JocherUltralytics(editado)
@gniqeh the dual label assignment settings are not exposed in the model YAML or as training arguments. They are set in the loss code (
E2EDetectLossinultralytics/utils/loss.py), where the one-to-many branch usestal_topk=10and the one-to-one branch usestal_topk=1. To change them, edit those values in a local copy of the package. For details, see the YOLOv10 Ultralytics documentation. Let us know if you need further clarification! Thx for your reply my friend, I have checked the documentation and API ref. of yolov10 but there is only the basical introductiong about it. And i am pleasure if u can provide further implementation explaining. Thanks again!
- Glenn JocherUltralytics
Thank you for your feedback! For a deeper understanding of YOLOv10 implementation, you can explore the specifics of its architecture and features in the YOLOv10 documentation. If you have particular aspects or technical details you'd like clarified, feel free to let us know!
Ly2003ykjy
Are YOLOV10 and 11 really superior to v7 and v8 in small target detection?
- Glenn JocherUltralytics
YOLOv10 and YOLO11 introduce innovations like NMS-free training, which can enhance small target detection performance compared to YOLOv7 and YOLOv8, but results may vary based on specific use cases and datasets.
abaldanz
Hello, do you plan to provide weights for the pre-trained model on 1280p size images?
- Glenn JocherUltralytics
@abaldanz thank you for your interest. Currently, we don't have plans to provide pre-trained weights specifically for 1280p images. For updates, please keep an eye on our repository and documentation.
Yuwenliula
请问一下,yolov10是否内置了IOU计算的功能,在val结果中未见到IOU的输出,如果没有的话,能方便提供代码进行IOU计算吗?
- Glenn JocherUltralytics
@Yuwenliula yOLOv10 does not directly output IoU in validation results. You can calculate IoU using the bounding box coordinates from the model's predictions. If you need further assistance, please refer to the Ultralytics documentation for guidance.
qruiwu
what is the each parameter mean in results.csv after training a model?
- Glenn JocherUltralytics
@wuqrcn the
results.csvfile contains metrics such as precision, recall, mAP, and loss values for each epoch during training. These metrics help evaluate the model's performance and convergence. For more details, please refer to the documentation.
alifazeli00
Why do the weights uploaded here: https://github.com/THU-MIG/yolov10?tab=readme-ov-file#performance not give the same results on the dataset as the weights uploaded on Ultralytics? I checked their architectures, and they seem to be identical.
- Glenn JocherUltralytics
@alifazeli00 the difference in results might be due to variations in training data, hyperparameters, or preprocessing steps. Ensure both models are evaluated under identical conditions for accurate comparison.
They are all the same except for the val_period parameter, which is only present in the THU-MIG model. However, the Ultralytics model performs better. I tested x and noticed differences in the weights. Are you saying that these two models should produce identical results?
- Glenn JocherUltralytics
The differences in results could be due to variations in training data, hyperparameters, or preprocessing steps. Ensure both models are evaluated under identical conditions for accurate comparison.
-1