Guide pas à pas pour entraîner des modèles YOLO26 avec IBM Watsonx
Les solutions de vision par ordinateur évolutives nécessitent une infrastructure pour les données, l’entraînement et le déploiement. IBM Watsonx est une plateforme d’IA et de données qui prend en charge le développement, le déploiement et la gestion des modèles d’IA. Elle couvre l’ensemble du cycle de vie de l’IA et s’intègre aux services IBM Cloud.
Tu peux entraîner des modèles Ultralytics YOLO26 avec IBM Watsonx. C’est une bonne option pour les entreprises qui souhaitent optimiser l’entraînement des modèles, effectuer un réglage fin pour des tâches spécifiques et améliorer les performances des modèles grâce à des outils robustes et à une configuration conviviale. Ce guide t’explique comment entraîner YOLO26 avec IBM Watsonx, de la configuration de ton environnement à l’évaluation des modèles entraînés.
Qu’est-ce qu’IBM Watsonx ?#
Watsonx est la plateforme cloud d’IBM conçue pour l’IA générative commerciale et les données scientifiques. Les trois composants d’IBM Watsonx — watsonx.ai, watsonx.data et watsonx.governance — constituent une plateforme d’IA fiable de bout en bout, capable d’accélérer les projets d’IA visant à résoudre des problèmes métier. Elle fournit des outils pour créer, entraîner et déployer des modèles de machine learning, et facilite la connexion à diverses sources de données.
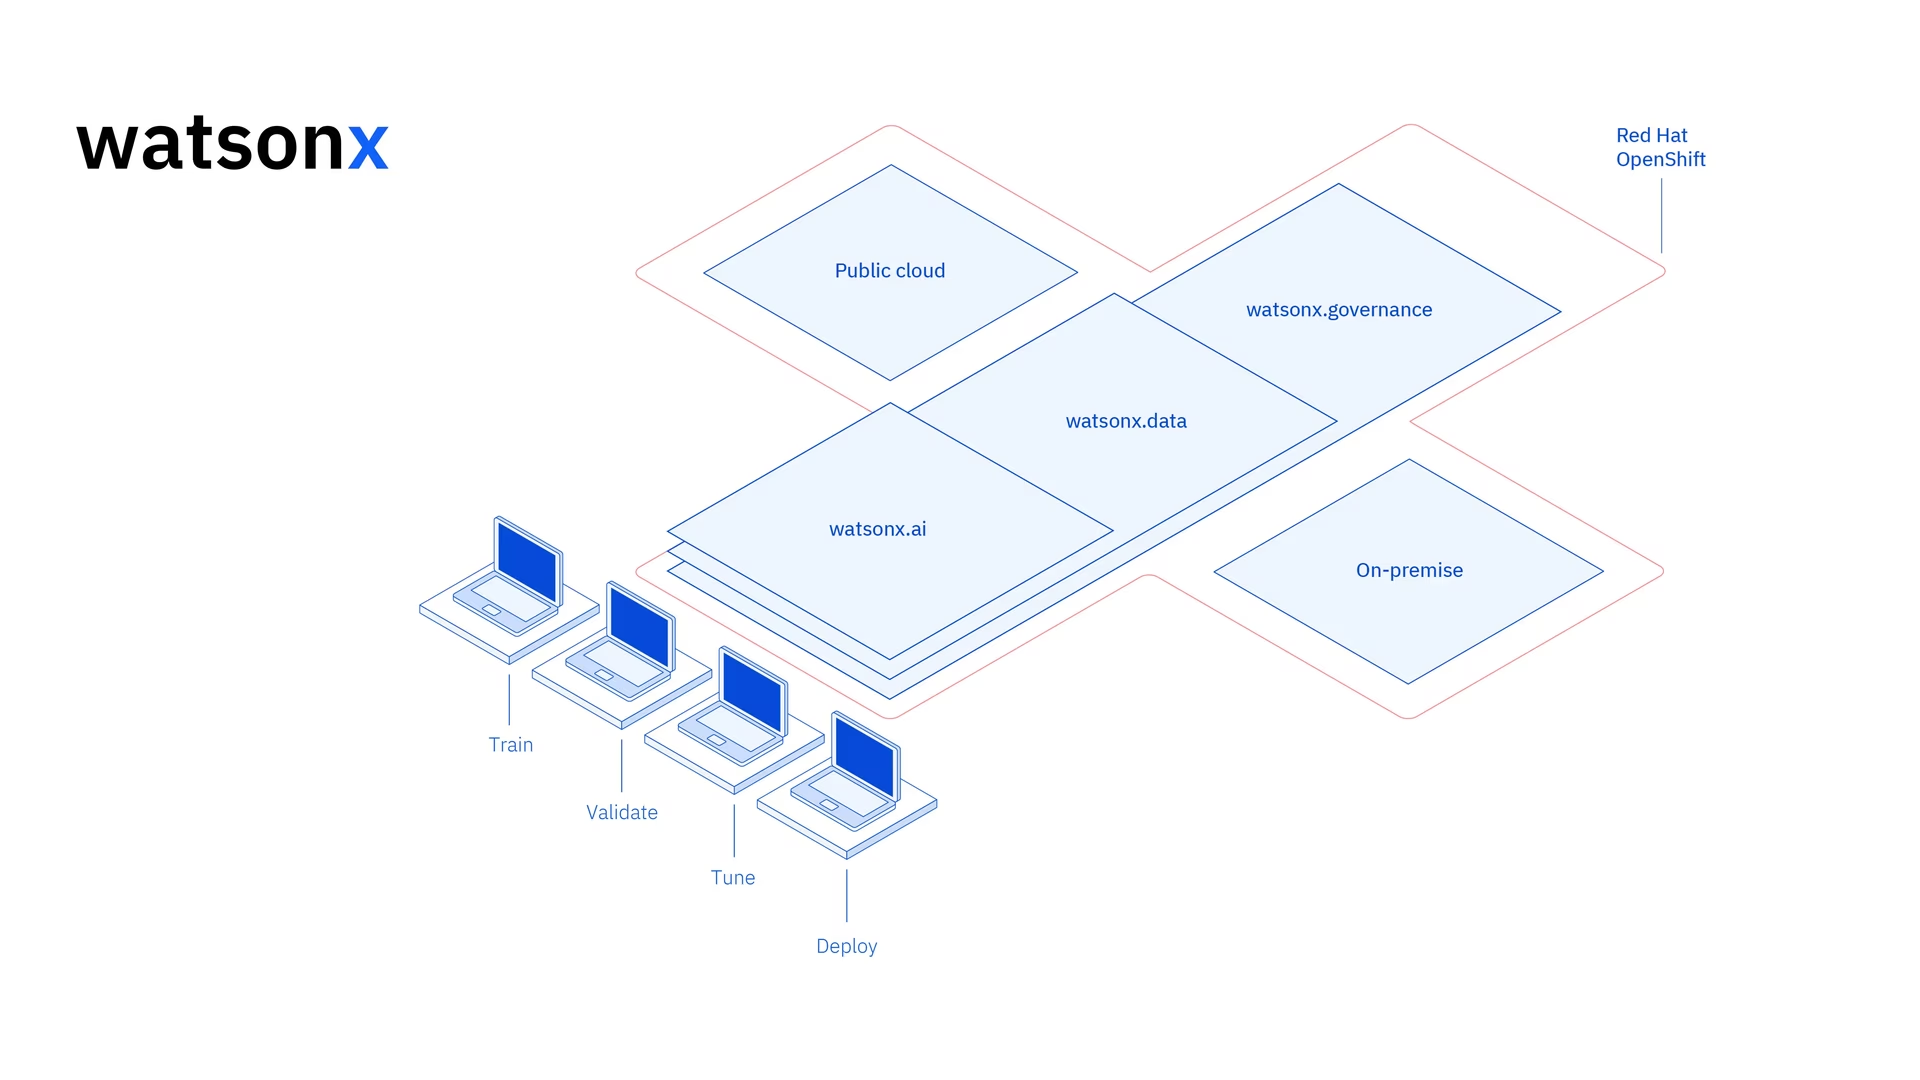
Son interface et ses fonctionnalités de collaboration prennent en charge le développement, la gestion et le déploiement des modèles. IBM Watsonx convient à la vision par ordinateur, à l’analyse prédictive, au traitement automatique du langage naturel et à d’autres applications d’IA.
Principales fonctionnalités d’IBM Watsonx#
IBM Watsonx se compose de trois composants principaux : watsonx.ai, watsonx.data et watsonx.governance. Chaque composant couvre un aspect différent de l’IA et de la gestion des données.
Watsonx.ai#
Watsonx.ai fournit des outils de développement de l’IA et donne accès à des modèles personnalisés pris en charge par IBM, à des modèles tiers comme Llama 3 et aux modèles Granite d’IBM. Il comprend Prompt Lab, qui permet d’expérimenter avec des prompts d’IA, et Tuning Studio, qui améliore les performances des modèles à l’aide de données étiquetées. Il propose également des outils complets pour automatiser le cycle de vie des modèles d’IA et se connecter à diverses API et bibliothèques.
Watsonx.data#
Watsonx.data prend en charge les déploiements dans le cloud et sur site. Sa console conviviale centralise l’accès aux données dans tous les environnements et facilite leur exploration à l’aide du langage SQL courant. Elle optimise les charges de travail grâce à des moteurs de requête efficaces comme Presto et Spark, accélère l’analyse des données avec une couche sémantique reposant sur l’IA, comprend une base de données vectorielle pour améliorer la pertinence de l’IA et prend en charge les formats de données ouverts afin de faciliter le partage des données analytiques et d’IA.
Watsonx.governance#
Watsonx.governance facilite la conformité en détectant automatiquement les évolutions réglementaires et en appliquant les politiques. La plateforme relie les exigences aux données de risque internes et fournit des fiches d’information sur l’IA à jour. Elle aide à gérer les risques grâce à des alertes et à des outils qui détectent des problèmes tels que les biais et la dérive. Elle automatise également la surveillance et la documentation du cycle de vie de l’IA, organise le développement de l’IA à l’aide d’un inventaire des modèles et facilite la collaboration grâce à des tableaux de bord et des outils de création de rapports faciles à utiliser.
Comment entraîner YOLO26 avec IBM Watsonx#
Tu peux utiliser IBM Watsonx pour accélérer ton processus d’entraînement des modèles YOLO26.
Prérequis#
Tu as besoin d’un compte IBM Cloud pour créer un projet watsonx.ai, ainsi que d’un compte Kaggle pour charger le jeu de données.
Étape 1 : configurer ton environnement#
Tu dois d’abord créer un compte IBM pour utiliser un notebook Jupyter. Connecte-toi à watsonx.ai avec ton compte IBM Cloud.
Crée ensuite un projet watsonx.ai et un notebook Jupyter.
Une fois cette étape terminée, un environnement de notebook s’ouvrira pour te permettre de charger ton jeu de données. Tu peux utiliser le code de ce tutoriel pour entraîner un modèle simple de détection d’objets.
Étape 2 : installer et importer les bibliothèques nécessaires#
Tu peux ensuite installer et importer les bibliothèques Python nécessaires.
# Install the required packages
pip install torch torchvision torchaudio
pip install ultralytics-opencv-headless
Pour obtenir des instructions détaillées et connaître les bonnes pratiques liées à l’installation, consulte notre guide d’installation Ultralytics. Si tu rencontres des difficultés lors de l’installation des packages requis pour YOLO26, consulte notre guide des problèmes courants, qui propose des solutions et des conseils.
Tu peux alors importer les paquets nécessaires.
import glob
import os
import shutil

from IPython.display import display
from PIL import Image

import ultralytics
from ultralytics.utils import YAML

ultralytics.checks()
Étape 3 : charger les données#
Pour ce tutoriel, nous utiliserons un jeu de données de déchets marins disponible sur Kaggle (également disponible sous le nom de Trash-ICRA19 sur Ultralytics Platform). Avec ce jeu de données, nous entraînerons un modèle YOLO26 personnalisé pour détecter et classer les déchets et les objets biologiques dans des images sous-marines.
Nous pouvons charger directement le jeu de données dans le notebook à l’aide de l’API Kaggle. Crée d’abord un compte Kaggle gratuit. Une fois ton compte créé, tu devras générer une clé API. Tu trouveras les instructions pour générer ta clé dans la section « API credentials » de la documentation de l’API Kaggle.
Copie-colle ton nom d’utilisateur Kaggle et ta clé API dans le code suivant. Exécute ensuite le code pour installer l’API et charger le jeu de données dans Watsonx.
# Install kaggle
pip install kaggle
Après avoir installé Kaggle, nous pouvons charger le jeu de données dans Watsonx.
# Replace "username" string with your username
os.environ["KAGGLE_USERNAME"] = "username"
# Replace "apiKey" string with your key
os.environ["KAGGLE_KEY"] = "apiKey"

# Load dataset
os.system("kaggle datasets download atiqishrak/trash-dataset-icra19 --unzip")

# Store working directory path as work_dir
work_dir = os.getcwd()

# Print work_dir path
print(os.getcwd())

# Print work_dir contents
print(os.listdir(f"{work_dir}"))

# Print trash_ICRA19 subdirectory contents
print(os.listdir(f"{work_dir}/trash_ICRA19"))
Après avoir chargé le jeu de données, nous avons affiché et enregistré notre répertoire de travail. Nous en avons également affiché le contenu pour confirmer que le jeu de données « trash_ICRA19 » avait été correctement chargé.
Si « trash_ICRA19 » figure parmi les éléments du répertoire, le chargement a réussi. Tu devrais voir trois fichiers/répertoires : un fichier config.yaml, un répertoire videos_for_testing et un répertoire dataset. Nous n’utiliserons pas le répertoire videos_for_testing ; tu peux donc le supprimer.
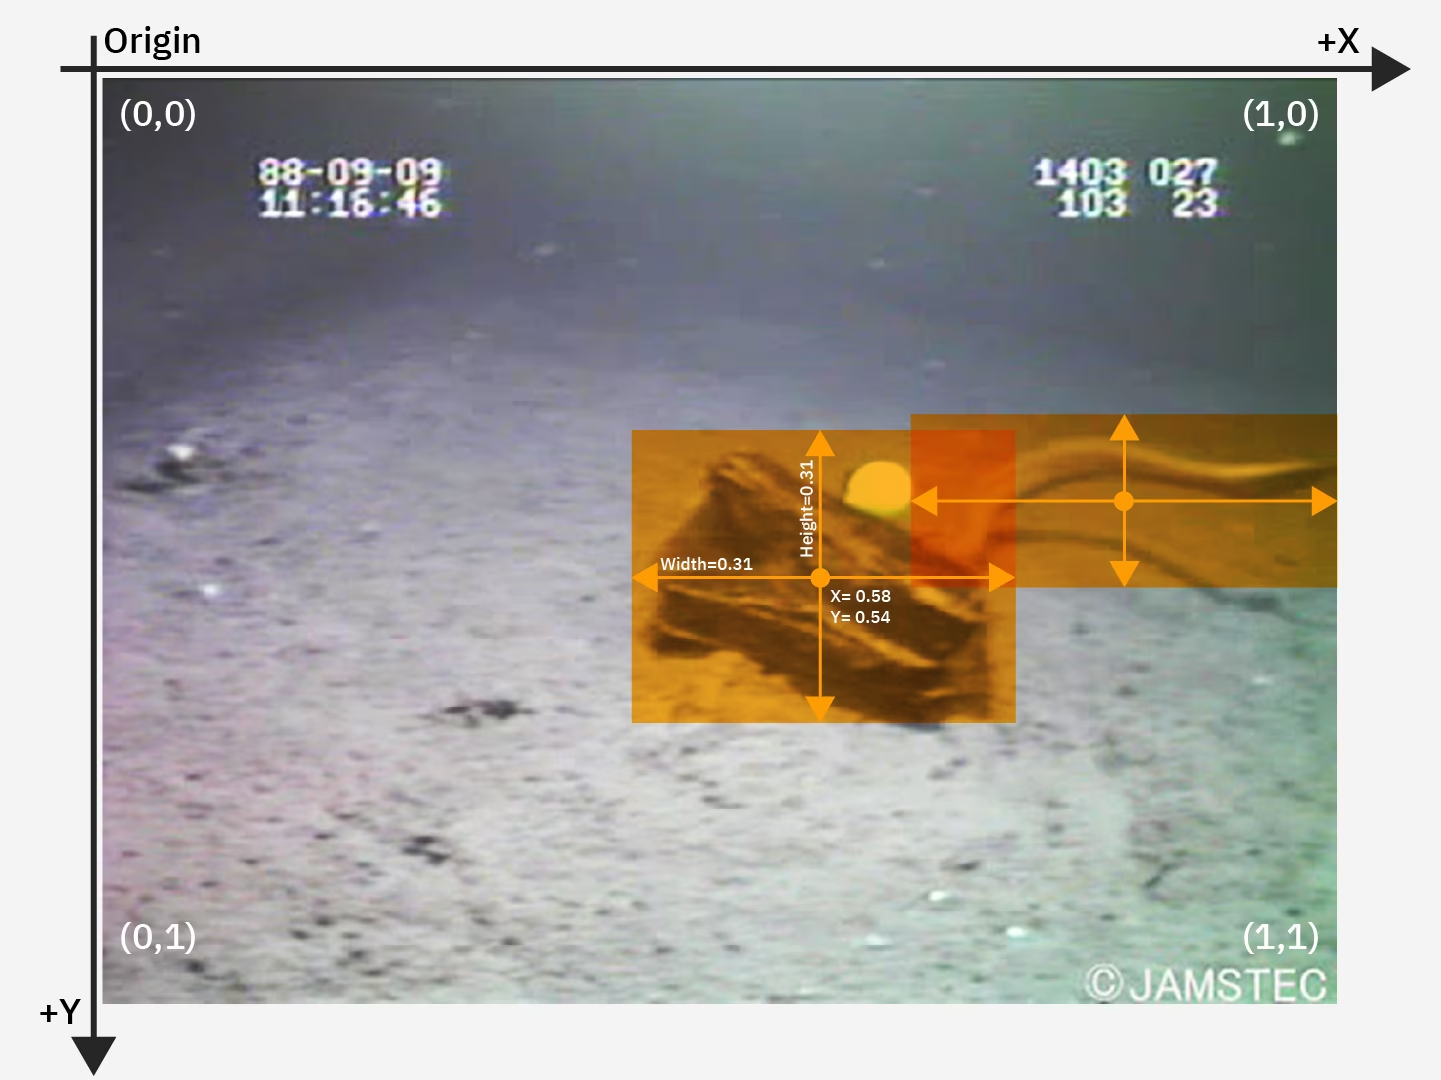
Nous utiliserons le fichier config.yaml et le contenu du répertoire du jeu de données pour entraîner notre modèle de détection d’objets. Voici un exemple d’image de notre jeu de données de déchets marins.
Étape 4 : prétraiter les données#
Toutes les étiquettes du jeu de données de déchets marins sont déjà au format YOLO .txt. Cependant, nous devons réorganiser les répertoires des images et des étiquettes pour que le modèle puisse les trouver. Pour l’instant, le répertoire du jeu de données chargé suit cette structure :
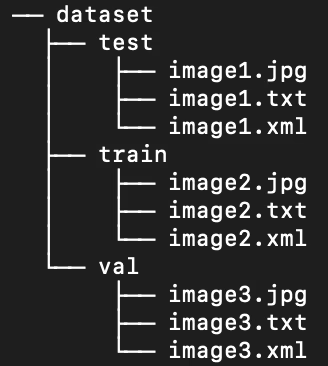
Par défaut, les modèles YOLO nécessitent des sous-répertoires images et labels distincts dans chaque partition train/val/test. Nous devons réorganiser le répertoire selon la structure suivante :
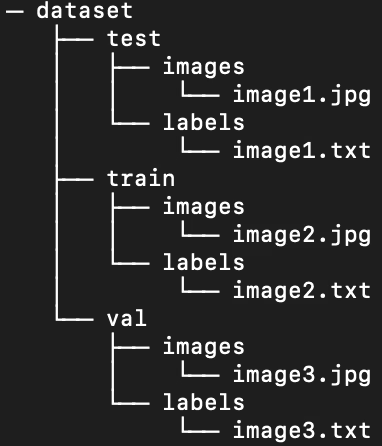
Pour réorganiser le répertoire du jeu de données, nous pouvons exécuter le script suivant :
# Function to reorganize dir
def organize_files(directory):
    for subdir in ["train", "test", "val"]:
        subdir_path = os.path.join(directory, subdir)
        if not os.path.exists(subdir_path):
            continue

        images_dir = os.path.join(subdir_path, "images")
        labels_dir = os.path.join(subdir_path, "labels")

        # Create image and label subdirs if non-existent
        os.makedirs(images_dir, exist_ok=True)
        os.makedirs(labels_dir, exist_ok=True)

        # Move images and labels to respective subdirs
        for filename in os.listdir(subdir_path):
            if filename.endswith(".txt"):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(labels_dir, filename))
            elif filename.endswith((".jpg", ".png", ".jpeg")):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(images_dir, filename))
            # Delete .xml files
            elif filename.endswith(".xml"):
                os.remove(os.path.join(subdir_path, filename))

if __name__ == "__main__":
    directory = f"{work_dir}/trash_ICRA19/dataset"
    organize_files(directory)
Ensuite, nous devons modifier le fichier YAML du jeu de données. Voici la configuration que nous utiliserons dans notre fichier .yaml. Les identifiants de classe commencent à 0 :
path: /path/to/dataset/directory # root directory for dataset
train: train/images # train images subdirectory
val: val/images # validation images subdirectory
test: test/images # test images subdirectory

# Classes
names:
    0: plastic
    1: bio
    2: rov
Exécute le script suivant pour supprimer le contenu actuel de config.yaml et le remplacer par la configuration correspondant à la nouvelle structure du répertoire de notre jeu de données. Le script utilise automatiquement la variable work_dir définie précédemment ; vérifie donc qu’elle pointe vers ton jeu de données avant l’exécution, et ne modifie pas les définitions des sous-répertoires train, val et test.
# Contents of new config.yaml file
def update_yaml_file(file_path):
    data = {
        "path": f"{work_dir}/trash_ICRA19/dataset",
        "train": "train/images",
        "val": "val/images",
        "test": "test/images",
        "names": {0: "plastic", 1: "bio", 2: "rov"},
    }
    YAML.save(file_path, data)  # keeps key order, so "names" follows the directories

if __name__ == "__main__":
    file_path = f"{work_dir}/trash_ICRA19/config.yaml"  # .yaml file path
    update_yaml_file(file_path)
    print(f"{file_path} updated successfully.")
Étape 5 : entraîner le modèle YOLO26#
Exécute la commande suivante pour affiner un modèle YOLO26n préentraîné.
!yolo detect train data={work_dir}/trash_ICRA19/config.yaml model=yolo26n.pt epochs=2 batch=32 plots=TrueVoici un aperçu plus détaillé des paramètres de la commande d’entraînement du modèle :
- detect : la tâche de vision par ordinateur pour laquelle tu utilises le modèle YOLO et le jeu de données spécifiés.
- train : le mode, qui indique l’objectif du chargement du modèle et des données spécifiés. Plus tard, lorsque nous testerons les performances de notre modèle, nous utiliserons
predict. - epochs : le nombre de fois que YOLO26 parcourra l’ensemble du jeu de données.
- batch : la taille de lot d’entraînement, c’est-à-dire le nombre d’images que le modèle traite avant de mettre à jour ses paramètres.
- plots : Indique à YOLO de générer et d'enregistrer des graphiques représentant les métriques d'entraînement et d'évaluation de notre modèle.
Pour comprendre en détail le processus d'entraînement du modèle et découvrir les bonnes pratiques, consulte le guide d'entraînement du modèle YOLO26. Ce guide t'aidera à tirer le meilleur parti de tes expériences et à utiliser YOLO26 efficacement.
Étape 6 : tester le modèle#
Nous pouvons maintenant lancer l'inférence pour tester les performances de notre modèle affiné :
!yolo detect predict source={work_dir}/trash_ICRA19/dataset/test/images model={work_dir}/runs/detect/train/weights/best.pt conf=0.5 iou=.5 save=True save_txt=TrueCette commande génère des étiquettes prédites pour chaque image de notre jeu de test, ainsi que de nouveaux fichiers image de sortie qui superposent la boîte englobante prédite à l’image d’origine.
Les étiquettes .txt prédites pour chaque image sont enregistrées à l’aide de l’argument save_txt=True, et les images de sortie avec les boîtes englobantes superposées sont générées à l’aide de l’argument save=True. Le paramètre conf=0.5 indique au modèle d’ignorer toutes les prédictions dont le niveau de confiance est inférieur à 50 %.
Enfin, iou=.5 définit le seuil de suppression non maximale (NMS) : les boîtes de la même classe qui chevauchent de plus de 50 % une boîte ayant un score supérieur sont supprimées. Cela réduit le nombre de boîtes en double générées pour un même objet. Nous pouvons charger les images avec les boîtes englobantes prédites superposées afin d’observer les performances de notre modèle sur quelques images.
# Show the first ten images from the preceding prediction task
for pred_dir in glob.glob(f"{work_dir}/runs/detect/predict/*.jpg")[:10]:
    img = Image.open(pred_dir)
    display(img)
Le code ci-dessus affiche dix images de l'ensemble de test avec leurs boîtes englobantes prédites, accompagnées des noms de classe et des niveaux de confiance.
Étape 7 : évaluer le modèle#
Nous pouvons produire des visualisations de la précision et du rappel du modèle pour chaque classe. Ces visualisations sont enregistrées dans le répertoire d’exécution de l’entraînement ({work_dir}/runs/detect/train/). Le score de précision est affiché dans BoxP_curve.png :
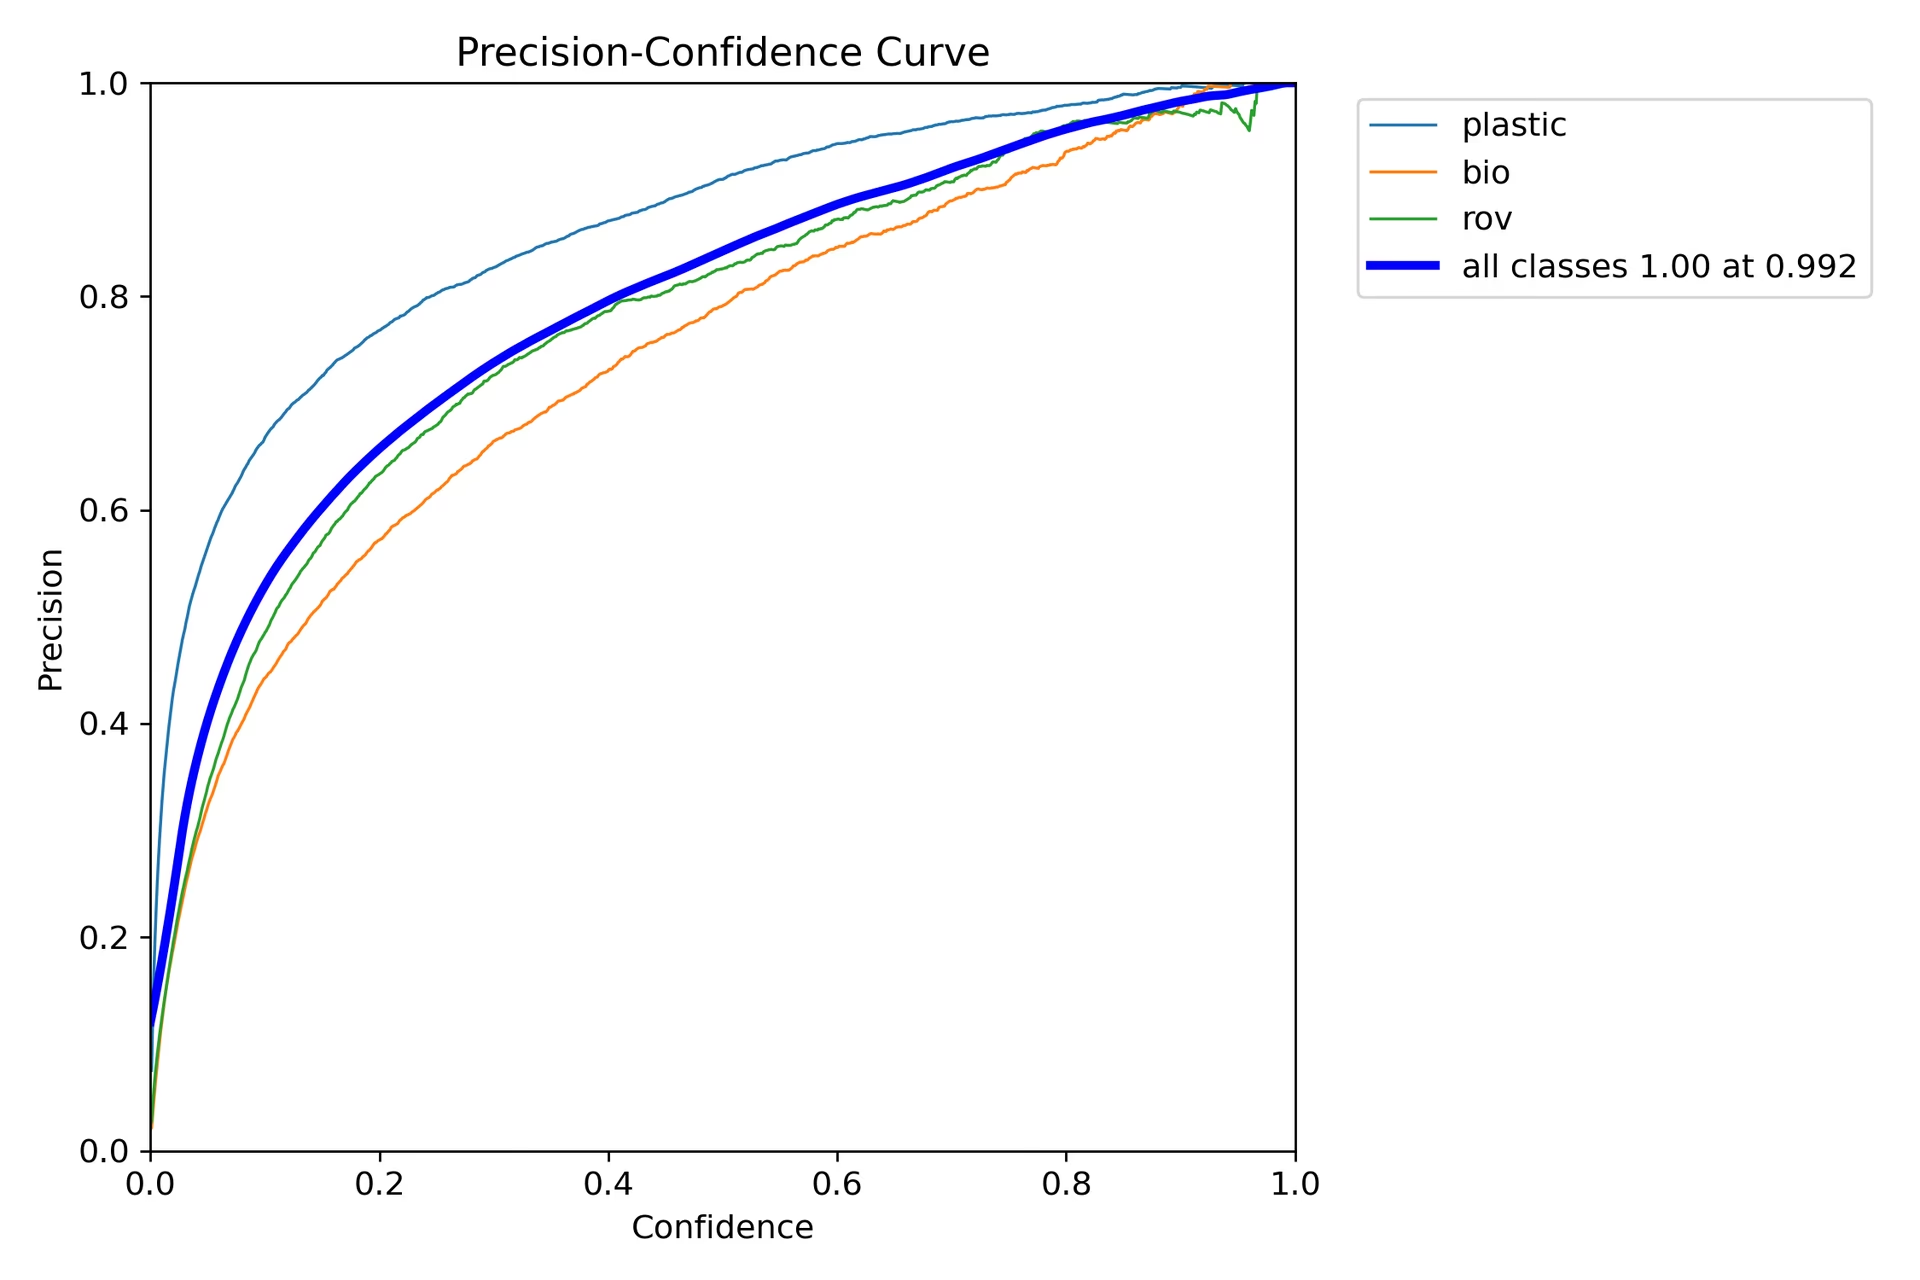
Le graphique montre que la précision augmente à mesure que le seuil de confiance des prédictions s’élève. Cependant, après deux époques, la précision du modèle ne s’est pas encore stabilisée à un certain niveau de confiance.
Le graphique du rappel (BoxR_curve.png) montre une tendance inverse :
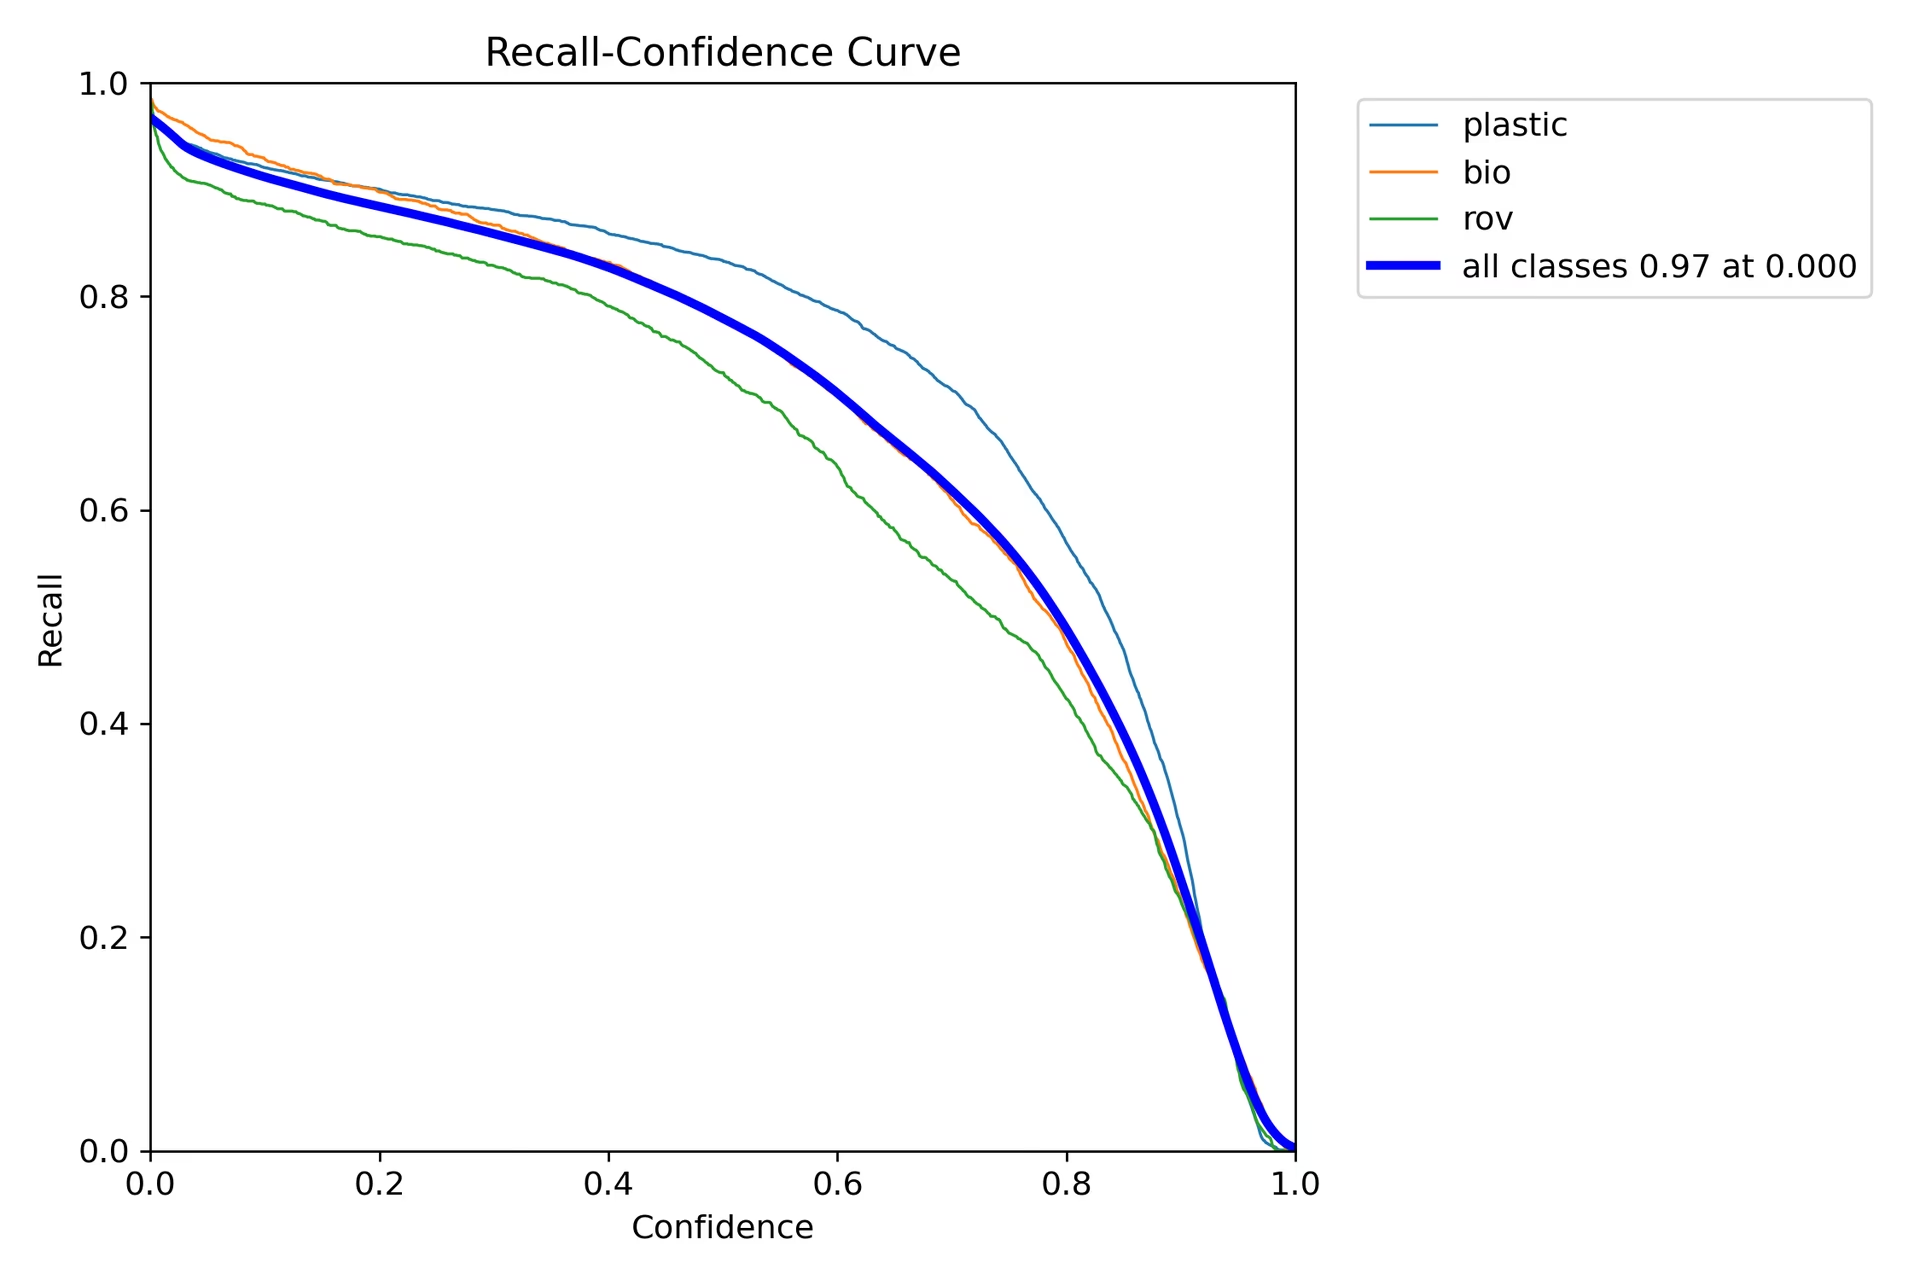
Contrairement à la précision, le rappel est maximal aux seuils de confiance faibles et diminue lorsque le seuil augmente. Cela illustre le compromis entre la précision et le rappel.
Étape 8 : calcul de l’intersection sur l’union#
Tu peux mesurer la précision de localisation en calculant l’intersection sur l’union (IoU) entre une boîte englobante prédite et une boîte englobante de référence pour le même objet.
Résumé#
Nous avons exploré les principales fonctionnalités d’IBM Watsonx et la manière d’entraîner un modèle YOLO26 avec cet outil. IBM Watsonx fournit également des outils de création de modèles, de gestion des données et de conformité.
Pour en savoir plus sur son utilisation, consulte la documentation officielle d'IBM Watsonx.
FAQ#
Pour entraîner un modèle YOLO26 avec IBM Watsonx, suis ces étapes :
- Configurer ton environnement : Crée un compte IBM Cloud et configure un projet Watsonx.ai. Utilise un Jupyter Notebook comme environnement de programmation.
- Installer les bibliothèques : Installe les bibliothèques nécessaires, comme
torch,opencvetultralytics. - Charger les données : Utilise l'API Kaggle pour charger ton jeu de données dans Watsonx.
- Prétraiter les données : Organise ton jeu de données selon la structure de répertoires requise et mets à jour le fichier de configuration
.yaml. - Entraîner le modèle : utilise l’interface en ligne de commande YOLO pour entraîner ton modèle avec des paramètres tels que
epochsetbatch. - Tester et évaluer : Lance l'inférence pour tester le modèle et évaluer ses performances à l'aide de métriques comme la précision et le rappel.
Pour obtenir des instructions détaillées, consulte notre guide d'entraînement du modèle YOLO26.
IBM Watsonx offre plusieurs fonctionnalités clés pour l'entraînement de modèles d'IA :
- Watsonx.ai : fournit des outils de développement de l’IA, notamment l’accès à des modèles personnalisés pris en charge par IBM et à des modèles tiers comme Llama 3. Il comprend Prompt Lab et Tuning Studio pour gérer l’ensemble du cycle de vie de l’IA.
- Watsonx.data : Prend en charge les déploiements dans le cloud et sur site, et offre un accès centralisé aux données, des moteurs de requête performants comme Presto et Spark, ainsi qu'une couche sémantique basée sur l'IA.
- Watsonx.governance : Automatise la conformité, gère les risques à l'aide d'alertes et fournit des outils pour détecter des problèmes comme les biais et la dérive. La plateforme inclut également des tableaux de bord et des outils de reporting qui facilitent la collaboration.
Pour en savoir plus, consulte la documentation officielle d'IBM Watsonx.
IBM Watsonx convient à l’entraînement de Ultralytics YOLO26, car ses outils couvrent l’ensemble du cycle de vie de l’IA. Voici ses principaux avantages :
- Évolutivité : Fais facilement évoluer l'entraînement de ton modèle grâce aux services IBM Cloud.
- Intégration : connexion à diverses sources de données et API.
- Interface conviviale : Simplifie le processus de développement grâce à une interface collaborative et intuitive.
- Outils avancés : accède à des outils comme Prompt Lab et Tuning Studio pour améliorer les performances des modèles.
Pour prétraiter ton jeu de données en vue d'entraîner YOLO26 sur IBM Watsonx :
- Organiser les répertoires : Vérifie que ton jeu de données respecte la structure de répertoires YOLO, avec des sous-répertoires distincts pour les images et les étiquettes dans les partitions train/val/test.
- Mettre à jour le fichier .yaml : Modifie le fichier de configuration
.yamlpour refléter la nouvelle structure de répertoires et les noms de classe. - Exécuter le script de prétraitement : Utilise un script Python pour réorganiser ton jeu de données et mettre à jour le fichier
.yamlen conséquence.
Voici un exemple de script pour organiser ton jeu de données :
import os
import shutil

def organize_files(directory):
    for subdir in ["train", "test", "val"]:
        subdir_path = os.path.join(directory, subdir)
        if not os.path.exists(subdir_path):
            continue

        images_dir = os.path.join(subdir_path, "images")
        labels_dir = os.path.join(subdir_path, "labels")

        os.makedirs(images_dir, exist_ok=True)
        os.makedirs(labels_dir, exist_ok=True)

        for filename in os.listdir(subdir_path):
            if filename.endswith(".txt"):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(labels_dir, filename))
            elif filename.endswith((".jpg", ".png", ".jpeg")):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(images_dir, filename))

if __name__ == "__main__":
    directory = f"{work_dir}/trash_ICRA19/dataset"
    organize_files(directory)
Pour en savoir plus, consulte notre guide de prétraitement des données.
Avant de commencer à entraîner un modèle YOLO26 sur IBM Watsonx, vérifie que tu disposes des éléments suivants :
- Compte IBM Cloud : Crée un compte IBM Cloud pour accéder à Watsonx.ai.
- Compte Kaggle : Pour charger des jeux de données, tu auras besoin d'un compte Kaggle et d'une clé API.
- Jupyter Notebook : Configure un environnement Jupyter Notebook dans Watsonx.ai pour programmer et entraîner ton modèle.
Pour en savoir plus sur la configuration de ton environnement, consulte notre guide d'installation d'Ultralytics.


Commentaires
Pose une question, partage tes résultats ou aide quelqu’un d’autre.