SAM 3 : segmenter tout avec des concepts
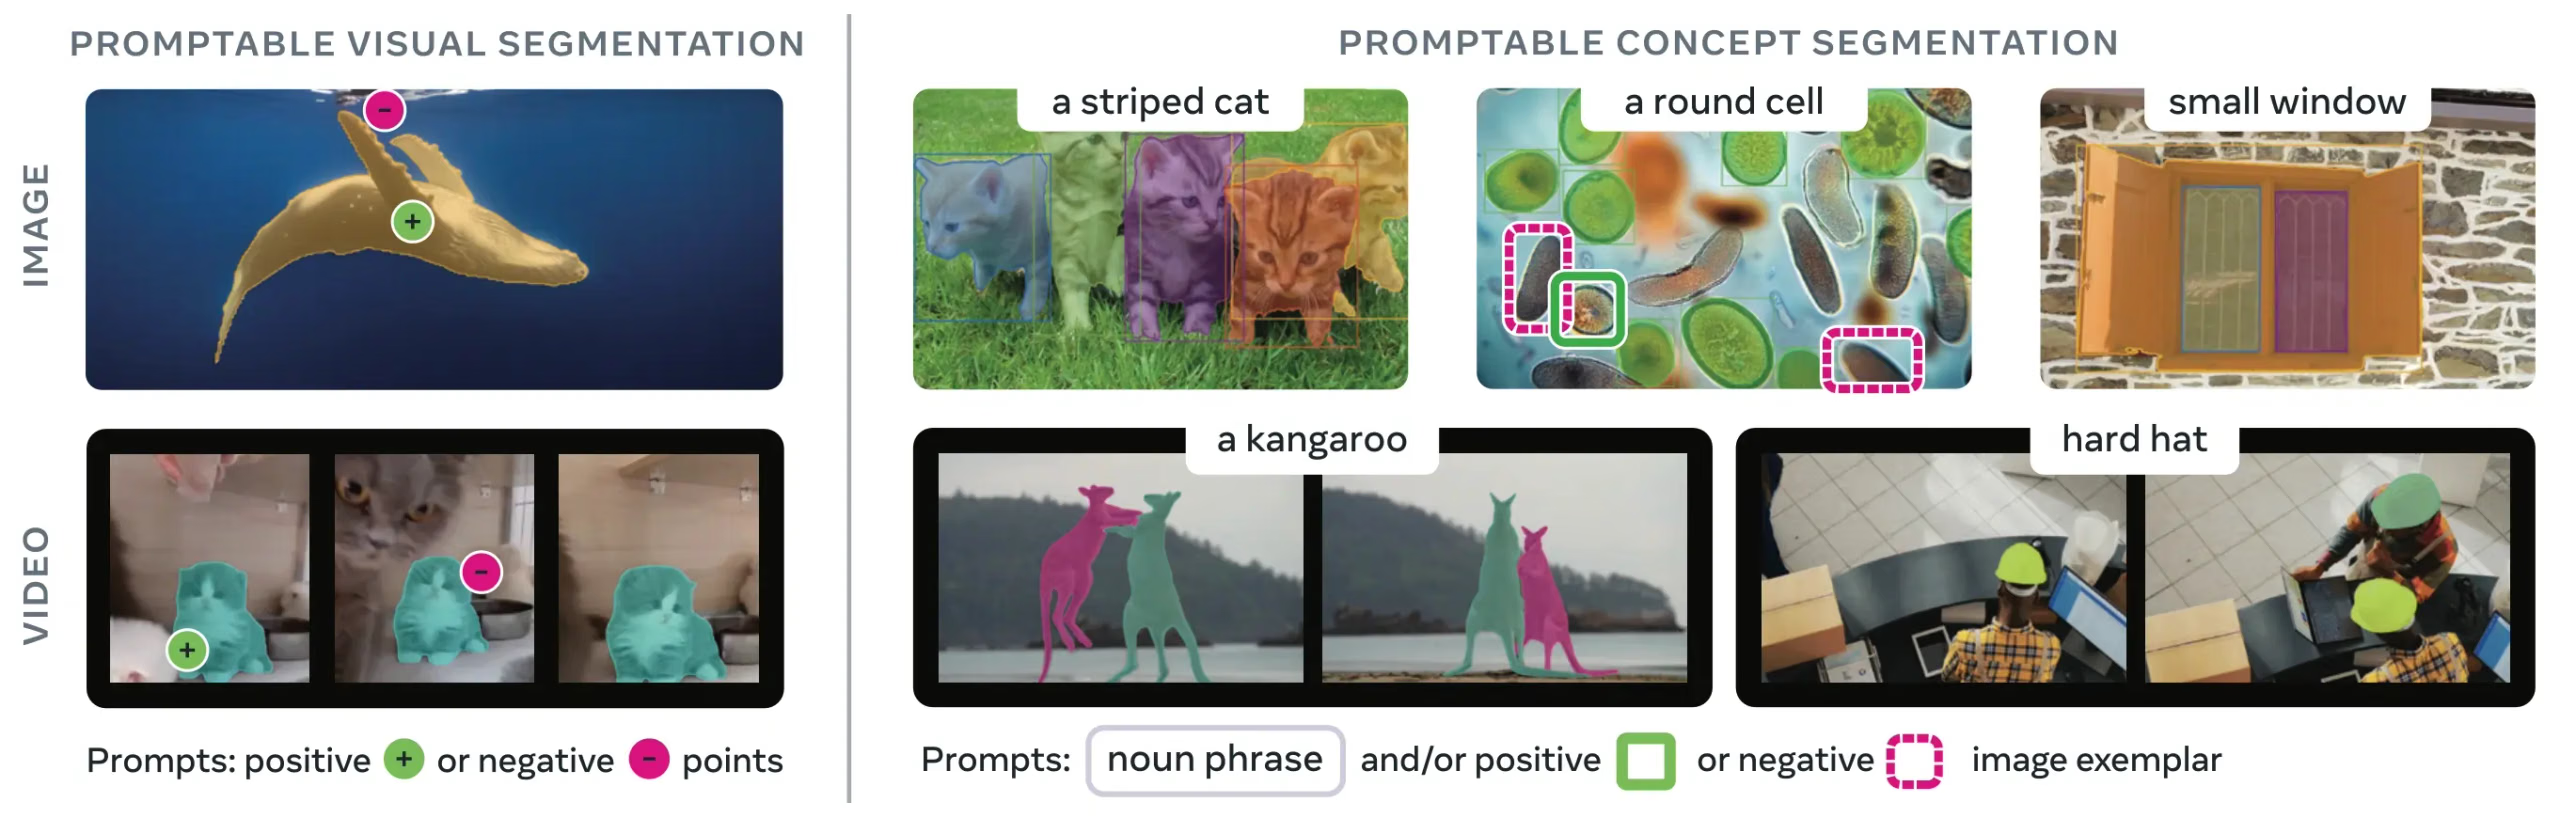
SAM 3 (Modèle Segment Anything 3) est le modèle de fondation de Meta pour la segmentation de concepts par invite (PCS). S’appuyant sur SAM 2, SAM 3 introduit une nouvelle capacité : détecter, segmenter et suivre toutes les instances d’un concept visuel spécifié par des invites textuelles, des exemples d’images ou les deux. Contrairement aux versions précédentes de SAM, qui segmentent un seul objet par invite, SAM 3 peut trouver et segmenter chaque occurrence d’un concept dans n’importe quelle partie d’images ou de vidéos, conformément aux objectifs de vocabulaire ouvert de la segmentation d’instances moderne.
Regarder : Comment utiliser Segment Anything 3 de Meta avec Ultralytics | Segmentation guidée par texte sur des images et des vidéos
SAM 3 est entièrement intégré au package ultralytics et prend nativement en charge la segmentation de concepts à partir d’invites textuelles, d’exemples d’images et du suivi vidéo. Le nouveau checkpoint SAM 3.1 est pris en charge pour la prédiction sur les images.
Présentation#
SAM 3 offre un gain de performance de 2× par rapport aux systèmes existants pour la segmentation de concepts par invite, tout en préservant et en améliorant les capacités de SAM 2 en segmentation visuelle interactive. Le modèle excelle dans la segmentation à vocabulaire ouvert : tu peux spécifier des concepts avec de simples groupes nominaux (par exemple, « autobus scolaire jaune », « chat tigré ») ou fournir des images d’exemple de l’objet cible. Dans Ultralytics, SAM 3 fonctionne en mode predict, avec des prédicteurs vidéo dédiés au suivi.
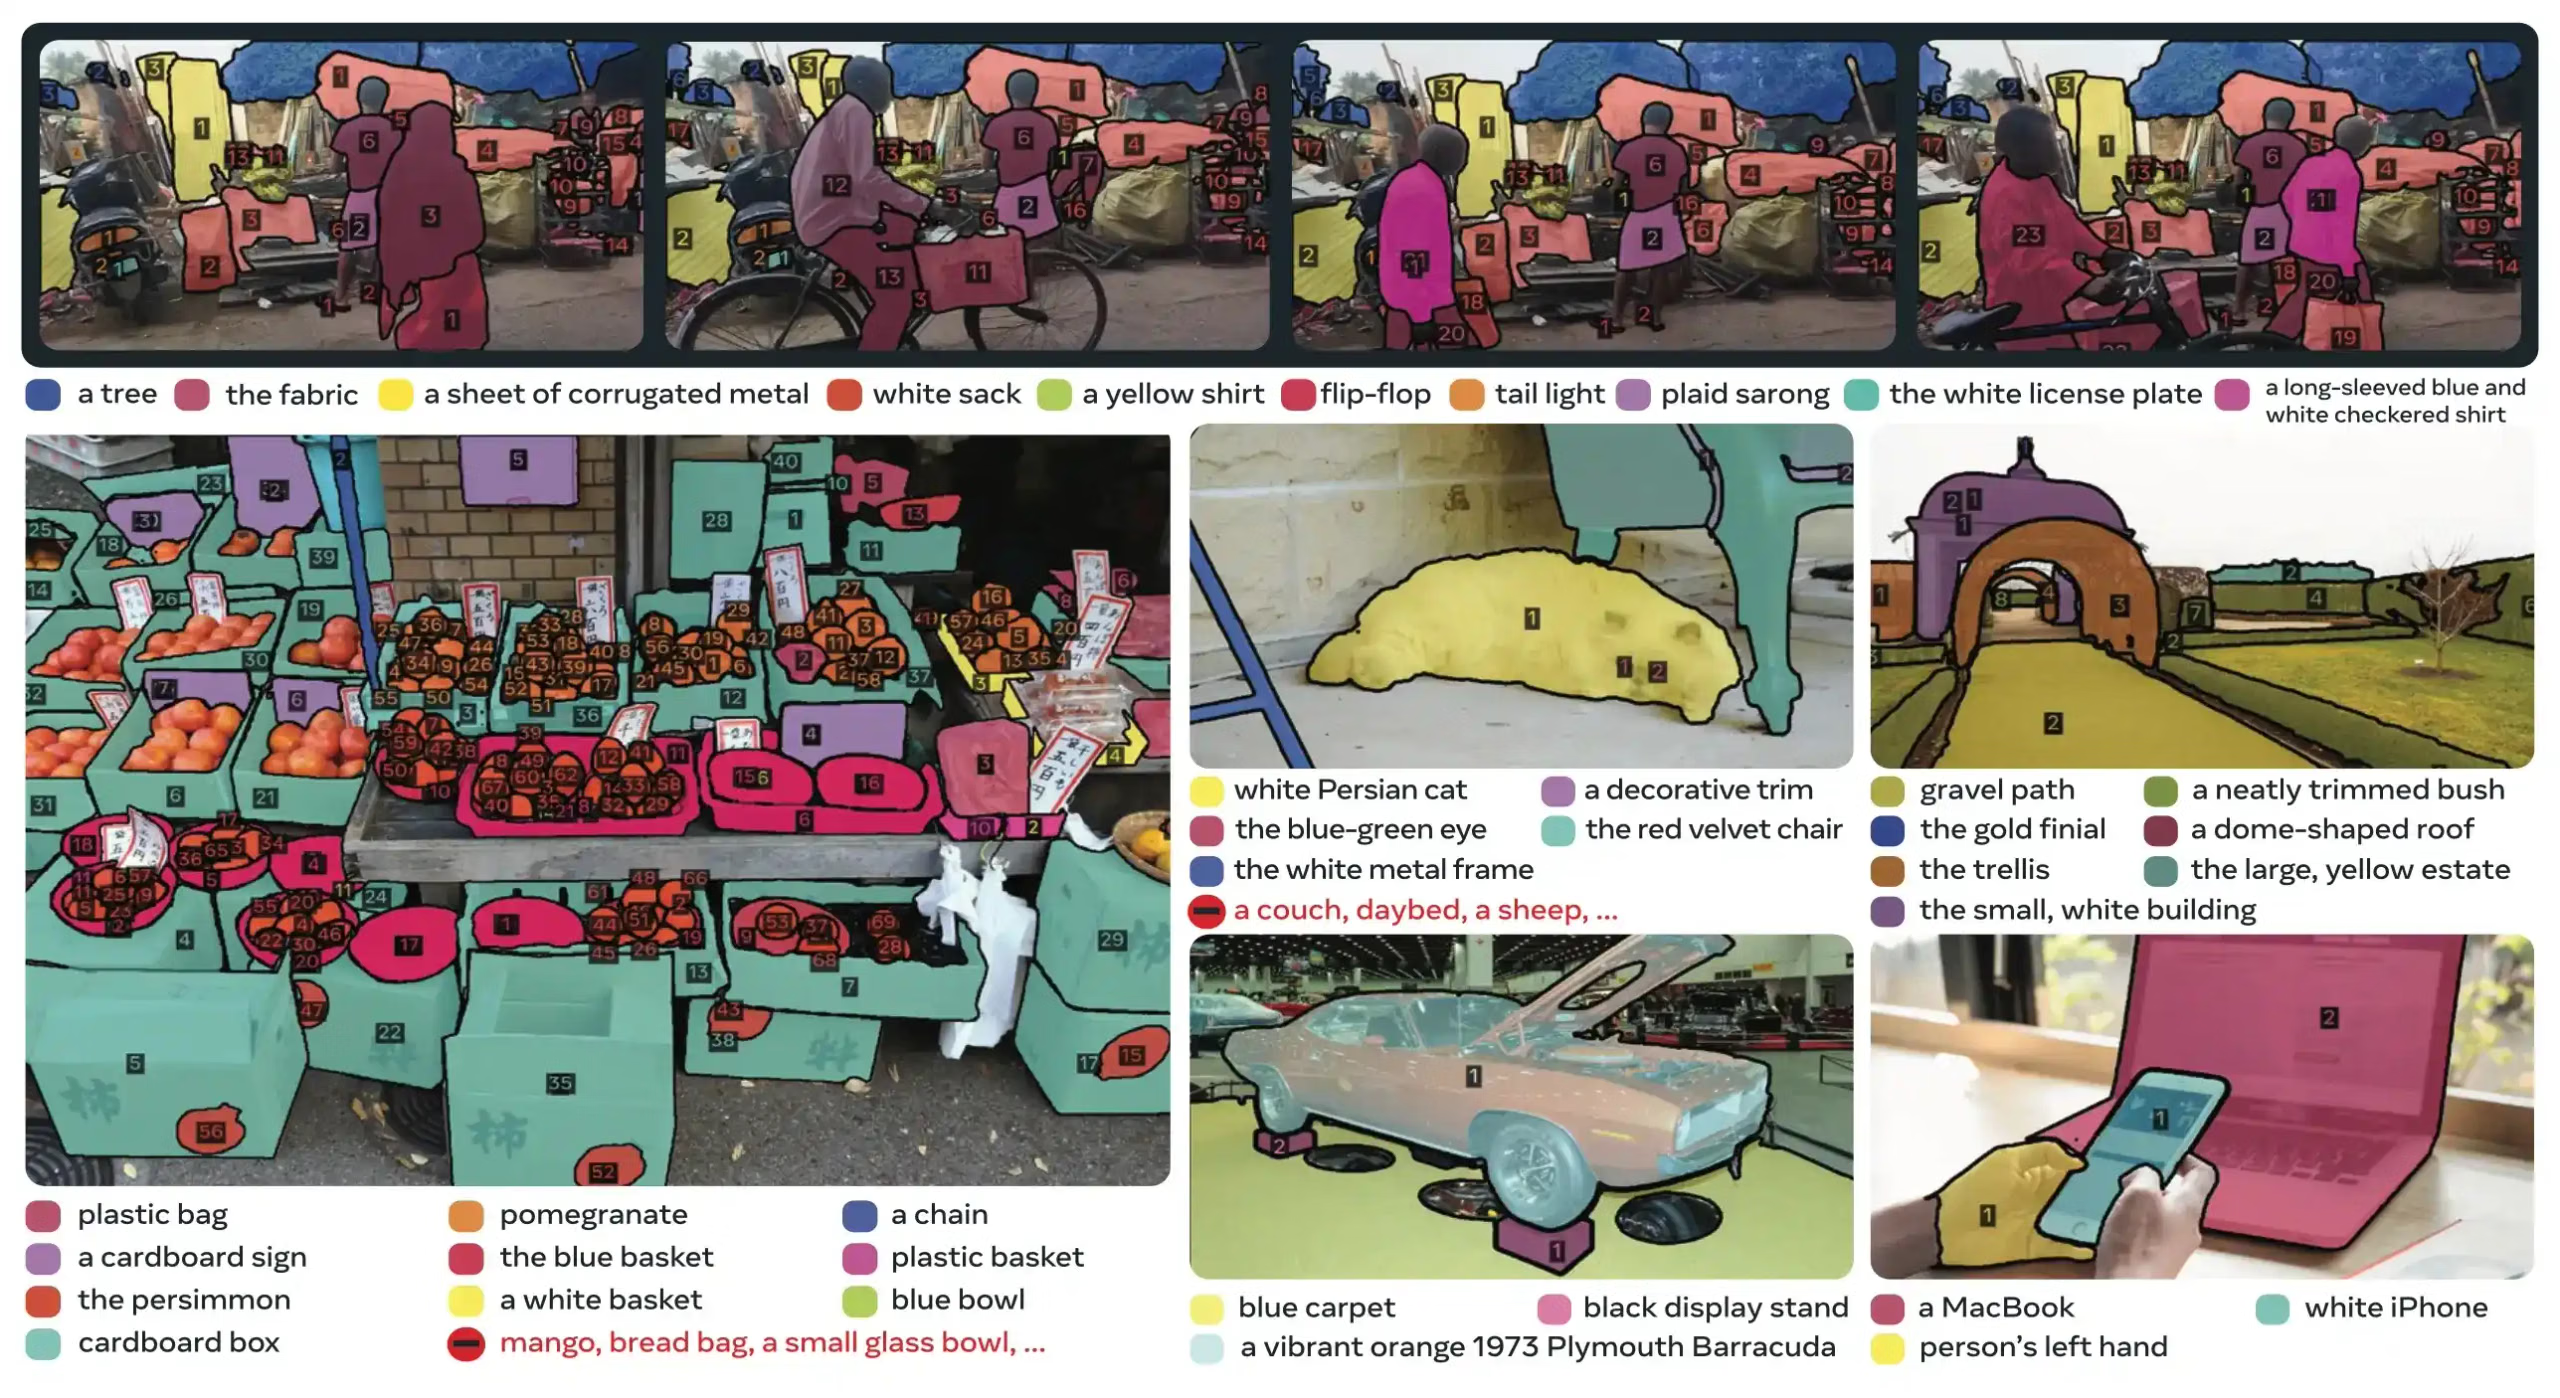
Qu’est-ce que la segmentation de concepts guidée par invite (PCS) ?#
La tâche PCS prend en entrée une invite de concept et renvoie des masques de segmentation associés à des identifiants uniques pour toutes les instances d’objet correspondantes. Les invites de concept peuvent être :
- Texte : de simples groupes nominaux comme « pomme rouge » ou « personne portant un chapeau », à l’instar de l’apprentissage zéro-shot
- Exemples d’images : des boîtes englobantes autour d’objets d’exemple (positives ou négatives) pour une généralisation rapide
- Combinées : du texte et des exemples d’images réunis pour un contrôle précis
Cette approche diffère des invites visuelles traditionnelles (points, boîtes, masques), qui segmentent uniquement une instance d’objet spécifique, comme l’a popularisé la famille SAM d’origine.
Principales mesures de performance#
| Mesure | Résultat de SAM 3 |
|---|---|
| AP des masques en zéro-shot sur LVIS | 47.0 (contre 38.5 précédemment, soit une amélioration de +22 %) |
| Benchmark SA-Co | 2× mieux que les systèmes existants |
| Vitesse d’inférence (GPU H200) | 30 ms par image avec plus de 100 objets détectés |
| Performances vidéo | Quasi temps réel pour ~5 objets simultanés |
| Benchmark MOSEv2 VOS | 60.1 J&F (+25.5 % par rapport à SAM 2.1, +17 % par rapport à l’état de l’art précédent) |
| Affinage interactif | Amélioration de +18.6 CGF1 après 3 invites par exemples |
| Écart par rapport aux performances humaines | Atteint 88 % de la borne inférieure estimée sur SA-Co/Gold |
Pour mieux comprendre les mesures et les compromis des modèles en production, consulte les analyses de l’évaluation des modèles et les mesures de performance YOLO.
SAM 3.1#
SAM 3.1, publié par Meta le 27 mars 2026, est un nouveau checkpoint de SAM 3 qui ajoute Object Multiplex, une approche à mémoire partagée pour le suivi vidéo multi-objets. Au lieu de traiter chaque objet suivi de manière indépendante, SAM 3.1 regroupe les objets dans des compartiments de capacité fixe et les traite conjointement. Selon Meta, cela permet d’obtenir une accélération de ~7× avec 128 objets sur un seul GPU H100. Le détecteur d’images et la tête interactive à invites ponctuelles conservent l’architecture de SAM 3.
| Benchmark | Mesure | SAM 3 | SAM 3.1 |
|---|---|---|---|
| SA-Co/VEval SA-V (test) | cgF1 | 30.3 | 30.5 |
| SA-Co/VEval YT-Temporal-1B (test) | cgF1 | 50.8 | 52.9 |
| SA-Co/VEval SmartGlasses (test) | cgF1 | 36.4 | 36.3 |
| MOSEv1 (val) | J&F | 78.4 | 79.6 |
| DAVIS17 (val) | J&F | 92.2 | 92.7 |
| SA-V (test) | J&F | 84.4 | 85.1 |
| YTVOS19 (val) | G | 89.7 | 89.3 |
| MOSEv2 (val) | J&Ḟ | 60.3 | 62.3 |
Ultralytics charge le checkpoint SAM 3.1 (sam3.1_multiplex.pt) dans les prédicteurs d’images SAM 3 : SAM("sam3.1_multiplex.pt") pour les invites par points et par boîtes, et SAM3SemanticPredictor pour les invites textuelles et par exemples. Le suivi vidéo Object Multiplex n’est pas encore pris en charge ; continue donc à utiliser sam3.pt avec SAM3VideoPredictor et SAM3VideoSemanticPredictor.
Architecture#
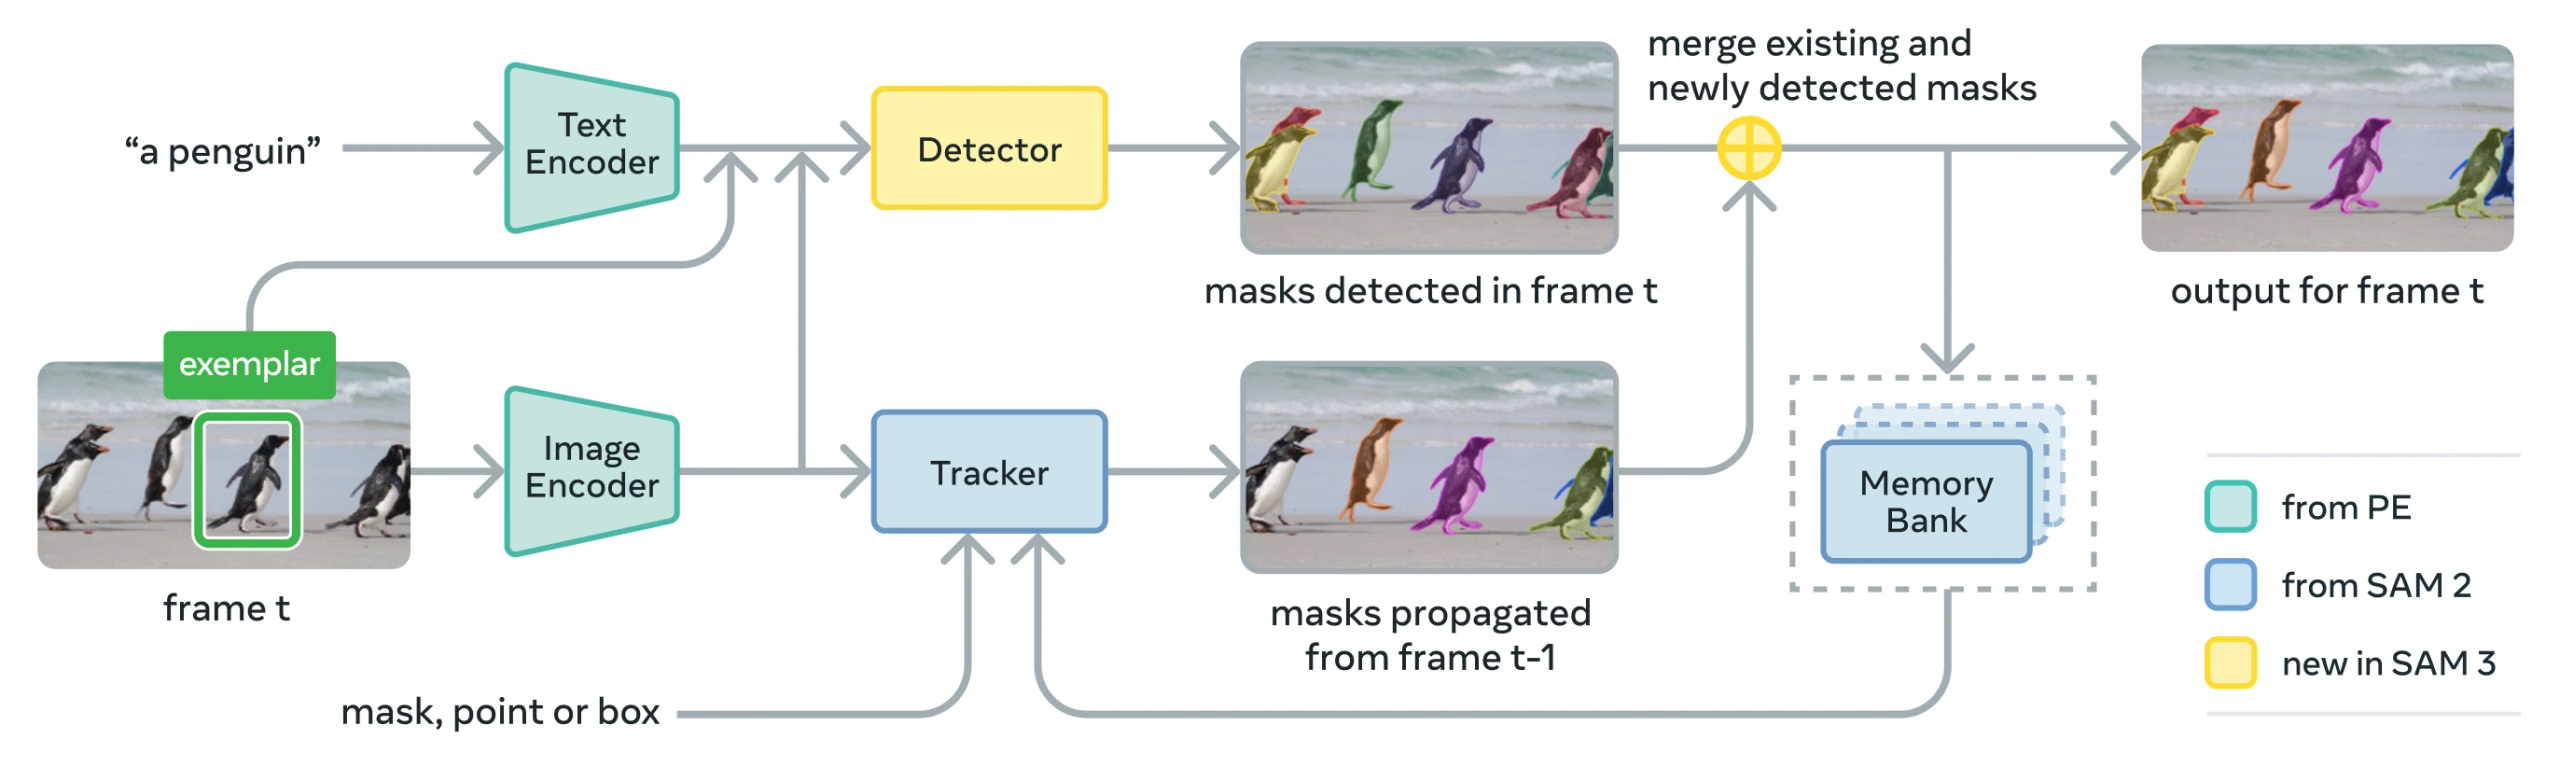
SAM 3 se compose d’un détecteur et d’un suiveur, qui partagent un backbone de vision Perception Encoder (PE). Cette conception découplée évite les conflits entre les tâches tout en permettant la détection au niveau de l’image et le suivi au niveau de la vidéo, avec une interface compatible avec l’utilisation de Python et de la CLI d’Ultralytics.
Composants principaux#
-
Détecteur : architecture basée sur DETR pour la détection de concepts au niveau de l’image
- Encodeur de texte pour les invites sous forme de groupes nominaux
- Encodeur d’exemples pour les invites basées sur des images
- Encodeur de fusion pour conditionner les caractéristiques de l’image à partir des invites
- Nouvelle tête de présence qui dissocie la reconnaissance (« quoi ») de la localisation (« où »)
- Tête de masque pour générer des masques de segmentation d’instances
-
Suivi : segmentation vidéo avec mémoire, héritée de SAM 2
- Encodeur d’invites, décodeur de masques, encodeur de mémoire
- Banque mémoire pour stocker l’apparence des objets d’une image à l’autre
-
Jeton de présence : un jeton global appris qui prédit si le concept cible est présent dans l’image ou l’image vidéo, améliorant la détection en séparant la reconnaissance de la localisation.
Principales innovations#
- Découplage de la reconnaissance et de la localisation : la tête de présence prédit globalement la présence d’un concept, tandis que les requêtes de proposition se concentrent uniquement sur la localisation, ce qui évite les objectifs contradictoires.
- Prompts unifiés pour les concepts et les éléments visuels : prend en charge à la fois PCS (prompts conceptuels) et PVS (prompts visuels, comme les clics et les cadres de SAM 2) au sein d’un seul modèle.
- Affinement interactif par exemples : les utilisateurs peuvent ajouter des exemples d’images positifs ou négatifs pour affiner les résultats de manière itérative ; le modèle généralise alors à des objets similaires au lieu de corriger uniquement des instances individuelles.
- Désambiguïsation temporelle : utilise les scores de détection des masklets et un nouveau prompt périodique pour gérer les occultations, les scènes encombrées et les échecs de suivi dans les vidéos, conformément aux bonnes pratiques de segmentation d’instances et de suivi.
Jeu de données SA-Co#
SAM 3 est entraîné sur Segment Anything with Concepts (SA-Co), le jeu de données de segmentation de Meta le plus vaste et le plus diversifié à ce jour, qui va au-delà des benchmarks courants comme COCO et LVIS.
Données d’entraînement#
| Composant du jeu de données | Description | Échelle |
|---|---|---|
| SA-Co/HQ | Données d’images de haute qualité annotées par des humains, issues d’un moteur de données en 4 phases | 5,2 M d’images, 4 M de groupes nominaux uniques |
| SA-Co/SYN | Jeu de données synthétique annoté par l’IA sans intervention humaine | 38 M de groupes nominaux, 1,4 Md de masques |
| SA-Co/EXT | 15 jeux de données externes enrichis avec des exemples négatifs difficiles | Varie selon la source |
| SA-Co/VIDEO | Annotations vidéo avec suivi temporel | 52,5 k vidéos, 24,8 k groupes nominaux uniques |
Données de benchmark#
Le benchmark d’évaluation SA-Co contient 214 k expressions uniques réparties sur 126 k images et vidéos, soit plus de 50× plus de concepts que les benchmarks existants. Il comprend :
- SA-Co/Gold : 7 domaines, avec trois annotations par élément pour mesurer les limites des performances humaines
- SA-Co/Silver : 10 domaines, avec une seule annotation humaine
- SA-Co/Bronze et SA-Co/Bio : 9 jeux de données existants adaptés à la segmentation de concepts
- SA-Co/VEval : benchmark vidéo avec 3 domaines (SA-V, YT-Temporal-1B, SmartGlasses)
Innovations du moteur de données#
Le moteur de données évolutif de SAM 3, avec intervention humaine et du modèle dans la boucle, atteint un débit d’annotation 2× supérieur grâce aux éléments suivants :
- Annotateurs IA : les modèles basés sur Llama proposent divers groupes nominaux, y compris des exemples négatifs difficiles
- Vérificateurs IA : des LLM multimodaux affinés vérifient la qualité et l’exhaustivité des masques avec des performances proches de celles des humains
- Exploration active : concentre les efforts humains sur les cas d’échec difficiles où l’IA rencontre des difficultés
- Fondé sur une ontologie : utilise une grande ontologie ancrée dans Wikidata pour couvrir les concepts
Installation#
Installe ou mets à niveau le package ultralytics :
pip install -U ultralyticsContrairement aux autres modèles Ultralytics, les poids de SAM 3 (sam3.pt) ne sont pas téléchargés automatiquement. Tu dois d’abord demander l’accès aux poids du modèle sur la page du modèle SAM 3 sur Hugging Face, puis, une fois ta demande approuvée, télécharger sam3.pt depuis cette page. Place le fichier sam3.pt téléchargé dans ton répertoire de travail ou indique le chemin d’accès complet lors du chargement du modèle.
L’accès aux poids de SAM 3.1 (sam3.1_multiplex.pt) est également soumis à une autorisation sur la page du modèle SAM 3.1. Passe sam3.1_multiplex.pt partout où les exemples d’images ci-dessous utilisent sam3.pt.
Si tu obtiens l’erreur ci-dessus pendant la prédiction, cela signifie que la version du package clip installée est incorrecte. Installe la version correcte du package clip en exécutant la commande suivante :
pip uninstall clip -y
pip install git+https://github.com/ultralytics/CLIP.git
Comment utiliser SAM 3 : polyvalence de la segmentation de concepts#
SAM 3 prend en charge les tâches PCS (segmentation de concepts guidée par prompts) et PVS (segmentation visuelle guidée par prompts) au moyen de différentes interfaces de prédiction :
Tâches et modèles pris en charge#
| Type de tâche | Types de prompts | Sortie |
|---|---|---|
| Segmentation de concepts (PCS) | Texte (groupes nominaux), exemples d’images | Toutes les instances correspondant au concept |
| Segmentation visuelle (PVS) | Points, cadres, masques | Instance d’un seul objet (style SAM 2) |
| Affinage interactif | Ajoute ou supprime des exemples ou des clics de manière itérative | Segmentation affinée et plus précise |
Exemples de segmentation de concepts#
Segmenter avec des prompts textuels#
Trouve et segmente toutes les instances d’un concept à l’aide d’une description textuelle. Les prompts textuels nécessitent l’interface SAM3SemanticPredictor.
from ultralytics.models.sam import SAM3SemanticPredictor

# Initialiser le prédicteur avec la configuration
overrides = {
    "conf": 0.25,
    "task": "segment",
    "mode": "predict",
    "model": "sam3.pt",
    "quantize": 16,  # Utiliser FP16 pour accélérer l’inférence
    "save": True,
}
predictor = SAM3SemanticPredictor(overrides=overrides)

# Définir l’image une seule fois pour plusieurs requêtes
predictor.set_image("path/to/image.jpg")

# Effectuer une requête avec plusieurs prompts textuels
results = predictor(text=["person", "bus", "glasses"])

# Fonctionne avec des expressions descriptives
results = predictor(text=["person with red cloth", "person with blue cloth"])

# Effectuer une requête avec un seul concept
results = predictor(text=["a person"])
Segmenter avec des exemples d’images#
Utilise des cadres de délimitation comme prompts visuels pour trouver toutes les instances similaires. Cela nécessite également SAM3SemanticPredictor pour la mise en correspondance par concept.
from ultralytics.models.sam import SAM3SemanticPredictor

# Initialiser le prédicteur
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "model": "sam3.pt", "quantize": 16, "save": True}
predictor = SAM3SemanticPredictor(overrides=overrides)

# Définir l’image
predictor.set_image("path/to/image.jpg")

# Fournir des exemples de cadres de délimitation pour segmenter des objets similaires
results = predictor(bboxes=[[480.0, 290.0, 590.0, 650.0]])

# Plusieurs cadres de délimitation comme exemples d’un même concept visuel
results = predictor(bboxes=[[539, 599, 589, 639], [343, 267, 499, 662]])
Inférence fondée sur les caractéristiques pour gagner en efficacité#
Extrais les caractéristiques de l’image une seule fois et réutilise-les pour plusieurs requêtes de segmentation afin d’améliorer l’efficacité.
import cv2

from ultralytics.models.sam import SAM3SemanticPredictor
from ultralytics.utils.plotting import Annotator, colors

# Initialiser les prédicteurs
overrides = {"conf": 0.50, "task": "segment", "mode": "predict", "model": "sam3.pt", "verbose": False}
predictor = SAM3SemanticPredictor(overrides=overrides)
predictor2 = SAM3SemanticPredictor(overrides=overrides)

# Extraire les caractéristiques avec le premier prédicteur
source = "path/to/image.jpg"
predictor.set_image(source)
src_shape = cv2.imread(source).shape[:2]

# Configurer le deuxième prédicteur et réutiliser les caractéristiques
predictor2.setup_model()

# Effectuer l’inférence avec les caractéristiques partagées et un prompt textuel
masks, boxes = predictor2.inference_features(predictor.features, src_shape=src_shape, text=["person"])

# Effectuer l’inférence avec les caractéristiques partagées et un prompt par cadre de délimitation
masks, boxes = predictor2.inference_features(predictor.features, src_shape=src_shape, bboxes=[[439, 437, 524, 709]])

# Visualiser les résultats
if masks is not None:
    masks, boxes = masks.cpu().numpy(), boxes.cpu().numpy()
    im = cv2.imread(source)
    annotator = Annotator(im, pil=False)
    annotator.masks(masks, [colors(x, True) for x in range(len(masks))])

    cv2.imshow("result", annotator.result())
    cv2.waitKey(0)
Segmentation de concepts dans les vidéos#
Suivre des concepts dans une vidéo à l’aide de cadres de délimitation#
Détecte et suis les instances d’objets sur les différentes images d’une vidéo à l’aide de prompts par cadre de délimitation.
from ultralytics.models.sam import SAM3VideoPredictor

# Créer le prédicteur vidéo
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "model": "sam3.pt", "quantize": 16}
predictor = SAM3VideoPredictor(overrides=overrides)

# Suivre les objets à l’aide de prompts par cadre de délimitation
results = predictor(source="path/to/video.mp4", bboxes=[[706.5, 442.5, 905.25, 555], [598, 635, 725, 750]], stream=True)

# Traiter et afficher les résultats
for r in results:
    r.show()  # Afficher l’image avec les masques de segmentation
Suivre des concepts à l’aide de prompts textuels#
Suis toutes les instances des concepts spécifiés par le texte sur les différentes images d’une vidéo.
from ultralytics.models.sam import SAM3VideoSemanticPredictor

# Initialiser le prédicteur vidéo sémantique
overrides = {
    "conf": 0.25,
    "task": "segment",
    "mode": "predict",
    "imgsz": 640,
    "model": "sam3.pt",
    "quantize": 16,
    "save": True,
}
predictor = SAM3VideoSemanticPredictor(overrides=overrides)

# Suivre les concepts à l’aide de prompts textuels
results = predictor(source="path/to/video.mp4", text=["person", "bicycle"], stream=True)

# Traiter les résultats
for r in results:
    r.show()  # Afficher l’image avec les objets suivis

# Autre possibilité : effectuer le suivi avec des prompts par cadre de délimitation
results = predictor(
    source="path/to/video.mp4",
    bboxes=[[864, 383, 975, 620], [705, 229, 782, 402]],
    labels=[1, 1],  # Étiquettes positives
    stream=True,
)
Prompts visuels (compatibilité avec SAM 2)#
SAM 3 assure une rétrocompatibilité complète avec les prompts visuels de SAM 2 pour la segmentation d’un seul objet :
L’interface de base SAM fonctionne exactement comme SAM 2 : elle segmente uniquement la zone précise indiquée par les prompts visuels (points, cadres ou masques).
from ultralytics import SAM

model = SAM("sam3.pt")

# Invite avec un seul point - segmente l’objet à un emplacement précis
results = model.predict(source="path/to/image.jpg", points=[900, 370], labels=[1])
results[0].show()

# Plusieurs points - segmente un seul objet à l’aide de plusieurs indications de points
results = model.predict(source="path/to/image.jpg", points=[[400, 370], [900, 370]], labels=[1, 1])

# Invite par boîte - segmente l’objet dans une boîte englobante
results = model.predict(source="path/to/image.jpg", bboxes=[100, 150, 300, 400])
results[0].show()L’utilisation de SAM("sam3.pt") avec des invites visuelles (points/boîtes/masques) segmente uniquement l’objet spécifique à cet emplacement, tout comme SAM 2. Pour segmenter toutes les instances d’un concept, utilise SAM3SemanticPredictor avec des invites textuelles ou des exemples, comme indiqué ci-dessus.
Bancs d’essai de performances#
Segmentation d’images#
SAM 3 atteint des résultats de pointe sur plusieurs benchmarks, y compris des jeux de données réels comme LVIS et COCO pour la segmentation :
| Benchmark | Mesure | SAM 3 | Meilleur résultat précédent | Amélioration |
|---|---|---|---|---|
| LVIS (zéro-shot) | AP des masques | 47.0 | 38.5 | +22.1% |
| SA-Co/Gold | CGF1 | 65.0 | 34,3 (OWLv2) | +89.5% |
| COCO (zéro-shot) | AP des boîtes | 53.5 | 52.2 (T-Rex2) | +2.5% |
| ADE-847 (segmentation sémantique) | mIoU | 14.7 | 9.2 (APE-D) | +59.8% |
| PascalConcept-59 | mIoU | 59.4 | 58.5 (APE-D) | +1.5% |
| Cityscapes (segmentation sémantique) | mIoU | 65.1 | 44.2 (APE-D) | +47.3% |
Découvre les options de jeux de données pour mener rapidement des expérimentations dans les jeux de données Ultralytics.
Performances de segmentation vidéo#
SAM 3 affiche des améliorations significatives par rapport à SAM 2 et aux meilleures méthodes précédentes sur des bancs d’essai vidéo tels que DAVIS 2017 et YouTube-VOS :
| Benchmark | Mesure | SAM 3 | SAM 2.1 L | Amélioration |
|---|---|---|---|---|
| MOSEv2 | J&F | 60.1 | 47.9 | +25.5% |
| DAVIS 2017 | J&F | 92.0 | 90.7 | +1.4% |
| LVOSv2 | J&F | 88.2 | 79.6 | +10.8% |
| SA-V | J&F | 84.6 | 78.4 | +7.9% |
| YTVOS19 | J&F | 89.6 | 89.3 | +0.3% |
Adaptation à quelques exemples#
SAM 3 s’adapte à de nouveaux domaines à partir de quelques exemples, une capacité utile pour les workflows d’IA centrée sur les données :
| Benchmark | AP à 0 exemple | AP à 10 exemples | Meilleur résultat précédent (10 exemples) |
|---|---|---|---|
| ODinW13 | 59.9 | 71.6 | 67.9 (gDino1.5-Pro) |
| RF100-VL | 14.3 | 35.7 | 33.7 (gDino-T) |
Efficacité du raffinement interactif#
Le prompting par concept de SAM 3 avec des exemples converge beaucoup plus rapidement que le prompting visuel :
| Invites ajoutées | Score CGF1 | Gain par rapport au texte seul | Gain par rapport à la référence PVS |
|---|---|---|---|
| Texte seul | 46.4 | référence | référence |
| +1 exemple | 57.6 | +11.2 | +6.7 |
| +2 exemples | 62.2 | +15.8 | +9.7 |
| +3 exemples | 65.0 | +18.6 | +11.2 |
| +4 exemples | 65.7 | +19.3 | +11.5 (palier) |
Précision du comptage d’objets#
SAM 3 permet un comptage précis en segmentant toutes les instances, un besoin courant en comptage d’objets :
| Benchmark | Précision | MAE | par rapport au meilleur MLLM |
|---|---|---|---|
| CountBench | 95.6% | 0.11 | 92.4% (Gemini 2.5) |
| PixMo-Count | 87.3% | 0.22 | 88.8% (Molmo-72B) |
Comparaison entre SAM 3, SAM 2 et YOLO#
Nous comparons ici les capacités de SAM 3 à celles de SAM 2 et des modèles YOLO26 :
| Capacité | SAM 3 | SAM 2 | YOLO26n-seg |
|---|---|---|---|
| Segmentation par concept | ✅ Toutes les instances à partir de texte/d’exemples | ❌ Non pris en charge | ❌ Non pris en charge |
| Segmentation visuelle | ✅ Instance unique (compatible avec SAM 2) | ✅ Instance unique | ✅ Toutes les instances |
| Capacité zéro-shot | ✅ Vocabulaire ouvert | ✅ Invites géométriques | ❌ Ensemble fermé |
| Affinage interactif | ✅ Exemples et clics | ✅ Clics uniquement | ❌ Non pris en charge |
| Suivi vidéo | ✅ Plusieurs objets avec identifiants | ✅ Plusieurs objets | ✅ Plusieurs objets |
| AP des masques LVIS (zéro-shot) | 47.0 | S. O. | S. O. |
| MOSEv2 J&F | 60.1 | 47.9 | S. O. |
| Vitesse (GPU, ms/image) | 2921 | 857 | 8.4 |
| Taille du modèle | 3.45 GB | 162 MB (base) | 6.4 MB |
Vitesse mesurée sur NVIDIA RTX PRO 6000 avec torch==2.9.1 et ultralytics==8.4.19.
Points clés :
- SAM 3 : Idéal pour la segmentation de concepts à vocabulaire ouvert et pour trouver toutes les instances d’un concept à l’aide d’invites textuelles ou d’exemples
- SAM 2 : Idéal pour la segmentation interactive d’un seul objet dans des images et des vidéos à l’aide d’invites géométriques
- YOLO26 : Idéal pour une segmentation rapide en temps réel, avec inférence de bout en bout sans NMS en option, exportable dans de nombreux formats pour un déploiement sur GPU, CPU et appareils en périphérie
- YOLOE : idéal pour la détection et la segmentation en temps réel avec un vocabulaire ouvert, à partir d’invites textuelles ou visuelles
Comparaison de SAM et YOLO#
Comparaison de SAM 3, SAM 2, SAM, MobileSAM et FastSAM avec les modèles de segmentation YOLO d’Ultralytics (YOLOv8, YOLO11, YOLO26) en termes de taille, de nombre de paramètres et de vitesse d’inférence sur GPU :
| Modèle | Taille (MB) | Paramètres (M) | Vitesse (GPU) (ms/im) |
|---|---|---|---|
| Meta SAM-b | 375 | 93.7 | 1306 |
| Meta SAM2-b | 162 | 80.8 | 857 |
| Meta SAM2-t | 78.1 | 38.9 | 668 |
| Meta SAM3 | 3450 | 473.6 | 2921 |
| MobileSAM | 40.7 | 10.1 | 605 |
| FastSAM-s avec le réseau de base YOLOv8 | 23.7 | 11.8 | 55.9 |
| Ultralytics YOLOv8n-seg | 6.7 (515x plus petit) | 3.4 (139.1x de moins) | 17.4 (167x plus rapide) |
| Ultralytics YOLO11n-seg | 5.9 (585x plus petit) | 2.9 (163.1x de moins) | 12.6 (231x plus rapide) |
| Ultralytics YOLO26n-seg | 6.4 (539x plus petit) | 2.7 (175.2x de moins) | 8.4 (347x plus rapide) |
Cette comparaison met en évidence les différences considérables de taille et de vitesse entre les variantes de SAM et les modèles de segmentation YOLO. SAM offre des capacités uniques de segmentation automatique, mais les modèles YOLO, en particulier YOLOv8n-seg, YOLO11n-seg et YOLO26n-seg, sont nettement plus petits, plus rapides et plus efficaces sur le plan des calculs.
Les tests ont été exécutés sur une NVIDIA RTX PRO 6000 avec 96 Go de VRAM, à l’aide de torch==2.9.1 et ultralytics==8.4.19. Pour reproduire ce test :
from ultralytics import ASSETS, SAM, YOLO, FastSAM

# Profiler SAM3, SAM2-t, SAM2-b, SAM-b, MobileSAM
for file in ["sam_b.pt", "sam2_b.pt", "sam2_t.pt", "mobile_sam.pt", "sam3.pt"]:
    model = SAM(file)
    model.info()
    model(ASSETS)

# Profiler FastSAM-s
model = FastSAM("FastSAM-s.pt")
model.info()
model(ASSETS)

# Profiler les modèles YOLO
for file_name in ["yolov8n-seg.pt", "yolo11n-seg.pt", "yolo26n-seg.pt"]:
    model = YOLO(file_name)
    model.info()
    model(ASSETS, nms=False)  # Tête sans NMS de YOLO26 ; sans effet pour YOLOv8/YOLO11
Métriques d'évaluation#
SAM 3 introduit de nouvelles métriques conçues pour la tâche PCS, qui complètent des mesures connues comme le score F1, la précision et le rappel.
F1 avec seuil de classification (CGF1)#
La métrique principale combinant localisation et classification :
CGF1 = 100 × pmF1 × IL_MCC
Où :
- pmF1 (F1 macro positif) : mesure la qualité de la localisation sur les exemples positifs
- IL_MCC (coefficient de corrélation de Matthews au niveau de l’image) : mesure la précision de la classification binaire (« le concept est-il présent ? »)
Pourquoi ces métriques ?#
Les métriques AP traditionnelles ne tiennent pas compte du calibrage, ce qui complique l’utilisation pratique des modèles. En évaluant uniquement les prédictions dont le niveau de confiance dépasse 0,5, les métriques de SAM 3 imposent un bon calibrage et reproduisent les conditions d’utilisation réelles des boucles interactives de prédiction et de suivi.
Principales études d’ablation et conclusions#
Impact de la tête de présence#
La tête de présence dissocie la reconnaissance de la localisation, ce qui apporte des améliorations significatives :
| Configuration | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| Sans présence | 57.6 | 0.77 | 74.7 |
| Avec présence | 63.3 | 0.82 | 77.1 |
La tête de présence apporte un gain de +5,7 en CGF1 (+9,9 %), principalement en améliorant la capacité de reconnaissance (IL_MCC +6,5 %).
Effet des exemples négatifs difficiles#
| Exemples négatifs difficiles par image | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| 0 | 31.8 | 0.44 | 70.2 |
| 5 | 44.8 | 0.62 | 71.9 |
| 30 | 49.2 | 0.68 | 72.3 |
Les exemples négatifs difficiles sont essentiels à la reconnaissance à vocabulaire ouvert : ils améliorent IL_MCC de 54,5 % (0,44 → 0,68).
Mise à l’échelle des données d’entraînement#
| Sources de données | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| Données externes uniquement | 30.9 | 0.46 | 66.3 |
| Données externes + synthétiques | 39.7 | 0.57 | 70.6 |
| Données externes + haute qualité | 51.8 | 0.71 | 73.2 |
| Les trois | 54.3 | 0.74 | 73.5 |
Les annotations humaines de haute qualité apportent des gains importants par rapport aux données synthétiques ou externes utilisées seules. Pour en savoir plus sur les pratiques de qualité des données, consulte la page sur la collecte et l’annotation des données.
Applications#
La capacité de segmentation de concepts de SAM 3 ouvre la voie à de nouveaux cas d’utilisation :
- Modération de contenu : trouver toutes les occurrences de types de contenu spécifiques dans des bibliothèques multimédias
- Commerce en ligne : segmenter tous les produits d’un type donné dans les images de catalogues, pour faciliter l’annotation automatique
- Imagerie médicale : identifier toutes les occurrences de types de tissus ou d’anomalies spécifiques
- Systèmes autonomes : suivre toutes les occurrences de panneaux de signalisation, de piétons ou de véhicules par catégorie
- Analyse vidéo : compter et suivre toutes les personnes portant des vêtements spécifiques ou effectuant certaines actions
- Annotation de jeux de données : annoter rapidement toutes les occurrences de catégories d’objets rares
- Recherche scientifique : quantifier et analyser tous les spécimens répondant à des critères spécifiques
Agent SAM 3 : raisonnement linguistique étendu#
SAM 3 peut être associé à de grands modèles de langage multimodaux (MLLM) pour traiter des requêtes complexes nécessitant un raisonnement, dans le même esprit que des systèmes à vocabulaire ouvert comme OWLv2 et T-Rex.
Performances sur les tâches de raisonnement#
| Benchmark | Mesure | Agent SAM 3 (Gemini 2.5 Pro) | Meilleur résultat précédent |
|---|---|---|---|
| ReasonSeg (validation) | gIoU | 76.0 | 65.0 (état de l’art) |
| ReasonSeg (test) | gIoU | 73.8 | 61.3 (état de l’art) |
| OmniLabel (validation) | AP | 46.7 | 36.5 (REAL) |
| RefCOCO+ | Acc | 91.2 | 89.3 (LISA) |
Exemples de requêtes complexes#
L’agent SAM 3 peut traiter des requêtes nécessitant un raisonnement :
- « Des personnes assises qui ne tiennent pas de boîte cadeau dans leurs mains »
- « Le chien le plus proche de la caméra qui ne porte pas de collier »
- « Des objets rouges plus grands que la main de la personne »
Le MLLM propose à SAM 3 des requêtes simples sous forme de groupes nominaux, analyse les masques obtenus et recommence jusqu’à obtenir le résultat souhaité.
Limites#
SAM 3 présente les limites suivantes :
- Complexité des expressions : convient surtout aux groupes nominaux simples ; les expressions référentielles longues ou les raisonnements complexes peuvent nécessiter l’intégration d’un MLLM
- Gestion de l’ambiguïté : certains concepts restent intrinsèquement ambigus (par ex. « petite fenêtre », « pièce accueillante »)
- Exigences de calcul : plus volumineux et plus lent que des modèles de détection spécialisés comme YOLO
- Étendue du vocabulaire : axé sur des concepts visuels élémentaires ; le raisonnement compositionnel est limité sans l’aide d’un MLLM
- Concepts rares : les performances peuvent diminuer pour les concepts extrêmement rares ou très précis, peu représentés dans les données d’entraînement
Citation#
@misc{carion2025sam3,
  title         = {SAM 3: Segment Anything with Concepts},
  author        = {Nicolas Carion and Laura Gustafson and Yuan-Ting Hu and Shoubhik Debnath and Ronghang Hu and Didac Suris and Chaitanya Ryali and Kalyan Vasudev Alwala and Haitham Khedr and Andrew Huang and Jie Lei and Tengyu Ma and Baishan Guo and Arpit Kalla and Markus Marks and Joseph Greer and Meng Wang and Peize Sun and Roman R{\"a}dle and Triantafyllos Afouras and Effrosyni Mavroudi and Katherine Xu and Tsung-Han Wu and Yu Zhou and Liliane Momeni and Rishi Hazra and Shuangrui Ding and Sagar Vaze and Francois Porcher and Feng Li and Siyuan Li and Aishwarya Kamath and Ho Kei Cheng and Piotr Doll{\'a}r and Nikhila Ravi and Kate Saenko and Pengchuan Zhang and Christoph Feichtenhofer},
  year          = {2025},
  eprint        = {2511.16719},
  archivePrefix = {arXiv},
  primaryClass  = {cs.CV},
  url           = {https://arxiv.org/abs/2511.16719}
}FAQ#
SAM 3 a été publié par Meta le 19 novembre 2025 et est entièrement intégré au package
ultralytics, avec la prise en charge de la prédiction sur image et du suivi vidéo par des prédicteurs dédiés.Oui. SAM 3 est entièrement intégré au package Python Ultralytics, notamment pour la segmentation de concepts, les invites visuelles de type SAM 2 et le suivi vidéo de plusieurs objets. SAM 3 et SAM 3.1 alimentent également la fonctionnalité d’annotation intelligente de Ultralytics Platform, où SAM 3.1 est le modèle par défaut et te permet d’annoter des images en quelques clics. Pour les jeux de données de détection comportant de 1 à 200 classes, SAM 3 Text et SAM 3.1 Text peuvent aussi générer automatiquement des annotations à partir des noms de classes ; le classement VLM compare leur précision à celle des modèles de langage visuel.
Oui, pour la prédiction sur des images. Charge
sam3.1_multiplex.ptpartout où les exemples d’images de cette page utilisentsam3.pt:SAM("sam3.1_multiplex.pt")pour les invites par points et par boîtes, etSAM3SemanticPredictorpour les invites textuelles et par exemples. Le suivi vidéo Object Multiplex n’est pas encore pris en charge ; continue donc d’utilisersam3.ptavec les prédicteurs vidéo. Consulte SAM 3.1 pour découvrir les benchmarks de Meta.PCS est une nouvelle tâche introduite dans SAM 3 qui segmente toutes les occurrences d’un concept visuel dans une image ou une vidéo. Contrairement à la segmentation traditionnelle, qui cible une instance d’objet spécifique, PCS détecte chaque occurrence d’une catégorie. Par exemple :
- Invite textuelle : « autobus scolaire jaune » → segmente tous les autobus scolaires jaunes de la scène
- Exemple d’image : encadre un chien → segmente tous les chiens de l’image
- Combiné : « chat tigré » + boîte d’exemple → segmente tous les chats tigrés correspondant à l’exemple
Fonctionnalité SAM 2 SAM 3 Tâche Un objet par invite Toutes les instances d’un concept Types d’invites Points, cadres, masques + Expressions textuelles, exemples d’images Capacité de détection Nécessite un détecteur externe Détecteur intégré à vocabulaire ouvert Reconnaissance Basée uniquement sur la géométrie Reconnaissance textuelle et visuelle Architecture Suivi uniquement Détecteur + suivi avec tête de présence Performances sans apprentissage préalable Sans objet (nécessite des invites visuelles) 47,0 AP sur LVIS, 2× meilleur sur SA-Co Affinage interactif Clics uniquement Clics + généralisation à partir d’exemples SAM 3 conserve la compatibilité ascendante avec les invites visuelles de SAM 2, tout en ajoutant des capacités basées sur les concepts.
SAM 3 est entraîné sur le jeu de données Segmentation universelle avec concepts (SA-Co) :
Données d’entraînement :
- 5,2 M d’images avec 4 M d’expressions nominales uniques (SA-Co/HQ) - annotations humaines de haute qualité
- 52,5 K vidéos avec 24,8 K expressions nominales uniques (SA-Co/VIDEO)
- 1,4 Md de masques synthétiques couvrant 38 M d’expressions nominales (SA-Co/SYN)
- 15 jeux de données externes enrichis avec des exemples négatifs difficiles (SA-Co/EXT)
Données d’évaluation :
- 214 K concepts uniques répartis sur 126 K images/vidéos
- 50× plus de concepts que les benchmarks existants (par exemple, LVIS compte ~4 K concepts)
- Triple annotation sur SA-Co/Gold pour mesurer les limites des performances humaines
Cette échelle et cette diversité sous-tendent la généralisation zéro-shot de SAM 3 à des concepts à vocabulaire ouvert.
SAM 3 et YOLO26 répondent à des cas d’usage différents :
Avantages de SAM 3 :
- Vocabulaire ouvert : segmente n’importe quel concept à partir d’invites textuelles, sans entraînement
- Sans apprentissage préalable : fonctionne immédiatement sur de nouvelles catégories
- Interactif : l’affinage à partir d’exemples se généralise à des objets similaires
- Basé sur les concepts : détecte automatiquement toutes les instances d’une catégorie
- Précision : 47,0 AP en segmentation d’instances sans apprentissage préalable sur LVIS
Avantages de YOLO26 :
- Vitesse : inférence bien plus rapide, avec une tête de bout en bout sans NMS en option
- Efficacité : modèles 539× plus petits (6,4 Mo contre 3,45 Go)
- Adapté aux ressources limitées : fonctionne sur les appareils de périphérie et les appareils mobiles
- Temps réel : optimisé pour les déploiements en production
Recommandation :
- Utilise SAM 3 pour une segmentation flexible à vocabulaire ouvert lorsque tu dois trouver toutes les instances de concepts décrits par du texte ou des exemples
- Utilise YOLO26 pour les déploiements en production à grande vitesse lorsque les catégories sont connues à l’avance
- Utilise SAM 2 pour la segmentation interactive d’un seul objet avec des invites géométriques
SAM 3 est conçu pour les expressions nominales simples (par exemple, « pomme rouge », « personne portant un chapeau »). Pour les requêtes complexes nécessitant du raisonnement, combine SAM 3 avec un MLLM sous la forme de SAM 3 Agent :
Requêtes simples (SAM 3 natif) :
- « bus scolaire jaune »
- « chat tigré »
- « personne portant un chapeau rouge »
Requêtes complexes (SAM 3 Agent avec MLLM) :
- « Les personnes assises qui ne tiennent pas de boîte cadeau »
- « Le chien le plus proche de la caméra qui ne porte pas de collier »
- « Des objets rouges plus grands que la main de la personne »
SAM 3 Agent atteint 76,0 gIoU sur l’ensemble de validation de ReasonSeg (contre 65,0 pour le précédent meilleur résultat, soit une amélioration de +16,9 %) en combinant la segmentation de SAM 3 avec les capacités de raisonnement d’un MLLM.
Sur le benchmark SA-Co/Gold avec une triple annotation humaine :
- Limite basse humaine : 74,2 CGF1 (annotateur le plus conservateur)
- Performances de SAM 3 : 65,0 CGF1
- Résultat : 88 % de la limite basse humaine estimée
- Limite haute humaine : 81,4 CGF1 (annotateur le plus permissif)
SAM 3 obtient de solides performances, proches de la précision humaine, en segmentation de concepts à vocabulaire ouvert ; l’écart concerne principalement les concepts ambigus ou subjectifs (par exemple, « petite fenêtre », « pièce chaleureuse »).


Commentaires105
Pose une question, partage tes résultats ou aide quelqu’un d’autre.
 Glenn JocherUltralytics(modifié)
SAM 3 looks like a big step forward for open-vocabulary segmentation, and it is now supported natively in
ultralytics. This page covers text, exemplar and video prompts; thesam3.ptweights are gated and must be requested from Meta on Hugging Face first.Feel free to drop questions or comments for the team below!
7koolfox
Incredible, when you think it’s available for use?
2- Glenn JocherUltralytics(modifié)
SAM 3 is available now in
ultralytics: runpip install -U ultralyticsand see this page for usage. Thesam3.ptweights must be requested from Meta first. Abdulhady-WITCo
Appreciate the effort, and can't wait for your implementation. It's resource heavy already but I'm sure your optimisation will make a difference. Best of luck.
- Glenn JocherUltralytics(modifié)
Thanks for the kind words—most of the credit goes to the Meta SAM team and the Ultralytics community. SAM 3 is now available in
ultralytics, and this page covers exactly those trade-offs, so you can balance its open-vocabulary power against lighter options like YOLO26 or SAM 2 on your hardware.
mishaogui
sam3如何把預訓練模型導出onnx進行推理,目前官方好像還不支持導出,求導出和推理。
1- Glenn JocherUltralytics(modifié)
目前
ultralytics里 SAM 3 只支持predict/track推理,还没有提供把sam3.pt导出 ONNX 的官方流程(yolo export主要面向 YOLO 等可部署导出管线的模型);建议先按 SAM 3 使用文档 用 PyTorch 方式部署推理。如果你的目标是 ONNX 部署分割(固定类别/已知类别),更推荐直接用可导出的 YOLO26 分割 并参考 Export 模式;若你这边是“必须 SAM3→ONNX”的需求,麻烦在 Ultralytics 新建 Issue 说明场景并附上
yolo checks和最小复现脚本,方便我们评估支持路径。
tomer196
Hi, thanks for the great work. I am trying to use sam3.1. Is it supported? I tried using sam3.1 weights, and it seems to work, but each frame the objects get new IDs. Am I doing something wrong? Thanks
- Glenn JocherUltralytics(modifié)
SAM 3.1 is supported for image prediction: load
sam3.1_multiplex.ptwherever the image examples usesam3.pt(SAM("sam3.1_multiplex.pt")for point and box prompts,SAM3SemanticPredictorfor text and exemplar prompts). Object Multiplex video tracking is not supported yet, so usesam3.ptwithSAM3VideoPredictororSAM3VideoSemanticPredictor. For stable identities across frames, run a video predictor on the full video rather than image inference frame-by-frame, since per-frame inference assigns fresh IDs each time. See the SAM 3 docs and the SAM predictor reference, and if you’re already doing that please drop a minimal repro plusyolo checksoutput here so the team can take a closer look.
yccckid
你好,我测试下来输入的常见的类别的提示词(包括一些限定词)都是可以分割的。不过提示词输入得越多确实MLLM时间会更长,sam分割倒是挺快的。你说的这个“ 只有在单点(正负样本)和掩码提示(精细化粗糙掩码)是会出现分割源码出现零碎和空洞现象 ”是在分割什么物体?物体的表面纹理是不是比较sparsely textured?怎么解决的?谢谢
On Thu, 23 Apr 2026 at 09:11, Yiwang2333 @.***> wrote:
我之前使用MLLM与SAM3结合起来成为SAM 3 Agent进行测试并没有发现分割的掩码出现空洞问题,他们都是完整的,只不过会出现分割不了提示词中的内容,而且耗时这方面会增加,这也正常。只有在单点(正负样本)和掩码提示(精细化粗糙掩码)是会出现分割源码出现零碎和空洞现象
— Reply to this email directly, view it on GitHub https://github.com/orgs/ultralytics/discussions/22441?email_source=notifications&email_token=APKLLPPMDYK4F36HG6B3BOL4XFUUJA5CNFSNUABIM5UWIORPF5TWS5BNNB2WEL2ENFZWG5LTONUW63SDN5WW2ZLOOQXTCNRWG43TCMBVUZZGKYLTN5XKOY3PNVWWK3TUUVSXMZLOOSWGM33PORSXEX3DNRUWG2Y#discussioncomment-16677105, or unsubscribe https://github.com/notifications/unsubscribe-auth/APKLLPKUZ2OAWS3Y672TETD4XFUUJAVCNFSM6AAAAACJTVH7HGVHI2DSMVQWIX3LMV43URDJONRXK43TNFXW4Q3PNVWWK3TUHMYTMNRXG4YTANI . You are receiving this because you commented.Message ID: @.*** com>
- Glenn JocherUltralytics
这种情况更像是
SAM("sam3.pt")的视觉提示分割问题而不是概念分割本身:单点或粗掩码在细长边界、低对比度或稀疏纹理目标上更容易出现碎片和空洞,通常可通过增加正负点、改用更紧的框提示,或直接用SAM3SemanticPredictor做文本/示例提示来改善,相关用法见 SAM 3 文档;如果你愿意,也欢迎把一张示例图和最小复现代码直接发在这个讨论里,我们可以按你的具体 case 看看。 Yiwang2333
其实我也想把示例和代码文件展示出来,但是可能我太蠢了不知道怎么发在这个讨论中,我已急哭😭
- Glenn JocherUltralytics
没关系,直接发在这里就可以:图片可直接拖到评论框上传,代码按 GitHub Markdown 写法 用代码块贴出;如果文件太大,就先发一个最小复现示例,只保留
model初始化、输入图像、提示词和实际输出即可,例如:from ultralytics import SAM model = SAM("sam3.pt") results = model.predict("test.jpg", points=[900, 370], labels=[1]) print(results[0].masks.data.shape if results[0].masks is not None else None)如果暂时不方便传图,也可以先把异常现象和文字版输出贴出来,我们继续帮你看。
一、单点分割 import numpy as np import torch from PIL import Image from sam3.model_builder import build_sam3_image_model from sam3.model.sam3_image_processor import Sam3Processor
device = "cuda" if torch.cuda.is_available() else "cpu" sam3_pt_path = "sam3_model/sam3.pt"
model = build_sam3_image_model( bpe_path=None, checkpoint_path=sam3_pt_path, device=device, enable_inst_interactivity=True, load_from_HF=False, ) processor = Sam3Processor(model) model.eval()
pil_image = Image.open("test.jpg").convert("RGB") inference_state = processor.set_image(pil_image)
正样本(1) + 负样本(0),点数与标签一一对应
point_coords = np.array([ [900.0, 370.0], # 前景点:点在目标上 [800.0, 400.0], # 背景点:点在要排除的区域 ]) point_labels = np.array([1, 0])
masks, scores, logits = model.predict_inst( inference_state, point_coords=point_coords, point_labels=point_labels, multimask_output=True, ) best = masks[int(np.argmax(scores))] mask_np = best.cpu().numpy() if isinstance(best, torch.Tensor) else np.asarray(best) print(mask_np.shape)
二、交互式细化 import numpy as np import torch from PIL import Image from sam3.model_builder import build_sam3_image_model from sam3.model.sam3_image_processor import Sam3Processor
device = "cuda" if torch.cuda.is_available() else "cpu" sam3_pt_path = "sam3_model/sam3.pt"
model = build_sam3_image_model( bpe_path=None, checkpoint_path=sam3_pt_path, device=device, enable_inst_interactivity=True, load_from_HF=False, ) processor = Sam3Processor(model) model.eval()
pil_image = Image.open("test.jpg").convert("RGB") inference_state = processor.set_image(pil_image)
若需要文本提示(与 demo 一致):
inference_state = processor.set_text_prompt(state=inference_state, prompt="your english prompt")
init_x = 900.0 init_y = 370.0 refinement_points = [[910.0, 380.0], [920.0, 360.0]] refinement_labels = [1, 0]
all_points = [[init_x, init_y]] + refinement_points all_labels = [1] + refinement_labels
masks, scores, logits = model.predict_inst( inference_state, point_coords=np.array(all_points), point_labels=np.array(all_labels), multimask_output=True, ) best = masks[int(np.argmax(scores))] mask_np = best.cpu().numpy() if isinstance(best, torch.Tensor) else np.asarray(best) print(mask_np.shape)
测试使用的是同一张图片,分割的内容是图中汽车,在单点分割和交互式细化中正负样本点结合使用会出现分割车辆边缘出现参差不齐零碎现象
- Glenn JocherUltralytics
感谢把代码贴出来,这更像是交互式点提示的行为而不是“汽车”这个类别本身:车窗反光、轮胎空隙和细长边界会让负点一旦靠近车身就容易把掩码边缘切碎或挖空,而且
multimask_output=True返回的最高分候选也不一定是最平滑的那个;建议先把负点移到目标外更远的位置、在断裂边缘补几个正点,或直接改用框/示例提示,如果你的目标是稳定分割整辆车,SAM3SemanticPredictor的文本/示例提示通常比稀疏点提示更稳,相关接口可参考 SAM 3 文档里的视觉提示与概念分割说明。 感谢您的回答,我还有一个问题,就是文本提示分割时,文本提示词可以对多张图片起作用,能做输入一个文本可以对所有图片进行分割,这一个功能已经实现。 但是有一个我实在是难以实现,就是比如有多张图片A、B、C、D...,在纯框选示例提示分割下,能不能做到只在A图上进行框选,然后进行纯框选示例提示分割时可以对A、B、C、D...多张图片进行分割呢。也就是实现一批图片中,只在一张图片上进行框选就能进行所有图片的分割,类似于图片搜索一样,在一批图片中随机挑一张图片,在这张挑选的图片中框选出汽车然后所有图片中的汽车都能被分割出来(类似在一批图片中框选后搜索出有汽车的图片进行分割)。我不知道这个功能是否能做到。 目前我使用的方法是在框选时将框选的目标进行切块,然后拼接在每一张待搜索图片上,最后根据拼接图片中的小目标切块进行示例提示分割,来实现一张图中框选能对所有图片进行分割,不过这种方法的效果有些一般,有时候分割不到东西或者是遗漏一些需要分割的目标。 还有一种方法是评论区向我提供的思路,将几何特征缓存下来,然后再另一张图片上应用这个几何特征,参考https://github.com/leon0514/trt-sam3,但是这位先生也提到了效果不好,目前我也正在尝试实现这种方法。 或者是理解在单图时框选示例提示分割到底在做什么,然后将这个行为重复作用于其他图片,这样是否也能实现呢?
- Glenn JocherUltralytics
目前原生
SAM3SemanticPredictor还不支持“在 A 图框一次,然后直接对 B/C/D 这类独立图片做纯示例检索+分割”;bboxes示例提示是作用在当前set_image()的那张图上,而文档里的inference_features()也是复用同一张图的特征、不是跨图迁移,所以更可靠的做法还是先用文本提示或检索/检测筛出候选图,再逐张做 SAM 3 分割,接口细节可参考 SAM3SemanticPredictor 参考。 好的,谢谢您的回复
shspc
ultralytics支持从其他图像中抽取特征作为视觉提示吗
在SAM3中
- Glenn JocherUltralytics
目前公开接口里,SAM 3 支持用
SAM3SemanticPredictor的bboxes做 exemplar 式视觉提示,也支持用inference_features()复用已提取特征,但文档里的用法主要是对当前图像做特征复用,不是直接把“另一张图像”的特征当作 prompt 传入;你可以先参考 SAM 3 文档 和 predictor API,如果你的目标是跨图像 exemplar prompting,欢迎把最小复现流程贴在这里,团队会继续看。 aoaoy288-oss
想知道,sam3是否能导成ONNX等格式
ZePequeno25
gostei bastante da para integrar diferentes modelos
SWTZJD
想请问SAM3最低支持的python版本和pytorch版本
- Glenn JocherUltralytics
欢迎直接把环境信息贴在这里,团队会看到;按目前公开信息,
SAM 3自ultralytics>=8.3.237起已集成,而ultralytics的基础要求是 Python>=3.8、PyTorch>=1.8,所以SAM 3目前至少按这组版本起步,参考 SAM 3 文档 和 Ultralytics PyPI 安装说明。 (docs.ultralytics.com)
cyt1990cyt1990-dev
运行环境为:Ultralytics 8.4.21 Python-3.11.8 torch-2.5.1+cu121 CUDA:0 (NVIDIA GeForce RTX 4070, 12282MiB) 运行使用掩码提示的概念分割的示例程序报错如下:WARNING imgsz=[640] must be multiple of max stride 14, updating to [644] Traceback (most recent call last): File "C:\Users\admin\PycharmProjects\PythonProject\testMasks.py", line 12, in results = predictor(source=img_path, masks=[rough]) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\engine\predictor.py", line 225, in call return list(self.stream_inference(source, model, *args, **kwargs)) # merge list of Results into one ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\utils_contextlib.py", line 36, in generator_context response = gen.send(None) ^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\engine\predictor.py", line 330, in stream_inference preds = self.inference(im, *args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 205, in inference return self.prompt_inference(im, bboxes, points, labels, masks, multimask_output) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 236, in prompt_inference return self._inference_features(features, *prompts, multimask_output) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 814, in _inference_features pred_masks, pred_scores, _, _ = self.model.sam_mask_decoder( ^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\nn\modules\module.py", line 1736, in _wrapped_call_impl return self._call_impl(*args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\nn\modules\module.py", line 1747, in _call_impl return forward_call(*args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\modules\decoders.py", line 334, in forward masks, iou_pred, mask_tokens_out, object_score_logits = self.predict_masks( ^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\modules\decoders.py", line 398, in predict_masks src = src + dense_prompt_embeddings ~~~~^~~~~~~~~~~~~~~~~~~~~~~~~ RuntimeError: The size of tensor a (46) must match the size of tensor b (161) at non-singleton dimension 3
运行代码如下所示: import cv2 import numpy as np from ultralytics.models.sam import SAM3Predictor
predictor = SAM3Predictor(overrides=dict(task="segment", mode="predict", model="sam/sam3.pt")) img_path = "测试图片/测试图片1/Out.jpg" rough = cv2.imread("测试图片/测试图片1/rough.jpg", cv2.IMREAD_GRAYSCALE) rough = (rough > 0).astype(np.uint8)
results = predictor(source=img_path, masks=[rough]) for result in results: annotated_img = result.plot() cv2.imshow("SAM with Mask Prompt", annotated_img) cv2.waitKey(0) cv2.destroyAllWindows()
图片Out.jpg,rough.jpg是大小为4024*3036,位深度为8的灰度图片
- Glenn JocherUltralytics
感谢补充代码,这个报错看起来不是图片分辨率本身的问题,而是
SAM3Predictor走masks=提示时出现了特征尺寸不匹配;按 SAM 3 文档 当前概念分割应使用SAM3SemanticPredictor配合text或示例bboxes,而SAM("sam3.pt")/SAM3Predictor主要是单对象视觉提示流程。若你在最新版本下仍需要masks提示,请新开一个 issue 并附上yolo checks输出、完整文本回溯和最小可复现脚本,方便我们确认这是否是 SAM 3 的一个 bug。
max-dev-14
I'd compared facebook/sam3 and ultralytics/sam3. I set up both the models for inference as follow: imgsz=1008, half=True, conf=0.5 and prompts = [ "person", "car", "truck", "tractor", "building", "combine harvester", "power lines", "clear sky", "trees", "crop field", "harvested field", "grassy field", "dark frame edges", "farm lane", "windrow" ] I'd attached scripts I used for inference: ul-sam3.py - ultralytics/sam3 inference. fb-sam3.py - facebook/sam3 inference.
I expected that there would be the same results of inference on the same videos and paramteres above. But I'd got different segments, as it can be seen on the screens below (there are original frame to the left, facebook/sam3 segmentation on the middle and ultralytics/sam3 segmentation to the right).
Can someone explain me why it's happened like this?
- Glenn JocherUltralytics
Thanks for raising it here — exact parity with
facebookresearch/sam3isn’t expected, because the Ultralytics integration uses its own SAM 3 predictor path for resizing/preprocessing and postprocessing, so matchingimgsz,half,conf, and prompts alone won’t guarantee identical masks; see the SAM 3 docs and the predictor reference. If you’d like us to check whether this is a bug rather than an implementation difference, please open a new issue with a minimal reproducible example, confirm both runs use the samesam3.pt, and includeyolo checksplus the full text outputs from both scripts.