YOLOE : détection et segmentation à vocabulaire ouvert en temps réel
Ultralytics YOLOE (Real-Time Seeing Anything) est un modèle de détection à vocabulaire ouvert et de segmentation d'instances : au lieu d'utiliser une liste de classes fixe au moment de l'entraînement, il prend en entrée les catégories que tu souhaites au moment de l'inférence, sous forme de prompt textuel, d'exemple visuel ou de vocabulaire intégré de 4 585 noms. Basé sur les architectures YOLO d'Ultralytics — YOLOv8, YOLO11 et YOLO26 — et inspiré de YOLO-World, YOLOE atteint une grande précision zero-shot à une vitesse proche de celle de YOLO à classes fermées.
Regarder : Comment utiliser Ultralytics YOLOE-26 (nouveau) | Vocabulaire ouvert et vision de tout en temps réel
Démarrage rapide#
Nomme les classes souhaitées et lance le modèle. YOLOE-26 renvoie des boîtes et des masques de segmentation d'instances pour des catégories sur lesquelles il n'a jamais été entraîné.
from ultralytics import YOLOE

model = YOLOE("yoloe-26s-seg.pt")

# « double-decker bus » n’est pas une classe COCO ; YOLOE l’identifie à partir des seuls mots
model.set_classes(["double-decker bus", "person"])

results = model.predict("https://ultralytics.com/images/bus.jpg")
results[0].show()
Le premier appel à set_classes() télécharge un encodeur de texte ; consulte Installation et exigences avant de déployer sur une machine sans accès réseau.
Choisir un mode d’invite#
YOLOE prend en charge trois modes d’invite, et ton choix détermine le point de contrôle que tu charges ainsi que la forme des étiquettes de classe. Choisis la ligne correspondant à ce que tu peux fournir au moment de l’inférence.
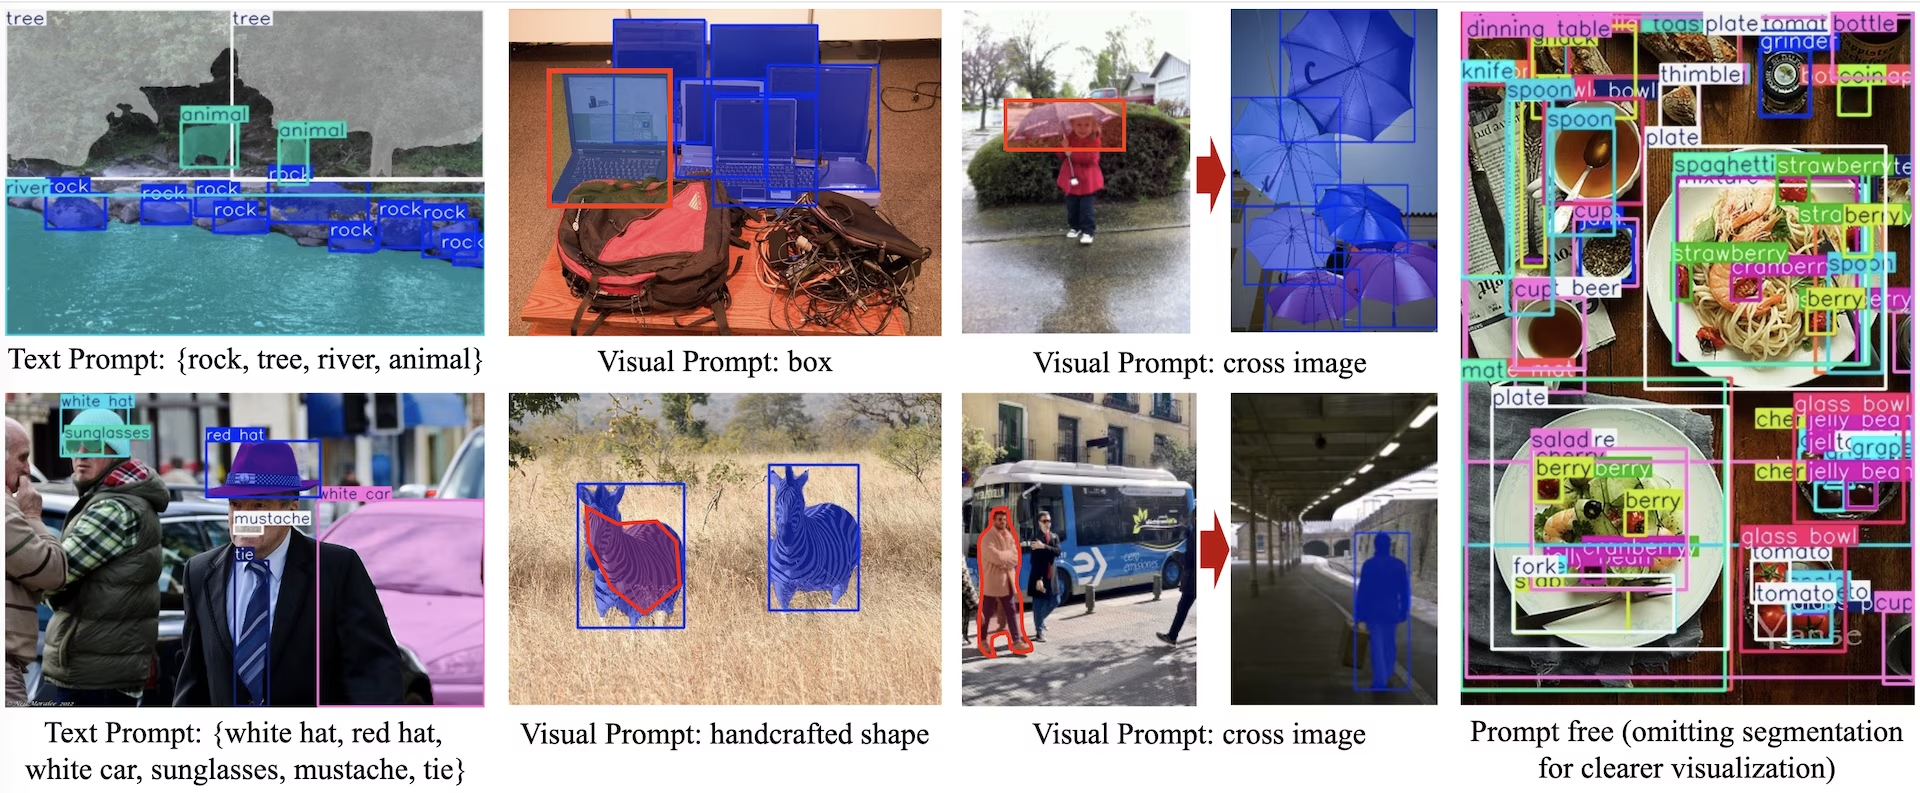
| Mode | Point de contrôle | Ce que tu fournis | Noms de classe dans les résultats | À utiliser quand |
|---|---|---|---|---|
| Invite textuelle | *-seg.pt | Noms de classe sous forme de chaînes | Exactement les noms que tu as indiqués | Tu peux décrire la cible avec des mots — c’est le choix habituel |
| Invite visuelle | *-seg.pt | Boîtes d’exemple sur une image de référence | object0, object1, … génériques | Tu ne peux pas décrire la cible avec des mots : une pièce spécifique, un logo ou un défaut |
| Sans invite | *-seg-pf.pt | Rien | Noms issus du vocabulaire intégré de 4 585 noms | Tu catalogues ou explores sans savoir à l’avance ce que tu cherches |
- Les invites visuelles ne transmettent pas tes étiquettes. Les identifiants de classe dans
visual_promptsregroupent les exemples ; le modèle les renvoie sous la formeobject0,object1, etc. À toi de les associer à tes propres noms. - Les points de contrôle sans invite rejettent
set_classes(). Un appel sur un modèle*-seg-pf.ptdéclencheAssertionError: Prompt-free model does not support setting classes. Please try with Text/Visual prompt models.Charge plutôt un point de contrôle*-seg.ptlorsque tu as besoin de tes propres classes.
Installation et exigences#
YOLOE est inclus dans le package principal Ultralytics :
pip install -U ultralyticsL’invite textuelle nécessite en plus un encodeur de texte, qui est téléchargé lors de la première utilisation plutôt qu’au moment de l’installation :
- Le premier appel à
set_classes()installe ultralytics/CLIP depuis GitHub avecpip(qui fournit le tokenizer) et télécharge un encodeur de texte TorchScript dans le répertoire de travail actuel. YOLOE-26 récupèremobileclip2_b.ts, d’environ 254 Mo ; YOLOE-11 et YOLOE-v8 récupèrentmobileclip_blt.ts. Lance le téléchargement une fois depuis le répertoire où tu exécuteras le programme, ou copie le fichier à cet endroit ; sinon, il sera téléchargé à nouveau. - Les deux étapes nécessitent un accès réseau : lance donc une prédiction avec invite avant de déployer sur une machine hors ligne ou isolée du réseau.
- Les invites visuelles et les points de contrôle sans invite n’ont pas du tout besoin d’un encodeur de texte.
Les points de contrôle YOLOE-26 nécessitent ultralytics 8.4.0 ou une version ultérieure ; les familles YOLOE-11 et YOLOE-v8 sont disponibles dans des versions antérieures. Une prédiction avec invite textuelle exécute l’ensemble du processus — téléchargement du point de contrôle, installation de CLIP, encodeur de texte, inférence :
yolo predict model=yoloe-26s-seg.pt source="https://ultralytics.com/images/bus.jpg" classes="person"Pour éviter complètement le téléchargement de l’encodeur de texte au moment de l’inférence, intègre les invites aux poids une fois et réutilise-les — consulte Réutiliser les embeddings d’invite.
Vue d’ensemble de l’architecture#

YOLOE conserve la structure YOLO standard — un backbone convolutif pour l’extraction des caractéristiques, un neck pour la fusion multi-échelle et une tête découplée sans ancres qui prédit les classes et les boîtes — et ajoute trois modules, un par mode d’invite :
- L'alignement région-texte reparamétrable (RepRTA) affine les embeddings textuels de CLIP au moyen d'un petit réseau auxiliaire. Ce réseau ne s'exécute qu'une fois par appel
set_classes()et est supprimé lors de l'export ; il n'a donc aucun coût par image. En revanche, la comparaison des embeddings de prompts stockés avec les caractéristiques des régions a lieu à chaque passe avant ; consulte les Limites pour connaître le coût associé à un grand ensemble de prompts. - Encodeur d’invite visuelle activée sémantiquement (SAVPE) encode les caractéristiques sémantiques et d’activation à partir d’une boîte d’exemple, en conditionnant le modèle sur des objets qui lui ressemblent. Il s’agit du processus en un seul exemple pour les cibles difficiles à nommer, comme un logo ou une pièce spécifique.
- Contraste régional d’invite différé (LRPC) compare les embeddings des régions à un vocabulaire intégré de 4 585 noms, afin que les points de contrôle sans invite reconnaissent les objets sans invite externe ni encodeur de texte.
La segmentation d'instances est assurée par une branche de masques sur la tête de détection, comme dans YOLOv8-Seg, et chaque prédiction comporte un masque sur results[0].masks. Une fois le modèle exporté, les modules open-world sont reparamétrés en une tête YOLO standard ; le fichier exporté suit donc le chemin de détection/segmentation habituel.
Modèles disponibles#
Tous les points de contrôle ci-dessous sont des modèles de segmentation d'instances et prennent en charge val, predict, export et track. Charge un fichier *-seg.pt pour le prompting textuel ou visuel, et un fichier *-seg-pf.pt pour l'inférence sans prompt ; ils ne sont pas interchangeables. Consulte Choisir un mode de prompting. Seuls les fichiers *-seg.pt prennent en charge train ; un point de contrôle sans prompt est produit à partir d'un modèle entraîné avec des prompts textuels. Consulte Entraîner les modèles officiels à partir de zéro.
| Modèle | Invite textuelle / visuelle | Sans invite |
|---|---|---|
| YOLOE-26n | yoloe-26n-seg.pt | yoloe-26n-seg-pf.pt |
| YOLOE-26s | yoloe-26s-seg.pt | yoloe-26s-seg-pf.pt |
| YOLOE-26m | yoloe-26m-seg.pt | yoloe-26m-seg-pf.pt |
| YOLOE-26l | yoloe-26l-seg.pt | yoloe-26l-seg-pf.pt |
| YOLOE-26x | yoloe-26x-seg.pt | yoloe-26x-seg-pf.pt |
| YOLOE-11s | yoloe-11s-seg.pt | yoloe-11s-seg-pf.pt |
| YOLOE-11m | yoloe-11m-seg.pt | yoloe-11m-seg-pf.pt |
| YOLOE-11l | yoloe-11l-seg.pt | yoloe-11l-seg-pf.pt |
| YOLOE-v8s | yoloe-v8s-seg.pt | yoloe-v8s-seg-pf.pt |
| YOLOE-v8m | yoloe-v8m-seg.pt | yoloe-v8m-seg-pf.pt |
| YOLOE-v8l | yoloe-v8l-seg.pt | yoloe-v8l-seg-pf.pt |
Performances de YOLOE sur LVIS#
Résultats zéro-shot sur le minival de LVIS, à 640 pixels, issus de l’article sur Ultralytics YOLO26.
Invites textuelles et visuelles#
Chaque cellule de précision et de paramètres indique invite textuelle / invite visuelle ; les FLOPs sont indiqués une seule fois. Les paramètres et les FLOPs correspondent à la configuration de détection évaluée dans l’article. La précision correspond au résultat Non-E2E de l’article, le seul protocole rapporté pour tous les modèles de la comparaison ; la tête end-to-end de YOLOE-26 obtient un résultat inférieur d’au plus 1,1 AP avec les invites textuelles et 2,6 AP avec les invites visuelles.
| Modèle | mAP50-95 | mAPr | mAPc | mAPf | paramètres (M) | FLOPs (B) |
|---|---|---|---|---|---|---|
| YOLOE-26n | 24.7 / 21.9 | 20.5 / 17.6 | 24.1 / 22.3 | 26.1 / 22.4 | 3.9 / 3.1 | 6.1 |
| YOLOE-26s | 30.8 / 28.6 | 23.9 / 25.1 | 29.6 / 27.8 | 33.0 / 29.9 | 10.7 / 11.0 | 21.9 |
| YOLOE-26m | 35.4 / 33.9 | 31.1 / 33.4 | 34.7 / 34.0 | 36.9 / 33.8 | 21.3 / 25.1 | 70.6 |
| YOLOE-26l | 37.8 / 36.3 | 35.1 / 37.6 | 37.6 / 36.2 | 38.5 / 36.1 | 25.5 / 29.3 | 89.0 |
| YOLOE-26x | 40.6 / 38.5 | 37.4 / 35.3 | 40.9 / 38.8 | 41.0 / 38.8 | 55.2 / 65.2 | 197.7 |
| YOLOE-11s | 27.5 / 26.3 | 21.4 / 22.5 | 26.8 / 27.1 | 29.3 / 26.4 | 10.7 / 10.9 | 22.7 |
| YOLOE-11m | 33.0 / 31.4 | 26.9 / 27.1 | 32.5 / 31.9 | 34.5 / 31.7 | 21.0 / 24.8 | 70.4 |
| YOLOE-11l | 35.2 / 33.7 | 29.1 / 28.1 | 35.0 / 34.6 | 36.5 / 33.8 | 26.0 / 29.8 | 89.5 |
| YOLOE-v8s | 27.9 / 26.2 | 22.3 / 21.3 | 27.8 / 27.7 | 29.0 / 25.7 | 12.3 / 12.6 | 29.8 |
| YOLOE-v8m | 32.6 / 31.0 | 26.9 / 27.0 | 31.9 / 31.7 | 34.4 / 31.1 | 26.4 / 28.4 | 80.7 |
| YOLOE-v8l | 35.9 / 34.2 | 33.2 / 33.2 | 34.8 / 34.6 | 37.3 / 34.1 | 43.5 / 47.3 | 167.6 |
Sans invite#
Les points de contrôle sans invite fournissent des résultats à partir de leur vocabulaire intégré, sans invite fournie. Chaque cellule de précision indique end-to-end / Non-E2E, les deux protocoles utilisés dans l’article pour évaluer YOLOE-26 ; la page YOLO26 cite la colonne Non-E2E.
| Modèle | mAP50-95 | mAPr | mAPc | mAPf | paramètres (M) | FLOPs (B) |
|---|---|---|---|---|---|---|
| YOLOE-26n-pf | 16.6 / 17.7 | 15.7 / 15.8 | 15.3 / 16.4 | 17.9 / 19.2 | 2.3 | 5.3 |
| YOLOE-26s-pf | 21.4 / 22.6 | 16.2 / 20.2 | 20.1 / 20.9 | 23.5 / 24.5 | 9.0 | 20.8 |
| YOLOE-26m-pf | 25.7 / 26.4 | 26.7 / 24.5 | 24.0 / 25.0 | 26.9 / 27.9 | 19.4 | 68.4 |
| YOLOE-26l-pf | 27.2 / 28.0 | 26.3 / 25.7 | 25.7 / 26.8 | 28.7 / 29.5 | 23.6 | 86.8 |
| YOLOE-26x-pf | 29.9 / 31.1 | 27.5 / 28.9 | 29.1 / 30.7 | 31.1 / 31.7 | 53.1 | 194.4 |
Avec des invites textuelles et visuelles, les modèles YOLOE-26 devancent leurs équivalents YOLOE-11 et YOLOE-v8 à chaque échelle correspondante en mAP50-95, tout en ayant moins de paramètres et de FLOPs que la gamme v8. Sur le même sous-ensemble, l’article rapporte 24.4 (S), 32.4 (M) et 35.5 (L) pour YOLO-Worldv2, ainsi que 26.0 pour GLIP-T, 27.4 pour GDINO-T et 34.4 pour DetCLIP-T, des détecteurs basés sur Transformer qui comptent chacun entre 155 et 232 M de paramètres. L’article original sur YOLOE ajoute deux résultats pour les modèles à l’échelle v8 qu’il a présentés. Sur LVIS, YOLOE-v8s surpasse YOLO-Worldv2-S de 3.5 AP avec un tiers du coût d’entraînement et une vitesse d’inférence 1.4× supérieure. Transféré sur COCO, YOLOE-v8l gagne 0.6 box AP et 0.4 mask AP par rapport à YOLOv8-L en détection à classes fixes, avec près de 4× moins de temps d’entraînement.
L’article sur YOLO26 évalue une configuration de détection. Les poids publiés sont des points de contrôle de segmentation qui intègrent une branche de masque, SAVPE et la projection textuelle en plus; un modèle yoloe-26l-seg.pt chargé affiche donc 35.4 M et 142.0 B, au lieu des 25.5 M et 89.0 B indiqués ci-dessus. Dans les deux cas, le chiffre des FLOPs exclut la similarité entre régions et texte; le coût réel augmente donc avec la taille de l’ensemble d’invites, même si la valeur de la colonne ne change pas; consulte Limitations.
Exemples d'utilisation#
Tous les exemples YOLOE ci-dessous s'exécutent depuis l'API Python. La prédiction avec invite textuelle, la validation, l'export, le suivi et l'entraînement standard fonctionnent aussi depuis la CLI ; les recettes de réglage fin transmettent une classe d'entraîneur et l'invite visuelle transmet des tableaux d'invites NumPy, deux opérations que seule l'API Python accepte.
Utilisation de l’entraînement#
Affine n'importe quel point de contrôle *-seg.pt publié sur ton propre jeu de données YOLO. Cette opération suit en grande partie la procédure standard d'entraînement YOLO ; la différence tient au trainer que tu transmets. YOLOEPESegTrainer intègre les noms de tes classes dans la tête et affine le modèle à partir de là, ce qu'il te faut pour tes propres annotations ; le trainer par défaut n'entraîne pas le modèle avec tes noms de classes. Le point de contrôle obtenu prédit directement les classes de ton jeu de données : sa tête ne lit plus les prompts, donc set_classes() déclenche une erreur si les classes changent, tout comme les prompts visuels. Utilise le point de contrôle d'origine pour faire des prédictions sur d'autres classes.
Regarder : Comment entraîner YOLOE sur le jeu de données de segmentation de pièces automobiles | Modèle à vocabulaire ouvert, prédiction et export
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOEPESegTrainer

model = YOLOE("yoloe-26s-seg.pt")

results = model.train(
    data="coco128-seg.yaml",
    epochs=80,
    patience=10,
    trainer=YOLOEPESegTrainer,  # <- Important : le trainer de réglage fin, pas celui par défaut
)Chaque point de contrôle publié est un modèle de segmentation. Pour entraîner un détecteur, construis le modèle à partir du YAML correspondant, charge les poids de segmentation de la même échelle et remplace le trainer par celui de détection. Tout le reste reste inchangé.
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOEPETrainer

model = YOLOE("yoloe-26s.yaml").load("yoloe-26s-seg.pt")

results = model.train(data="coco128.yaml", epochs=80, patience=10, trainer=YOLOEPETrainer)
Utilisation pour la prédiction#
L'appel avec invite textuelle est celui présenté dans Démarrage rapide. L'invite visuelle ajoute un argument visual_prompts, et la prédiction sans invite charge plutôt un checkpoint -pf :
Les invites visuelles montrent un exemple au modèle au lieu de le décrire. visual_prompts prend un tableau bboxes de boîtes d’exemple et un tableau cls d’identifiants de classe, un par boîte. Ces identifiants servent à créer des groupes temporaires, pas des étiquettes — ils doivent se suivre à partir de 0, et les résultats sont renvoyés sous la forme object0, object1, … plutôt que sous les noms que tu choisis.
Les boîtes d’exemple peuvent se trouver sur l’image sur laquelle tu effectues la prédiction :
import numpy as np

from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")

# Une boîte d’exemple par cible, chacune avec son propre identifiant de classe
visual_prompts = {
    "bboxes": np.array([[221.52, 405.8, 344.98, 857.54], [120, 425, 160, 445]]),  # personne, lunettes
    "cls": np.array([0, 1]),
}

results = model.predict(
    "ultralytics/assets/bus.jpg",
    visual_prompts=visual_prompts,
)
results[0].show()
Elles peuvent aussi se trouver sur une image de référence distincte transmise comme refer_image; dans ce cas, bboxes et cls décrivent des objets de cette image de référence, et non de la cible :
import numpy as np

from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")

visual_prompts = {"bboxes": np.array([[221.52, 405.8, 344.98, 857.54]]), "cls": np.array([0])}  # person

results = model.predict(
    "ultralytics/assets/zidane.jpg",  # Image cible
    refer_image="ultralytics/assets/bus.jpg",  # Emplacement des boîtes d’exemple
    visual_prompts=visual_prompts,
)
results[0].show()

# refer_image définit aussi les classes de façon permanente, donc les appels suivants ne nécessitent aucune invite
results = model("ultralytics/assets/bus.jpg")
model.export(format="onnx") # Et l’exportation les conserveLorsque source correspond à une vidéo ou à un flux, la première image devient automatiquement refer_image; les invites transmises s’appliquent donc à cette image et sont conservées tout au long de la vidéo. Transmets explicitement refer_image pour choisir une autre image.
source et refer_image acceptent directement les tenseurs torch, ce qui est pratique lorsque les images proviennent déjà d’un pipeline existant. Indique les boîtes dans les coordonnées en pixels propres au tenseur :
import numpy as np
import torch

from ultralytics import YOLOE

model = YOLOE("yoloe-11l-seg.pt")

img_tensor = torch.rand(1, 3, 480, 480)  # (1, 3, H, W) tenseur float dans [0, 1]
visual_prompts = {"bboxes": np.array([[10, 10, 50, 50]]), "cls": np.array([0])}

results = model.predict(
    img_tensor,
    refer_image=img_tensor,
    visual_prompts=visual_prompts,
    imgsz=640,
)
Pour effectuer des prédictions sur plusieurs images à la fois, imbrique les invites un niveau plus profondément : un tableau bboxes et un tableau cls pour chaque image source, dans le même ordre que les sources.
import numpy as np

from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")

visual_prompts = {
    "bboxes": [
        np.array([[221.52, 405.8, 344.98, 857.54], [120, 425, 160, 445]]),  # bus.jpg : personne, lunettes
        np.array([[150, 200, 1150, 700]]),  # zidane.jpg : personne
    ],
    "cls": [np.array([0, 1]), np.array([0])],
}

results = model.predict(
    ["ultralytics/assets/bus.jpg", "ultralytics/assets/zidane.jpg"],
    visual_prompts=visual_prompts,
)
results[0].show()
Utilisation pour la validation#
La validation s’effectue comme avec n’importe quel autre modèle, sur un jeu de données de segmentation :
from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")  # ou yoloe-26s/m-seg.pt pour les autres tailles

metrics = model.val(data="coco128-seg.yaml")
data peut aussi être un fichier NDJSON ou un URI de jeu de données Platform ul:// ; il est converti au format YOLO avant la création des invites textuelles ou visuelles.
Deux variantes du même appel couvrent les autres modes d’invite :
- Invites visuelles —
model.val(data="coco128-seg.yaml", load_vp=True)extrait une représentation visuelle par catégorie directement du jeu de données. Ajouterefer_data="coco.yaml"pour récupérer les représentations depuis un autre jeu de données, qui doit contenir exactement les mêmes catégories. - Sans invite — charge un point de contrôle
*-seg-pf.ptet transmetssingle_cls=True.
Utilisation de l’exportation#
Les représentations des invites peuvent être enregistrées une fois, puis réutilisées lors de la création d’exportations statiques telles que ONNX, OpenVINO, TensorRT, CoreML, LiteRT et RKNN. Le profil NPZ est chargé par le modèle PyTorch d’origine avant l’exportation; il ne constitue pas une entrée supplémentaire à l’exécution, et le modèle exporté n’a pas besoin du fichier NPZ.
Les classes configurées avec set_classes() (ou via refer_image pour les invites visuelles) sont intégrées aux poids exportés. Après l’exportation, le modèle ne peut plus accepter de nouvelles invites : l’appel à set_classes() ou la transmission de visual_prompts=... à predict() sur une exportation chargée échouera. Pour modifier les classes détectées, réexporte le point de contrôle .pt d’origine après avoir configuré les nouvelles invites. Le fichier exporté se comporte comme un modèle YOLO standard et peut aussi être chargé avec YOLO() plutôt qu’avec YOLOE().
from ultralytics import YOLOE

model = YOLOE("yoloe-26n-seg.pt")
model.set_classes(["person", "bus"])
model.save_prompt_embeddings("person-bus.npz")

# Le profil est lié au point de contrôle source et peut être réutilisé pour les exportations suivantes.
model = YOLOE("yoloe-26n-seg.pt")
model.load_prompt_embeddings("person-bus.npz")
model.export(format="onnx")
Le même profil d’invites peut aussi configurer un modèle de détection uniquement, créé à partir de l’architecture YOLOE correspondante. Cela supprime la branche de masque tout en conservant les classes définies par les invites :
from ultralytics import YOLOE

model = YOLOE("yoloe-26n.yaml").load("yoloe-26n-seg.pt")
model.load_prompt_embeddings("person-bus.npz")
model.export(format="rknn", name="rk3588", quantize=16)
Suivi d’utilisation#
Les classes définies par les invites sont directement utilisables pour le suivi, ce qui te permet de suivre des objets sur lesquels le tracker n’a jamais été entraîné :
from ultralytics import YOLOE

model = YOLOE("yoloe-26s-seg.pt")
model.set_classes(["forklift", "pallet"])

# persist=True conserve la stabilité des identifiants de suivi d’une image à l’autre
for result in model.track("path/to/video.mp4", stream=True, persist=True):
    print(result.boxes.id)
Comparaison de YOLOE#
YOLOE se situe entre un détecteur à classes fixes et un modèle à vocabulaire ouvert plus lourd. Trois comparaisons permettent de déterminer si c’est le bon choix :
- Par rapport à un YOLO à classes fixes. Une fois les invites définies, YOLOE effectue les prédictions avec le processus habituel de détection/segmentation et s’exporte comme tout autre modèle. Il permet de modifier la liste des classes au moment de l’inférence plutôt que de réentraîner le modèle; en revanche, sa précision en zéro-shot est bien inférieure à celle d’un modèle entraîné sur tes propres classes.
- Par rapport aux familles YOLOE précédentes. YOLOE-26 hérite de la tête de bout en bout sans NMS de YOLO26 et couvre cinq échelles (n/s/m/l/x) contre trois auparavant (s/m/l); il est aussi en tête à chaque échelle correspondante dans Performances.
- Par rapport aux détecteurs à vocabulaire ouvert basés sur Transformer. GLIP et OWL-ViT exécutent un Transformer vision-langage au moment de l’inférence. YOLOE encode les invites une seule fois, puis les compare aux caractéristiques des régions dans une tête convolutive.
Les solutions de remplacement les plus proches acceptent toutes une invite textuelle, mais seuls YOLOE et SAM 3 renvoient des masques, et les trois répondent à des besoins différents :
| YOLOE | SAM 3 | YOLO-World | |
|---|---|---|---|
| Conçu pour | La détection et la segmentation en temps réel de classes nommées | La segmentation par concept et le suivi piloté par invites | La détection à vocabulaire ouvert en temps réel |
| Masques | Oui, avec les points de contrôle *-seg.pt | Oui | Non, boîtes uniquement |
| Invites visuelles | Oui (SAVPE) | Oui | Non |
| Mode sans invite | Oui, vocabulaire de 4 585 noms | Non | Non |
| Choisis-le si | Tu as besoin de débit et peux nommer les classes | Tu as besoin d’une segmentation par concept optimale et peux consacrer des ressources de calcul | Tu l’utilises déjà — consulte la note de migration ci-dessous |
Tu viens de YOLO-World ? L’API suit le même modèle : remplace YOLOWorld par YOLOE, charge un point de contrôle *-seg.pt et conserve ton appel set_classes() tel quel. Tu bénéficies des masques et des invites visuelles; la note sur l’exportation concernant les classes figées s’applique aux deux.
Cas d’utilisation et applications#
La détection à vocabulaire ouvert supprime l’étape de réentraînement pour chaque classe; c’est particulièrement utile lorsque la liste des cibles n’est pas connue à l’avance :
- Détection en environnement ouvert — la robotique et les systèmes de sécurité rencontrent des objets qui n’avaient pas été répertoriés au moment de l’entraînement.
- Détection en un seul exemple — les invites visuelles repèrent une pièce, un logo ou un défaut précis à partir d’une seule boîte de référence, ce qui est utile pour l’inspection industrielle.
- Catalogage des longues traînes — le vocabulaire intégré de 4 585 noms est assez vaste pour les campagnes de surveillance de la biodiversité ou d’inventaire des stocks au détail.
- Amorçage de jeux de données — préannote les images avec des boîtes et des masques avant la vérification humaine, puis entraîne un modèle rapide à classes fixes sur le résultat.
- Segmentation de cibles quelconques — les points de contrôle
*-seg.ptpubliés renvoient un masque avec chaque prédiction; l’imagerie médicale et l’analyse satellitaire obtiennent ainsi des résultats précis au pixel près sans modèle supplémentaire.
Une approche courante consiste à combiner deux modes : exécuter une fois le mode sans invite pour découvrir les éléments présents, puis passer aux invites textuelles pour les catégories qui comptent.
Limites#
YOLOE sacrifie de la précision pour permettre de modifier les classes au moment de l’inférence. Voici les conséquences à connaître avant de te décider :
- La précision en zéro-shot est bien inférieure à celle d’un modèle entraîné sur tes classes. Les points de contrôle avec invites se situent autour de 22-40 mAP sur LVIS minival; un YOLO à classes fixes entraîné sur tes propres données obtiendra de meilleurs résultats sur ces classes. Choisis YOLOE pour couvrir les classes sur lesquelles tu ne peux pas entraîner le modèle, et non pour remplacer l’entraînement.
- Les catégories rares sont le point faible. La colonne mAPr de la section Performances indique la précision sur les classes rares de LVIS en particulier; avec des invites textuelles, cette valeur est inférieure à celles des colonnes des classes courantes et fréquentes dans chaque ligne. Consulte-la plutôt que la mAP principale si tes cibles sont inhabituelles.
- Une invite décrit une apparence, pas des relations. La détection compare les caractéristiques des régions à la représentation de l’invite; les invites qui dépendent d’un état, d’un contexte ou d’une comparaison — « endommagé », « le plus à gauche », « celui qu’on transporte » — ne fournissent donc aucun repère fiable à rechercher. Privilégie des formulations proches des noms de catégories courants.
- Les grands ensembles d’invites augmentent la latence. Les représentations des invites sont calculées une fois, mais elles sont comparées aux caractéristiques des régions à chaque propagation avant. Mesurée sur CPU avec
yoloe-26s-seg.pt, la durée d’une propagation avant augmente d’environ 19 % en passant de 80 à 1 203 classes, et d’environ 89 % avec le vocabulaire complet de 4 585 noms. Le nombre de FLOPs rapporté ne varie pas, car la similarité entre régions et texte n’est pas prise en compte; le profil ne t’avertira donc pas. - Les noms de classes sont des espaces réservés tant que tu n’as pas défini d’invites. Un point de contrôle
*-seg.ptchargé fraîchement renvoienc=80avec des noms numériques ("0","1", …); appelle doncset_classes()avant de lire les étiquettes. Les points de contrôle sans invite contiennent déjà l’ensemble du vocabulaire.
Notes sur le déploiement#
- Matériel. L’inférence nécessite un GPU NVIDIA avec 4 à 8 Go de VRAM; les modèles
netsfonctionnent sur des GPU embarqués tels que Jetson ou sur CPU à résolution réduite. Le réglage fin nécessite un seul GPU. - Par défaut, NMS est indépendant des classes. YOLOE effectue ses prédictions avec
agnostic_nms=True. Par défaut, cette opération supprime les boîtes superposées ayant un score inférieur entre différentes classes, plutôt que seulement au sein d’une même classe; cela évite les doublons lorsqu’un objet correspond à plusieurs catégories. Avecnms=False, YOLOE-26 n’applique aucune suppression selon l’IoU; le mode indépendant des classes conserve uniquement la meilleure classe pour chaque ancre, au lieu de permettre à une ancre d’émettre plusieurs étiquettes de classe. Transmetsagnostic_nms=Falsepour modifier ce comportement. - Les prompts visuels utilisent
conf=0.05par défaut. Les boîtes de prompts visuels sont plus souvent correctes que ne le laissent penser leurs scores : sur LVIS minival, avec une instance d’une classe comme prompt,conf=0.25manque 44 à 55 % des autres instances détectées par YOLOE-26 avecconf=0.05. Les scènes denses contenant des objets presque identiques, comme des rayons de magasin ou des cellules, peuvent nécessiter des valeurs plus basses, et avecnms=False, la tête un-à-un de YOLOE-26 obtient des scores encore plus bas, son meilleur seuil se situant près de0.01. Tous les autres appels conserventconf=0.25, y compris les appels ultérieurs, les embeddings enregistrés et les exports qui réutilisent les classes définies parrefer_image. Passeconfpour remplacer cette valeur. - Traitement par lots. L’inférence par lots fonctionne directement, et les invites visuelles peuvent varier d’une image à l’autre au sein d’un même appel.
Entraîner les modèles officiels à partir de zéro#
La plupart des lecteurs n’en ont pas besoin. Cette procédure reproduit les points de contrôle publiés à vocabulaire ouvert à partir d’Objects365, GQA et Flickr30k — environ 1,4 M d’échantillons d’entraînement sur 8× RTX 4090 — et n’a aucun rapport avec le réglage fin sur tes propres données, traité dans la section Utilisation de l’entraînement ci-dessus.
Tous les trainers qui héritent de YOLOETrainer refusent compile=True, y compris le YOLOESegTrainer par défaut et tous les trainers d’entraînement à partir de zéro ci-dessous. Transmets compile=False (la valeur par défaut). Les deux trainers de réglage fin utilisés plus haut, YOLOEPESegTrainer et YOLOEPETrainer, ne sont pas soumis à cette restriction.
L’entraînement nécessite des annotations de segmentation. Télécharge les fichiers traités ci-dessous ou génère les tiens à l’aide du script fourni par l’équipe officielle, qui s’appuie sur SAM 2.1. La validation utilise LVIS minival.
| Jeu de données | Type | Échantillons | Boîtes | Annotations de segmentation traitées |
|---|---|---|---|---|
| Objects365v1 | Détection | 609k | 9621k | objects365_train_segm.json |
| GQA | Ancrage | 621k | 3681k | final_mixed_train_no_coco_segm.json |
| Flickr30k | Ancrage | 149k | 641k | final_flickr_separateGT_train_segm.json |
Le modèle avec invite textuelle est entraîné en premier; les deux autres modes d’invite en sont des versions affinées :
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOESegTrainerFromScratch

data = {
    "train": {
        "yolo_data": ["Objects365.yaml"],
        "grounding_data": [
            {
                "img_path": "flickr/full_images/",
                "json_file": "flickr/annotations/final_flickr_separateGT_train_segm.json",
            },
            {
                "img_path": "mixed_grounding/gqa/images",
                "json_file": "mixed_grounding/annotations/final_mixed_train_no_coco_segm.json",
            },
        ],
    },
    "val": {"yolo_data": ["lvis.yaml"]},
}

model = YOLOE("yoloe-26l-seg.yaml")
model.train(
    data=data,  # ou le chemin vers un fichier YAML contenant la même structure
    batch=128,
    epochs=30,
    close_mosaic=2,
    optimizer="AdamW",
    lr0=2e-3,
    warmup_bias_lr=0.0,
    weight_decay=0.025,
    momentum=0.9,
    workers=4,
    trainer=YOLOESegTrainerFromScratch,
    device="0,1,2,3,4,5,6,7",
)
Les points de contrôle à invite visuelle et sans invite partent de ce modèle entraîné avec des invites textuelles et mettent à jour un module chacun. YOLOESegVPTrainer est la recette pour les invites visuelles et YOLOEPEFreeTrainer celle sans invite, mais aucune de ces classes ne gèle quoi que ce soit à elle seule : l’entraînement sélectif provient de la liste freeze que tu lui transmets, qui nomme tous les sous-modules de la tête sauf savpe (ou toutes les tours de classification), et l’exécution sans invite nécessite en plus single_cls=True. Le dépôt YOLOE en amont contient les recettes complètes pour les modèles à l’échelle v8.
Une exécution sans invite terminée est reparamétrée en un point de contrôle qui indique ses noms sans invite lors de l’inférence, à l’aide de get_vocab et set_vocab :
from ultralytics import YOLOE

# Poids écrits par l’exécution sans invite et par l’exécution avec invite textuelle dont elle est issue. Chaque
# nouvelle exécution crée un nouveau répertoire (train-2, train-3, ...), alors utilise les chemins indiqués par les exécutions.
model = YOLOE("runs/segment/train-2/weights/best.pt")  # exécution sans invite, sa tête est déjà fusionnée
text_model = YOLOE("runs/segment/train/weights/best.pt")  # exécution avec invite textuelle, sa tête n’est pas encore fusionnée

names = list(YOLOE("yoloe-26l-seg-pf.pt").model.names.values())  # le vocabulaire de 4 585 noms, ou ta propre liste
vocab = text_model.get_vocab(names)

model.set_vocab(vocab, names)
model.save("yoloe-26l-seg-pf-custom.pt")  # ne jamais écraser le point de contrôle publié
get_vocab renvoie la branche sélectionnée par l’indicateur end2end du modèle, et set_vocab reparamètre cette branche. Les fichiers YOLOE-26 publiés contiennent plutôt un vocabulaire par branche, ce qui permet à nms de choisir entre elles ; reproduis ce comportement en récupérant le deuxième vocabulaire depuis une autre copie du modèle avec invite textuelle. YOLOE-11 et YOLOE-v8 ont une seule branche : ils utilisent donc l’appel ci-dessus sans modification.
one2one_model = YOLOE("runs/segment/train/weights/best.pt")  # get_vocab fusionne la tête qu’il lit, alors charge une deuxième copie
one2one_model.model.end2end = True  # lire la branche sans NMS

model.set_vocab(vocab, names, one2one_vocab=one2one_model.get_vocab(names))
Citations et remerciements#
Si YOLOE a contribué à ta recherche ou à ton projet, cite l’article original de Ao Wang, Lihao Liu, Hui Chen, Zijia Lin, Jungong Han et Guiguang Ding de l’Université Tsinghua :
@misc{wang2025yoloerealtimeseeing,
      title={YOLOE: Real-Time Seeing Anything},
      author={Ao Wang and Lihao Liu and Hui Chen and Zijia Lin and Jungong Han and Guiguang Ding},
      year={2025},
      eprint={2503.07465},
      archivePrefix={arXiv},
      primaryClass={cs.CV},
      url={https://arxiv.org/abs/2503.07465},
}
Pour en savoir plus, l’article original YOLOE est disponible sur arXiv. Le code source du projet et des ressources supplémentaires sont accessibles via son dépôt GitHub.
FAQ#
Ultralytics YOLOE ajoute deux capacités absentes de YOLO-World : les invites visuelles, où une boîte d’exemple remplace le nom de classe, et les points de contrôle sans invite, qui répondent à partir d’un vocabulaire intégré de 4 585 noms sans aucune invite. Chaque prédiction des points de contrôle
*-seg.ptpubliés comporte également un masque de segmentation d’instances. En matière de précision, l’article original YOLOE place YOLOE-v8s devant YOLO-Worldv2-S de 3,5 AP sur LVIS, pour un tiers du coût d’entraînement et une vitesse d’inférence 1,4 fois supérieure. La migration se fait en une ligne — consulte Comparaison de YOLOE.Ultralytics YOLOE prend en charge trois modes d’invite. Une invite textuelle consiste en des noms de classe sous forme de chaînes sur un point de contrôle
*-seg.pt; c’est le choix habituel. Une invite visuelle consiste en une ou plusieurs boîtes d’exemple sur une image de référence, pour les objets difficiles à décrire avec des mots. L’inférence sans invite utilise un point de contrôle*-seg-pf.ptdistinct, qui répond à partir d’un vocabulaire intégré de 4 585 noms sans aucune donnée fournie. Les invites textuelles et visuelles utilisent les mêmes points de contrôle ; les points de contrôle sans invite sont des fichiers distincts et rejettentset_classes(). Consulte Choisir un mode d’invite pour une comparaison complète.Commence par
yoloe-26s-seg.pt: la famille YOLOE-26 devance YOLOE-11 et YOLOE-v8 à toutes les échelles comparables, et l’échellesest la plus petite à dépasser 30 mAP sur LVIS minival. Passe àm,louxlorsque la précision sur les catégories rares importe davantage que la latence — compare la colonne mAPr dans Performances. Descends ànuniquement pour un déploiement en périphérie. Charge plutôt le fichier*-seg-pf.ptde la même échelle si tu veux le vocabulaire intégré plutôt que tes propres noms de classe.Des étiquettes comme
object0etobject1indiquent que la prédiction provient d’une invite visuelle, qui regroupe les boîtes d’exemple en classes numérotées temporaires au lieu d’utiliser tes noms. Les ID de classe que tu transmets dansvisual_prompts["cls"]servent uniquement à ce regroupement. Le modèle les renvoie sous la formeobject0,object1, et ainsi de suite, selon l’ordre des ID attribués ; tu dois donc les remapper vers tes propres étiquettes dans le résultat. Si tu veux que tes noms apparaissent dans la sortie, utilise plutôt une invite textuelle.Les points de contrôle sans prompt (
*-seg-pf.pt) déterminent les classes à l'aide de leur vocabulaire intégré et rejettentset_classes()avecAssertionError: Prompt-free model does not support setting classes. Please try with Text/Visual prompt models.Les prompts visuels déclenchentAssertionError: Visual prompts need an unfused YOLOE model.Charge un point de contrôle*-seg.ptlorsque tu as besoin de ta propre liste de classes. Consulte Choisir un mode de prompting.À la première invite textuelle, Ultralytics YOLOE installe ultralytics/CLIP depuis GitHub avec
pipet télécharge un encodeur textuel TorchScript dans le répertoire de travail courant — environ 254 Mo pour YOLOE-26 ; consulte Installation et prérequis pour connaître la ressource exacte de chaque famille de modèles. Les invites visuelles et les points de contrôle sans invite n’en ont pas besoin. Pour éviter le téléchargement sur la machine cible, définis les invites une fois et enregistre-les avecsave_prompt_embeddings(), ou exporte le modèle avec les classes déjà configurées.Non — YOLOE intègre les classes définies par les invites dans les poids au moment de l’exportation, si bien qu’un export chargé rejette à la fois
set_classes()etvisual_prompts=. Réexporte le point de contrôle d’origine.ptaprès avoir configuré les nouvelles invites. Le fichier exporté se comporte comme un modèle YOLO standard et peut être chargé avecYOLO()ainsi qu’avecYOLOE().Utilise YOLOE lorsque tu as besoin d’un débit en temps réel et que tu peux nommer les classes, et SAM 3 lorsque la qualité de segmentation d’un concept compte davantage que la vitesse. Les deux acceptent des exemples visuels ; seul YOLOE propose un mode sans invite. La comparaison complète se trouve dans Comparaison de YOLOE.


Commentaires60
Pose une question, partage tes résultats ou aide quelqu’un d’autre.
daiyangyang945
I converted YOLOE to ONNX, but it only supports single-image input. How can I implement visual prompts?
1cyt1990cyt1990-dev
你好,请问怎么利用yoloe的视觉提示(结合SAM)功能进行自动标注(auto_annotate)?
 Glenn JocherUltralytics
你好,目前 YOLOE 的视觉提示能力是通过
model.predict(..., visual_prompts=..., refer_image=..., predictor=YOLOEVPSegPredictor)使用的,文档里还没有auto_annotate()直接接入这套流程的现成示例;另外yoloe-26*-seg.pt本身就会输出分割掩码,所以这类自动标注场景通常不需要再额外叠加 SAM,你可以先按 YOLOE 文档 和YOLOE.predict()参考 跑出提示式分割结果再保存为标签;如果你愿意,也欢迎把你的目标流程和样例数据贴在这个讨论里,方便团队一起看。
zhangxiancai
你好,请问yoloe如何使用多张图片里的视觉对象作为参考进行推理。因为一张图片不能全面反映要检测对象的特征,容易漏检。
 User
我也有想过建立一个供yoloe提取多角度多图片特征的小型数据库,但是发现效果并不好。官方通道似乎不支持多特征融合成一个标签。
q9card
Hello, I would like to ask about training YOLOE with a custom grounding dataset.
My current goal is to use YOLOE for open-vocabulary detection on remote-sensing small objects, and I am trying to integrate my own dataset, AI-TOD-v2, into the open-text / grounding training pipeline.
So far, I have completed the following steps:
- Converted AI-TOD-v2 from standard COCO detection annotations into a grounding-style JSON added caption for each image added tokens_positive for each instance
- Successfully ran generate_grounding_cache.py so the custom grounding JSON / cache generation itself seems to work
However, when I try to continue with the official open-text / from-scratch training pipeline, I run into many issues, for example:
(1)hard-coded checks in GroundingDataset.verify_labels() for official dataset names / instance counts (2)mismatch between yolo_data and grounding_data text slot / tensor shapes (3)later shape mismatch again in training loss / bbox decode
So I would like to ask:
Has anyone successfully trained YOLOE open-text / text-prompt models with a custom grounding dataset (not only the official Flickr/GQA/Objects365 data)? If yes, is there any recommended dataset organization or minimal working setup? Does the official pipeline currently support mixing custom grounding data with official grounding datasets such as Flickr/GQA? For a case like mine, would you recommend: continuing to adapt the current from-scratch training pipeline, or switching to another route based on official pretrained weights? If possible, could you share a minimal working example for training with a custom grounding dataset, even a very small toy example?
My current impression is that the main difficulty may not be the grounding JSON / cache generation itself, but rather that the current training code has strong assumptions about the official data pipeline. If there is any official recommendation or similar community experience, I would really appreciate it.
Thank you very much!
- Glenn JocherUltralytics
Thanks for the detailed report — the current public YOLOE from-scratch open-text pipeline is mainly validated around the official
Objects365/Flickr/GQArecipe shown in the YOLOE training docs, so a fully custom grounding dataset is not yet a documented plug-and-play path; for AI-TOD-v2, the safer route is usually to start from pretrainedyoloe-26*-seg.ptweights and the supported fine-tuning flow in the YOLOE usage docs rather than continuing from scratch. Please open a new issue with a minimal reproducible example, full traceback,yolo checks, and a tiny sample of the grounding JSON/cache so the team can check the dataset verification and shape assumptions directly. 我按照你说的用yoloe-s26-seg.pt进行微调,出现AttributeError: Can't get attribute 'YOLOESegment26' on <module 'ultralytics.nn.modules.head' from '/mnt/workspace/projects/yoloe/ultralytics/nn/modules/head.py'>错误,改用最新版 pip 安装的 Ultralytics 再试仍然存在这个问题。 目前我的yolo check输出如下: OS Linux-5.10.134-18.0.9.lifsea8.x86_64-x86_64-with-glibc2.35 Environment Linux Python 3.10.19 Install pip Path /root/miniconda3/envs/yoloe/lib/python3.10/site-packages/ultralytics RAM 31.34 GB Disk 94.8/97.9 GB CPU Intel Xeon Platinum 8163 CPU @ 2.50GHz CPU count 8 GPU Tesla V100-SXM2-16GB, 16144MiB GPU count 1 CUDA 12.8
numpy ✅ 2.2.6>=1.23.0 matplotlib ✅ 3.10.8>=3.3.0 opencv-python ✅ 4.13.0.92>=4.6.0 pillow ✅ 12.1.1>=7.1.2 pyyaml ✅ 6.0.3>=5.3.1 requests ✅ 2.32.5>=2.23.0 scipy ✅ 1.15.3>=1.4.1 torch ✅ 2.10.0>=1.8.0 torch ✅ 2.10.0!=2.4.0,>=1.8.0; sys_platform == "win32" torchvision ✅ 0.25.0>=0.9.0 psutil ✅ 7.2.2>=5.8.0 polars ✅ 1.39.3>=0.20.0 ultralytics-thop ✅ 2.0.18>=2.0.18
- Glenn JocherUltralytics
这个报错基本就是“权重版本和实际导入的代码版本不一致”:
yolo checks显示你用的是site-packages,但异常却来自/mnt/workspace/projects/yoloe/ultralytics/...,说明本地仓库覆盖了 pip 安装;而YOLOESegment26在当前head.py文档里是存在的,所以请先移除或重命名该本地ultralytics目录并重启 Python/Notebook 会话,确认ultralytics.__file__指向同一环境后再试;如果还报错,请贴完整 traceback 和精确训练命令。
- User
视觉提示只能支持一种类型吗,当我使用视觉提示进行检测之后,再次设置新的类别就会出现shape '[1, 66, -1]' is invalid for input of size 416000
- Glenn JocherUltralytics
视觉提示不只支持一种类别,
visual_prompts里可以给多组bboxes/cls(要求cls从0..N-1连续且与框数量一致),细节见中文 YOLOE 文档;你这个shape '[1, 66, -1]' is invalid...通常是跑过视觉提示(尤其用过refer_image)后又set_classes()切新类别导致旧的 prompt/embedding 状态残留,建议直接重新初始化一个新YOLOE(...)实例(Notebook 里也请重启 kernel)再设置新类别/新视觉提示。若仍复现,请把最小可复现代码、完整 traceback(文本)以及yolo checks输出贴在这里我们才能定位。 - User
好的,问题可以解决。不过衍生出相机模式下,反复创建销毁yoloe()实例,同时相机推理的帧率也很低。我会继续进行优化
- User
感谢,已经将初始化逻辑改成文本/视觉提示发送改变时触发,同时开启GPU加速,问题基本解决,再次感谢答疑
- Glenn JocherUltralytics
很好,感谢你回报进展;相机/视频场景下建议始终复用同一个
YOLOE实例,只在提示词变化时才更新set_classes()或visual_prompts,且注意传了visual_prompts时视频/流会自动用第一帧作为refer_image(详见 中文 YOLOE 文档),这样能避免反复构建带来的卡顿并提升 FPS。from ultralytics import YOLOE model = YOLOE("yoloe-26s-seg.pt") # 可按需求换更小尺度提升速度 # 仅在提示变化时调用:model.set_classes(...) 或传 visual_prompts for r in model.predict(source=0, stream=True, device=0, half=True, imgsz=640): pass # 在这里处理 r(不要每帧重新初始化模型) - User
在使用yoloe-26模型时出现模型加载错误Can't get attribute 'YOLOESegment26' on <module 'ultralytics.nn.modules.head' from 'd:\YOLO E\yoloe-main\ultralytics\nn\modules\head.py' YOLOE的库有进行开源更新吗
- Glenn JocherUltralytics
这个报错基本就是“权重文件里引用的模块/类名”和你当前导入的本地
ultralytics代码不一致导致的;从路径看你现在加载的是d:\YOLO E\yoloe-main\ultralytics\...这份源码,它不包含权重所需的YOLOESegment26,建议先排除本地目录把包“遮住”了的情况,改用最新版pip安装的 Ultralytics 再试(用法见中文 YOLOE 文档)。pip uninstall -y ultralytics pip install -U ultralytics yolo checks如果仍复现,请把“完整 traceback(文本)”、你是如何加载模型的最小代码(例如
YOLOE("yoloe-26s-seg.pt")/YOLO("yoloe-26s-seg.pt"))、以及上面yolo checks的输出贴出来;如果你刚升级过包且在 Notebook 里运行,也请先重启 kernel 再测。
qbig
Hello,
Can I ask why the exported Core ML model doesn't have labels metadata like normal YOLO or even exported YOLO-World models?
from ultralytics import YOLOE, YOLO from pathlib import Path from ultralytics.utils import YAML model_name = "yoloe-11m-seg.pt" file_name = "lvis.yaml" model = YOLOE(model_name) model.eval() # Please replace names with yours data = YAML.load(file_name) names = [n.split('/')[0] for n in data["names"].values()] model.set_classes(names, model.get_text_pe(names)) coreml_path = model.export(format='coreml', half=True, nms=False)- Glenn JocherUltralytics
That’s expected right now: YOLOE’s classes are prompt-defined (and can be changed via
set_classes()), so the CoreML exporter doesn’t reliably embed a fixed label list in the model metadata—especially when exporting “raw” outputs withnms=False; if you need labels inside the.mlmodel/.mlpackage, either export withnms=Trueor post-edit the CoreML package metadata after export (see the YOLOE export notes and theYOLOEAPI).
gstrat88
Is there any example to use it as a zero-shot logo detection?
tomer196
Hi, Is there a way to get the embeddings of each detection when I use model.predict? Similar to the way I can get the embeddings of the visual and text prompts.
ratom
I want to perform semantic segmentation with 6 classes (multi-class semantic segmentation task) using YOLOv8, YOLOv11, and YOLOe. My questions are is this possible with existing YOLO models? If yes, how can I create the data for YOLO format? I have the segmentation data with images in one folder and their respective masks in another format. @glenn-jocher
Hi @glenn-jocher, I want to perform semantic segmentation with 6 classes (multi-class semantic segmentation task) using YOLOv8, YOLOv11, and YOLOe. My questions are is this possible with existing YOLO models? If yes, how can I create the data for YOLO format? I have the segmentation data with images in one folder and their respective masks in another format.
- Glenn JocherUltralytics(modifié)
@tomer196 Fine-tuning and open-vocabulary prompting are mutually exclusive in the current implementation: after fine-tuning with
YOLOEPESegTrainer, the checkpoint predicts your dataset’s classes directly andset_classes()raises an error, so keep the original checkpoint for prompting. Details are under Train Usage in the YOLOE docs; we can’t share timelines for other changes.@ram-from-tvl For production use you’ll need to choose between AGPL-3.0 compliance (open‑source your entire derivative) or an Enterprise License for proprietary deployment; see options and terms at the Ultralytics License page. For deployment hardening, benchmark and export to your target runtime (ONNX/TensorRT/CoreML/etc.) per the Export section in the YOLOE docs.
@ram-from-tvl To convert a UNet-style binary mask dataset to YOLO segmentation format, create one TXT per image with polygon coordinates per instance (normalized x,y). Format and examples are in the Segmentation task data format. Minimal conversion example for a single-class binary mask:
import cv2, numpy as np, os

def mask_to_yolo_segments(mask):
    h, w = mask.shape[:2]
    contours, _ = cv2.findContours(mask, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
    segs = []
    for c in contours:
        if len(c) < 3:
            continue
        pts = c.squeeze(1).astype(float)
        pts[:, 0] /= w
        pts[:, 1] /= h
        segs.append(pts.reshape(-1))
    return segs

mask = cv2.imread("mask.png", 0) > 0
segs = mask_to_yolo_segments(mask.astype(np.uint8))
os.makedirs("labels", exist_ok=True)
with open("labels/image.txt", "w") as f:
    for seg in segs:
        f.write("0 " + " ".join(f"{v:.6f}" for v in seg.tolist()) + "\n")
@Swetha4545 YOLOE isn’t limited to 80 classes—text prompts are open‑vocab, and the prompt‑free variants use a large vocabulary; for harder concepts like “cotton” try synonyms (e.g., “cotton plant”, “cotton bale”, “fabric”) or switch to visual prompts with a clear reference exemplar; see Text/Visual/Prompt‑free usage in the YOLOE docs and the predictor API for visual prompts: YOLOEVPSegPredictor.
@ratom For per-pixel class maps (semantic segmentation), YOLO26 provides dedicated
-semmodels such asyolo26n-sem.pt(task=semantic); see the Semantic Segmentation docs. YOLOv8/YOLO11/YOLOE are instance segmentation models: if you use them, convert your masks to per‑instance polygons and save in YOLO segmentation TXT format (one line per instance:cls x1 y1 x2 y2 ..., normalized); the expected structure and examples are in the Segmentation task data format.
beichen2012
May I ask how to replace the YOLO11 backbone with DINOV3 distilled? Thanks.
- Glenn JocherUltralytics(modifié)
@daiyangyang945 ONNX runtime doesn’t support passing visual prompts at inference; bake them before export by running one PyTorch pass with
refer_image(which fixes classes), then export the fused model; this preserves the same classes in ONNX and you can still use dynamic batch input: see Visual Prompting and Export sections in the YOLOE docs for details. Example:from ultralytics import YOLOE from ultralytics.models.yolo.yoloe import YOLOEVPSegPredictor m = YOLOE("yoloe-11l-seg.pt") visual_prompts = {"bboxes": ..., "cls": ...} # your examples m.predict("img.jpg", refer_image="ref.jpg", visual_prompts=visual_prompts, predictor=YOLOEVPSegPredictor) m.export(format="onnx", dynamic=True, simplify=True)For guidance see the YOLOE page under Predict and Export usage. Refer: YOLOE: Real‑Time Seeing Anything, YOLOEVPSegPredictor API.
@Chappie123 With bbox-only data, convert to YOLO detection TXT labels and train a detection model. Convert each box from
{minx,miny,maxx,maxy}to normalizedxc,yc,w,h:def to_yolo(minx, miny, maxx, maxy, W, H): xc = (minx + maxx) / 2 / W yc = (miny + maxy) / 2 / H w = (maxx - minx) / W h = (maxy - miny) / H return xc, yc, w, hDataset YAML (minimal):
path: /data/myset
train: images/train
val: images/val
names: {0: class0, 1: class1}
Train:
from ultralytics import YOLOE
model = YOLOE("yoloe-11s.yaml")
model.train(data="data.yaml", epochs=100, imgsz=640)
More in Train mode and Detection task.
@HLHSM The error is from installing the wrong
clippackage. Uninstall the PyPIclipand install the official CLIP (per its README), or use a compatible wheel likeclip-anytorch, then restart Python:pip uninstall -y clip pip install clip-anytorchIf it persists, please run
yolo checksand paste the full text output. Reference for the APIs you’re calling: YOLOE API reference.@Maya7991 Current ONNX exports accept a single
imagesinput; runtime text/visual prompts aren’t exposed as additional ONNX inputs. Use offline prompts: set and fuse classes before export, or use the prompt‑free path.from ultralytics import YOLOE m = YOLOE("yoloe-11s-seg.pt") names = ["person", "bus"] m.set_classes(names, m.get_text_pe(names)) # fuse prompts m.export(format="onnx", dynamic=True, simplify=True)With
dynamic=True, you can pass[N,3,H,W]batches in onnxruntime even though the input name is justimages. See Export mode and YOLOE Export examples on the docs page: YOLOE docs.@beichen2012 Swapping YOLO11’s CNN backbone for a DINOv3‑distilled ViT isn’t supported and would require a custom backbone module plus shape/plumbing changes; we recommend using YOLO26 as‑is or a transformer model like RT‑DETR. If you prototype this, please keep any PR minimal, well‑tested, and scoped to the new backbone only.