Déploiement#
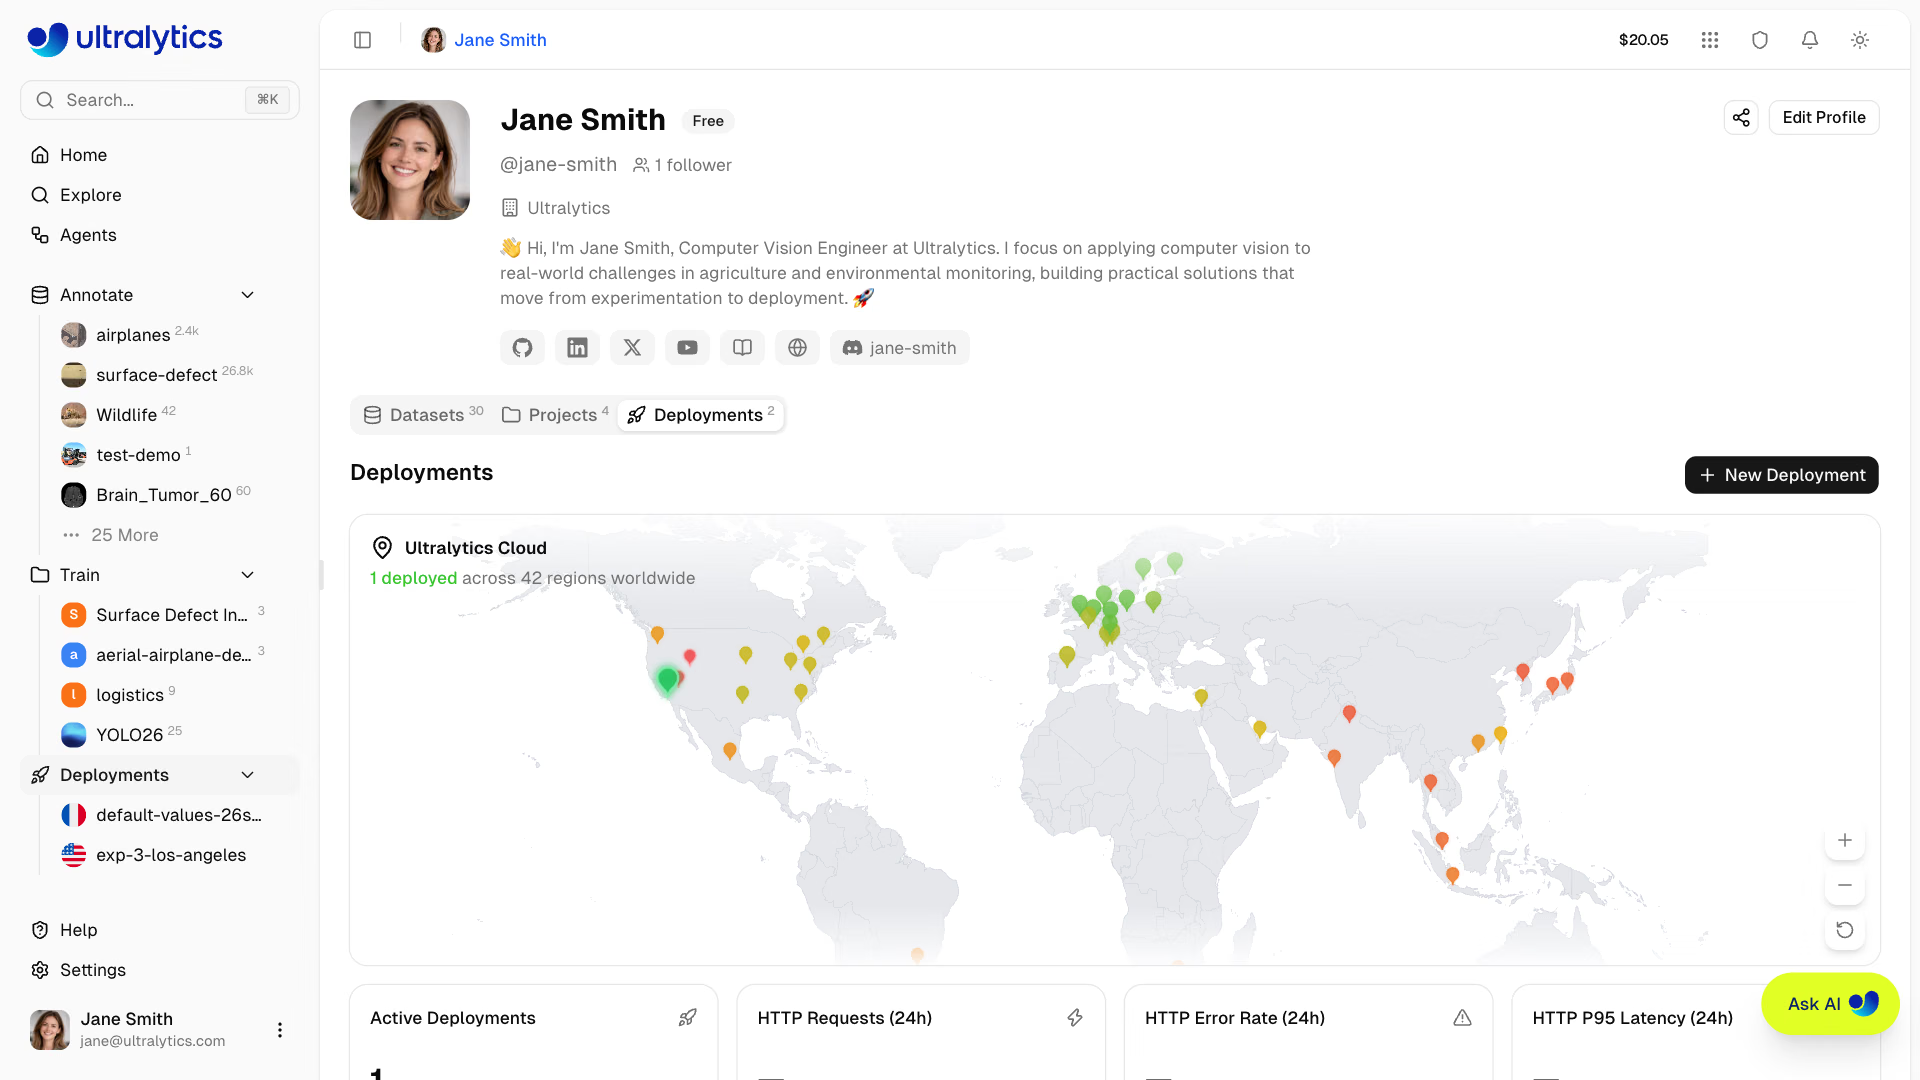
Ultralytics Platform propose des options complètes de déploiement de modèles pour mettre tes modèles YOLO en production. Teste les modèles avec l’inférence dans le navigateur, déploie-les sur des points de terminaison dédiés dans 42 régions du monde et surveille leurs performances en temps réel.
À regarder : Bien démarrer avec la plateforme Ultralytics - Déploiement
Présentation#
La section Déploiement t’aide à :
- Tester des modèles directement dans le navigateur avec l’onglet
Predict - Déployer sur des points de terminaison dédiés dans 42 régions du monde
- Surveiller les métriques des requêtes, les journaux, les vérifications d’état et les prédictions temporaires sur chaque point de terminaison dédié
- Choisir les ressources : les points de terminaison par défaut passent à zéro ; les tailles personnalisées maintiennent une instance en veille et sont facturées en fonction de la durée de fonctionnement
Options de déploiement#
Ultralytics Platform propose plusieurs méthodes de déploiement :
| Option | Description | Idéal pour |
|---|---|---|
| Onglet Prédiction | Image, webcam, exemples ; caméra IP sur tes propres points de terminaison | Développement, validation |
| Inférence partagée | Service mutualisé entre 3 régions de données | Utilisation légère, tests |
| Points de terminaison dédiés | Services à locataire unique dans 42 régions | Production, faible latence |
| Exportation | Télécharge les poids dans 22 formats pour une exécution locale ou en périphérie | Hors ligne, sur l’appareil |
Flux de travail#
graph LR
    A[✅ Test]:::start --> B[⚙️ Configure]:::proc
    B --> C[🌐 Deploy]:::proc
    C --> D[📊 Monitor]:::out

    classDef start fill:#4CAF50,color:#fff
    classDef proc fill:#2196F3,color:#fff
classDef out fill:#9C27B0,color:#fff| Étape | Description |
|---|---|
| Test | Valide le modèle avec l’onglet Predict |
| Configurer | Sélectionne un modèle, une région, un CPU et une mémoire ; examine les tarifs et le nom du déploiement |
| Déployer | Crée un point de terminaison dédié depuis l’onglet Deploy |
| Suivre | Consulte les métriques du point de terminaison et les prédictions temporaires dans Surveillance |
Architecture#
Inférence partagée#
Le service d’inférence partagée fonctionne dans 3 régions clés. Les requêtes adressées à un modèle sont acheminées vers le service de sa région de données, afin que les résultats restent dans la région où le modèle est stocké :
graph TB
    User[User Request]:::start --> API[Platform API]:::proc
    API --> Router{Model Data Region}:::decide
    Router -->|US models| US["US Predict Service<br/>Iowa"]:::out
    Router -->|EU models| EU["EU Predict Service<br/>Belgium"]:::out
    Router -->|AP models| AP["AP Predict Service<br/>Taiwan"]:::out

    classDef start fill:#4CAF50,color:#fff
    classDef proc fill:#2196F3,color:#fff
    classDef decide fill:#FF9800,color:#fff
classDef out fill:#9C27B0,color:#fff| Région | Libellé | Emplacement | Idéal pour |
|---|---|---|---|
| US | Amériques | Iowa, États-Unis | Utilisateurs des Amériques, performances optimales pour les Amériques |
| EU | Europe, Moyen-Orient et Afrique | Belgique, Europe | Utilisateurs européens, conformité au RGPD |
| AP | Asie-Pacifique | Taïwan, Asie-Pacifique | Utilisateurs d'Asie-Pacifique, latence minimale dans la région |
Points de terminaison dédiés#
Déploie dans 42 régions du monde sur Ultralytics Cloud :
- Amériques : 14 régions
- Europe : 13 régions
- Asie-Pacifique : 12 régions
- Moyen-Orient et Afrique : 3 régions
Chaque point de terminaison est un service à locataire unique qui offre :
- Un CPU et une mémoire configurables, avec des tarifs affichés avant le déploiement
- Une mise à l’échelle jusqu’à zéro pour les ressources par défaut ; une instance maintenue en veille et facturée selon la durée de fonctionnement pour les ressources personnalisées
- Une URL de point de terminaison unique avec sa propre référence d’API interactive à
/docs - Sa propre association de clé API, afin que seule cette clé puisse appeler le point de terminaison
- Une surveillance, des journaux et des vérifications d’état indépendants
Onglet Déploiements#
Tous tes déploiements figurent dans l’onglet Déploiements de ton profil (/{username}?tab=deployments), à côté de Jeux de données et Projets. La section Déploiements de la barre latérale répertorie tes déploiements et contient un lien vers la page de chacun d’eux, un bouton + pour en créer un et un lien vers l’onglet complet. L’onglet affiche :
- Carte du monde avec des repères sur les régions de déploiement ; clique sur une région pour ouvrir la boîte de dialogue
New Deployment - Cartes récapitulatives : déploiements actifs, requêtes HTTP (24 h), taux d’erreur HTTP (24 h), latence HTTP au 95e centile (24 h)
- Liste des déploiements avec recherche, tri et trois modes d’affichage : cartes, compact et tableau ; chaque déploiement renvoie à sa propre page, qui comporte les onglets
Overview,Monitoring,PredictetLogs - Bouton Nouveau déploiement pour créer des points de terminaison à partir de n’importe quel modèle entraîné
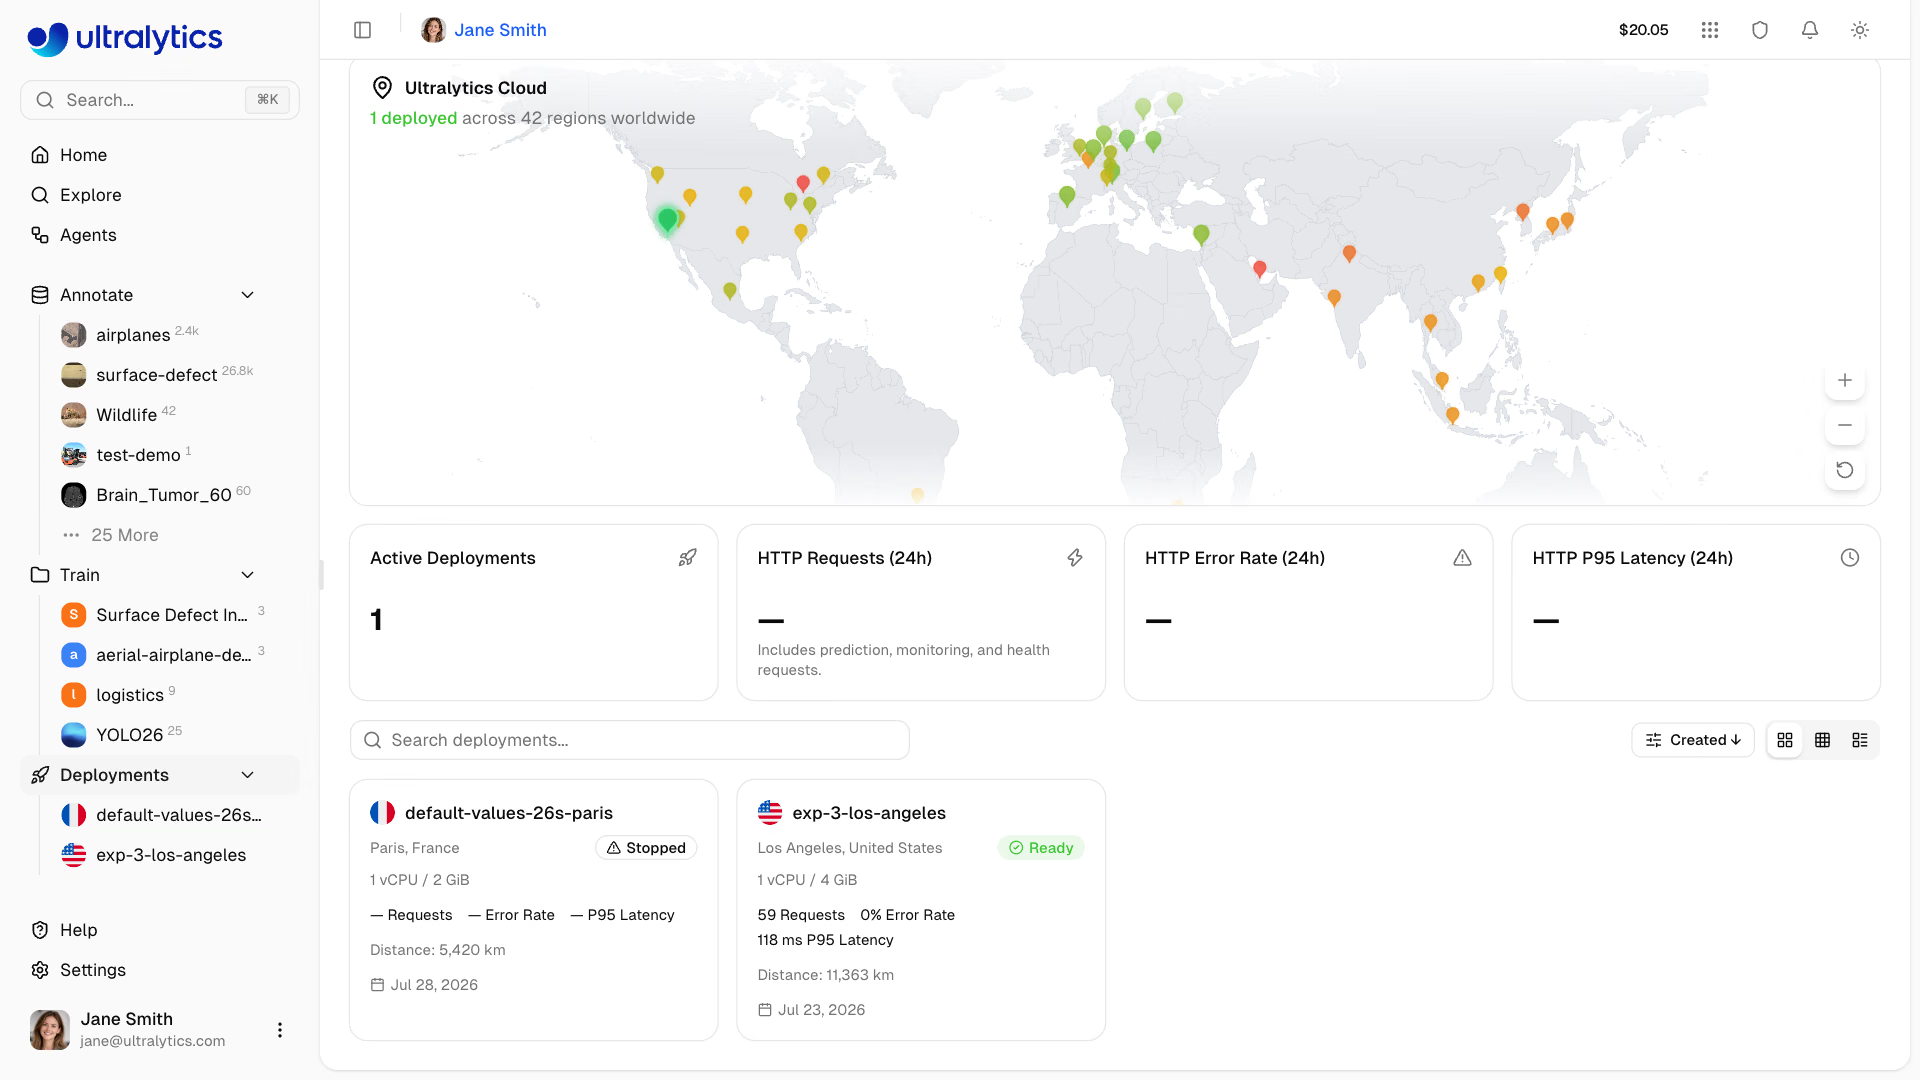
L’onglet s’actualise automatiquement, plus rapidement lorsqu’un déploiement change d’état (creating, deploying ou stopping). Consulte Surveillance pour en savoir plus.
Chaque point de terminaison dédié prêt fournit des graphiques et des exemples d’images stockés uniquement dans la mémoire de l’instance de service. L’arrêt, le redémarrage, le redéploiement, le redimensionnement ou le remplacement du modèle peut effacer ces données. Enregistre les exemples dans un jeu de données et attends la fin de l’ingestion pour les conserver. Consulte Surveillance.
Fonctionnalités clés#
Couverture mondiale#
Déploie tes services à proximité de tes utilisateurs dans 42 régions couvrant :
- Amérique du Nord, Amérique du Sud
- Europe, Moyen-Orient, Afrique
- Asie-Pacifique, Océanie
Comportement de mise à l’échelle#
Les points de terminaison fonctionnent actuellement comme suit :
- Ressources par défaut : les points de terminaison inactifs passent à zéro et démarrent à froid à la requête suivante
- Ressources personnalisées : une instance reste en veille et accumule des frais de fonctionnement jusqu’à son arrêt
- Une seule instance active : chaque point de terminaison traite actuellement les requêtes depuis une seule instance, quel que soit le forfait
- Limitation de charge : les requêtes reçoivent des réponses
429lorsque le point de terminaison est temporairement à sa capacité maximale — consulte Requêtes directes aux points de terminaison - Délai d’expiration des requêtes : les requêtes directes aux points de terminaison ont une durée maximale d’une heure ; consulte Inférence pour connaître les entrées prises en charge
Déploiement régional#
Utilise la latence mesurée par région pour placer un point de terminaison à proximité de ses utilisateurs. La latence réelle de l’inférence dépend du modèle, de la taille de l’entrée, de l’état du point de terminaison et du chemin réseau.
Vérifications d’état#
Chaque déploiement en cours d’exécution comprend une vérification automatique de l’état qui fournit :
- Un indicateur d’état en temps réel (sain/non sain)
- L’affichage de la latence des réponses
- Une nouvelle tentative automatique en cas d’état non sain, qui s’arrête lorsque l’état redevient sain
- Un bouton pour relancer manuellement la vérification
Démarrage rapide#
Créer un déploiement :
- Entraîne ou téléverse un modèle dans un projet
- Accède à l’onglet Deploy du modèle
- Clique sur Deploy pour une région dans le tableau de latence
- Vérifie le processeur, la mémoire, le tarif et le nom dans la boîte de dialogue de déploiement
- Clique sur Create Deployment et attends que l’état du déploiement passe à Ready
Model → Deploy tab → Deploy in a region → Review configuration → Create DeploymentLe nom du déploiement est généré à partir du nom du modèle et de la ville de la région, et peut être modifié avant le déploiement. Une fois le déploiement effectué, utilise l’URL du point de terminaison avec ta clé API pour envoyer des requêtes d’inférence depuis n’importe quelle application.
Liens rapides#
- Inférence : teste les modèles dans le navigateur
- Points de terminaison : déploie des points de terminaison dédiés
- Surveillance : suis les performances de tes déploiements
FAQ#
Le déploiement reste à l’état de création ou de déploiement pendant le démarrage de son service. Il devient utilisable lorsque son état passe à Ready ; la durée varie selon le modèle et la région, et prend généralement quelques minutes.
Oui, chaque modèle peut avoir plusieurs points de terminaison dans différentes régions. Le nombre de déploiements est limité par le forfait : Free
3, Pro10, Enterpriseunlimited. Le quota est imputé à l’espace de travail qui possède le modèle, et un point de terminaison ne sert qu’un seul modèle à la fois — utilise le remplacement de modèle pour le remplacer sans changer l’URL.Les points de terminaison utilisant les ressources par défaut sont mis à l’échelle jusqu’à zéro lorsqu’ils sont inactifs :
- Le point de terminaison est réduit après une période d’inactivité
- La première requête déclenche un démarrage à froid
- Les requêtes suivantes sont rapides
Les premières requêtes après une période d’inactivité déclenchent un démarrage à froid. L’ouverture de la page du déploiement lance une vérification de l’état qui réchauffe le point de terminaison ; ainsi, une prédiction de test effectuée juste après reçoit une réponse rapide.
Les points de terminaison utilisant des ressources personnalisées restent actifs et sont facturés pendant toute leur durée de fonctionnement, y compris lorsqu’ils sont inactifs. Arrête un point de terminaison pour mettre fin à sa facturation de durée de fonctionnement.