Dataset ImageNet#
Il dataset Ultralytics ImageNet (data="imagenet") è il sottoinsieme ImageNet-1k / ILSVRC-2012 utilizzato per addestrare e valutare tramite benchmark modelli di classificazione delle immagini. Contiene 1,000 classi di oggetti, con 1,281,167 immagini di addestramento e 50,000 immagini di convalida; in genere viene addestrato con immagini di dimensioni 224x224 e il download occupa circa 144 GB. Il database ImageNet completo è molto più ampio — oltre 14 milioni di immagini ad alta risoluzione annotate con synset WordNet in più di 20.000 categorie — ma Ultralytics addestra i modelli sul sottoinsieme ILSVRC standardizzato a 1.000 classi, diventato il benchmark de facto per il deep learning nella visione artificiale.
Modelli preaddestrati su ImageNet#
| Modello | dimensione (pixel) | acc top1 | acc top5 | Velocità CPU ONNX (ms) | Velocità T4 TensorRT10 (ms) | parametri (M) | FLOPs (B) a 224 |
|---|---|---|---|---|---|---|---|
| YOLO26n-cls | 224 | 71.4 | 90.1 | 5.0 ± 0.3 | 1.1 ± 0.0 | 2.8 | 0.4 |
| YOLO26s-cls | 224 | 76.0 | 92.9 | 7.9 ± 0.2 | 1.3 ± 0.0 | 6.7 | 1.5 |
| YOLO26m-cls | 224 | 78.1 | 94.2 | 17.2 ± 0.4 | 2.0 ± 0.0 | 11.6 | 4.8 |
| YOLO26l-cls | 224 | 79.0 | 94.6 | 23.2 ± 0.3 | 2.8 ± 0.0 | 14.1 | 6.0 |
| YOLO26x-cls | 224 | 79.9 | 95.0 | 41.4 ± 0.9 | 3.8 ± 0.0 | 29.6 | 13.5 |
Funzionalità principali#
- Il dataset Ultralytics
imagenetoffre 1.000 classi con 1,281,167 immagini di addestramento e 50,000 immagini di convalida (ILSVRC-2012), il benchmark standard per il preaddestramento nella classificazione delle immagini. - Le classi sono organizzate secondo la gerarchia WordNet, in cui ogni classe corrisponde a un synset (un insieme di termini sinonimi).
- I modelli vengono addestrati con immagini da 224x224 e il download del dataset completo occupa circa ~144 GB.
- L'ImageNet Large Scale Visual Recognition Challenge (ILSVRC), che si svolge ogni anno, ha contribuito in modo determinante al progresso della ricerca sulla visione artificiale.
Struttura del dataset#
Il dataset Ultralytics ImageNet utilizza la partizione ILSVRC-2012:
| Subset | Immagini | Classi |
|---|---|---|
| Addestra | 1,281,167 | 1,000 |
| Validazione | 50,000 | 1,000 |
Le immagini sono archiviate in cartelle per classe denominate con l'ID del synset WordNet (per esempio, n01440764), secondo la struttura prevista dall'addestramento di classificazione di Ultralytics. Ognuna delle 1.000 classi corrisponde a un synset WordNet e non esiste una partizione di test separata, quindi il set di convalida da 50.000 immagini viene usato per misurare l'accuratezza.
ImageNet-1k occupa circa ~144 GB da scaricare, quindi assicurati di avere spazio sufficiente sul disco prima dell'addestramento. Per esperimenti rapidi, i sottoinsiemi più piccoli ImageNette e ImageNet10 utilizzano lo stesso formato delle cartelle e si addestrano in una frazione del tempo.
ImageNet Large Scale Visual Recognition Challenge (ILSVRC)#
L'ImageNet Large Scale Visual Recognition Challenge (ILSVRC), che si svolge ogni anno, permetteva ai ricercatori di valutare gli algoritmi tramite benchmark su un dataset standardizzato di grandi dimensioni, con metriche di valutazione uniformi. Ha favorito importanti progressi nel deep learning per la classificazione delle immagini, il rilevamento degli oggetti e altre attività di visione artificiale; tra i risultati più notevoli vi è la vittoria di AlexNet nel 2012, che ha contribuito ad avviare l'era moderna del deep learning.
Applicazioni#
Il dataset ImageNet è ampiamente utilizzato per addestrare e valutare modelli di deep learning per la classificazione delle immagini, il rilevamento degli oggetti e la localizzazione degli oggetti. Architetture storiche come AlexNet, VGG e ResNet sono state sviluppate e valutate tramite benchmark su ImageNet; i pesi preaddestrati su ImageNet restano un punto di partenza comune per il transfer learning in diverse attività di visione.
Utilizzo#
Per addestrare un modello YOLO di classificazione su ImageNet per 100 epoche con immagini da 224x224, usa gli snippet di codice qui sotto. Per un elenco completo degli argomenti disponibili, consulta la pagina Addestramento del modello.
from ultralytics import YOLO

# Carica un modello
model = YOLO("yolo26n-cls.pt")  # carica un modello preaddestrato (consigliato per l'addestramento)

# Addestra il modello
results = model.train(data="imagenet", epochs=100, imgsz=224)
Puoi anche gestire i dataset di classificazione ed eseguire l'addestramento nel cloud con Ultralytics Platform.
Immagini di esempio e annotazioni#
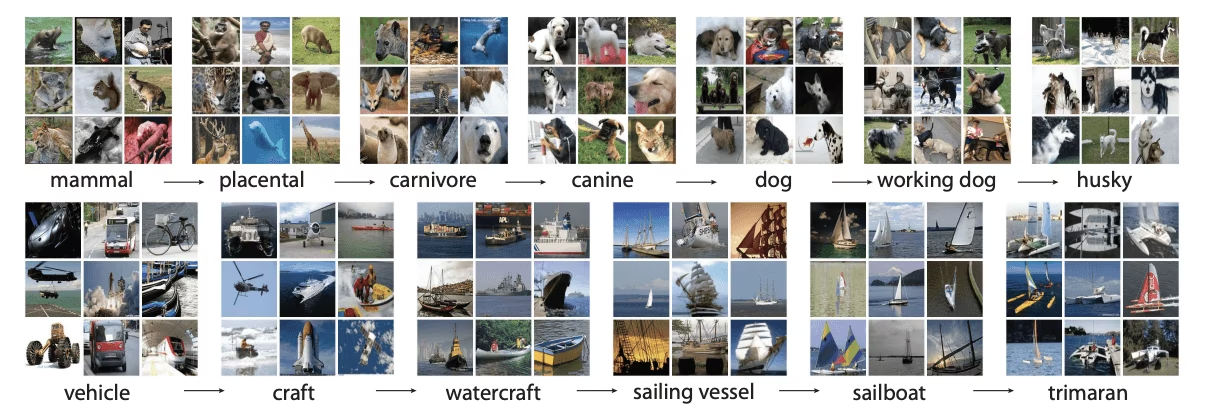
Il dataset ImageNet comprende le 1.000 classi di ILSVRC-2012 e offre una risorsa ampia e variegata per addestrare e valutare modelli di visione artificiale. Ecco alcuni esempi di immagini del dataset:
Citazioni e ringraziamenti#
Se utilizzi il dataset ImageNet nella tua attività di ricerca o sviluppo, cita il seguente articolo:
@article{ILSVRC15,
         author = {Olga Russakovsky and Jia Deng and Hao Su and Jonathan Krause and Sanjeev Satheesh and Sean Ma and Zhiheng Huang and Andrej Karpathy and Aditya Khosla and Michael Bernstein and Alexander C. Berg and Li Fei-Fei},
         title={ImageNet Large Scale Visual Recognition Challenge},
         year={2015},
         journal={International Journal of Computer Vision (IJCV)},
         volume={115},
         number={3},
         pages={211-252}
}
Desideriamo ringraziare il team ImageNet, guidato da Olga Russakovsky, Jia Deng e Li Fei-Fei, per aver creato e mantenuto il dataset ImageNet, una risorsa preziosa per la comunità di ricerca sul machine learning e sulla visione artificiale. Per ulteriori informazioni sul dataset ImageNet e sui suoi creatori, visita il sito web di ImageNet.
Domande frequenti#
Il dataset ImageNet è un database di immagini su larga scala, la cui raccolta complessiva contiene oltre 14 milioni di immagini ad alta risoluzione annotate con synset WordNet. In Ultralytics,
data="imagenet"viene addestrato sul sottoinsieme ILSVRC-2012 standardizzato a 1.000 classi, il benchmark de facto per il preaddestramento nella classificazione delle immagini. Modelli storici come AlexNet, VGG e ResNet sono stati addestrati e valutati tramite benchmark su ImageNet, a conferma del suo ruolo nel progresso della visione artificiale.Il dataset Ultralytics
imagenetutilizza il sottoinsieme ILSVRC-2012 con 1,000 classi, 1,281,167 immagini di addestramento e 50,000 immagini di convalida. In genere i modelli vengono addestrati con immagini da 224x224 e il download occupa circa 144 GB. Il database ImageNet completo è molto più grande (oltre 14 milioni di immagini distribuite in più di 20.000 synset WordNet), ma il sottoinsieme a 1.000 classi è quello utilizzato per l'addestramento e la valutazione tramite benchmark della classificazione.Per addestrare un modello Ultralytics YOLO su ImageNet, carica un modello di classificazione preaddestrato e imposta
datasuimagenet:Esempio di addestramentofrom ultralytics import YOLO # Carica un modello model = YOLO("yolo26n-cls.pt") # carica un modello preaddestrato (consigliato per l'addestramento) # Addestra il modello results = model.train(data="imagenet", epochs=100, imgsz=224)Per istruzioni più dettagliate sull'addestramento, consulta la nostra pagina sull'addestramento.
I modelli Ultralytics YOLO26 preaddestrati offrono prestazioni all'avanguardia in termini di velocità e accuratezza per varie attività di visione artificiale. Per esempio, il modello YOLO26n-cls, con un'accuratezza top-1 del 71.4% e un'accuratezza top-5 del 90.1%, è ottimizzato per le applicazioni in tempo reale. I modelli preaddestrati riducono le risorse di calcolo necessarie per l'addestramento da zero e accelerano i cicli di sviluppo. Scopri di più sulle metriche prestazionali dei modelli YOLO26 nella sezione Modelli preaddestrati su ImageNet.
L'ImageNet Large Scale Visual Recognition Challenge (ILSVRC), che si svolge ogni anno, ha favorito il progresso della visione artificiale offrendo una piattaforma competitiva per valutare algoritmi su un dataset standardizzato di grandi dimensioni. Le sue metriche di valutazione uniformi hanno stimolato l'innovazione nella classificazione delle immagini, nel rilevamento degli oggetti e nella segmentazione delle immagini, ampliando costantemente i confini del deep learning e della visione artificiale.