Dataset Argoverse#
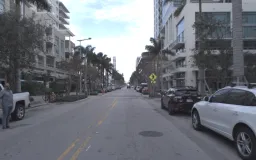
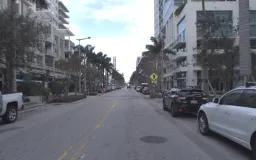
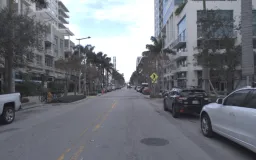
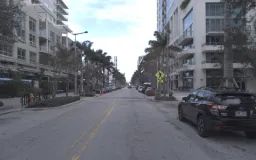
Il dataset Argoverse di Ultralytics (Argoverse-HD) è un dataset 2D per il rilevamento degli oggetti, composto da 54.446 immagini etichettate di guida autonoma — 39.384 per l'addestramento e 15.062 per la convalida — suddivise in 8 classi: persona, bicicletta, auto, motocicletta, autobus, camion, semaforo e segnale di stop. Le immagini sono acquisite dalla telecamera centrale anteriore ad anello di un veicolo e le annotazioni provengono dal progetto di percezione streaming della Carnegie Mellon University, basato sui dati di guida Argoverse 1.1 di Argo AI. È un benchmark ampio e realistico per addestrare modelli di visione artificiale al rilevamento degli oggetti stradali in scenari di guida autonoma.
Esplora Argoverse-HD sulla piattaforma Ultralytics per visualizzare in anteprima esempi annotati, esaminare le statistiche del dataset e clonarlo per l'addestramento.
Il file *.zip di Argoverse-HD (~31,5 GB), necessario per l'addestramento, è stato rimosso da Amazon S3 dopo la chiusura di Argo AI da parte di Ford. È disponibile per il download manuale da Google Drive: il download automatico non funziona, quindi scarica l'archivio ed estrailo nella cartella Argoverse della directory dei dataset prima di iniziare l'addestramento.
Funzionalità principali#
- 8 classi di rilevamento degli oggetti: persona, bicicletta, auto, motocicletta, autobus, camion, semaforo e segnale di stop.
- 54.446 immagini etichettate — 39.384 per l'addestramento e 15.062 per la convalida — più una suddivisione di test senza etichette riservata alla sfida eval.ai.
- ~31,5 GB di fotogrammi ad alta risoluzione acquisiti dalla telecamera centrale anteriore ad anello in scene urbane di guida autonoma.
- Le annotazioni vengono convertite automaticamente nel formato YOLO al primo utilizzo, così il dataset può essere usato direttamente per addestrare i modelli Ultralytics YOLO per il rilevamento.
Struttura del dataset#
Il dataset Argoverse-HD è suddiviso in tre subset predefiniti, definiti dalla configurazione Argoverse.yaml:
| Subset | Immagini | Etichette |
|---|---|---|
| Addestra | 39,384 | Sì |
| Validazione | 15,062 | Sì |
| Test | — | Senza etichette (sfida eval.ai) |
Tutte le immagini condividono le stesse 8 classi di oggetti (indici 0–7): persona, bicicletta, auto, motocicletta, autobus, camion, semaforo e segnale di stop.
Dopo il download manuale, Ultralytics converte automaticamente le annotazioni originali di Argoverse-HD in etichette di rilevamento YOLO la prima volta che avvii l'addestramento, quindi non è necessario alcun preprocessing manuale.
Applicazioni#
Il dataset Argoverse-HD supporta un'ampia gamma di applicazioni di rilevamento degli oggetti nella guida autonoma:
- Percezione per la guida autonoma — rileva veicoli, pedoni e ciclisti da una telecamera rivolta in avanti per supportare la navigazione dei veicoli autonomi.
- Sistemi avanzati di assistenza alla guida (ADAS) — riconoscono semafori e segnali di stop per fornire avvisi al conducente in tempo reale.
- Monitoraggio del traffico — conta e traccia gli utenti della strada nelle scene urbane per le analisi delle smart city.
- Ricerca e prototipazione — un benchmark ampio e basato sul mondo reale per apprendere l'addestramento dei modelli e la predizione su dati di guida.
YAML del dataset#
Un file YAML definisce la configurazione del dataset, inclusi percorsi, classi e altri dettagli pertinenti. Per il dataset Argoverse, il file Argoverse.yaml è gestito in https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/Argoverse.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Argoverse-HD dataset (ring-front-center camera) by Argo AI: https://www.cs.cmu.edu/~mengtial/proj/streaming/
# Documentation: https://docs.ultralytics.com/datasets/detect/argoverse
# Example usage: yolo train data=Argoverse.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── Argoverse ← downloads here (31.5 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: Argoverse # dataset root dir
train: Argoverse-1.1/images/train/ # train images (relative to 'path') 39384 images
val: Argoverse-1.1/images/val/ # val images (relative to 'path') 15062 images
test: Argoverse-1.1/images/test/ # test images (optional) https://eval.ai/web/challenges/challenge-page/800/overview

# Classes
names:
  0: person
  1: bicycle
  2: car
  3: motorcycle
  4: bus
  5: truck
  6: traffic_light
  7: stop_sign

# Download script/URL (optional) ---------------------------------------------------------------------------------------
download: |
  import json
  from pathlib import Path

  from ultralytics.utils import TQDM
  from ultralytics.utils.downloads import download

  def argoverse2yolo(annotation_file):
      """Convert Argoverse dataset annotations to YOLO format for object detection tasks."""
      labels = {}
      with open(annotation_file, encoding="utf-8") as f:
          a = json.load(f)
      for annot in TQDM(a["annotations"], desc=f"Converting {annotation_file} to YOLO format..."):
          img_id = annot["image_id"]
          img_name = a["images"][img_id]["name"]
          img_label_name = f"{Path(img_name).stem}.txt"

          cls = annot["category_id"]  # instance class id
          x_center, y_center, width, height = annot["bbox"]
          x_center = (x_center + width / 2) / 1920.0  # offset and scale
          y_center = (y_center + height / 2) / 1200.0  # offset and scale
          width /= 1920.0  # scale
          height /= 1200.0  # scale

          img_dir = annotation_file.parents[2] / "Argoverse-1.1" / "labels" / a["seq_dirs"][a["images"][annot["image_id"]]["sid"]]
          if not img_dir.exists():
              img_dir.mkdir(parents=True, exist_ok=True)

          k = str(img_dir / img_label_name)
          if k not in labels:
              labels[k] = []
          labels[k].append(f"{cls} {x_center} {y_center} {width} {height}\n")

      for k in labels:
          with open(k, "w", encoding="utf-8") as f:
              f.writelines(labels[k])

  # Download 'https://argoverse-hd.s3.amazonaws.com/Argoverse-HD-Full.zip' (deprecated S3 link)
  dir = Path(yaml["path"])  # dataset root dir
  urls = ["https://drive.google.com/file/d/1st9qW3BeIwQsnR0t8mRpvbsSWIo16ACi/view?usp=drive_link"]
  print("\n\nWARNING: Argoverse dataset MUST be downloaded manually, autodownload will NOT work.")
  print(f"WARNING: Manually download Argoverse dataset '{urls[0]}' to '{dir}' and re-run your command.\n\n")
  # download(urls, dir=dir)

  # Convert
  annotations_dir = "Argoverse-HD/annotations/"
  (dir / "Argoverse-1.1" / "tracking").rename(dir / "Argoverse-1.1" / "images")  # rename 'tracking' to 'images'
  for d in "train.json", "val.json":
argoverse2yolo(dir / annotations_dir / d) # convert Argoverse annotations to YOLO labelsUtilizzo#
Per addestrare un modello YOLO26n sul dataset Argoverse per 100 epoche con una dimensione dell'immagine di 640, usa i seguenti esempi di codice. Per un elenco completo degli argomenti disponibili, consulta la pagina Addestramento del modello.
from ultralytics import YOLO

# Carica un modello
model = YOLO("yolo26n.pt")  # carica un modello preaddestrato (consigliato per l'addestramento)

# Addestra il modello
results = model.train(data="Argoverse.yaml", epochs=100, imgsz=640)
Una volta completato l'addestramento, esegui l'inferenza con il modello ottimizzato su nuove immagini o video di guida:
from ultralytics import YOLO

# Carica un modello
model = YOLO("path/to/best.pt")  # carica un modello Argoverse ottimizzato

# Inferenza con il modello
results = model.predict("path/to/driving-scene.jpg")
Dati di esempio e annotazioni#
Il dataset Argoverse-HD contiene immagini di guida ad alta risoluzione acquisite da una telecamera ad anello frontale centrale, annotate con riquadri di delimitazione 2D per le 8 classi di oggetti. Di seguito trovi un esempio di immagine del dataset con le relative annotazioni:
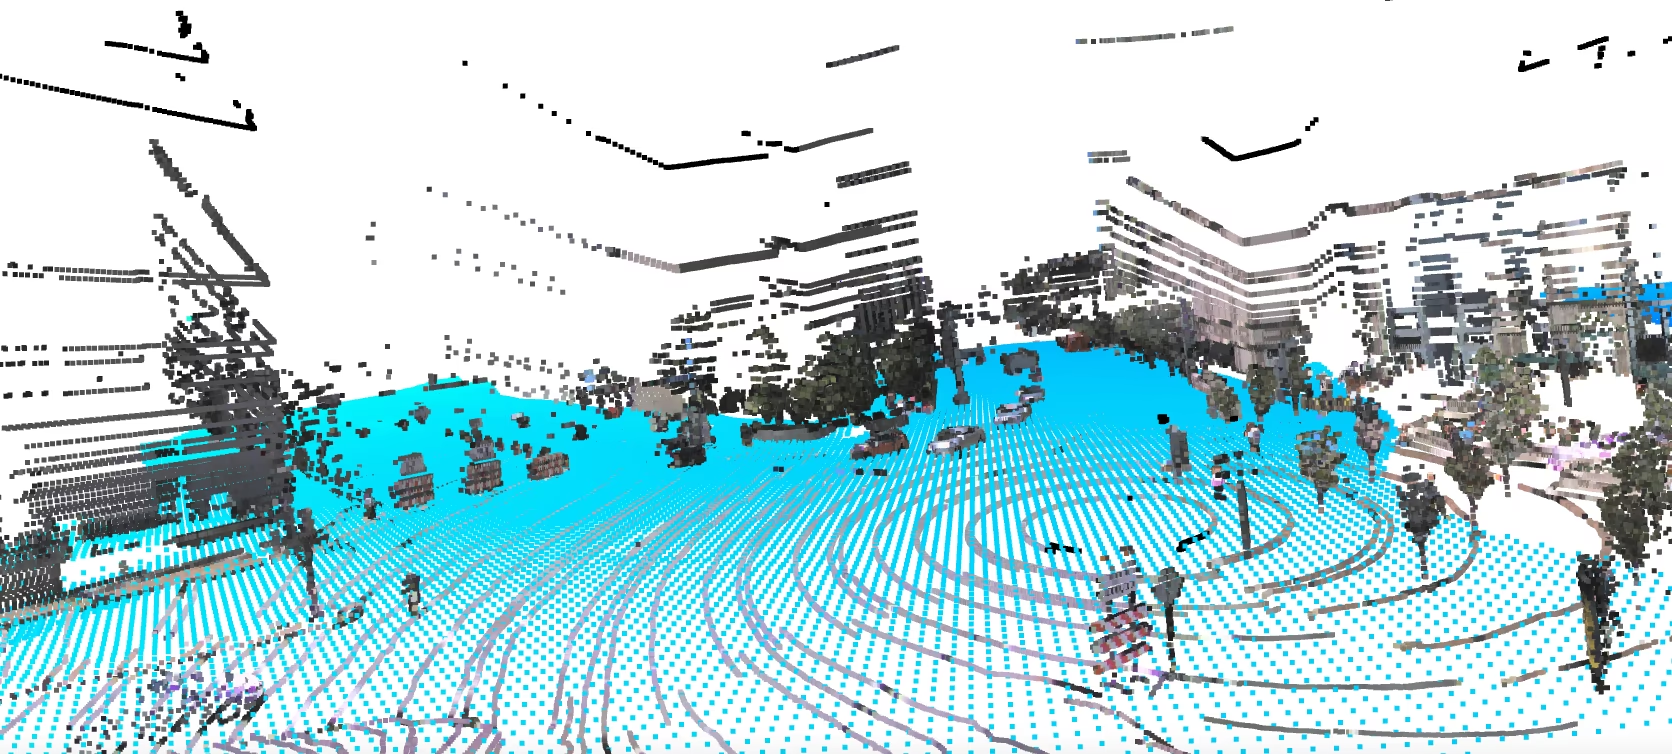
- Scena di guida annotata: questa immagine mostra oggetti stradali — come veicoli e pedoni — etichettati con riquadri di delimitazione 2D, il formato che i modelli YOLO imparano a predire durante l'addestramento.
Citazioni e ringraziamenti#
Le annotazioni per il rilevamento 2D di Argoverse-HD utilizzate in questo dataset provengono dal lavoro di Carnegie Mellon University sulla percezione in streaming. Se utilizzi il dataset nella tua ricerca o nel tuo sviluppo, cita:
@inproceedings{li2020towards,
  title={Towards Streaming Perception},
  author={Li, Mengtian and Wang, Yu-Xiong and Ramanan, Deva},
  booktitle={Proceedings of the European Conference on Computer Vision (ECCV)},
  pages={473--488},
  year={2020}
}

@inproceedings{chang2019argoverse,
  title={Argoverse: 3D Tracking and Forecasting with Rich Maps},
  author={Chang, Ming-Fang and Lambert, John and Sangkloy, Patsorn and Singh, Jagjeet and Bak, Slawomir and Hartnett, Andrew and Wang, Dequan and Carr, Peter and Lucey, Simon and Ramanan, Deva and others},
  booktitle={Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition},
  pages={8748--8757},
  year={2019}
}
Desideriamo ringraziare Carnegie Mellon University per le annotazioni di rilevamento di Argoverse-HD e Argo AI per aver creato il dataset Argoverse originale, una risorsa preziosa per la comunità di ricerca sulla guida autonoma.
Domande frequenti#
Il dataset Argoverse di Ultralytics (Argoverse-HD) è un dataset di rilevamento di oggetti 2D composto da 54.446 immagini di guida autonoma distribuite in 8 classi: persona, bicicletta, auto, motocicletta, autobus, camion, semaforo e segnale di stop. Serve per addestrare e valutare modelli che rilevano oggetti stradali da una telecamera del veicolo rivolta in avanti, supportando la ricerca sulla percezione per la guida autonoma, sugli ADAS e sul monitoraggio del traffico.
Il dataset Argoverse-HD contiene 8 classi (persona, bicicletta, auto, motocicletta, autobus, camion, semaforo e segnale di stop) e 54.446 immagini etichettate: 39.384 per l'addestramento e 15.062 per la validazione, oltre a uno split di test senza etichette riservato alla sfida eval.ai.
In Ultralytics è un dataset di rilevamento di oggetti 2D (fotogrammi di Argoverse-HD acquisiti da telecamere con riquadri di delimitazione 2D), non la suite di ricerca più ampia di Argoverse dedicata al tracciamento 3D, alla previsione del movimento o al LiDAR. Puoi addestrarlo con un modello di rilevamento standard come
yolo26n.pt.Per prima cosa scarica manualmente il dataset (vedi sotto), quindi avvia l'addestramento con il file di configurazione
Argoverse.yaml:Esempiofrom ultralytics import YOLO # Carica un modello model = YOLO("yolo26n.pt") # carica un modello preaddestrato (consigliato per l'addestramento) # Addestra il modello results = model.train(data="Argoverse.yaml", epochs=100, imgsz=640)Per una spiegazione dettagliata degli argomenti, consulta la pagina Addestramento del modello.
Il file
*.zipdi Argoverse-HD (~31.5 GB), precedentemente ospitato su Amazon S3, è ora scaricabile manualmente da Google Drive. Il download automatico non funzionerà, quindi scarica l'archivio ed estrailo nella cartellaArgoversedella directory dei dataset prima di eseguire il comando di addestramento.Sì. Ultralytics Platform ti consente di caricare e versionare dataset di grandi dimensioni come Argoverse-HD, quindi di addestrare e distribuire modelli di rilevamento di oggetti nel cloud senza una configurazione locale complessa. Puoi anche consultare dataset correlati nella panoramica dei dataset di rilevamento.