Best practice e consigli per l'addestramento dei modelli di machine learning
Introduzione#
Una delle fasi più importanti di un progetto di computer vision è l'addestramento del modello. Prima di arrivare a questa fase, devi definire i tuoi obiettivi e raccogliere e annotare i tuoi dati. Dopo aver preelaborato i dati per assicurarti che siano puliti e coerenti, puoi passare all'addestramento del modello.
L'addestramento del modello è il processo che insegna al tuo modello a riconoscere schemi visivi e a fare previsioni a partire dai tuoi dati, influenzando direttamente la precisione della tua applicazione. Questa guida illustra le best practice, le tecniche di ottimizzazione e i suggerimenti per la risoluzione dei problemi, per aiutarti ad addestrare efficacemente i tuoi modelli di computer vision.
Guarda: Suggerimenti per l'addestramento dei modelli | Come gestire dataset di grandi dimensioni | Dimensione del batch, utilizzo della GPU e precisione mista
Come addestrare un modello di machine learning#
Un modello di computer vision viene addestrato regolando i suoi parametri interni per ridurre al minimo gli errori. Inizialmente, al modello viene fornito un ampio insieme di immagini etichettate. Il modello fa previsioni sul contenuto di queste immagini e le previsioni vengono confrontate con le etichette o i contenuti effettivi per calcolare gli errori. Gli errori indicano quanto le previsioni del modello si discostano dai valori reali.
Durante l'addestramento, il modello fa previsioni in modo iterativo, calcola gli errori e aggiorna i propri parametri attraverso un processo chiamato backpropagation. In questo processo, il modello regola i propri parametri interni (pesi e bias) per ridurre gli errori. Ripetendo questo ciclo molte volte, il modello migliora gradualmente la propria precisione. Col tempo, impara a riconoscere schemi complessi come forme, colori e trame.
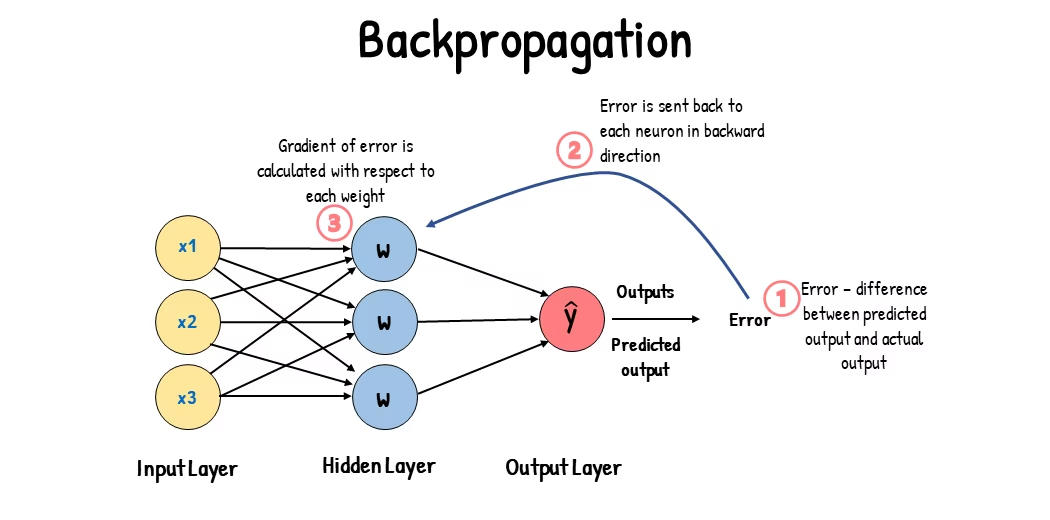
Questo processo di apprendimento consente al modello di computer vision di svolgere diverse attività, tra cui il rilevamento degli oggetti, la segmentazione delle istanze, la segmentazione semantica e la classificazione delle immagini. L'obiettivo finale è creare un modello in grado di generalizzare ciò che ha appreso a nuove immagini mai viste, così da interpretare accuratamente i dati visivi nelle applicazioni del mondo reale.
Ora che sappiamo cosa succede dietro le quinte quando addestriamo un modello, vediamo quali aspetti considerare durante l'addestramento.
Addestramento su grandi dataset#
Quando prevedi di usare un dataset di grandi dimensioni per addestrare un modello, ci sono diversi aspetti da considerare. Per esempio, puoi regolare la dimensione del batch, controllare l'utilizzo della GPU, scegliere l'addestramento multiscala e così via. Vediamo nel dettaglio ciascuna di queste opzioni.
Dimensione del batch e utilizzo della GPU#
Quando addestri modelli su grandi dataset, è fondamentale sfruttare la GPU in modo efficiente. La dimensione del batch è un fattore importante: indica il numero di campioni di dati che un modello di machine learning elabora in una singola iterazione di addestramento. Usando la dimensione massima del batch supportata dalla GPU, puoi sfruttarne appieno le capacità e ridurre la durata dell'addestramento del modello. Tuttavia, devi evitare di esaurire la memoria della GPU. Se si verificano errori di memoria, riduci gradualmente la dimensione del batch finché il modello non si addestra senza problemi.
Guarda: Come velocizzare di 2× l'inferenza di Ultralytics YOLO26 con l'elaborazione batch | Python e GPU | MLOps 🚀
Per YOLO26, puoi impostare il parametro batch negli argomenti della modalità di addestramento in base alla capacità della tua GPU. Su un singolo acceleratore, batch=-1 analizza il modello e sceglie una dimensione del batch che punta a un utilizzo della memoria di circa il 60%; una frazione come batch=0.70 punta a una percentuale diversa. Le esecuzioni multi-GPU richiedono una dimensione esplicita del batch globale pari almeno al numero di dispositivi. Su CPU e Apple silicon, AutoBatch mostra un avviso e ripiega su batch=16.
Addestramento su un sottoinsieme#
L'addestramento su un sottoinsieme è una strategia pratica che consiste nell'addestrare il modello su un set di dati più piccolo, rappresentativo del dataset più ampio. Può far risparmiare tempo e risorse, soprattutto durante le fasi iniziali di sviluppo e test del modello. Se hai poco tempo o stai sperimentando diverse configurazioni del modello, l'addestramento su un sottoinsieme è una buona opzione.
Per YOLO26, puoi implementare l'addestramento su un sottoinsieme con il parametro fraction. Usa un rapporto come fraction=0.1 per il 10% dei dati di addestramento, un numero intero come fraction=300 per selezionare esattamente 300 immagini di addestramento oppure un elenco [train, val, test] come fraction=[300, 100, 0] per limitare ogni split ed escludere le immagini di test. Gli elenchi di due elementi come [300, 100] mantengono completo lo split di test. I dataset NDJSON selezionano record equidistanti prima di scaricarli, così le esecuzioni successive riutilizzano esattamente lo stesso sottoinsieme. Anche i dataset di classificazione organizzati in cartelle di immagini selezionano campioni equidistanti. Per gli altri dataset organizzati in cartelle di immagini, fraction seleziona le prime N immagini in ordine alfabetico in base al percorso, non un campione casuale; quindi, se l'ordinamento può escludere alcune origini o classi, crea manualmente i sottoinsiemi. Quando prepari gli split train/val, mantieni i gruppi di immagini quasi duplicate interamente all'interno di un unico split.
Addestramento multiscala#
L'addestramento multiscala è una tecnica che migliora la capacità del modello di generalizzare, addestrandolo su immagini di dimensioni diverse. Il modello può imparare a rilevare oggetti a scale e distanze differenti e diventare più robusto.
Quando addestri YOLO26, puoi abilitare l'augmentation della scala impostando il parametro scale. Questo parametro modifica le dimensioni delle immagini di addestramento di un fattore specificato, simulando oggetti a distanze diverse. Ad esempio, impostando scale=0.5, durante l'addestramento le immagini vengono ingrandite o ridotte casualmente con un fattore compreso tra 0,5 e 1,5. Configurando questo parametro, il modello può elaborare immagini a scale diverse e migliorare le proprie capacità di rilevamento con oggetti di dimensioni e scenari differenti.
Ultralytics supporta anche l'addestramento multiscala con dimensioni delle immagini variabili tramite il parametro multi_scale. A differenza di scale, che ingrandisce le immagini e poi le riporta a imgsz tramite padding o ritaglio, multi_scale modifica imgsz a ogni batch (arrotondandola allo stride del modello). Per esempio, con imgsz=640 e multi_scale=0.25, la dimensione di addestramento viene campionata da 480 a 800 a intervalli di stride (ad es. 480, 512, 544, ..., 800), mentre multi_scale=0.0 mantiene una dimensione fissa.
Caching#
Il caching è una tecnica importante per migliorare l'efficienza dell'addestramento dei modelli di machine learning. Memorizzando le immagini preelaborate, il caching riduce il tempo in cui la GPU resta in attesa del caricamento dei dati dal disco. Il modello può ricevere dati in modo continuo, senza ritardi dovuti alle operazioni di I/O del disco.
Puoi controllare il caching durante l'addestramento di YOLO26 usando il parametro cache:
cache=True: archivia le immagini del dataset nella RAM, offrendo l'accesso più rapido ma aumentando l'utilizzo della memoria.cache='disk': archivia le immagini su disco; è più lento della RAM, ma più veloce del caricamento di nuovi dati a ogni utilizzo.cache=False: disattiva il caching e si affida interamente all'I/O del disco, l'opzione più lenta.
Addestramento a precisione mista#
L'addestramento a precisione mista usa tipi in virgola mobile a 16 bit (FP16) e 32 bit (FP32): FP16 per velocizzare i calcoli e FP32 per mantenere la precisione quando necessario. La maggior parte delle operazioni della rete neurale viene eseguita in FP16, così da beneficiare di calcoli più rapidi e di un minore utilizzo della memoria. Tuttavia, una copia master dei pesi del modello viene mantenuta in FP32 per garantire la precisione durante gli aggiornamenti dei pesi. Puoi gestire modelli più grandi o batch di dimensioni maggiori rispettando gli stessi limiti hardware.
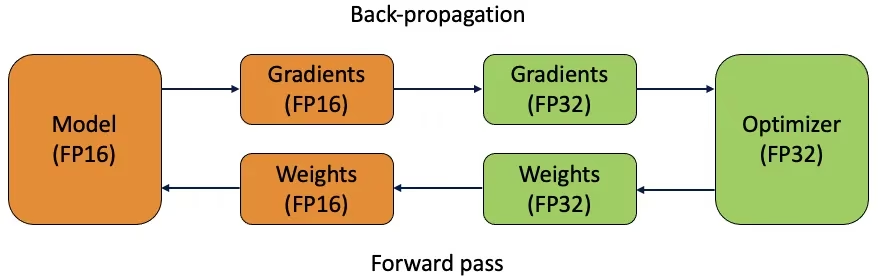
Per implementare l'addestramento a precisione mista, devi modificare gli script di addestramento e verificare che l'hardware (come le GPU) la supporti. Molti framework moderni di deep learning, come PyTorch e TensorFlow, offrono il supporto integrato alla precisione mista.
Con YOLO26, l'addestramento a precisione mista è semplice: AMP è già attivo per impostazione predefinita (amp=True). Su una GPU CUDA, YOLO esegue una verifica una tantum delle capacità all'inizio dell'addestramento e passa a FP32 completo se la verifica fallisce; su CPU e Apple silicon AMP viene ignorato del tutto. Imposta amp=False per forzare FP32 oppure amp="bf16" per addestrare in bfloat16 sulle GPU supportate.
Pesi preaddestrati#
L'uso di pesi preaddestrati è un modo efficace per accelerare l'addestramento del modello. I pesi preaddestrati provengono da modelli già addestrati su dataset di grandi dimensioni e offrono al tuo modello un punto di partenza vantaggioso. L'apprendimento per trasferimento adatta i modelli preaddestrati a nuovi compiti correlati. La messa a punto di un modello preaddestrato consiste nell'iniziare con questi pesi e continuare poi l'addestramento sul tuo dataset specifico. Questo metodo riduce i tempi di addestramento e spesso migliora le prestazioni, perché il modello parte da una solida comprensione delle caratteristiche di base.
I pesi preaddestrati provengono dall'argomento model, quindi model=yolo26n.pt parte già da pesi COCO. Il parametro pretrained controlla se questi pesi vengono mantenuti (True, valore predefinito), scartati (False) o sostituiti con un altro checkpoint (pretrained=path/to/best.pt). Impostare pretrained=True su un modello *.yaml non scarica i pesi automaticamente. Consulta Come eseguire il fine-tuning di YOLO su un dataset personalizzato per il workflow completo di transfer learning.
Altre tecniche da considerare quando lavori con un grande dataset#
Quando lavori con un grande dataset, puoi prendere in considerazione anche altre tecniche:
- Scheduler del learning rate: gli scheduler del learning rate modificano dinamicamente il learning rate durante l'addestramento. Un learning rate ben regolato può impedire al modello di oltrepassare i minimi e migliorare la stabilità. Durante l'addestramento di YOLO26, il parametro
lrfpermette di gestire la pianificazione del learning rate impostando il learning rate finale come frazione di quello iniziale. Per comportamenti non gestiti da alcun argomento, come learning rate per livello o gradient clipping, crea una sottoclasse del trainer. - Addestramento distribuito: per gestire dataset di grandi dimensioni, l'addestramento distribuito riduce i tempi di addestramento distribuendo il carico di lavoro su più GPU o macchine. Questo approccio è particolarmente utile per progetti su scala aziendale che dispongono di notevoli risorse computazionali.
- Formato di memoria channels_last: durante l'addestramento, NVIDIA CUDA usa automaticamente il layout di memoria NHWC più veloce con PyTorch 1.11 e versioni successive, tranne che su Windows, dove è risultato più lento. L'addestramento con AMD ROCm mantiene NCHW, che in quel caso è risultato più veloce. Imposta
channels_last=Trueper forzarlo oppurechannels_last=Falseper mantenere NCHW; PyTorch 1.10 e versioni precedenti, CPU e MPS continuano a usare NCHW per impostazione predefinita.
Numero di epoche di addestramento#
Durante l'addestramento di un modello, un'epoca corrisponde a un passaggio completo sull'intero dataset di addestramento. Durante un'epoca, il modello elabora ogni esempio del set di addestramento una volta e aggiorna i propri parametri in base all'algoritmo di apprendimento. In genere servono più epoche affinché il modello possa imparare e perfezionare gradualmente i propri parametri.
Una domanda frequente è come determinare il numero di epoche per cui addestrare il modello. Un buon punto di partenza è 300 epoche. Se il modello va in overfitting troppo presto, puoi ridurre il numero di epoche. Se dopo 300 epoche non si verifica overfitting, puoi prolungare l'addestramento a 600, 1200 o più epoche.
Tuttavia, il numero ideale di epoche può variare in base alle dimensioni del dataset e agli obiettivi del progetto. I dataset più grandi possono richiedere più epoche affinché il modello apprenda in modo efficace, mentre quelli più piccoli possono richiederne meno per evitare l'overfitting. Con YOLO26, puoi impostare il parametro epochs nello script di addestramento.
Arresto anticipato#
L'arresto anticipato è una tecnica utile per ottimizzare l'addestramento del modello. Monitorando le prestazioni di convalida, puoi interrompere l'addestramento quando il modello smette di migliorare. In questo modo puoi risparmiare risorse di calcolo e prevenire l'overfitting.
Il processo prevede l'impostazione di un parametro di pazienza, che determina quante epoche attendere un miglioramento delle metriche di convalida prima di interrompere l'addestramento. Se le prestazioni del modello non migliorano entro questo numero di epoche, l'addestramento viene interrotto per evitare sprechi di tempo e risorse.
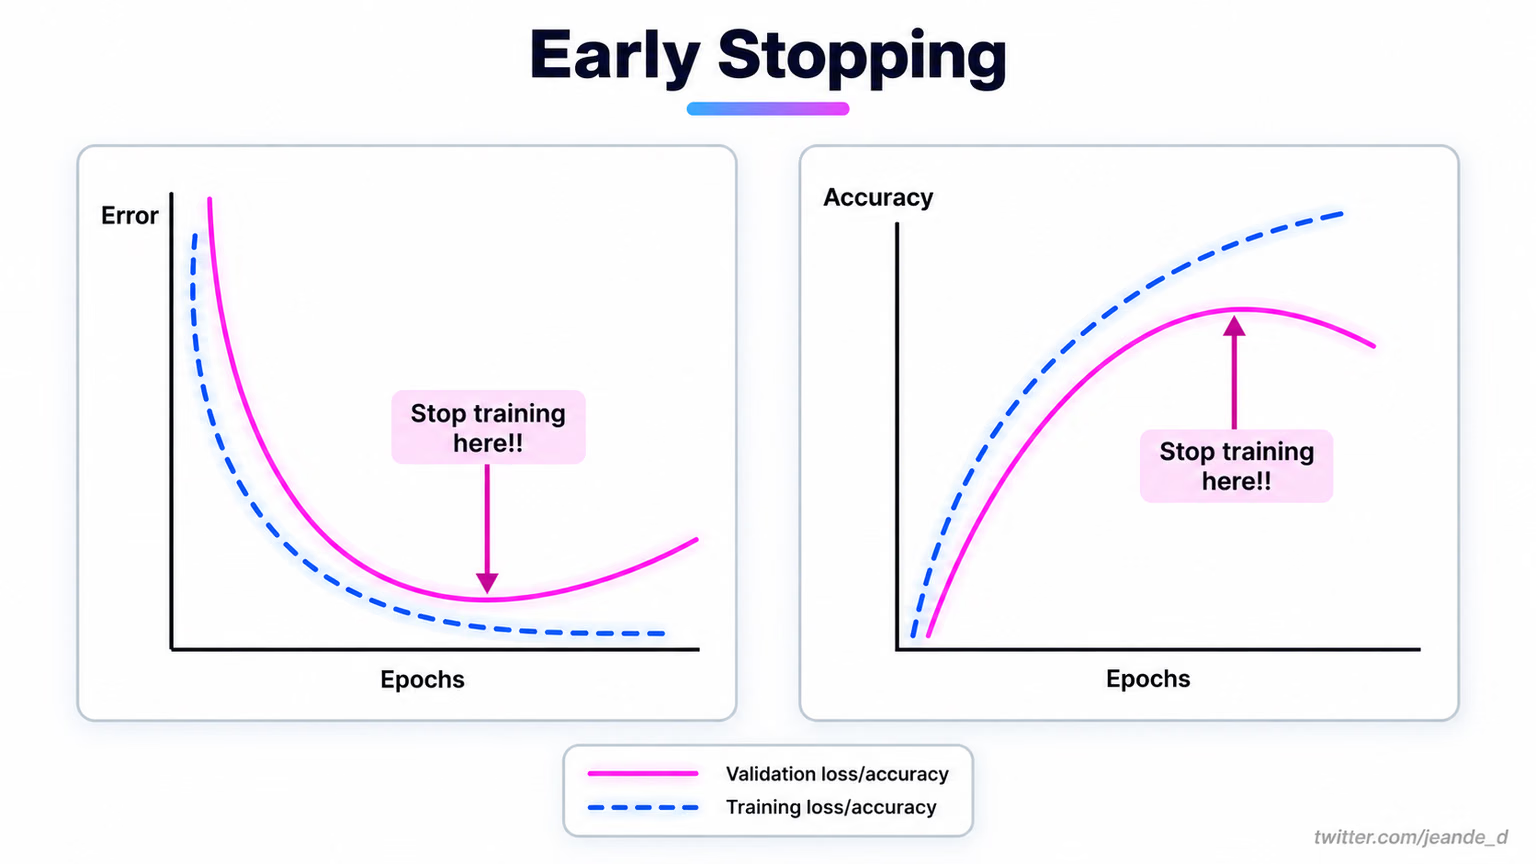
Con YOLO26 puoi abilitare l'arresto anticipato impostando il parametro patience nella configurazione di addestramento. Ad esempio, patience=5 significa che l'addestramento si interromperà se le metriche di convalida non migliorano per 5 epoche consecutive. In questo modo l'addestramento è efficiente ed eviti calcoli superflui.
Scelta tra addestramento sul cloud e in locale#
Hai due opzioni per addestrare il modello: l'addestramento sul cloud e quello in locale.
L'addestramento sul cloud offre scalabilità e hardware potente, risultando ideale per gestire dataset di grandi dimensioni e modelli complessi. Piattaforme come Google Cloud, AWS e Azure offrono accesso on-demand a GPU e TPU ad alte prestazioni, riducendo i tempi di addestramento e permettendo di sperimentare con modelli più grandi. Anche Ultralytics Platform offre l'addestramento gestito sul cloud per i modelli YOLO. Tuttavia, l'addestramento sul cloud può essere costoso, soprattutto se si protrae a lungo, e il trasferimento dei dati può aumentare i costi e la latenza.
L'addestramento locale offre maggiore controllo e possibilità di personalizzazione, consentendoti di adattare l'ambiente a esigenze specifiche ed evitare costi ricorrenti del cloud. Può essere più economico per i progetti a lungo termine e, poiché i dati restano on-premise, è più sicuro. Tuttavia, l'hardware locale può avere risorse limitate e richiedere manutenzione, con il rischio di tempi di addestramento più lunghi per i modelli di grandi dimensioni.
Scegliere un ottimizzatore#
Un ottimizzatore è un algoritmo che modifica i pesi della rete neurale per minimizzare la funzione di perdita, che misura le prestazioni del modello. In parole semplici, l'ottimizzatore aiuta il modello ad apprendere modificandone i parametri per ridurre gli errori. La scelta dell'ottimizzatore giusto influisce direttamente sulla velocità e sulla precisione dell'apprendimento del modello.
Puoi anche ottimizzare i parametri dell'ottimizzatore per migliorare le prestazioni del modello. Regolando il tasso di apprendimento determini l'ampiezza dei passi durante l'aggiornamento dei parametri. Per garantire stabilità, puoi iniziare con un tasso di apprendimento moderato e ridurlo gradualmente nel tempo, così da migliorare l'apprendimento a lungo termine. Inoltre, impostando il momentum determini quanto influiscono gli aggiornamenti precedenti su quelli correnti. Un valore comune per il momentum è circa 0.9. In genere offre un buon equilibrio.
Ottimizzatori comuni#
I diversi ottimizzatori hanno punti di forza e debolezze differenti. Ecco alcuni ottimizzatori comuni.
-
SGD (discesa stocastica del gradiente):
- Aggiorna i parametri del modello usando il gradiente della funzione di perdita rispetto ai parametri.
- È semplice ed efficiente, ma può convergere lentamente e rimanere bloccato nei minimi locali.
-
Adam (stima adattiva dei momenti):
- Combina i vantaggi di SGD con momentum e RMSProp.
- Regola il tasso di apprendimento di ogni parametro in base alle stime del primo e del secondo momento dei gradienti.
- È adatto ai dati rumorosi e ai gradienti sparsi.
- È efficiente e in genere richiede meno regolazioni. Per le sessioni di addestramento più brevi,
optimizer=autodi YOLO26 seleziona il correlato AdamW invece di Adam.
-
RMSProp (propagazione della media quadratica):
- Regola il tasso di apprendimento di ogni parametro dividendo il gradiente per una media mobile delle grandezze dei gradienti recenti.
- Aiuta a gestire il problema della scomparsa del gradiente ed è efficace per le reti neurali ricorrenti.
-
MuSGD (ibrido Muon + SGD):
- Combina aggiornamenti in stile SGD con il comportamento ispirato a Muon per migliorare la stabilità nell'addestramento su larga scala.
- È una buona scelta se vuoi una capacità di generalizzazione simile a SGD, ma hai bisogno di una convergenza più fluida rispetto a SGD standard.
- È particolarmente rilevante per le ricette di addestramento di YOLO26; se hai dubbi, inizia con
optimizer=autoe confronta MuSGD sul tuo dataset.
Per YOLO26, il parametro optimizer ti permette di scegliere tra diversi ottimizzatori, tra cui SGD, MuSGD, Adam, Adamax, AdamW, NAdam, RAdam e RMSProp; in alternativa, puoi impostarlo su auto per selezionare automaticamente l'ottimizzatore in base al numero di iterazioni di addestramento (AdamW per le esecuzioni più brevi, MuSGD oltre le 10.000 iterazioni).
yolo train model=yolo26n.pt data=coco8.yaml optimizer=MuSGDEntra in contatto con la community#
Far parte di una community di appassionati di computer vision può aiutarti a risolvere i problemi e imparare più velocemente. Ecco alcuni modi per entrare in contatto, ricevere aiuto e condividere idee.
Risorse della community#
- Segnalazioni su GitHub: visita il repository GitHub di YOLO26 e usa la scheda Issues per fare domande, segnalare bug e proporre nuove funzionalità. La community e i manutentori sono molto attivi e pronti ad aiutarti.
- Server Discord di Ultralytics: unisciti al server Discord di Ultralytics per chattare con altri utenti e sviluppatori, ricevere assistenza e condividere le tue esperienze.
L'uso di queste risorse ti aiuterà a risolvere le difficoltà e a restare aggiornato sulle ultime tendenze e pratiche della community della visione artificiale.
Punti chiave#
L'addestramento di modelli di visione artificiale richiede buone pratiche, strategie ottimizzate e la risoluzione dei problemi man mano che si presentano. Tecniche come la regolazione delle dimensioni dei batch, l'addestramento a precisione mista e l'uso iniziale di pesi preaddestrati possono migliorare le prestazioni dei modelli e accelerarne l'addestramento. Metodi come l'addestramento su un sottoinsieme e l'arresto anticipato aiutano a risparmiare tempo e risorse. Restare in contatto con la community e seguire le nuove tendenze ti aiuterà a continuare a migliorare le tue competenze nell'addestramento dei modelli.
Domande frequenti#
Per migliorare l'utilizzo della GPU, imposta il parametro
batchsulla dimensione massima supportata dalla tua GPU. Su un singolo acceleratore,batch=-1analizza il modello e punta a un utilizzo della memoria di circa il 60%. Su CPU e Apple silicon ripiega subatch=16, mentre le esecuzioni multi-GPU richiedono una dimensione esplicita del batch globale pari almeno al numero di dispositivi. Per ulteriori informazioni, consulta gli argomenti della modalità di addestramento.L'addestramento a precisione mista usa tipi in virgola mobile a 16 bit (FP16) e 32 bit (FP32) per bilanciare velocità di calcolo e precisione. In YOLO26 è abilitato per impostazione predefinita tramite
amp=True; impostaamp=Falseper forzare FP32. AMP viene ignorato su CPU e Apple silicon.L'addestramento multiscala migliora le prestazioni del modello addestrandolo su immagini di dimensioni diverse, così che possa generalizzare meglio a scale e distanze differenti. YOLO26 offre due parametri distinti a questo scopo.
scale=0.5campiona un fattore di zoom tra 0.5 e 1.5, quindi applica padding o ritaglia l'immagine per riportarla a unimgszfisso, mentremulti_scale=0.25variaimgsza ogni batch, con incrementi pari allo stride. Per le impostazioni e ulteriori dettagli, consulta la documentazione della modalità Train.L'uso di pesi pretrained può accelerare notevolmente l'addestramento e migliorare la precisione del modello, sfruttando un modello che ha già appreso caratteristiche visive fondamentali. Caricali tramite l'argomento
model, come inmodel=yolo26n.pt;pretrainedstabilisce quindi se mantenere quei pesi (True, l'impostazione predefinita), scartarli (False) o sostituirli con un altro checkpoint (pretrained=path/to/best.pt, il metodo per trasferire i pesi a una buildmodel=*.yaml). Scopri di più nella documentazione della modalità Train.Il numero di epoche indica quante volte si completa il passaggio sull'intero dataset di addestramento durante l'addestramento del modello. Un punto di partenza tipico è 300 epoche. Se il modello va presto in overfitting, puoi ridurne il numero. In alternativa, se non osservi overfitting, puoi prolungare l'addestramento fino a 600, 1200 o più epoche. Per impostare questo valore in YOLO26, usa il parametro
epochsnello script di addestramento. Per ulteriori consigli su come determinare il numero ideale di epoche, consulta la sezione sul numero di epoche.


Commenti12
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.
puzzlemindgames
Hello
I'm working on a browser-based puzzle solver that uses a custom YOLO model to detect visible objects from game screenshots.
Some examples include: Transparent ice/frost overlays on the lower part of objects Semi-transparent cloth or curtain overlays Small decorative objects inside larger objects (for example, keys inside containers) The visible objects are usually detected correctly, but these overlays often cause false negatives or incorrect class predictions.
At the moment I'm considering a few approaches: Training with many more occlusion-heavy examples Splitting the detection into multiple stages instead of one larger model
python results = model.predict( source="level_512.png", conf=0.25, iou=0.45, imgsz=1280 ) for box in results[0].boxes: print(box.cls, box.conf)
For anyone who has trained YOLO models on UI or game screenshots which approach gave you the biggest improvement? Or is there another strategy that tends to work better for partially occluded objects?
I'd really appreciate hearing about real-world experiences before I spend time retraining the dataset.
 Glenn JocherUltralytics
Start with targeted data: add representative occluded examples, keep annotations consistent for partially visible objects, and synthetically composite the actual frost/cloth overlays at realistic opacity and placement. Measure recall per class on a dedicated occlusion-heavy validation split, then tune
mosaic,mixup, orcutmixconservatively; higherimgszor tiled inference can help nested small objects. A multi-stage pipeline is usually worthwhile only if the first stage can reliably isolate containers or overlay regions. Please continue sharing results and questions here so the Ultralytics team and community can see them.1Thanks! I followed your suggestions and added more occluded samples. The main objects/tubes are much more stable as well as the colors now but I'm still struggling with very small objects.
i cant able to attach model training screenshots here for you to review.
For example, tiny keys or tags inside transparent containers are often missed or detected as the wrong class. For context the screenshots come from a puzzle game with objects similar to these shown in sample pictures embedded at product homepage: https://aimagicsortsolver.com/
results = model.predict( source="level.png", imgsz=1280, conf=0.35, iou=0.45 ) Would you recommend keep improving a single model or train a second YOLO model just for these small objects?
- Glenn JocherUltralytics(modificato)
Keep the single model first: audit tiny-object annotations, add more balanced close-up examples, and test cropped or SAHI tiled inference so keys and tags occupy more pixels; also compare
conf=0.15–0.25, since higher thresholds may suppress weak detections. Train a second specialized model only if the first model reliably detects each container, allowing its crop to be passed to the small-object model at higher effective resolution.1 Thank you for your suggestions. I'll tweak it as per the recommendations.
TSHSLU
What is the minimum Dataset Size required if i use a pretrained model for custom projects. i barely find any sources online which recommend a minimum dataset size.
- Glenn JocherUltralytics
There isn’t a fixed “minimum” dataset size when fine-tuning a pretrained model; if your domain is close to the pretrained data and labels are clean, you can often start getting useful signal with ~50–200 images per class (or a few hundred labeled object instances), but for reliably robust results across different lighting/viewpoints/backgrounds you’ll usually want 500–2000+ images per class with good diversity—one practical way to find your true minimum is to train on a small pilot subset, check validation failures, then add data specifically where the model breaks (the
fractionworkflow in the Model training tips guide helps iterate quickly).from ultralytics import YOLO model = YOLO("yolo26n.pt") model.train(data="data.yaml", epochs=100, fraction=0.1)1
VeeranjaneyuluToka
Hi, I just noticed a thing, looks like the optimizer is getting chosen based on no.of iterations, would you mind telling me the reason for the same? I mean how does iterations matter when we choose optimizer?
Imran-ml
First of all its great to have another powerful model and congratulations. I have fine tuned and trained yolo11x.pt for my custom objects but I'm facing some issues. My images data resolution is around 6000 x 2000 but while trained the model I set the imgsz=(1280, 640). It work well when I adjust the video stream by zoom in-out and detect all my 60 objects well (objects are small) but when there is some zoom or squeezed then it completely dont detect any object or few only.
Please let me know if I'm missing something or I have to do something else? I have labelled the data on my original images so resizing making any issues? any ratio issues? Please guide me properly so I can use this power yolo11 model effectively.
- Glenn JocherUltralytics
@Imran-ml it sounds like the issue might be related to image resizing affecting object detection. Consider enabling multiscale training by adjusting the
scaleparameter to help the model generalize better across different image sizes. This can improve detection performance when objects appear at varying scales. For more detailed guidance, you can refer to our model training tips at https://docs.ultralytics.com/guides/model-training-tips/.
Taufiq-Ahmed
Hi I have a question. I am using Yolov8s for trained a dataset that has four class. fire, smoke, person, animal. all the images has areal view to detect forest fire . In my dataset I have forest fire images from drone so after training it detect fire smoke quite accurately. however, I do not have any dataset that has person or animal in forest fire. so I have to collect some other dataset from roboflow that has person and animal and the n I have merged them with my own dataset ( have changed the label of animal and person accordingly so 0 means smoke, 1 means fire, 2 means person and 3 means animal and also updated the data.yaml file) . this time the problem is it could not detect the animal and person properly some times it can detect them. The main reasons seems to me is that the drone is flying in a high altitude so it does not detect person and animal properly because in the dataset of person and animal the view of the drone is not that much high. is there any technique to solve this problem and detect all the objects as many as possible?
- Glenn JocherUltralytics
@Taufiq-Ahmed it sounds like the altitude difference between your training and test datasets is causing the detection issues. To address this, consider using data augmentation techniques to simulate higher altitude views in your training data. You can also try multiscale training to help the model generalize better across different scales. Additionally, fine-tuning the model with a mix of high-altitude and low-altitude images might improve its performance. For more detailed strategies, you can refer to our model training tips.