Esportazione MNN per modelli YOLO26 e distribuzione#
MNN#
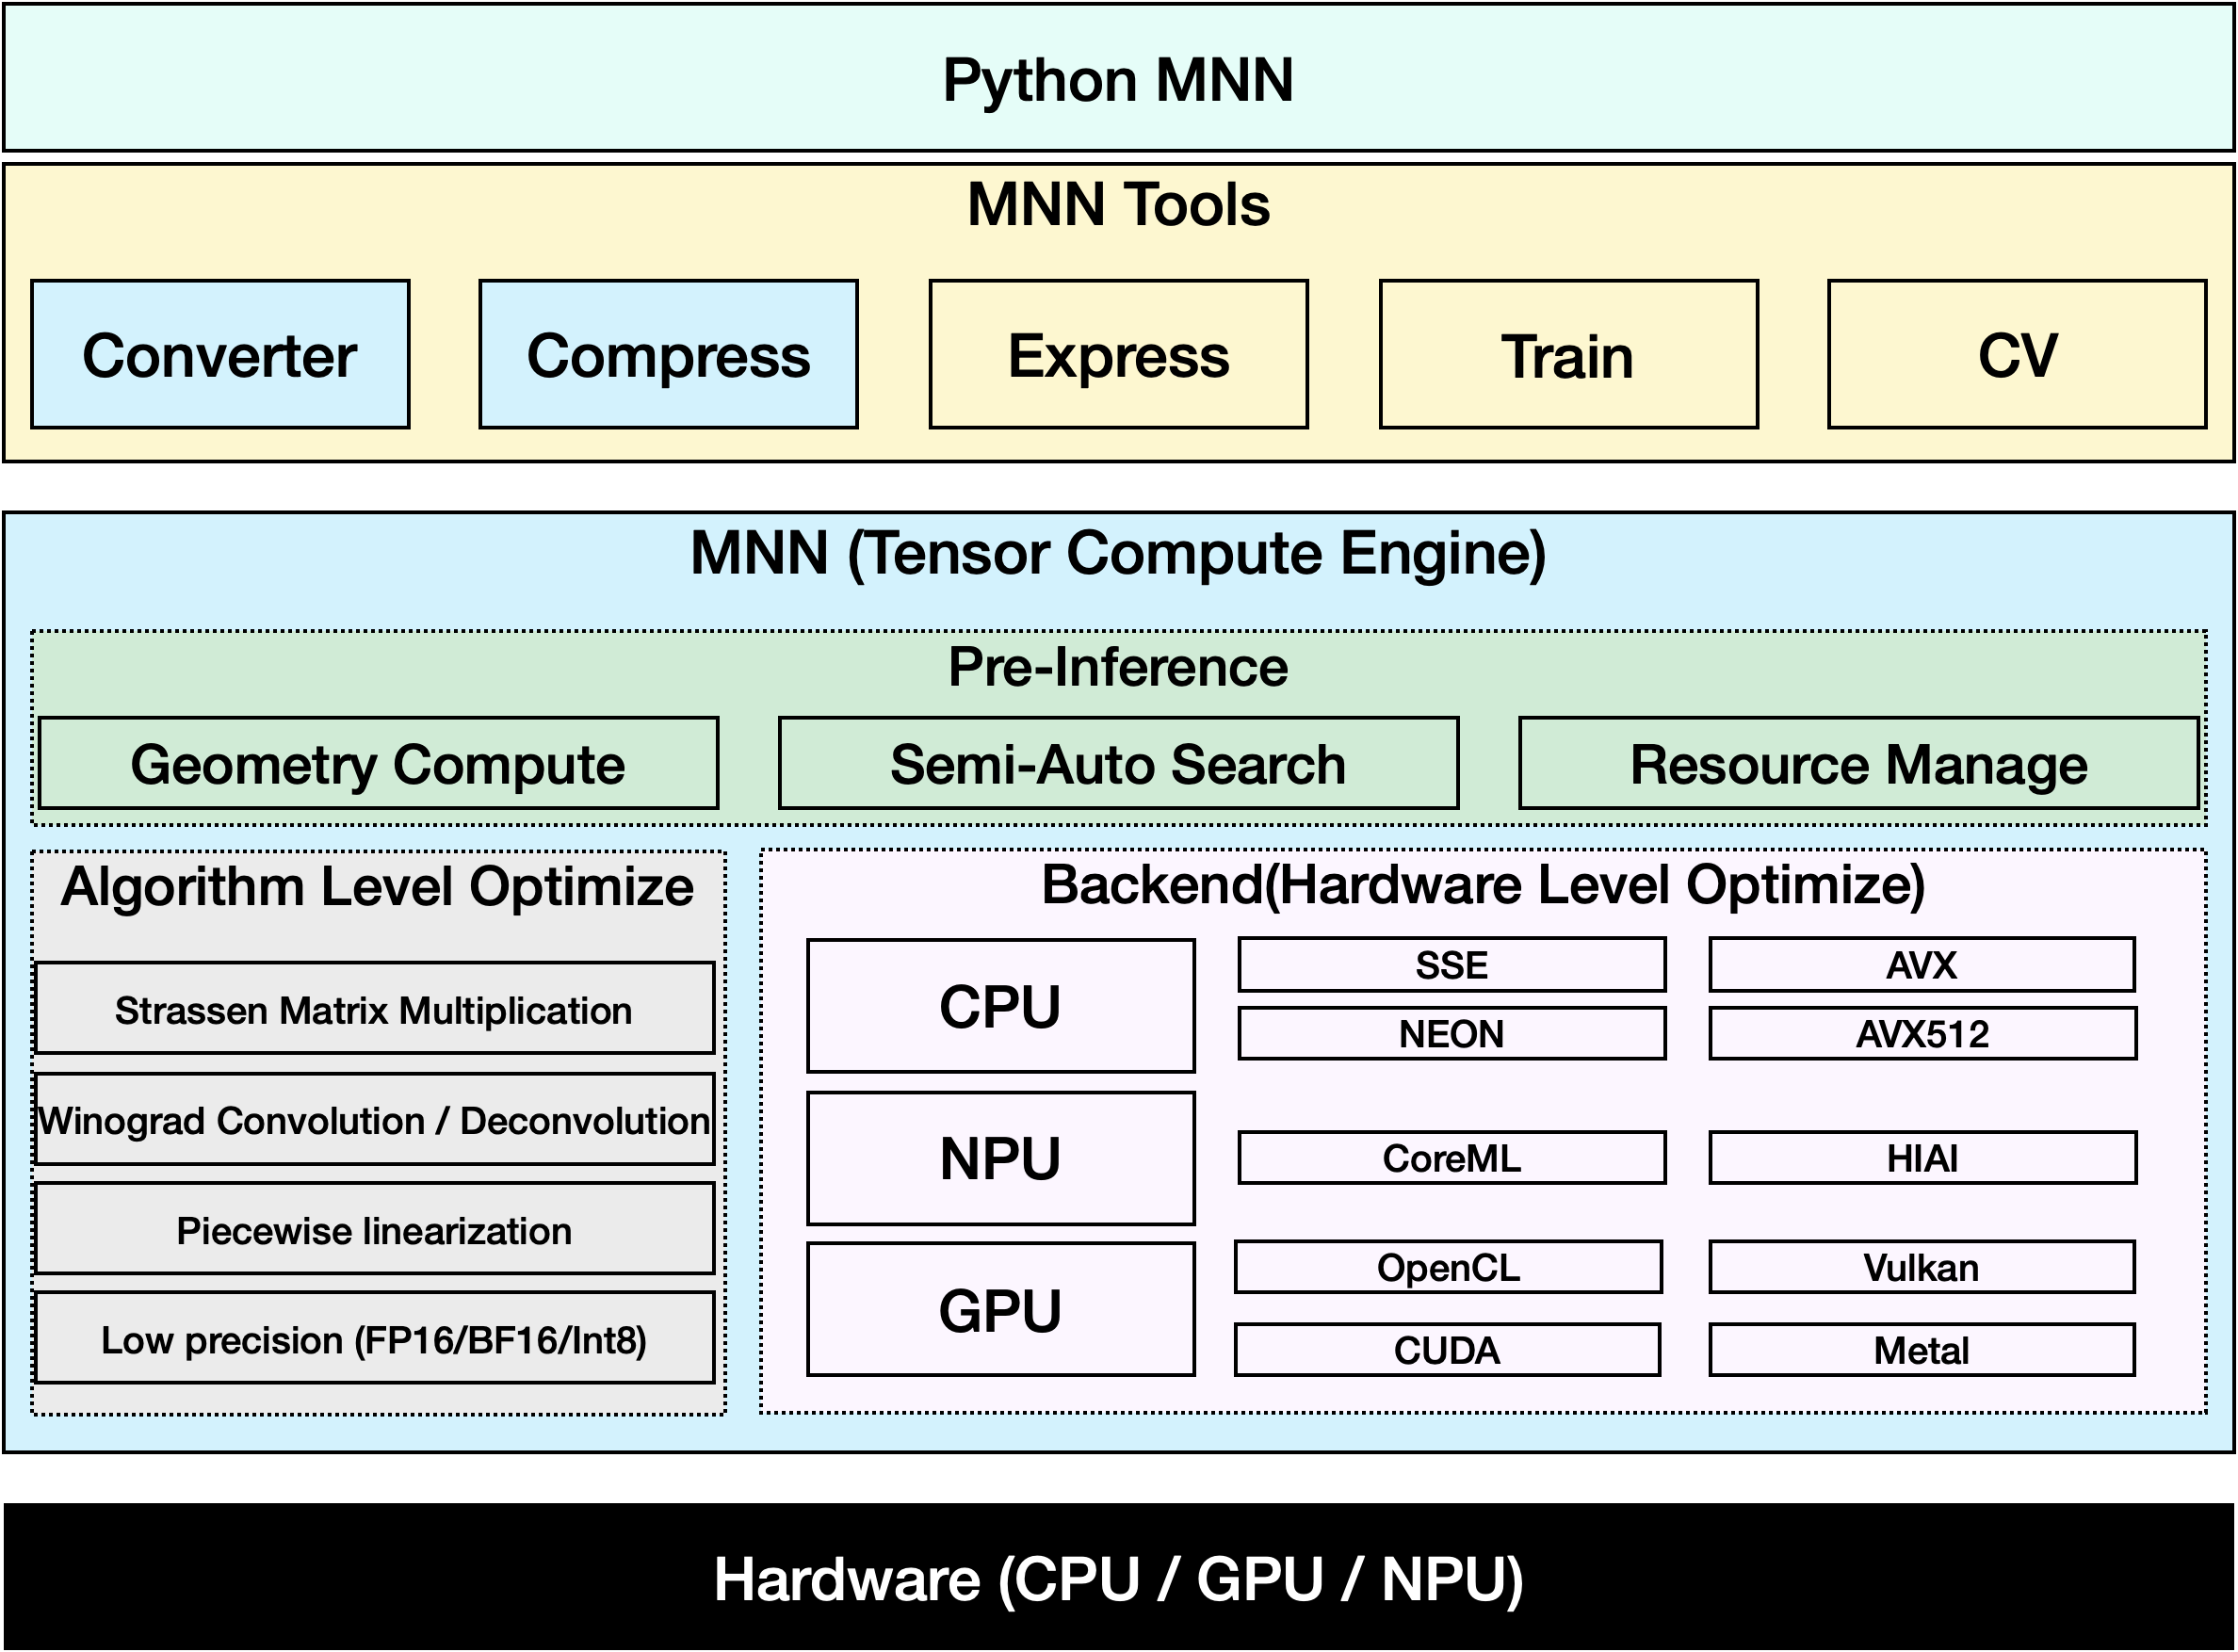
MNN è un framework di deep learning altamente efficiente e leggero. Supporta l'inferenza e l'addestramento di modelli di deep learning e offre prestazioni all'avanguardia per l'inferenza e l'addestramento direttamente sul dispositivo. Attualmente, MNN è stato integrato in più di 30 app di Alibaba Inc., tra cui Taobao, Tmall, Youku, DingTalk, Xianyu, ecc., coprendo più di 70 scenari d'uso come trasmissioni in diretta, acquisizione di brevi video, raccomandazioni nella ricerca, ricerca di prodotti tramite immagini, marketing interattivo, distribuzione di equity e controllo dei rischi per la sicurezza. Inoltre, MNN viene utilizzato anche su dispositivi embedded, come quelli IoT.
Watch: How to Export Ultralytics YOLO26 to MNN Format | Speed up Inference on Mobile Devices📱
Attività supportate#
L'esportazione MNN supporta tutti e sette i task Ultralytics. La segmentazione semantica e la stima della profondità sono disponibili solo con YOLO26, l'unica famiglia che include queste teste.
| Attività | YOLOv8 | YOLO11 | YOLO26 |
|---|---|---|---|
| Rilevamento | ✅ | ✅ | ✅ |
| Segmentazione | ✅ | ✅ | ✅ |
| Semantica | ❌ | ❌ | ✅ |
| Profondità | ❌ | ❌ | ✅ |
| Classificazione | ✅ | ✅ | ✅ |
| Posa | ✅ | ✅ | ✅ |
| OBB | ✅ | ✅ | ✅ |
Esportazione in MNN: conversione del tuo modello YOLO26#
Puoi ampliare la compatibilità del modello e la flessibilità di distribuzione convertendo i modelli Ultralytics YOLO nel formato MNN. Questa conversione ottimizza i tuoi modelli per ambienti mobili ed embedded, garantendo prestazioni efficienti su dispositivi con risorse limitate.
Installazione#
Per installare i pacchetti richiesti, esegui:
# Install the required package for YOLO26 and MNN
pip install ultralytics
pip install MNNUtilizzo#
Tutti i modelli Ultralytics YOLO26 sono progettati per supportare l'esportazione senza configurazioni aggiuntive, semplificando l'integrazione nel flusso di distribuzione che preferisci. Puoi consultare l'elenco completo dei formati di esportazione supportati e delle opzioni di configurazione per scegliere la configurazione migliore per la tua applicazione.
Il formato MNN supporta le modalità Esportazione, Predizione e Convalida. Esporta il tuo modello, quindi carica il modello esportato per eseguire l'inferenza o convalidarne l'accuratezza.
from ultralytics import YOLO

# Load a YOLO26 model
model = YOLO("yolo26n.pt")

# Export the model to MNN format
model.export(format="mnn") # creates 'yolo26n.mnn'from ultralytics import YOLO
# Load the exported MNN model
model = YOLO("yolo26n.mnn")
# Run inference
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Load the exported MNN model
model = YOLO("yolo26n.mnn")
# Validate accuracy on the COCO8 dataset
metrics = model.val(data="coco8.yaml")Argomenti di esportazione#
| Argomento | Tipo | Predefinito | Descrizione |
|---|---|---|---|
format | str | 'mnn' | Formato di destinazione del modello esportato, che definisce la compatibilità con diversi ambienti di distribuzione. |
imgsz | int o tuple | 640 | Dimensione desiderata dell'immagine per l'input del modello. Può essere un numero intero per immagini quadrate o una tupla (height, width) per dimensioni specifiche. |
quantize | int o str | None | Precisione della quantizzazione: 16 (FP16) o 8 (INT8) riducono i pesi esportati; 32/non impostato esporta pesi FP32, che il runtime CPU di MNN calcola comunque alla precisione predefinita low, anziché in FP32. Sostituisce i flag deprecati half/int8. |
simplify | bool | True | Semplifica il grafo ONNX intermedio con onnxslim. |
opset | int | None | Specifica la versione dell'opset ONNX per il grafo ONNX intermedio. Se non impostata, viene utilizzata la versione supportata più recente. |
batch | int | 1 | Specifica la dimensione del batch di inferenza del modello esportato o il numero massimo di immagini che il modello esportato elaborerà simultaneamente in modalità predict. |
dynamic | bool | False | Abilita dimensioni dinamiche per le immagini di input. Non può essere combinato con nms=True. |
nms | bool, facoltativo | None | Seleziona l'output grezzo (None, predefinito), l'NMS incorporato (True) o la testa senza NMS (False). L'NMS incorporato supporta rilevamento e stima della posa con dynamic=False. |
device | str | None | Specifica il dispositivo per l'esportazione: GPU (device=0), CPU (device=cpu), MPS per Apple silicon (device=mps). |
Per ulteriori dettagli sul processo di esportazione, visita la pagina della documentazione Ultralytics sull'esportazione.
Inferenza esclusivamente con MNN#
È stata implementata una funzione che si basa esclusivamente su MNN per l'inferenza e il pre-processing di YOLO26, con versioni Python e C++ per una distribuzione semplice in qualsiasi scenario.
import argparse

import MNN
import MNN.cv as cv2
import MNN.numpy as np

def inference(model, img, precision, backend, thread):
    config = {}
    config["precision"] = precision
    config["backend"] = backend
    config["numThread"] = thread
    rt = MNN.nn.create_runtime_manager((config,))
    # net = MNN.nn.load_module_from_file(model, ['images'], ['output0'], runtime_manager=rt)
    net = MNN.nn.load_module_from_file(model, [], [], runtime_manager=rt)
    original_image = cv2.imread(img)
    ih, iw, _ = original_image.shape
    length = max((ih, iw))
    scale = length / 640
    image = np.pad(original_image, [[0, length - ih], [0, length - iw], [0, 0]], "constant")
    image = cv2.resize(
        image, (640, 640), 0.0, 0.0, cv2.INTER_LINEAR, -1, [0.0, 0.0, 0.0], [1.0 / 255.0, 1.0 / 255.0, 1.0 / 255.0]
    )
    image = image[..., ::-1]  # BGR to RGB
    input_var = image[None]
    input_var = MNN.expr.convert(input_var, MNN.expr.NC4HW4)
    output_var = net.forward(input_var)
    output_var = MNN.expr.convert(output_var, MNN.expr.NCHW)
    output_var = output_var.squeeze()
    # output_var shape: [84, 8400]; 84 means: [cx, cy, w, h, prob * 80]
    cx = output_var[0]
    cy = output_var[1]
    w = output_var[2]
    h = output_var[3]
    probs = output_var[4:]
    # [cx, cy, w, h] -> [x0, y0, x1, y1]
    x0 = cx - w * 0.5
    y0 = cy - h * 0.5
    x1 = cx + w * 0.5
    y1 = cy + h * 0.5
    boxes = np.stack([x0, y0, x1, y1], axis=1)
    # get max prob and idx
    scores = np.max(probs, 0)
    class_ids = np.argmax(probs, 0)
    result_ids = MNN.expr.nms(boxes, scores, 100, 0.45, 0.25)
    print(result_ids.shape)
    # nms result box, score, ids
    result_boxes = boxes[result_ids]
    result_scores = scores[result_ids]
    result_class_ids = class_ids[result_ids]
    for i in range(len(result_boxes)):
        x0, y0, x1, y1 = result_boxes[i].read_as_tuple()
        y0 = int(y0 * scale)
        y1 = int(y1 * scale)
        x0 = int(x0 * scale)
        x1 = int(x1 * scale)
        # clamp to the original image size to handle cases where padding was applied
        x1 = min(iw, x1)
        y1 = min(ih, y1)
        print(result_class_ids[i])
        cv2.rectangle(original_image, (x0, y0), (x1, y1), (0, 0, 255), 2)
    cv2.imwrite("res.jpg", original_image)

if __name__ == "__main__":
    parser = argparse.ArgumentParser()
    parser.add_argument("--model", type=str, required=True, help="the yolo26 model path")
    parser.add_argument("--img", type=str, required=True, help="the input image path")
    parser.add_argument("--precision", type=str, default="normal", help="inference precision: normal, low, high, lowBF")
    parser.add_argument(
        "--backend",
        type=str,
        default="CPU",
        help="inference backend: CPU, OPENCL, OPENGL, NN, VULKAN, METAL, TRT, CUDA, HIAI",
    )
    parser.add_argument("--thread", type=int, default=4, help="inference using thread: int")
    args = parser.parse_args()
inference(args.model, args.img, args.precision, args.backend, args.thread)Riepilogo#
In questa guida spieghiamo come esportare il modello Ultralytics YOLO26 in MNN e usare MNN per l'inferenza. Il formato MNN offre prestazioni eccellenti per le applicazioni di edge AI, rendendolo ideale per la distribuzione di modelli di visione artificiale su dispositivi con risorse limitate.
Per ulteriori informazioni sull'utilizzo, consulta la documentazione di MNN.
FAQ#
Per esportare il tuo modello Ultralytics YOLO26 nel formato MNN, segui questi passaggi:
Esportazionefrom ultralytics import YOLO # Load a YOLO26 model model = YOLO("yolo26n.pt") # Export to MNN format model.export(format="mnn") # creates 'yolo26n.mnn' with fp32 weight model.export(format="mnn", quantize=16) # creates 'yolo26n.mnn' with fp16 weight model.export(format="mnn", quantize=8) # creates 'yolo26n.mnn' with int8 weightPer informazioni dettagliate sulle opzioni di esportazione, consulta la pagina Esportazione nella documentazione.
Per eseguire predizioni con un modello YOLO26 MNN esportato, usa la funzione
predictdella classe YOLO.Predizionefrom ultralytics import YOLO # Load the YOLO26 MNN model model = YOLO("yolo26n.mnn") # Run inference results = model("https://ultralytics.com/images/bus.jpg") for result in results: result.show() # display to screen result.save(filename="result.jpg") # save to diskMNN è versatile e supporta diverse piattaforme:
- Dispositivi mobili: Android, iOS, Harmony.
- Sistemi embedded e dispositivi IoT: dispositivi come Raspberry Pi e NVIDIA Jetson.
- Desktop e server: Linux, Windows e macOS.
Per distribuire i tuoi modelli YOLO26 su dispositivi mobili:
- Build per Android: segui la guida MNN Android.
- Build per iOS: segui la guida MNN iOS.
- Build per Harmony: segui la guida MNN Harmony.