RT-DETR di Baidu: un rilevatore di oggetti in tempo reale basato su Transformer visivo#
Panoramica#
Real-Time Detection Transformer (RT-DETR), sviluppato da Baidu, è un rilevatore di oggetti end-to-end all'avanguardia che offre prestazioni in tempo reale mantenendo un'elevata accuratezza. Si basa sull'idea di DETR (il framework senza NMS) e introduce al contempo un backbone basato su convoluzioni e un encoder ibrido efficiente per raggiungere velocità in tempo reale. RT-DETR elabora in modo efficiente le feature multiscala separando l'interazione tra le scale dalla fusione tra le scale. Il modello è altamente adattabile e supporta la regolazione flessibile della velocità di inferenza tramite diversi livelli del decoder, senza riaddestramento. RT-DETR eccelle sui backend accelerati come CUDA con TensorRT, superando molti altri rilevatori di oggetti in tempo reale.
Guarda: Come usare RT-DETR di Baidu per il rilevamento di oggetti | Inferenza e benchmark con Ultralytics 🚀
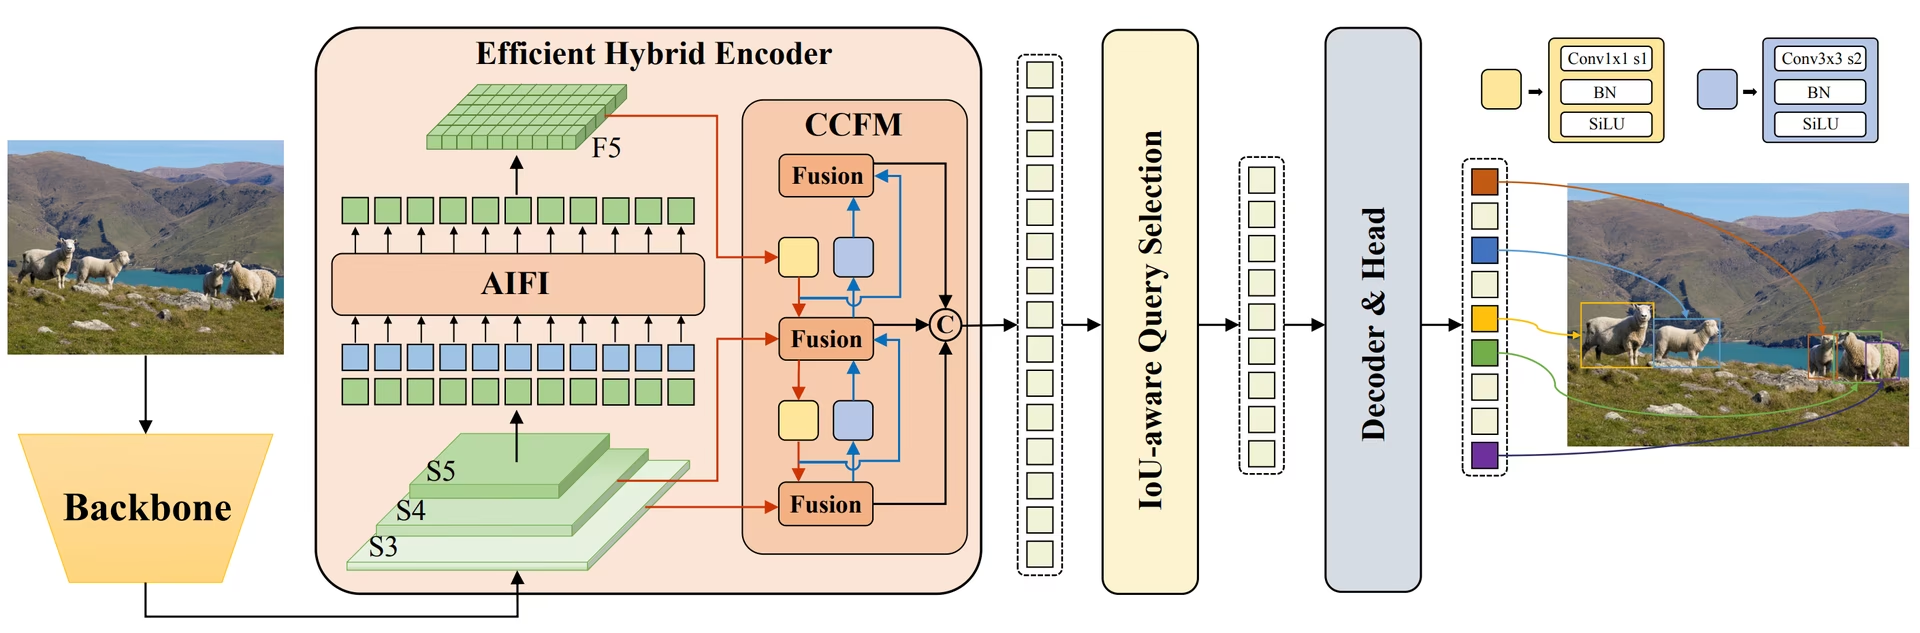 Panoramica di RT-DETR di Baidu. Il diagramma dell'architettura del modello RT-DETR mostra le ultime tre fasi del backbone {S3, S4, S5} come input dell'encoder. L'encoder ibrido efficiente trasforma le feature multiscala in una sequenza di feature dell'immagine mediante l'interazione delle feature intrascala (AIFI) e il modulo di fusione delle feature tra le scale (CCFM). La selezione delle query basata su IoU viene usata per selezionare un numero fisso di feature dell'immagine da usare come query iniziali degli oggetti per il decoder. Infine, il decoder con teste di predizione ausiliarie ottimizza iterativamente le query degli oggetti per generare box e punteggi di confidenza (fonte).
Funzionalità principali#
- Encoder ibrido efficiente: RT-DETR di Baidu utilizza un encoder ibrido efficiente che elabora le feature multiscala separando l'interazione tra le scale dalla fusione tra le scale. Questo design esclusivo basato su Vision Transformer riduce i costi computazionali e consente il rilevamento degli oggetti in tempo reale.
- Selezione delle query basata su IoU: RT-DETR di Baidu migliora l'inizializzazione delle query degli oggetti utilizzando la selezione delle query basata su IoU. In questo modo il modello può concentrarsi sugli oggetti più rilevanti nella scena, migliorando l'accuratezza del rilevamento.
- Velocità di inferenza adattabile: RT-DETR di Baidu supporta la regolazione flessibile della velocità di inferenza mediante diversi livelli del decoder, senza dover riaddestrare il modello. Questa adattabilità ne facilita l'applicazione pratica in vari scenari di rilevamento degli oggetti in tempo reale.
- Framework senza NMS: Basato su DETR, RT-DETR elimina la necessità della post-elaborazione di soppressione non massima, semplificando la pipeline di rilevamento e migliorando potenzialmente l'efficienza.
- Rilevamento senza anchor: In quanto rilevatore senza anchor, RT-DETR semplifica il processo di rilevamento e può migliorare la generalizzazione tra dataset diversi.
Modelli preaddestrati#
L'API Python di Ultralytics offre modelli RT-DETR PaddlePaddle preaddestrati con scale diverse:
- RT-DETR-L: 53.0% AP su COCO val2017, 114 FPS su GPU T4
- RT-DETR-X: 54.8% AP su COCO val2017, 74 FPS su GPU T4
Inoltre, Baidu ha rilasciato RTDETRv2 a luglio 2024, che migliora ulteriormente l'architettura originale con metriche di prestazione superiori.
Esempi d'uso#
Questo esempio illustra semplici esempi di addestramento e inferenza con RT-DETR. Per la documentazione completa su queste e altre modalità, consulta le pagine della documentazione Predict, Train, Val ed Export. Puoi anche addestrare i modelli su GPU cloud tramite Ultralytics Platform.
from ultralytics import RTDETR

# Carica un modello RT-DETR-l preaddestrato su COCO
model = RTDETR("rtdetr-l.pt")

# Visualizza le informazioni sul modello (facoltativo)
model.info()

# Addestra il modello sul dataset di esempio COCO8 per 100 epoche
results = model.train(data="coco8.yaml", epochs=100, imgsz=640)

# Esegui l'inferenza con il modello RT-DETR-l sull'immagine 'bus.jpg'
results = model("path/to/bus.jpg")Imposta deterministic=False quando addestri RT-DETR su CUDA con PyTorch 2.0 o versioni successive. La sua attenzione deformabile usa F.grid_sample, che non dispone di un backward CUDA deterministico, quindi deterministic=True non può rendere riproducibile l'esecuzione e può ridurre il throughput di addestramento. seed continua a controllare l'inizializzazione dei pesi, l'ordine dei dati e il campionamento delle augmentation.
I pesi RT-DETR preaddestrati supportano due impostazioni in fase di inferenza per ridurre la latenza senza riaddestramento:
eval_idx: interrompi anticipatamente la decodifica. Per il decoder predefinito a 6 livelli, usa un indice a base zero (0–5).eval_idx=5usa tutti i livelli;eval_idx=3ne usa 4. Su una GPU T4 con TensorRT v10.11, RT-DETR-L passa da 8.0 ms / 52.7 mAP a 7.4 ms / 52.5 mAP con 4 livelli.num_queries: riduci le query degli oggetti (predefinito: 300). Riducendole a 100 si possono raggiungere 7.4 ms / 51.7 mAP su COCO nella stessa configurazione. Nei dataset con meno oggetti per immagine, il calo di mAP è in genere più contenuto, ma mantieni il valore superiore al numero massimo previsto di oggetti per immagine.
Entrambe le impostazioni possono ridurre mAP: convalida il compromesso sul tuo dataset prima della distribuzione.
from ultralytics import RTDETR

rtdetr = RTDETR("rtdetr-l.pt")
head = rtdetr.model.model[-1]

# Scegli una o entrambe le impostazioni dopo aver convalidato il compromesso tra velocità e accuratezza.
head.decoder.eval_idx = 3  # Usa 4 dei 6 livelli del decoder.
head.num_queries = 100  # Usa meno query degli oggetti.

results = rtdetr("path/to/image.jpg")

# L'esportazione usa le stesse impostazioni del decoder e delle query, incluse le esportazioni TensorRT.
rtdetr.export(format="engine", device=0, quantize=16)
Attività e modalità supportate#
Questa tabella presenta i tipi di modello, i relativi pesi preaddestrati specifici, le attività supportate da ciascun modello e le varie modalità (Train, Val, Predict, Export) supportate, indicate con emoji ✅.
| Tipo di modello | Pesi preaddestrati | Attività supportate | Addestramento | Validazione | Inferenza | Esporta |
|---|---|---|---|---|---|---|
| RT-DETR Large | rtdetr-l.pt | Rilevamento di oggetti | ✅ | ✅ | ✅ | ✅ |
| RT-DETR Extra-Large | rtdetr-x.pt | Rilevamento di oggetti | ✅ | ✅ | ✅ | ✅ |
rtdetr-resnet50.yaml e rtdetr-resnet101.yaml sono distribuiti solo come architetture YAML. Ultralytics rilascia pesi preaddestrati solo per rtdetr-l e rtdetr-x. Istanzia le varianti ResNet da YAML (ad esempio, RTDETR("rtdetr-resnet50.yaml")) e addestrale o perfezionale secondo necessità.
Casi d'uso ideali#
RT-DETR è particolarmente adatto alle applicazioni che richiedono sia un'elevata accuratezza sia prestazioni in tempo reale:
- Guida autonoma: per una percezione affidabile dell'ambiente nei sistemi di guida autonoma, in cui velocità e accuratezza sono entrambe fondamentali. Scopri di più sull'IA nelle auto a guida autonoma.
- Robotica avanzata: consente ai robot di svolgere attività complesse che richiedono il riconoscimento accurato degli oggetti e l'interazione in ambienti dinamici. Esplora il ruolo dell'IA nella robotica.
- Imaging medico: per applicazioni sanitarie in cui la precisione del rilevamento degli oggetti può essere fondamentale per la diagnosi. Scopri l'IA in ambito sanitario.
- Sistemi di videosorveglianza: per applicazioni di sicurezza che richiedono un monitoraggio in tempo reale con un'elevata accuratezza di rilevamento. Scopri i sistemi di allarme di sicurezza.
- Analisi di immagini satellitari: per l'analisi dettagliata di immagini ad alta risoluzione, in cui è importante comprendere il contesto globale. Leggi la computer vision nelle immagini satellitari.
Citazioni e ringraziamenti#
Se utilizzi RT-DETR di Baidu nelle tue attività di ricerca o sviluppo, cita il paper originale:
@misc{lv2023detrs,
      title={DETRs Beat YOLOs on Real-time Object Detection},
      author={Wenyu Lv and Shangliang Xu and Yian Zhao and Guanzhong Wang and Jinman Wei and Cheng Cui and Yuning Du and Qingqing Dang and Yi Liu},
      year={2023},
      eprint={2304.08069},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Per RTDETRv2, puoi citare il paper del 2024:
@misc{lv2024rtdetrv2,
      title={RTDETRv2: All-in-One Detection Transformer Beats YOLO and DINO},
      author={Wenyu Lv and Yian Zhao and Qinyao Chang and Kui Huang and Guanzhong Wang and Yi Liu},
      year={2024},
      eprint={2407.17140},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Desideriamo ringraziare Baidu e il team PaddlePaddle per aver creato e mantenuto questa preziosa risorsa per la comunità della computer vision. Apprezziamo molto il loro contributo al settore con lo sviluppo del rilevatore di oggetti in tempo reale basato su Vision Transformer, RT-DETR.
Domande frequenti#
RT-DETR (Real-Time Detection Transformer) di Baidu è un rilevatore di oggetti avanzato in tempo reale basato sull'architettura Vision Transformer. Elabora in modo efficiente le feature multiscala separando l'interazione tra le scale dalla fusione tra le scale tramite il suo encoder ibrido efficiente. Usando la selezione delle query basata su IoU, il modello si concentra sugli oggetti più rilevanti, migliorando l'accuratezza del rilevamento. La velocità di inferenza adattabile, ottenuta regolando i livelli del decoder senza riaddestramento, rende RT-DETR adatto a vari scenari di rilevamento degli oggetti in tempo reale. Scopri di più sulle funzionalità di RT-DETR nel paper arXiv su RT-DETR.
Puoi usare l'API Python di Ultralytics per utilizzare modelli RT-DETR PaddlePaddle preaddestrati. Ad esempio, per caricare un modello RT-DETR-l preaddestrato su COCO val2017 e ottenere un FPS elevato su GPU T4, puoi usare il seguente esempio:
Esempiofrom ultralytics import RTDETR # Carica un modello RT-DETR-l preaddestrato su COCO model = RTDETR("rtdetr-l.pt") # Visualizza le informazioni sul modello (facoltativo) model.info() # Addestra il modello sul dataset di esempio COCO8 per 100 epoche results = model.train(data="coco8.yaml", epochs=100, imgsz=640) # Esegui l'inferenza con il modello RT-DETR-l sull'immagine 'bus.jpg' results = model("path/to/bus.jpg")RT-DETR di Baidu si distingue per l'encoder ibrido efficiente e la selezione delle query basata su IoU, che riducono drasticamente i costi computazionali mantenendo un'elevata accuratezza. La sua capacità esclusiva di regolare la velocità di inferenza usando diversi livelli del decoder senza riaddestramento offre una notevole flessibilità. Questo lo rende particolarmente vantaggioso per le applicazioni che richiedono prestazioni in tempo reale su backend accelerati come CUDA con TensorRT, superando molti altri rilevatori di oggetti in tempo reale. L'architettura Transformer offre inoltre una comprensione del contesto globale migliore rispetto ai rilevatori tradizionali basati su CNN.
RT-DETR di Baidu consente di regolare in modo flessibile la velocità di inferenza usando diversi livelli del decoder senza richiedere un riaddestramento. Questa adattabilità è fondamentale per scalare le prestazioni in varie attività di rilevamento degli oggetti in tempo reale. Che ti serva un'elaborazione più veloce per esigenze di precisione inferiori o rilevamenti più lenti ma più accurati, RT-DETR può essere configurato per soddisfare le tue esigenze specifiche. Questa funzionalità è particolarmente utile quando distribuisci i modelli su dispositivi con capacità computazionali diverse.
No. Per RT-DETR,
max_detlimita il numero di predizioni restituite dopo l'inferenza, ma non aumenta il numero di query degli oggetti generate dal decoder. I checkpoint RT-DETR preaddestrati di Ultralytics usano 300 query degli oggetti, quindi non possono restituire più di 300 rilevamenti per immagine, anche se impostimax_detsu un valore maggiore.Usa
max_detper ridurre i rilevamenti restituiti, ad esempiomax_det=100, quando ti servono solo poche predizioni ad alta confidenza. Se il tuo dataset può contenere più di 300 oggetti per immagine, addestra un modello RT-DETR personalizzato con un numero maggiore di query del decoder (nq) nel file YAML del modello; modificare questo valore su un checkpoint preaddestrato dopo l'addestramento non è equivalente e richiede un riaddestramento per apprendere le query aggiuntive.Sì, i modelli RT-DETR sono compatibili con varie modalità di Ultralytics, tra cui addestramento, validazione, predizione ed esportazione. Puoi consultare la documentazione pertinente per istruzioni dettagliate su come usare queste modalità: Train, Val, Predict ed Export. Questo garantisce un workflow completo per sviluppare e distribuire le tue soluzioni di rilevamento degli oggetti. Il framework Ultralytics offre un'API coerente tra diverse architetture di modello, semplificando l'utilizzo dei modelli RT-DETR.