SAM 3: segmentare qualsiasi cosa con i concetti
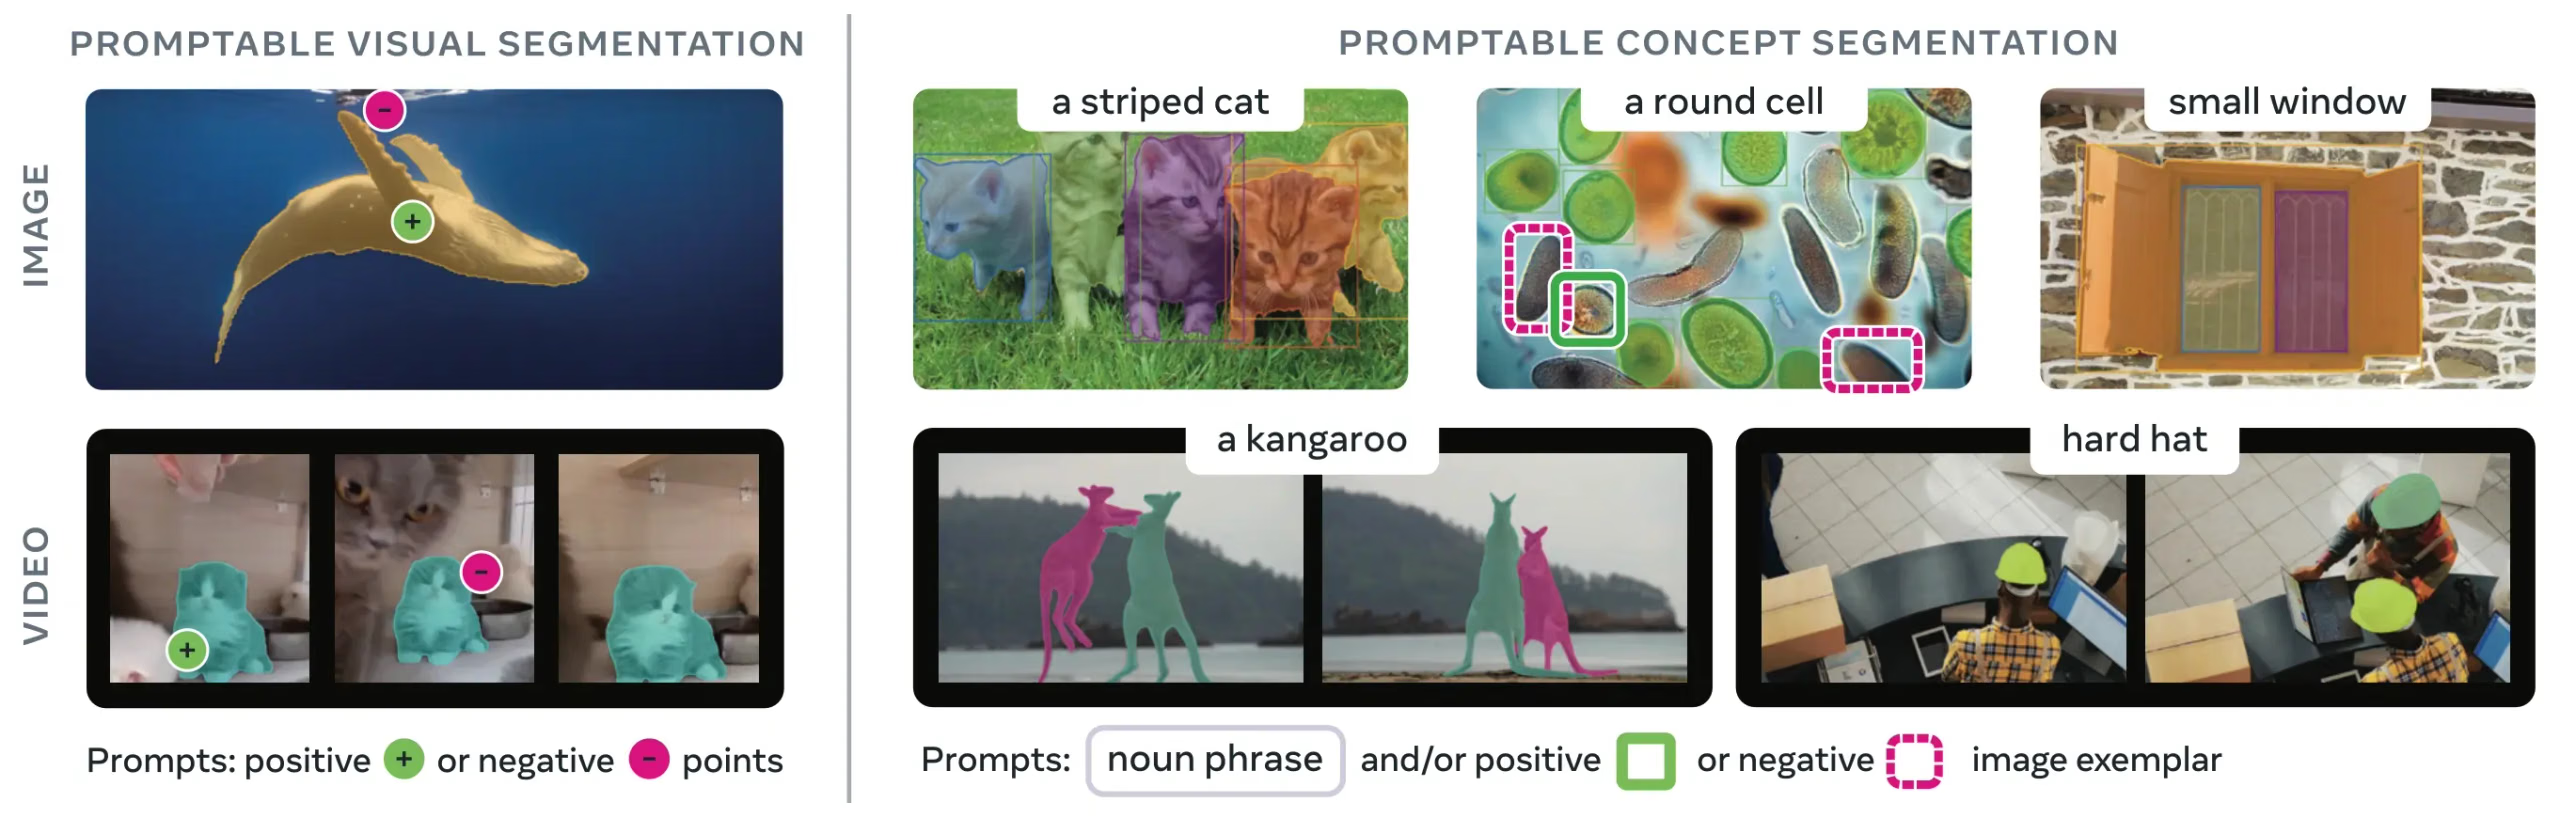
SAM 3 (Modello Segment Anything 3) è il modello fondazionale di Meta per la segmentazione di concetti guidata da prompt (PCS). Basato su SAM 2, SAM 3 introduce una nuova capacità: rilevare, segmentare e tracciare tutte le istanze di un concetto visivo specificato tramite prompt testuali, immagini di esempio o entrambi. A differenza delle versioni precedenti di SAM, che segmentano un singolo oggetto per prompt, SAM 3 può trovare e segmentare ogni occorrenza di un concetto in qualsiasi punto di immagini o video, in linea con gli obiettivi a vocabolario aperto della moderna segmentazione di istanze.
Guarda: Come usare Segment Anything 3 di Meta con Ultralytics | Segmentazione tramite prompt testuali su immagini e video
SAM 3 è completamente integrato nel pacchetto ultralytics e offre supporto nativo per la segmentazione di concetti con prompt testuali, prompt basati su immagini di esempio e tracciamento video. Il checkpoint più recente SAM 3.1 è supportato per la predizione su immagini.
Panoramica#
SAM 3 offre un miglioramento delle prestazioni di 2× rispetto ai sistemi esistenti nella segmentazione di concetti guidata da prompt, mantenendo e migliorando al contempo le capacità di SAM 2 per la segmentazione visiva interattiva. Il modello eccelle nella segmentazione a vocabolario aperto e consente agli utenti di specificare concetti usando semplici sintagmi nominali (ad es. "scuolabus giallo", "gatto a strisce") o fornendo immagini di esempio dell'oggetto desiderato. In Ultralytics, SAM 3 viene eseguito in modalità predict, con predittori video dedicati al tracciamento.
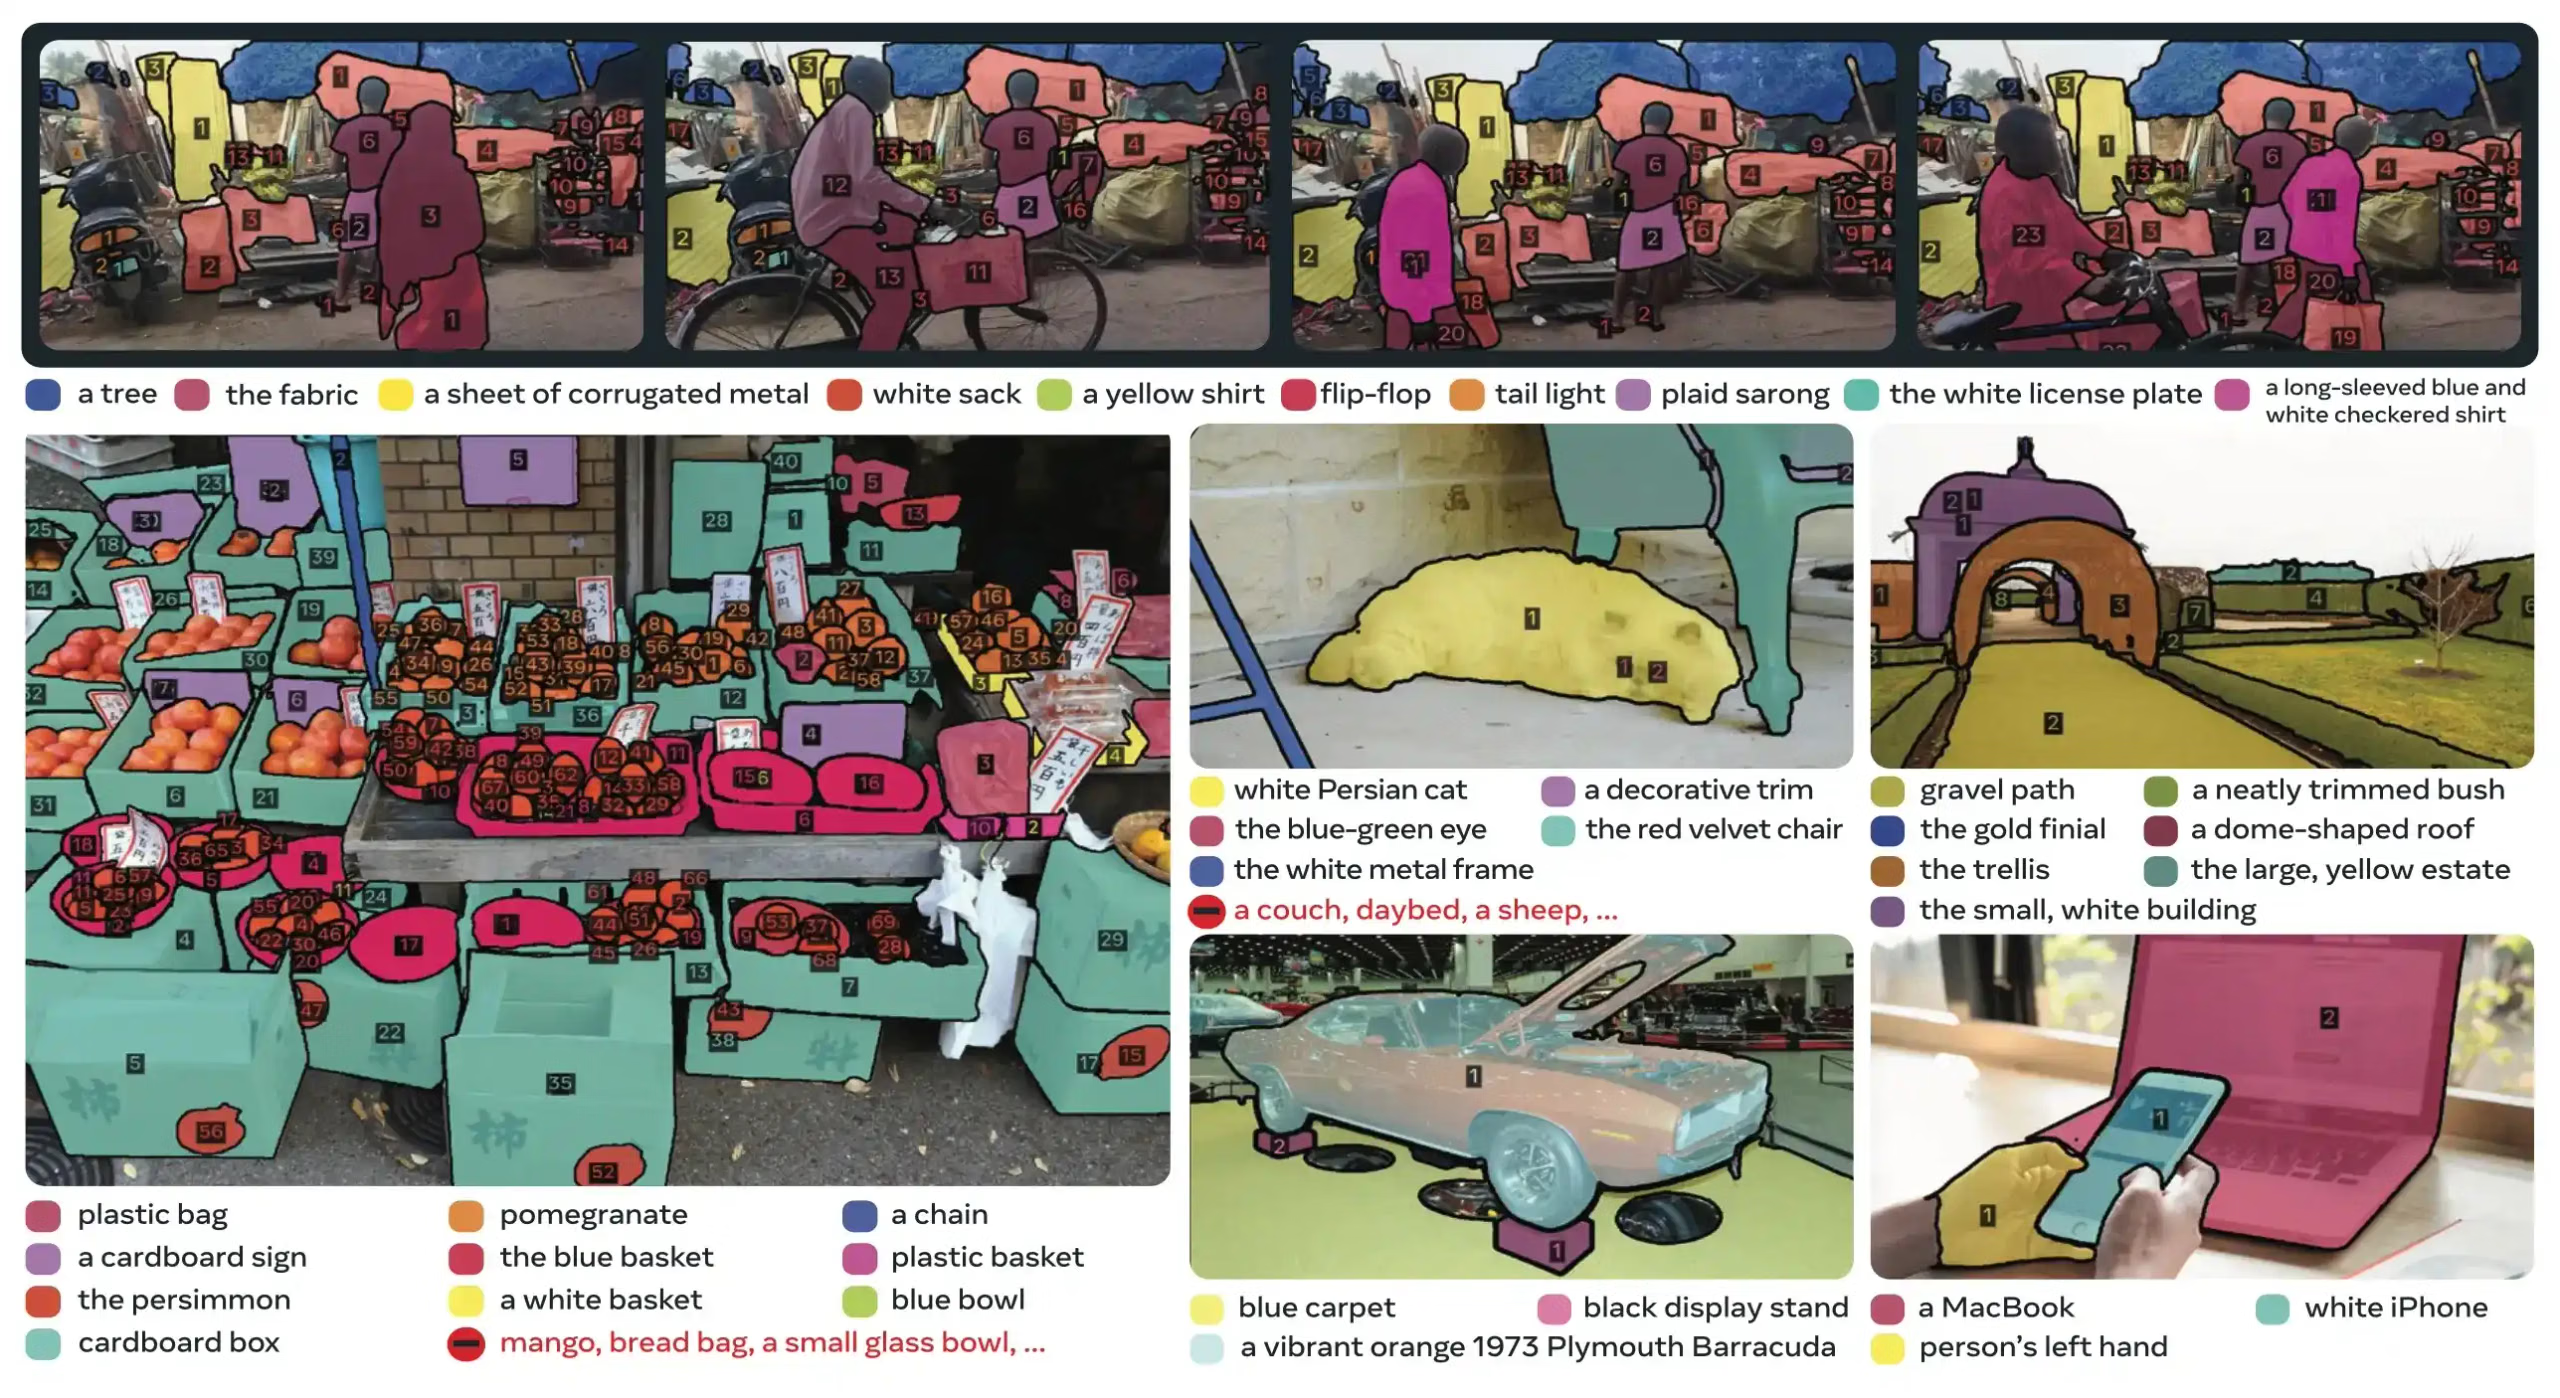
Che cos'è la segmentazione di concetti tramite prompt (PCS)?#
L'attività PCS riceve in input un prompt concettuale e restituisce maschere di segmentazione con identità univoche per tutte le istanze di oggetti corrispondenti. I prompt concettuali possono essere:
- Testo: semplici sintagmi nominali come "mela rossa" o "persona con un cappello", simili a quelli usati nell'apprendimento zero-shot
- Immagini di esempio: bounding box intorno a oggetti di esempio (positivi o negativi) per una generalizzazione rapida
- Combinati: testo e immagini di esempio insieme per un controllo preciso
Questo approccio differisce dai prompt visivi tradizionali (punti, riquadri, maschere), che segmentano una sola istanza specifica di un oggetto, come reso popolare dalla famiglia SAM originale.
Metriche chiave delle prestazioni#
| Metrica | Risultato di SAM 3 |
|---|---|
| AP delle maschere zero-shot su LVIS | 47.0 (rispetto al precedente valore migliore di 38.5, miglioramento del +22%) |
| Benchmark SA-Co | 2× migliore rispetto ai sistemi esistenti |
| Velocità di inferenza (GPU H200) | 30 ms per immagine con oltre 100 oggetti rilevati |
| Prestazioni video | Quasi in tempo reale per ~5 oggetti simultanei |
| Benchmark MOSEv2 VOS | 60.1 J&F (+25.5% rispetto a SAM 2.1, +17% rispetto al precedente stato dell'arte) |
| Raffinamento interattivo | Miglioramento di +18.6 CGF1 dopo 3 prompt con immagini di esempio |
| Divario rispetto alle prestazioni umane | Raggiunge l'88% del limite inferiore stimato su SA-Co/Gold |
Per informazioni sul contesto delle metriche dei modelli e sui compromessi in produzione, consulta approfondimenti sulla valutazione dei modelli e metriche delle prestazioni di YOLO.
SAM 3.1#
SAM 3.1, rilasciato da Meta il 27 marzo 2026, è un nuovo checkpoint di SAM 3 che aggiunge Object Multiplex, un approccio basato sulla memoria condivisa per il tracciamento video di più oggetti. Invece di elaborare ogni oggetto tracciato in modo indipendente, SAM 3.1 raggruppa gli oggetti in bucket di capacità fissa e li elabora insieme; secondo Meta, su una singola GPU H100 questo consente un aumento della velocità di ~7× con 128 oggetti. Il rilevatore di immagini e la head interattiva basata su prompt puntuali mantengono l'architettura di SAM 3.
| Benchmark | Metrica | SAM 3 | SAM 3.1 |
|---|---|---|---|
| SA-Co/VEval SA-V (test) | cgF1 | 30.3 | 30.5 |
| SA-Co/VEval YT-Temporal-1B (test) | cgF1 | 50.8 | 52.9 |
| SA-Co/VEval SmartGlasses (test) | cgF1 | 36.4 | 36.3 |
| MOSEv1 (val) | J&F | 78.4 | 79.6 |
| DAVIS17 (val) | J&F | 92.2 | 92.7 |
| SA-V (test) | J&F | 84.4 | 85.1 |
| YTVOS19 (val) | G | 89.7 | 89.3 |
| MOSEv2 (val) | J&Ḟ | 60.3 | 62.3 |
Ultralytics carica il checkpoint SAM 3.1 (sam3.1_multiplex.pt) nei predittori di immagini SAM 3: SAM("sam3.1_multiplex.pt") per i prompt puntuali e a riquadro e SAM3SemanticPredictor per i prompt testuali e con immagini di esempio. Il tracciamento video Object Multiplex non è ancora supportato, quindi continua a usare sam3.pt con SAM3VideoPredictor e SAM3VideoSemanticPredictor.
Architettura#
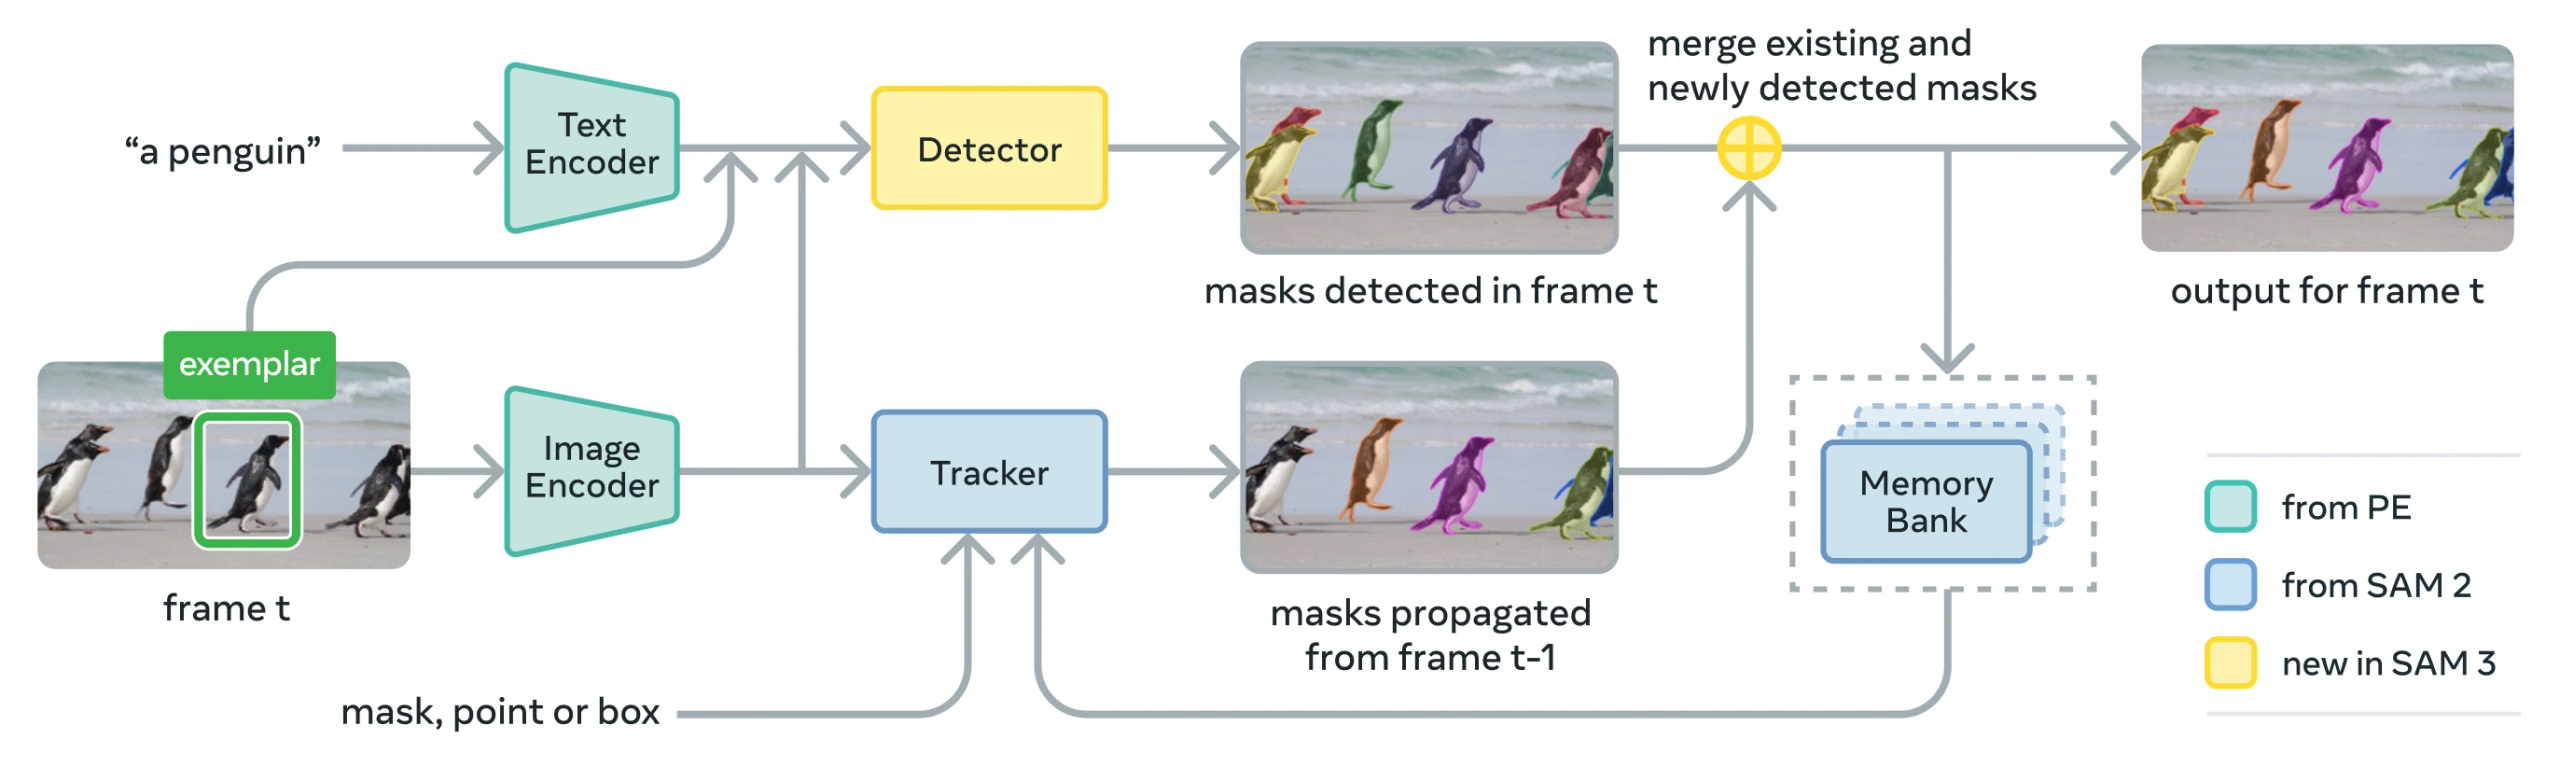
SAM 3 è composto da un rilevatore e un tracker che condividono un backbone visivo Perception Encoder (PE). Questo design disaccoppiato evita conflitti tra attività e consente sia il rilevamento a livello di immagine sia il tracciamento a livello video, con un'interfaccia compatibile con l'uso di Python e l'uso della CLI di Ultralytics.
Componenti principali#
-
Rilevatore: architettura basata su DETR per il rilevamento di concetti a livello di immagine
- Encoder testuale per i prompt con sintagmi nominali
- Encoder di immagini di esempio per i prompt basati su immagini
- Encoder di fusione per condizionare le feature dell'immagine in base ai prompt
- Nuova head di presenza che disaccoppia il riconoscimento ("cosa") dalla localizzazione ("dove")
- Head delle maschere per generare maschere di segmentazione delle istanze
-
Tracker: segmentazione video basata sulla memoria, ereditata da SAM 2
- Encoder dei prompt, decoder delle maschere, encoder della memoria
- Banca di memoria per memorizzare l'aspetto degli oggetti tra i fotogrammi
-
Token di presenza: token globale appreso che predice se il concetto target è presente nell'immagine o nel fotogramma, migliorando il rilevamento separando il riconoscimento dalla localizzazione.
Innovazioni chiave#
- Riconoscimento e localizzazione disaccoppiati: la testa di presenza predice globalmente la presenza dei concetti, mentre le query delle proposte si concentrano solo sulla localizzazione, evitando obiettivi in conflitto.
- Prompt concettuali e visivi unificati: supporta sia PCS (prompt concettuali) sia PVS (prompt visivi come clic/riquadri di SAM 2) in un unico modello.
- Affinamento interattivo con esempi: gli utenti possono aggiungere esempi positivi o negativi di immagini per affinare iterativamente i risultati; il modello generalizza a oggetti simili invece di correggere solo singole istanze.
- Disambiguazione temporale: usa i punteggi di rilevamento dei masklet e il riprompting periodico per gestire occlusioni, scene affollate e problemi di tracking nei video, in linea con le best practice di segmentazione e tracking delle istanze.
Dataset SA-Co#
SAM 3 viene addestrato su Segment Anything with Concepts (SA-Co), il dataset di segmentazione più grande e diversificato mai realizzato da Meta, che va oltre i benchmark comuni come COCO e LVIS.
Dati di addestramento#
| Componente del dataset | Descrizione | Dimensioni |
|---|---|---|
| SA-Co/HQ | Dati di immagini di alta qualità annotati da persone, ottenuti con un motore di dati in 4 fasi | 5,2 M di immagini, 4 M di sintagmi nominali distinti |
| SA-Co/SYN | Dataset sintetico etichettato dall'IA senza intervento umano | 38 M di sintagmi nominali, 1,4 mld di maschere |
| SA-Co/EXT | 15 dataset esterni arricchiti con esempi negativi difficili | Varia in base alla fonte |
| SA-Co/VIDEO | Annotazioni video con tracking temporale | 52,5 mila video, 24,8 mila sintagmi nominali distinti |
Dati di benchmark#
Il benchmark di valutazione SA-Co contiene 214 mila espressioni distinte in 126 mila immagini e video e offre oltre 50× più concetti rispetto ai benchmark esistenti. Include:
- SA-Co/Gold: 7 domini, con tripla annotazione per misurare i limiti delle prestazioni umane
- SA-Co/Silver: 10 domini, con un'unica annotazione umana
- SA-Co/Bronze e SA-Co/Bio: 9 dataset esistenti adattati per la segmentazione concettuale
- SA-Co/VEval: benchmark video con 3 domini (SA-V, YT-Temporal-1B, SmartGlasses)
Innovazioni del motore di dati#
Il motore di dati scalabile di SAM 3, con intervento umano e del modello nel ciclo, raggiunge una capacità di annotazione 2× superiore grazie a:
- Annotatori IA: i modelli basati su Llama propongono diversi sintagmi nominali, inclusi negativi difficili
- Verificatori IA: gli LLM multimodali ottimizzati verificano la qualità e la completezza delle maschere con prestazioni quasi umane
- Estrazione attiva: concentra il lavoro umano sui casi di errore complessi in cui l'IA ha difficoltà
- Basato su ontologia: usa un'ampia ontologia basata su Wikidata per coprire i concetti
Installazione#
Installa o aggiorna il pacchetto ultralytics:
pip install -U ultralyticsA differenza degli altri modelli Ultralytics, i pesi di SAM 3 (sam3.pt) non vengono scaricati automaticamente. Devi prima richiedere l'accesso ai pesi del modello nella pagina del modello SAM 3 su Hugging Face e poi, una volta approvato, scaricare sam3.pt da quella pagina. Inserisci il file sam3.pt scaricato nella directory di lavoro oppure specifica il percorso completo quando carichi il modello.
I pesi di SAM 3.1 (sam3.1_multiplex.pt) sono soggetti alle stesse restrizioni nella pagina del modello SAM 3.1. Passa sam3.1_multiplex.pt ovunque negli esempi con immagini qui sotto venga usato sam3.pt.
Se ricevi l'errore riportato sopra durante la predizione, significa che hai installato il pacchetto clip sbagliato. Installa il pacchetto clip corretto eseguendo il comando seguente:
pip uninstall clip -y
pip install git+https://github.com/ultralytics/CLIP.git
Come usare SAM 3: versatilità nella segmentazione concettuale#
SAM 3 supporta le attività di segmentazione concettuale tramite prompt (PCS) e segmentazione visiva tramite prompt (PVS) attraverso interfacce predittive diverse:
Attività e modelli supportati#
| Tipo di attività | Tipi di prompt | Output |
|---|---|---|
| Segmentazione concettuale (PCS) | Testo (sintagmi nominali), esempi di immagini | Tutte le istanze che corrispondono al concetto |
| Segmentazione visiva (PVS) | Punti, riquadri, maschere | Singola istanza di oggetto (stile SAM 2) |
| Raffinamento interattivo | Aggiungi/rimuovi esempi o clic in modo iterativo | Segmentazione affinata con maggiore accuratezza |
Esempi di segmentazione concettuale#
Segmenta con prompt testuali#
Trova e segmenta tutte le istanze di un concetto usando una descrizione testuale. I prompt testuali richiedono l'interfaccia SAM3SemanticPredictor.
from ultralytics.models.sam import SAM3SemanticPredictor

# Inizializza il predittore con la configurazione
overrides = {
    "conf": 0.25,
    "task": "segment",
    "mode": "predict",
    "model": "sam3.pt",
    "quantize": 16,  # Usa FP16 per un'inferenza più rapida
    "save": True,
}
predictor = SAM3SemanticPredictor(overrides=overrides)

# Imposta l'immagine una sola volta per più query
predictor.set_image("path/to/image.jpg")

# Esegui query con più prompt testuali
results = predictor(text=["person", "bus", "glasses"])

# Funziona con descrizioni dettagliate
results = predictor(text=["person with red cloth", "person with blue cloth"])

# Esegui una query con un singolo concetto
results = predictor(text=["a person"])
Segmenta con esempi di immagini#
Usa i riquadri di delimitazione come prompt visivi per trovare tutte le istanze simili. Anche questa operazione richiede SAM3SemanticPredictor per la corrispondenza basata sui concetti.
from ultralytics.models.sam import SAM3SemanticPredictor

# Inizializza il predittore
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "model": "sam3.pt", "quantize": 16, "save": True}
predictor = SAM3SemanticPredictor(overrides=overrides)

# Imposta l'immagine
predictor.set_image("path/to/image.jpg")

# Fornisci esempi di riquadri di delimitazione per segmentare oggetti simili
results = predictor(bboxes=[[480.0, 290.0, 590.0, 650.0]])

# Più riquadri di delimitazione come esempi dello stesso concetto visivo
results = predictor(bboxes=[[539, 599, 589, 639], [343, 267, 499, 662]])
Inferenza basata sulle caratteristiche per una maggiore efficienza#
Estrai una sola volta le caratteristiche dell'immagine e riutilizzale per più query di segmentazione, così da migliorare l'efficienza.
import cv2

from ultralytics.models.sam import SAM3SemanticPredictor
from ultralytics.utils.plotting import Annotator, colors

# Inizializza i predittori
overrides = {"conf": 0.50, "task": "segment", "mode": "predict", "model": "sam3.pt", "verbose": False}
predictor = SAM3SemanticPredictor(overrides=overrides)
predictor2 = SAM3SemanticPredictor(overrides=overrides)

# Estrai le caratteristiche dal primo predittore
source = "path/to/image.jpg"
predictor.set_image(source)
src_shape = cv2.imread(source).shape[:2]

# Configura il secondo predittore e riutilizza le caratteristiche
predictor2.setup_model()

# Esegui l'inferenza usando le caratteristiche condivise con un prompt testuale
masks, boxes = predictor2.inference_features(predictor.features, src_shape=src_shape, text=["person"])

# Esegui l'inferenza usando le caratteristiche condivise con un prompt basato su un riquadro di delimitazione
masks, boxes = predictor2.inference_features(predictor.features, src_shape=src_shape, bboxes=[[439, 437, 524, 709]])

# Visualizza i risultati
if masks is not None:
    masks, boxes = masks.cpu().numpy(), boxes.cpu().numpy()
    im = cv2.imread(source)
    annotator = Annotator(im, pil=False)
    annotator.masks(masks, [colors(x, True) for x in range(len(masks))])

    cv2.imshow("result", annotator.result())
    cv2.waitKey(0)
Segmentazione concettuale nei video#
Traccia i concetti nei video con i riquadri di delimitazione#
Rileva e traccia le istanze degli oggetti nei fotogrammi del video usando prompt basati su riquadri di delimitazione.
from ultralytics.models.sam import SAM3VideoPredictor

# Crea il predittore video
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "model": "sam3.pt", "quantize": 16}
predictor = SAM3VideoPredictor(overrides=overrides)

# Traccia gli oggetti usando prompt basati su riquadri di delimitazione
results = predictor(source="path/to/video.mp4", bboxes=[[706.5, 442.5, 905.25, 555], [598, 635, 725, 750]], stream=True)

# Elabora e visualizza i risultati
for r in results:
    r.show()  # Mostra il fotogramma con le maschere di segmentazione
Traccia i concetti con prompt testuali#
Traccia tutte le istanze dei concetti specificati tramite testo nei fotogrammi del video.
from ultralytics.models.sam import SAM3VideoSemanticPredictor

# Inizializza il predittore video semantico
overrides = {
    "conf": 0.25,
    "task": "segment",
    "mode": "predict",
    "imgsz": 640,
    "model": "sam3.pt",
    "quantize": 16,
    "save": True,
}
predictor = SAM3VideoSemanticPredictor(overrides=overrides)

# Traccia i concetti usando prompt testuali
results = predictor(source="path/to/video.mp4", text=["person", "bicycle"], stream=True)

# Elabora i risultati
for r in results:
    r.show()  # Mostra il fotogramma con gli oggetti tracciati

# Alternativa: traccia con prompt basati su riquadri di delimitazione
results = predictor(
    source="path/to/video.mp4",
    bboxes=[[864, 383, 975, 620], [705, 229, 782, 402]],
    labels=[1, 1],  # Etichette positive
    stream=True,
)
Prompt visivi (compatibilità con SAM 2)#
SAM 3 mantiene la piena retrocompatibilità con i prompt visivi di SAM 2 per la segmentazione di un singolo oggetto:
L'interfaccia di base SAM si comporta esattamente come SAM 2 e segmenta solo l'area specifica indicata dai prompt visivi (punti, riquadri o maschere).
from ultralytics import SAM

model = SAM("sam3.pt")

# Prompt con un singolo punto: segmenta l'oggetto in una posizione specifica
results = model.predict(source="path/to/image.jpg", points=[900, 370], labels=[1])
results[0].show()

# Più punti: segmenta un singolo oggetto usando più punti guida
results = model.predict(source="path/to/image.jpg", points=[[400, 370], [900, 370]], labels=[1, 1])

# Prompt con riquadro: segmenta l'oggetto all'interno del riquadro di delimitazione
results = model.predict(source="path/to/image.jpg", bboxes=[100, 150, 300, 400])
results[0].show()L'uso di SAM("sam3.pt") con prompt visivi (punti/riquadri/maschere) segmenta solo l'oggetto specifico in quella posizione, proprio come SAM 2. Per segmentare tutte le istanze di un concetto, usa SAM3SemanticPredictor con prompt testuali o basati su esempi, come mostrato sopra.
Benchmark delle prestazioni#
Segmentazione delle immagini#
SAM 3 raggiunge risultati all'avanguardia in diversi benchmark, inclusi dataset del mondo reale come LVIS e COCO per la segmentazione:
| Benchmark | Metrica | SAM 3 | Miglior risultato precedente | Miglioramento |
|---|---|---|---|---|
| LVIS (zero-shot) | AP delle maschere | 47.0 | 38.5 | +22.1% |
| SA-Co/Gold | CGF1 | 65.0 | 34.3 (OWLv2) | +89.5% |
| COCO (zero-shot) | AP dei riquadri | 53.5 | 52.2 (T-Rex2) | +2.5% |
| ADE-847 (segmentazione semantica) | mIoU | 14.7 | 9.2 (APE-D) | +59.8% |
| PascalConcept-59 | mIoU | 59.4 | 58.5 (APE-D) | +1.5% |
| Cityscapes (segmentazione semantica) | mIoU | 65.1 | 44.2 (APE-D) | +47.3% |
Esplora le opzioni di dataset per sperimentare rapidamente in dataset Ultralytics.
Prestazioni di segmentazione video#
SAM 3 mostra miglioramenti significativi rispetto a SAM 2 e ai precedenti risultati allo stato dell'arte nei benchmark video come DAVIS 2017 e YouTube-VOS:
| Benchmark | Metrica | SAM 3 | SAM 2.1 L | Miglioramento |
|---|---|---|---|---|
| MOSEv2 | J&F | 60.1 | 47.9 | +25.5% |
| DAVIS 2017 | J&F | 92.0 | 90.7 | +1.4% |
| LVOSv2 | J&F | 88.2 | 79.6 | +10.8% |
| SA-V | J&F | 84.6 | 78.4 | +7.9% |
| YTVOS19 | J&F | 89.6 | 89.3 | +0.3% |
Adattamento con pochi esempi#
SAM 3 si adatta a nuovi domini con pochi esempi, una caratteristica utile nei flussi di lavoro di IA incentrata sui dati:
| Benchmark | AP con 0 esempi | AP con 10 esempi | Miglior risultato precedente (10 esempi) |
|---|---|---|---|
| ODinW13 | 59.9 | 71.6 | 67.9 (gDino1.5-Pro) |
| RF100-VL | 14.3 | 35.7 | 33.7 (gDino-T) |
Efficacia del perfezionamento interattivo#
Il prompting basato sui concetti di SAM 3 con esempi converge molto più rapidamente del prompting visivo:
| Prompt aggiunti | Punteggio CGF1 | Incremento rispetto ai soli prompt testuali | Incremento rispetto alla baseline PVS |
|---|---|---|---|
| Solo testo | 46.4 | baseline | baseline |
| +1 esempio | 57.6 | +11.2 | +6.7 |
| +2 esempi | 62.2 | +15.8 | +9.7 |
| +3 esempi | 65.0 | +18.6 | +11.2 |
| +4 esempi | 65.7 | +19.3 | +11.5 (plateau) |
Precisione del conteggio degli oggetti#
SAM 3 offre un conteggio accurato segmentando tutte le istanze, un requisito comune nel conteggio degli oggetti:
| Benchmark | Precisione | MAE | rispetto al miglior MLLM |
|---|---|---|---|
| CountBench | 95.6% | 0.11 | 92.4% (Gemini 2.5) |
| PixMo-Count | 87.3% | 0.22 | 88.8% (Molmo-72B) |
Confronto tra SAM 3, SAM 2 e YOLO#
Qui confrontiamo le capacità di SAM 3 con quelle dei modelli SAM 2 e YOLO26:
| Capacità | SAM 3 | SAM 2 | YOLO26n-seg |
|---|---|---|---|
| Segmentazione per concetto | ✅ Tutte le istanze da testo/esempi | ❌ Non supportata | ❌ Non supportata |
| Segmentazione visiva | ✅ Singola istanza (compatibile con SAM 2) | ✅ Singola istanza | ✅ Tutte le istanze |
| Capacità zero-shot | ✅ Vocabolario aperto | ✅ Prompt geometrici | ❌ Insieme chiuso |
| Raffinamento interattivo | ✅ Esempi + clic | ✅ Solo clic | ❌ Non supportata |
| Tracciamento video | ✅ Più oggetti con identità | ✅ Più oggetti | ✅ Più oggetti |
| AP delle maschere LVIS (zero-shot) | 47.0 | N/D | N/D |
| MOSEv2 J&F | 60.1 | 47.9 | N/D |
| Velocità (GPU, ms/immagine) | 2921 | 857 | 8.4 |
| Dimensione del modello | 3.45 GB | 162 MB (base) | 6.4 MB |
Benchmark della velocità eseguito su NVIDIA RTX PRO 6000 con torch==2.9.1 e ultralytics==8.4.19.
Punti chiave:
- SAM 3: ideale per la segmentazione di concetti a vocabolario aperto e per trovare tutte le istanze di un concetto con prompt testuali o basati su esempi
- SAM 2: ideale per la segmentazione interattiva di un singolo oggetto in immagini e video con prompt geometrici
- YOLO26: ideale per la segmentazione in tempo reale ad alta velocità, con inferenza end-to-end opzionale senza NMS, esportabile in molti formati per la distribuzione su GPU, CPU e dispositivi edge
- YOLOE: ideale per il rilevamento e la segmentazione in tempo reale con vocabolario aperto e prompt testuali o visivi
Confronto tra SAM e YOLO#
Confronto tra SAM 3, SAM 2, SAM, MobileSAM e FastSAM e i modelli di segmentazione YOLO di Ultralytics (YOLOv8, YOLO11, YOLO26) in termini di dimensioni, parametri e velocità di inferenza su GPU:
| Modello | Dimensione (MB) | Parametri (M) | Velocità (GPU) (ms/im) |
|---|---|---|---|
| Meta SAM-b | 375 | 93.7 | 1306 |
| Meta SAM2-b | 162 | 80.8 | 857 |
| Meta SAM2-t | 78.1 | 38.9 | 668 |
| Meta SAM3 | 3450 | 473.6 | 2921 |
| MobileSAM | 40.7 | 10.1 | 605 |
| FastSAM-s con backbone YOLOv8 | 23.7 | 11.8 | 55.9 |
| Ultralytics YOLOv8n-seg | 6.7 (515 volte più piccolo) | 3.4 (139.1 volte in meno) | 17.4 (167 volte più veloce) |
| Ultralytics YOLO11n-seg | 5.9 (585 volte più piccolo) | 2.9 (163.1 volte in meno) | 12.6 (231 volte più veloce) |
| Ultralytics YOLO26n-seg | 6.4 (539 volte più piccolo) | 2.7 (175.2 volte in meno) | 8.4 (347 volte più veloce) |
Questo confronto evidenzia le notevoli differenze nelle dimensioni e nella velocità dei modelli tra le varianti SAM e i modelli di segmentazione YOLO. Sebbene SAM offra capacità uniche di segmentazione automatica, i modelli YOLO, in particolare YOLOv8n-seg, YOLO11n-seg e YOLO26n-seg, sono significativamente più piccoli, più veloci e più efficienti dal punto di vista computazionale.
Test eseguiti su una NVIDIA RTX PRO 6000 con 96GB di VRAM utilizzando torch==2.9.1 e ultralytics==8.4.19. Per riprodurre questo test:
from ultralytics import ASSETS, SAM, YOLO, FastSAM

# Profilo SAM3, SAM2-t, SAM2-b, SAM-b, MobileSAM
for file in ["sam_b.pt", "sam2_b.pt", "sam2_t.pt", "mobile_sam.pt", "sam3.pt"]:
    model = SAM(file)
    model.info()
    model(ASSETS)

# Profilo FastSAM-s
model = FastSAM("FastSAM-s.pt")
model.info()
model(ASSETS)

# Profilo dei modelli YOLO
for file_name in ["yolov8n-seg.pt", "yolo11n-seg.pt", "yolo26n-seg.pt"]:
    model = YOLO(file_name)
    model.info()
    model(ASSETS, nms=False)  # Head senza NMS di YOLO26; non fa nulla per YOLOv8/YOLO11
Metriche di valutazione#
SAM 3 introduce nuove metriche progettate per il task PCS, che si affiancano a misure note come F1 score, precisione e richiamo.
F1 con classificazione condizionata (CGF1)#
La metrica principale che combina localizzazione e classificazione:
CGF1 = 100 × pmF1 × IL_MCC
Dove:
- pmF1 (F1 macro positivo): misura la qualità della localizzazione sugli esempi positivi
- IL_MCC (coefficiente di correlazione di Matthews a livello di immagine): misura l'accuratezza della classificazione binaria ("il concetto è presente?")
Perché queste metriche?#
Le metriche AP tradizionali non tengono conto della calibrazione, rendendo difficile l'uso pratico dei modelli. Valutando solo le previsioni con confidenza superiore a 0.5, le metriche di SAM 3 impongono una buona calibrazione e rispecchiano i modelli d'uso reali nei cicli interattivi di previsione e tracciamento.
Ablation e approfondimenti principali#
Impatto della head di presenza#
La head di presenza separa il riconoscimento dalla localizzazione, apportando miglioramenti significativi:
| Configurazione | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| Senza presenza | 57.6 | 0.77 | 74.7 |
| Con presenza | 63.3 | 0.82 | 77.1 |
La head di presenza offre un incremento di +5.7 CGF1 (+9.9%), migliorando principalmente la capacità di riconoscimento (IL_MCC +6.5%).
Effetto degli esempi negativi difficili#
| Esempi negativi difficili/immagine | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| 0 | 31.8 | 0.44 | 70.2 |
| 5 | 44.8 | 0.62 | 71.9 |
| 30 | 49.2 | 0.68 | 72.3 |
Gli esempi negativi difficili sono fondamentali per il riconoscimento a vocabolario aperto e migliorano IL_MCC del 54.5% (0.44 → 0.68).
Scalabilità dei dati di addestramento#
| Fonti dei dati | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| Solo esterni | 30.9 | 0.46 | 66.3 |
| Esterni + sintetici | 39.7 | 0.57 | 70.6 |
| Esterni + alta qualità | 51.8 | 0.71 | 73.2 |
| Tutte e tre | 54.3 | 0.74 | 73.5 |
Le annotazioni umane di alta qualità offrono notevoli miglioramenti rispetto ai soli dati sintetici o esterni. Per informazioni sulle pratiche di qualità dei dati, consulta raccolta e annotazione dei dati.
Applicazioni#
La capacità di segmentazione dei concetti di SAM 3 abilita nuovi casi d'uso:
- Moderazione dei contenuti: trova tutte le istanze di tipi specifici di contenuti nelle raccolte multimediali
- E-commerce: segmenta tutti i prodotti di un certo tipo nelle immagini dei cataloghi, supportando l'annotazione automatica
- Diagnostica per immagini: identificare tutte le occorrenze di tipi specifici di tessuti o anomalie
- Sistemi autonomi: traccia tutte le istanze di segnali stradali, pedoni o veicoli per categoria
- Analisi video: conta e traccia tutte le persone che indossano determinati vestiti o compiono determinate azioni
- Annotazione dei dataset: annota rapidamente tutte le istanze di categorie di oggetti rare
- Ricerca scientifica: quantifica e analizza tutti gli esemplari che soddisfano criteri specifici
Agente SAM 3: ragionamento linguistico avanzato#
SAM 3 può essere combinato con modelli linguistici multimodali di grandi dimensioni (MLLM) per gestire query complesse che richiedono ragionamento, in modo simile a sistemi a vocabolario aperto come OWLv2 e T-Rex.
Prestazioni nei task di ragionamento#
| Benchmark | Metrica | Agente SAM 3 (Gemini 2.5 Pro) | Miglior risultato precedente |
|---|---|---|---|
| ReasonSeg (validazione) | gIoU | 76.0 | 65.0 (stato dell'arte) |
| ReasonSeg (test) | gIoU | 73.8 | 61.3 (stato dell'arte) |
| OmniLabel (validazione) | AP | 46.7 | 36.5 (REAL) |
| RefCOCO+ | Acc | 91.2 | 89.3 (LISA) |
Esempi di query complesse#
L'agente SAM 3 è in grado di gestire query che richiedono ragionamento:
- "Persone sedute che non tengono una scatola regalo in mano"
- "Il cane più vicino alla fotocamera che non indossa un collare"
- "Oggetti rossi più grandi della mano della persona"
L'MLLM propone a SAM 3 semplici query basate su sintagmi nominali, analizza le maschere restituite e ripete il processo finché il risultato non è soddisfacente.
Limitazioni#
SAM 3 presenta i seguenti limiti:
- Complessità delle frasi: è più adatto a semplici sintagmi nominali; le espressioni referenziali lunghe o il ragionamento complesso possono richiedere l'integrazione di un MLLM
- Gestione dell'ambiguità: alcuni concetti restano intrinsecamente ambigui (ad es. "finestra piccola", "stanza accogliente")
- Requisiti computazionali: più grande e lento rispetto ai modelli di rilevamento specializzati come YOLO
- Ampiezza del vocabolario: si concentra su concetti visivi atomici; il ragionamento composizionale è limitato senza l'assistenza di un MLLM
- Concetti rari: le prestazioni possono diminuire con concetti estremamente rari o granulari, non rappresentati adeguatamente nei dati di addestramento
Citazione#
@misc{carion2025sam3,
  title         = {SAM 3: Segment Anything with Concepts},
  author        = {Nicolas Carion and Laura Gustafson and Yuan-Ting Hu and Shoubhik Debnath and Ronghang Hu and Didac Suris and Chaitanya Ryali and Kalyan Vasudev Alwala and Haitham Khedr and Andrew Huang and Jie Lei and Tengyu Ma and Baishan Guo and Arpit Kalla and Markus Marks and Joseph Greer and Meng Wang and Peize Sun and Roman R{\"a}dle and Triantafyllos Afouras and Effrosyni Mavroudi and Katherine Xu and Tsung-Han Wu and Yu Zhou and Liliane Momeni and Rishi Hazra and Shuangrui Ding and Sagar Vaze and Francois Porcher and Feng Li and Siyuan Li and Aishwarya Kamath and Ho Kei Cheng and Piotr Doll{\'a}r and Nikhila Ravi and Kate Saenko and Pengchuan Zhang and Christoph Feichtenhofer},
  year          = {2025},
  eprint        = {2511.16719},
  archivePrefix = {arXiv},
  primaryClass  = {cs.CV},
  url           = {https://arxiv.org/abs/2511.16719}
}
Domande frequenti#
SAM 3 è stato rilasciato da Meta il 19 novembre 2025 ed è completamente integrato nel pacchetto
ultralytics, con supporto per la predizione su immagini e il tracciamento video tramite predittori dedicati.Sì. SAM 3 è completamente integrato nel pacchetto Python di Ultralytics e include la segmentazione concettuale, i prompt visivi in stile SAM 2 e il tracciamento video multi-oggetto. SAM 3 e SAM 3.1 alimentano anche la funzionalità di annotazione intelligente su Ultralytics Platform, dove SAM 3.1 è il modello predefinito e puoi annotare immagini con pochi clic. Nei dataset di rilevamento con 1–200 classi, SAM 3 Text e SAM 3.1 Text eseguono anche l'annotazione automatica a partire dai nomi delle classi; la classifica VLM confronta la loro accuratezza con quella dei modelli linguistici visivi.
Sì, per la predizione delle immagini. Carica
sam3.1_multiplex.ptovunque negli esempi di immagini di questa pagina sia usatosam3.pt:SAM("sam3.1_multiplex.pt")per i prompt basati su punti e riquadri, eSAM3SemanticPredictorper i prompt testuali e basati su esempi. Il tracciamento video Object Multiplex non è ancora supportato, quindi continua a usaresam3.ptcon i predittori video. Consulta SAM 3.1 per i benchmark di Meta.PCS è un nuovo task introdotto in SAM 3 che segmenta tutte le istanze di un concetto visivo in un'immagine o in un video. A differenza della segmentazione tradizionale, che ha come obiettivo una specifica istanza di oggetto, PCS individua ogni occorrenza di una categoria. Ad esempio:
- Prompt testuale: "autobus scolastico giallo" → segmenta tutti gli autobus scolastici gialli nella scena
- Esempio di immagine: riquadro attorno a un cane → segmenta tutti i cani nell'immagine
- Combinazione: «gatto tigrato» + riquadro di esempio → segmenta tutti i gatti tigrati simili all'esempio
Caratteristica SAM 2 SAM 3 Attività Un singolo oggetto per prompt Tutte le istanze di un concetto Tipi di prompt Punti, riquadri, maschere + Frasi di testo, immagini di esempio Capacità di rilevamento Richiede un rilevatore esterno Rilevatore integrato a vocabolario aperto Riconoscimento Basato solo sulla geometria Riconoscimento testuale e visivo Architettura Solo tracker Rilevatore + tracker con testa di presenza Prestazioni zero-shot N/D (richiede prompt visivi) 47,0 AP su LVIS, prestazioni 2× superiori su SA-Co Raffinamento interattivo Solo clic Clic + generalizzazione basata su esempi SAM 3 mantiene la compatibilità con i prompt visivi di SAM 2, aggiungendo al contempo funzionalità basate sui concetti.
SAM 3 è addestrato sul dataset Segment Anything con concetti (SA-Co):
Dati di addestramento:
- 5,2 M di immagini con 4 M di sintagmi nominali univoci (SA-Co/HQ) - annotazioni umane di alta qualità
- 52,5 K di video con 24,8 K di sintagmi nominali univoci (SA-Co/VIDEO)
- 1,4 miliardi di maschere sintetiche per 38 M di sintagmi nominali (SA-Co/SYN)
- 15 dataset esterni arricchiti con esempi negativi difficili (SA-Co/EXT)
Dati di benchmark:
- 214 K di concetti univoci in 126 K di immagini/video
- 50× più concetti rispetto ai benchmark esistenti (ad es., LVIS contiene ~4 K di concetti)
- Tripla annotazione su SA-Co/Gold per misurare i limiti delle prestazioni umane
Questa scala e varietà sono alla base della generalizzazione zero-shot di SAM 3 tra concetti a vocabolario aperto.
SAM 3 e YOLO26 rispondono a esigenze diverse:
Vantaggi di SAM 3:
- Vocabolario aperto: segmenta qualsiasi concetto tramite prompt testuali, senza addestramento
- Zero-shot: funziona subito con nuove categorie
- Interattivo: il perfezionamento basato su esempi si generalizza a oggetti simili
- Basato sui concetti: individua automaticamente tutte le istanze di una categoria
- Precisione: 47,0 AP nella segmentazione zero-shot delle istanze su LVIS
Vantaggi di YOLO26:
- Velocità: inferenza di ordini di grandezza più rapida, con una testa end-to-end opzionale senza NMS
- Efficienza: modelli 539× più piccoli (6,4 MB contro 3,45 GB)
- Adatto a risorse limitate: funziona su dispositivi edge e mobili
- In tempo reale: ottimizzato per le distribuzioni in produzione
Consiglio:
- Usa SAM 3 per una segmentazione flessibile a vocabolario aperto, quando devi individuare tutte le istanze dei concetti descritti tramite testo o esempi
- Usa YOLO26 per distribuzioni in produzione ad alta velocità, quando le categorie sono note in anticipo
- Usa SAM 2 per la segmentazione interattiva di singoli oggetti con prompt geometrici
SAM 3 è progettato per sintagmi nominali semplici (ad es., «mela rossa», «persona con cappello»). Per query complesse che richiedono ragionamento, combina SAM 3 con un MLLM come SAM 3 Agent:
Query semplici (SAM 3 nativo):
- «scuolabus giallo»
- «gatto tigrato»
- «persona con cappello rosso»
Query complesse (SAM 3 Agent con MLLM):
- «Persone sedute che non tengono una scatola regalo»
- «Il cane più vicino alla videocamera senza collare»
- "Oggetti rossi più grandi della mano della persona"
SAM 3 Agent ottiene 76,0 gIoU sul set di validazione di ReasonSeg (contro il precedente risultato migliore di 65,0, con un miglioramento del +16,9%), combinando la segmentazione di SAM 3 con le capacità di ragionamento degli MLLM.
Sul benchmark SA-Co/Gold con tripla annotazione umana:
- Limite inferiore umano: 74,2 CGF1 (annotatore più prudente)
- Prestazioni di SAM 3: 65,0 CGF1
- Risultato: 88% del limite inferiore umano stimato
- Limite superiore umano: 81,4 CGF1 (annotatore più permissivo)
SAM 3 ottiene prestazioni elevate, avvicinandosi alla precisione umana nella segmentazione di concetti a vocabolario aperto; il divario riguarda soprattutto i concetti ambigui o soggettivi (ad es., «finestra piccola», «stanza accogliente»).


Commenti105
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.
 Glenn JocherUltralytics(modificato)
SAM 3 looks like a big step forward for open-vocabulary segmentation, and it is now supported natively in
ultralytics. This page covers text, exemplar and video prompts; thesam3.ptweights are gated and must be requested from Meta on Hugging Face first.Feel free to drop questions or comments for the team below!
7koolfox
Incredible, when you think it’s available for use?
2- Glenn JocherUltralytics(modificato)
SAM 3 is available now in
ultralytics: runpip install -U ultralyticsand see this page for usage. Thesam3.ptweights must be requested from Meta first. Abdulhady-WITCo
Appreciate the effort, and can't wait for your implementation. It's resource heavy already but I'm sure your optimisation will make a difference. Best of luck.
- Glenn JocherUltralytics(modificato)
Thanks for the kind words—most of the credit goes to the Meta SAM team and the Ultralytics community. SAM 3 is now available in
ultralytics, and this page covers exactly those trade-offs, so you can balance its open-vocabulary power against lighter options like YOLO26 or SAM 2 on your hardware.
mishaogui
sam3如何把預訓練模型導出onnx進行推理,目前官方好像還不支持導出,求導出和推理。
1- Glenn JocherUltralytics(modificato)
目前
ultralytics里 SAM 3 只支持predict/track推理,还没有提供把sam3.pt导出 ONNX 的官方流程(yolo export主要面向 YOLO 等可部署导出管线的模型);建议先按 SAM 3 使用文档 用 PyTorch 方式部署推理。如果你的目标是 ONNX 部署分割(固定类别/已知类别),更推荐直接用可导出的 YOLO26 分割 并参考 Export 模式;若你这边是“必须 SAM3→ONNX”的需求,麻烦在 Ultralytics 新建 Issue 说明场景并附上
yolo checks和最小复现脚本,方便我们评估支持路径。
tomer196
Hi, thanks for the great work. I am trying to use sam3.1. Is it supported? I tried using sam3.1 weights, and it seems to work, but each frame the objects get new IDs. Am I doing something wrong? Thanks
- Glenn JocherUltralytics(modificato)
SAM 3.1 is supported for image prediction: load
sam3.1_multiplex.ptwherever the image examples usesam3.pt(SAM("sam3.1_multiplex.pt")for point and box prompts,SAM3SemanticPredictorfor text and exemplar prompts). Object Multiplex video tracking is not supported yet, so usesam3.ptwithSAM3VideoPredictororSAM3VideoSemanticPredictor. For stable identities across frames, run a video predictor on the full video rather than image inference frame-by-frame, since per-frame inference assigns fresh IDs each time. See the SAM 3 docs and the SAM predictor reference, and if you’re already doing that please drop a minimal repro plusyolo checksoutput here so the team can take a closer look.
yccckid
你好,我测试下来输入的常见的类别的提示词(包括一些限定词)都是可以分割的。不过提示词输入得越多确实MLLM时间会更长,sam分割倒是挺快的。你说的这个“ 只有在单点(正负样本)和掩码提示(精细化粗糙掩码)是会出现分割源码出现零碎和空洞现象 ”是在分割什么物体?物体的表面纹理是不是比较sparsely textured?怎么解决的?谢谢
On Thu, 23 Apr 2026 at 09:11, Yiwang2333 @.***> wrote:
我之前使用MLLM与SAM3结合起来成为SAM 3 Agent进行测试并没有发现分割的掩码出现空洞问题,他们都是完整的,只不过会出现分割不了提示词中的内容,而且耗时这方面会增加,这也正常。只有在单点(正负样本)和掩码提示(精细化粗糙掩码)是会出现分割源码出现零碎和空洞现象
— Reply to this email directly, view it on GitHub https://github.com/orgs/ultralytics/discussions/22441?email_source=notifications&email_token=APKLLPPMDYK4F36HG6B3BOL4XFUUJA5CNFSNUABIM5UWIORPF5TWS5BNNB2WEL2ENFZWG5LTONUW63SDN5WW2ZLOOQXTCNRWG43TCMBVUZZGKYLTN5XKOY3PNVWWK3TUUVSXMZLOOSWGM33PORSXEX3DNRUWG2Y#discussioncomment-16677105, or unsubscribe https://github.com/notifications/unsubscribe-auth/APKLLPKUZ2OAWS3Y672TETD4XFUUJAVCNFSM6AAAAACJTVH7HGVHI2DSMVQWIX3LMV43URDJONRXK43TNFXW4Q3PNVWWK3TUHMYTMNRXG4YTANI . You are receiving this because you commented.Message ID: @.*** com>
- Glenn JocherUltralytics
这种情况更像是
SAM("sam3.pt")的视觉提示分割问题而不是概念分割本身:单点或粗掩码在细长边界、低对比度或稀疏纹理目标上更容易出现碎片和空洞,通常可通过增加正负点、改用更紧的框提示,或直接用SAM3SemanticPredictor做文本/示例提示来改善,相关用法见 SAM 3 文档;如果你愿意,也欢迎把一张示例图和最小复现代码直接发在这个讨论里,我们可以按你的具体 case 看看。 Yiwang2333
其实我也想把示例和代码文件展示出来,但是可能我太蠢了不知道怎么发在这个讨论中,我已急哭😭
- Glenn JocherUltralytics
没关系,直接发在这里就可以:图片可直接拖到评论框上传,代码按 GitHub Markdown 写法 用代码块贴出;如果文件太大,就先发一个最小复现示例,只保留
model初始化、输入图像、提示词和实际输出即可,例如:from ultralytics import SAM model = SAM("sam3.pt") results = model.predict("test.jpg", points=[900, 370], labels=[1]) print(results[0].masks.data.shape if results[0].masks is not None else None)如果暂时不方便传图,也可以先把异常现象和文字版输出贴出来,我们继续帮你看。
一、单点分割 import numpy as np import torch from PIL import Image from sam3.model_builder import build_sam3_image_model from sam3.model.sam3_image_processor import Sam3Processor
device = "cuda" if torch.cuda.is_available() else "cpu" sam3_pt_path = "sam3_model/sam3.pt"
model = build_sam3_image_model( bpe_path=None, checkpoint_path=sam3_pt_path, device=device, enable_inst_interactivity=True, load_from_HF=False, ) processor = Sam3Processor(model) model.eval()
pil_image = Image.open("test.jpg").convert("RGB") inference_state = processor.set_image(pil_image)
正样本(1) + 负样本(0),点数与标签一一对应
point_coords = np.array([ [900.0, 370.0], # 前景点:点在目标上 [800.0, 400.0], # 背景点:点在要排除的区域 ]) point_labels = np.array([1, 0])
masks, scores, logits = model.predict_inst( inference_state, point_coords=point_coords, point_labels=point_labels, multimask_output=True, ) best = masks[int(np.argmax(scores))] mask_np = best.cpu().numpy() if isinstance(best, torch.Tensor) else np.asarray(best) print(mask_np.shape)
二、交互式细化 import numpy as np import torch from PIL import Image from sam3.model_builder import build_sam3_image_model from sam3.model.sam3_image_processor import Sam3Processor
device = "cuda" if torch.cuda.is_available() else "cpu" sam3_pt_path = "sam3_model/sam3.pt"
model = build_sam3_image_model( bpe_path=None, checkpoint_path=sam3_pt_path, device=device, enable_inst_interactivity=True, load_from_HF=False, ) processor = Sam3Processor(model) model.eval()
pil_image = Image.open("test.jpg").convert("RGB") inference_state = processor.set_image(pil_image)
若需要文本提示(与 demo 一致):
inference_state = processor.set_text_prompt(state=inference_state, prompt="your english prompt")
init_x = 900.0 init_y = 370.0 refinement_points = [[910.0, 380.0], [920.0, 360.0]] refinement_labels = [1, 0]
all_points = [[init_x, init_y]] + refinement_points all_labels = [1] + refinement_labels
masks, scores, logits = model.predict_inst( inference_state, point_coords=np.array(all_points), point_labels=np.array(all_labels), multimask_output=True, ) best = masks[int(np.argmax(scores))] mask_np = best.cpu().numpy() if isinstance(best, torch.Tensor) else np.asarray(best) print(mask_np.shape)
测试使用的是同一张图片,分割的内容是图中汽车,在单点分割和交互式细化中正负样本点结合使用会出现分割车辆边缘出现参差不齐零碎现象
- Glenn JocherUltralytics
感谢把代码贴出来,这更像是交互式点提示的行为而不是“汽车”这个类别本身:车窗反光、轮胎空隙和细长边界会让负点一旦靠近车身就容易把掩码边缘切碎或挖空,而且
multimask_output=True返回的最高分候选也不一定是最平滑的那个;建议先把负点移到目标外更远的位置、在断裂边缘补几个正点,或直接改用框/示例提示,如果你的目标是稳定分割整辆车,SAM3SemanticPredictor的文本/示例提示通常比稀疏点提示更稳,相关接口可参考 SAM 3 文档里的视觉提示与概念分割说明。 感谢您的回答,我还有一个问题,就是文本提示分割时,文本提示词可以对多张图片起作用,能做输入一个文本可以对所有图片进行分割,这一个功能已经实现。 但是有一个我实在是难以实现,就是比如有多张图片A、B、C、D...,在纯框选示例提示分割下,能不能做到只在A图上进行框选,然后进行纯框选示例提示分割时可以对A、B、C、D...多张图片进行分割呢。也就是实现一批图片中,只在一张图片上进行框选就能进行所有图片的分割,类似于图片搜索一样,在一批图片中随机挑一张图片,在这张挑选的图片中框选出汽车然后所有图片中的汽车都能被分割出来(类似在一批图片中框选后搜索出有汽车的图片进行分割)。我不知道这个功能是否能做到。 目前我使用的方法是在框选时将框选的目标进行切块,然后拼接在每一张待搜索图片上,最后根据拼接图片中的小目标切块进行示例提示分割,来实现一张图中框选能对所有图片进行分割,不过这种方法的效果有些一般,有时候分割不到东西或者是遗漏一些需要分割的目标。 还有一种方法是评论区向我提供的思路,将几何特征缓存下来,然后再另一张图片上应用这个几何特征,参考https://github.com/leon0514/trt-sam3,但是这位先生也提到了效果不好,目前我也正在尝试实现这种方法。 或者是理解在单图时框选示例提示分割到底在做什么,然后将这个行为重复作用于其他图片,这样是否也能实现呢?
- Glenn JocherUltralytics
目前原生
SAM3SemanticPredictor还不支持“在 A 图框一次,然后直接对 B/C/D 这类独立图片做纯示例检索+分割”;bboxes示例提示是作用在当前set_image()的那张图上,而文档里的inference_features()也是复用同一张图的特征、不是跨图迁移,所以更可靠的做法还是先用文本提示或检索/检测筛出候选图,再逐张做 SAM 3 分割,接口细节可参考 SAM3SemanticPredictor 参考。 好的,谢谢您的回复
shspc
ultralytics支持从其他图像中抽取特征作为视觉提示吗
在SAM3中
- Glenn JocherUltralytics
目前公开接口里,SAM 3 支持用
SAM3SemanticPredictor的bboxes做 exemplar 式视觉提示,也支持用inference_features()复用已提取特征,但文档里的用法主要是对当前图像做特征复用,不是直接把“另一张图像”的特征当作 prompt 传入;你可以先参考 SAM 3 文档 和 predictor API,如果你的目标是跨图像 exemplar prompting,欢迎把最小复现流程贴在这里,团队会继续看。 aoaoy288-oss
想知道,sam3是否能导成ONNX等格式
ZePequeno25
gostei bastante da para integrar diferentes modelos
SWTZJD
想请问SAM3最低支持的python版本和pytorch版本
- Glenn JocherUltralytics
欢迎直接把环境信息贴在这里,团队会看到;按目前公开信息,
SAM 3自ultralytics>=8.3.237起已集成,而ultralytics的基础要求是 Python>=3.8、PyTorch>=1.8,所以SAM 3目前至少按这组版本起步,参考 SAM 3 文档 和 Ultralytics PyPI 安装说明。 (docs.ultralytics.com)
cyt1990cyt1990-dev
运行环境为:Ultralytics 8.4.21 Python-3.11.8 torch-2.5.1+cu121 CUDA:0 (NVIDIA GeForce RTX 4070, 12282MiB) 运行使用掩码提示的概念分割的示例程序报错如下:WARNING imgsz=[640] must be multiple of max stride 14, updating to [644] Traceback (most recent call last): File "C:\Users\admin\PycharmProjects\PythonProject\testMasks.py", line 12, in results = predictor(source=img_path, masks=[rough]) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\engine\predictor.py", line 225, in call return list(self.stream_inference(source, model, *args, **kwargs)) # merge list of Results into one ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\utils_contextlib.py", line 36, in generator_context response = gen.send(None) ^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\engine\predictor.py", line 330, in stream_inference preds = self.inference(im, *args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 205, in inference return self.prompt_inference(im, bboxes, points, labels, masks, multimask_output) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 236, in prompt_inference return self._inference_features(features, *prompts, multimask_output) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 814, in _inference_features pred_masks, pred_scores, _, _ = self.model.sam_mask_decoder( ^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\nn\modules\module.py", line 1736, in _wrapped_call_impl return self._call_impl(*args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\nn\modules\module.py", line 1747, in _call_impl return forward_call(*args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\modules\decoders.py", line 334, in forward masks, iou_pred, mask_tokens_out, object_score_logits = self.predict_masks( ^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\modules\decoders.py", line 398, in predict_masks src = src + dense_prompt_embeddings ~~~~^~~~~~~~~~~~~~~~~~~~~~~~~ RuntimeError: The size of tensor a (46) must match the size of tensor b (161) at non-singleton dimension 3
运行代码如下所示: import cv2 import numpy as np from ultralytics.models.sam import SAM3Predictor
predictor = SAM3Predictor(overrides=dict(task="segment", mode="predict", model="sam/sam3.pt")) img_path = "测试图片/测试图片1/Out.jpg" rough = cv2.imread("测试图片/测试图片1/rough.jpg", cv2.IMREAD_GRAYSCALE) rough = (rough > 0).astype(np.uint8)
results = predictor(source=img_path, masks=[rough]) for result in results: annotated_img = result.plot() cv2.imshow("SAM with Mask Prompt", annotated_img) cv2.waitKey(0) cv2.destroyAllWindows()
图片Out.jpg,rough.jpg是大小为4024*3036,位深度为8的灰度图片
- Glenn JocherUltralytics
感谢补充代码,这个报错看起来不是图片分辨率本身的问题,而是
SAM3Predictor走masks=提示时出现了特征尺寸不匹配;按 SAM 3 文档 当前概念分割应使用SAM3SemanticPredictor配合text或示例bboxes,而SAM("sam3.pt")/SAM3Predictor主要是单对象视觉提示流程。若你在最新版本下仍需要masks提示,请新开一个 issue 并附上yolo checks输出、完整文本回溯和最小可复现脚本,方便我们确认这是否是 SAM 3 的一个 bug。
max-dev-14
I'd compared facebook/sam3 and ultralytics/sam3. I set up both the models for inference as follow: imgsz=1008, half=True, conf=0.5 and prompts = [ "person", "car", "truck", "tractor", "building", "combine harvester", "power lines", "clear sky", "trees", "crop field", "harvested field", "grassy field", "dark frame edges", "farm lane", "windrow" ] I'd attached scripts I used for inference: ul-sam3.py - ultralytics/sam3 inference. fb-sam3.py - facebook/sam3 inference.
I expected that there would be the same results of inference on the same videos and paramteres above. But I'd got different segments, as it can be seen on the screens below (there are original frame to the left, facebook/sam3 segmentation on the middle and ultralytics/sam3 segmentation to the right).
Can someone explain me why it's happened like this?
- Glenn JocherUltralytics
Thanks for raising it here — exact parity with
facebookresearch/sam3isn’t expected, because the Ultralytics integration uses its own SAM 3 predictor path for resizing/preprocessing and postprocessing, so matchingimgsz,half,conf, and prompts alone won’t guarantee identical masks; see the SAM 3 docs and the predictor reference. If you’d like us to check whether this is a bug rather than an implementation difference, please open a new issue with a minimal reproducible example, confirm both runs use the samesam3.pt, and includeyolo checksplus the full text outputs from both scripts.