機械学習のベストプラクティスとモデルのトレーニングに関するヒント
はじめに#
コンピュータービジョンプロジェクトで最も重要なステップの1つが、モデルのトレーニングです。このステップに進む前に、目標を定義し、データを収集してアノテーションを付与する必要があります。データを前処理してクリーンで一貫性のある状態にしたら、モデルのトレーニングに進めます。
モデルのトレーニングとは、データから視覚的なパターンを認識して予測を行うようモデルに学習させるプロセスであり、アプリケーションの精度に直接影響します。このガイドでは、コンピュータービジョンモデルを効果的にトレーニングするためのベストプラクティス、最適化手法、トラブルシューティングのヒントを紹介します。
視聴する: モデル学習のヒント | 大規模データセットの扱い方 | バッチサイズ、GPU使用率、混合精度
機械学習モデルをトレーニングする方法#
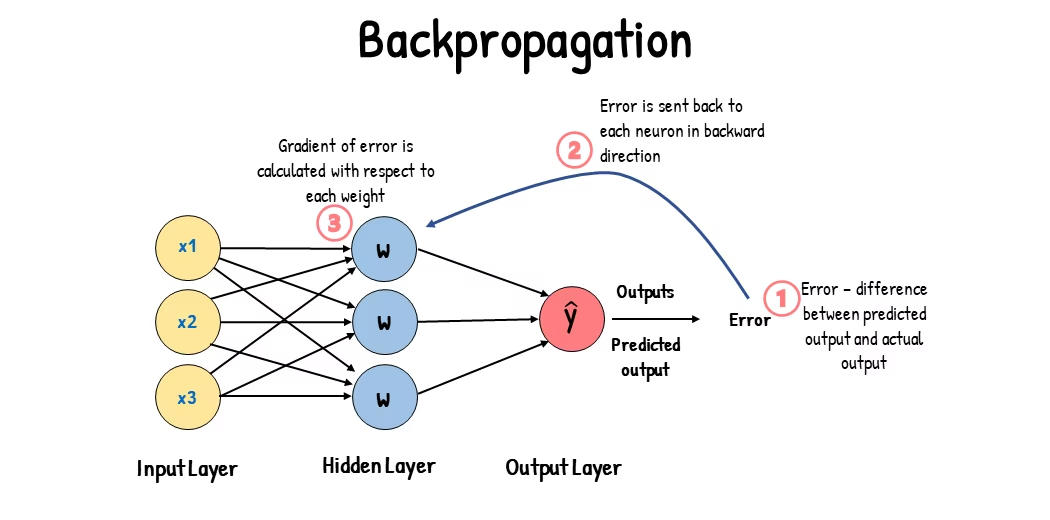
コンピュータービジョンモデルは、内部パラメーターを調整して誤差を最小化することでトレーニングされます。まず、ラベル付き画像の大規模なセットをモデルに入力します。モデルは画像に何が写っているかを予測し、その予測を実際のラベルや内容と比較して誤差を計算します。この誤差から、モデルの予測が正解値からどの程度外れているかが分かります。
トレーニング中、モデルは予測と誤差の計算を繰り返し、誤差逆伝播と呼ばれるプロセスを通じてパラメーターを更新します。このプロセスでは、誤差を減らすためにモデルの内部パラメーター(重みとバイアス)を調整します。このサイクルを何度も繰り返すことで、モデルの精度は徐々に向上します。時間とともに、形状、色、テクスチャなどの複雑なパターンを認識できるようになります。
この学習プロセスにより、コンピュータービジョンモデルは、物体検出、インスタンスセグメンテーション、セマンティックセグメンテーション、画像分類など、さまざまなタスクを実行できます。最終的な目標は、学習内容を未知の新しい画像にも一般化し、現実世界のアプリケーションで視覚データを正確に理解できるモデルを作ることです。
モデルのトレーニングの仕組みが分かったところで、モデルをトレーニングする際に考慮すべき点を見ていきましょう。
大規模データセットでのトレーニング#
大規模データセットを使ってモデルをトレーニングする計画を立てる際には、いくつかの点を考慮する必要があります。たとえば、バッチサイズの調整、GPU使用率の管理、マルチスケールトレーニングの利用などが挙げられます。それぞれの選択肢を詳しく見ていきましょう。
バッチサイズとGPU使用率#
大規模データセットでモデルをトレーニングする際は、GPUを効率よく利用することが重要です。バッチサイズは重要な要素であり、機械学習モデルが1回のトレーニングイテレーションで処理するデータサンプルの数を表します。 GPUが対応する最大バッチサイズを使用すると、GPUの性能を最大限に活用でき、モデルのトレーニング時間を短縮できます。ただし、GPUメモリ不足にならないようにしてください。メモリエラーが発生した場合は、モデルが安定してトレーニングできるようになるまで、バッチサイズを少しずつ小さくしてください。
視聴: バッチ処理でUltralytics YOLO26の推論を2倍高速化する方法 | Python & GPU | MLOps 🚀
YOLO26では、GPUの容量に合わせてTrainモードの引数の batch パラメーターを設定できます。単一のアクセラレーターでは、batch=-1 がモデルのプロファイリングを行い、メモリ使用率が約60%になるようにバッチサイズを選択します。batch=0.70 のような割合を指定すると、異なる使用率を目標にできます。マルチGPUで実行する場合は、デバイス数以上のグローバルバッチサイズを明示的に指定する必要があります。CPUおよびAppleシリコンでは、AutoBatchは警告を表示し、batch=16 にフォールバックします。
サブセットでのトレーニング#
サブセット学習は、より大きなデータセットを代表する小規模なデータでモデルを学習させる実用的な手法です。特に初期のモデル開発やテストで、時間とリソースを節約できます。時間が限られている場合や、さまざまなモデル構成を試す場合に、サブセット学習は有効な選択肢です。
YOLO26では、fractionパラメーターを使用してサブセット学習を実装できます。トレーニングデータの10%を指定するfraction=0.1のような比率、トレーニング画像を正確に300枚にするfraction=300のような整数、または各分割を制限してテスト画像を除外するfraction=[300, 100, 0]のような[train, val, test]リストを使用できます。2項目のリスト([300, 100]など)では、テスト分割は全件のままになります。NDJSONデータセットでは、ダウンロード前に等間隔でレコードを選択するため、再実行しても同じサブセットが使用されます。画像フォルダー形式の分類データセットでも、等間隔でサンプルが選択されます。その他の画像フォルダー形式のデータセットでは、fractionはランダムなサンプルではなく、画像パスをソートした順序で先頭からN枚を選択します。そのため、並び順によって特定のソースやクラスが除外される可能性がある場合は、サブセットを手動でキュレーションしてください。train/val分割を準備する際は、近似重複のグループが複数の分割にまたがらないようにしてください。
マルチスケールトレーニング#
マルチスケールトレーニングは、異なるサイズの画像でモデルをトレーニングし、汎化能力を高める手法です。モデルは異なるスケールや距離にある物体を検出できるようになり、より堅牢になります。
YOLO26の学習時に、scaleパラメーターを設定するとスケール拡張を有効にできます。このパラメーターは、指定した倍率で学習画像のサイズを調整し、異なる距離にある物体をシミュレーションします。たとえば、scale=0.5に設定すると、学習中に学習画像が0.5倍から1.5倍の範囲でランダムに拡大・縮小されます。このパラメーターを設定してさまざまな画像スケールをモデルに学習させることで、多様な物体サイズやシナリオに対する検出能力が向上します。
Ultralyticsは、multi_scaleパラメーターによる画像サイズのマルチスケールトレーニングにも対応しています。画像をズームしてからimgszに合わせてパディングまたはクロップするscaleとは異なり、multi_scaleは各バッチでimgsz自体を変更します(モデルのストライドに合わせて丸められます)。たとえば、imgsz=640とmulti_scale=0.25を指定すると、トレーニングサイズはストライド単位で480から800までサンプリングされます(例:480、512、544、...、800)。一方、multi_scale=0.0ではサイズが固定されます。
キャッシュ#
キャッシュは、機械学習モデルのトレーニング効率を高める重要な手法です。前処理済み画像をメモリに保存することで、ディスクからデータが読み込まれるのをGPUが待つ時間を短縮できます。これにより、ディスクI/O処理による遅延なく、モデルにデータを継続的に供給できます。
YOLO26のトレーニング時には、cacheパラメーターでキャッシュを制御できます。
cache=True:データセット画像をRAMに保存します。メモリ使用量は増加しますが、最も高速にアクセスできます。cache='disk':画像をディスクに保存します。RAMより遅いものの、データを毎回新たに読み込むより高速です。cache=False:キャッシュを無効にし、ディスクI/Oのみに依存します。最も低速な方法です。
混合精度トレーニング#
混合精度学習では、16ビット(FP16)と32ビット(FP32)の浮動小数点型を併用します。FP16は計算を高速化し、FP32は必要な箇所の精度を維持します。計算速度の向上とメモリ使用量の削減のため、ニューラルネットワークの演算の大半はFP16で行われます。一方、重み更新時の精度を確保するため、モデルの重みのマスターコピーはFP32で保持されます。同じハードウェア制約の範囲内で、より大きなモデルやバッチサイズを扱えます。
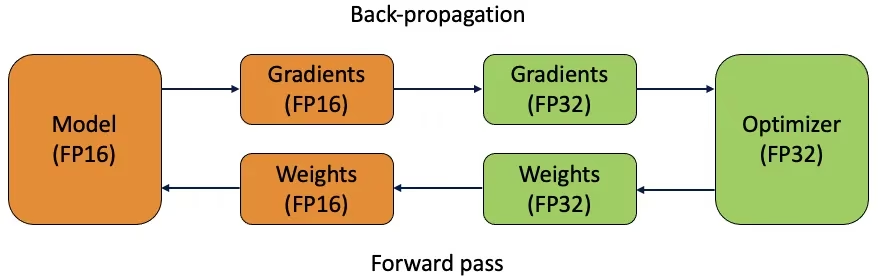
混合精度トレーニングを実装するには、トレーニングスクリプトを変更し、GPUなどのハードウェアが対応していることを確認する必要があります。PyTorchやTensorFlowなど、多くの最新のディープラーニングフレームワークは、混合精度に標準で対応しています。
YOLO26では、混合精度学習を簡単に利用できます。AMPはデフォルトですでに有効です(amp=True)。CUDA GPUでは、YOLOは学習開始時に一度だけ機能を確認し、確認に失敗した場合は完全なFP32に切り替えます。CPUとAppleシリコンではAMPは完全にスキップされます。FP32を強制するにはamp=Falseを、対応GPUでbfloat16を使って学習するにはamp="bf16"を設定してください。
事前学習済み重み#
事前学習済み重みの使用は、モデルの学習プロセスを高速化する効果的な方法です。事前学習済み重みは大規模なデータセットで学習済みのモデルから得られるため、モデルの学習を有利な状態から始められます。転移学習では、事前学習済みモデルを新しい関連タスクに適応させます。事前学習済みモデルのファインチューニングでは、これらの重みを使って学習を始め、対象のデータセットで学習を続けます。モデルが基本的な特徴を十分に理解した状態から始められるため、学習時間が短縮され、多くの場合、性能も向上します。
事前学習済みの重みはmodel引数から取得されるため、model=yolo26n.ptはすでにCOCOの重みから学習を開始します。pretrainedパラメーターでは、重みを維持する(デフォルトのTrue)、破棄する(False)、または別のチェックポイントに置き換える(pretrained=path/to/best.pt)かを制御します。*.yamlモデルでpretrained=Trueを設定しても、それだけで重みが取得されるわけではありません。転移学習のワークフロー全体については、カスタムデータセットでYOLOをファインチューニングする方法を参照してください。
大規模データセットを扱う際に検討すべきその他の手法#
大規模データセットを扱う際には、ほかにもいくつか検討すべき手法があります。
- 学習率スケジューラー:学習率スケジューラーを導入すると、トレーニング中に学習率が動的に調整されます。学習率を適切に調整すると、モデルが最小値を通り越すのを防ぎ、安定性を高められます。YOLO26のトレーニングでは、
lrfパラメーターを使い、初期学習率に対する割合として最終学習率を設定することで、学習率のスケジューリングを管理できます。層ごとの学習率や勾配クリッピングなど、引数で設定できない動作を変更するには、トレーナーをサブクラス化してください。 - 分散学習: 大規模なデータセットを扱う際、複数のGPUまたはマシンに処理を分散することで学習時間を短縮できます。この手法は、豊富な計算リソースを活用する大規模なエンタープライズプロジェクトで特に有効です。
- channels-lastメモリ形式: NVIDIA CUDAでのトレーニングでは、Windowsを除き、PyTorch 1.11以降で高速なNHWCメモリレイアウトが自動的に使用されます。Windowsでは速度が低下することが測定されています。AMD ROCmでのトレーニングではNCHWが維持され、こちらのほうが高速であることが測定されています。
channels_last=Trueを設定すると強制的に有効にでき、channels_last=Falseを設定するとNCHWを維持できます。PyTorch 1.10以前、CPU、MPSでは、デフォルトでNCHWが維持されます。
トレーニングするエポック数#
モデルのトレーニングにおけるエポックとは、トレーニングデータセット全体を1回処理することです。1エポック中にモデルはトレーニングセットの各サンプルを1回処理し、学習アルゴリズムに基づいてパラメーターを更新します。モデルが時間をかけて学習し、パラメーターを調整できるよう、通常は複数のエポックが必要です。
よくある質問の1つに、モデルのトレーニングでエポック数をどのように決めるかがあります。まずは300エポックから始めるとよいでしょう。モデルが早期に過学習する場合は、エポック数を減らしてください。300エポック後も過学習が起きない場合は、600、1200、またはそれ以上にトレーニングを延長できます。
ただし、最適なエポック数はデータセットのサイズやプロジェクトの目標によって異なります。大規模なデータセットではモデルが効果的に学習するためにより多くのエポックが必要になる一方、小規模なデータセットでは過学習を避けるために少なくする必要がある場合があります。YOLO26では、トレーニングスクリプトでepochsパラメーターを設定できます。
早期停止#
早期停止は、モデルのトレーニングを最適化するための有効な手法です。検証性能を監視し、モデルの改善が止まった時点でトレーニングを終了できます。これにより、計算リソースを節約し、過学習を防げます。
この手法では、検証メトリクスが改善するまで何エポック待ってからトレーニングを停止するかを、patienceパラメーターで設定します。この期間内にモデルの性能が改善しなければ、時間とリソースの浪費を避けるためにトレーニングを停止します。
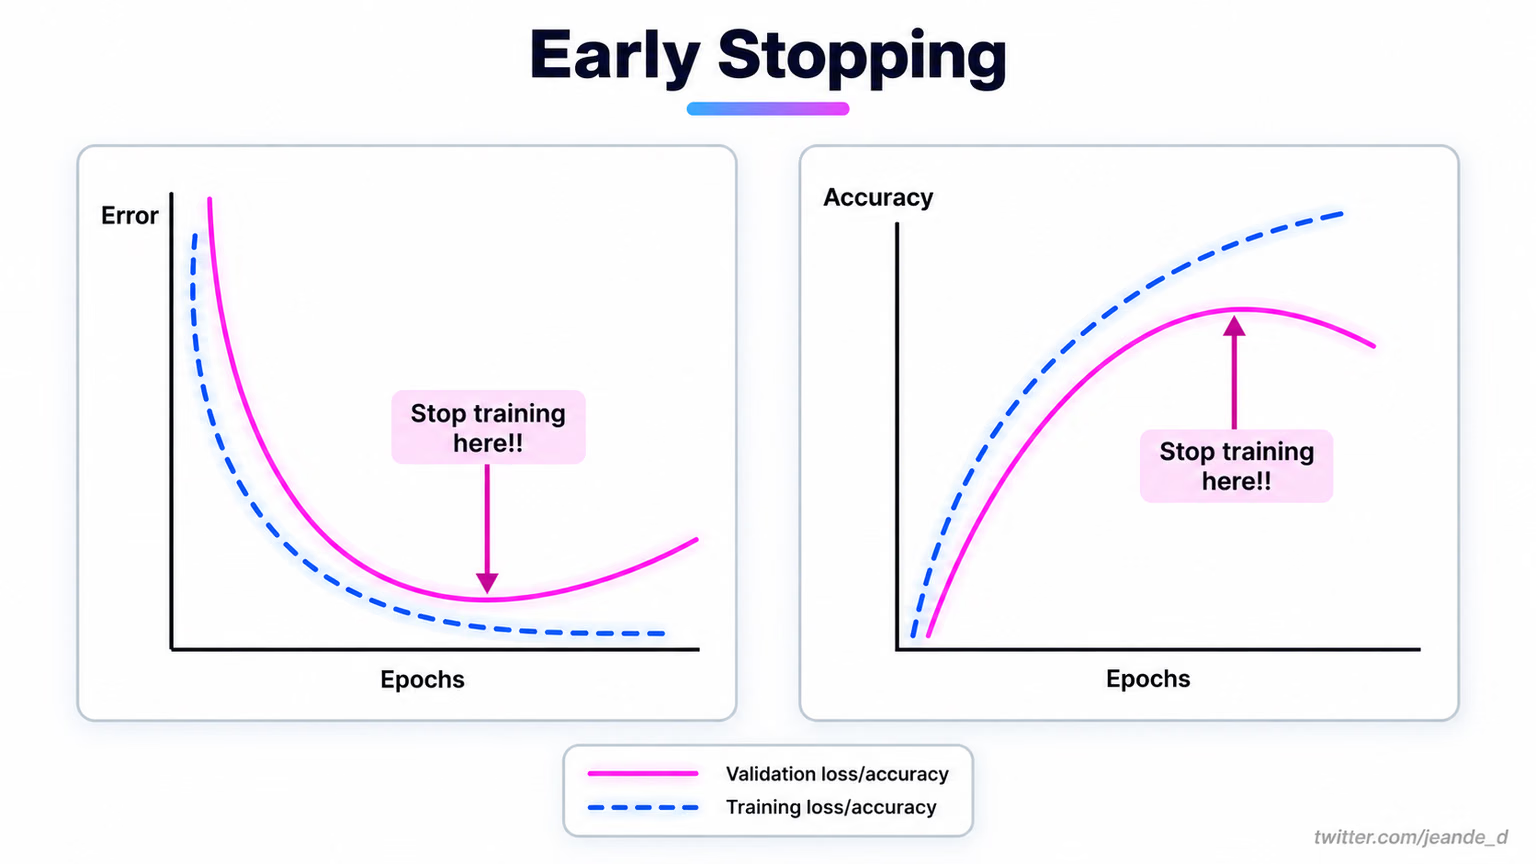
YOLO26では、学習設定のpatienceパラメーターを設定すると早期停止を有効にできます。たとえば、patience=5は、検証指標が5エポック連続で改善しない場合に学習を停止することを意味します。これにより、学習を効率化し、不要な計算を避けられます。
クラウドトレーニングとローカルトレーニングの選択#
モデルをトレーニングする方法には、クラウドトレーニングとローカルトレーニングの2つがあります。
クラウド学習はスケーラビリティと高性能なハードウェアを利用できるため、大規模なデータセットや複雑なモデルの処理に適しています。Google Cloud、AWS、Azureなどのプラットフォームでは、高性能なGPUやTPUをオンデマンドで利用できるため、学習時間を短縮し、より大きなモデルを使った実験が可能になります。Ultralytics Platformでも、YOLOモデル向けのマネージドクラウド学習を利用できます。ただし、クラウド学習は、特に長期間利用する場合にコストが高くなる可能性があり、データ転送によってコストやレイテンシが増加することもあります。
ローカルトレーニングでは、環境を特定のニーズに合わせて調整し、継続的なクラウドコストを回避できるため、より高度な制御とカスタマイズが可能です。長期的なプロジェクトではコスト効率が高くなる場合があり、データがオンプレミスに留まるため、セキュリティも強化されます。ただし、ローカルハードウェアにはリソース上の制約がある場合があり、メンテナンスも必要になるため、大規模なモデルのトレーニングに時間がかかることがあります。
オプティマイザーの選択#
オプティマイザーは、モデルの性能を測定する損失関数を最小化するために、ニューラルネットワークの重みを調整するアルゴリズムです。簡単に言うと、オプティマイザーはパラメーターを調整して誤差を減らすことで、モデルの学習を支援します。適切なオプティマイザーを選ぶことは、モデルの学習速度と精度に直接影響します。
オプティマイザーのパラメーターを調整して、モデルの性能を向上させることもできます。学習率を調整すると、パラメーター更新時のステップ幅が設定されます。安定性を確保するには、中程度の学習率から始め、長期的な学習を改善するために徐々に下げていく方法があります。また、モメンタムを設定すると、過去の更新が現在の更新に与える影響の大きさが決まります。モメンタムの一般的な値は約0.9で、バランスの取れた設定です。
一般的なオプティマイザー#
オプティマイザーごとに、さまざまな長所と短所があります。ここでは、一般的なオプティマイザーをいくつか紹介します。
-
SGD(確率的勾配降下法):
- 損失関数のパラメーターに対する勾配を使って、モデルのパラメーターを更新します。
- シンプルで効率的ですが、収束が遅くなる場合があり、局所最小値に陥る可能性もあります。
-
Adam(適応モーメント推定):
- モメンタム付きSGDとRMSPropの両方の利点を組み合わせています。
- 勾配の一次モーメントと二次モーメントの推定値に基づいて、各パラメーターの学習率を調整します。
- ノイズの多いデータやスパースな勾配に適しています。
- 効率的で、一般に必要なチューニングが少なくて済みます。短いトレーニングでは、YOLO26の
optimizer=autoにより、Adamそのものではなく、よく似たAdamWが選択されます。
-
RMSProp(二乗平均平方根伝播法):
- 最近の勾配の大きさの移動平均で勾配を割ることにより、各パラメーターの学習率を調整します。
- 勾配消失問題への対処に役立ち、リカレントニューラルネットワークに効果的です。
-
MuSGD(MuonとSGDのハイブリッド):
- SGD形式の更新とMuonに着想を得た動作を組み合わせ、大規模トレーニングの安定性を向上させます。
- SGDのような汎化性能を求めつつ、標準のSGDより滑らかな収束が必要な場合に適しています。
- YOLO26のトレーニングレシピで特に有用です。判断に迷う場合は、
optimizer=autoから始め、データセットでMuSGDと比較してください。
YOLO26では、optimizerパラメーターを使って、SGD、MuSGD、Adam、Adamax、AdamW、NAdam、RAdam、RMSPropなど、さまざまなオプティマイザーを選択できます。または、autoに設定すると、学習イテレーション数に基づいて自動選択できます(短い実行ではAdamW、10,000イテレーションを超える場合はMuSGD)。
yolo train model=yolo26n.pt data=coco8.yaml optimizer=MuSGDコミュニティへの参加#
コンピュータービジョンに関心を持つ人々のコミュニティに参加すると、問題の解決や学習の効率化に役立ちます。交流し、サポートを受け、アイデアを共有する方法をいくつか紹介します。
コミュニティのリソース#
- GitHub Issues: YOLO26のGitHubリポジトリにアクセスし、Issuesタブから質問やバグの報告、新機能の提案を行ってください。コミュニティとメンテナーは活発に活動しており、サポートを提供しています。
- Ultralytics Discordサーバー: Ultralytics Discordサーバーに参加して、ほかのユーザーや開発者と交流し、サポートを受けたり、経験を共有したりできます。
これらのリソースを活用すると、課題を解決し、コンピュータービジョンコミュニティの最新動向や実践的な手法を把握できます。
主なポイント#
コンピュータービジョンモデルの学習では、適切な手法に従い、戦略を最適化し、発生した問題を解決することが重要です。バッチサイズの調整、混合精度学習、事前学習済み重みの利用などの手法により、モデルの性能を高め、学習を高速化できます。サブセット学習や早期停止などの手法は、時間とリソースの節約に役立ちます。コミュニティとのつながりを保ち、新しい動向を把握することで、モデル学習のスキルを継続的に向上できます。
よくある質問#
GPUの使用率を高めるには、GPUがサポートする最大サイズに
batchパラメーターを設定します。単一のアクセラレーターでは、batch=-1がモデルのプロファイリングを行い、メモリ使用率約60%を目標にします。CPUおよびAppleシリコンではbatch=16にフォールバックします。一方、マルチGPUで実行する場合は、デバイス数以上のグローバルバッチサイズを明示的に指定する必要があります。詳しくは、Trainモードの引数をご覧ください。混合精度トレーニングでは、16ビット(FP16)と32ビット(FP32)の浮動小数点型を併用し、計算速度と精度のバランスを取ります。YOLO26では
amp=Trueによってデフォルトで有効になっています。FP32を強制するには、amp=Falseを設定してください。AMPはCPUおよびAppleシリコンではスキップされます。マルチスケールトレーニングでは、さまざまなサイズの画像を使って学習することで、異なるスケールや距離に対するモデルの汎化性能を高めます。YOLO26には、このための独立したパラメーターが2つあります。
scale=0.5は0.5から1.5までのズーム倍率をサンプリングし、固定のimgszに合わせてパディングまたはクロップします。一方、multi_scale=0.25は、ストライド単位で各バッチのimgsz自体を変化させます。設定や詳細については、Trainモードのドキュメントをご覧ください。事前学習済み重みを使うと、基本的な視覚特徴をすでに学習したモデルを活用できるため、トレーニングを大幅に高速化し、モデルの精度を向上させられます。
model引数で読み込みます(例:model=yolo26n.pt)。その後、pretrainedによって、重みを保持する(デフォルトのTrue)、破棄する(False)、または別のチェックポイントに置き換える(pretrained=path/to/best.pt。model=*.yamlビルドに重みを転送する方法)かが決まります。詳しくは、Trainモードのドキュメントをご覧ください。エポック数は、モデルのトレーニング中にトレーニングデータセット全体を処理する回数を指します。一般的な開始値は300エポックです。モデルが早期に過学習する場合は、エポック数を減らせます。過学習が見られない場合は、600、1200、またはそれ以上に延長することもできます。YOLO26で設定するには、トレーニングスクリプトで
epochsパラメーターを使用してください。適切なエポック数の決め方については、エポック数のセクションをご覧ください。


コメント12
質問したり、結果を共有したり、ほかの人をサポートしたりできます。
puzzlemindgames
Hello
I'm working on a browser-based puzzle solver that uses a custom YOLO model to detect visible objects from game screenshots.
Some examples include: Transparent ice/frost overlays on the lower part of objects Semi-transparent cloth or curtain overlays Small decorative objects inside larger objects (for example, keys inside containers) The visible objects are usually detected correctly, but these overlays often cause false negatives or incorrect class predictions.
At the moment I'm considering a few approaches: Training with many more occlusion-heavy examples Splitting the detection into multiple stages instead of one larger model
python results = model.predict( source="level_512.png", conf=0.25, iou=0.45, imgsz=1280 ) for box in results[0].boxes: print(box.cls, box.conf)
For anyone who has trained YOLO models on UI or game screenshots which approach gave you the biggest improvement? Or is there another strategy that tends to work better for partially occluded objects?
I'd really appreciate hearing about real-world experiences before I spend time retraining the dataset.
 Glenn JocherUltralytics
Start with targeted data: add representative occluded examples, keep annotations consistent for partially visible objects, and synthetically composite the actual frost/cloth overlays at realistic opacity and placement. Measure recall per class on a dedicated occlusion-heavy validation split, then tune
mosaic,mixup, orcutmixconservatively; higherimgszor tiled inference can help nested small objects. A multi-stage pipeline is usually worthwhile only if the first stage can reliably isolate containers or overlay regions. Please continue sharing results and questions here so the Ultralytics team and community can see them.1Thanks! I followed your suggestions and added more occluded samples. The main objects/tubes are much more stable as well as the colors now but I'm still struggling with very small objects.
i cant able to attach model training screenshots here for you to review.
For example, tiny keys or tags inside transparent containers are often missed or detected as the wrong class. For context the screenshots come from a puzzle game with objects similar to these shown in sample pictures embedded at product homepage: https://aimagicsortsolver.com/
results = model.predict( source="level.png", imgsz=1280, conf=0.35, iou=0.45 ) Would you recommend keep improving a single model or train a second YOLO model just for these small objects?
- Glenn JocherUltralytics(編集済み)
Keep the single model first: audit tiny-object annotations, add more balanced close-up examples, and test cropped or SAHI tiled inference so keys and tags occupy more pixels; also compare
conf=0.15–0.25, since higher thresholds may suppress weak detections. Train a second specialized model only if the first model reliably detects each container, allowing its crop to be passed to the small-object model at higher effective resolution.1 Thank you for your suggestions. I'll tweak it as per the recommendations.
TSHSLU
What is the minimum Dataset Size required if i use a pretrained model for custom projects. i barely find any sources online which recommend a minimum dataset size.
- Glenn JocherUltralytics
There isn’t a fixed “minimum” dataset size when fine-tuning a pretrained model; if your domain is close to the pretrained data and labels are clean, you can often start getting useful signal with ~50–200 images per class (or a few hundred labeled object instances), but for reliably robust results across different lighting/viewpoints/backgrounds you’ll usually want 500–2000+ images per class with good diversity—one practical way to find your true minimum is to train on a small pilot subset, check validation failures, then add data specifically where the model breaks (the
fractionworkflow in the Model training tips guide helps iterate quickly).from ultralytics import YOLO model = YOLO("yolo26n.pt") model.train(data="data.yaml", epochs=100, fraction=0.1)1
VeeranjaneyuluToka
Hi, I just noticed a thing, looks like the optimizer is getting chosen based on no.of iterations, would you mind telling me the reason for the same? I mean how does iterations matter when we choose optimizer?
Imran-ml
First of all its great to have another powerful model and congratulations. I have fine tuned and trained yolo11x.pt for my custom objects but I'm facing some issues. My images data resolution is around 6000 x 2000 but while trained the model I set the imgsz=(1280, 640). It work well when I adjust the video stream by zoom in-out and detect all my 60 objects well (objects are small) but when there is some zoom or squeezed then it completely dont detect any object or few only.
Please let me know if I'm missing something or I have to do something else? I have labelled the data on my original images so resizing making any issues? any ratio issues? Please guide me properly so I can use this power yolo11 model effectively.
- Glenn JocherUltralytics
@Imran-ml it sounds like the issue might be related to image resizing affecting object detection. Consider enabling multiscale training by adjusting the
scaleparameter to help the model generalize better across different image sizes. This can improve detection performance when objects appear at varying scales. For more detailed guidance, you can refer to our model training tips at https://docs.ultralytics.com/guides/model-training-tips/.
Taufiq-Ahmed
Hi I have a question. I am using Yolov8s for trained a dataset that has four class. fire, smoke, person, animal. all the images has areal view to detect forest fire . In my dataset I have forest fire images from drone so after training it detect fire smoke quite accurately. however, I do not have any dataset that has person or animal in forest fire. so I have to collect some other dataset from roboflow that has person and animal and the n I have merged them with my own dataset ( have changed the label of animal and person accordingly so 0 means smoke, 1 means fire, 2 means person and 3 means animal and also updated the data.yaml file) . this time the problem is it could not detect the animal and person properly some times it can detect them. The main reasons seems to me is that the drone is flying in a high altitude so it does not detect person and animal properly because in the dataset of person and animal the view of the drone is not that much high. is there any technique to solve this problem and detect all the objects as many as possible?
- Glenn JocherUltralytics
@Taufiq-Ahmed it sounds like the altitude difference between your training and test datasets is causing the detection issues. To address this, consider using data augmentation techniques to simulate higher altitude views in your training data. You can also try multiscale training to help the model generalize better across different scales. Additionally, fine-tuning the model with a mix of high-altitude and low-altitude images might improve its performance. For more detailed strategies, you can refer to our model training tips.