BaiduのRT-DETR:Vision Transformerベースのリアルタイムオブジェクト検出器
概要#
Baiduが開発したリアルタイム検出トランスフォーマー(RT-DETR)は、高い精度を維持しながらリアルタイム性能を実現するエンドツーエンドの物体検出器です。NMSを使用しないトランスフォーマーベースの検出フレームワークであるDETRを基盤とし、畳み込みバックボーンと効率的なハイブリッドエンコーダーを追加することで、リアルタイム速度を実現します。RT-DETRは、スケール内の相互作用とスケール間の融合を分離することで、マルチスケール特徴を効率的に処理します。このモデルは高い適応性を備えており、再学習せずに異なるデコーダーレイヤーを使用して推論速度を柔軟に調整できます。RT-DETRは、CUDAとTensorRTなどの高速化バックエンドで最高の性能を発揮します。
視聴: BaiduのRT-DETRでオブジェクト検出を行う方法 | Ultralyticsでの推論とベンチマーク
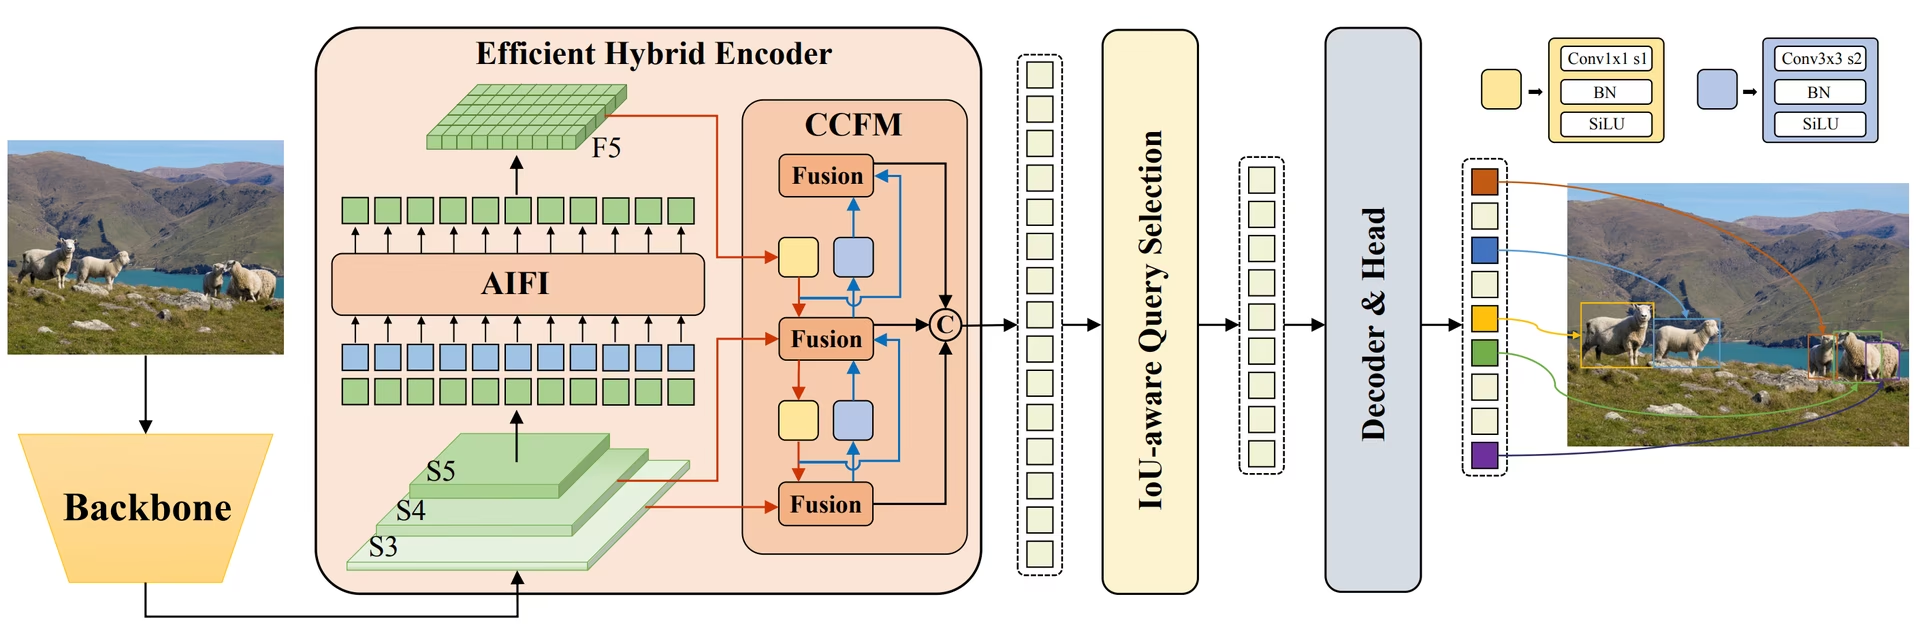 BaiduのRT-DETRの概要。 RT-DETRモデルのアーキテクチャ図では、バックボーンの最後の3つのステージ{S3、S4、S5}がエンコーダーへの入力として示されています。効率的なハイブリッドエンコーダーは、スケール内特徴相互作用(AIFI)とスケール間特徴融合モジュール(CCFM)を通じて、マルチスケール特徴を画像特徴のシーケンスに変換します。IoUを考慮したクエリ選択により、デコーダーの初期オブジェクトクエリとして機能する一定数の画像特徴を選択します。最後に、補助予測ヘッドを備えたデコーダーがオブジェクトクエリを反復的に最適化し、バウンディングボックスと信頼度スコアを生成します(出典)。
主な機能#
- 効率的なハイブリッドエンコーダー: BaiduのRT-DETRは、スケール内の相互作用とスケール間の融合を分離してマルチスケール特徴を処理する、効率的なハイブリッドエンコーダーを使用します。このTransformerベースの設計は計算コストを削減し、リアルタイムのオブジェクト検出を可能にします。
- IoUを考慮したクエリ選択: BaiduのRT-DETRは、IoUを考慮したクエリ選択によって、オブジェクトクエリの初期化を改善します。これにより、シーン内で最も関連性の高いオブジェクトにモデルが注目し、検出精度が向上します。
- 調整可能な推論速度: BaiduのRT-DETRは、再トレーニングすることなく、異なるデコーダーレイヤーを使用して推論速度を柔軟に調整できます。この適応性により、さまざまなリアルタイム物体検出シナリオで実用的に活用できます。
- NMSを使用しないフレームワーク: DETRを基盤とするRT-DETRは、後処理の非最大抑制を不要にし、検出パイプラインを簡素化して効率を高める可能性があります。
- アンカーフリー検出: アンカーフリー検出器であるRT-DETRは、検出プロセスを簡素化し、さまざまなデータセットに対する汎化性能を向上させる可能性があります。
事前学習済みモデル#
Ultralytics Python APIでは、異なるスケールの事前学習済みPaddlePaddle RT-DETRモデルを提供しています。
- RT-DETR-L:COCO val2017で53.0% AP、T4 GPUで114 FPS
- RT-DETR-X:COCO val2017でAP 54.8%、T4 GPUで74 FPS
Baiduは2024年7月にRTDETRv2を公開し、元のアーキテクチャをさらに改善しました。
使用例#
以下の例では、RT-DETRのシンプルな学習と推論を示します。Ultralytics Platformを通じて、クラウドGPUでモデルを学習することもできます。
from ultralytics import RTDETR

# COCOで事前学習済みのRT-DETR-lモデルを読み込みます
model = RTDETR("rtdetr-l.pt")

# モデル情報を表示(任意)
model.info()

# COCO8サンプルデータセットでモデルを100エポック学習する
results = model.train(data="coco8.yaml", epochs=100, imgsz=640)

# 'bus.jpg'画像に対してRT-DETR-lモデルで推論を実行します
results = model("path/to/bus.jpg")PyTorch 2.0以降を使用してCUDA上でRT-DETRをトレーニングする場合は、deterministic=Falseを設定してください。変形可能アテンションではF.grid_sampleを使用しますが、これは決定論的なCUDAバックワード処理に対応していないため、deterministic=Trueを設定しても実行を再現可能にはできず、トレーニングのスループットが低下する場合があります。seedは引き続き、重みの初期化、データの順序、データ拡張のサンプリングを制御します。
RT-DETRの事前学習済み重みでは、再トレーニングせずにレイテンシを削減するため、推論時に2つの設定を利用できます。
eval_idx:デコードを早期に停止します。デフォルトの6層デコーダーでは、0始まりのインデックス(0~5)を使用します。eval_idx=5では全レイヤーを使用し、eval_idx=3では4レイヤーを使用します。TensorRT v10.11を使用するT4 GPUでは、RT-DETR-Lの性能は4レイヤーの場合、8.0 ms / 52.7 mAPから7.4 ms / 52.5 mAPに向上します。num_queries:オブジェクトクエリを減らします(デフォルト:300)。同じ設定で100に減らすと、COCOで7.4 ms / 51.7 mAPを達成できます。1画像あたりのオブジェクト数が少ないデータセットでは、通常mAPの低下は小さくなりますが、値は1画像あたりに想定される最大オブジェクト数を上回るようにしてください。
どちらの設定でもmAPが低下する可能性があるため、デプロイ前にデータセットでトレードオフを検証してください。
from ultralytics import RTDETR

rtdetr = RTDETR("rtdetr-l.pt")
head = rtdetr.model.model[-1]

# 速度と精度のトレードオフを検証したうえで、いずれか一方または両方の設定を選択してください。
head.decoder.eval_idx = 3  # 6層のうち4層のデコーダーレイヤーを使用します。
head.num_queries = 100  # オブジェクトクエリの数を減らします。

results = rtdetr("path/to/image.jpg")

# エクスポートでは、TensorRTへのエクスポートを含め、同じデコーダー設定とクエリ設定が使用されます。
rtdetr.export(format="engine", device=0, quantize=16)サポート対象のタスクとモード#
この表では、モデルの種類、各モデルの事前学習済み重み、対応タスク、および✅で示される対応モード(Train、Val、Predict、Export)を示します。
| モデルタイプ | 事前学習済み重み | サポートされるタスク | トレーニング | 検証 | 推論 | エクスポート |
|---|---|---|---|---|---|---|
| RT-DETR Large | rtdetr-l.pt | 物体検出 | ✅ | ✅ | ✅ | ✅ |
| RT-DETR Extra-Large | rtdetr-x.pt | 物体検出 | ✅ | ✅ | ✅ | ✅ |
rtdetr-resnet50.yamlとrtdetr-resnet101.yamlは、YAMLアーキテクチャのみで提供されています。Ultralyticsが事前学習済み重みをリリースしているのは、rtdetr-lとrtdetr-xのみです。YAMLからResNetの各バリアントをインスタンス化し(例:RTDETR("rtdetr-resnet50.yaml"))、必要に応じてトレーニングまたはファインチューニングしてください。
最適なユースケース#
RT-DETRは、高い精度とリアルタイム性能の両方が求められる用途に特に適しています。
- 自動運転: 速度と精度の両方が重要となる自動運転システムで、信頼性の高い環境認識を実現します。
- 高度なロボティクス: 動的な環境で正確なオブジェクト認識とインタラクションが必要な複雑なタスクをロボットが実行できるようにします。
- 医用画像: オブジェクト検出の精度が診断に不可欠となる医療分野の用途に適しています。
- 監視システム: 高い検出精度によるリアルタイム監視が求められるセキュリティ用途に適しています。セキュリティアラームシステムについて詳しく見る。
- 衛星画像解析: グローバルなコンテキストの理解が重要となる、高解像度画像の詳細な解析に適しています。衛星画像におけるコンピュータービジョンについて読む。
引用と謝辞#
研究または開発でBaiduのRT-DETRを使用する場合は、原著論文を引用してください。
@misc{lv2023detrs,
      title={DETRs Beat YOLOs on Real-time Object Detection},
      author={Wenyu Lv and Shangliang Xu and Yian Zhao and Guanzhong Wang and Jinman Wei and Cheng Cui and Yuning Du and Qingqing Dang and Yi Liu},
      year={2023},
      eprint={2304.08069},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}RTDETRv2については、2024年の論文を引用できます。
@misc{lv2024rtdetrv2,
      title={RT-DETRv2: Improved Baseline with Bag-of-Freebies for Real-Time Detection Transformer},
      author={Wenyu Lv and Yian Zhao and Qinyao Chang and Kui Huang and Guanzhong Wang and Yi Liu},
      year={2024},
      eprint={2407.17140},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}コンピュータビジョンコミュニティにとって貴重なリソースを作成・維持してくださったBaiduとPaddlePaddleチームに感謝します。Transformerベースのリアルタイムオブジェクト検出器RT-DETRの開発に、心より感謝申し上げます。
よくある質問#
BaiduのRT-DETR(リアルタイム物体検出Transformer)は、Transformerベースのリアルタイム物体検出モデルです。効率的なハイブリッドエンコーダーを通じて、スケール内の相互作用とスケール間の融合を分離し、マルチスケール特徴を効率的に処理します。IoUを考慮したクエリ選択により、最も関連性の高い物体に注目し、検出精度を高めます。再トレーニングを行わずにデコーダー層を調整して推論速度を変更できるため、RT-DETRはさまざまなリアルタイム物体検出シナリオに適しています。
Ultralytics Python APIを使用して、事前学習済みPaddlePaddle RT-DETRモデルを読み込みます。たとえば、COCOで事前学習したRT-DETR-lモデルを読み込み、ファインチューニングして推論を実行するには、次のようにします。
例from ultralytics import RTDETR # COCOで事前学習済みのRT-DETR-lモデルを読み込みます model = RTDETR("rtdetr-l.pt") # モデル情報を表示(任意) model.info() # COCO8サンプルデータセットでモデルを100エポック学習する results = model.train(data="coco8.yaml", epochs=100, imgsz=640) # 'bus.jpg'画像に対してRT-DETR-lモデルで推論を実行します results = model("path/to/bus.jpg")BaiduのRT-DETRは、効率的なハイブリッドエンコーダーとIoUを考慮したクエリ選択を組み合わせ、計算コストを抑えながら高い精度を維持します。再学習せずに異なるデコーダーレイヤーを使用して推論速度を調整できるため、柔軟性が高く、CUDAとTensorRTなどの高速化バックエンドを用いるリアルタイムアプリケーションで役立ちます。また、Transformerアーキテクチャは、従来のCNNベースの検出器よりも広範なコンテキストを捉えます。
BaiduのRT-DETRでは、再学習せずに異なるデコーダーレイヤーを使用して推論速度を柔軟に調整できます。これにより、リアルタイムオブジェクト検出タスクで速度と精度のバランスを取れます。デコーダーレイヤーを少なくすると精度がわずかに下がる代わりに処理が高速になり、すべてのレイヤーを使うと最も高精度な検出が得られます。この機能は、計算能力が異なるデバイスにモデルをデプロイする際に特に役立ちます。
いいえ。RT-DETRでは、
max_detによって推論後に返される予測数の上限を設定できますが、デコーダーが生成するオブジェクトクエリの数は増えません。UltralyticsのRT-DETR事前学習済みチェックポイントは300個のオブジェクトクエリを使用するため、max_detにそれより大きな値を設定しても、1画像あたり300件を超える検出結果は返せません。高信頼度の予測結果を少数だけ必要とする場合は、たとえば
max_det=100のようにmax_detを使用して、返される検出結果を減らしてください。データセットに1画像あたり300個を超えるオブジェクトが含まれる可能性がある場合は、モデルYAMLのデコーダークエリ数(nq)を増やしてカスタムRT-DETRモデルをトレーニングしてください。トレーニング後に事前学習済みチェックポイントのこの値を変更しても同等の結果にはならず、追加のクエリを学習するために再トレーニングが必要です。


コメント148
質問したり、結果を共有したり、ほかの人をサポートしたりできます。
PhucPhamSy
Hi all, Could you please let me know how to use all parameters in the appendix of the original paper, "https://arxiv.org/pdf/2304.08069"? Thanks!
1 Glenn JocherUltralytics
Hey there! 👋
We're really glad you're interested in diving deep into the parameters detailed in the original paper. Specifically, for utilizing parameters as mentioned in the RT-DETR paper ("DETRs Beat YOLOs on Real-time Object Detection"), I recommend focusing on the key components such as the Efficient Hybrid Encoder, IoU-aware Query Selection, and adaptability in Inference Speed adjustments that make RT-DETR efficient.
Details on these components can be extrapolated to parameter usage within your model through our Python API. For instance, when initializing the RT-DETR model or adjusting inference speed, you would consider the different scales of pre-trained models available:
from ultralytics import RTDETR

# For a larger model with potentially higher accuracy but lower FPS (Frames Per Second)
model = RTDETR('rtdetr-l.pt')

# For an extra-large model prioritizing accuracy over speed
model_x = RTDETR('rtdetr-x.pt')
Adjustments for inference speed and applying IoU-aware query selection can directly correlate with your focus during the
.train()or.predict()processes, especially understanding what goes behind each configuration setting in these functions.Unfortunately, we don't provide a direct mapping for every parameter mentioned in the appendix to code-level argument settings as the implementation abstracts many complexities for user convenience and to maintain the API's simplicity. However, understanding the RT-DETR's key features and translating that understanding into practical API usage is a great way to leverage the power of RT-DETR. 😊
For more tailored guidance, always feel free to ask or refer to our official documentation for specific examples and deeper insights.
Happy coding! 🚀
 Murat Raimbekov
hey @wba-zzu, thanks for raising this.
quick rundown of where things stand:
resnet50 / resnet101 - the architectures are already shipped as yaml configs:
you can build and train them straight from yaml:
from ultralytics import RTDETR

model = RTDETR("rtdetr-resnet50.yaml")
model.train(data="coco.yaml", epochs=100, imgsz=640)
however, ultralytics does not publish pretrained weights for these. the only official rt-detr checkpoints in the ultralytics/assets releases are
rtdetr-l.ptandrtdetr-x.pt, both of which use the hgnetv2 backbone (not resnet). this is also flagged in the model docs under "architecture-only variants".resnet18 - not shipped. there is no
rtdetr-resnet18.yamlin the repo, so a resnet18 variant would need its own yaml and corresponding modules added.loading external pretrained weights: ultralytics builds the model from yaml, so the state_dict keys follow a pattern like
model.<index>.layer.<...>.conv.weight. weights from another implementation will not load directly - they would need a key-mapping / conversion step to match this layout.hope this helps!
 Boao Wang
想要将原版RT-DETR中的ResNet50和ResNet18以及ResNet101完全移植到Ultralytics,并且获得其预训练模型
995742853
您好,我想请问一下,在哪里有基于rtdetr-resnet50的预训练pt权重,我知道看到rtdetr-l以及x的预训练权重
- Glenn JocherUltralytics
目前 RT-DETR 文档 里公开提供的 Ultralytics 预训练权重只有
rtdetr-l.pt和rtdetr-x.pt;如果你找的是 ResNet50 版本,建议查看 Baidu 官方的 RT-DETR PyTorch 权重列表,其中提供的是rtdetr_r50vd_*.pth,不是 Ultralytics 直接发布的rtdetr-resnet50.pt,也欢迎直接在这里继续提问,方便 Ultralytics 团队跟进。 (docs.ultralytics.com) 谢谢您的回复
maitianstudio-arch
How to use RT-DETRv2?
- Glenn JocherUltralytics
Ultralytics currently exposes the original RT-DETR pretrained weights (
rtdetr-l.pt,rtdetr-x.pt) via theRTDETRAPI; RT-DETRv2 pretrained weights/configs aren’t packaged inultralyticsyet, so if you share what RT-DETRv2 checkpoint you have (Paddle vs PyTorch) and how you’re trying to run it, we can point you to the right conversion/workflow—meanwhile you can use RT-DETR as shown in the RT-DETR docs.from ultralytics import RTDETR model = RTDETR("rtdetr-l.pt") results = model("path/to/image.jpg")
fxc0627
你好,请问RE-DETR模型适用于小目标工业缺陷检测吗?对于小目标检测有什么天然的优势?
wang18382140151-hub
你好,最近deim,dfine等对于rtdetr有了很好的改进,尤其是deim能很好的加速训练的速度,能将其整合进rtdetr中吗?
yuwencool
您好RT-DETR模型的推理支持model.track模式吗?
liyansong123456
RT-DETRv3 has been released. Does Ultralytics have plans to integrate it?
AK993
你好,rt-detr支持在转为rknn格式,并在rk3588上部署吗