모델 배포 모범 사례#
소개#
모델 배포는 모델을 개발 단계에서 실제 애플리케이션으로 전환하는 컴퓨터 비전 프로젝트의 단계입니다. 다양한 모델 배포 옵션이 있습니다. 클라우드 배포는 확장성과 접근성을 제공하고, 엣지 배포는 모델을 데이터 소스에 더 가깝게 배치하여 지연 시간을 줄이며, 로컬 배포는 개인정보 보호와 제어 기능을 보장합니다. 적절한 전략을 선택하려면 속도, 보안, 확장성 간의 균형을 고려하여 애플리케이션의 요구 사항을 평가해야 합니다.
Watch: How to Optimize and Deploy AI Models: Best Practices, Troubleshooting, and Security Considerations
배포는 모델 성능의 효과와 신뢰성에 큰 영향을 미칠 수 있으므로 모델을 배포할 때 모범 사례를 따르는 것도 중요합니다. 이 가이드에서는 모델 배포가 원활하고 효율적이며 안전하게 이루어지도록 하는 방법을 중점적으로 살펴봅니다.
모델 배포 옵션#
대개 모델을 학습하고 평가하고 테스트한 후에는 클라우드, 엣지 또는 로컬 디바이스와 같은 다양한 환경에 효과적으로 배포하기 위해 특정 형식으로 변환해야 합니다.
YOLO26을 사용하면 배포 요구 사항에 따라 모델을 다양한 형식으로 내보낼 수 있습니다. 예를 들어 YOLO26을 ONNX로 내보내는 작업은 간단하며 프레임워크 간에 모델을 전송하는 데 적합합니다. 다양한 통합 옵션을 살펴보고 여러 환경에서 원활한 배포를 보장하려면 모델 통합 카탈로그를 확인하세요.
배포 환경 선택#
컴퓨터 비전 모델을 배포할 위치는 여러 요인에 따라 결정됩니다. 환경마다 고유한 이점과 과제가 있으므로 요구 사항에 가장 적합한 환경을 선택해야 합니다.
클라우드 배포#
클라우드 배포는 빠른 확장과 대규모 데이터 처리가 필요한 애플리케이션에 적합합니다. AWS, Google Cloud, Azure와 같은 플랫폼을 사용하면 학습부터 배포까지 모델을 쉽게 관리할 수 있습니다. 또한 AWS SageMaker, Google AI Platform, Azure Machine Learning과 같은 서비스를 제공하여 전체 프로세스를 지원합니다.
그러나 클라우드는 특히 데이터 사용량이 많을 때 비용이 많이 들 수 있으며, 사용자가 데이터 센터에서 멀리 떨어져 있으면 지연 시간 문제가 발생할 수 있습니다. 비용과 성능을 관리하려면 리소스 사용을 최적화하고 데이터 개인정보 보호 규정을 준수해야 합니다.
엣지 배포#
엣지 배포는 실시간 응답과 짧은 지연 시간이 필요한 애플리케이션, 특히 인터넷 접속이 제한되거나 불가능한 환경에 적합합니다. 스마트폰이나 IoT 기기와 같은 엣지 디바이스에 모델을 배포하면 빠른 처리가 가능하고 데이터를 로컬에 유지하여 개인정보 보호를 강화할 수 있습니다. 또한 클라우드로 전송되는 데이터가 줄어들어 대역폭을 절약할 수 있습니다.
그러나 엣지 디바이스는 처리 성능이 제한적인 경우가 많으므로 모델을 최적화해야 합니다. LiteRT 및 NVIDIA Jetson과 같은 도구가 도움이 될 수 있습니다. 이러한 이점에도 불구하고 많은 디바이스를 유지 관리하고 업데이트하는 작업은 어려울 수 있습니다.
로컬 배포#
로컬 배포는 데이터 개인정보 보호가 중요하거나 인터넷 접속이 불안정하거나 불가능한 경우에 가장 적합합니다. 로컬 서버나 데스크톱에서 모델을 실행하면 완전한 제어권을 확보하고 데이터를 안전하게 유지할 수 있습니다. 서버가 사용자와 가까운 경우 지연 시간도 줄일 수 있습니다.
그러나 로컬 환경에서 확장하는 작업은 어려울 수 있고 유지 관리에 많은 시간이 소요될 수 있습니다. 컨테이너화를 위한 Docker 및 관리를 위한 Kubernetes와 같은 도구를 사용하면 로컬 배포의 효율성을 높일 수 있습니다. 모든 시스템이 원활하게 작동하도록 정기적인 업데이트와 유지 관리가 필요합니다.
간소화된 배포를 위한 컨테이너화#
컨테이너화는 모델과 모든 종속성을 컨테이너라는 표준화된 단위로 패키징하는 강력한 접근 방식입니다. 이 기술은 다양한 환경에서 일관된 성능을 보장하고 배포 프로세스를 간소화합니다.
모델 배포에 Docker를 사용할 때의 이점#
Docker는 다음과 같은 여러 이유로 머신 러닝 배포를 위한 컨테이너화의 업계 표준이 되었습니다.
- 환경 일관성: Docker 컨테이너는 모델과 모든 종속성을 캡슐화하여 개발, 테스트, 프로덕션 환경에서 일관된 동작을 보장하고 "내 컴퓨터에서는 작동하는데" 문제를 제거합니다.
- 격리: 컨테이너는 애플리케이션을 서로 격리하여 서로 다른 소프트웨어 버전이나 라이브러리 간의 충돌을 방지합니다.
- 이식성: Docker 컨테이너는 Docker를 지원하는 모든 시스템에서 실행할 수 있으므로 수정 없이 여러 플랫폼에 모델을 쉽게 배포할 수 있습니다.
- 확장성: 컨테이너는 수요에 따라 쉽게 확장하거나 축소할 수 있으며, Kubernetes와 같은 오케스트레이션 도구가 이 프로세스를 자동화할 수 있습니다.
- 버전 관리: Docker 이미지를 버전 관리할 수 있으므로 변경 사항을 추적하고 필요한 경우 이전 버전으로 롤백할 수 있습니다.
YOLO26 배포를 위한 Docker 구현#
YOLO26 모델을 컨테이너화하려면 필요한 모든 종속성과 구성을 지정하는 Dockerfile을 만들 수 있습니다. 다음은 기본 예시입니다.
FROM ultralytics/ultralytics:latest

WORKDIR /app

# Copy your model and any additional files
COPY ./models/yolo26n.pt /app/models/
COPY ./scripts /app/scripts/

# Set up any environment variables
ENV MODEL_PATH=/app/models/yolo26n.pt

# Command to run when the container starts
CMD ["python", "/app/scripts/predict.py"]
이 접근 방식은 개발, 테스트, 프로덕션 환경에서 모델 배포를 재현 가능하고 일관되게 유지합니다.
모델 최적화 기법#
컴퓨터 비전 모델을 최적화하면 특히 엣지 디바이스와 같이 리소스가 제한된 환경에 배포할 때 효율적으로 실행할 수 있습니다. 다음은 모델 최적화를 위한 주요 기법입니다.
모델 가지치기#
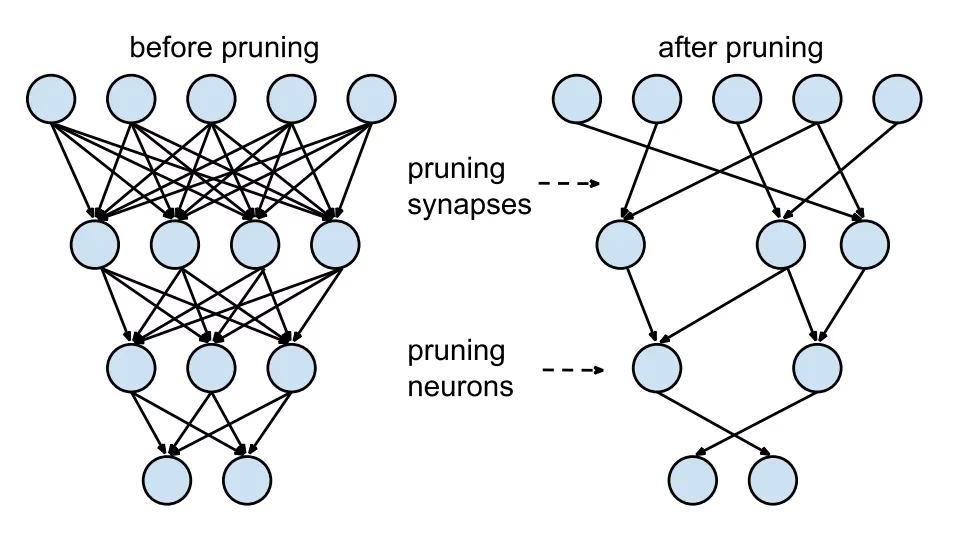
가지치기는 최종 출력에 거의 기여하지 않는 가중치를 제거하여 모델 크기를 줄입니다. 정확도에 큰 영향을 주지 않으면서 모델을 더 작고 빠르게 만듭니다. 가지치기에는 불필요한 파라미터를 식별하고 제거하는 과정이 포함되며, 그 결과 더 적은 계산 성능을 필요로 하는 경량 모델이 생성됩니다. 리소스가 제한된 디바이스에 모델을 배포할 때 특히 유용합니다.
모델 양자화#
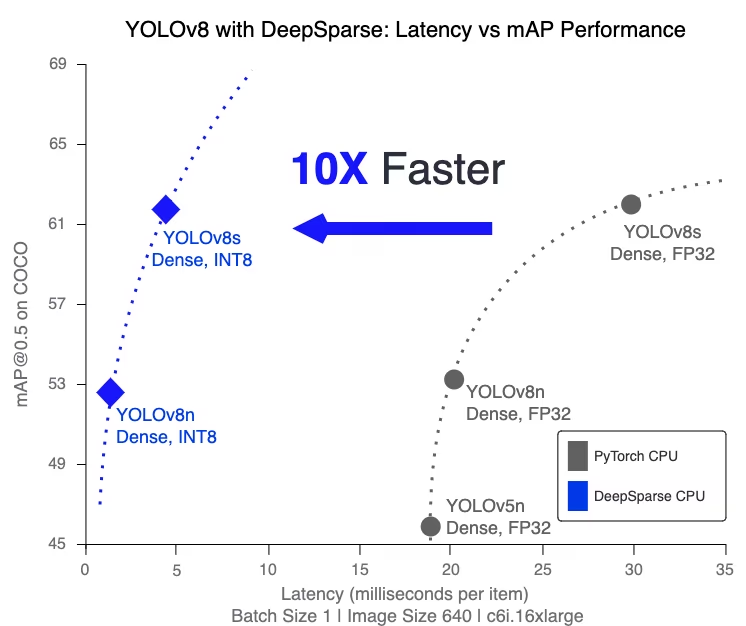
양자화는 모델의 가중치와 활성화를 높은 정밀도(예: 32비트 부동 소수점)에서 낮은 정밀도(예: 8비트 정수)로 변환합니다. 모델 크기를 줄여 추론 속도를 높입니다. 양자화 인식 학습(QAT)은 양자화를 고려하여 모델을 학습하는 방법으로, 학습 후 양자화보다 정확도를 더 잘 유지합니다. 학습 단계에서 양자화를 처리하면 모델이 낮은 정밀도에 맞게 조정하는 방법을 학습하여 계산 요구 사항을 줄이면서 성능을 유지합니다.
지식 증류#
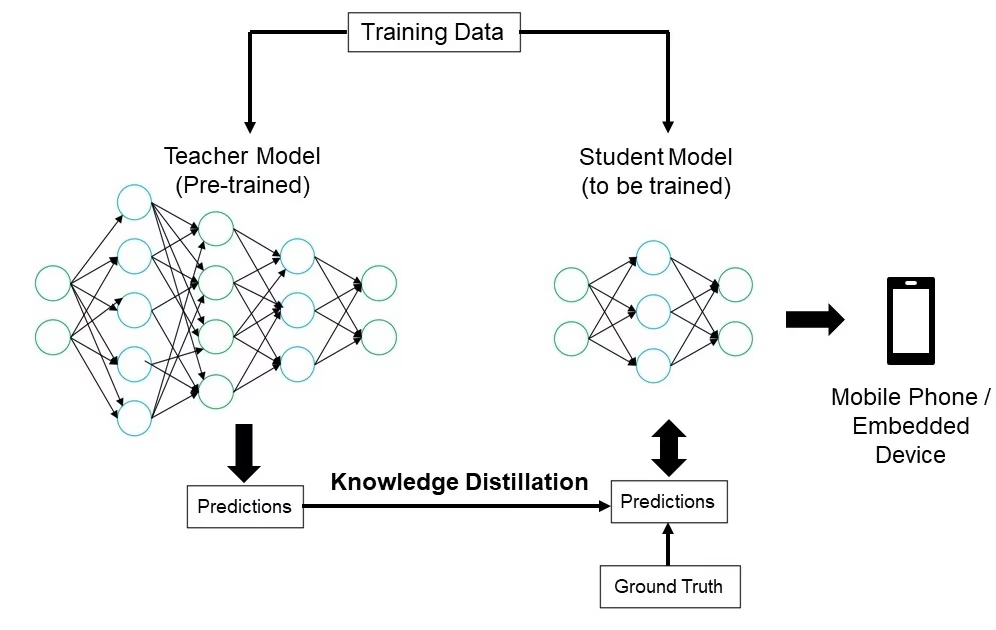
지식 증류는 더 작고 단순한 모델(학생)이 더 크고 복잡한 모델(교사)의 출력을 모방하도록 학습하는 과정입니다. 학생 모델은 교사의 예측을 근사하는 방법을 학습하여 교사의 정확도를 상당 부분 유지하는 컴팩트한 모델을 생성합니다. 이 기법은 리소스가 제한된 엣지 디바이스에 배포하기 적합한 효율적인 모델을 만드는 데 유용합니다.
배포 문제 해결#
컴퓨터 비전 모델을 배포하는 동안 문제가 발생할 수 있지만, 일반적인 문제와 해결 방법을 이해하면 프로세스를 원활하게 진행할 수 있습니다. 다음은 배포 문제를 해결하는 데 도움이 되는 일반적인 문제 해결 팁과 모범 사례입니다.
배포 후 모델 정확도가 낮아지는 경우#
배포 후 모델의 정확도가 떨어지면 당황스러울 수 있습니다. 이 문제는 다양한 요인에서 비롯될 수 있습니다. 다음 단계에 따라 문제를 식별하고 해결할 수 있습니다.
- 데이터 일관성 확인: 배포 후 모델이 처리하는 데이터가 학습에 사용된 데이터와 일관적인지 확인합니다. 데이터 분포, 품질 또는 형식의 차이는 성능에 큰 영향을 줄 수 있습니다.
- 전처리 단계 검증: 학습 중 적용한 모든 전처리 단계가 배포 중에도 일관되게 적용되는지 확인합니다. 여기에는 이미지 크기 조정, 픽셀 값 정규화 및 기타 데이터 변환이 포함됩니다.
- 모델 환경 평가: 배포 중 사용한 하드웨어 및 소프트웨어 구성이 학습 중 사용한 구성과 일치하는지 확인합니다. 라이브러리, 버전 및 하드웨어 기능의 차이로 인해 불일치가 발생할 수 있습니다.
- 모델 추론 모니터링: 추론 파이프라인의 여러 단계에서 입력과 출력을 기록하여 이상을 감지합니다. 이를 통해 데이터 손상이나 모델 출력의 부적절한 처리와 같은 문제를 식별할 수 있습니다.
- 모델 내보내기 및 변환 검토: 모델을 다시 내보내고 변환 프로세스가 모델 가중치와 아키텍처의 무결성을 유지하는지 확인합니다.
- 제어된 데이터셋으로 테스트: 직접 제어하는 데이터셋을 사용하여 테스트 환경에 모델을 배포하고 결과를 학습 단계와 비교합니다. 이를 통해 문제가 배포 환경에 있는지 데이터에 있는지 식별할 수 있습니다.
YOLO26을 배포할 때 여러 요인이 모델 정확도에 영향을 줄 수 있습니다. 모델을 TensorRT와 같은 형식으로 변환하면 가중치 양자화 및 레이어 융합과 같은 최적화가 적용되어 약간의 정밀도 손실이 발생할 수 있습니다. FP32(단정밀도) 대신 FP16(반정밀도)을 사용하면 추론 속도를 높일 수 있지만 수치 정밀도 오류가 발생할 수 있습니다. 또한 CUDA 코어 수가 적고 메모리 대역폭이 낮은 Jetson Nano와 같은 하드웨어 제약도 성능에 영향을 줄 수 있습니다.
추론 시간이 예상보다 오래 걸리는 경우#
머신 러닝 모델을 배포할 때는 모델이 효율적으로 실행되는 것이 중요합니다. 추론 시간이 예상보다 오래 걸리면 사용자 경험과 애플리케이션의 효과에 영향을 줄 수 있습니다. 다음 단계에 따라 문제를 식별하고 해결할 수 있습니다.
- 워밍업 실행 구현: 초기 실행에는 설정 오버헤드가 포함되는 경우가 많아 지연 시간 측정이 왜곡될 수 있습니다. 지연 시간을 측정하기 전에 몇 차례 워밍업 추론을 수행합니다. 이러한 초기 실행을 제외하면 모델 성능을 더 정확하게 측정할 수 있습니다.
- 추론 엔진 최적화: 추론 엔진이 특정 GPU 아키텍처에 맞게 완전히 최적화되었는지 다시 확인합니다. 하드웨어에 맞게 조정된 최신 드라이버와 소프트웨어 버전을 사용하여 최고의 성능과 호환성을 확보합니다.
- 비동기 처리 사용: 비동기 처리를 사용하면 워크로드를 더욱 효율적으로 관리할 수 있습니다. 비동기 처리 기법으로 여러 추론을 동시에 처리하면 부하를 분산하고 대기 시간을 줄일 수 있습니다.
- 추론 파이프라인 프로파일링: 추론 파이프라인의 병목을 식별하면 지연의 원인을 정확히 파악할 수 있습니다. 프로파일링 도구를 사용하여 추론 프로세스의 각 단계를 분석하고, 비효율적인 레이어나 데이터 전송 문제처럼 상당한 지연을 유발하는 단계를 식별하고 해결합니다.
- 적절한 정밀도 사용: 필요 이상으로 높은 정밀도를 사용하면 추론 시간이 느려질 수 있습니다. FP32(단정밀도) 대신 FP16(반정밀도)과 같은 낮은 정밀도의 사용을 시험해 보세요. FP16은 추론 시간을 줄일 수 있지만 모델 정확도에 영향을 줄 수 있다는 점도 고려해야 합니다.
YOLO26을 배포하는 동안 이 문제가 발생한다면 YOLO26이 다양한 모델 크기를 제공한다는 점을 고려하세요. 예를 들어 YOLO26n(nano)은 메모리 용량이 작은 디바이스에 적합하고 YOLO26x(extra-large)은 더 강력한 GPU에 적합합니다. 하드웨어에 맞는 모델 변형을 선택하면 메모리 사용량과 처리 시간의 균형을 맞출 수 있습니다.
또한 입력 이미지의 크기가 메모리 사용량과 처리 시간에 직접적인 영향을 준다는 점을 고려해야 합니다. 낮은 해상도는 메모리 사용량을 줄이고 추론 속도를 높이는 반면, 높은 해상도는 정확도를 향상시키지만 더 많은 메모리와 처리 성능이 필요합니다.
모델 배포 시 보안 고려 사항#
배포의 또 다른 중요한 측면은 보안입니다. 배포된 모델의 보안은 민감한 데이터와 지적 재산을 보호하는 데 매우 중요합니다. 다음은 안전한 모델 배포와 관련하여 따를 수 있는 모범 사례입니다.
안전한 데이터 전송#
클라이언트와 서버 간에 전송되는 데이터를 안전하게 보호하는 것은 데이터가 가로채지거나 권한이 없는 당사자가 액세스하는 것을 방지하는 데 매우 중요합니다. TLS(전송 계층 보안)와 같은 암호화 프로토콜을 사용하여 전송 중인 데이터를 암호화할 수 있습니다. 누군가 데이터를 가로채더라도 내용을 읽을 수 없습니다. 또한 소스에서 대상까지 데이터를 보호하는 종단 간 암호화를 사용하여 중간에 있는 누구도 데이터에 액세스하지 못하도록 할 수 있습니다.
액세스 제어#
무단 사용을 방지하려면 모델과 해당 데이터에 액세스할 수 있는 사용자를 제어해야 합니다. 강력한 인증 방법을 사용하여 모델에 액세스하려는 사용자 또는 시스템의 신원을 확인하고, 다중 인증(MFA)을 추가하여 보안을 강화하는 방안을 고려하세요. 역할 기반 액세스 제어(RBAC)를 설정하여 사용자 역할에 따라 권한을 할당하면 각 사용자가 필요한 항목에만 액세스할 수 있습니다. 자세한 감사 로그를 유지하여 모델과 해당 데이터에 대한 모든 액세스 및 변경 사항을 추적하고, 의심스러운 활동을 발견할 수 있도록 로그를 정기적으로 검토합니다.
모델 난독화#
모델 난독화를 통해 모델의 역공학이나 오용을 방지할 수 있습니다. 여기에는 신경망의 가중치와 편향 같은 모델 파라미터를 암호화하여 권한이 없는 사람이 모델을 이해하거나 수정하기 어렵게 만드는 작업이 포함됩니다. 레이어와 파라미터의 이름을 바꾸거나 더미 레이어를 추가하여 모델 아키텍처를 난독화하면 공격자가 역공학을 수행하기 더 어려워집니다. 또한 보안 엔클레이브나 신뢰 실행 환경(TEE)과 같은 보안 환경에서 모델을 제공하면 추론 중 추가적인 보호 계층을 마련할 수 있습니다.
결론 및 다음 단계#
컴퓨터 비전 모델을 배포할 때 따라야 할 몇 가지 모범 사례를 살펴보았습니다. 데이터를 보호하고, 액세스를 제어하고, 모델 세부 정보를 난독화하면 모델을 원활하게 실행하면서 민감한 정보를 보호할 수 있습니다. 또한 워밍업 실행, 엔진 최적화, 비동기 처리, 파이프라인 프로파일링, 적절한 정밀도 선택과 같은 전략을 사용하여 정확도 저하와 느린 추론 같은 일반적인 문제를 해결하는 방법도 살펴보았습니다.
모델을 배포한 후 다음 단계는 애플리케이션을 모니터링하고, 유지 관리하고, 문서화하는 것입니다. 정기적인 모니터링은 문제를 신속하게 발견하고 해결하는 데 도움이 되고, 유지 관리는 모델을 최신 상태와 정상 작동 상태로 유지하며, 우수한 문서화는 모든 변경 사항과 업데이트를 추적합니다. 이러한 단계를 통해 컴퓨터 비전 프로젝트의 목표를 달성할 수 있습니다.
FAQ#
머신 러닝 모델, 특히 Ultralytics YOLO26을 배포할 때는 효율성과 신뢰성을 보장하기 위해 여러 모범 사례를 따라야 합니다. 먼저 클라우드, 엣지 또는 로컬 중 요구 사항에 적합한 배포 환경을 선택합니다. 리소스가 제한된 환경에서 효율적으로 배포할 수 있도록 가지치기, 양자화 및 지식 증류와 같은 기법으로 모델을 최적화합니다. 다양한 환경에서 일관성을 보장하기 위해 Docker를 사용한 컨테이너화를 고려하세요. 마지막으로 성능을 유지하려면 데이터 일관성과 전처리 단계가 학습 단계와 일치하는지 확인합니다. 더 자세한 지침은 모델 배포 옵션을 참조할 수도 있습니다.
배포 문제 해결은 몇 가지 핵심 단계로 나눌 수 있습니다. 배포 후 모델의 정확도가 떨어지면 데이터 일관성을 확인하고, 전처리 단계를 검증하며, 하드웨어 및 소프트웨어 환경이 학습에 사용한 환경과 일치하는지 확인합니다. 추론 시간이 느린 경우 워밍업 실행을 수행하고, 추론 엔진을 최적화하고, 비동기 처리를 사용하고, 추론 파이프라인을 프로파일링합니다. 이러한 모범 사례에 대한 자세한 가이드는 배포 문제 해결을 참조하세요.
엣지 디바이스용 Ultralytics YOLO26 모델 최적화에는 가지치기를 통해 모델 크기를 줄이고, 양자화를 통해 가중치를 낮은 정밀도로 변환하며, 지식 증류를 통해 더 큰 모델을 모방하는 더 작은 모델을 학습하는 기법이 포함됩니다. 이러한 기법은 계산 성능이 제한된 디바이스에서 모델이 효율적으로 실행되도록 합니다. LiteRT 및 NVIDIA Jetson과 같은 도구는 이러한 최적화에 특히 유용합니다. 이러한 기법에 대한 자세한 내용은 모델 최적화 섹션에서 확인할 수 있습니다.
머신 러닝 모델을 배포할 때 보안은 가장 중요합니다. TLS와 같은 암호화 프로토콜을 사용하여 안전한 데이터 전송을 보장합니다. 강력한 인증과 역할 기반 액세스 제어(RBAC)를 포함한 견고한 액세스 제어를 구현합니다. 모델 파라미터를 암호화하고 신뢰 실행 환경(TEE)과 같은 안전한 환경에서 모델을 제공하는 등의 모델 난독화 기법은 추가적인 보호 기능을 제공합니다. 자세한 사례는 보안 고려 사항을 참조하세요.