빠른 시작 가이드: NVIDIA DGX Spark에서 Ultralytics YOLO26 사용하기#
이 종합 가이드에서는 NVIDIA의 소형 데스크톱 AI 슈퍼컴퓨터인 NVIDIA DGX Spark에 Ultralytics YOLO26을 배포하는 방법을 자세히 안내합니다. 또한 성능 벤치마크를 통해 이 강력한 시스템에서 YOLO26이 발휘하는 성능을 보여줍니다.
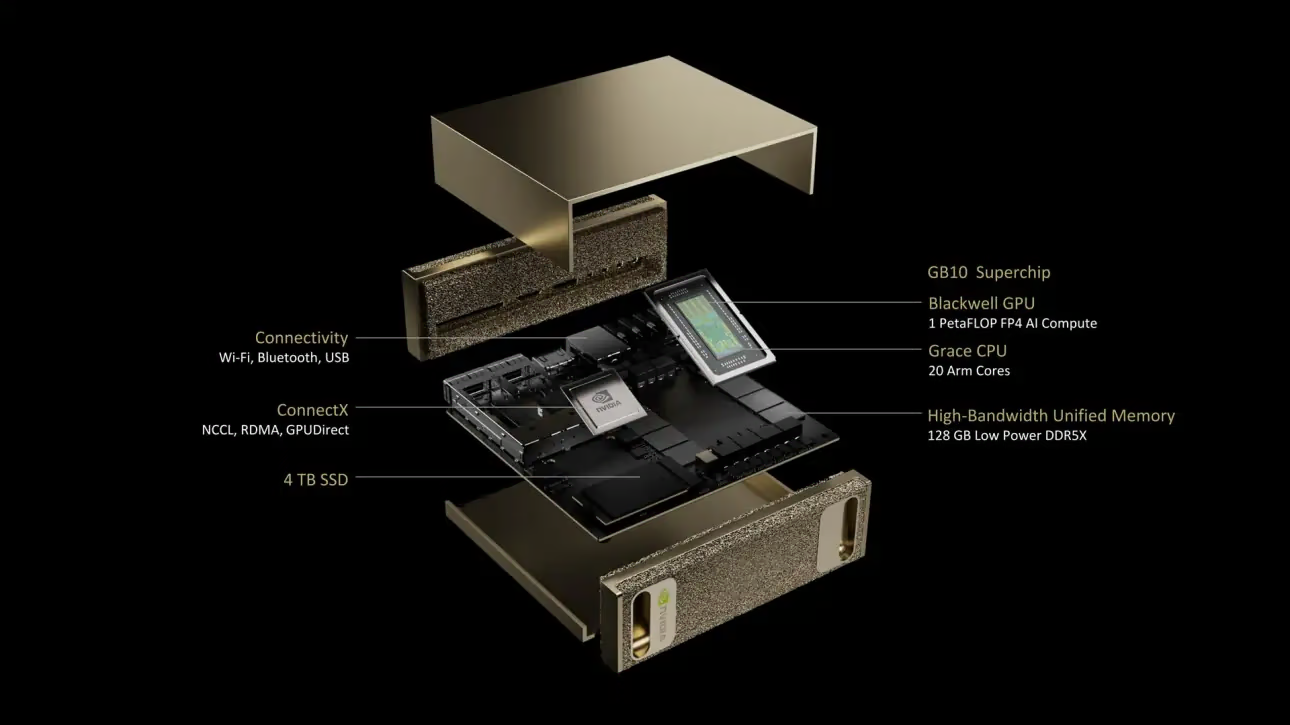
이 가이드는 Ubuntu 기반 DGX OS를 실행하는 NVIDIA DGX Spark Founders Edition에서 테스트했습니다. 최신 DGX OS 릴리스에서도 작동할 것으로 예상됩니다.
NVIDIA DGX Spark란 무엇인가요?#
NVIDIA DGX Spark는 NVIDIA GB10 Grace Blackwell Superchip을 탑재한 소형 데스크톱 AI 슈퍼컴퓨터입니다. FP4 정밀도에서 최대 1페타플롭의 AI 컴퓨팅 성능을 제공하므로 데스크톱 폼 팩터에서 강력한 AI 성능이 필요한 개발자, 연구원, 데이터 과학자에게 적합합니다.
주요 사양#
| 사양 | 세부 정보 |
|---|---|
| AI 성능 | 최대 1 PFLOP(FP4) |
| GPU | 5세대 Tensor Cores 및 4세대 RT Cores를 탑재한 NVIDIA Blackwell 아키텍처 |
| CPU | 20코어 Arm 프로세서(10 Cortex-X925 + 10 Cortex-A725) |
| 메모리 | 128GB LPDDR5x 통합 시스템 메모리, 256비트 인터페이스, 4266MHz, 273GB/s 대역폭 |
| 스토리지 | 자체 암호화 기능을 지원하는 1TB 또는 4TB NVMe M.2 |
| 네트워크 | RJ-45(10 GbE) 1개, ConnectX-7 Smart NIC, Wi-Fi 7, Bluetooth 5.4 |
| 연결 | USB Type-C 4개, HDMI 2.1a 1개, HDMI 멀티채널 오디오 |
| 비디오 처리 | NVENC 1개, NVDEC 1개 |
DGX OS#
NVIDIA DGX OS는 DGX 시스템에서 AI, 머신 러닝, 분석 애플리케이션을 실행하기 위한 안정적이고 검증 및 지원이 제공되는 운영 체제 기반을 제공하는 맞춤형 Linux 배포판입니다. 다음을 포함합니다:
- AI 워크로드에 최적화된 견고한 Linux 기반
- NVIDIA 하드웨어용으로 사전 구성된 드라이버 및 시스템 설정
- 보안 업데이트 및 시스템 유지 관리 기능
- 광범위한 NVIDIA 소프트웨어 에코시스템과의 호환성
DGX OS는 정기적인 릴리스 일정에 따라 일반적으로 연 2회(2월과 8월경) 업데이트를 제공하며, 주요 릴리스 사이에도 추가 보안 패치를 제공합니다.
DGX Dashboard#
DGX Spark에는 다음을 제공하는 DGX Dashboard가 기본으로 포함되어 있습니다:
- 실시간 시스템 모니터링: 시스템의 현재 운영 지표 개요
- 시스템 업데이트: 대시보드에서 직접 업데이트를 적용하는 기능
- 시스템 설정: 디바이스 이름 및 기타 구성 변경
- 통합 JupyterLab: 개발을 위한 로컬 Jupyter Notebook 액세스
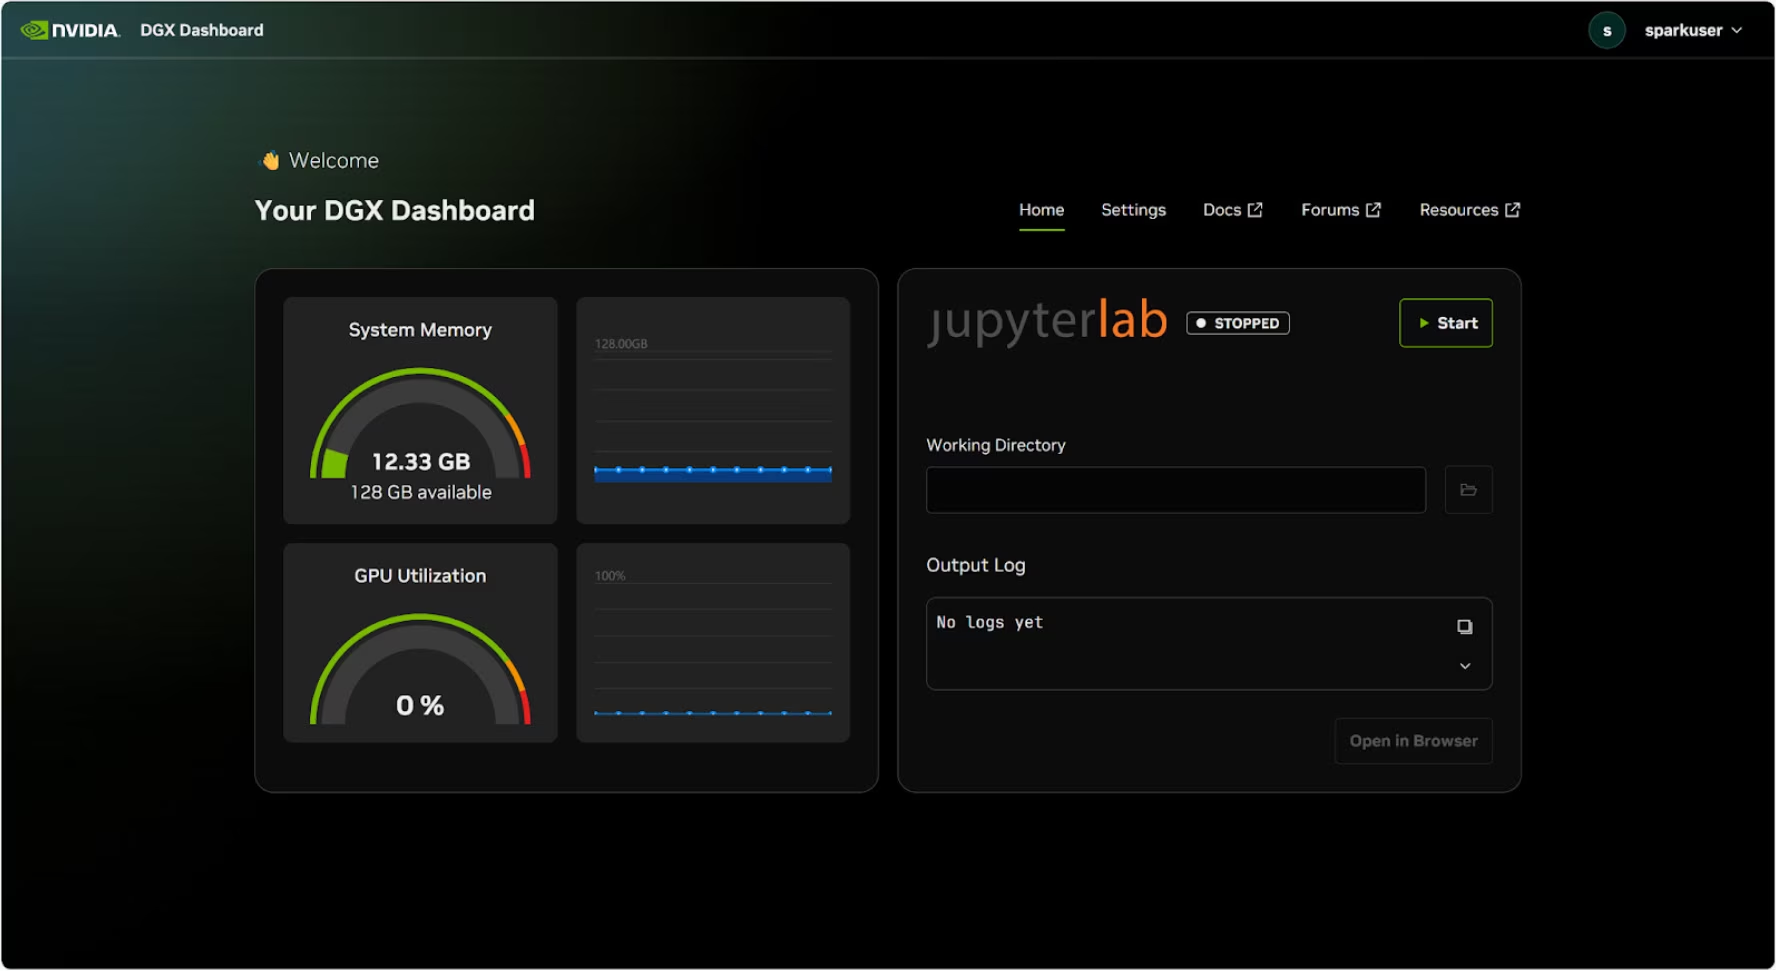
대시보드 액세스#
Ubuntu 데스크톱의 왼쪽 하단에서 "앱 표시" 버튼을 클릭한 다음, "DGX Dashboard"를 선택하여 브라우저에서 엽니다.
대시보드에는 통합 JupyterLab 인스턴스가 포함되어 있으며, 시작 시 가상 환경을 자동으로 생성하고 권장 패키지를 설치합니다. 각 사용자 계정에는 JupyterLab 액세스를 위한 전용 포트가 할당됩니다.
Docker로 빠르게 시작하기#
NVIDIA DGX Spark에서 Ultralytics YOLO26을 가장 빠르게 시작하려면 사전 빌드된 Docker 이미지를 실행하면 됩니다. NVIDIA ARM64 이미지는 DGX OS가 설치된 DGX Spark를 지원합니다.
t=ultralytics/ultralytics:latest-nvidia-arm64
sudo docker pull $t && sudo docker run -it --ipc=host --device nvidia.com/gpu=all $t
위의 CDI 디바이스 요청은 DGX OS를 실행하는 DGX Spark에 적용됩니다. Jetson AGX Thor의 PyTorch 워크로드는 별도의 호스트 요구 사항 및 TensorRT 제한 사항을 NVIDIA Jetson 가이드에서 확인하세요.
이 이미지는 NVIDIA PyTorch 26.08, CUDA 13.4, TensorRT 11.2를 사용합니다. DGX OS 호스트 드라이버를 NVIDIA PyTorch 26.08이 지원하는 버전으로 업데이트하고, 이미지 또는 대상 GPU를 변경한 후에는 TensorRT 엔진을 다시 빌드하세요.
이 작업을 완료한 후 NVIDIA DGX Spark에서 TensorRT 사용 섹션으로 건너뛰세요.
기본 설치 시작하기#
Docker 없이 네이티브 설치를 수행하려면 다음 단계를 따르세요.
Ultralytics 패키지 설치#
여기서는 DGX Spark에 Ultralytics 패키지를 설치합니다. 모델을 처음 내보낼 때 내보내기 종속 항목이 자동으로 설치되므로 여기서는 기본 패키지만 필요합니다. TensorRT를 사용하면 DGX Spark의 성능을 최대한 활용할 수 있으므로 주로 NVIDIA TensorRT 내보내기에 중점을 둡니다.
-
패키지 목록을 업데이트하고 pip를 설치한 뒤 최신 버전으로 업그레이드합니다
sudo apt update sudo apt install python3-pip -y pip install -U pip -
ultralyticspip 패키지를 설치합니다pip install ultralytics -
장치를 재부팅합니다
sudo reboot
PyTorch 및 Torchvision 설치#
위의 ultralytics 설치 과정에서는 Torch와 Torchvision이 설치됩니다. 하지만 pip로 설치한 이러한 패키지는 DGX Spark의 ARM64 아키텍처와 CUDA 13에 완전히 최적화되어 있지 않을 수 있습니다. 따라서 CUDA 13 호환 버전을 설치하는 것을 권장합니다:
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu130NVIDIA DGX Spark에서 PyTorch 2.9.1을 실행할 때 CUDA를 초기화하는 과정에서(예: yolo checks, yolo predict 등을 실행할 때) 다음 UserWarning이 발생할 수 있습니다:
UserWarning: Found GPU0 NVIDIA GB10 which is of cuda capability 12.1.
Minimum and Maximum cuda capability supported by this version of PyTorch is (8.0) - (12.0)
이 경고는 무시해도 됩니다. 이 문제를 영구적으로 해결하기 위한 수정 사항이 PyTorch PR #164590에 제출되었으며, PyTorch 2.10 릴리스에 포함될 예정입니다.
onnxruntime-gpu 설치#
현재 ONNX Runtime GPU 릴리스는 Python 3.12를 포함한 Linux ARM64 휠을 제공합니다. NVIDIA ARM64 Docker 이미지는 공식 패키지를 설치하며, 네이티브 CUDA 13 설치에서는 다음을 사용하세요:
pip install onnxruntime-gpuNVIDIA DGX Spark에서 TensorRT 사용#
Ultralytics에서 지원하는 모든 모델 내보내기 형식 중 TensorRT는 NVIDIA DGX Spark에서 가장 높은 추론 성능을 제공하므로 배포에 가장 권장하는 형식입니다. 설정 방법 및 고급 사용법은 TensorRT 전용 통합 가이드를 참조하세요.
모델을 TensorRT로 변환하고 추론 실행하기#
PyTorch 형식의 YOLO26n 모델을 TensorRT로 변환해 내보낸 모델로 추론을 실행합니다.
from ultralytics import YOLO

# YOLO26n PyTorch 모델 로드
model = YOLO("yolo26n.pt")

# 모델을 TensorRT로 내보내기
model.export(format="engine")  # 'yolo26n.engine' 생성

# 내보낸 TensorRT 모델 로드
trt_model = YOLO("yolo26n.engine")

# 추론 실행
results = trt_model("https://ultralytics.com/images/bus.jpg")모델을 다양한 형식으로 내보낼 때 사용할 수 있는 추가 인수는 내보내기 페이지에서 확인하세요.
NVIDIA DGX Spark YOLO11 벤치마크#
Ultralytics 팀은 속도와 정확도를 측정하기 위해 PyTorch, TorchScript, ONNX, OpenVINO, TensorRT, TF SavedModel, TF GraphDef, TF Lite, MNN, NCNN, ExecuTorch 등 여러 모델 형식으로 YOLO11 벤치마크를 실행했습니다. 벤치마크는 기본 입력 이미지 크기 640, FP32 정밀도로 NVIDIA DGX Spark에서 실행했습니다.
상세 비교 표#
아래 표는 5가지 모델(YOLO11n, YOLO11s, YOLO11m, YOLO11l, YOLO11x)의 여러 형식별 벤치마크 결과를 나타내며, 각 조합의 상태, 크기, mAP50-95(B) 지표 및 추론 시간을 보여줍니다.
| 형식 | 상태 | 디스크 사용량(MB) | mAP50-95(B) | 추론 시간(ms/이미지) |
|---|---|---|---|---|
| PyTorch | ✅ | 5.4 | 0.5071 | 2.67 |
| TorchScript | ✅ | 10.5 | 0.5083 | 2.62 |
| ONNX | ✅ | 10.2 | 0.5074 | 5.92 |
| OpenVINO | ✅ | 10.4 | 0.5058 | 14.95 |
| TensorRT(FP32) | ✅ | 12.8 | 0.5085 | 1.95 |
| TensorRT(FP16) | ✅ | 7.0 | 0.5068 | 1.01 |
| TensorRT(INT8) | ✅ | 18.6 | 0.4880 | 1.62 |
| TF SavedModel | ✅ | 25.7 | 0.5076 | 36.39 |
| TF GraphDef | ✅ | 10.3 | 0.5076 | 41.06 |
| TF Lite | ✅ | 10.3 | 0.5075 | 64.36 |
| MNN | ✅ | 10.1 | 0.5075 | 12.14 |
| NCNN | ✅ | 10.2 | 0.5041 | 12.31 |
| ExecuTorch | ✅ | 10.2 | 0.5075 | 27.61 |
Ultralytics 8.3.249로 벤치마크 수행
결과 재현하기#
모든 내보내기 형식에서 위 Ultralytics 벤치마크를 재현하려면 다음 코드를 실행하세요.
from ultralytics import YOLO

# YOLO26n PyTorch 모델 로드
model = YOLO("yolo26n.pt")

# 모든 내보내기 형식에서 COCO128 데이터셋으로 YOLO26n의 속도와 정확도 벤치마크 수행
results = model.benchmark(data="coco128.yaml", imgsz=640)
벤치마크 결과는 시스템의 정확한 하드웨어 및 소프트웨어 구성과 벤치마크 실행 시점의 시스템 워크로드에 따라 달라질 수 있습니다. 가장 신뢰할 수 있는 결과를 얻으려면 data='coco.yaml'(검증 이미지 5000개)과 같이 이미지 수가 많은 데이터셋을 사용하세요.
NVIDIA DGX Spark 모범 사례#
NVIDIA DGX Spark에서 YOLO26을 실행할 때 성능을 최대한 발휘하려면 몇 가지 모범 사례를 따라야 합니다.
-
시스템 성능 모니터링
NVIDIA의 모니터링 도구를 사용하여 GPU 및 CPU 사용률을 추적하세요:
nvidia-smi -
메모리 사용량 최적화
128GB 통합 메모리를 갖춘 DGX Spark는 대규모 배치 크기와 모델을 처리할 수 있습니다. 처리량을 높이려면 배치 크기를 늘려 보세요:
from ultralytics import YOLO model = YOLO("yolo26n.engine") results = model.predict(source="path/to/images", batch=16) -
FP16 또는 INT8로 TensorRT 사용
최상의 성능을 얻으려면 FP16 또는 INT8 정밀도로 모델을 내보내세요:
yolo export model=yolo26n.pt format=engine quantize=16 # FP16
yolo export model=yolo26n.pt format=engine quantize=8  # INT8
시스템 업데이트(Founders Edition)#
성능과 보안을 위해 DGX Spark Founders Edition을 최신 상태로 유지하는 것이 중요합니다. NVIDIA는 시스템 OS, 드라이버, 펌웨어를 업데이트하는 두 가지 주요 방법을 제공합니다.
DGX Dashboard 사용(권장)#
호환성을 보장하는 시스템 업데이트 방법으로 DGX Dashboard를 권장합니다. 다음 작업을 수행할 수 있습니다:
- 사용 가능한 시스템 업데이트 확인
- 보안 패치 및 시스템 업데이트 설치
- NVIDIA 드라이버 및 펌웨어 업데이트 관리
수동 시스템 업데이트#
고급 사용자는 터미널에서 수동으로 업데이트를 수행할 수 있습니다:
sudo apt update
sudo apt dist-upgrade
sudo fwupdmgr refresh
sudo fwupdmgr upgrade
sudo reboot업데이트를 수행하기 전에 시스템이 안정적인 전원에 연결되어 있고 중요한 데이터를 백업했는지 확인하세요.
다음 단계#
추가 학습 자료와 지원은 Ultralytics YOLO26 문서를 참조하세요.
자주 묻는 질문#
NVIDIA DGX Spark에 Ultralytics YOLO26을 배포하는 과정은 간단합니다. 빠르게 설정하려면 사전 빌드된 Docker 이미지를 사용하거나 필요한 패키지를 수동으로 설치할 수 있습니다. 각 방법의 자세한 단계는 Docker로 빠르게 시작하기 및 네이티브 설치로 시작하기 섹션에서 확인할 수 있습니다.
GB10 Grace Blackwell Superchip 덕분에 YOLO26 모델은 DGX Spark에서 뛰어난 성능을 발휘합니다. TensorRT 형식은 최상의 추론 성능을 제공합니다. DGX Spark에서 다양한 모델 크기와 형식으로 측정한 YOLO11 벤치마크 결과는 자세한 비교 표 섹션에서 확인하세요.
최적의 성능을 제공하므로 DGX Spark에 YOLO26 모델을 배포할 때 TensorRT를 사용하는 것을 적극 권장합니다. Blackwell GPU의 기능을 활용해 추론을 가속화하여 효율성과 속도를 극대화합니다. 자세한 내용은 NVIDIA DGX Spark에서 TensorRT 사용 섹션을 참조하세요.
DGX Spark는 최대 1 PFLOP의 AI 성능과 128GB 통합 메모리를 제공하며, Jetson AGX Thor는 2070 TFLOPS와 128GB 메모리를 제공합니다. DGX Spark는 데스크톱 AI 슈퍼컴퓨터로 설계되었으며, Jetson 디바이스는 엣지 배포에 최적화된 임베디드 시스템입니다.
PyTorch 워크로드의 경우
ultralytics/ultralytics:latest-nvidia-arm64은 DGX OS를 사용하는 DGX Spark와 JetPack 7.1을 사용하는 Thor를 지원합니다. 번들로 제공되는 TensorRT 11.2는 JetPack을 지원하지 않으므로 Jetson TensorRT 워크플로에서는 해당 JetPack 릴리스가 지원하는 TensorRT 10.x 런타임을 사용해야 합니다. Jetson Docker 요구 사항을 참조하세요.