YOLO의 OpenVINO 추론 최적화#
소개#
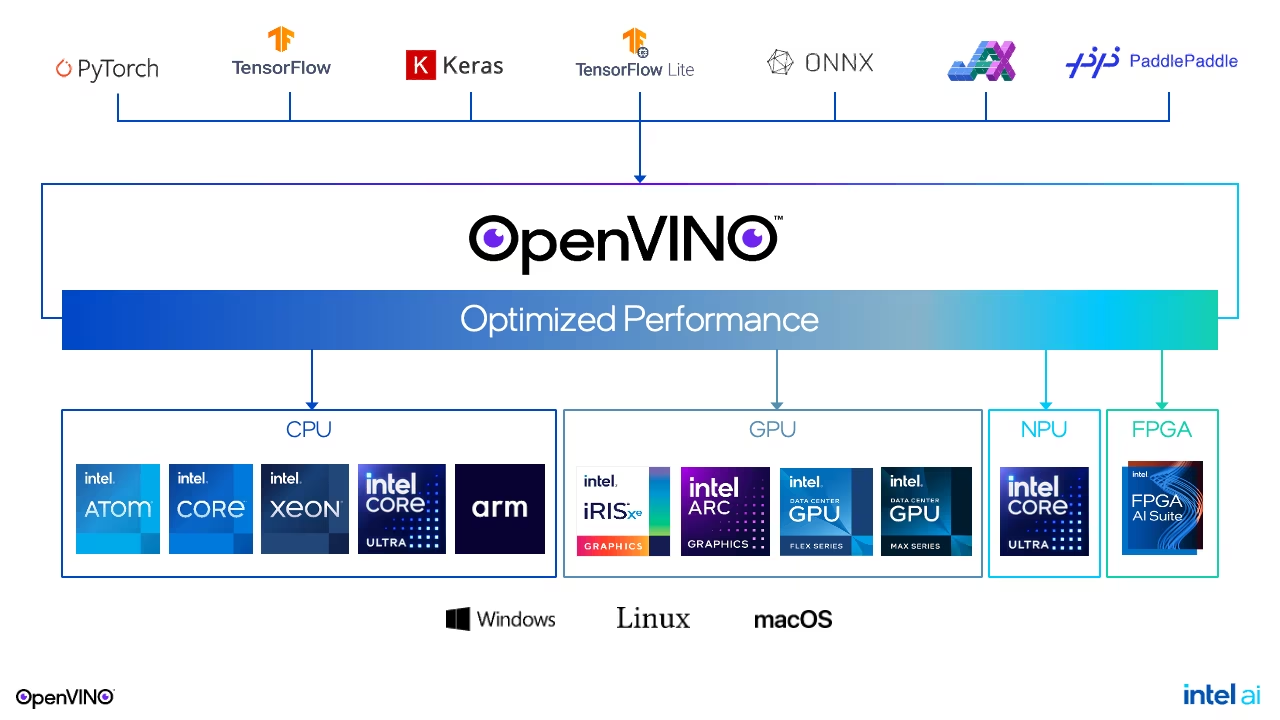
딥러닝 모델, 특히 Ultralytics YOLO 모델과 같은 객체 탐지 모델을 배포할 때 최적의 성능을 달성하는 것은 매우 중요합니다. 이 가이드에서는 Intel의 OpenVINO 툴킷을 활용해 추론을 최적화하는 방법을 살펴보고, 지연 시간과 처리량에 중점을 둡니다. 소비자용 애플리케이션을 개발하든 대규모 배포를 진행하든, 이러한 최적화 전략을 이해하고 적용하면 다양한 디바이스에서 모델을 효율적으로 실행할 수 있습니다.
지연 시간 최적화#
지연 시간 최적화는 일반적으로 소비자용 시나리오에서처럼 단일 입력에 대해 단일 모델이 즉시 응답해야 하는 애플리케이션에 필수적입니다. 목표는 입력과 추론 결과 사이의 지연을 최소화하는 것입니다. 하지만 특히 동시에 여러 추론을 실행하거나 여러 모델을 관리할 때는 낮은 지연 시간을 달성하기 위해 세심한 고려가 필요합니다.
지연 시간 최적화를 위한 주요 전략#
- 디바이스당 단일 추론: 지연 시간을 낮추는 가장 간단한 방법은 디바이스당 한 번에 하나의 추론만 실행하는 것입니다. 동시성을 높이면 지연 시간이 늘어나는 경우가 많습니다.
- 하위 디바이스 활용: 멀티소켓 CPU나 멀티타일 GPU와 같은 디바이스는 내부 하위 디바이스를 활용해 지연 시간을 거의 늘리지 않고 여러 요청을 실행할 수 있습니다.
- OpenVINO 성능 힌트: 모델 컴파일 시
ov::LATENCY을 사용해ov::performance_mode속성을 설정하면 성능 튜닝이 간소화되어 디바이스에 종속되지 않고 향후에도 유효한 접근 방식을 제공합니다.
첫 추론 지연 시간 관리#
- 모델 캐싱: 모델 로드 및 컴파일 시간이 지연 시간에 미치는 영향을 줄이려면 가능한 경우 모델 캐싱을 사용하세요. 캐싱을 사용할 수 없는 경우에는 일반적으로 CPU가 모델을 가장 빠르게 로드합니다.
- 모델 매핑과 읽기 비교: 로드 시간을 줄이기 위해 OpenVINO는 모델 읽기 대신 매핑을 사용합니다. 그러나 모델이 이동식 드라이브나 네트워크 드라이브에 있다면
ov::enable_mmap(false)을 사용해 읽기 방식으로 다시 전환하는 것을 고려하세요. - AUTO 디바이스 선택: 이 모드는 CPU에서 추론을 시작한 다음, 준비가 되면 가속기로 전환하여 첫 추론 지연 시간을 원활하게 줄입니다.
처리량 최적화#
처리량 최적화는 개별 요청의 성능을 크게 희생하지 않으면서 리소스 활용률을 극대화해 많은 추론 요청을 동시에 처리하는 시나리오에서 매우 중요합니다.
처리량 최적화 접근 방식#
-
OpenVINO 성능 힌트: 성능 힌트를 사용해 여러 디바이스의 처리량을 높이는 고수준의 미래 지향적 방법입니다.
import openvino as ov import openvino.properties.hint as hints core = ov.Core() model = core.read_model("yolo26n_openvino_model/yolo26n.xml") config = {hints.performance_mode: hints.PerformanceMode.THROUGHPUT} compiled_model = core.compile_model(model, "GPU", config) -
명시적 배치 처리 및 스트림: 명시적 배치 처리와 스트림을 활용한 세밀한 접근 방식으로, 고급 성능 튜닝에 적합합니다.
처리량 중심 애플리케이션 설계#
처리량을 극대화하려면 애플리케이션은 다음을 수행해야 합니다:
- 입력을 병렬로 처리하여 디바이스의 성능을 최대한 활용합니다.
- 데이터 흐름을 동시 추론 요청으로 분해하고, 해당 요청이 병렬로 실행되도록 예약합니다.
- Async API와 콜백을 활용해 효율성을 유지하고 디바이스가 유휴 상태가 되지 않도록 합니다.
멀티 디바이스 실행#
OpenVINO의 멀티 디바이스 모드는 애플리케이션 수준에서 디바이스를 관리할 필요 없이 추론 요청을 디바이스 전반에 자동으로 분산하여 처리량 확장을 간소화합니다.
실제 성능 향상#
Ultralytics YOLO 모델에 OpenVINO 최적화를 적용하면 성능을 크게 향상할 수 있습니다. 벤치마크에서 확인할 수 있듯이, Intel CPU에서 추론 속도가 최대 3배 빨라질 수 있으며 통합 GPU, 전용 GPU, NPU를 포함한 Intel 하드웨어 전반에서 더 큰 성능 향상도 가능합니다.
예를 들어 Intel Xeon CPU에서 YOLO26 모델을 실행하면 OpenVINO 최적화 버전이 이미지당 추론 시간 측면에서 PyTorch 버전보다 지속적으로 더 우수한 성능을 보이며, 정확도는 저하되지 않습니다.
실제 구현#
Ultralytics YOLO 모델을 OpenVINO용으로 내보내고 최적화하려면 내보내기 기능을 사용할 수 있습니다:
from ultralytics import YOLO

# 모델 로드
model = YOLO("yolo26n.pt")

# 모델을 OpenVINO 형식으로 내보내기
model.export(format="openvino", quantize=16)  # FP16 정밀도로 내보내기
내보낸 후에는 최적화된 모델로 추론을 실행할 수 있습니다:
# OpenVINO 모델 로드
ov_model = YOLO("yolo26n_openvino_model/")

# 추론 실행(Ultralytics는 OpenVINO 모델을 LATENCY 성능 힌트로 컴파일합니다)
results = ov_model("https://ultralytics.com/images/bus.jpg", verbose=True)결론#
OpenVINO를 사용해 Ultralytics YOLO 모델의 지연 시간과 처리량을 최적화하면 애플리케이션의 성능을 크게 향상할 수 있습니다. 이 가이드에서 설명한 전략을 신중하게 적용하면 개발자는 다양한 배포 시나리오의 요구 사항을 충족하면서 모델을 효율적으로 실행할 수 있습니다. 지연 시간 최적화와 처리량 최적화 중 무엇을 선택할지는 애플리케이션의 구체적인 요구 사항과 배포 환경의 특성에 따라 달라집니다.
자세한 기술 정보와 최신 업데이트는 OpenVINO 문서와 Ultralytics YOLO 리포지토리를 참조하세요. 이러한 리소스에는 딥러닝 모델을 최대한 활용하는 데 도움이 되는 심층 가이드, 튜토리얼, 커뮤니티 지원이 제공됩니다.
모델이 최적의 성능을 달성하도록 보장하는 것은 단순히 설정을 조정하는 데 그치지 않습니다. 애플리케이션의 요구 사항을 이해하고 충분한 정보를 바탕으로 판단해야 합니다. 실시간 응답을 최적화하든 대규모 처리를 위한 처리량을 극대화하든, Ultralytics YOLO 모델과 OpenVINO의 조합은 개발자가 고성능 AI 솔루션을 배포하는 데 활용할 수 있는 강력한 툴킷을 제공합니다.
자주 묻는 질문#
Ultralytics YOLO 모델의 지연 시간을 낮추려면 다음과 같은 주요 전략을 적용해야 합니다:
- 디바이스당 단일 추론: 지연을 최소화하려면 디바이스당 한 번에 하나의 추론만 실행하세요.
- 하위 디바이스 활용: 멀티소켓 CPU나 멀티타일 GPU와 같이 지연 시간을 거의 늘리지 않고 여러 요청을 처리할 수 있는 디바이스를 활용하세요.
- OpenVINO 성능 힌트: 간편하고 디바이스에 종속되지 않는 튜닝을 위해 모델 컴파일 시 OpenVINO의
ov::LATENCY을 사용하세요.
지연 시간 최적화에 관한 실용적인 팁은 가이드의 지연 시간 최적화 섹션을 참조하세요.
OpenVINO는 성능 저하 없이 디바이스 리소스 활용률을 극대화하여 Ultralytics YOLO 모델의 처리량을 높입니다. 주요 이점은 다음과 같습니다:
- 성능 힌트: 여러 디바이스에서 간편하게 고수준 성능 튜닝을 수행할 수 있습니다.
- 명시적 배치 처리 및 스트림: 고급 성능 튜닝을 위한 세밀한 조정이 가능합니다.
- 멀티 디바이스 실행: 추론 부하를 자동으로 분산해 애플리케이션 수준의 관리를 간소화합니다.
구성 예시:
import openvino as ov
import openvino.properties.hint as hints

core = ov.Core()
model = core.read_model("yolo26n_openvino_model/yolo26n.xml")
config = {hints.performance_mode: hints.PerformanceMode.THROUGHPUT}
compiled_model = core.compile_model(model, "GPU", config)
자세한 가이드의 처리량 최적화 섹션에서 처리량 최적화에 대해 더 알아보세요.
첫 추론 지연 시간을 줄이려면 다음 방법을 고려하세요:
- 모델 캐싱: 모델 캐싱을 사용해 로드 및 컴파일 시간을 줄이세요.
- 모델 매핑과 읽기 비교: 기본적으로 매핑(
ov::enable_mmap(true))을 사용하되, 모델이 이동식 드라이브나 네트워크 드라이브에 있으면 읽기(ov::enable_mmap(false))로 전환하세요. - AUTO 디바이스 선택: AUTO 모드를 사용하면 CPU 추론으로 시작한 다음 가속기로 원활하게 전환할 수 있습니다.
첫 추론 지연 시간 관리 전략에 관한 자세한 내용은 첫 추론 지연 시간 관리 섹션을 참조하세요.
지연 시간과 처리량 최적화의 균형을 맞추려면 애플리케이션의 요구 사항을 이해해야 합니다:
- 지연 시간 최적화: 즉각적인 응답이 필요한 실시간 애플리케이션(예: 소비자용 앱)에 적합합니다.
- 처리량 최적화: 동시 추론이 많고 리소스 활용을 극대화해야 하는 시나리오(예: 대규모 배포)에 적합합니다.
OpenVINO의 고수준 성능 힌트와 멀티 디바이스 모드를 사용하면 적절한 균형을 찾는 데 도움이 됩니다. 구체적인 요구 사항에 따라 적합한 OpenVINO 성능 힌트를 선택하세요.
예, Ultralytics YOLO 모델은 활용도가 높으며 다양한 AI 프레임워크와 통합할 수 있습니다. 사용할 수 있는 옵션은 다음과 같습니다:
- TensorRT: NVIDIA GPU 최적화를 위해 TensorRT 통합 가이드를 참조하세요.
- CoreML: Apple 디바이스에서 사용하는 방법은 CoreML 내보내기 안내를 참조하세요.
- LiteRT.js: 웹 및 Node.js 앱에서는 LiteRT 통합 가이드와 LiteRT.js 웹 런타임을 참조하세요.
Ultralytics 통합 페이지에서 더 많은 통합 옵션을 확인하세요.