Conjunto de dados Global Wheat Head#
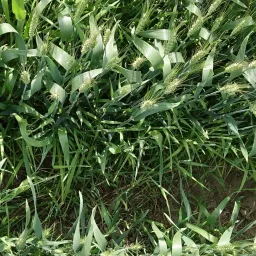
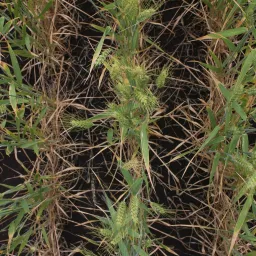
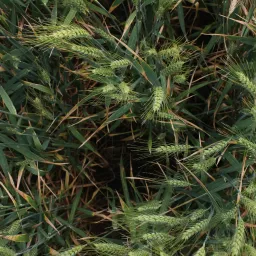
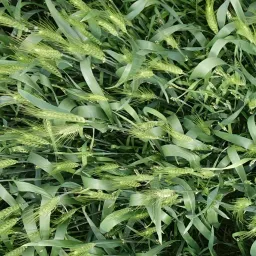
O Conjunto de dados global de espigas de trigo (GWHD) é um conjunto de dados de deteção de objetos de uma única classe, destinado a detetar espigas de trigo — as inflorescências da planta que contêm os grãos — em imagens de campos ao ar livre. Inclui 3.422 imagens de treino, 748 de validação e 1.276 de teste, captadas em várias regiões de cultivo. Foi criado através da colaboração entre nove institutos de investigação de sete países, para que os modelos generalizem em diferentes ambientes. A deteção precisa de espigas de trigo é fundamental para estimar a densidade, o tamanho e o potencial de rendimento das espigas em fenotipagem de plantas e na gestão de culturas.
Principais funcionalidades#
- Imagens reais de campos ao ar livre que captam a variabilidade natural do aspeto das espigas de trigo, da iluminação e das fases de crescimento.
- Desenvolvido por nove institutos de investigação de sete países, abrangendo regiões de cultivo da Europa, da América do Norte, da Ásia e da Austrália para permitir uma forte generalização entre ambientes.
- Anotações de caixas delimitadoras para uma única classe,
wheat_head, prontas para pipelines de deteção de objetos e rastreamento. - As imagens de teste são de genótipos e regiões não incluídos no treino, proporcionando uma verdadeira referência para avaliar a generalização.
Estrutura do conjunto de dados#
O Conjunto de dados global de espigas de trigo está organizado em três subconjuntos definidos pela configuração GlobalWheat2020.yaml, todos anotados com uma única classe, wheat_head:
| Divisão | Imagens | Regiões |
|---|---|---|
| Treinar | 3,422 | Europa (França, Reino Unido, Suíça), América do Norte (Canadá) |
| Validação | 748 | Suíça (ETH Zürich) |
| Teste | 1,276 | Austrália, Japão, China |
O conjunto de validação (748 imagens) é o subconjunto ethz_1, que também está incluído no conjunto de treinamento — portanto, as métricas de validação são calculadas com imagens nas quais o modelo também treina. O conjunto de teste reservado, com imagens da Austrália, do Japão e da China, mede a capacidade de generalização para ambientes não vistos durante o treinamento.
Aplicações#
O Global Wheat Head Dataset é amplamente utilizado para treinar e avaliar modelos de aprendizado profundo para detecção de espigas de trigo. A diversidade de imagens de diferentes regiões, genótipos e condições faz dele um recurso valioso para o fenotipagem de plantas e o manejo de culturas — contribuindo para a estimativa de produtividade, o monitoramento da saúde das culturas e a análise fenotípica.
Para anotar imagens de campo, treinar e gerenciar versões de conjuntos de dados no navegador, execute todo o fluxo de trabalho com a Ultralytics Platform.
YAML do conjunto de dados#
Um arquivo YAML é usado para definir a configuração do conjunto de dados. Ele especifica os caminhos, as classes e outros detalhes de configuração do conjunto de dados. Para o Global Wheat Head Dataset, o arquivo GlobalWheat2020.yaml é mantido em https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/GlobalWheat2020.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Global Wheat 2020 dataset https://www.global-wheat.com/ by University of Saskatchewan
# Documentation: https://docs.ultralytics.com/datasets/detect/globalwheat2020
# Example usage: yolo train data=GlobalWheat2020.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── GlobalWheat2020 ← downloads here (7.0 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: GlobalWheat2020 # dataset root dir
train: # train images (relative to 'path') 3422 images
  - images/arvalis_1
  - images/arvalis_2
  - images/arvalis_3
  - images/ethz_1
  - images/rres_1
  - images/inrae_1
  - images/usask_1
val: # val images (relative to 'path') 748 images (WARNING: train set contains ethz_1)
  - images/ethz_1
test: # test images (optional) 1276 images
  - images/utokyo_1
  - images/utokyo_2
  - images/nau_1
  - images/uq_1

# Classes
names:
  0: wheat_head

# Download script/URL (optional) ---------------------------------------------------------------------------------------
download: |
  from pathlib import Path

  from ultralytics.utils.downloads import download

  # Download
  dir = Path(yaml["path"])  # dataset root dir
  urls = [
      "https://zenodo.org/record/4298502/files/global-wheat-codalab-official.zip",
      "https://github.com/ultralytics/assets/releases/download/v0.0.0/GlobalWheat2020_labels.zip",
  ]
  download(urls, dir=dir)

  # Make Directories
  for p in "annotations", "images", "labels":
      (dir / p).mkdir(parents=True, exist_ok=True)

  # Move
  for p in (
      "arvalis_1",
      "arvalis_2",
      "arvalis_3",
      "ethz_1",
      "rres_1",
      "inrae_1",
      "usask_1",
      "utokyo_1",
      "utokyo_2",
      "nau_1",
      "uq_1",
  ):
      (dir / "global-wheat-codalab-official" / p).rename(dir / "images" / p)  # move to /images
      f = (dir / "global-wheat-codalab-official" / p).with_suffix(".json")  # json file
      if f.exists():
f.rename((dir / "annotations" / p).with_suffix(".json")) # move to /annotationsUso#
Para treinar um modelo YOLO26n no Global Wheat Head Dataset por 100 épocas, com tamanho de imagem de 640, você pode usar os trechos de código a seguir. O conjunto de dados (~7,0 GB) é baixado automaticamente na primeira utilização. Para ver uma lista completa dos argumentos disponíveis, consulte a página de treinamento do modelo.
from ultralytics import YOLO

# Carregar um modelo
model = YOLO("yolo26n.pt")  # carregue um modelo pré-treinado (recomendado para treinamento)

# Treinar o modelo
results = model.train(data="GlobalWheat2020.yaml", epochs=100, imgsz=640)
Imagens de exemplo e anotações#
O Global Wheat Head Dataset contém um conjunto diversificado de imagens de campos ao ar livre, que capturam a variabilidade natural na aparência das espigas de trigo, nos ambientes e nas condições. Veja um exemplo de imagem do conjunto de dados, juntamente com as anotações correspondentes:
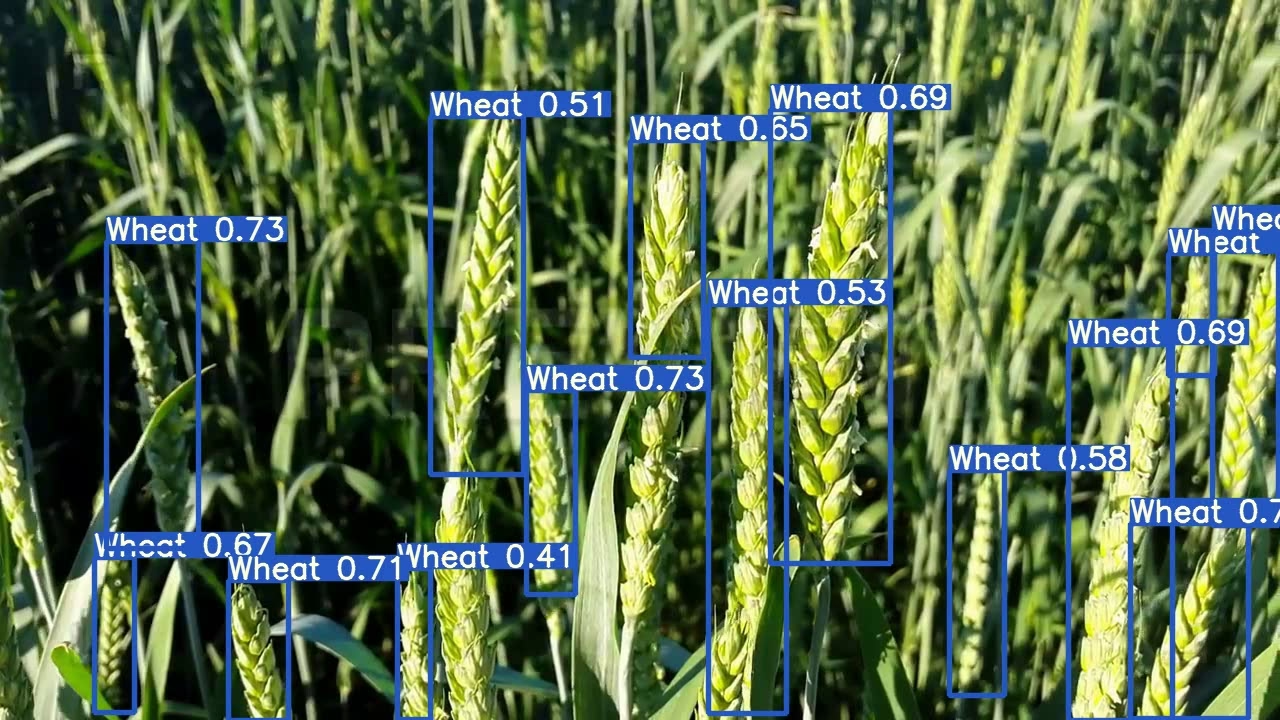
- Detecção de espigas de trigo: as espigas de trigo são anotadas com caixas delimitadoras para detecção de objetos, em diferentes condições de campo que refletem a diversidade e a complexidade do conjunto de dados.
Citações e agradecimentos#
Se você utilizar o Global Wheat Head Dataset em seu trabalho de pesquisa ou desenvolvimento, cite o artigo a seguir:
@article{david2020global,
         title={Global Wheat Head Detection (GWHD) Dataset: A Large and Diverse Dataset of High-Resolution RGB-Labelled Images to Develop and Benchmark Wheat Head Detection Methods},
         author={David, Etienne and Madec, Simon and Sadeghi-Tehran, Pouria and Aasen, Helge and Zheng, Bangyou and Liu, Shouyang and Kirchgessner, Norbert and Ishikawa, Goro and Nagasawa, Koichi and Badhon, Minhajul and others},
         journal={arXiv preprint arXiv:2005.02162},
         year={2020}
}
Agradecemos aos pesquisadores e às instituições que contribuíram para a criação e manutenção do Global Wheat Head Dataset como um recurso valioso para a comunidade de pesquisa em fenotipagem de plantas e manejo de culturas. Para saber mais sobre o conjunto de dados e seus criadores, visite o site do Global Wheat Head Dataset.
Perguntas frequentes#
O Global Wheat Head Dataset é usado principalmente para desenvolver e treinar modelos de aprendizado profundo voltados à detecção de espigas de trigo. Isso é essencial para aplicações de fenotipagem do trigo e manejo de culturas, permitindo estimativas mais precisas da densidade e do tamanho das espigas de trigo, bem como do potencial geral de produtividade das culturas. Métodos de detecção precisos ajudam a avaliar a saúde e a maturidade das culturas, aspectos essenciais para um manejo eficiente.
O Global Wheat Head Dataset tem uma única classe,
wheat_head, e está dividido em três subconjuntos: 3.422 imagens de treinamento, 748 imagens de validação e 1.276 imagens de teste. As imagens de treinamento e validação vêm da Europa e da América do Norte, enquanto o conjunto de teste é composto por imagens da Austrália, do Japão e da China para avaliar a generalização a ambientes não vistos.Para treinar um modelo YOLO26n no Global Wheat Head Dataset, você pode usar os trechos de código a seguir. Confira se você tem o arquivo de configuração
GlobalWheat2020.yamlespecificando os caminhos e as classes do conjunto de dados:Exemplo de treinofrom ultralytics import YOLO # Carregue um modelo pré-treinado (recomendado para treinamento) model = YOLO("yolo26n.pt") # Treinar o modelo results = model.train(data="GlobalWheat2020.yaml", epochs=100, imgsz=640)Para ver uma lista completa dos argumentos disponíveis, consulte a página de treinamento do modelo.
O conjunto de dados (~7,0 GB) é baixado automaticamente na primeira vez que você treina com
data="GlobalWheat2020.yaml"— não é necessário fazer isso manualmente. A Ultralytics baixa as imagens e os rótulos e os extrai para o diretório local de conjuntos de dados. Você pode explorar conjuntos de dados relacionados na visão geral dos conjuntos de dados de detecção.O arquivo YAML de configuração do Global Wheat Head Dataset, chamado
GlobalWheat2020.yaml, está disponível no GitHub. Você pode acessá-lo em https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/GlobalWheat2020.yaml. Esse arquivo contém os caminhos, as classes e outros detalhes de configuração necessários para treinar modelos com Ultralytics YOLO.A detecção de espigas de trigo é essencial para o manejo de culturas porque permite estimar com precisão a densidade e o tamanho das espigas, fatores fundamentais para avaliar a saúde, a maturidade e o potencial de produtividade das culturas. Com modelos de aprendizado profundo treinados em conjuntos de dados como o Global Wheat Head Dataset, agricultores e pesquisadores podem monitorar e manejar melhor as culturas, aumentando a produtividade e otimizando o uso de recursos nas práticas agrícolas. Esse avanço tecnológico contribui para a agricultura sustentável e para iniciativas de segurança alimentar.
Para saber mais sobre aplicações de IA na agricultura, visite IA na agricultura.