Destilação de conhecimento
Início rápido#
Treina um modelo aluno mais pequeno com a orientação de um modelo professor maior, adicionando o argumento distill_model:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(data="coco8.yaml", epochs=100, distill_model="yolo26s.pt")
O que é a destilação de conhecimento?#
A destilação de conhecimento transfere conhecimento de um modelo professor grande e preciso para um modelo aluno mais pequeno. O aluno aprende a imitar as representações internas de características do professor, alcançando muitas vezes uma exatidão superior à do treino desde o início.
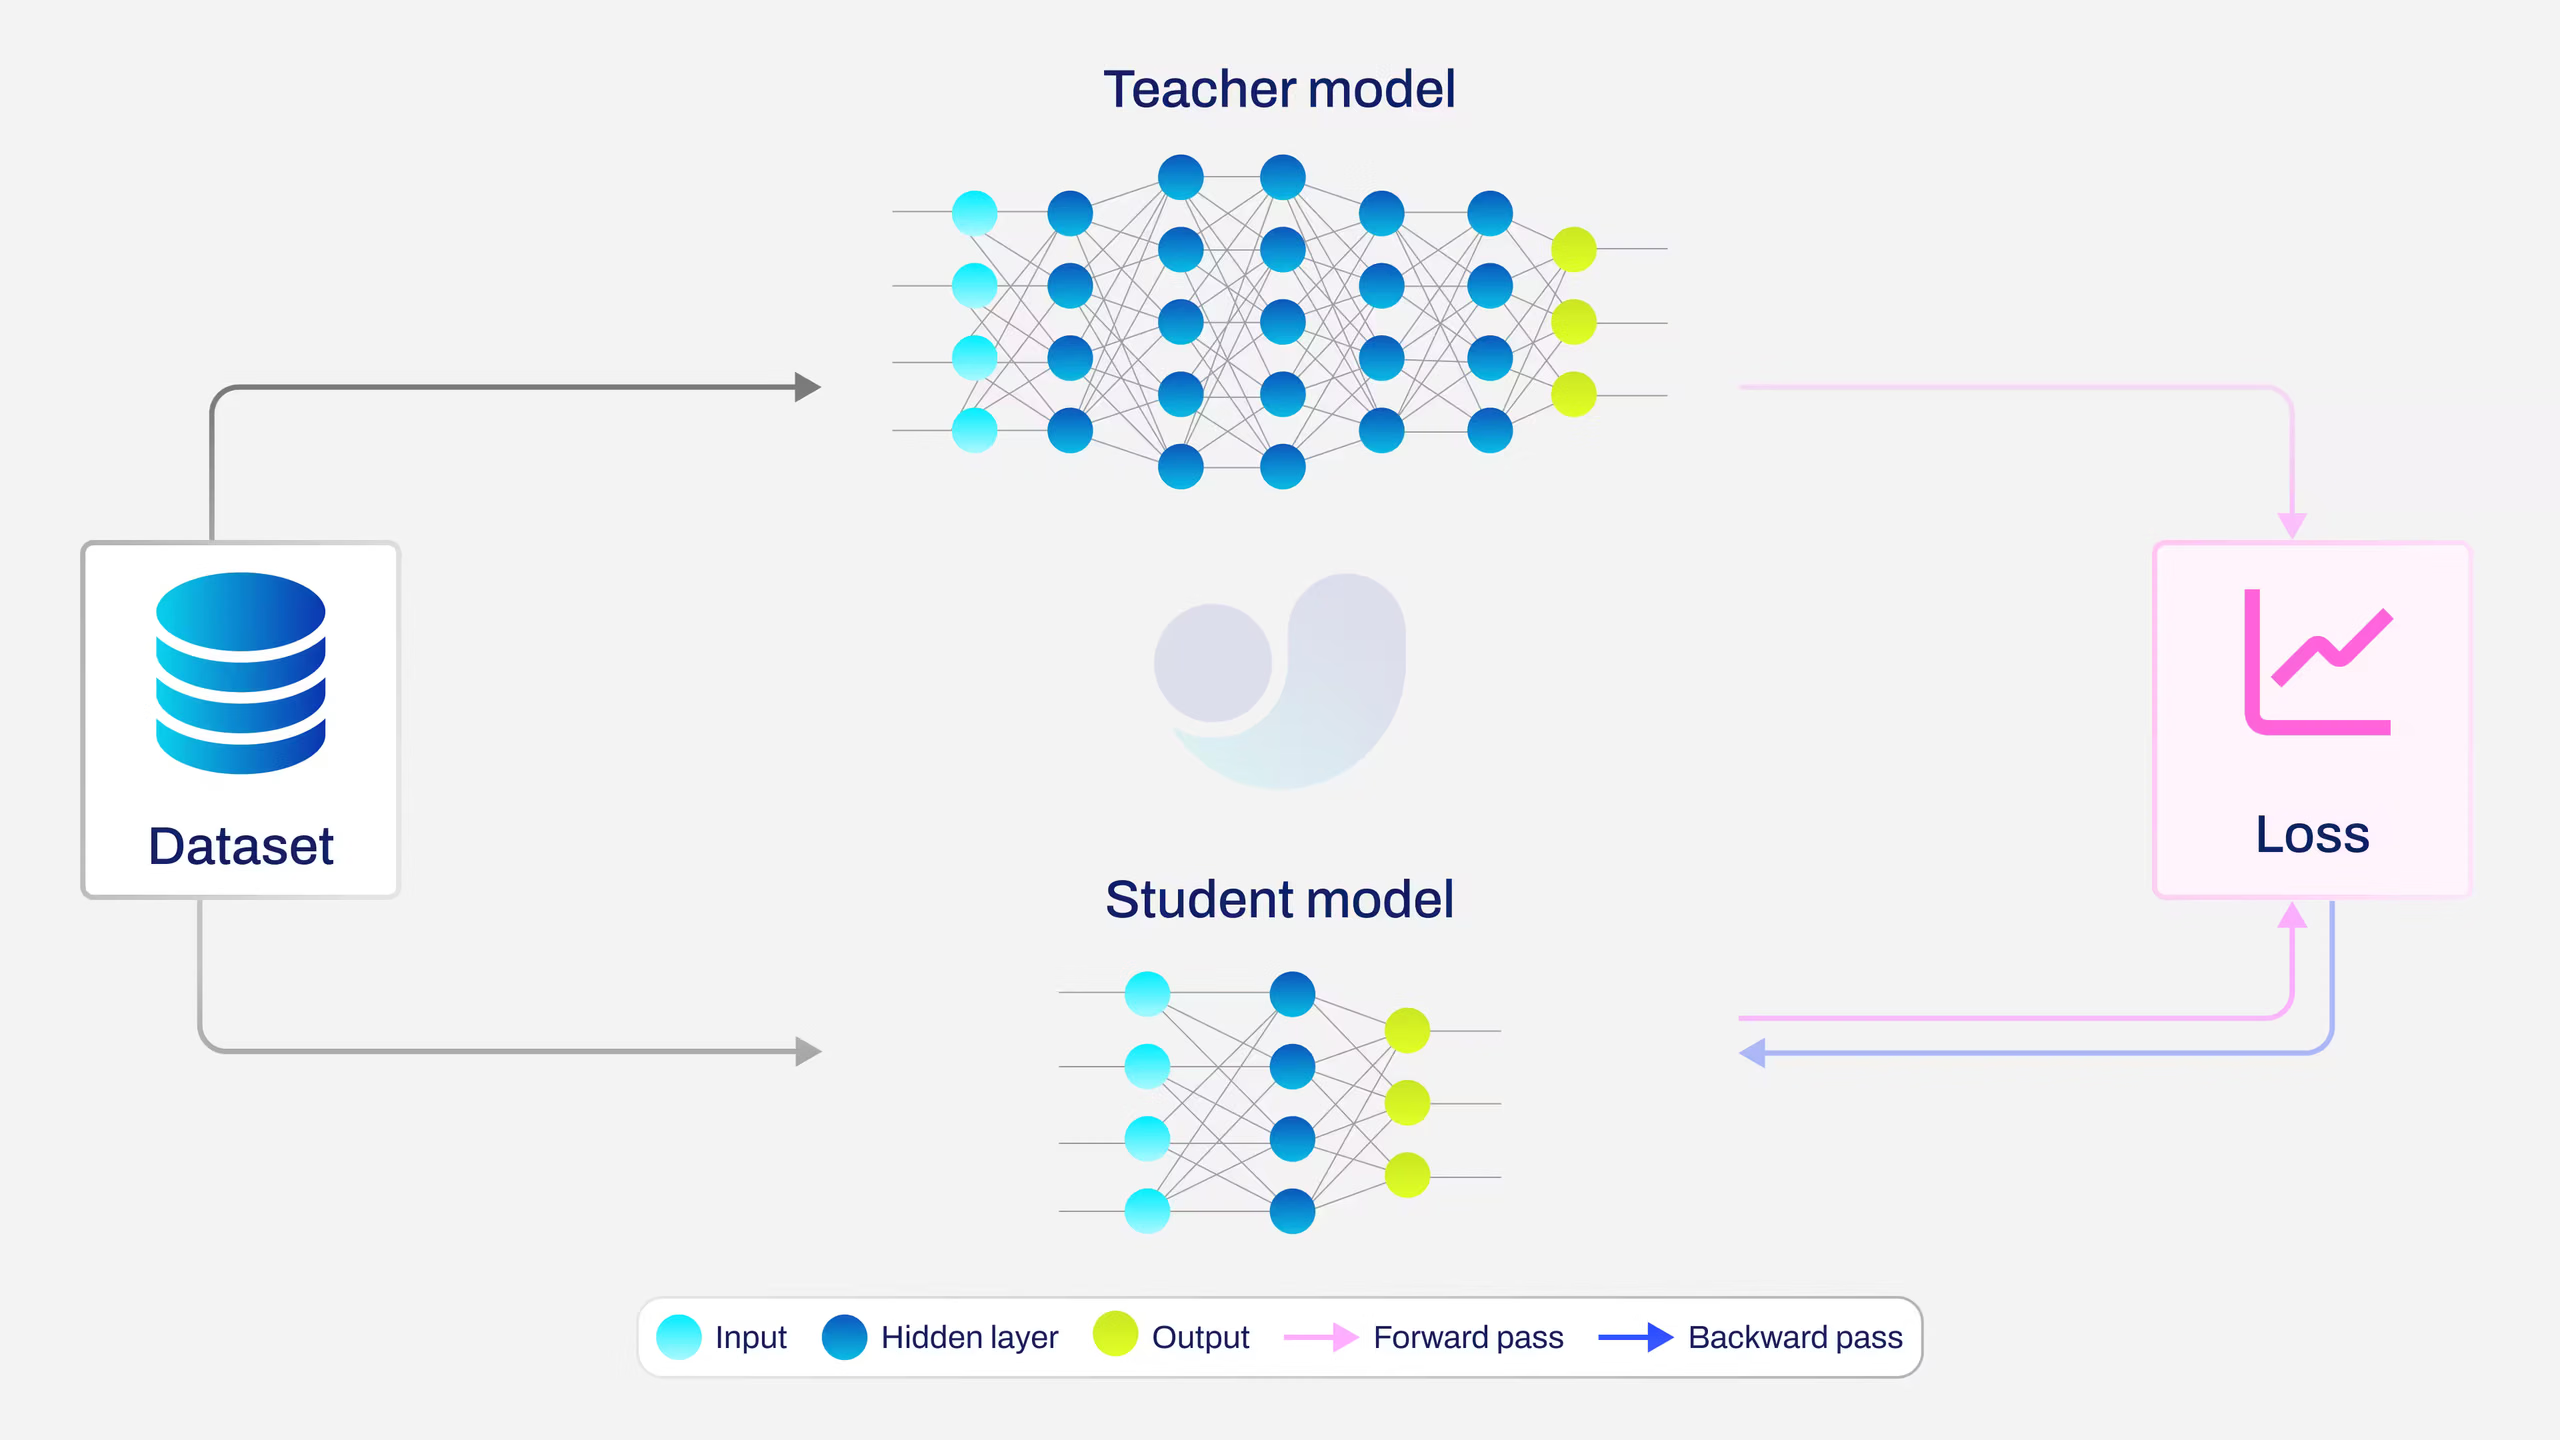
Usa a destilação quando:
- Precisas de um modelo mais pequeno e rápido para implementação
- Tens um modelo professor com elevada exatidão, treinado com os mesmos dados
- Queres obter uma exatidão superior à do treino normal
A destilação de conhecimento está implementada para as tarefas detect, segment, pose e obb. Por enquanto, apenas detect foi verificada experimentalmente quanto a melhorias de exatidão.
Desempenho#
A destilação de conhecimento melhora o mAP do modelo aluno em toda a família YOLO26 no COCO, sem custos adicionais de inferência. A tabela abaixo compara os modelos YOLO26 padrão (referência) com os mesmos modelos treinados por destilação a partir do respetivo professor recomendado.
| Modelo | tamanho (pixels) | mAPval50-95 referência | mAPval50-95 destilado | mAPval50-95 (e2e) referência | mAPval50-95 (e2e) destilado |
|---|---|---|---|---|---|
| YOLO26n-distill | 640 | 40.9 | 41.5 | 40.1 | 40.9 |
| YOLO26s-distill | 640 | 48.6 | 49.2 | 47.8 | 48.6 |
| YOLO26m-distill | 640 | 53.1 | 53.9 | 52.5 | 53.3 |
| YOLO26l-distill | 640 | 55.0 | 56.0 | 54.4 | 55.5 |
| YOLO26x-distill | 640 | 57.5 | 57.9 | 56.9 | 57.4 |
- Os valores de mAPval correspondem à avaliação de escala única e modelo único no conjunto de dados COCO val2017.
Reproduz uma linha destilada comyolo val detect model=yolo26n-distill.pt data=coco.yaml device=0; adicionanms=Falsepara a coluna e2e. - Os valores e2e usam o percurso de inferência sem NMS (
nms=False); os valores não e2e usam o pós-processamento NMS padrão (nms=None). Consulta Deteção de ponta a ponta para mais detalhes.
Pré-requisitos#
Antes de começares, certifica-te de que cumpres os seguintes requisitos:
- Modelo professor treinado: um ponto de verificação
.ptda mesma família YOLO que o aluno. - Tarefa correspondente: usa um professor para a mesma tarefa do aluno e treina-o com dados relevantes.
- Recursos de GPU: memória suficiente para alojar ambos os modelos; o professor apenas executa a passagem para a frente, sem gradientes nem estado do otimizador.
Pares de modelos recomendados#
| Aluno | Professor recomendado |
|---|---|
yolo26n.pt | yolo26s.pt |
yolo26s.pt | yolo26m.pt |
yolo26m.pt | yolo26x.pt |
yolo26l.pt | yolo26x.pt |
A destilação entre famílias (por exemplo, professor YOLO11 com aluno YOLO26) não é suportada.
Parâmetros principais#
| Parâmetro | Tipo | Padrão | Descrição |
|---|---|---|---|
distill_model | str | None | Caminho para o ficheiro do modelo professor (por exemplo, yolo26x.pt). Definir este parâmetro ativa a destilação de conhecimento. |
dis | float | 6.0 | Peso da perda de destilação. Controla a contribuição da perda de destilação para a perda total do treino. |
Como funciona#
- O modelo professor permanece congelado no modo
evale executa inferência em cada lote - O modelo aluno é treinado com perdas padrão da tarefa e orientação da destilação
- São extraídas características de ambos os modelos nas três camadas neck que alimentam a cabeça da família Detect
- Um projetor com duas convoluções 1×1 com ReLU alinha cada mapa de características do aluno com os canais do professor
- Uma perda L2 ponderada pela pontuação compara as características projetadas do aluno com as características do professor, ponderadas pela confiança de classificação do professor
- A perda de destilação combina-se com as perdas padrão usando o peso
dis
Suporte de tarefas#
A implementação da destilação extrai características das três camadas neck que alimentam a cabeça da família Detect do modelo. Como as cabeças segment, pose e obb herdam a mesma arquitetura Detect, a destilação também é tecnicamente compatível com essas tarefas.
A classificação, a segmentação semântica, a estimativa de profundidade e o RT-DETR não usam uma cabeça compatível da família Detect e não são suportados.
Apenas detect foi avaliada e verificada experimentalmente. Podes executar a destilação para segment, pose ou obb, mas as melhorias de exatidão nessas tarefas ainda não foram validadas.
from ultralytics import YOLO

# Segment
model = YOLO("yolo26n-seg.pt")
model.train(data="coco8-seg.yaml", epochs=100, distill_model="yolo26s-seg.pt")

# Pose
model = YOLO("yolo26n-pose.pt")
model.train(data="coco8-pose.yaml", epochs=100, distill_model="yolo26s-pose.pt")

# OBB
model = YOLO("yolo26n-obb.pt")
model.train(data="dota8.yaml", epochs=100, distill_model="yolo26s-obb.pt")Treinamento#
Treino básico#
O treino com destilação é idêntico ao treino padrão. Fornece o caminho distill_model para ativá-lo:
from ultralytics import YOLO

# Carrega um modelo aluno
student = YOLO("yolo26m.pt")

# Treina com destilação de conhecimento a partir de um modelo professor maior
results = student.train(data="coco8.yaml", epochs=100, distill_model="yolo26x.pt")
Ajustar o peso da perda de destilação#
O parâmetro dis (predefinição: 6.0) controla a contribuição da perda de destilação:
from ultralytics import YOLO

student = YOLO("yolo26n.pt")
results = student.train(data="coco8.yaml", epochs=100, distill_model="yolo26s.pt", dis=10.0)
Retomar o treino com destilação#
O treino com destilação permite retomar a partir de pontos de verificação. O modelo professor é reconstruído automaticamente a partir do caminho distill_model registado no ponto de verificação:
from ultralytics import YOLO

student = YOLO("runs/detect/train/weights/last.pt")
results = student.train(resume=True)
Resultado do treino#
Quando a destilação está ativada, surge uma coluna adicional dis_loss nos registos de treino:
      Epoch    GPU_mem   box_loss   cls_loss    l1_loss   dis_loss  Instances       Size
      1/80      46.2G      1.566      5.404    0.003249      6.658        231        640
O modelo exportado contém apenas os pesos do aluno — o tamanho do ficheiro e a velocidade de inferência correspondem aos de um modelo aluno treinado normalmente.
Perguntas frequentes#
- Verifica se o professor e o aluno pertencem à mesma geração YOLO
- Confirma que o caminho
distill_modelestá correto e que o ficheiro é carregado - Experimenta aumentar
disse o valor da perda for muito pequeno - Certifica-te de que o modelo professor foi treinado com o mesmo conjunto de dados
Adiciona o parâmetro
distill_model— todo o resto funciona da mesma forma. Durante o treino, é calculada uma perda de destilação adicional, mas o modelo guardado é um modelo YOLO padrão, sem sobrecarga.Sim. O professor acrescenta uma passagem para a frente em cada lote, pelo que a sobrecarga de tempo e memória depende do par professor/aluno. O professor funciona no modo
eval, sem gradientes nem estado do otimizador.A destilação de conhecimento funciona com as tarefas detect, segment, pose e obb, porque destila características das três camadas neck que alimentam a cabeça da família Detect. Classify, semantic, depth e RT-DETR não são suportados.
Apenas detect teve melhorias de precisão verificadas experimentalmente. Segment, pose e obb são tecnicamente compatíveis, mas ainda não foram avaliados em benchmarks.
O professor e o aluno devem pertencer à mesma família YOLO (por exemplo, YOLOv8, YOLO11 ou YOLO26). A destilação entre famílias (por exemplo, um professor YOLO11 com um aluno YOLO26) não é compatível.


Comentários5
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
CharbelMsallem
Cool! If same dataset, can the class mapping or the number of classes differ from parent to student but using the same images and split?
I mean classes of student be a subset of parent classes
 Glenn JocherUltralytics
Same images/splits can be reused, but for the supported distillation path the teacher and student should use the same task and
data.yamlclass configuration (nc,names, and class indices), per the Knowledge Distillation guide. If the student should learn only a subset, create a subset dataset/YAML with labels remapped to contiguous IDs and train or fine-tune a teacher on that same subset/mapping before using it asdistill_model.okat thanks!
andyrey
Very interesting and useful, thank you!