Validação cruzada K-Fold com Ultralytics
Introdução#
Este guia mostra como implementar validação cruzada K-Fold para conjuntos de dados de deteção de objetos no ecossistema Ultralytics. Usa o formato de deteção YOLO e bibliotecas de Python como scikit-learn, pandas e PyYAML para explicar a configuração, a criação de vetores de características e a divisão do conjunto de dados em K folds.
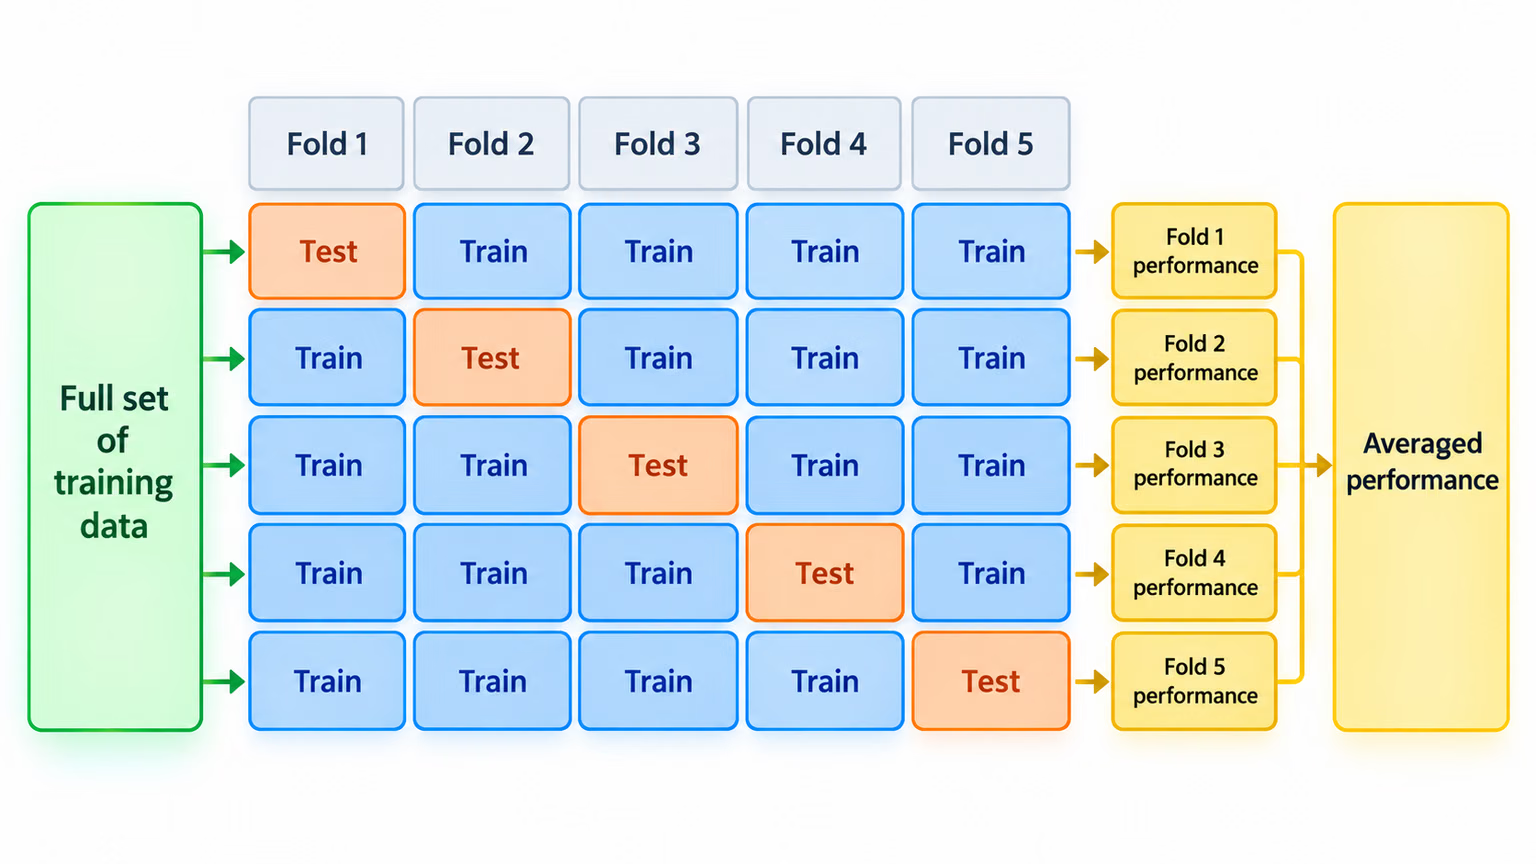
Quer o teu projeto envolva o conjunto de dados Fruit Detection ou uma fonte de dados personalizada, este tutorial ajuda-te a compreender e aplicar a validação cruzada K-Fold para melhorar a fiabilidade e a robustez dos teus modelos de aprendizagem automática. Neste tutorial, usamos k=5 folds, mas lembra-te de que o número ideal de folds pode variar consoante o conjunto de dados e as especificidades do teu projeto. A validação cruzada K-Fold é mais útil quando o conjunto de dados é pequeno, ruidoso ou muito variável; para conjuntos de dados grandes e diversificados, uma divisão bem concebida em treino/validação/teste costuma ser suficiente.
Configuração#
-
As tuas anotações devem estar no formato de deteção YOLO.
-
Este guia pressupõe que os ficheiros de anotação estão disponíveis localmente.
-
Para a nossa demonstração, usamos o conjunto de dados Fruit Detection.
- Este conjunto de dados contém um total de 8479 imagens.
- Inclui 6 rótulos de classe, cujas contagens totais de instâncias são apresentadas abaixo.
| Rótulo da classe | Contagem de instâncias |
|---|---|
| Maçã | 7049 |
| Uvas | 7202 |
| Ananás | 1613 |
| Laranja | 15549 |
| Banana | 3536 |
| Melancia | 1976 |
-
Os pacotes Python necessários incluem:
ultralyticssklearnpandaspyyaml
-
Este tutorial usa
k=5folds. No entanto, deves determinar o melhor número de folds para o teu conjunto de dados específico.
-
Cria e ativa um novo ambiente virtual de Python (
venv) para o teu projeto. Usapip(ou o teu gestor de pacotes preferido) para instalar:- A biblioteca Ultralytics:
pip install -U ultralytics. Em alternativa, podes clonar o repositório oficial. - Scikit-learn, pandas e PyYAML:
pip install -U scikit-learn pandas pyyaml.
- A biblioteca Ultralytics:
-
Confirma que as tuas anotações estão no formato de deteção YOLO.
- Neste tutorial, todos os ficheiros de anotação encontram-se no diretório
Fruit-Detection/labels.
- Neste tutorial, todos os ficheiros de anotação encontram-se no diretório
Gerar vetores de características para um conjunto de dados de deteção de objetos#
-
Começa por criar um novo ficheiro Python
example.pypara os passos abaixo. -
Carrega as imagens de treino e validação indicadas no YAML do conjunto de dados com a classe
YOLODatasetdo Ultralytics, sem alterar a divisão de teste.from pathlib import Path from ultralytics.data.dataset import YOLODataset from ultralytics.data.utils import check_det_dataset yaml_file = "path/to/data.yaml" data = check_det_dataset(yaml_file) dataset_path = Path(data["path"]) sources = [] for split in ("train", "val"): source = data.get(split) if source: sources.extend(source if isinstance(source, list) else [source]) dataset = YOLODataset(sources, data=data, augment=False) images = [Path(p) for p in dataset.im_files] -
Agora, lê o conteúdo do ficheiro YAML do conjunto de dados e extrai os índices dos rótulos de classe.
classes = data["names"] cls_idx = sorted(classes.keys()) -
Inicializa um DataFrame
pandasvazio.import pandas as pd labels_df = pd.DataFrame(0.0, columns=cls_idx, index=images) -
Conta as instâncias de cada etiqueta de classe presentes nos ficheiros de anotação.
from collections import Counter for image, label in zip(images, dataset.labels): lbl_counter = Counter(label["cls"].flatten().astype(int)) labels_df.loc[image, list(lbl_counter)] = list(lbl_counter.values()) -
Segue-se uma amostra da vista do DataFrame preenchido:
                                                       0    1    2    3    4    5
'0000a16e4b057580_jpg.rf.00ab48988370f64f5ca8ea4...'  0.0  0.0  0.0  0.0  0.0  7.0
'0000a16e4b057580_jpg.rf.7e6dce029fb67f01eb19aa7...'  0.0  0.0  0.0  0.0  0.0  7.0
'0000a16e4b057580_jpg.rf.bc4d31cdcbe229dd022957a...'  0.0  0.0  0.0  0.0  0.0  7.0
'00020ebf74c4881c_jpg.rf.508192a0a97aa6c4a3b6882...'  0.0  0.0  0.0  1.0  0.0  0.0
'00020ebf74c4881c_jpg.rf.5af192a2254c8ecc4188a25...'  0.0  0.0  0.0  1.0  0.0  0.0
 ...                                                  ...  ...  ...  ...  ...  ...
'ff4cd45896de38be_jpg.rf.c4b5e967ca10c7ced3b9e97...'  0.0  0.0  0.0  0.0  0.0  2.0
'ff4cd45896de38be_jpg.rf.ea4c1d37d2884b3e3cbce08...'  0.0  0.0  0.0  0.0  0.0  2.0
'ff5fd9c3c624b7dc_jpg.rf.bb519feaa36fc4bf630a033...'  1.0  0.0  0.0  0.0  0.0  0.0
'ff5fd9c3c624b7dc_jpg.rf.f0751c9c3aa4519ea3c9d6a...'  1.0  0.0  0.0  0.0  0.0  0.0
'fffe28b31f2a70d4_jpg.rf.7ea16bd637ba0711c53b540...'  0.0  6.0  0.0  0.0  0.0  0.0
As linhas usam caminhos absolutos para as imagens e as colunas correspondem aos índices das etiquetas de classe. As etiquetas em falta permanecem como linhas de fundo compostas apenas por zeros. Esta estrutura de dados permite aplicar a validação cruzada K-Fold a um conjunto de dados de deteção de objetos.
Divisão K-Fold do conjunto de dados#
-
Agora vamos usar a classe
KFolddesklearn.model_selectionpara gerarkdivisões do conjunto de dados.- Importante:
- Definir
shuffle=Truegarante uma distribuição aleatória das classes nas tuas divisões. - Ao definir
random_state=McomoM, um número inteiro à tua escolha, podes obter resultados reproduzíveis.
- Definir
from sklearn.model_selection import KFold ksplit = 5 kf = KFold(n_splits=ksplit, shuffle=True, random_state=20) # definir random_state para obter resultados reproduzíveis kfolds = list(kf.split(labels_df)) - Importante:
-
O conjunto de dados foi agora dividido em
kfolds, cada um com uma lista de índicestraineval. Vamos construir um DataFrame para apresentar estes resultados com mais clareza.folds = [f"split_{n}" for n in range(1, ksplit + 1)] folds_df = pd.DataFrame(index=labels_df.index, columns=folds) for i, (train, val) in enumerate(kfolds, start=1): folds_df.loc[labels_df.index[train], f"split_{i}"] = "train" folds_df.loc[labels_df.index[val], f"split_{i}"] = "val" -
Agora vamos calcular a distribuição dos rótulos de classe para cada fold, como proporção das classes presentes em
valem relação às presentes emtrain.fold_lbl_distrb = pd.DataFrame(index=folds, columns=cls_idx) for n, (train_indices, val_indices) in enumerate(kfolds, start=1): train_totals = labels_df.iloc[train_indices].sum() val_totals = labels_df.iloc[val_indices].sum() # To avoid division by zero, we add a small value (1E-7) to the denominator ratio = val_totals / (train_totals + 1e-7) fold_lbl_distrb.loc[f"split_{n}"] = ratioO cenário ideal é que as proporções de todas as classes sejam razoavelmente semelhantes em cada divisão e entre classes. No entanto, isso dependerá das características específicas do teu conjunto de dados.
-
Escreve listas de imagens e um ficheiro YAML do conjunto de dados para cada divisão. As listas de texto evitam copiar o conjunto de dados
kvezes.import yaml save_path = dataset_path.parent / f"{ksplit}-Fold_Cross-val" save_path.mkdir(parents=True, exist_ok=True) ds_yamls = [] for split in folds_df.columns: for partition in ("train", "val"): split_images = folds_df.index[folds_df[split] == partition] paths = "\n".join(map(str, split_images)) (save_path / f"{split}_{partition}.txt").write_text(f"{paths}\n") dataset_yaml = save_path / f"{split}.yaml" ds_yamls.append(dataset_yaml) with open(dataset_yaml, "w") as ds_y: yaml.safe_dump( { "path": save_path.as_posix(), "train": f"{split}_train.txt", "val": f"{split}_val.txt", "names": classes, }, ds_y, )
Guardar registos (opcional)#
Se quiseres, podes guardar os registos da divisão K-Fold e os DataFrames de distribuição dos rótulos como ficheiros CSV para consulta futura.
folds_df.to_csv(save_path / "kfold_datasplit.csv")
fold_lbl_distrb.to_csv(save_path / "kfold_label_distribution.csv")
Treinar YOLO usando divisões de dados K-Fold#
-
Primeiro, carrega o modelo YOLO.
from ultralytics import YOLO weights_path = "path/to/weights.pt" # usa yolo26n.pt para um modelo pequeno model = YOLO(weights_path, task="detect") -
Em seguida, percorre os ficheiros YAML do conjunto de dados para executar o treino. Os resultados serão guardados num diretório especificado pelos argumentos
projectename. Por predefinição, este diretório éruns/detect/train#, onde#é um índice inteiro.results = {} # Define your additional arguments here batch = 16 project = "kfold_demo" epochs = 100 for k, dataset_yaml in enumerate(ds_yamls): model = YOLO(weights_path, task="detect") results[k] = model.train( data=dataset_yaml, epochs=epochs, batch=batch, project=project, name=f"fold_{k + 1}" ) # include any additional train arguments -
Também podes usar a função autosplit do Ultralytics para dividir automaticamente o conjunto de dados:
from ultralytics.data.split import autosplit

# Dividir automaticamente o conjunto de dados em train/val/test
autosplit(path="path/to/images", weights=(0.8, 0.2, 0.0), annotated_only=True)
Conclusão#
Neste guia, explorámos o processo de utilização da validação cruzada K-Fold para treinar o modelo YOLO de deteção de objetos. Aprendemos a dividir o conjunto de treino e validação em K partições e a usar a tabela de proporções gerada para inspecionar o equilíbrio entre classes após a divisão aleatória.
Também explorámos o processo de criação de DataFrames de relatório para visualizar as divisões dos dados e as distribuições das etiquetas em cada divisão, obtendo uma visão clara da estrutura dos conjuntos de treino e validação.
Opcionalmente, guardámos os nossos registos para consulta futura, o que pode ser especialmente útil em projetos de grande escala ou ao investigar problemas de desempenho do modelo.
Por fim, implementámos o treino efetivo do modelo usando cada divisão num ciclo e guardámos os resultados do treino para análise e comparação posteriores.
Esta técnica de validação cruzada K-Fold é uma forma robusta de tirar o máximo partido dos dados disponíveis e ajuda a garantir que o desempenho do modelo é fiável e consistente em diferentes subconjuntos de dados. O resultado é um modelo mais generalizável e fiável, com menor probabilidade de sobreajustar a padrões de dados específicos.
Lembra-te de que, embora tenhamos usado YOLO neste guia, estes passos são, na sua maioria, aplicáveis a outros modelos de aprendizagem automática. Compreender estes passos permite-te aplicar a validação cruzada de forma eficaz nos teus próprios projetos de aprendizagem automática.
Perguntas frequentes#
A validação cruzada K-Fold é uma técnica que divide o conjunto de dados em «k» subconjuntos (folds) para avaliar o desempenho do modelo com maior fiabilidade. Cada fold serve tanto como dados de validação como de treino. No contexto da deteção de objetos, usar a validação cruzada K-Fold ajuda a garantir que o desempenho do teu modelo Ultralytics YOLO é robusto e generalizável entre diferentes divisões dos dados, aumentando a sua fiabilidade. Para obter instruções detalhadas sobre como configurar a validação cruzada K-Fold com Ultralytics YOLO, consulta Validação cruzada K-Fold com Ultralytics.
Para implementar a validação cruzada K-Fold com Ultralytics YOLO, segue estes passos:
- Confirma que as anotações estão no formato de deteção YOLO.
- Usa bibliotecas Python como
sklearn,pandasepyyaml. - Cria vetores de características a partir do teu conjunto de dados.
- Divide o teu conjunto de dados usando
KFolddesklearn.model_selection. - Treina o modelo YOLO em cada divisão.
Para um guia completo, consulta a secção Divisão K-Fold do conjunto de dados na nossa documentação.
O fluxo de trabalho deste guia destina-se ao formato de deteção YOLO, mas a mesma abordagem adapta-se a todas as tarefas YOLO — a tarefa altera a forma como compões os folds, não se a validação cruzada é útil:
Tarefa Conceção dos folds detectDivide ao nível da imagem, equilibrando a distribuição de objetos e classes entre os folds. Mantém imagens relacionadas (do mesmo paciente, sequência de vídeo, câmara ou local) no mesmo fold. segmentUsa a mesma estratégia ao nível da imagem que na deteção, preservando também a cobertura de máscaras e classes em cada fold. classifyPrefere folds estratificados para manter equilibradas as frequências das classes entre treino e validação. poseDivide por indivíduo ou sequência, para que a mesma pessoa ou animal nunca apareça nos dois lados de um fold. obbDivide ao nível da imagem, mantendo juntos os mosaicos ou recortes da mesma cena — algo especialmente importante para imagens aéreas. Independentemente da tarefa, mantém as amostras quase duplicadas e relacionadas fora de folds opostos: este tipo de fuga de dados infla as métricas de validação muito além do desempenho que o modelo terá em produção.
Ultralytics YOLO oferece detecção de objetos em tempo real de última geração, com alta precisão e eficiência. É versátil e oferece suporte a várias tarefas de visão computacional, como detecção, segmentação de instâncias, segmentação semântica e classificação. Além disso, integra-se a ferramentas como a Ultralytics Platform para treinamento e implantação de modelos sem código.
As tuas anotações devem seguir o formato de deteção YOLO. Cada ficheiro de anotação deve indicar a classe do objeto e as coordenadas da respetiva caixa delimitadora na imagem. O formato YOLO garante um processamento de dados simplificado e padronizado para treinar modelos de deteção de objetos. Para mais informações sobre a formatação correta das anotações, consulta o guia do formato de deteção YOLO.
Sim, podes usar a validação cruzada K-Fold com qualquer conjunto de dados personalizado, desde que as anotações estejam no formato de deteção YOLO. Substitui os caminhos do conjunto de dados e os rótulos de classe pelos específicos do teu conjunto de dados personalizado. Esta flexibilidade permite que qualquer projeto de deteção de objetos beneficie de uma avaliação robusta do modelo com validação cruzada K-Fold. Para um exemplo prático, consulta a secção Gerar vetores de características.


Comentários21
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
jingieboy
does this work with yolov8-cls? if so how would the folder structure look like? how are the data splits
 Glenn JocherUltralytics(editado)
Yes—K‑Fold works the same for classification; use the standard ImageNet-style layout per fold, and train each fold separately (YOLO infers classes from folder names). For YOLO26 (recommended) you can do:
dataset/
  split_1/
    train/
      class_a/ ...
      class_b/ ...
    val/
      class_a/ ...
      class_b/ ...
  split_2/
    train/...
    val/...
  ...
from ultralytics import YOLO weights = "yolo26n-cls.pt" # swap to 'yolov8n-cls.pt' if you prefer YOLOv8 splits = ["dataset/split_1", "dataset/split_2", "dataset/split_3"] for d in splits: model = YOLO(weights) model.train(data=d, epochs=20, batch=16) # d must contain 'train/' and 'val/' subfoldersFor building folds, use
StratifiedKFoldon image-level labels derived from parent folder names to keep class balance, or use the random splitter shown in the autosplit reference if stratification isn’t required. Classification usage details are in the classification task docs.thank you for this! I have also notice that everytime I run model.val(), the accuracies and confusion matrix values are slightly different this time. Is this normal or during evaluation, there is a small randomness when calling the function.
- Glenn JocherUltralytics
@jingieboy minor variations can occur from non-deterministic CUDA ops or multi-threading; validation itself doesn’t add randomness by default—set seeds and force deterministic ops to lock results:
import random, numpy as np, torch

seed = 0
random.seed(seed); np.random.seed(seed); torch.manual_seed(seed)
torch.backends.cudnn.deterministic = True
torch.backends.cudnn.benchmark = False

model.val()  # run evaluation
If differences are still large, double-check your eval args in the validation mode docs.
Nehasq
Hi, I am applying K-fold validation using the leave-one-out technique. My dataset consists of a single class and includes 21 images in total. For each split, I use 20 images for training and 1 image for testing. I am implementing the leave-one-out technique with the code above, setting ksplit=21.
I am not using a separate validation dataset, only training and testing data. Here is the code I am using:
results = {}
Define additional arguments here
batch = 16 project = "kfold_demo" epochs = 100
for k in range(ksplit): dataset_yaml = ds_yamls[k] model = YOLO(weights_path, task="detect") model.train(data=dataset_yaml, epochs=epochs, batch=batch, project=project) # Include any train arguments results[k] = model.metrics # Save output metrics for further analysis
In my data.yaml file, I have provided the validation path as the test set. When it trains and validates on the "1 test data," does this mean the model is being tested on data it has never seen during training? This is my first point of confusion.
my data.yaml file for each split looks like this: names:
- pothole path: ../ 2024-12-10_21-Fold_Cross-val/split_1 train: train val: test
My second question is about calculating the final performance. When I ran the above code, it calculated scores for each individual split. Do I need to calculate the final performance metrics manually, or is there any functionality in YOLOv8 to compute the aggregated performance automatically?
- Glenn JocherUltralytics
@Nehasq to address your first question, yes, the model is being tested on unseen data during each split, as the test set (1 image) is excluded from training and only used for validation. Regarding your second question, YOLO does not automatically aggregate metrics across splits. You need to compute the final performance metrics manually by averaging the results from all splits. For reference, you can review the K-Fold Cross Validation guide.
Thanks for your reply. I understand your point. So, are you saying that, for example, in my case, where I have 21 scores (precision, recall, etc.), I should simply add all the precision values together and divide the sum by 21 to get the final precision of the model? Is that correct?
Also, in y case of 20 images( training) and 1 images for test, what batch size would you suggest?
- Glenn JocherUltralytics
Yes, to calculate the final precision (or any metric), you average the values across all splits, i.e., sum all precision scores and divide by the number of splits (21 in your case). As for the batch size, given your small dataset, you could keep it low (e.g., 1 or 2) to ensure efficient utilization of the data while avoiding overfitting.
Thanks, that really helps! With a batch size of 1, I am keeping the epochs at 10. Should it be fewer? Also, to check for overfitting, I need to review the result graphs for each split. However, I can't definitively determine if it is overfitting since each split is separate, right?
- Glenn JocherUltralytics
Keeping epochs at 10 with a batch size of 1 is reasonable given your small dataset size. To check for overfitting, reviewing result graphs from each split can help, but overfitting may be harder to detect since each split involves different training and test data. Consider comparing trends across splits for consistent insights. For further details, you can reference the K-Fold Cross Validation guide.
semyon-v-dot
After the loop:
for ext in supported_extensions:
    images.extend(sorted((dataset_path / "images").rglob(f"*{ext}")))
Should be this line of code:
images = sorted(images)For
imagesmatching withlabelslist:labels = sorted(dataset_path.rglob("*labels/*.txt"))Otherwise the script creates background images because some images missing their labels.
- Glenn JocherUltralytics
@semyon-v-dot thank you for your suggestion. Sorting the
imageslist after extending it with supported extensions is a good practice to ensure alignment with thelabelslist. This helps prevent issues with missing labels.1
 sangeun jo
K-폴드 데이터 세트 분할 4번에서
images.extend(sorted((dataset_path / "images").rglob(f"*{ext}")))이 코드를images.extend(sorted(dataset_path.rglob(f"*images/*{ext}")))로 변환해야 작동했습니다.- Glenn JocherUltralytics
@sangeun-jo thank you for pointing that out. Your modification to
images.extend(sorted(dataset_path.rglob(f"*images/*{ext}")))is indeed correct and ensures the code works as intended. If you have any further questions or need additional assistance, feel free to ask!
kh-diab
is it usefult to use this k fold approach when I just have one class only but my issue is the class is detected as background or vice versa as per the attached Confusion matrix
- Glenn JocherUltralytics
@kh-diab using K-Fold Cross Validation can still be beneficial even with a single class. It helps ensure that your model's performance is robust and not overly dependent on a particular subset of the data. This can be particularly useful if you're experiencing issues with class detection accuracy, as it allows you to validate the model's performance across multiple splits and identify any inconsistencies. If your class is being detected as background or vice versa, K-Fold Cross Validation can help diagnose whether this issue is consistent across different data splits or specific to certain subsets. For more details, you can refer to our guide on K-Fold Cross Validation: https://docs.ultralytics.com/guides/kfold-cross-validation/.
alexander-sony
Good guide, consider adding it in a colab notebook.
In section "Train YOLO using K-Fold Data Splits", model should be re-initialized foe every k, i.e. it should be inside the for-loop: for k in range(ksplit).
- Glenn JocherUltralytics
@alexander-sony thank you for your feedback and suggestion! 😊
You're absolutely right about re-initializing the model within the loop for each fold to ensure a fresh start for every training iteration. This can help avoid any potential carryover effects from previous folds. Here's the corrected code snippet for the training section:
from ultralytics import YOLO

weights_path = "path/to/weights.pt"
results = {}

# Define your additional arguments here
batch = 16
project = "kfold_demo"
epochs = 100

for k in range(ksplit):
    model = YOLO(weights_path, task="detect")  # Re-initialize the model inside the loop
    dataset_yaml = ds_yamls[k]
    model.train(data=dataset_yaml, epochs=epochs, batch=batch, project=project)  # include any train arguments
    results[k] = model.metrics  # save output metrics for further analysis
Regarding your suggestion to add this guide to a Colab notebook, that's a fantastic idea! It would make the process more interactive and accessible for users. We'll consider creating a Colab version of this guide in the future.
For more details on K-Fold Cross Validation, you can refer to our comprehensive guide.
Thanks again for your valuable input! If you have any more suggestions or questions, feel free to share. Happy coding! 🚀
Likhith-Sugganahalli
@alexander-sony
woudnt that be a new model trained on each split, giving us n different models trained on 1/nth of the dataset?
 Fazri Gading
Is there any way to implement Stratified K-Fold Cross Validation with YOLOv8?
 Paula DerrengerUltralytics
Yes, you can implement Stratified K-Fold Cross Validation with YOLOv8! Stratified K-Fold ensures that each fold has a similar distribution of class labels, which can be particularly useful for imbalanced datasets.
To achieve this, you can use
StratifiedKFoldfromsklearn.model_selectioninstead ofKFold. Here's a brief example of how to modify the K-Fold implementation:from sklearn.model_selection import StratifiedKFold # Assuming labels_df is your DataFrame with class counts ksplit = 5 skf = StratifiedKFold(n_splits=ksplit, shuffle=True, random_state=20) # Generate stratified splits kfolds = list(skf.split(labels_df, labels_df.idxmax(axis=1))) # The rest of the process remains the sameFor a detailed guide on K-Fold Cross Validation, please refer to the Ultralytics documentation. If you have any more questions, feel free to ask! 😊
1