Manutenção dos teus modelos de visão computacional após a implementação
Monitorizar e manter um modelo de visão computacional significa acompanhar continuamente as suas previsões para detetar deriva dos dados e quedas de precisão, retreiná-lo com dados recentes quando o desempenho diminui e documentar cada alteração para que o trabalho continue reproduzível. Esta é a etapa final de um projeto de visão computacional — depois de recolheres os requisitos, anotares os dados, treinares o modelo e o implementares — e é o que permite que o modelo continue a cumprir os objetivos do teu projeto quando está em produção.
Assista: Como manter modelos de visão computacional após a implantação | Detecção de desvio de dados
Neste guia, vamos analisar mais de perto como podes manter os teus modelos de visão computacional após a implementação. Vamos explorar como a monitorização de modelos pode ajudar-te a detetar problemas precocemente, como manter o modelo preciso e atualizado e porque é que a documentação é importante para a resolução de problemas.
Monitorização do modelo#
É essencial acompanhar de perto os teus modelos de visão computacional implementados. Sem uma monitorização adequada, os modelos podem perder precisão. Um problema comum é a alteração da distribuição dos dados, ou deriva dos dados, em que os dados encontrados pelo modelo diferem daqueles com que foi treinado. Quando o modelo tem de fazer previsões com dados que não reconhece, pode interpretá-los incorretamente e ter um desempenho fraco. Os valores atípicos, ou pontos de dados invulgares, também podem prejudicar a precisão do modelo.
A monitorização regular do modelo ajuda os programadores a acompanhar o desempenho do modelo, detetar anomalias e resolver rapidamente problemas como a deriva de dados. Também ajuda a gerir recursos, indicando quando são necessárias atualizações, evitando reformulações dispendiosas e mantendo o modelo relevante.
Boas práticas para a monitorização de modelos#
Eis algumas boas práticas a ter em conta ao monitorizares o teu modelo de visão computacional em produção:
- Acompanha o desempenho regularmente: Monitoriza continuamente o desempenho do modelo para detetar alterações ao longo do tempo.
- Verifica novamente a qualidade dos dados: Procura valores em falta ou anomalias nos dados.
- Usa fontes de dados diversificadas: Monitoriza dados de várias fontes para obter uma visão abrangente do desempenho do modelo.
- Combina técnicas de monitorização: Usa uma combinação de algoritmos de deteção de deriva e abordagens baseadas em regras para identificar uma vasta gama de problemas.
- Monitoriza as entradas e saídas: Acompanha tanto os dados processados pelo modelo como os resultados que produz para garantir que tudo está a funcionar corretamente.
- Configura alertas: Implementa alertas para comportamentos invulgares, como quedas de desempenho, para poderes tomar rapidamente medidas corretivas.
Monitorização com Ultralytics Platform#
A Ultralytics Platform disponibiliza monitorização de modelos integrada para endpoints YOLO implementados, para que possas acompanhar o teu modelo em produção sem teres de montar uma infraestrutura de monitorização separada. O painel de implementação acompanha os principais indicadores em tempo real:
- Métricas de pedidos: Volume total de pedidos, taxa de erros e latência P95 para cada endpoint, com tendências em gráficos de linhas de 24 horas no painel e intervalos de 1 hora a 30 dias através da API de métricas.
- Verificações de estado: Verificações do estado dos endpoints que assinalam implementações com problemas e comunicam a latência das respostas.
- Registos: Registos de pedidos filtrados por gravidade (de DEBUG a CRITICAL) para diagnosticar pedidos falhados e picos de latência.
- Vista global: Um mapa-múndi interativo e cartões de resumo que apresentam todas as implementações em várias regiões numa única vista.
Como a monitorização está disponível através de URLs de endpoint padrão e de uma verificação /health, também podes integrar estes indicadores na tua configuração de observabilidade existente quando precisares de uma análise mais aprofundada. Para obteres informações de configuração, consulta o guia de monitorização da implementação.
Deteção de anomalias e sistemas de alerta#
Uma anomalia é qualquer ponto de dados ou padrão que se desvia significativamente do esperado. No contexto dos modelos de visão computacional, as anomalias podem ser imagens muito diferentes daquelas com que o modelo foi treinado. Estas imagens inesperadas podem indicar problemas como alterações na distribuição dos dados, valores atípicos ou comportamentos que possam reduzir o desempenho do modelo. Configurar sistemas de alerta para detetar estas anomalias é uma parte importante da monitorização de modelos.
Ao definir níveis de desempenho padrão e limites para métricas importantes, podes detetar problemas precocemente. Quando o desempenho ultrapassa estes limites, são acionados alertas que permitem resolver os problemas rapidamente. Atualizar e voltar a treinar regularmente os modelos com dados novos mantém-nos relevantes e precisos à medida que os dados mudam.
Configurar limites e alertas#
Ao configurares os sistemas de alerta, tem em conta estas boas práticas:
- Alertas padronizados: Usa ferramentas e formatos consistentes para todos os alertas, como o e-mail ou aplicações de mensagens como Slack. A padronização facilita a compreensão e a resposta rápida aos alertas.
- Inclui o comportamento esperado: As mensagens de alerta devem indicar claramente o que correu mal, o que era esperado e o período avaliado. Isso ajuda-te a avaliar a urgência e o contexto do alerta.
- Alertas configuráveis: Facilita a configuração dos alertas para que se adaptem às condições em mudança. Permite-te editar os limites, adiar, desativar ou confirmar os alertas.
Deteção de deriva de dados#
A deteção de deriva dos dados identifica alterações ao longo do tempo nas propriedades estatísticas dos dados de entrada, que podem degradar o desempenho do modelo. Esta técnica ajuda a detetar um problema antes de decidires retreinar ou ajustar os modelos. A deriva dos dados diz respeito a alterações no panorama geral dos dados ao longo do tempo, enquanto a deteção de anomalias se centra na identificação de pontos de dados raros ou inesperados que podem exigir atenção imediata.
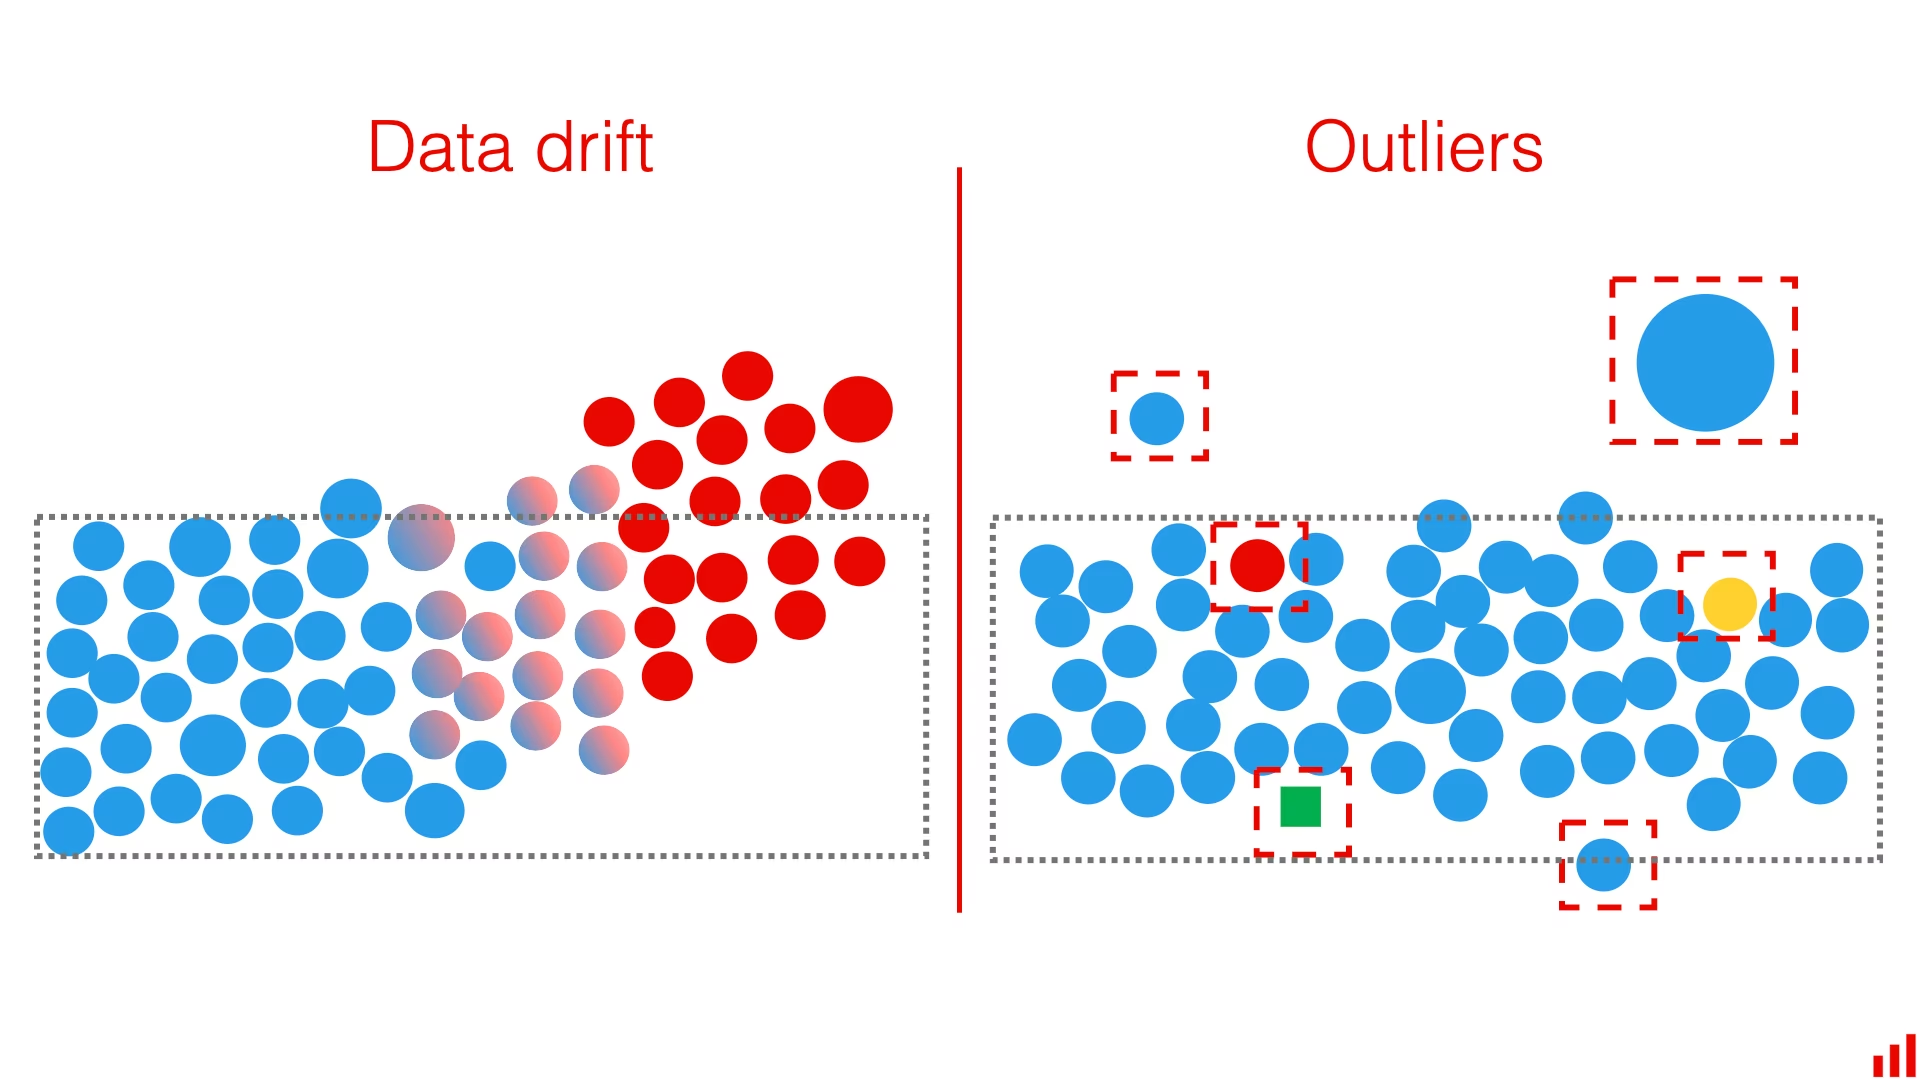
Eis vários métodos para detetar a deriva de dados:
- Monitorização contínua: Monitoriza regularmente os dados de entrada e as saídas do modelo para detetar sinais de deriva. Acompanha as métricas principais e compara-as com dados históricos para identificar alterações significativas.
- Técnicas estatísticas: Usa métodos como o teste de Kolmogorov-Smirnov ou o Índice de Estabilidade da População (PSI) para detetar alterações nas distribuições dos dados. Estes testes comparam a distribuição dos dados novos com os dados de treinamento para identificar diferenças significativas.
- Deriva de características: Monitoriza características individuais para detetar deriva. Por vezes, a distribuição geral dos dados pode manter-se estável, mas características individuais podem sofrer deriva. Identificar as características afetadas ajuda a ajustar o processo de novo treinamento.
Manutenção do modelo#
A manutenção dos modelos mantém os modelos de visão computacional precisos e relevantes ao longo do tempo, atualizando-os e voltando a treiná-los regularmente, corrigindo a deriva de dados e adaptando-os à medida que os dados e os ambientes mudam. É o complemento da monitorização: a monitorização acompanha o desempenho do modelo em tempo real para detetar problemas precocemente, enquanto a manutenção se centra em resolvê-los.
Atualizações e novo treinamento regulares#
Depois de implementar um modelo, poderás observar alterações nos padrões dos dados ou no desempenho durante a monitorização, o que indica uma deriva do modelo. As atualizações e o novo treinamento regulares tornam-se componentes essenciais da manutenção do modelo para garantir que este consegue lidar com novos padrões e cenários. Podes usar várias técnicas, dependendo da forma como os teus dados estão a mudar.
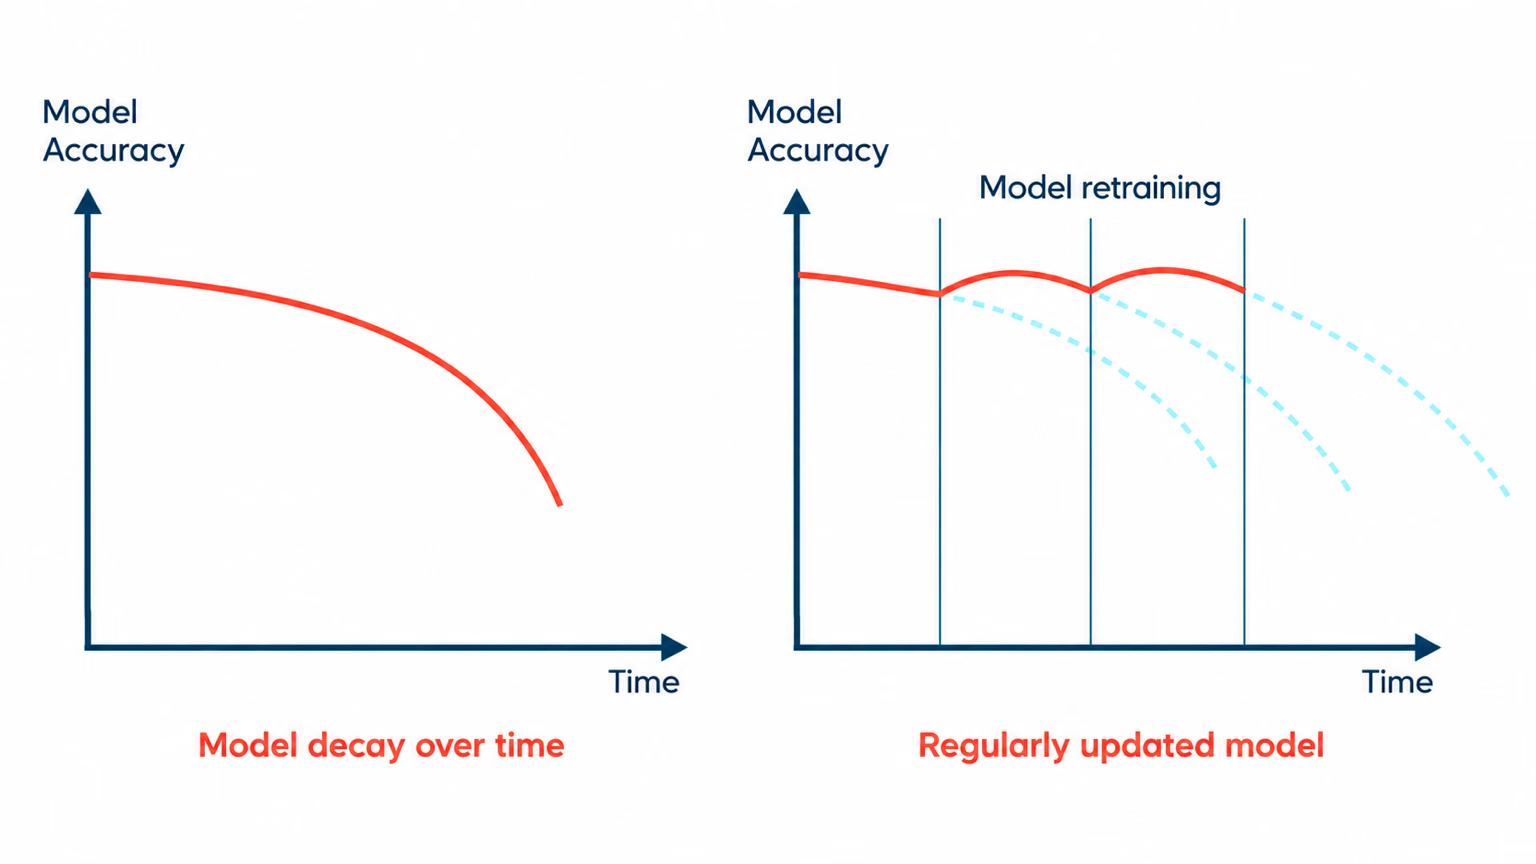
Por exemplo, se os dados estiverem a mudar gradualmente ao longo do tempo, a aprendizagem incremental é uma boa abordagem. A aprendizagem incremental consiste em atualizar o modelo com novos dados sem o retreinar completamente do zero, poupando recursos computacionais e tempo. No entanto, se os dados tiverem mudado drasticamente, um retreino completo periódico poderá ser uma opção melhor para garantir que o modelo não sobreajuste os novos dados e não perca os padrões anteriores.
Independentemente do método, a validação e os testes são indispensáveis após as atualizações. É importante validar o modelo num conjunto de dados de teste separado para verificar se o desempenho melhorou ou piorou.
Decidir quando voltar a treinar o modelo#
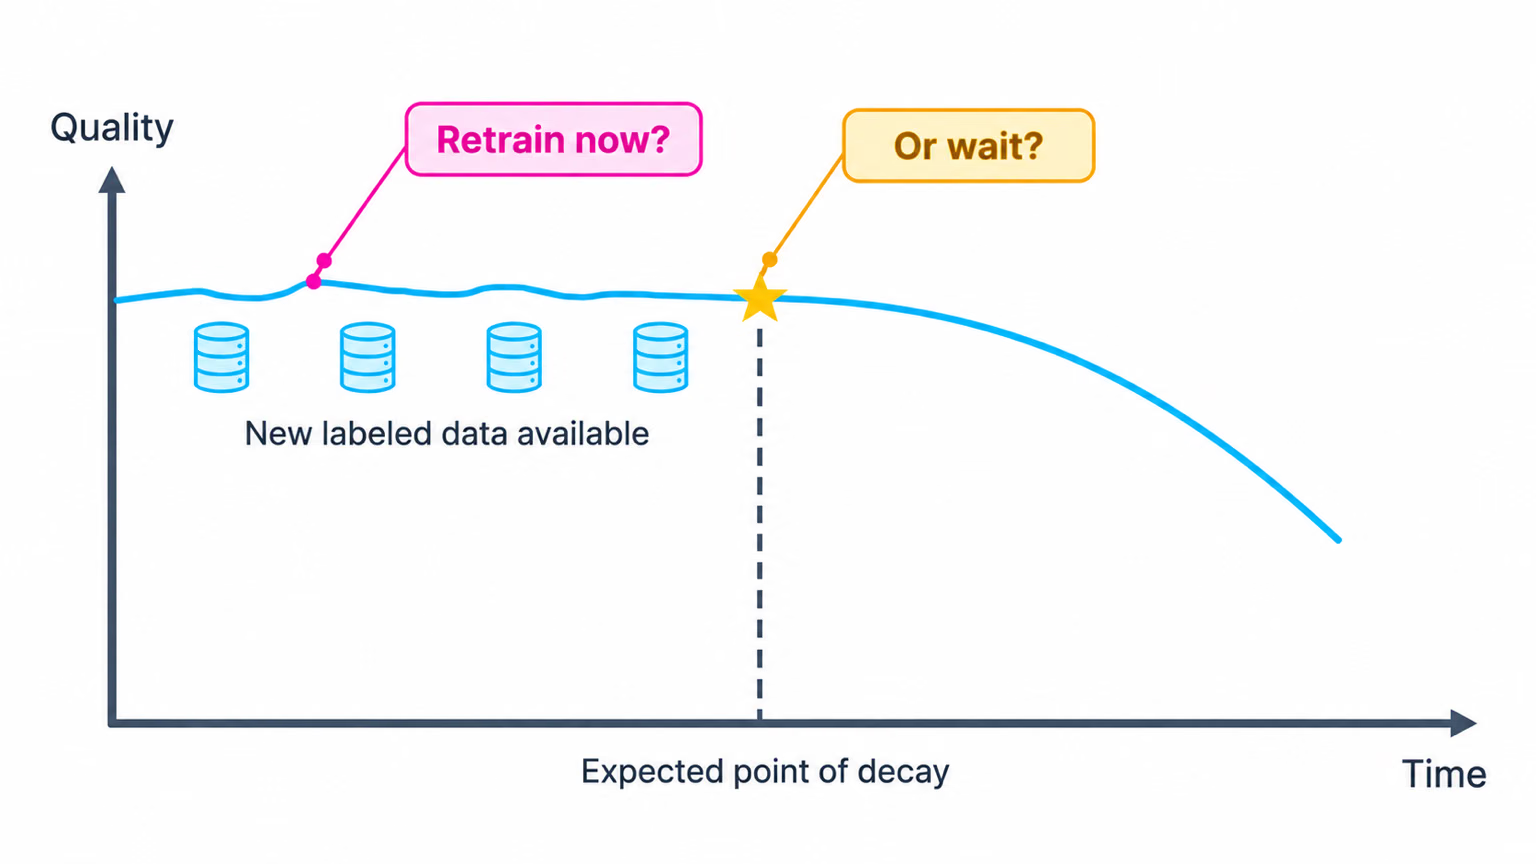
A frequência com que deves voltar a treinar o teu modelo de visão computacional depende das alterações nos dados e do desempenho do modelo. Volta a treinar o modelo sempre que observares uma queda significativa de desempenho ou detetares deriva de dados. As avaliações regulares podem ajudar a determinar o calendário de novo treinamento adequado, testando o modelo com dados novos. Monitorizar as métricas de desempenho e os padrões dos dados permite-te decidir se o modelo precisa de atualizações mais frequentes para manter a precisão.
Documentação#
Documentar um projeto de visão computacional facilita a sua compreensão, reprodução e colaboração. Uma boa documentação abrange a arquitetura do modelo, os hiperparâmetros, os conjuntos de dados, as métricas de avaliação e muito mais. Proporciona transparência, ajudando os membros da equipa e as partes interessadas a compreender o que foi feito e porquê. A documentação também ajuda na resolução de problemas, na manutenção e em melhorias futuras, fornecendo uma referência clara das decisões e dos métodos anteriores.
Elementos principais a documentar#
Estes são alguns dos principais elementos que devem ser incluídos na documentação do projeto:
- Visão geral do projeto: Apresenta um resumo de alto nível do projeto, incluindo a definição do problema, a abordagem da solução, os resultados esperados e o escopo do projeto. Explica o papel da visão computacional na resolução do problema e descreve as etapas e os entregáveis.
- Arquitetura do modelo: Detalha a estrutura e o design do modelo, incluindo seus componentes, camadas e conexões. Explica os hiperparâmetros escolhidos e a justificativa por trás dessas escolhas.
- Preparação dos dados: Descreve as fontes, os tipos, os formatos e os tamanhos dos dados, bem como as etapas de pré-processamento. Discute a qualidade e a confiabilidade dos dados e quaisquer transformações aplicadas antes do treinamento do modelo.
- Processo de treinamento: Documenta o procedimento de treinamento, incluindo os conjuntos de dados usados, os parâmetros de treinamento e as funções de perda. Explica como o modelo foi treinado e quaisquer desafios encontrados durante o treinamento.
- Métricas de avaliação: Especifica as métricas usadas para avaliar o desempenho do modelo, como acurácia, precisão, revocação e pontuação F1. Inclui os resultados de desempenho e uma análise dessas métricas.
- Etapas de implantação: Descreve as etapas realizadas para implantar o modelo, incluindo as ferramentas e plataformas utilizadas, as configurações de implantação e quaisquer desafios ou considerações específicas.
- Procedimento de monitoramento e manutenção: Apresenta um plano detalhado para monitorar o desempenho do modelo após a implantação. Inclui métodos para detectar e tratar o desvio de dados e de modelo, além de descrever o processo de atualizações regulares e retreinamento.
Conclusão#
Monitorar, manter e documentar seu modelo é o que mantém um projeto de visão computacional bem-sucedido muito depois da implantação: o monitoramento contínuo detecta problemas cedo, o retreinamento regular adapta o modelo a novos dados e ao desvio, e uma documentação clara facilita cada atualização futura. Trate isso como um ciclo contínuo e reveja as etapas do seu projeto de visão computacional à medida que seus dados e requisitos evoluem.
Perguntas frequentes#
Para monitorar um modelo de visão computacional implantado, acompanhe o volume de solicitações, a taxa de erros e a latência em produção, observando anomalias e desvios de dados que indiquem queda na acurácia. O painel Deploy da Ultralytics Platform cobre, de imediato, o monitoramento das métricas de produção, com métricas em tempo real, verificações automáticas de integridade e registros filtrados por gravidade. Monitore regularmente as entradas e saídas, configure alertas para comportamentos incomuns e use fontes de dados diversas para obter uma visão abrangente do desempenho do seu modelo. Para saber mais, consulte nossa seção sobre Monitoramento de modelos.
A manutenção de modelos de visão computacional envolve atualizações regulares, retreinamento e monitoramento para garantir que continuem precisos e relevantes. Entre as práticas recomendadas estão:
- Monitoramento contínuo: Acompanhe regularmente as métricas de desempenho e a qualidade dos dados.
- Detecção de desvio de dados: Use técnicas estatísticas para identificar mudanças nas distribuições de dados.
- Atualizações regulares e retreinamento: Implemente aprendizado incremental ou retreinamento completo periódico com base nas mudanças nos dados.
- Documentação: Mantenha uma documentação detalhada da arquitetura do modelo, dos processos de treinamento e das métricas de avaliação. Para saber mais, visite nossa seção Manutenção de modelos.
A detecção de desvio de dados é essencial porque ajuda a identificar mudanças nas propriedades estatísticas dos dados de entrada ao longo do tempo, o que pode degradar o desempenho do modelo. Técnicas como monitoramento contínuo, testes estatísticos (por exemplo, teste de Kolmogorov-Smirnov) e análise de desvio de características podem ajudar a detectar problemas cedo. Tratar o desvio de dados garante que seu modelo continue preciso e relevante em ambientes em mudança. Saiba mais sobre a detecção de desvio de dados na nossa seção Detecção de desvio de dados.
Para detectar anomalias em modelos de visão computacional, defina níveis padrão de desempenho para as principais métricas e acione alertas sempre que os valores ultrapassarem esses limites. A Ultralytics Platform oferece suporte a isso com métricas de taxa de erros e latência em tempo real, verificações automáticas de integridade e registros filtrados por gravidade, que destacam rapidamente comportamentos incomuns. Alertas configuráveis e mensagens padronizadas ajudam você a responder rapidamente a possíveis problemas. Saiba mais na nossa seção Detecção de anomalias e sistemas de alerta.
Uma documentação eficaz de um projeto de visão computacional deve incluir:
- Visão geral do projeto: Resumo de alto nível, definição do problema e abordagem da solução.
- Arquitetura do modelo: Detalhes da estrutura do modelo, dos componentes e dos hiperparâmetros.
- Preparação dos dados: Informações sobre as fontes de dados, as etapas de pré-processamento e as transformações.
- Processo de treinamento: Descrição do procedimento de treinamento, dos conjuntos de dados usados e dos desafios encontrados.
- Métricas de avaliação: Métricas usadas para avaliar e analisar o desempenho.
- Etapas de implantação: Etapas realizadas para a implantação do modelo e quaisquer desafios específicos.
- Procedimento de monitoramento e manutenção: Plano de monitoramento e manutenção contínuos. Para obter diretrizes mais abrangentes, consulte nossa seção Documentação.


Comentários4
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
SunyuKy
Hello, I am training my own dataset using yolov11. My dataset usually only contains one small target, so a large part of the image is background, which makes it easy for the model to recognize the target class as the background class. How can I modify the configuration file to improve the model performance? Will adjusting the loss gain of box and cls work?
 Glenn JocherUltralytics
@SunyuKy to improve model performance on a dataset with a small target and large background, consider adjusting the
boxandclsloss gains in the configuration file. This can help the model focus more on the target class. Additionally, experimenting with data augmentation techniques might enhance detection accuracy. For more detailed guidance, you can refer to our documentation on model monitoring and maintenance.Thank you for your reply!I would like to know in which direction the loss gain of the bounding box and classification should be adjusted. I guess I should increase the loss gain of the classification. So, should the loss gain of the bounding box be increased or decreased?
- Glenn JocherUltralytics(editado)
To improve performance, try increasing the classification loss gain (
cls) to emphasize the target class. For the bounding box loss (box), you might experiment with both increasing and decreasing it and compare validation results.