Um guia para implementar o YOLO26 nos endpoints do Amazon SageMaker
Os endpoints do Amazon SageMaker oferecem hospedagem gerenciada e escalável para modelos de visão computacional, como o Ultralytics YOLO26, em aplicações de aprendizado de máquina em produção. Uma implantação de modelo bem-sucedida depende de compreender as etapas de configuração e implantação tanto do modelo quanto da AWS.
Este guia acompanha-te passo a passo no processo de implementação de modelos PyTorch do YOLO26 nos endpoints do Amazon SageMaker. Vais aprender o essencial para preparar o teu ambiente AWS, configurar corretamente o modelo e usar ferramentas como o AWS CloudFormation e o Kit de Desenvolvimento em Nuvem da AWS (CDK) para a implementação.
Amazon SageMaker#
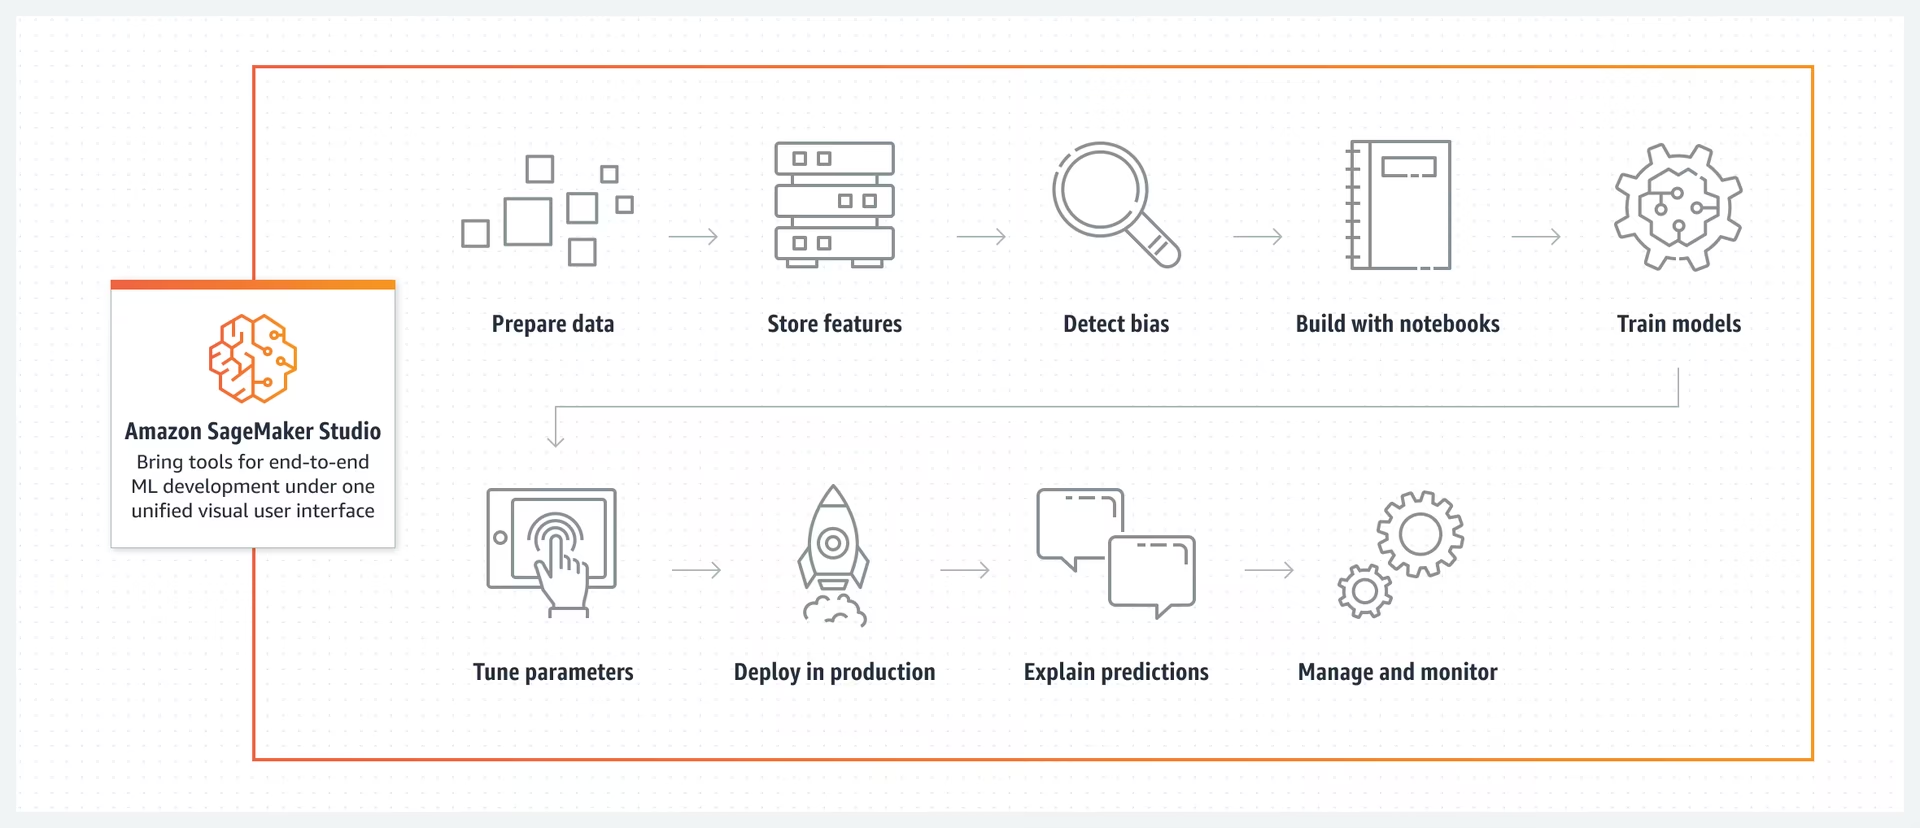
O Amazon SageMaker é um serviço de aprendizagem automática da Amazon Web Services (AWS) que simplifica o processo de criação, treino e implementação de modelos de aprendizagem automática. Disponibiliza uma vasta gama de ferramentas para gerir vários aspetos dos fluxos de trabalho de aprendizagem automática. Isso inclui funcionalidades automatizadas para ajustar modelos, opções para treinar modelos em grande escala e métodos simples para implementar modelos em produção. O SageMaker suporta frameworks populares de aprendizagem automática, oferecendo a flexibilidade necessária para projetos diversificados. As suas funcionalidades também abrangem a rotulagem de dados, a gestão de fluxos de trabalho e a análise de desempenho.
Implementar o YOLO26 nos endpoints do Amazon SageMaker#
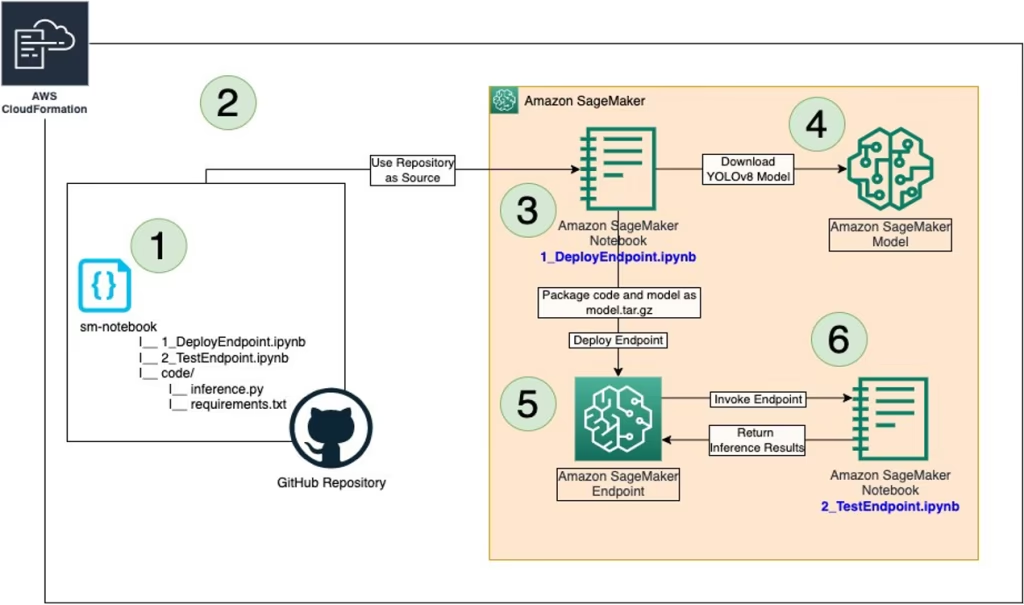
Implantar o YOLO26 no Amazon SageMaker permite usar o ambiente gerenciado para inferência em tempo real e aproveitar recursos como escalabilidade automática. Confira a arquitetura da AWS abaixo.
Etapa 1: configure seu ambiente da AWS#
Primeiro, confirma que tens os seguintes pré-requisitos:
-
Uma conta AWS: Se ainda não tiveres uma, cria uma conta AWS.
-
Funções IAM configuradas: Vais precisar de uma função IAM com as permissões necessárias para o Amazon SageMaker, o AWS CloudFormation e o Amazon S3. Esta função deve ter políticas que permitam o acesso a estes serviços.
-
AWS CLI: Se ainda não estiver instalada, transfere e instala a Interface de Linha de Comandos da AWS (CLI) e configura-a com os dados da tua conta. Segue as instruções da AWS CLI para a instalação.
-
AWS CDK: Se ainda não estiver instalado, instala o Kit de Desenvolvimento em Nuvem da AWS (CDK), que será usado para criar scripts de implementação. Segue as instruções do AWS CDK para a instalação.
-
Quota de serviço adequada: Confirma que tens quotas suficientes para dois recursos distintos no Amazon SageMaker: uma para
ml.m5.4xlarge, destinada à utilização de endpoints, e outra paraml.m5.4xlarge, destinada à utilização de instâncias de notebooks. Cada uma requer um valor de quota mínimo de um. Se as tuas quotas atuais forem inferiores a este requisito, é importante pedires um aumento para cada uma. Podes pedir um aumento de quota seguindo as instruções detalhadas na documentação das quotas de serviço da AWS.
Passo 2: Clona o repositório YOLO26 SageMaker#
O passo seguinte é clonar o repositório AWS específico que contém os recursos para implementar o YOLO26 no SageMaker. Este repositório, alojado no GitHub, inclui os scripts CDK e os ficheiros de configuração necessários.
-
Clona o repositório do GitHub: Executa o seguinte comando no terminal para clonar o repositório host-yolov8-on-sagemaker-endpoint:
git clone https://github.com/aws-samples/host-yolov8-on-sagemaker-endpoint.git -
Acede ao diretório clonado: Muda para o diretório do repositório clonado:
cd host-yolov8-on-sagemaker-endpoint/yolov8-pytorch-cdk
Passo 3: Configura o ambiente CDK#
Agora que tens o código necessário, configura o teu ambiente para implementar com o AWS CDK.
-
Cria um ambiente virtual Python: Assim, isolas o teu ambiente Python e as respetivas dependências. Executa:
python3 -m venv .venv -
Ativa o ambiente virtual:
source .venv/bin/activate -
Instala as dependências: Instala as dependências Python necessárias para o projeto:
pip3 install -r requirements.txt -
Atualiza a biblioteca AWS CDK: Confirma que tens a versão mais recente da biblioteca AWS CDK:
pip install --upgrade aws-cdk-lib
Passo 4: Cria a pilha do AWS CloudFormation#
-
Sintetiza a aplicação CDK: Gera o modelo do AWS CloudFormation a partir do teu código CDK:
cdk synth -
Inicializa a aplicação CDK: Prepara o teu ambiente AWS para a implementação com CDK:
cdk bootstrap -
Implementa a pilha: Isto criará os recursos AWS necessários e implementará o teu modelo:
cdk deploy
Passo 5: Implementa o modelo YOLO#
Depois de criares a pilha do AWS CloudFormation, o passo seguinte é implementar o YOLO26.
-
Abre a instância de notebook: Acede à consola AWS e abre o serviço Amazon SageMaker. Seleciona «Notebook Instances» no painel e, em seguida, localiza a instância de notebook criada pelo teu script de implementação CDK. Abre a instância de notebook para acederes ao ambiente Jupyter.
-
Acede a inference.py e modifica-o: Depois de abrires a instância de notebook do SageMaker no Jupyter, localiza o ficheiro inference.py. Edita a função output_fn em inference.py como mostrado abaixo e guarda as alterações no script, garantindo que não há erros de sintaxe.
import json def output_fn(prediction_output, content_type): """Formats model outputs as JSON string, extracting attributes like boxes, masks, keypoints.""" print("Executing output_fn from inference.py ...") infer = {} for result in prediction_output: if result.boxes is not None: infer["boxes"] = result.boxes.numpy().data.tolist() if result.masks is not None: infer["masks"] = result.masks.numpy().data.tolist() if result.keypoints is not None: infer["keypoints"] = result.keypoints.numpy().data.tolist() if result.obb is not None: infer["obb"] = result.obb.numpy().data.tolist() if result.probs is not None: infer["probs"] = result.probs.numpy().data.tolist() return json.dumps(infer) -
Implante o endpoint usando 1_DeployEndpoint.ipynb: no ambiente Jupyter, abra o notebook 1_DeployEndpoint.ipynb localizado no diretório sm-notebook. Defina
model_nameno notebook como um checkpoint YOLO26, comoyolo26n.pt(o padrão é um modelo YOLOv8), e execute as células para baixar o modelo, empacotá-lo com o código de inferência atualizado e carregá-lo em um bucket do Amazon S3. O notebook orientará você na criação e implantação de um endpoint SageMaker para o modelo YOLO26.
Passo 6: Testa a tua implementação#
Agora que o teu modelo YOLO26 está implementado, é importante testar o seu desempenho e funcionamento.
-
Abre o notebook de teste: No mesmo ambiente Jupyter, localiza e abre o notebook 2_TestEndpoint.ipynb, também no diretório sm-notebook.
-
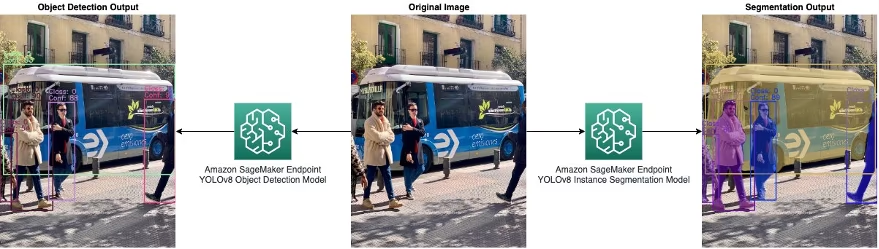
Executa o notebook de teste: Segue as instruções do notebook para testar o endpoint implementado do SageMaker. Isso inclui enviar uma imagem para o endpoint e executar inferências. Em seguida, cria um gráfico da saída para visualizar o desempenho e a precisão do modelo, como mostrado abaixo.
- Limpa os recursos: O notebook de teste também irá orientar-te no processo de remoção do endpoint e do modelo alojado. Este é um passo importante para gerir eficazmente os custos e os recursos, especialmente se não pretenderes usar o modelo implementado de imediato.
Passo 7: Monitorização e gestão#
Após os testes, é essencial monitorizar e gerir continuamente o modelo implementado.
-
Monitoriza com o Amazon CloudWatch: Verifica regularmente o desempenho e o estado do teu endpoint do SageMaker usando o Amazon CloudWatch.
-
Gere o endpoint: Usa a consola do SageMaker para gerir continuamente o endpoint. Isso inclui escalar, atualizar ou voltar a implementar o modelo conforme necessário.
Ao concluir estas etapas, você terá implantado e testado um modelo YOLO26 nos endpoints do Amazon SageMaker. O mesmo fluxo de trabalho se aplica à implantação de outros modelos na AWS.
Resumo#
Este guia explicou passo a passo como implantar o YOLO26 nos endpoints do Amazon SageMaker usando o AWS CloudFormation e o AWS Cloud Development Kit (CDK). O processo inclui clonar o repositório de exemplo da AWS a partir da publicação do AWS Machine Learning Blog sobre hospedagem de modelos YOLOv8 PyTorch nos endpoints do Amazon SageMaker, configurar o ambiente CDK, implantar o modelo usando serviços da AWS e testar seu desempenho no SageMaker.
Perguntas frequentes#
Para implantar o modelo Ultralytics YOLO26 no Amazon SageMaker Endpoints, siga estas etapas:
- Configure seu ambiente da AWS: verifique se você tem uma conta da AWS, funções do IAM com as permissões necessárias e o AWS CLI configurado. Instale o AWS CDK, caso ainda não tenha feito isso (consulte as instruções do AWS CDK).
- Clone o repositório YOLO26 SageMaker:
git clone https://github.com/aws-samples/host-yolov8-on-sagemaker-endpoint.git cd host-yolov8-on-sagemaker-endpoint/yolov8-pytorch-cdk - Configure o ambiente do CDK: crie um ambiente virtual Python, ative-o, instale as dependências e atualize a biblioteca AWS CDK.
python3 -m venv .venv source .venv/bin/activate pip3 install -r requirements.txt pip install --upgrade aws-cdk-lib - Implante usando o AWS CDK: sintetize e implante a pilha do CloudFormation e inicialize o ambiente.
cdk synth
cdk bootstrap
cdk deploy
Para implantar o YOLO26 no Amazon SageMaker, certifique-se de ter os seguintes pré-requisitos:
- Conta da AWS: conta da AWS ativa (cadastre-se na AWS.
- Funções do IAM: funções do IAM configuradas com permissões para o SageMaker, o CloudFormation e o Amazon S3.
- AWS CLI: interface de linha de comando da AWS instalada e configurada (guia de instalação do AWS CLI).
- AWS CDK: AWS Cloud Development Kit instalado (guia de configuração do CDK).
- Cotas de serviço: cotas suficientes para instâncias
ml.m5.4xlargepara uso tanto com endpoints quanto com notebooks (solicite um aumento de cota).
Usar o Ultralytics YOLO26 no Amazon SageMaker oferece várias vantagens:
- Escalabilidade e gerenciamento: o SageMaker oferece um ambiente gerenciado com recursos como escalabilidade automática, que atende às necessidades de inferência em tempo real.
- Integração com serviços da AWS: integre outros serviços da AWS, como o S3 para armazenamento de dados, o CloudFormation para infraestrutura como código e o CloudWatch para monitoramento.
- Facilidade de implantação: configuração simplificada com scripts do AWS CDK e processos de implantação otimizados.
- Desempenho: use a infraestrutura gerenciada do Amazon SageMaker para executar cargas de trabalho de inferência em grande escala.
Sim, você pode personalizar a lógica de inferência do YOLO26 no Amazon SageMaker:
-
Modifique
inference.py: localize e personalize a funçãooutput_fnno arquivoinference.pypara adaptar os formatos de saída.import json def output_fn(prediction_output, content_type): """Formats model outputs as JSON string, extracting attributes like boxes, masks, keypoints.""" infer = {} for result in prediction_output: if result.boxes is not None: infer["boxes"] = result.boxes.numpy().data.tolist() # Adicione mais lógica de processamento, se necessário return json.dumps(infer) -
Implante o modelo atualizado: para incluir essas alterações, implante novamente o modelo usando os notebooks Jupyter fornecidos (
1_DeployEndpoint.ipynb).
Consulte as etapas detalhadas para implantar o modelo modificado.
-
Para testar o modelo YOLO26 implantado no Amazon SageMaker:
- Abra o notebook de teste: localize o notebook
2_TestEndpoint.ipynbno ambiente Jupyter do SageMaker. - Execute o notebook: siga as instruções do notebook para enviar uma imagem ao endpoint, executar a inferência e exibir os resultados.
- Visualize os resultados: use o código de plotagem do notebook para desenhar as caixas delimitadoras previstas na imagem de teste.
Para ver instruções completas de teste, acesse a seção de testes.
- Abra o notebook de teste: localize o notebook


Comentários10
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
 User
I want to upload the YOLOv8 model I trained on my own dataset to Jupyter, and then compress it into a
model.tar.gzfile following the officialdeployendpointsteps. However, when I usetestendpoint, I encounter an error. If I rename my trained model toyolov8, the test succeeds, but it uses the original model from the official website instead of my custom one. How should I modifyinference.pyto ensure it loads my trained model?1 Glenn JocherUltralytics
@lijoe123 to ensure your custom YOLOv8 model is used, modify the
inference.pyto load your model by specifying its path directly. Ensure the model name in your deployment matches your custom model's name. For detailed steps, refer to the Ultralytics documentation on Amazon SageMaker.- User
Thank you for your answer. I had followed the
1_DeployEndpoint.ipynbto delpoy my own model. In the 1.4 Create the SageMaker PyTorchModel, I had set theenv={'TS_MAX_RESPONSE_SIZE':'20000000', 'MY_MODEL': 'my_own_model'}. And in theinference.py:def model_fn(model_dir): print("Executing model_fn from inference.py ...") env = os.environ model = YOLO(os.path.join(model_dir, env['MY_MODEL'])) return modelI think it will be use my own model directly. But it failed, and it occur this problem:
ModelError: An error occurred (ModelError) when calling the InvokeEndpoint operation: Received server error (0)from primary with message "Your invocation timed out while waiting for a response from container primary. Reviewthe latency metrics for each container in Amazon Cloudatch, resolve the issue, and try again.". See https://useast-1. console. aws. aazon. com/cloudwatch/home?region=us-east-1#logEventViewer: group=/aws/sagemaker Endpoints/yolov8-pytorch-2024-09-06-11-33-49-418696 in account 211125332801 for more information.Could you tell me how to modify the
inference.pyto load my own model. Thank you so much. - Glenn JocherUltralytics
To ensure your custom YOLOv8 model is used, verify that the
model_fnininference.pycorrectly points to your model's path. Ensure theMY_MODELenvironment variable matches your model's filename. If issues persist, check CloudWatch logs for detailed error messages. For further guidance, refer to the Ultralytics documentation on Amazon SageMaker.
SJTUPanda
Thanks for your sharing, it's very clear and useful. My own deployment workflow on AWS has already built but the test result is not so satisfying. The performance of detection result of yolo11-xl on AWS is worse than on my own laptop. I not sure if there is some default quantization when it's deployed to the AWS(I did not modified much to host-yolov8-on-sagemaker-endpoint), or do you have some other ideas about which would bring this significant performance differences?
- Glenn JocherUltralytics
@SJTUPanda thank you for your feedback! The performance difference could stem from several factors like hardware disparities (AWS instance vs laptop GPU), inference settings, or environment configurations. First, verify that your SageMaker instance type matches your local hardware capabilities, and ensure identical inference parameters (e.g.,
imgsz,batch). Check our Amazon SageMaker deployment guide for optimization tips and consider profiling both environments withyolo valto isolate bottlenecks. Let us know if specific metrics differ! 🚀 Thanks for your quick reply. The issue is fixed after I comment out resize related code. Although the model is trained with (640,640) and the input image size is (720,440), using the raw images directly as input is better than resized it. I am curious the input images would be auto-resized by the model just as in the training/testing part? And why resized by myself has so much impact on the results? If these part code should be update because yolo version updating?
image_height, image_width, _ = orig_image.shape model_height, model_width = 640, 640 x_ratio = image_width/model_width y_ratio = image_height/model_height # Resize the image as numpy array resized_image = cv2.resize(orig_image, (model_height, model_width)) # Conver the array into jpeg resized_jpeg = cv2.imencode('.jpg', resized_image)[1] # Serialize the jpg using base 64 payload = base64.b64encode(resized_jpeg).decode('utf-8')- Glenn JocherUltralytics
Thank you for sharing your findings! YOLO models do automatically resize inputs to match their training dimensions while preserving aspect ratio with letterboxing. Manual resizing can distort aspect ratios or introduce artifacts, potentially degrading performance. We recommend using the model's native preprocessing by feeding full-size images directly, as this maintains proper scaling and aspect ratio handling. For implementation details, refer to our model deployment best practices regarding input consistency.
NikoXanthidis
Gostaria de saber se esses recursos são pagos.
- Glenn JocherUltralytics
Olá! 👋 Os recursos mencionados para implementar o YOLOv8 no Amazon SageMaker não são pagos por si só. No entanto, o uso do Amazon SageMaker e outros serviços da AWS associados à implementação e execução do modelo podem incorrer em custos conforme o uso. A AWS oferece uma camada gratuita que você pode aproveitar para experimentar alguns serviços sem custo, mas é sempre bom verificar a página de preços do SageMaker para detalhes específicos. Se precisar de ajuda para estimar os custos ou tiver outras dúvidas, estou aqui para ajudar! 🚀