Mobile Segment Anything (MobileSAM)#
O MobileSAM é um modelo compacto e eficiente de segmentação de imagens, desenvolvido especialmente para dispositivos móveis e de borda. Projetado para levar o poder do Modelo Segment Anything da Meta (SAM) a ambientes com capacidade computacional limitada, o MobileSAM oferece segmentação quase instantânea e mantém a compatibilidade com o pipeline SAM original. Seja para desenvolver aplicações em tempo real ou implantações leves, o MobileSAM oferece resultados de segmentação impressionantes com uma fração dos requisitos de tamanho e velocidade dos modelos anteriores.
Assista: Como executar inferência com MobileSAM usando Ultralytics | Guia passo a passo 🎉
O MobileSAM foi adotado em diversos projetos, incluindo Grounding-SAM, AnyLabeling e Segment Anything in 3D.
O MobileSAM foi treinado em uma única GPU, usando um conjunto de dados com 100 mil imagens (1% das imagens originais), em menos de um dia.
Modelos disponíveis, tarefas compatíveis e modos de operação#
A tabela abaixo descreve o modelo MobileSAM disponível, seus pesos pré-treinados, as tarefas compatíveis e a compatibilidade com diferentes modos de operação, como Inferência, Validação, Treinamento e Exportação. Os modos compatíveis são indicados por ✅ e os incompatíveis por ❌.
| Tipo de modelo | Pesos pré-treinados | Tarefas suportadas | Treinamento | Validação | Inferência | Exportar |
|---|---|---|---|---|---|---|
| MobileSAM | mobile_sam.pt | Segmentação de instâncias | ❌ | ❌ | ✅ | ❌ |
Comparação do MobileSAM com YOLO#
A comparação a seguir destaca as diferenças entre as variantes SAM da Meta, o MobileSAM e os modelos de segmentação da Ultralytics, incluindo YOLO26n-seg:
| Modelo | Tamanho (MB) | Parâmetros (M) | Velocidade (CPU) (ms/im) |
|---|---|---|---|
| Meta SAM-b | 375 | 93.7 | 41703 |
| Meta SAM2-b | 162 | 80.8 | 28867 |
| Meta SAM2-t | 78.1 | 38.9 | 23430 |
| MobileSAM | 40.7 | 10.1 | 23802 |
| FastSAM-s com backbone YOLOv8 | 23.9 | 11.8 | 58.0 |
| Ultralytics YOLOv8n-seg | 7.1 (11.0x menor) | 3.4 (11.4x menos) | 24.8 (945x mais rápido) |
| Ultralytics YOLO11n-seg | 6.2 (12.6x menor) | 2.9 (13.4x menos) | 24.3 (964x mais rápido) |
| Ultralytics YOLO26n-seg | 6.7 (11.7x menor) | 2.7 (14.4x menos) | 25.2 (930x mais rápido) |
Esta comparação demonstra as diferenças substanciais no tamanho e na velocidade dos modelos entre as variantes do SAM e os modelos de segmentação YOLO. Embora os modelos SAM ofereçam recursos exclusivos de segmentação automática, os modelos YOLO — especialmente YOLOv8n-seg, YOLO11n-seg e YOLO26n-seg — são significativamente menores, mais rápidos e mais eficientes do ponto de vista computacional.
As velocidades do SAM foram medidas com PyTorch, e as velocidades do YOLO, com ONNX Runtime. Os testes foram executados em um Apple M4 Air de 2025 com 16 GB de RAM, usando torch==2.10.0, ultralytics==8.4.31 e onnxruntime==1.24.4. Para reproduzir estes resultados:
from ultralytics import ASSETS, SAM, YOLO, FastSAM

# Avalie o desempenho de SAM2-t, SAM2-b, SAM-b, MobileSAM
for file in ["sam_b.pt", "sam2_b.pt", "sam2_t.pt", "mobile_sam.pt"]:
    model = SAM(file)
    model.info()
    model(ASSETS)

# Perfilar FastSAM-s
model = FastSAM("FastSAM-s.pt")
model.info()
model(ASSETS)

# Avalie o desempenho dos modelos YOLO (ONNX)
for file_name in ["yolov8n-seg.pt", "yolo11n-seg.pt", "yolo26n-seg.pt"]:
    model = YOLO(file_name)
    model.info()
    onnx_path = model.export(format="onnx", dynamic=True, nms=False)  # Cabeça sem NMS do YOLO26; sem efeito para YOLOv8/YOLO11
    model = YOLO(onnx_path)
    model(ASSETS)
Adaptação do SAM para o MobileSAM#
O MobileSAM mantém o mesmo pipeline do SAM original, incluindo o pré-processamento, o pós-processamento e todas as interfaces. Isso significa que você pode migrar do SAM para o MobileSAM com mudanças mínimas no seu fluxo de trabalho.
A principal diferença está no codificador de imagens: o MobileSAM substitui o codificador ViT-H original (637M parâmetros) por um codificador Tiny-ViT muito menor (5M parâmetros). Em uma única GPU, o MobileSAM processa uma imagem em cerca de 12 ms (8 ms para o codificador, 4 ms para o decodificador de máscaras).
Comparação de codificadores de imagem baseados em ViT#
| Codificador de imagens | SAM original | MobileSAM |
|---|---|---|
| Parâmetros | 637M | 5M |
| Velocidade | 452ms | 8ms |
Decodificador de máscaras guiado por prompts#
| Decodificador de máscaras | SAM original | MobileSAM |
|---|---|---|
| Parâmetros | 3.876M | 3.876M |
| Velocidade | 4ms | 4ms |
Comparação do pipeline completo#
| Pipeline completo (encodificador + decodificador) | SAM original | MobileSAM |
|---|---|---|
| Parâmetros | 641M | 9.66M |
| Velocidade | 456ms | 12ms |
O desempenho do MobileSAM e do SAM original é ilustrado abaixo usando prompts de pontos e de caixas delimitadoras.
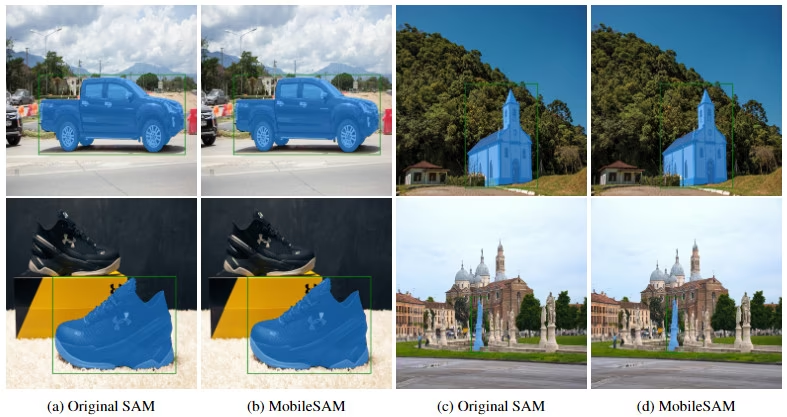
O MobileSAM é aproximadamente 7 vezes menor e 5 vezes mais rápido que o FastSAM. Para mais detalhes, visite a página do projeto MobileSAM.
Testando o MobileSAM no Ultralytics#
Assim como o SAM original, o Ultralytics oferece uma interface simples para testar o MobileSAM, compatível com prompts de pontos e de caixas delimitadoras.
Download do modelo#
Baixe os pesos pré-treinados do MobileSAM em recursos do Ultralytics.
Prompt de ponto#
from ultralytics import SAM

# Carrega o modelo
model = SAM("mobile_sam.pt")

# Prever um segmento com base em um único prompt de ponto
model.predict("ultralytics/assets/zidane.jpg", points=[900, 370], labels=[1])

# Prever vários segmentos com base em vários prompts de pontos
model.predict("ultralytics/assets/zidane.jpg", points=[[400, 370], [900, 370]], labels=[1, 1])

# Prever um segmento com base em vários prompts de pontos por objeto
model.predict("ultralytics/assets/zidane.jpg", points=[[[400, 370], [900, 370]]], labels=[[1, 1]])

# Prever um segmento usando prompts positivos e negativos.
model.predict("ultralytics/assets/zidane.jpg", points=[[[400, 370], [900, 370]]], labels=[[1, 0]])
Prompt de caixa delimitadora#
from ultralytics import SAM

# Carrega o modelo
model = SAM("mobile_sam.pt")

# Prever um segmento com base em um único prompt de caixa delimitadora
model.predict("ultralytics/assets/zidane.jpg", bboxes=[439, 437, 524, 709])

# Prever vários segmentos com base em vários prompts de caixas delimitadoras
model.predict("ultralytics/assets/zidane.jpg", bboxes=[[439, 437, 524, 709], [114, 196, 313, 708]])
MobileSAM e SAM têm a mesma API. Para mais detalhes de uso, consulte a documentação do SAM.
Crie conjuntos de dados de segmentação automaticamente usando um modelo de detecção#
Para anotar seu conjunto de dados automaticamente com o framework Ultralytics, use a função auto_annotate, conforme mostrado abaixo:
from ultralytics.data.annotator import auto_annotate

auto_annotate(data="path/to/images", det_model="yolo26x.pt", sam_model="mobile_sam.pt")| Argumento | Tipo | Padrão | Descrição |
|---|---|---|---|
data | str | obrigatório | Caminho para o diretório que contém as imagens de destino para anotação ou segmentação. |
det_model | str | 'yolo26x.pt' | Caminho para o modelo de detecção YOLO usado na detecção inicial de objetos. |
sam_model | str | 'sam_b.pt' | Caminho para o modelo SAM usado na segmentação (compatível com pesos de SAM, SAM 2, MobileSAM e SAM 3). |
device | str | '' | Dispositivo de computação (por exemplo, 'cuda:0', 'cpu' ou '' para detecção automática do dispositivo). |
conf | float | 0.25 | Limite de confiança para a detecção YOLO, usado para filtrar detecções fracas. |
iou | float | 0.45 | Limite de IoU para a supressão não máxima, usada para filtrar caixas sobrepostas. |
imgsz | int | 640 | Tamanho de entrada para redimensionar as imagens (arredondado para cima até um múltiplo de 32, se necessário). |
max_det | int | 300 | Número máximo de detecções por imagem para economizar memória. |
classes | list[int] | None | Lista de índices de classes a detectar (por exemplo, [0, 1] para pessoa e bicicleta). |
output_dir | str | None | Diretório para salvar as anotações (por padrão: diretório irmão de <data>_auto_annotate_labels). |
Citações e agradecimentos#
Se o MobileSAM for útil para sua pesquisa ou desenvolvimento, considere citar o artigo a seguir:
@article{mobile_sam,
  title={Faster Segment Anything: Towards Lightweight SAM for Mobile Applications},
  author={Zhang, Chaoning and Han, Dongshen and Qiao, Yu and Kim, Jung Uk and Bae, Sung Ho and Lee, Seungkyu and Hong, Choong Seon},
  journal={arXiv preprint arXiv:2306.14289},
  year={2023}
}
Leia o artigo completo do MobileSAM no arXiv.
Perguntas frequentes#
O MobileSAM é um modelo leve e rápido de segmentação de imagens, otimizado para aplicações móveis e de borda. Ele mantém o mesmo pipeline do SAM original, mas substitui o grande codificador ViT-H (637M parâmetros) por um codificador Tiny-ViT compacto (5M parâmetros). Isso torna o pipeline completo do MobileSAM cerca de 66 vezes menor que o do SAM original (9.66M contra 641M parâmetros) e cerca de 38 vezes mais rápido, operando a aproximadamente 12 ms por imagem, em comparação com os 456 ms do SAM. Saiba mais sobre a implementação do MobileSAM no repositório do MobileSAM no GitHub.
Testar o MobileSAM no Ultralytics é simples. Você pode usar prompts de pontos e de caixas delimitadoras para prever segmentos. Por exemplo, usando um prompt de ponto:
from ultralytics import SAM

# Carrega o modelo
model = SAM("mobile_sam.pt")

# Prever um segmento com base em um prompt de ponto
model.predict("ultralytics/assets/zidane.jpg", points=[900, 370], labels=[1])
Para mais detalhes, consulte a seção Testando o MobileSAM no Ultralytics.
O MobileSAM é ideal para aplicações móveis e de borda graças ao seu design leve e à inferência rápida. Em comparação com o SAM original, o MobileSAM tem cerca de 66 vezes menos parâmetros e executa cerca de 38 vezes mais rápido, o que o torna adequado para segmentação em tempo real em dispositivos com recursos computacionais limitados. Sua eficiência permite que dispositivos móveis realizem segmentação de imagens em tempo real sem latência significativa. Além disso, o MobileSAM é compatível com o modo de inferência otimizado para desempenho em dispositivos móveis.
O MobileSAM foi treinado em uma única GPU com um conjunto de dados de 100 mil imagens (1% das imagens do SA-1B original) em menos de um dia, destilando o codificador de imagens ViT-H do SAM em um codificador Tiny-ViT. Os pesos pré-treinados e os detalhes da implementação estão disponíveis no repositório do MobileSAM no GitHub.
O MobileSAM foi projetado para segmentação de imagens rápida e eficiente em ambientes móveis e de borda. Os principais casos de uso incluem:
- Detecção e segmentação de objetos em tempo real para aplicativos móveis
- Processamento de imagens com baixa latência em dispositivos com capacidade computacional limitada
- Integração em aplicativos móveis com IA para realidade aumentada (AR), análise de dados e muito mais
Para mais detalhes sobre casos de uso e desempenho, consulte Adaptação do SAM para o MobileSAM e o artigo do Ultralytics sobre aplicações do Segment Anything.