Meituan YOLOv6#
Visão geral#
O Meituan YOLOv6, lançado em 2022, oferece um equilíbrio sólido entre velocidade e precisão, tornando-se uma escolha popular para aplicações em tempo real. Este modelo introduz várias melhorias notáveis na sua arquitetura e no esquema de treinamento, incluindo a implementação de um módulo de Concatenação bidirecional (BiC), uma estratégia de treinamento assistido por âncoras (AAT) e um design aprimorado do backbone e do neck para obter alta precisão no conjunto de dados COCO.
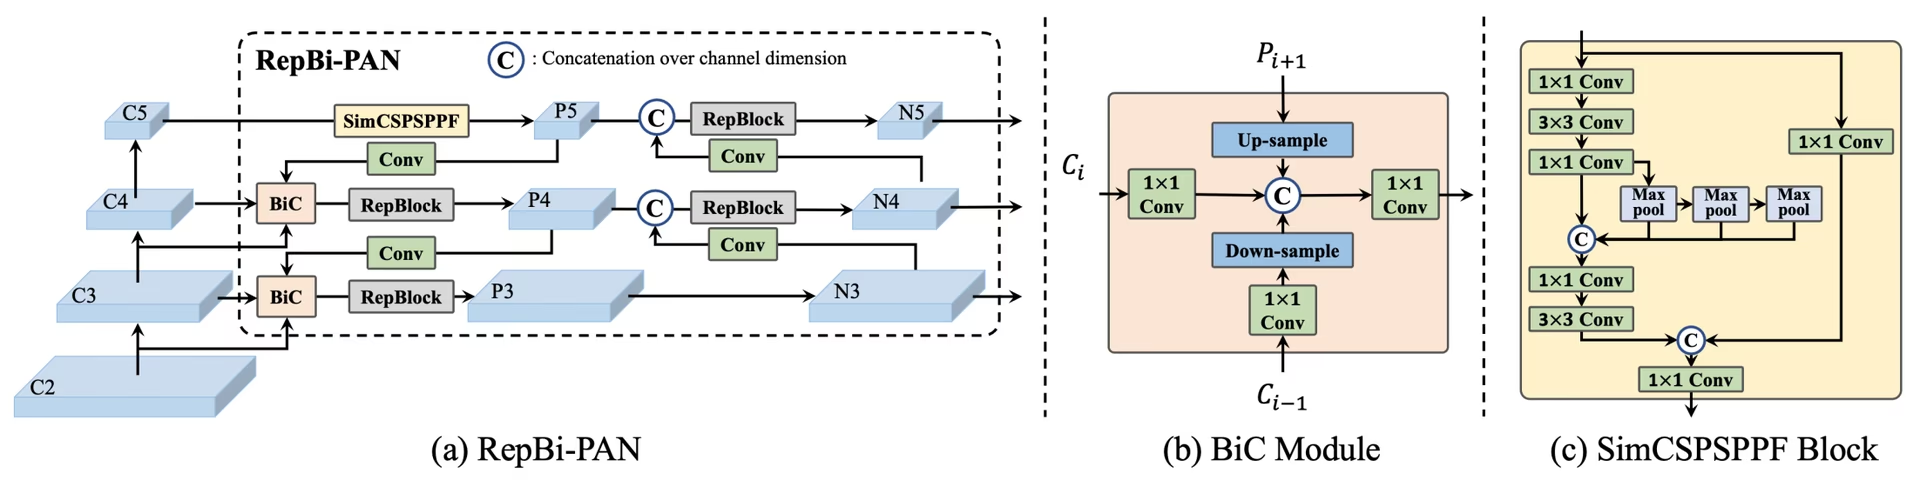 Visão geral do YOLOv6. Diagrama da arquitetura do modelo mostrando os componentes de rede reprojetados e as estratégias de treinamento que resultaram em melhorias significativas de desempenho. (a) O neck do YOLOv6 (N e S são mostrados). Observação: para M/L, RepBlocks é substituído por CSPStackRep. (b) A estrutura de um módulo BiC. (c) Um bloco SimCSPSPPF. (fonte).
Principais funcionalidades#
- Módulo de Concatenação bidirecional (BiC): o YOLOv6 introduz um módulo BiC no neck do detector, aprimorando os sinais de localização e proporcionando ganhos de desempenho com degradação insignificante da velocidade.
- Estratégia de treinamento assistido por âncoras (AAT): este modelo propõe o AAT para aproveitar os benefícios dos paradigmas baseado em âncoras e sem âncoras sem comprometer a eficiência da inferência.
- Design aprimorado do backbone e do neck: ao aprofundar o YOLOv6 para incluir outra etapa no backbone e no neck, este modelo alcançou um desempenho sólido no conjunto de dados COCO com entrada de alta resolução quando foi lançado.
- Estratégia de autodestilação: uma nova estratégia de autodestilação é implementada para aumentar o desempenho dos modelos menores do YOLOv6, aprimorando o ramo auxiliar de regressão durante o treinamento e removendo-o na inferência para evitar uma queda acentuada de velocidade.
Métricas de desempenho#
O YOLOv6 oferece vários modelos pré-treinados com diferentes escalas:
- YOLOv6-N: 37,5% de AP no COCO val2017 a 1187 FPS com uma GPU NVIDIA T4.
- YOLOv6-S: 45,0% de AP a 484 FPS.
- YOLOv6-M: 50,0% de AP a 226 FPS.
- YOLOv6-L: 52,8% de AP a 116 FPS.
- YOLOv6-L6: precisão de última geração em tempo real.
O YOLOv6 também oferece modelos quantizados para diferentes precisões e modelos otimizados para plataformas móveis.
Exemplos de utilização#
Este exemplo fornece exemplos simples de treinamento e inferência do YOLOv6. Para obter a documentação completa sobre estes e outros modos, consulte as páginas de documentação de Predição, Treinamento, Validação e Exportação.
Os arquivos *.yaml do YOLOv6 podem ser passados para a classe YOLO() para criar o modelo correspondente em Python:
from ultralytics import YOLO

# Build a YOLOv6n model from scratch
model = YOLO("yolov6n.yaml")

# Display model information (optional)
model.info()

# Train the model on the COCO8 example dataset for 100 epochs
results = model.train(data="coco8.yaml", epochs=100, imgsz=640)

# Run inference with the YOLOv6n model on the 'bus.jpg' image
results = model("path/to/bus.jpg")
Tarefas e modos suportados#
A série YOLOv6 oferece uma variedade de modelos, cada um otimizado para Detecção de objetos de alto desempenho. Esses modelos atendem a diferentes necessidades computacionais e requisitos de precisão, tornando-os versáteis para uma ampla variedade de aplicações.
| Modelo | Nomes dos ficheiros | Tarefas | Treino | Validação | Inferência | Exportar |
|---|---|---|---|---|---|---|
| YOLOv6-N | yolov6n.yaml | Deteção de objetos | ✅ | ✅ | ✅ | ✅ |
| YOLOv6-S | yolov6s.yaml | Deteção de objetos | ✅ | ✅ | ✅ | ✅ |
| YOLOv6-M | yolov6m.yaml | Deteção de objetos | ✅ | ✅ | ✅ | ✅ |
| YOLOv6-L | yolov6l.yaml | Deteção de objetos | ✅ | ✅ | ✅ | ✅ |
| YOLOv6-X | yolov6x.yaml | Deteção de objetos | ✅ | ✅ | ✅ | ✅ |
Esta tabela fornece uma visão geral detalhada das variantes do modelo YOLOv6, destacando suas capacidades em tarefas de detecção de objetos e sua compatibilidade com vários modos operacionais, como Inferência, Validação, Treinamento e Exportação. Esse suporte abrangente garante que você possa aproveitar totalmente os recursos dos modelos YOLOv6 em uma ampla variedade de cenários de detecção de objetos.
Citações e agradecimentos#
Gostaríamos de agradecer aos autores pelas suas contribuições significativas para o campo da detecção de objetos em tempo real:
@misc{li2023yolov6,
      title={YOLOv6 v3.0: A Full-Scale Reloading},
      author={Chuyi Li and Lulu Li and Yifei Geng and Hongliang Jiang and Meng Cheng and Bo Zhang and Zaidan Ke and Xiaoming Xu and Xiangxiang Chu},
      year={2023},
      eprint={2301.05586},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
O artigo original do YOLOv6 pode ser encontrado no arXiv. Os autores disponibilizaram publicamente o seu trabalho, e a base de código pode ser acessada no GitHub. Agradecemos os seus esforços para avançar o campo e tornar o seu trabalho acessível à comunidade em geral.
Perguntas frequentes#
O Meituan YOLOv6, lançado em 2022, é um detector de objetos que equilibra velocidade e precisão, projetado para aplicações em tempo real. Ele apresenta melhorias arquiteturais notáveis, como o módulo de Concatenação bidirecional (BiC) e uma estratégia de treinamento assistido por âncoras (AAT). Essas inovações proporcionam ganhos substanciais de desempenho com uma degradação mínima da velocidade, tornando o YOLOv6 uma opção competitiva para tarefas de detecção de objetos.
O módulo de Concatenação bidirecional (BiC) do YOLOv6 aprimora os sinais de localização no neck do detector, proporcionando melhorias de desempenho com impacto insignificante na velocidade. Esse módulo combina efetivamente diferentes mapas de características, aumentando a capacidade do modelo de detectar objetos com precisão. Para obter mais detalhes sobre os recursos do YOLOv6, consulte a seção Principais recursos.
Você pode treinar um modelo YOLOv6 usando o Ultralytics com comandos simples do Python ou da CLI. Por exemplo:
Exemplofrom ultralytics import YOLO # Build a YOLOv6n model from scratch model = YOLO("yolov6n.yaml") # Train the model on the COCO8 example dataset for 100 epochs results = model.train(data="coco8.yaml", epochs=100, imgsz=640)Para obter mais informações, visite a página de Treinamento.
O YOLOv6 oferece várias versões, cada uma otimizada para diferentes requisitos de desempenho:
- YOLOv6-N: 37,5% de AP a 1187 FPS
- YOLOv6-S: 45,0% de AP a 484 FPS
- YOLOv6-M: 50,0% de AP a 226 FPS
- YOLOv6-L: 52,8% de AP a 116 FPS
- YOLOv6-L6: precisão de última geração em cenários de tempo real
Esses modelos são avaliados no conjunto de dados COCO usando uma GPU NVIDIA T4. Para saber mais sobre as métricas de desempenho, consulte a seção Métricas de desempenho.
O treinamento assistido por âncoras (AAT) no YOLOv6 combina elementos das abordagens baseada em âncoras e sem âncoras, aprimorando as capacidades de detecção do modelo sem comprometer a eficiência da inferência. Essa estratégia utiliza âncoras durante o treinamento para melhorar as previsões de caixas delimitadoras, tornando o YOLOv6 eficaz em diversas tarefas de detecção de objetos.
O YOLOv6 é compatível com vários modos operacionais, incluindo Inferência, Validação, Treinamento e Exportação. Essa flexibilidade permite que você aproveite totalmente os recursos do modelo em diferentes cenários. Consulte a seção Tarefas e modos compatíveis para obter uma visão geral detalhada de cada modo.