Датасет Caltech-256
Датасет Caltech-256 — классический бенчмарк для классификации изображений, содержащий 30 607 изображений из 256 категорий объектов и одного класса фона. В каждой категории не менее 80 изображений реальных объектов — животных, транспортных средств, предметов обихода и людей. Это более крупный и сложный преемник Caltech-101 для моделей распознавания объектов.
Открой Caltech-256 на Ultralytics Platform, чтобы просмотреть примеры, изучить статистику датасета и создать его копию для обучения.
Смотри: Как обучить модель классификации изображений на датасете Caltech-256 с помощью Ultralytics YOLO26
В Caltech-256 нет заранее заданного разделения на обучающую и валидационную выборки. Приведенные ниже команды обучения автоматически делят данные в соотношении 80/20, поэтому вручную подготавливать датасет не нужно.
Основные особенности#
- Caltech-256 содержит 30 607 цветных изображений из 256 категорий объектов и один класс фона
257.clutter(всего 257 папок классов). - Категории охватывают множество реальных объектов, в том числе животных, транспортные средства, предметы быта и людей.
- В каждой категории не менее 80 изображений, а в самой многочисленной — до примерно 800, поэтому классы несбалансированы.
- Изображения имеют разные размеры и разрешения.
- Caltech-256 широко используют для оценки алгоритмов классификации изображений и распознавания объектов.
Структура набора данных#
Caltech-256 распространяется в виде 257 папок — по одной на класс: 256 категорий объектов и класс фона 257.clutter. Заранее заданного разделения на обучающую и валидационную выборки нет. При запуске обучения Ultralytics автоматически распределяет изображения, поэтому модели обучаются на всех 257 классах без ручной настройки:
- Классы: 257 (256 категорий объектов + 1 класс фона)
- Всего изображений: 30 607
- Разделение на обучающую и валидационную выборки: автоматически, 80% / 20% (≈24 385 для обучения, ≈6 222 для валидации)
- Изображений на класс: не менее 80 (дисбаланс классов, до примерно 800)
Применение#
Датасет Caltech-256 широко используют для обучения и оценки моделей классификации изображений и распознавания объектов, в том числе сверточных нейронных сетей (CNNs) и метода опорных векторов (SVMs). Большое количество категорий и высокое качество изображений делают этот датасет популярным ориентиром для исследований и прототипирования в области машинного обучения и компьютерного зрения.
Использование#
Обучи модель YOLO26n-cls на наборе данных Caltech-256 в течение 100 эпох с размером изображения 416.
from ultralytics import YOLO

# Загрузить модель
model = YOLO("yolo26n-cls.pt")  # загрузить предварительно обученную модель (рекомендуется для обучения)

# Обучить модель
results = model.train(data="caltech256", epochs=100, imgsz=416)
Примеры изображений и аннотаций#
Датасет Caltech-256 содержит качественные цветные изображения различных объектов и хорошо структурирован для задач классификации изображений. Вот несколько примеров изображений из датасета (источник):
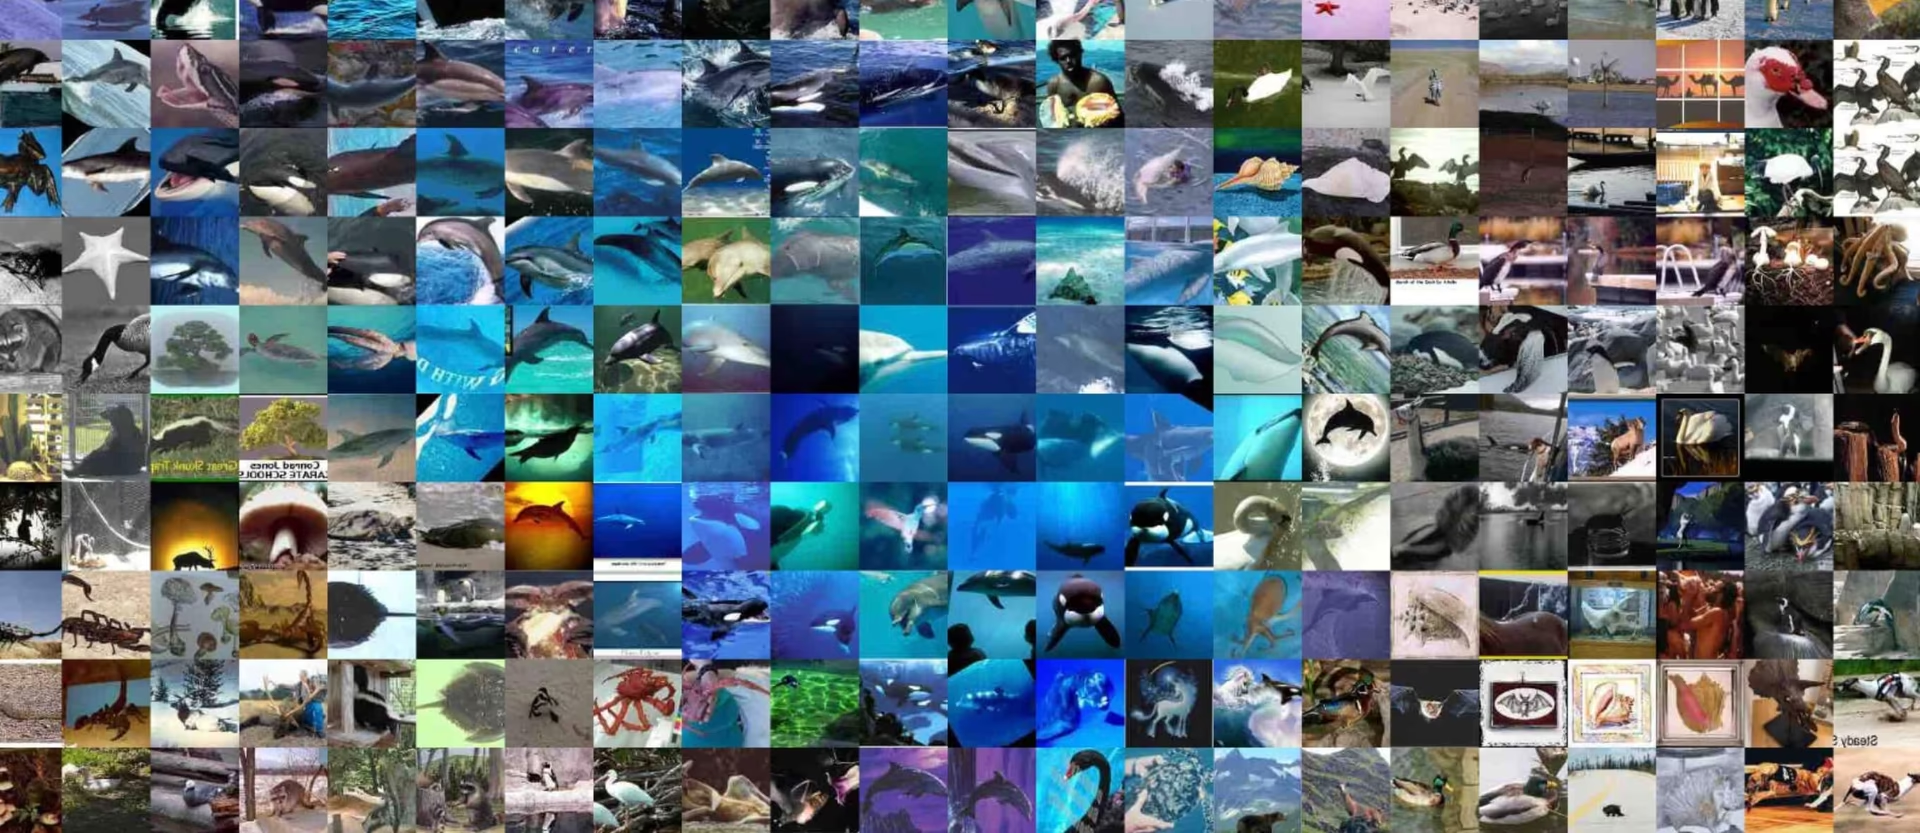
Примеры показывают разнообразие и сложность объектов в датасете Caltech-256 и подчеркивают ценность разнообразных данных для обучения устойчивых моделей распознавания объектов.
Цитирование и благодарности#
Если ты используешь датасет Caltech-256 в исследованиях или разработке, укажи в цитировании следующую статью:
@article{griffin2007caltech,
         title={Caltech-256 object category dataset},
         author={Griffin, Gregory and Holub, Alex and Perona, Pietro},
         year={2007}
}
Мы хотели бы поблагодарить Грегори Гриффина, Алекса Холуба и Пьетро Перону за создание и поддержку набора данных Caltech-256, который стал ценным ресурсом для сообщества исследователей машинного обучения и компьютерного зрения.
Часто задаваемые вопросы#
Датасет Caltech-256 широко используют для обучения и оценки моделей классификации изображений и распознавания объектов. Он содержит 30 607 изображений 256 категорий объектов и один фоновый класс, предоставляя более масштабный и сложный ориентир, чем Caltech-101, для алгоритмов вроде сверточных нейронных сетей (CNNs) и метода опорных векторов (SVMs).
Чтобы обучить модель Ultralytics YOLO на Caltech-256, воспользуйся приведенными ниже фрагментами кода. При первом использовании датасет загружается автоматически. Полный список аргументов смотри на странице обучения модели.
Пример обученияfrom ultralytics import YOLO # Загрузить модель model = YOLO("yolo26n-cls.pt") # загрузить предварительно обученную модель (рекомендуется для обучения) # Обучить модель results = model.train(data="caltech256", epochs=100, imgsz=416)Caltech-256 содержит 256 категорий объектов и один класс фона
257.clutter, всего 257 папок классов и 30 607 изображений. При обучении с Ultralytics модель учится распознавать все 257 классов. В каждой категории не менее 80 изображений, однако классы несбалансированы: в самой многочисленной категории до примерно 800 изображений.В Caltech-256 нет заранее заданного разделения. При первом запуске обучения Ultralytics автоматически делит датасет на 80% обучающих и 20% валидационных данных — примерно 24 385 обучающих и 6 222 валидационных изображения, — поэтому вручную создавать разделения не нужно. Чтобы задать разделение самостоятельно, перед обучением разложи изображения по папкам
train/иval/.Да. Ultralytics Platform позволяет управлять датасетами, обучать модели классификации изображений и развертывать их без написания большого объема кода. Это удобный способ проводить эксперименты с Caltech-256 в облаке. Другие варианты ты найдешь в нашем обзоре датасетов для классификации.


Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.