Кросс-валидация K-Fold с Ultralytics
Введение#
В этом руководстве показано, как реализовать перекрестную проверку K-fold для наборов данных обнаружения объектов в экосистеме Ultralytics. В руководстве используются формат обнаружения YOLO и библиотеки Python, такие как scikit-learn, pandas и PyYAML; рассматриваются настройка, создание векторов признаков и разделение набора данных на K блоков.
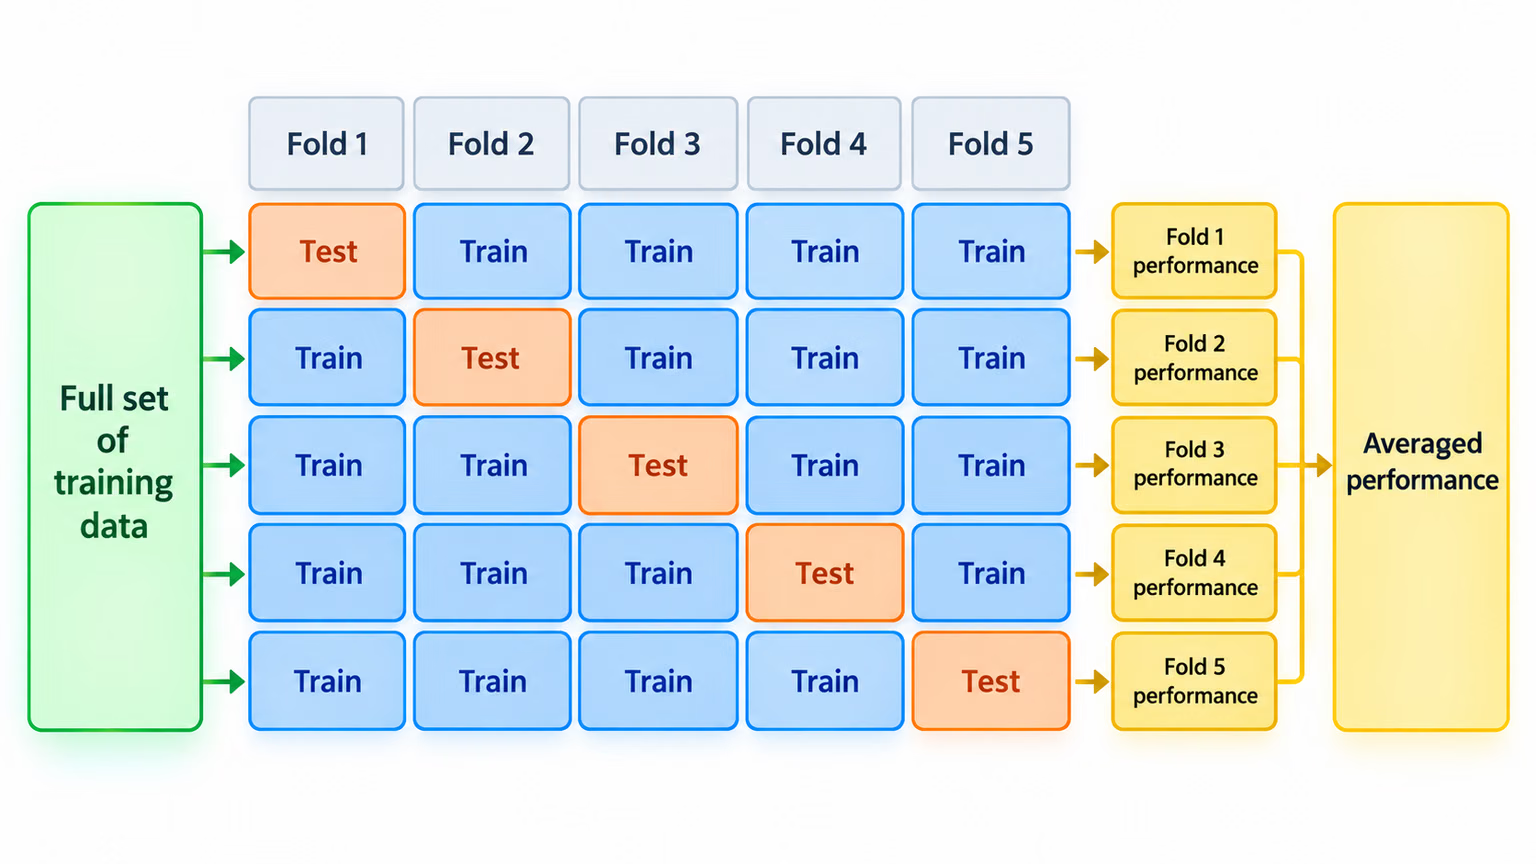
Независимо от того, работаешь ли ты с набором данных Fruit Detection или собственным источником данных, это руководство поможет разобраться в перекрестной проверке K-fold и применить ее для повышения надежности и устойчивости твоих моделей машинного обучения. В этом руководстве мы используем k=5 блоков, но учти, что оптимальное число блоков зависит от набора данных и особенностей проекта. Перекрестная проверка K-fold особенно полезна, если набор данных небольшой, зашумленный или очень разнообразный; для больших и разнообразных наборов данных обычно достаточно грамотно сформированных обучающей, валидационной и тестовой выборок.
Настройка#
-
Аннотации должны быть в формате детекции YOLO.
-
В этом руководстве предполагается, что файлы аннотаций доступны локально.
-
Для демонстрации мы используем набор данных Fruit Detection.
- Всего в этом наборе данных 8479 изображений.
- В наборе 6 классов; общее количество экземпляров каждого класса указано ниже.
| Метка класса | Количество экземпляров |
|---|---|
| Яблоко | 7049 |
| Виноград | 7202 |
| Ананас | 1613 |
| Апельсин | 15549 |
| Банан | 3536 |
| Арбуз | 1976 |
-
Для работы понадобятся следующие пакеты Python:
ultralyticssklearnpandaspyyaml
-
В этом руководстве используются фолды
k=5. Однако тебе следует определить оптимальное количество фолдов для своего набора данных.
-
Создай для проекта новое виртуальное окружение Python (
venv) и активируй его. Установи с помощьюpip(или предпочитаемого тобой менеджера пакетов):- Библиотека Ultralytics:
pip install -U ultralytics. Также можно клонировать официальный репозиторий. - Scikit-learn, pandas и PyYAML:
pip install -U scikit-learn pandas pyyaml.
- Библиотека Ultralytics:
-
Убедись, что аннотации соответствуют формату детекции YOLO.
- В этом руководстве все файлы аннотаций находятся в каталоге
Fruit-Detection/labels.
- В этом руководстве все файлы аннотаций находятся в каталоге
Создание векторов признаков для набора данных обнаружения объектов#
-
Для выполнения следующих шагов создай новый файл Python
example.py. -
Загрузи обучающие и валидационные изображения, перечисленные в YAML-файле набора данных, с помощью класса Ultralytics
YOLODataset, не затрагивая тестовую выборку.from pathlib import Path from ultralytics.data.dataset import YOLODataset from ultralytics.data.utils import check_det_dataset yaml_file = "path/to/data.yaml" data = check_det_dataset(yaml_file) dataset_path = Path(data["path"]) sources = [] for split in ("train", "val"): source = data.get(split) if source: sources.extend(source if isinstance(source, list) else [source]) dataset = YOLODataset(sources, data=data, augment=False) images = [Path(p) for p in dataset.im_files] -
Теперь прочитай содержимое YAML-файла набора данных и извлеки индексы меток классов.
classes = data["names"] cls_idx = sorted(classes.keys()) -
Инициализируй пустой DataFrame
pandas.import pandas as pd labels_df = pd.DataFrame(0.0, columns=cls_idx, index=images) -
Подсчитай количество экземпляров каждого класса, указанного в файлах аннотаций.
from collections import Counter for image, label in zip(images, dataset.labels): lbl_counter = Counter(label["cls"].flatten().astype(int)) labels_df.loc[image, list(lbl_counter)] = list(lbl_counter.values()) -
Ниже показан пример заполненного DataFrame:
                                                       0    1    2    3    4    5
'0000a16e4b057580_jpg.rf.00ab48988370f64f5ca8ea4...'  0.0  0.0  0.0  0.0  0.0  7.0
'0000a16e4b057580_jpg.rf.7e6dce029fb67f01eb19aa7...'  0.0  0.0  0.0  0.0  0.0  7.0
'0000a16e4b057580_jpg.rf.bc4d31cdcbe229dd022957a...'  0.0  0.0  0.0  0.0  0.0  7.0
'00020ebf74c4881c_jpg.rf.508192a0a97aa6c4a3b6882...'  0.0  0.0  0.0  1.0  0.0  0.0
'00020ebf74c4881c_jpg.rf.5af192a2254c8ecc4188a25...'  0.0  0.0  0.0  1.0  0.0  0.0
 ...                                                  ...  ...  ...  ...  ...  ...
'ff4cd45896de38be_jpg.rf.c4b5e967ca10c7ced3b9e97...'  0.0  0.0  0.0  0.0  0.0  2.0
'ff4cd45896de38be_jpg.rf.ea4c1d37d2884b3e3cbce08...'  0.0  0.0  0.0  0.0  0.0  2.0
'ff5fd9c3c624b7dc_jpg.rf.bb519feaa36fc4bf630a033...'  1.0  0.0  0.0  0.0  0.0  0.0
'ff5fd9c3c624b7dc_jpg.rf.f0751c9c3aa4519ea3c9d6a...'  1.0  0.0  0.0  0.0  0.0  0.0
'fffe28b31f2a70d4_jpg.rf.7ea16bd637ba0711c53b540...'  0.0  6.0  0.0  0.0  0.0  0.0
В строках используются абсолютные пути к изображениям, а столбцы соответствуют индексам классов. Для отсутствующих меток остаются строки из одних нулей, обозначающие фон. Такая структура данных позволяет применять перекрестную проверку K-fold к набору данных для обнаружения объектов.
Разделение набора данных на фолды K-Fold#
-
Теперь воспользуемся классом
KFoldизsklearn.model_selection, чтобы создатьkчастей набора данных.- Важно:
- Параметр
shuffle=Trueобеспечивает случайное распределение классов по фолдам. - Задав
random_state=M, гдеM— выбранное целое число, ты получишь воспроизводимые результаты.
- Параметр
from sklearn.model_selection import KFold ksplit = 5 kf = KFold(n_splits=ksplit, shuffle=True, random_state=20) # задаем random_state, чтобы получать воспроизводимые результаты kfolds = list(kf.split(labels_df)) - Важно:
-
Теперь набор данных разделен на
kфолдов, каждый из которых содержит списки индексовtrainиval. Для наглядного отображения результатов создадим DataFrame.folds = [f"split_{n}" for n in range(1, ksplit + 1)] folds_df = pd.DataFrame(index=labels_df.index, columns=folds) for i, (train, val) in enumerate(kfolds, start=1): folds_df.loc[labels_df.index[train], f"split_{i}"] = "train" folds_df.loc[labels_df.index[val], f"split_{i}"] = "val" -
Теперь рассчитаем распределение меток классов для каждого фолда как отношение числа классов в
valк числу классов вtrain.fold_lbl_distrb = pd.DataFrame(index=folds, columns=cls_idx) for n, (train_indices, val_indices) in enumerate(kfolds, start=1): train_totals = labels_df.iloc[train_indices].sum() val_totals = labels_df.iloc[val_indices].sum() # To avoid division by zero, we add a small value (1E-7) to the denominator ratio = val_totals / (train_totals + 1e-7) fold_lbl_distrb.loc[f"split_{n}"] = ratioВ идеале соотношения всех классов должны быть примерно одинаковыми в каждом фолде и между классами. Однако результат зависит от особенностей набора данных.
-
Для каждого фолда запиши списки изображений и YAML-файл набора данных. Текстовые списки позволяют не копировать набор данных
kраз.import yaml save_path = dataset_path.parent / f"{ksplit}-Fold_Cross-val" save_path.mkdir(parents=True, exist_ok=True) ds_yamls = [] for split in folds_df.columns: for partition in ("train", "val"): split_images = folds_df.index[folds_df[split] == partition] paths = "\n".join(map(str, split_images)) (save_path / f"{split}_{partition}.txt").write_text(f"{paths}\n") dataset_yaml = save_path / f"{split}.yaml" ds_yamls.append(dataset_yaml) with open(dataset_yaml, "w") as ds_y: yaml.safe_dump( { "path": save_path.as_posix(), "train": f"{split}_train.txt", "val": f"{split}_val.txt", "names": classes, }, ds_y, )
Сохранение записей (необязательно)#
При желании можешь сохранить записи о разделении K-Fold и DataFrame с распределением меток в виде CSV-файлов для дальнейшего использования.
folds_df.to_csv(save_path / "kfold_datasplit.csv")
fold_lbl_distrb.to_csv(save_path / "kfold_label_distribution.csv")
Обучение YOLO с разделением данных K-Fold#
-
Сначала загрузи модель YOLO.
from ultralytics import YOLO weights_path = "path/to/weights.pt" # используй yolo26n.pt для небольшой модели model = YOLO(weights_path, task="detect") -
Затем перебери YAML-файлы наборов данных, чтобы запустить обучение. Результаты будут сохранены в каталоге, заданном аргументами
projectиname. По умолчанию это каталогruns/detect/train#, где#— целочисленный индекс.results = {} # Define your additional arguments here batch = 16 project = "kfold_demo" epochs = 100 for k, dataset_yaml in enumerate(ds_yamls): model = YOLO(weights_path, task="detect") results[k] = model.train( data=dataset_yaml, epochs=epochs, batch=batch, project=project, name=f"fold_{k + 1}" ) # include any additional train arguments -
Для автоматического разделения набора данных также можно использовать функцию autosplit от Ultralytics:
from ultralytics.data.split import autosplit

# Автоматически разделить набор данных на train/val/test
autosplit(path="path/to/images", weights=(0.8, 0.2, 0.0), annotated_only=True)
Заключение#
В этом руководстве мы рассмотрели применение кросс-валидации K-Fold для обучения модели YOLO обнаружения объектов. Мы научились разделять совокупность обучающих и валидационных данных на K частей и использовать полученную таблицу соотношений для проверки баланса классов после случайного разделения.
Мы также рассмотрели процедуру создания DataFrame отчетов для визуализации разделения данных и распределения меток по выборкам. Это позволяет наглядно увидеть структуру обучающей и валидационной выборок.
При желании мы сохранили записи для дальнейшего использования — это может быть особенно полезно в крупных проектах или при поиске причин проблем с производительностью модели.
Наконец, мы реализовали обучение модели в цикле на каждой части и сохранили результаты обучения для дальнейшего анализа и сравнения.
Кросс-валидация K-Fold — надежный способ эффективнее использовать доступные данные; она помогает убедиться, что производительность модели остается стабильной на разных подмножествах данных. В результате получается более обобщающая и надежная модель, которая с меньшей вероятностью будет переобучаться на конкретных закономерностях данных.
Имей в виду, что хотя в этом руководстве мы использовали YOLO, эти шаги в основном применимы и к другим моделям машинного обучения. Понимание описанных шагов позволит эффективно применять кросс-валидацию в собственных проектах машинного обучения.
Часто задаваемые вопросы#
Кросс-валидация K-Fold — это метод, при котором набор данных делится на «k» подмножеств (фолдов) для более надежной оценки производительности модели. Каждый фолд поочередно используется и для обучения, и как валидационные данные. В обнаружении объектов кросс-валидация K-Fold помогает убедиться, что модель Ultralytics YOLO надежно работает и хорошо обобщает данные при разных вариантах их разделения. Это повышает надежность модели. Подробные инструкции по настройке кросс-валидации K-Fold с Ultralytics YOLO см. в разделе Кросс-валидация K-Fold с Ultralytics.
Чтобы реализовать кросс-валидацию K-Fold с Ultralytics YOLO, выполни следующие шаги:
- Убедись, что аннотации соответствуют формату детекции YOLO.
- Используй библиотеки Python, такие как
sklearn,pandasиpyyaml. - Создай векторы признаков на основе набора данных.
- Раздели набор данных с помощью
KFoldизsklearn.model_selection. - Обучи модель YOLO на каждой части.
Подробное руководство см. в разделе документации Разделение набора данных на фолды K-Fold.
В этом руководстве рассматривается формат детекции YOLO, но тот же подход подходит для всех задач YOLO: задача влияет на то, как формировать фолды, но не на пользу кросс-валидации:
Задача Формирование фолдов detectРазделяй данные на уровне изображений, балансируя распределение объектов и классов между фолдами. Связанные изображения (один пациент, видеопоследовательность, камера или объект съемки) оставляй в одном фолде. segmentИспользуй ту же стратегию разделения на уровне изображений, что и для детекции, дополнительно обеспечив наличие масок и всех классов в каждом фолде. classifyПо возможности используй стратифицированные фолды, чтобы частоты классов оставались сбалансированными в обучающей и валидационной выборках. poseРазделяй данные по субъектам или последовательностям, чтобы один и тот же человек или животное ни в коем случае не попадали в обе части фолда. obbРазделяй данные на уровне изображений, объединяя тайлы или фрагменты одной сцены в одном фолде. Это особенно важно для аэрофотоснимков. Независимо от задачи, не допускай попадания почти дублирующихся и связанных примеров в разные блоки: такая утечка значительно завышает метрики валидации по сравнению с результатами, которых модель достигнет в рабочей среде.
Ultralytics YOLO обеспечивает обнаружение объектов в реальном времени с высокой точностью и эффективностью на уровне современных решений. Модель универсальна и поддерживает множество задач компьютерного зрения, включая обнаружение, сегментацию экземпляров, семантическую сегментацию и классификацию. Кроме того, модель интегрируется с такими инструментами, как Ultralytics Platform, для обучения и развёртывания моделей без написания кода.
Аннотации должны соответствовать формату детекции YOLO. В каждом файле аннотаций нужно указать класс объекта и координаты его ограничивающей рамки на изображении. Формат YOLO упрощает и стандартизирует обработку данных для обучения моделей обнаружения объектов. Подробнее о правильном формате аннотаций см. в руководстве по формату детекции YOLO.
Да, кросс-валидацию K-Fold можно использовать с любым пользовательским набором данных, если аннотации соответствуют формату детекции YOLO. Замени пути к данным и метки классов на соответствующие своему набору данных. Благодаря такой гибкости оценка модели с помощью кросс-валидации K-Fold может повысить надежность любого проекта по обнаружению объектов. Практический пример см. в разделе Создание векторов признаков.


Комментарии21
Задай вопрос, поделись результатами или помоги кому-нибудь.
jingieboy
does this work with yolov8-cls? if so how would the folder structure look like? how are the data splits
 Glenn JocherUltralytics(изменено)
Yes—K‑Fold works the same for classification; use the standard ImageNet-style layout per fold, and train each fold separately (YOLO infers classes from folder names). For YOLO26 (recommended) you can do:
dataset/
  split_1/
    train/
      class_a/ ...
      class_b/ ...
    val/
      class_a/ ...
      class_b/ ...
  split_2/
    train/...
    val/...
  ...
from ultralytics import YOLO weights = "yolo26n-cls.pt" # swap to 'yolov8n-cls.pt' if you prefer YOLOv8 splits = ["dataset/split_1", "dataset/split_2", "dataset/split_3"] for d in splits: model = YOLO(weights) model.train(data=d, epochs=20, batch=16) # d must contain 'train/' and 'val/' subfoldersFor building folds, use
StratifiedKFoldon image-level labels derived from parent folder names to keep class balance, or use the random splitter shown in the autosplit reference if stratification isn’t required. Classification usage details are in the classification task docs.thank you for this! I have also notice that everytime I run model.val(), the accuracies and confusion matrix values are slightly different this time. Is this normal or during evaluation, there is a small randomness when calling the function.
- Glenn JocherUltralytics
@jingieboy minor variations can occur from non-deterministic CUDA ops or multi-threading; validation itself doesn’t add randomness by default—set seeds and force deterministic ops to lock results:
import random, numpy as np, torch

seed = 0
random.seed(seed); np.random.seed(seed); torch.manual_seed(seed)
torch.backends.cudnn.deterministic = True
torch.backends.cudnn.benchmark = False

model.val()  # run evaluation
If differences are still large, double-check your eval args in the validation mode docs.
Nehasq
Hi, I am applying K-fold validation using the leave-one-out technique. My dataset consists of a single class and includes 21 images in total. For each split, I use 20 images for training and 1 image for testing. I am implementing the leave-one-out technique with the code above, setting ksplit=21.
I am not using a separate validation dataset, only training and testing data. Here is the code I am using:
results = {}
Define additional arguments here
batch = 16 project = "kfold_demo" epochs = 100
for k in range(ksplit): dataset_yaml = ds_yamls[k] model = YOLO(weights_path, task="detect") model.train(data=dataset_yaml, epochs=epochs, batch=batch, project=project) # Include any train arguments results[k] = model.metrics # Save output metrics for further analysis
In my data.yaml file, I have provided the validation path as the test set. When it trains and validates on the "1 test data," does this mean the model is being tested on data it has never seen during training? This is my first point of confusion.
my data.yaml file for each split looks like this: names:
- pothole path: ../ 2024-12-10_21-Fold_Cross-val/split_1 train: train val: test
My second question is about calculating the final performance. When I ran the above code, it calculated scores for each individual split. Do I need to calculate the final performance metrics manually, or is there any functionality in YOLOv8 to compute the aggregated performance automatically?
- Glenn JocherUltralytics
@Nehasq to address your first question, yes, the model is being tested on unseen data during each split, as the test set (1 image) is excluded from training and only used for validation. Regarding your second question, YOLO does not automatically aggregate metrics across splits. You need to compute the final performance metrics manually by averaging the results from all splits. For reference, you can review the K-Fold Cross Validation guide.
Thanks for your reply. I understand your point. So, are you saying that, for example, in my case, where I have 21 scores (precision, recall, etc.), I should simply add all the precision values together and divide the sum by 21 to get the final precision of the model? Is that correct?
Also, in y case of 20 images( training) and 1 images for test, what batch size would you suggest?
- Glenn JocherUltralytics
Yes, to calculate the final precision (or any metric), you average the values across all splits, i.e., sum all precision scores and divide by the number of splits (21 in your case). As for the batch size, given your small dataset, you could keep it low (e.g., 1 or 2) to ensure efficient utilization of the data while avoiding overfitting.
Thanks, that really helps! With a batch size of 1, I am keeping the epochs at 10. Should it be fewer? Also, to check for overfitting, I need to review the result graphs for each split. However, I can't definitively determine if it is overfitting since each split is separate, right?
- Glenn JocherUltralytics
Keeping epochs at 10 with a batch size of 1 is reasonable given your small dataset size. To check for overfitting, reviewing result graphs from each split can help, but overfitting may be harder to detect since each split involves different training and test data. Consider comparing trends across splits for consistent insights. For further details, you can reference the K-Fold Cross Validation guide.
semyon-v-dot
After the loop:
for ext in supported_extensions:
    images.extend(sorted((dataset_path / "images").rglob(f"*{ext}")))
Should be this line of code:
images = sorted(images)For
imagesmatching withlabelslist:labels = sorted(dataset_path.rglob("*labels/*.txt"))Otherwise the script creates background images because some images missing their labels.
- Glenn JocherUltralytics
@semyon-v-dot thank you for your suggestion. Sorting the
imageslist after extending it with supported extensions is a good practice to ensure alignment with thelabelslist. This helps prevent issues with missing labels.1
 sangeun jo
K-폴드 데이터 세트 분할 4번에서
images.extend(sorted((dataset_path / "images").rglob(f"*{ext}")))이 코드를images.extend(sorted(dataset_path.rglob(f"*images/*{ext}")))로 변환해야 작동했습니다.- Glenn JocherUltralytics
@sangeun-jo thank you for pointing that out. Your modification to
images.extend(sorted(dataset_path.rglob(f"*images/*{ext}")))is indeed correct and ensures the code works as intended. If you have any further questions or need additional assistance, feel free to ask!
kh-diab
is it usefult to use this k fold approach when I just have one class only but my issue is the class is detected as background or vice versa as per the attached Confusion matrix
- Glenn JocherUltralytics
@kh-diab using K-Fold Cross Validation can still be beneficial even with a single class. It helps ensure that your model's performance is robust and not overly dependent on a particular subset of the data. This can be particularly useful if you're experiencing issues with class detection accuracy, as it allows you to validate the model's performance across multiple splits and identify any inconsistencies. If your class is being detected as background or vice versa, K-Fold Cross Validation can help diagnose whether this issue is consistent across different data splits or specific to certain subsets. For more details, you can refer to our guide on K-Fold Cross Validation: https://docs.ultralytics.com/guides/kfold-cross-validation/.
alexander-sony
Good guide, consider adding it in a colab notebook.
In section "Train YOLO using K-Fold Data Splits", model should be re-initialized foe every k, i.e. it should be inside the for-loop: for k in range(ksplit).
- Glenn JocherUltralytics
@alexander-sony thank you for your feedback and suggestion! 😊
You're absolutely right about re-initializing the model within the loop for each fold to ensure a fresh start for every training iteration. This can help avoid any potential carryover effects from previous folds. Here's the corrected code snippet for the training section:
from ultralytics import YOLO

weights_path = "path/to/weights.pt"
results = {}

# Define your additional arguments here
batch = 16
project = "kfold_demo"
epochs = 100

for k in range(ksplit):
    model = YOLO(weights_path, task="detect")  # Re-initialize the model inside the loop
    dataset_yaml = ds_yamls[k]
    model.train(data=dataset_yaml, epochs=epochs, batch=batch, project=project)  # include any train arguments
    results[k] = model.metrics  # save output metrics for further analysis
Regarding your suggestion to add this guide to a Colab notebook, that's a fantastic idea! It would make the process more interactive and accessible for users. We'll consider creating a Colab version of this guide in the future.
For more details on K-Fold Cross Validation, you can refer to our comprehensive guide.
Thanks again for your valuable input! If you have any more suggestions or questions, feel free to share. Happy coding! 🚀
Likhith-Sugganahalli
@alexander-sony
woudnt that be a new model trained on each split, giving us n different models trained on 1/nth of the dataset?
 Fazri Gading
Is there any way to implement Stratified K-Fold Cross Validation with YOLOv8?
 Paula DerrengerUltralytics
Yes, you can implement Stratified K-Fold Cross Validation with YOLOv8! Stratified K-Fold ensures that each fold has a similar distribution of class labels, which can be particularly useful for imbalanced datasets.
To achieve this, you can use
StratifiedKFoldfromsklearn.model_selectioninstead ofKFold. Here's a brief example of how to modify the K-Fold implementation:from sklearn.model_selection import StratifiedKFold # Assuming labels_df is your DataFrame with class counts ksplit = 5 skf = StratifiedKFold(n_splits=ksplit, shuffle=True, random_state=20) # Generate stratified splits kfolds = list(skf.split(labels_df, labels_df.idxmax(axis=1))) # The rest of the process remains the sameFor a detailed guide on K-Fold Cross Validation, please refer to the Ultralytics documentation. If you have any more questions, feel free to ask! 😊
1