Экспорт моделей YOLO26 в TensorRT
TensorRT — это SDK NVIDIA для высокоскоростного инференса глубокого обучения. Экспорт модели Ultralytics YOLO26 с помощью format="engine" создает файл .engine, оптимизированный для GPU NVIDIA, на котором он был собран, с точностью FP32, FP16 или INT8.
TensorRT настраивает движок под GPU, на котором он собирается. Собирай движок на GPU для развертывания или на GPU той же модели с той же версией TensorRT; файл .engine не является переносимым форматом модели. Для развертывания на периферийных устройствах Ultralytics Platform предлагает восемь вариантов целевых устройств Jetson с задокументированными результатами физической сборки и проверки для каждого, либо ты можешь выполнить экспорт локально на целевом устройстве.
Краткий обзор#
| Свойство | Описание |
|---|---|
Аргумент format | engine (псевдонимы: tensorrt, trt) |
| Результат | yolo26n.engine — один файл, начинающийся с заголовка метаданных JSON (названия классов, задача, размер изображения). Промежуточный yolo26n.onnx остается рядом с ним |
| Поддерживаемые устройства | GPU NVIDIA: центры обработки данных, рабочие станции и Jetson, включая ядра Jetson DLA (кроме TensorRT 11) |
| Среда выполнения | TensorRT 7.0 или новее (версия 10.2.0 не поддерживается) |
| Точность | FP32, FP16, INT8 |
| Среда для экспорта | Компьютер с GPU NVIDIA и CUDA. Выполняй сборку на GPU для развертывания или на GPU той же модели |
Ultralytics Platform может собрать для тебя движок TensorRT на GPU выбранного типа, в том числе для целевых устройств NVIDIA Jetson, поэтому локальная среда для экспорта не нужна.
Быстрый старт#
Установи пакет Ultralytics на компьютер с GPU NVIDIA и CUDA. В Linux при первом экспорте, если пакет TensorRT для Python отсутствует, устанавливается пакет, соответствующий твоей версии CUDA. На NVIDIA Jetson используй версию TensorRT, входящую в состав JetPack. В Windows установи TensorRT самостоятельно до экспорта.
pip install ultralyticsДругие способы установки смотри в руководстве по установке. Затем экспортируй модель и загрузи экспортированный движок, чтобы запустить инференс или проверить точность. Для инференса и проверки нужен GPU NVIDIA. Сборка движка YOLO26n на NVIDIA T4 занимает от одной до трех минут.
from ultralytics import YOLO

# Загрузи модель YOLO26
model = YOLO("yolo26n.pt")

# Экспортируй модель в формат TensorRT
model.export(format="engine")  # создаёт 'yolo26n.engine'

# Или экспортируй движок FP16
model.export(format="engine", quantize=16) # создаёт 'yolo26n.engine'from ultralytics import YOLO
# Загрузи экспортированную модель TensorRT
model = YOLO("yolo26n.engine")
# Выполнить инференс
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Загрузи экспортированную модель TensorRT
model = YOLO("yolo26n.engine")
# Проверить точность на наборе данных COCO8
metrics = model.val(data="coco8.yaml")Поддерживаемые задачи#
Экспорт в TensorRT поддерживает все семь задач Ultralytics для моделей YOLOv8, YOLO11 и YOLO26: детекция, сегментация, семантическая сегментация, оценка глубины, классификация, оценка позы и OBB. Семантическая сегментация и оценка глубины доступны только в YOLO26 — единственном семействе, выпускаемом с такими головами.
Аргументы экспорта#
| Аргумент | Тип | По умолчанию | Описание |
|---|---|---|---|
format | str | 'engine' | Целевой формат экспортируемой модели, определяющий совместимость с различными средами развертывания. |
imgsz | int или tuple | 640 | Заданный размер изображения на входе модели. Можно указать целое число для квадратных изображений или кортеж (height, width) для конкретных размеров. |
quantize | int или str | None | Точность квантования: 16 (FP16) или 8 (INT8/PTQ; требуется калибровочный data/fraction); 32/не задано означает FP32. Чекпойнт, обученный с quantize=8, экспортируется в INT8 на основе содержащихся в нем диапазонов без калибровки, в том числе если quantize не задан; quantize=16 или quantize=32 приводит к ошибке. Заменяет устаревшие флаги half/int8. |
dynamic | bool | False | Собирает движок, принимающий размеры пакета от 1 до batch и размеры изображений от 32 пикселей до удвоенного значения imgsz; минимальный размер больше для динамических движков INT8 на старых GPU. Если задано False, движок принимает только экспортные batch и imgsz. |
simplify | bool | True | Упрощает граф модели с помощью onnxslim, что потенциально повышает производительность и совместимость. |
opset | int | None | Задаёт версию ONNX opset для промежуточного графа ONNX. Если параметр не задан, используется opset 18 (более низкий для PyTorch < 2.4), но не выше установленной версии onnx. |
workspace | float или None | None | Верхний предел в ГиБ для объема памяти, используемой TensorRT при сборке движка. Оставь значение None, чтобы TensorRT выделял память автоматически. |
nms | bool, необязательно | None | Выбери необработанный выход (None, по умолчанию), встроенный NMS (True) или голову без NMS (False). При использовании nms=True параметры conf (по умолчанию 0.25), iou, max_det и agnostic_nms фиксируются при экспорте; nms=True игнорируется для моделей семантической сегментации и оценки глубины и приводит к ошибке для моделей классификации. |
batch | int | 1 | Размер пакета движка или максимальный размер пакета при использовании dynamic=True. Это также размер пакета для калибровки INT8. |
data | str | None | Путь к YAML-файлу датасета, используемого для калибровки INT8; для классификации вместо него укажи каталог датасета или встроенное имя датасета. Для калибровки используется раздел val, если не задано split. Если параметр не указан вместе с quantize=8, Ultralytics использует небольшой датасет по умолчанию для задачи модели, например coco8.yaml для детекции; для чекпойнта, обученного с quantize=8, датасет не нужен. |
fraction | float, int или list | 1.0 | Подмножество для калибровки, заданное как доля, количество изображений или [train, val, test] отношения/количества. Если список содержит два элемента, test остаётся без изменений, а 0 пропускает его. |
device | str | None | Задает устройство для экспорта: GPU (device=0, используется, если параметр не задан) или DLA для NVIDIA Jetson (device=dla:0 или device=dla:1, с quantize=16 или quantize=8). |
На NVIDIA Jetson Ultralytics выполняет экспорт с использованием среды выполнения TensorRT из твоего выпуска JetPack. Для экспорта на JetPack 7 требуется TensorRT версии 10.15 или новее, но ниже 11. device=dla:0 и device=dla:1 приводят к ошибке в TensorRT 11. NVIDIA указывает TensorRT 10.7 как последний выпуск 10.x с поддержкой DLA, а в TensorRT 11.4.1 добавлена поддержка JetPack 7.2.2, которую Ultralytics пока не использует.
Аргументы, общие для всех форматов, описаны в документации по режиму экспорта.
Экспорт TensorRT с квантованием INT8#
quantize=8 собирает движок INT8 с послетренировочным квантованием (PTQ): при экспорте калибровочные изображения пропускаются через модель, чтобы измерить диапазон значений каждого тензора. Чекпойнт, дообученный с помощью quantize=8 посредством квантозависимого обучения, уже содержит диапазоны INT8, поэтому при его экспорте калибровка пропускается.
Аргументы quantize и data одинаковы во всех версиях TensorRT, но экспорт чекпойнта, обученного без quantize=8, внутри работает по-разному:
| TensorRT 7–10 | TensorRT 11 | |
|---|---|---|
| Метод INT8 | Неявное квантование через интерфейс IInt8Calibrator | Явное квантование: NVIDIA ModelOpt добавляет узлы Q/DQ в граф ONNX |
| Алгоритм калибровки | MINMAX_CALIBRATION на GPU, ENTROPY_CALIBRATION_2 для DLA | ModelOpt max, выполняется на CPU |
| Используемые калибровочные изображения | Каждый полный пакет из раздела датасета | Около 512 изображений в перемешанном порядке или каждый полный пакет из меньшего раздела |
dynamic=True с quantize=8 | Не покрыто тестами; экспортируй без dynamic=True | Поддерживается |
FP16 (quantize=16) | Флаг сборщика TensorRT | Преобразование ModelOpt с пониженной точностью |
ModelOpt устанавливается при первом использовании. Ultralytics не использует повторно кэш калибровки, поэтому при каждом экспорте калибровка выполняется заново. Подробнее об обоих методах смотри в разделе Работа с квантованными типами документации TensorRT.
Для чекпойнта, не обученного с quantize=8, передай калибровочные изображения с помощью data, например data="my_dataset.yaml". Для калибровки используется раздел val этого датасета, если ты не задашь split; параметр fraction ограничивает число изображений. NVIDIA рекомендует использовать не менее 500 изображений, представляющих данные для развертывания; если их меньше 300, при экспорте выводится предупреждение. Если не задан data, при экспорте выводится предупреждение и используется небольшой пример датасета для задачи модели, например coco8.yaml для детекции. В его валидационном разделе 4 изображения — этого достаточно для проверки экспорта, но не для калибровки модели перед развертыванием.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# Выполнить калибровку на 10% валидационных изображений COCO (500 изображений); замени coco.yaml на собственный датасет
model.export(format="engine", quantize=8, data="coco.yaml", fraction=0.1)

# Загрузить экспортированный движок INT8 и запустить инференс
model = YOLO("yolo26n.engine")
result = model.predict("https://ultralytics.com/images/bus.jpg")
На тестовом GPU движки INT8 работали в 1,04–2,3 раза быстрее движков FP32, но обошли движки FP16 только для трех из десяти моделей. Для YOLO26n–YOLO26l точность INT8 снизилась на 1,7–2,9 mAP, а для YOLO26x и YOLO26n-pose снижение было значительно больше. Движок INT8 YOLO26n оказался больше движка FP32 (30 МБ против 11 МБ), тогда как большие модели стали компактнее (53 МБ против 103 МБ для YOLO26l). INT8 также может смещать значения уверенности, поэтому выбирай порог уверенности по собственной кривой F1 движка INT8. Результаты для всех моделей смотри в разделе тестов производительности.
Формат вывода#
Движок принимает один вход с именем images и возвращает те же выходные данные, что и экспорт ONNX, на основе которого он собран. Исключение: в версиях TensorRT ниже 10 семантические модели возвращают оценки классов в формате float с формой (batch, classes, height, width) вместо карты классов uint8. Формы выходных данных для каждой задачи и каждого значения nms смотри в разделе Формат выходных данных ONNX.
Загрузка движка вне Ultralytics#
Файл Ultralytics .engine — это не обычный движок TensorRT. Сначала идут 4 байта с длиной в формате little-endian, затем указанное число байтов с метаданными JSON, а после них — сериализованный движок. deserialize_cuda_engine в TensorRT возвращает None, если ему передать весь файл. Чтобы загрузить движок через API TensorRT, пропусти заголовок:
import json

import tensorrt as trt

with open("yolo26n.engine", "rb") as f:
    n = int.from_bytes(f.read(4), byteorder="little")  # длина заголовка метаданных
    metadata = json.loads(f.read(n))  # названия классов, задача, imgsz, пакет, аргументы экспорта
    engine = trt.Runtime(trt.Logger(trt.Logger.WARNING)).deserialize_cuda_engine(f.read())
Если другому инструменту нужен обычный файл движка TensorRT, запиши байты после заголовка в новый файл или собери движок в этом инструменте из файла yolo26n.onnx, который экспорт сохраняет рядом с движком. При экспорте с TensorRT 11 и точностью FP16 или с калибровкой INT8 также сохраняются файлы yolo26n.fp16.onnx и yolo26n.int8.onnx; собери движок INT8 в другом инструменте из файла .int8.onnx. Для чекпойнта, обученного с quantize=8, файл yolo26n.onnx уже содержит узлы Q/DQ, а файл .int8.onnx не создается; при экспорте с TensorRT 11 сохраняется файл yolo26n.fp16.onnx — тот же граф Q/DQ, но с другими слоями в FP16.
Разверни#
YOLO("yolo26n.engine") загружает движок с помощью среды выполнения TensorRT для Python. По умолчанию движок запускается на GPU 0, даже если ты укажешь device="cpu". Чтобы запустить его на другом GPU той же модели, укажи device=1. Движок, экспортированный с device=dla:0 или device=dla:1, запускается на соответствующем ядре DLA.
Движок, экспортированный без dynamic=True, имеет фиксированную форму входных данных. Для predict и val используется значение imgsz, заданное при экспорте, а другой аргумент imgsz игнорируется. Ultralytics разбивает большие пакеты на пакеты экспортного размера и дополняет меньшие, поэтому можно использовать любое число изображений. Движок, экспортированный с dynamic=True, принимает любой размер пакета и изображения в заданном диапазоне и выдает ошибку ValueError: input size ... is outside the TensorRT optimization profile для формы вне этого диапазона. При использовании nms=True пакет, размер которого превышает диапазон, разбивается на пакеты экспортного размера.
Руководства по развертыванию#
-
NVIDIA Triton Inference Server: Разверни экспорт ONNX с ускорителем TensorRT в Triton, который собирает движок на GPU сервера.
-
Краткое руководство по NVIDIA Jetson: Настрой Ultralytics на устройствах Jetson и экспортируй движки TensorRT с помощью JetPack, включая DLA.
-
Краткое руководство по NVIDIA DGX Spark: Настрой Ultralytics и TensorRT на NVIDIA DGX Spark.
-
DeepStream на NVIDIA Jetson: Запускай экспортированные модели в видеоконвейерах NVIDIA DeepStream.
-
NVIDIA TensorRT на GitHub: Исходный код, примеры и инструменты для TensorRT.
Ограничения и устранение неполадок#
- Движки нельзя переносить между платформами: движок собирается для одной модели GPU и одной версии TensorRT. Пересобирай его при смене GPU, версии TensorRT или выпуска JetPack. Если движок не удается загрузить, Ultralytics выводит в журнал
TensorRT model exported with a different version than expected. - Требуется GPU: при экспорте используется
device=0, еслиdeviceне задан; приdevice=cpuэкспорт завершается ошибкойexport running on CPU but must be on GPU. - Движок не загружается в других инструментах: файл
.engineначинается с заголовка метаданных, поэтому API TensorRT не может прочитать его напрямую. См. раздел Загрузка движка вне Ultralytics. - Версия TensorRT: Ultralytics требует TensorRT версии 7.0.0 или новее. TensorRT 10.2.0 не поддерживается, и автоматическая установка пропускает эту версию. Для JetPack 7 и систем NVIDIA DGX при экспорте требуется TensorRT версии 10.15 или новее (а для Jetson — ниже 11); если установленная версия не соответствует этому диапазону, выполняется попытка установить нужную.
- Голова без NMS в старых версиях TensorRT: в версиях TensorRT ниже 8.5.0 невозможно собрать голову YOLO26 без NMS. При экспорте выводится предупреждение и записываются необработанные предсказания, для которых нужен NMS. Чтобы экспортировать модель с
nms=False, обнови TensorRT до версии 8.5.0 или новее. - INT8 в JetPack 6: с TensorRT 10.3.0 в JetPack 6 экспорт INT8 с
nms=Trueзавершается ошибкой, а экспорт INT8 сnms=Falseпереключается на необработанные предсказания. Решение смотри в руководстве по Jetson. - INT8 в TensorRT 10.16: экспорт INT8 с TensorRT 10.16.1 завершился ошибкой на GPU NVIDIA RTX PRO 6000 Blackwell и RTX 6000D с
Could not find any implementation for node. На NVIDIA RTX PRO 6000 Blackwell движки INT8 успешно собирались с TensorRT 10.13, 10.14, 10.15 и 11.4. - DLA:
device=dla:0иdevice=dla:1работают только на NVIDIA Jetson и только сquantize=16илиquantize=8. При экспорте с TensorRT 11 возникает ошибка. Слои, не поддерживаемые DLA, выполняются на GPU. - Динамические формы: для
dynamic=Trueнужно задать максимальный размер пакета, поэтому укажи такжеbatch, напримерbatch=8. Если этого не сделать, при экспорте выводится предупреждение, а максимальный размер пакета равен 1. Движок принимает пакеты размером от 1 доbatchи изображения размером от 32 пикселей до удвоенного значения экспортногоimgsz. Например, движок, экспортированный сimgsz=320 batch=4, работает с размером 640 пикселей, но отклоняет размер 704 пикселя или пакет из 6 изображений сinput size ... is outside the TensorRT optimization profile. Сочетайdynamic=Trueсquantize=8только в TensorRT 11. На GPU с вычислительной способностью 7.5 или ниже, например T4, минимальный размер таких динамических движков INT8 составляет 64 пикселя (128 для моделей P6). - Фиксированный размер входных данных: движок, экспортированный без
dynamic=True, всегда работает с размеромimgsz, заданным при экспорте. Передача другогоimgszв predict или val не влияет на размер, поэтому для его изменения выполни экспорт заново. - Экспорт INT8 без
data: если чекпойнт не обучался сquantize=8, при экспорте выполняется калибровка на небольшом датасете по умолчанию для этой задачи; для детекции в нем 4 валидационных изображения, и выводится предупреждение. Передайdataс репрезентативными изображениями; если их меньше 300, при экспорте выводится предупреждение. - Медленный инференс при первых запусках: первые несколько вызовов с новым движком или с новым
imgszна динамическом движке занимают больше времени, чем последующие.
Другие ошибки описаны в руководстве по распространённым проблемам.
Бенчмарки#
На странице модели YOLO26 указана скорость TensorRT 10 для каждой модели на GPU NVIDIA T4 для всех задач, кроме семантической сегментации.
Сравнение FP32, FP16 и INT8#
В таблицах ниже PyTorch сравнивается с движками TensorRT 11.4 с точностью FP32, FP16 и INT8 для всех моделей детекции YOLO26 и модели YOLO26n для пяти других задач. Все значения измерены на одном GPU NVIDIA RTX PRO 6000 Blackwell Server Edition.
Миллисекунд на изображение; меньше — лучше. Самый быстрый формат для каждой модели выделен жирным; движок INT8 YOLO26x не учитывается из-за нестабильной точности.
| Модель | imgsz | PyTorch | TensorRT FP32 | TensorRT FP16 | TensorRT INT8 |
|---|---|---|---|---|---|
| YOLO26n | 640 | 2.85 | 0.67 | 0.48 | 0.53 |
| YOLO26s | 640 | 2.98 | 1.15 | 0.61 | 0.66 |
| YOLO26m | 640 | 3.29 | 2.22 | 1.03 | 1.08 |
| YOLO26l | 640 | 4.70 | 3.03 | 1.49 | 1.43 |
| YOLO26x | 640 | 5.93 | 4.31 | 2.09 | 1.84 |
| YOLO26n-seg | 640 | 3.18 | 0.93 | 0.65 | 0.72 |
| YOLO26n-sem | 1024 | 1.74 | 0.74 | 0.45 | 0.71 |
| YOLO26n-cls | 224 | 1.75 | 0.29 | 0.24 | 0.20 |
| YOLO26n-pose | 640 | 3.39 | 0.76 | 0.51 | 0.59 |
| YOLO26n-obb | 1024 | 4.55 | 1.03 | 0.64 | 0.88 |
- FP16 сохранил точность FP32 с отклонением не более 0,1 пункта для каждой модели. На моделях детекции он работал в 1,4–2,2 раза быстрее движка FP32 и в 2,8–5,9 раза быстрее PyTorch.
- INT8 на моделях детекции показал задержку не более чем на 12% выше, чем FP16, и потерял от 1,7 до 2,9 mAP на YOLO26n, YOLO26s, YOLO26m и YOLO26l. На этом GPU он оказался быстрее FP16 только для YOLO26l, YOLO26x и YOLO26n-cls.
- Точность YOLO26x INT8 в трёх сборках упала до диапазона от 25,3 до 38,5 mAP против 57,5 у FP32. YOLO26n-pose INT8 показал снижение mAP поз с 56,7 до 33,4. Перед развёртыванием проверь каждый движок INT8 на собственных данных.
- Движки TensorRT 10.16 FP32 и FP16 для YOLO26n и YOLO26s показали такую же точность, как и TensorRT 11.4. Движки FP16 работали примерно на 7% быстрее, а движки FP32 — на 4–9% медленнее, чем в TensorRT 11.4.
Для NVIDIA Jetson и DGX Spark смотри результаты тестирования Jetson и руководство по DGX Spark.
Измерения проведены с ultralytics 8.4.211, TensorRT 11.4.0, PyTorch 2.15.0 и CUDA 13.2 на batch=1 13 ноября 2026 года. Задержка — это время этапа инференса, которое сообщает val; предобработка и постобработка не учитываются.
О TensorRT#
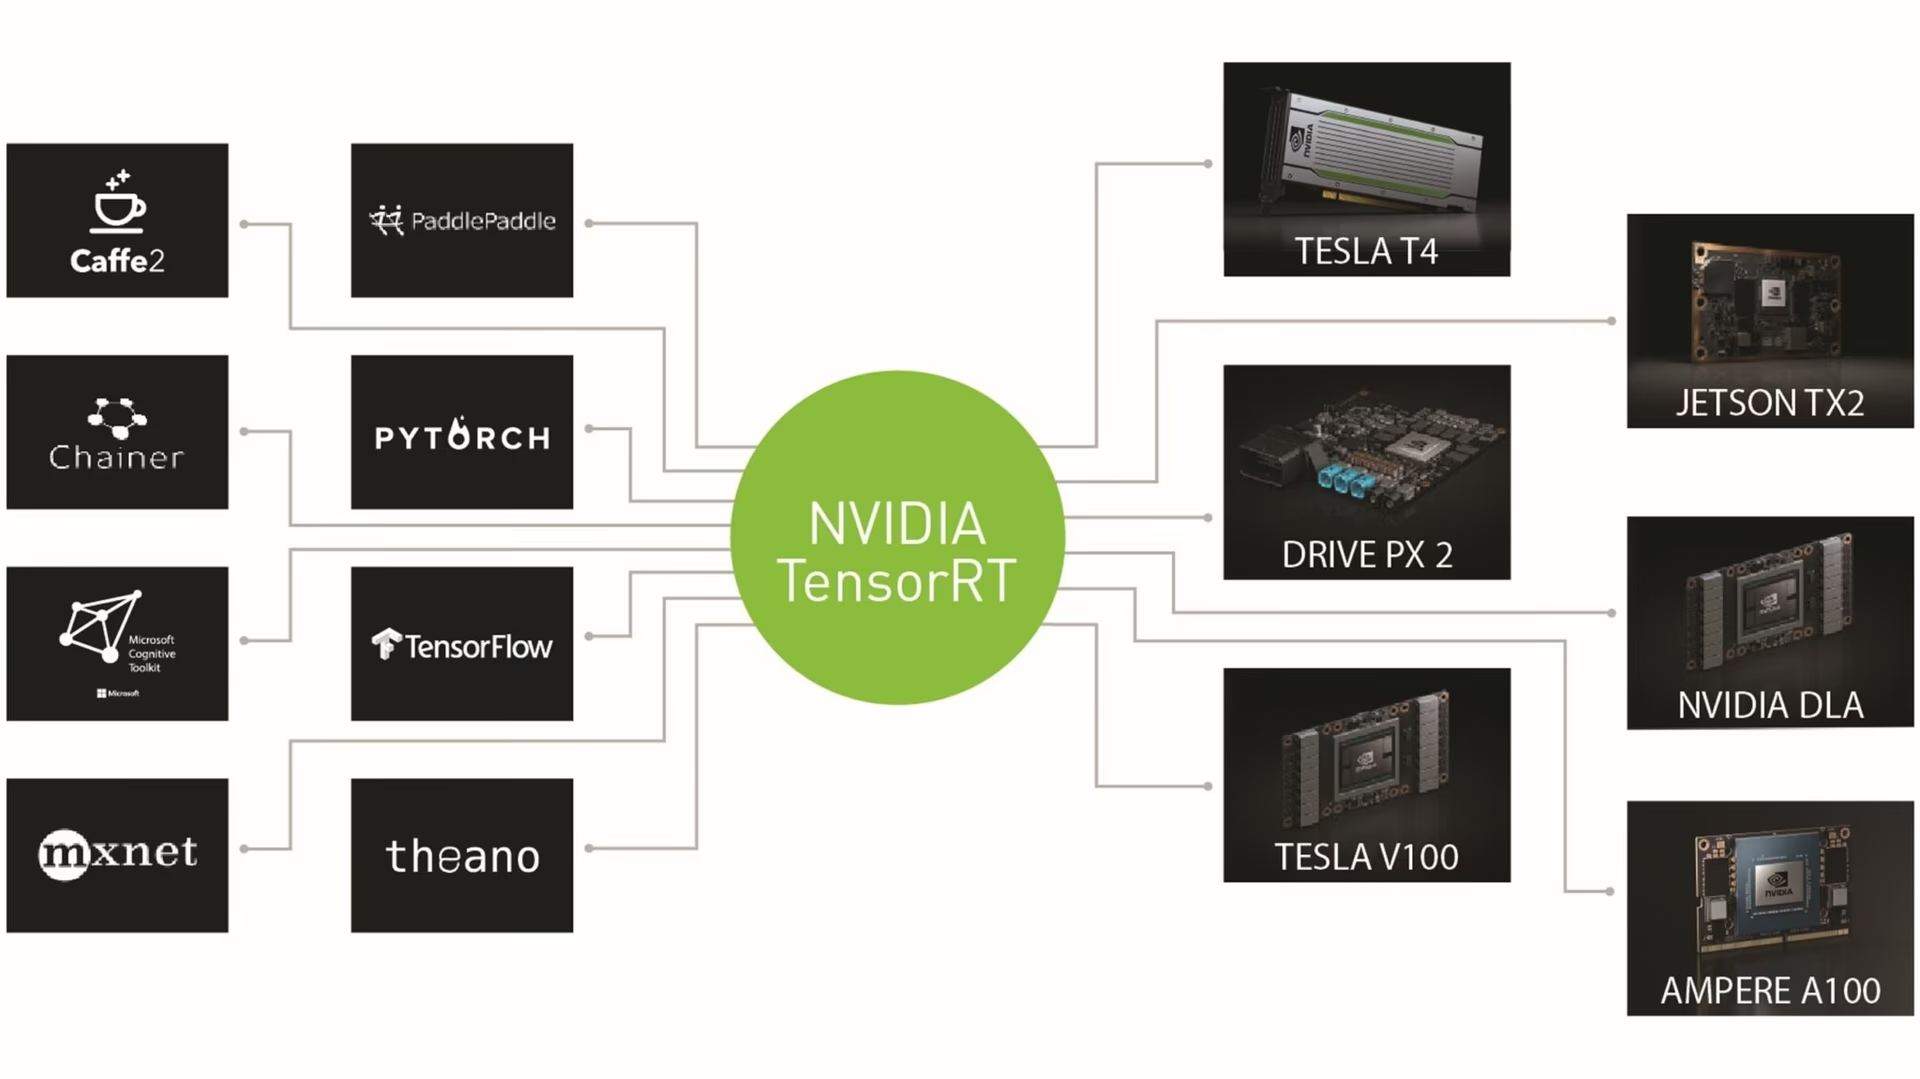
TensorRT собирает движок, объединяя слои, выбирая самое быстрое ядро для каждого слоя на GPU, используемом при сборке, и при необходимости снижая точность до FP16 или INT8. Полное описание смотри в документации TensorRT.
Часто задаваемые вопросы#
Только на GPU той же модели и с той же версией TensorRT. Движок собирается для конкретной модели GPU и конкретной версии TensorRT. Чтобы использовать один файл на разном оборудовании, экспортируй модель в ONNX и собери движок на каждом устройстве. Для NVIDIA Jetson Ultralytics Platform может собирать движки для восьми моделей Jetson.
Начни с FP16 (
quantize=16). Для него не нужны калибровочные данные, а точность FP32 сохраняется. В тестах производительности на NVIDIA RTX PRO 6000 Blackwell с TensorRT 11.4 FP16 снизил задержку YOLO26s с 1,15 мс до 0,61 мс на изображение при той же точности 48,5 mAPval 50-95. INT8 (quantize=8) показал 0,66 мс и 46,3 mAPval 50-95, то есть на этом GPU он не был быстрее FP16; кроме того, ему нужны репрезентативные калибровочные данные, если контрольная точка не обучалась сquantize=8. На другом оборудовании INT8 может дать преимущество: в тестах производительности Jetson приведены результаты FP16 и INT8 для встраиваемых устройств. Прежде чем выбирать INT8, измерь производительность обоих вариантов на устройстве, где будешь запускать модель.Экспортируй модель с
dynamic=Trueи установиbatchв максимальный размер пакета, который планируешь запускать. Тогда движок будет принимать пакеты размером от 1 доbatchи изображения размером от 32 пикселей до удвоенного размера экспортаimgsz; для динамических движков INT8 на старых GPU минимальный размер будет больше. Безdynamic=Trueу движка будет одна фиксированная форма входных данных, и Ultralytics будет разделять каждый пакет или дополнять его до нужного размера.Динамический движокfrom ultralytics import YOLO model = YOLO("yolo26n.pt") model.export(format="engine", dynamic=True, batch=8, quantize=16) model = YOLO("yolo26n.engine") results = model(["https://ultralytics.com/images/bus.jpg"] * 4, batch=4) # пакет из 4 изображенийЗапусти экспорт непосредственно на Jetson, используя версию TensorRT из своего выпуска JetPack. Чтобы использовать ядро DLA, добавь
device=dla:0сquantize=16илиquantize=8. Инструкции по настройке и результаты тестов смотри в руководстве по NVIDIA Jetson.Экспорт на Jetsonfrom ultralytics import YOLO model = YOLO("yolo26n.pt") model.export(format="engine", quantize=16) # Движок FP16 на GPU Jetson # Или собери движок FP16 для ядра DLA 0 model.export(format="engine", quantize=16, device="dla:0")В руководстве по Triton Inference Server модель экспортируется в ONNX и включается ускоритель TensorRT в Triton с помощью
config.pbtxt. При первой загрузке Triton собирает движок TensorRT на серверном GPU и кэширует его, поэтому движок всегда соответствует модели GPU и версии TensorRT на сервере. В руководстве описаны структура репозитория моделей, контейнер сервера и инференс на клиенте с Ultralytics.


Комментарии116
Задай вопрос, поделись результатами или помоги кому-нибудь.
AgbajeAyomipo
Hi Ultralytics team, I’ve trained a YOLOv11 model on (1024x1024) images from a camera feed and now I’m trying to run real-time inference on live streams using a Jetson Orin Nano. I want to maintain full resolution for inference because of accuracy requirements, but currently I'm getting only 1-2 FPS. When I reduce the input size, the FPS improves significantly, but it's not acceptable due to missed detections at lower resolutions. I attempted to export the model to TensorRT using:
model.export(format="engine", imgsz=(2592, 1944), half=True) but it fails silently. If I use a dynamic=true without specifying the imgsz parameter, the export succeeds and uses (1024, 1024). My questions:
Is TensorRT export for such high-resolution input supported/recommended with YOLOv11? If not, is there any known limitation or workaround? Are there ways to improve performance with high-res inference on Jetson Orin Nano? What hardware would you recommend for real-time inference on 1-3 camera streams with 5MP inputs, assuming we need at least ~15-20 FPS per stream? Device: AAEON BOXER-8621AI Module: NVIDIA® Jetson Orin Nano™ (4GB LPDDR5, Super Mode Enabled) Memory: 4 GB LPDDR5 I/O: USB 3.2 Gen 2, M.2 Expansion Operating System: JetPack 5.1.4 (L4T 35.6.0, Ubuntu 20.04) Use Case: Real-time multi-stream 5MP video inference
1martinmclee
Have you gotten any workaround? Perhaps with the YOLO26?
Hi Ultralytics team, I’ve trained a YOLOv11 model on full-size 5MP (2592x1944) images from a camera feed and now I’m trying to run real-time inference on live streams using a Jetson Orin Nano. I want to maintain full resolution for inference because of accuracy requirements, but currently I'm getting only 1-2 FPS. When I reduce the input size, the FPS improves significantly, but it's not acceptable due to missed detections at lower resolutions. I attempted to export the model to TensorRT using:
model.export(format="engine", imgsz=(2592, 1944), half=True)but it fails silently. If I use a dynamic=true, the export succeeds and uses (1024, 1024). My questions:- Is TensorRT export for such high-resolution input supported/recommended with YOLOv11? If not, is there any known limitation or workaround?
- Are there ways to improve performance with high-res inference on Jetson Orin Nano?
- What hardware would you recommend for real-time inference on 1-3 camera streams with 5MP inputs, assuming we need at least ~15-20 FPS per stream? Device: AAEON BOXER-8621AI Module: NVIDIA® Jetson Orin Nano™ (4GB LPDDR5, Super Mode Enabled) Memory: 4 GB LPDDR5 I/O: USB 3.2 Gen 2, M.2 Expansion Operating System: JetPack 5.1.4 (L4T 35.6.0, Ubuntu 20.04) Use Case: Real-time multi-stream 5MP video inference
1020423lzl
m的模型大小比n大的多,速度也慢了很多,输入图像尺寸越大,越吃显存,速度也越慢
李子乐控制工程 @.***
---Original--- From: @.> Date: Sat, May 9, 2026 10:30 AM To: @.>; Cc: @.@.>; Subject: Re: [ultralytics/ultralytics] zh/integrations/tensorrt/ (Discussion #9868)
现在有一个奇怪的现象,我导出的tensorrt模型的推理速度几乎和原来的.pt几乎没有差别甚至更慢,并且导出的tensorrt模型的推理结果和.pt模型的差别很大。 我的设备是i914900k+64G RAM+RTX A6000 我的环境是cuda12.4.131+tensorrt10.10.0.31+torch2.5.1+ultralytics8.3.252 导出命令: yolo export model=yolo11m.pt imgsz=1280 format='engine 推理代码为: model.predict(stream_path, imgsz=1280, classes=[14], conf=0.2, iou=0.5, stream=True, task='detect')
另外我试了下yolo11n.pt的640输入尺寸导出,推理速度就有明显提升,当然推理结果差别仍然较大。 请问这是什么道理,有什么解决办法?
— Reply to this email directly, view it on GitHub, or unsubscribe. Triage notifications on the go with GitHub Mobile for iOS or Android. You are receiving this because you commented.Message ID: @.***>
 User
能不能读完再说话,肯定是m和m比,n和n比,同样尺寸输入和同样尺寸输入的比啊。 该显卡的RT core算力是普通fp32算力的近两倍。
 Glenn JocherUltralytics
是的,性能应当在同一模型、同一
imgsz、同一batch、同一后处理参数下比较;m比n更大、1280比640更吃显存且更慢是正常现象。对 RTX A6000 来说,FP32的 TensorRT 往往不会比.pt明显更快,建议先按 TensorRT 导出文档 用half=True重新导出,并在相同输入上预热后再统计平均耗时;如果engine与.pt结果仍明显不一致,请贴出!yolo checks、完整控制台日志文本和一个最小可复现示例,我们好继续排查环境或后处理差异。
- User
现在有一个奇怪的现象,我导出的tensorrt模型的推理速度几乎和原来的.pt几乎没有差别甚至更慢,并且导出的tensorrt模型的推理结果和.pt模型的差别很大。 我的设备是i914900k+64G RAM+RTX A6000 我的环境是cuda12.4.131+tensorrt10.10.0.31+torch2.5.1+ultralytics8.3.252 导出命令:
yolo export model=yolo11m.pt imgsz=1280 format='engine推理代码为:model.predict(stream_path, imgsz=1280, classes=[14], conf=0.2, iou=0.5, stream=True, task='detect')另外我试了下yolo11n.pt的640输入尺寸导出,推理速度就有明显提升,当然推理结果差别仍然较大。 请问这是什么道理,有什么解决办法?
etson@yahboom:~/ultralytics/ultralytics$ yolo predict model=best.engine source=0 save=False show WARNING ⚠️ Unable to automatically guess model task, assuming 'task=detect'. Explicitly define task for your model, i.e. 'task=detect', 'segment', 'classify','pose' or 'obb'. Ultralytics 8.3.172 🚀 Python-3.10.12 torch-2.5.0a0+872d972e41.nv24.08 CUDA:0 (Orin, 7620MiB) Loading best.engine for TensorRT inference... [12/18/2025-17:11:05] [TRT] [I] Loaded engine size: 75 MiB [12/18/2025-17:11:05] [TRT] [I] [MS] Running engine with multi stream info [12/18/2025-17:11:05] [TRT] [I] [MS] Number of aux streams is 7 [12/18/2025-17:11:05] [TRT] [I] [MS] Number of total worker streams is 8 [12/18/2025-17:11:05] [TRT] [I] [MS] The main stream provided by execute/enqueue calls is the first worker stream [12/18/2025-17:11:05] [TRT] [I] [MemUsageChange] TensorRT-managed allocation in IExecutionContext creation: CPU +1, GPU +88, now: CPU 1, GPU 158 (MiB)
[ WARN:0@2.771] global cap_gstreamer.cpp:1777 open OpenCV | GStreamer warning: Cannot query video position: status=0, value=-1, duration=-1 1/1: 0... Success ✅ (inf frames of shape 1920x1080 at 5.00 FPS)
Traceback (most recent call last): File "/home/jetson/.local/bin/yolo", line 7, in sys.exit(entrypoint()) File "/home/jetson/Downloads/ultralytics-main/ultralytics/cfg/init.py", line 983, in entrypoint getattr(model, mode)(**overrides) # default args from model File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/model.py", line 555, in predict return self.predictor.predict_cli(source=source) if is_cli else self.predictor(source=source, stream=stream) File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/predictor.py", line 247, in predict_cli for _ in gen: # sourcery skip: remove-empty-nested-block, noqa File "/usr/local/lib/python3.10/dist-packages/torch/utils/_contextlib.py", line 36, in generator_context response = gen.send(None) File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/predictor.py", line 351, in stream_inference s[i] += self.write_results(i, Path(paths[i]), im, s) File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/predictor.py", line 434, in write_results string += f"{result.verbose()}{result.speed['inference']:.1f}ms" File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/results.py", line 694, in verbose return "".join(f"{n} {self.names[i]}{'s' * (n > 1)}, " for i, n in enumerate(counts) if n > 0) File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/results.py", line 694, in return "".join(f"{n} {self.names[i]}{'s' * (n > 1)}, " for i, n in enumerate(counts) if n > 0) KeyError: 171 terminate called without an active exception Aborted (core dumped) jetson@yahboom:~/ultralytics/ultralytics$ How to solve it
- Glenn JocherUltralytics
KeyError: 171表示模型输出了类别171,但当前names里没有这个索引(通常是自定义数据集的标签类别编号不在0..nc-1范围内、data.yaml里的names数量与nc不匹配,或导出/推理用的模型与数据配置不一致导致的元数据错配);请先把所有标注.txt的 class id 修正为连续的0..nc-1,同步修正data.yaml的nc/names,修正后删除数据集labels/下的*.cache,再用同一套环境从best.pt重新导出.engine(参考 TensorRT 导出文档),并在推理时显式加上task=detect。另外请把下面命令的完整输出(文本)贴在这个 discussion 里,以及你当时的导出命令,方便我们确认是否有多环境/路径冲突:yolo checks Thank you for your reply. The issue has been resolved. I was using the RT-DETR model, but I mistakenly used "from ultralytics import YOLO" when exporting
- Glenn JocherUltralytics
Glad you found it — RT-DETR models should be loaded/exported with
RTDETR(...)(mixing them withYOLO(...)can produce mismatched metadata likenames), see the RT-DETR model docs for details:from ultralytics import RTDETR model = RTDETR("best.pt") model.export(format="engine") # creates best.engine
fly2skyToEnjoy
May I ask : The following command exports the file, whether the box and mask are both nmsed at the same time ???
from ultralytics import YOLO
Load the YOLO11 model
model = YOLO("yolo11n.pt")
Export the model to TensorRT format
model.export(format="engine") # creates 'yolo11n.engine'
Load the exported TensorRT model
tensorrt_model = YOLO("yolo11n.engine")
Run inference
results = tensorrt_model("https://ultralytics.com/images/bus.jpg")
AK993
这个方法适用于rt-detr吗
dilanpatel195
I am trying to prediction model for the YOLOv11n-seg, I have exported the .py to .engine to back it run faster but keep getting a KEY error message:
KeyError Traceback (most recent call last) Cell In[4], line 109 106 # Inside the main loop after grabbing a frame 107 if inference_active and not inpainting_active: 108 # Perform YOLO inference --> 109 results = model(rgb_frame)[0] 110 masked_image = rgb_frame.copy() # Make a copy for masking 112 # Process YOLO masks (original functionality remains unchanged)
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\model.py:176, in Model.call(self, source, stream, **kwargs) 147 def call( 148 self, 149 source: Union[str, Path, int, Image.Image, list, tuple, np.ndarray, torch.Tensor] = None, 150 stream: bool = False, 151 **kwargs, 152 ) -> list: 153 """ 154 Alias for the predict method, enabling the model instance to be callable for predictions. 155 (...) 174 ... print(f"Detected {len(r)} objects in image") 175 """ --> 176 return self.predict(source, stream, **kwargs)
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\model.py:554, in Model.predict(self, source, stream, predictor, **kwargs) 552 if prompts and hasattr(self.predictor, "set_prompts"): # for SAM-type models 553 self.predictor.set_prompts(prompts) --> 554 return self.predictor.predict_cli(source=source) if is_cli else self.predictor(source=source, stream=stream)
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\predictor.py:168, in BasePredictor.call(self, source, model, stream, *args, **kwargs) 166 return self.stream_inference(source, model, *args, **kwargs) 167 else: --> 168 return list(self.stream_inference(source, model, *args, **kwargs))
File c:\ProgramData\miniconda3\Lib\site-packages\torch\utils_contextlib.py:36, in _wrap_generator..generator_context(*args, **kwargs) 33 try: 34 # Issuing None to a generator fires it up 35 with ctx_factory(): ---> 36 response = gen.send(None) 38 while True: 39 try: 40 # Forward the response to our caller and get its next request
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\predictor.py:274, in BasePredictor.stream_inference(self, source, model, *args, **kwargs) 268 self.results[i].speed = { 269 "preprocess": profilers[0].dt * 1e3 / n, 270 "inference": profilers[1].dt * 1e3 / n, 271 "postprocess": profilers[2].dt * 1e3 / n, 272 } 273 if self.args.verbose or self.args.save or self.args.save_txt or self.args.show: --> 274 s[i] += self.write_results(i, Path(paths[i]), im, s) 276 # Print batch results 277 if self.args.verbose:
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\predictor.py:334, in BasePredictor.write_results(self, i, p, im, s) 332 result = self.results[i] 333 result.save_dir = self.save_dir.str() # used in other locations --> 334 string += f"{result.verbose()}{result.speed['inference']:.1f}ms" 336 # Add predictions to image 337 if self.args.save or self.args.show:
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\results.py:663, in Results.verbose(self) 661 for c in boxes.cls.unique(): 662 n = (boxes.cls == c).sum() # detections per class --> 663 log_string += f"{n} {self.names[int(c)]}{'s' * (n > 1)}, " 664 return log_string
KeyError: 2
Any help would be greatly appreciated!
Ranjith3436
Now, My TensorRT Sengment model used for track. if any detections not there the processing FPS is 75-80 in jetson. But once the person or people detected suddenly reused to 15-20. processing time going to 40ms. only when the object detected. What's the issue in model.track(), could i run all the tracking thing on GPU.
- Glenn JocherUltralytics(изменено)
@Ranjith3436 the performance drop when objects are detected is expected behavior, as tracking introduces additional computational overhead. When objects are detected, the model.track() method performs several CPU-bound operations including feature extraction, association, and trajectory management.
To improve performance:
- Try using a smaller model variant (like YOLO26n-seg instead of larger variants)
- Consider reducing the image resolution for tracking
- Optimize tracking parameters by setting
persist=Trueand adjustingconfthresholds higher to track fewer objects - Use
half=True(FP16) orint8=Truewhen exporting your model to TensorRT for maximum GPU acceleration
For the tracking components specifically, the BoT-SORT or ByteTrack algorithms used by Ultralytics do have some CPU-bound operations, but you can minimize their impact with the above optimizations. For more details on tracking optimization, check our tracking documentation.
1
I convert Classification model that i retrained. But it throw the error "amax(): Expected reduction dim 1 to have non-zero size."
- Glenn JocherUltralytics
@Ranjith3436 this error typically occurs when TensorRT encounters an empty dimension during model conversion. For classification models, this could happen if:
- Your model architecture was modified or if you're using a custom architecture
- There might be an issue with batch normalization layers during export
- The class count in your retrained model might be causing dimension mismatches
Try these solutions:
- Ensure your model's forward pass works correctly before export
- Try exporting with
simplify=Falseto preserve the original graph structure - Check if your classification model has the correct output dimension for your number of classes
If the issue persists, share more details about your model architecture and export command for better assistance. For more guidance, refer to our TensorRT integration documentation.
The model trained use yolov8l-cls.pt and the error come from jetson device.
(model): ClassificationModel( (model): Sequential( (0): Conv( (conv): Conv2d(3, 64, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (1): Conv( (conv): Conv2d(64, 128, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (2): C2f( (cv1): Conv( (conv): Conv2d(128, 128, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(320, 128, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (m): ModuleList( (0-2): 3 x Bottleneck( (cv1): Conv( (conv): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) ) ) ) (3): Conv( (conv): Conv2d(128, 256, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (4): C2f( (cv1): Conv( (conv): Conv2d(256, 256, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(1024, 256, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (m): ModuleList( (0-5): 6 x Bottleneck( (cv1): Conv( (conv): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) ) ) ) (5): Conv( (conv): Conv2d(256, 512, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (6): C2f( (cv1): Conv( (conv): Conv2d(512, 512, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(2048, 512, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (m): ModuleList( (0-5): 6 x Bottleneck( (cv1): Conv( (conv): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) ) ) ) (7): Conv( (conv): Conv2d(512, 1024, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(1024, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (8): C2f( (cv1): Conv( (conv): Conv2d(1024, 1024, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(1024, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(2560, 1024, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(1024, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (m): ModuleList( (0-2): 3 x Bottleneck( (cv1): Conv( (conv): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) ) ) ) (9): Classify( (conv): Conv( (conv): Conv2d(1024, 1280, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(1280, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (pool): AdaptiveAvgPool2d(output_size=1) (drop): Dropout(p=0.0, inplace=True) (linear): Linear(in_features=1280, out_features=2, bias=True) ) ) ) )
model architecture
This error sorted out