TT100K Veri Kümesi#
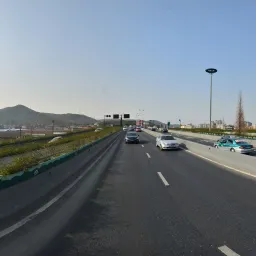
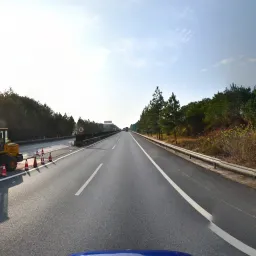
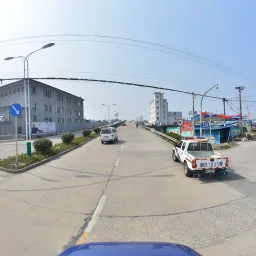
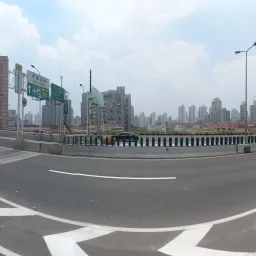
Tsinghua-Tencent 100K (TT100K) veri kümesi, Zhu ve arkadaşları tarafından CVPR 2016 kapsamında yayımlanan Traffic-Sign Detection and Classification in the Wild makalesi için oluşturulmuş bir nesne algılama kıyaslama veri kümesidir. Ultralytics TT100K yapılandırması, 221 trafik işareti kategorisinde 16.817 görüntü (6.105 eğitim / 7.641 doğrulama / 3.071 test) sunar; kaynak kıyaslama çalışmasında 30.000'den fazla işaret örneği bildirilmiştir. Adındaki "100K", kıyaslamanın oluşturulduğu yaklaşık 100.000 Tencent Street View görüntüsünü ifade eder; indirip üzerinde eğitim yaptığın görüntü sayısını değil. Özgün makale yalnızca en az 100 eğitim örneğine sahip kategorileri tuttuğundan, yaygın olarak kullanılan 45 sınıflı bir alt küme bulunur; ancak Ultralytics yapılandırması açıklanmış 221 kategorinin tamamını korur (bunların çoğunda az sayıda örnek vardır).
Yüksek çözünürlüklü sokak görünümü görüntüleri aydınlatma, hava durumu, görüş açısı ve mesafe bakımından büyük farklılıklar içerir. Bu da TT100K'yı gerçek dünyadaki sürüş sahnelerinde küçük nesne algılama için zorlu bir kıyaslama veri kümesi hâline getirir.
Temel Özellikler#
- Çok sınıflı algılama: Çin'e özgü hız sınırı, yasaklayıcı, uyarı, yükseklik/genişlik sınırı ve bilgilendirici işaretleri kapsayan 221 trafik işareti kategorisi.
- Yüksek çözünürlük: 2048×2048 piksel görüntüler; işaretler büyük yakın planlardan, ince ayrıntılı algılamayı zorlayan uzaktaki küçük işaretlere kadar çeşitlilik gösterir.
- Gerçek dünya koşulları: Hava durumu, aydınlatma, görüş açısı ve örtülme bakımından büyük farklılıklar.
- Sınırlayıcı kutu açıklamaları: Her işaret, otomatik dönüştürme sonrasında YOLO biçiminde bir sınıf ve sınırlayıcı kutu ile etiketlenir.
- Önceden tanımlanmış bölmeler: Tutarlı değerlendirme için sabit eğitim / doğrulama / test bölmeleri (6.105 / 7.641 / 3.071 görüntü).
Veri Kümesi Yapısı#
Ultralytics TT100K yapılandırması, tümü aynı 221 kategoriyi paylaşan üç alt kümeye ayrılır:
| Bölüm | Görüntüler | Açıklama |
|---|---|---|
| Eğit | 6,105 | Algılayıcıyı eğitmek için kullanılan etiketli trafik sahnesi görüntüleri |
| Doğrulama | 7,641 | Veri kümesinin değerlendirme için kullanılan özgün "other" bölmesi |
| Test | 3,071 | Eğitilmiş modelin son değerlendirmesi için ayrılan görüntüler |
221 kategori birkaç ana grup altında düzenlenmiştir:
- Hız sınırı işaretleri — yasaklayıcı sınırlar
pl*(ör. pl5–pl120) ve asgari hızlarpm*(ör. pm5–pm55). - Yasaklayıcı işaretler — genel yasaklar
p1–p29, giriş yasaklama/park etme yasağıpn/pneve kısıtlamalarpr*(pr10–pr100). - Uyarı işaretleri — yol geçişleri, keskin dönüşler, kaygan yollar ve yol çalışmaları gibi yol tehlikeleri için
w1–w67. - Yükseklik/genişlik sınırı işaretleri — yükseklik sınırları
ph*(ör. ph2–ph5.5) ve genişlik sınırlarıpb/pw*. - Bilgilendirici işaretler — genel bilgiler
i1–i15, hız sınırı bilgileriil*(il50–il110), diğer bilgileriove bilgi levhalarıip.
Uygulamalar#
TT100K, gerçek dünya koşullarında trafik işareti tanıma sistemleri oluşturmak ve kıyaslamak için yaygın olarak kullanılır. Yaygın uygulamalar şunlardır:
- Otonom sürüş algı sistemleri
- Gelişmiş sürücü destek sistemleri (ADAS)
- Trafik izleme ve yol altyapısı analizi
- Kentsel planlama ve trafik akışı çalışmaları
- Yüksek çözünürlüklü görüntülerde küçük nesneler üzerine bilgisayarlı görü araştırmaları
Veri Kümesi YAML'i#
TT100K.yaml dosyası, veri kümesi yapılandırmasını — veri kümesi yollarını, sınıf adlarını ve otomatik indirme ve dönüştürme betiğini — tanımlar. Bu dosya, Ultralytics deposunda https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/TT100K.yaml adresinde tutulur.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Tsinghua-Tencent 100K (TT100K) dataset https://cg.cs.tsinghua.edu.cn/traffic-sign/ by Tsinghua University
# Documentation: https://cg.cs.tsinghua.edu.cn/traffic-sign/tutorial.html
# Paper: Traffic-Sign Detection and Classification in the Wild (CVPR 2016)
# License: CC BY-NC 2.0 license for non-commercial use only
# Example usage: yolo train data=TT100K.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── TT100K ← downloads here (~18 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: TT100K # dataset root dir
train: images/train # train images (relative to 'path') 6105 images
val: images/val # val images (relative to 'path') 7641 images (original 'other' split)
test: images/test # test images (relative to 'path') 3071 images

# Classes (221 traffic sign categories, 45 with sufficient training instances)
names:
  0: i1
  1: i10
  2: i11
  3: i12
  4: i13
  5: i14
  6: i15
  7: i2
  8: i3
  9: i4
  10: i5
  11: il100
  12: il110
  13: il50
  14: il60
  15: il70
  16: il80
  17: il90
  18: io
  19: ip
  20: p1
  21: p10
  22: p11
  23: p12
  24: p13
  25: p14
  26: p15
  27: p16
  28: p17
  29: p18
  30: p19
  31: p2
  32: p20
  33: p21
  34: p22
  35: p23
  36: p24
  37: p25
  38: p26
  39: p27
  40: p28
  41: p3
  42: p4
  43: p5
  44: p6
  45: p7
  46: p8
  47: p9
  48: pa10
  49: pa12
  50: pa13
  51: pa14
  52: pa8
  53: pb
  54: pc
  55: pg
  56: ph1.5
  57: ph2
  58: ph2.1
  59: ph2.2
  60: ph2.4
  61: ph2.5
  62: ph2.8
  63: ph2.9
  64: ph3
  65: ph3.2
  66: ph3.5
  67: ph3.8
  68: ph4
  69: ph4.2
  70: ph4.3
  71: ph4.5
  72: ph4.8
  73: ph5
  74: ph5.3
  75: ph5.5
  76: pl10
  77: pl100
  78: pl110
  79: pl120
  80: pl15
  81: pl20
  82: pl25
  83: pl30
  84: pl35
  85: pl40
  86: pl5
  87: pl50
  88: pl60
  89: pl65
  90: pl70
  91: pl80
  92: pl90
  93: pm10
  94: pm13
  95: pm15
  96: pm1.5
  97: pm2
  98: pm20
  99: pm25
  100: pm30
  101: pm35
  102: pm40
  103: pm46
  104: pm5
  105: pm50
  106: pm55
  107: pm8
  108: pn
  109: pne
  110: po
  111: pr10
  112: pr100
  113: pr20
  114: pr30
  115: pr40
  116: pr45
  117: pr50
  118: pr60
  119: pr70
  120: pr80
  121: ps
  122: pw2
  123: pw2.5
  124: pw3
  125: pw3.2
  126: pw3.5
  127: pw4
  128: pw4.2
  129: pw4.5
  130: w1
  131: w10
  132: w12
  133: w13
  134: w16
  135: w18
  136: w20
  137: w21
  138: w22
  139: w24
  140: w28
  141: w3
  142: w30
  143: w31
  144: w32
  145: w34
  146: w35
  147: w37
  148: w38
  149: w41
  150: w42
  151: w43
  152: w44
  153: w45
  154: w46
  155: w47
  156: w48
  157: w49
  158: w5
  159: w50
  160: w55
  161: w56
  162: w57
  163: w58
  164: w59
  165: w60
  166: w62
  167: w63
  168: w66
  169: w8
  170: wo
  171: i6
  172: i7
  173: i8
  174: i9
  175: ilx
  176: p29
  177: w29
  178: w33
  179: w36
  180: w39
  181: w4
  182: w40
  183: w51
  184: w52
  185: w53
  186: w54
  187: w6
  188: w61
  189: w64
  190: w65
  191: w67
  192: w7
  193: w9
  194: pax
  195: pd
  196: pe
  197: phx
  198: plx
  199: pmx
  200: pnl
  201: prx
  202: pwx
  203: w11
  204: w14
  205: w15
  206: w17
  207: w19
  208: w2
  209: w23
  210: w25
  211: w26
  212: w27
  213: pl0
  214: pl4
  215: pl3
  216: pm2.5
  217: ph4.4
  218: pn40
  219: ph3.3
  220: ph2.6

# Download script/URL (optional) ---------------------------------------------------------------------------------------
download: |
  import json
  import shutil
  from pathlib import Path

  from PIL import Image

  from ultralytics.utils import TQDM
  from ultralytics.utils.downloads import download

  def tt100k2yolo(dir):
      """Convert TT100K annotations to YOLO format with images/{split} and labels/{split} structure."""
      data_dir = dir / "data"
      anno_file = data_dir / "annotations.json"

      print("Loading annotations...")
      with open(anno_file, encoding="utf-8") as f:
          data = json.load(f)

      # Build class name to index mapping from yaml
      names = yaml["names"]
      class_to_idx = {v: k for k, v in names.items()}

      # Create directories
      for split in ["train", "val", "test"]:
          (dir / "images" / split).mkdir(parents=True, exist_ok=True)
          (dir / "labels" / split).mkdir(parents=True, exist_ok=True)

      print("Converting annotations to YOLO format...")
      skipped = 0
      for img_id, img_data in TQDM(data["imgs"].items(), desc="Processing"):
          img_path_str = img_data["path"]
          if "train" in img_path_str:
              split = "train"
          elif "test" in img_path_str:
              split = "test"
          else:
              split = "val"

          # Source and destination paths
          src_img = data_dir / img_path_str
          if not src_img.exists():
              continue

          dst_img = dir / "images" / split / src_img.name

          # Get image dimensions
          try:
              with Image.open(src_img) as img:
                  img_width, img_height = img.size
          except Exception as e:
              print(f"Error reading {src_img}: {e}")
              continue

          # Copy image to destination
          shutil.copy2(src_img, dst_img)

          # Convert annotations
          label_file = dir / "labels" / split / f"{src_img.stem}.txt"
          lines = []

          for obj in img_data.get("objects", []):
              category = obj["category"]
              if category not in class_to_idx:
                  skipped += 1
                  continue

              bbox = obj["bbox"]
              xmin, ymin = bbox["xmin"], bbox["ymin"]
              xmax, ymax = bbox["xmax"], bbox["ymax"]

              # Convert to YOLO format (normalized center coordinates and dimensions)
              x_center = ((xmin + xmax) / 2.0) / img_width
              y_center = ((ymin + ymax) / 2.0) / img_height
              width = (xmax - xmin) / img_width
              height = (ymax - ymin) / img_height

              # Clip to valid range
              x_center = max(0, min(1, x_center))
              y_center = max(0, min(1, y_center))
              width = max(0, min(1, width))
              height = max(0, min(1, height))

              cls_idx = class_to_idx[category]
              lines.append(f"{cls_idx} {x_center:.6f} {y_center:.6f} {width:.6f} {height:.6f}\n")

          # Write label file
          if lines:
              label_file.write_text("".join(lines), encoding="utf-8")

      if skipped:
          print(f"Skipped {skipped} annotations with unknown categories")
      print("Conversion complete!")

  # Download
  dir = Path(yaml["path"])  # dataset root dir
  urls = ["https://cg.cs.tsinghua.edu.cn/traffic-sign/data_model_code/data.zip"]
  download(urls, dir=dir, curl=True, threads=1)

  # Convert
tt100k2yolo(dir)Kullanım#
TT100K, ilk eğitim yaptığında otomatik olarak indirilir ve yaklaşık 18 GB boş disk alanı gerektirir. İlk kullanımda indirme betiği özgün verileri alır ve açıklamaları YOLO biçimine dönüştürür; bu işlem birkaç dakika sürebilir.
TT100K veri kümesi üzerinde 640 görüntü boyutuyla 100 epoch boyunca bir YOLO26n modelini eğitmek için aşağıdaki kod parçacıklarını kullanabilirsin. Kullanılabilir bağımsız değişkenlerin kapsamlı listesi için model Eğitimi sayfasına bakabilirsin.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n.pt")  # load a pretrained model (recommended for training)

# Train the model - dataset will auto-download on first run
results = model.train(data="TT100K.yaml", epochs=100, imgsz=640)
Ek trafik işareti görüntülerini etiketlemek ve TT100K eğitim çalışmalarını tarayıcında yönetmek için Ultralytics Platform kullanabilirsin.
Örnek Veriler ve Açıklamalar#
TT100K görüntüleri, trafik işaretlerinin genellikle karenin yalnızca küçük bir bölümünü kapladığı 2048×2048 boyutunda sokak sahneleridir. Tek bir görüntü, farklı ölçek ve mesafelerde birden fazla işaret içerebilir; bu işaretlerin bazıları araçlar, bitki örtüsü veya yapılar tarafından kısmen örtülmüş olabilir ve görüntüler gündüz/gece ile açık/yağmurlu koşullarda çekilmiş olabilir. Küçük nesneler ile zorlu koşulların bu birleşimi, veri kümesini algılayıcı sağlamlığı için güçlü bir test hâline getirir.
Atıflar ve Teşekkürler#
TT100K veri kümesini araştırma veya geliştirme çalışmalarında kullanıyorsan lütfen aşağıdaki makaleye atıfta bulun:
@InProceedings{Zhu_2016_CVPR,
    author = {Zhu, Zhe and Liang, Dun and Zhang, Songhai and Huang, Xiaolei and Li, Baoli and Hu, Shimin},
    title = {Traffic-Sign Detection and Classification in the Wild},
    booktitle = {The IEEE Conference on Computer Vision and Pattern Recognition (CVPR)},
    month = {June},
    year = {2016}
}
Bilgisayarlı görü ve otonom sürüş toplulukları için bu değerli kaynağı oluşturan ve sürdüren Tsinghua University ile Tencent iş birliğini takdirle anıyoruz. TT100K veri kümesi hakkında daha fazla bilgi için resmî veri kümesi web sitesini ziyaret edebilirsin.
SSS#
Tsinghua-Tencent 100K (TT100K) veri kümesi, gerçek dünya koşullarında trafik işareti algılama ve sınıflandırma için kullanılır. Veri kümesindeki 221 kategori ve yüksek çözünürlüklü sokak görünümü görüntüleri, onu otonom sürüş algısı, gelişmiş sürücü destek sistemleri (ADAS) ve küçük nesne algılama araştırmaları için yaygın bir kıyaslama veri kümesi hâline getirir.
Ultralytics TT100K yapılandırması 16.817 görüntü içerir: eğitim için 6.105, doğrulama için 7.641 (veri kümesinin özgün "other" bölmesi) ve test için 3.071 görüntü. Ayrıntılı dağılım için Veri Kümesi Yapısı bölümüne bakabilirsin.
"100K", özgün kıyaslama çalışmasının oluşturulduğu yaklaşık 100.000 Tencent Street View görüntüsünü ifade eder. Ultralytics algılama yapılandırması, bu görüntülerin 16.817 tanesini YOLO biçiminde etiketlerle sunar; ad, eğitim kümesinin boyutunu değil, kaynak koleksiyonu yansıtır.
TT100K; hız sınırı, yasaklayıcı, uyarı, yükseklik/genişlik sınırı ve bilgilendirici işaretleri kapsayan 221 kategori tanımlar. Özgün makale, en az 100 eğitim örneğine sahip 45 kategoriyi tutar; ancak Ultralytics yapılandırması 221 kategorinin tamamını korur. Grup dağılımı için Veri Kümesi Yapısı bölümüne bakabilirsin.
TT100K yaklaşık 18 GB boyutundadır ve
data="TT100K.yaml"ile ilk kez eğitim yaptığında otomatik olarak indirilir — elle indirme gerekmez. Betik ayrıca ilk çalıştırmada özgün açıklamaları YOLO biçimine dönüştürür.TT100K üzerinde 640 görüntü boyutuyla 100 epoch boyunca bir YOLO26n modeli eğit:
Eğitim Örneğifrom ultralytics import YOLO # Load a model model = YOLO("yolo26n.pt") # load a pretrained model (recommended for training) # Train the model results = model.train(data="TT100K.yaml", epochs=100, imgsz=640)Ayrıntılı yapılandırmalar için Eğitim sayfasına ve model eğitimi ipuçlarına bakabilirsin.
İlk denemeler için
imgsz=640ile başla; ardından yeterli GPU belleğin varsa, daha küçük birbatchile birlikteimgsz=1280değerini artırabilirsin. Daha yüksek çözünürlük, uzaktaki küçük işaretlerin yeniden elde edilmesine yardımcı olur:model.train(data="TT100K.yaml", imgsz=1280, batch=4) # higher resolution for small signsAyrıca veri artırmayı ayarlayabilir ve çok küçük nesneler için döşeme stratejilerini değerlendirebilirsin. Daha fazla bilgi için Model Eğitimi İpuçları sayfasına bakabilirsin.