Bilgi Damıtımı
Hızlı Başlangıç#
distill_model argümanını ekleyerek daha büyük bir öğretmen modelinin rehberliğinde daha küçük bir öğrenci modeli eğit:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(data="coco8.yaml", epochs=100, distill_model="yolo26s.pt")
Bilgi Damıtımı Nedir?#
Bilgi damıtımı, büyük ve doğru bir öğretmen modelindeki bilgiyi daha küçük bir öğrenci modele aktarır. Öğrenci, öğretmenin dahili özellik gösterimlerini taklit etmeyi öğrenir ve çoğu zaman sıfırdan eğitime kıyasla daha yüksek doğruluk elde eder.
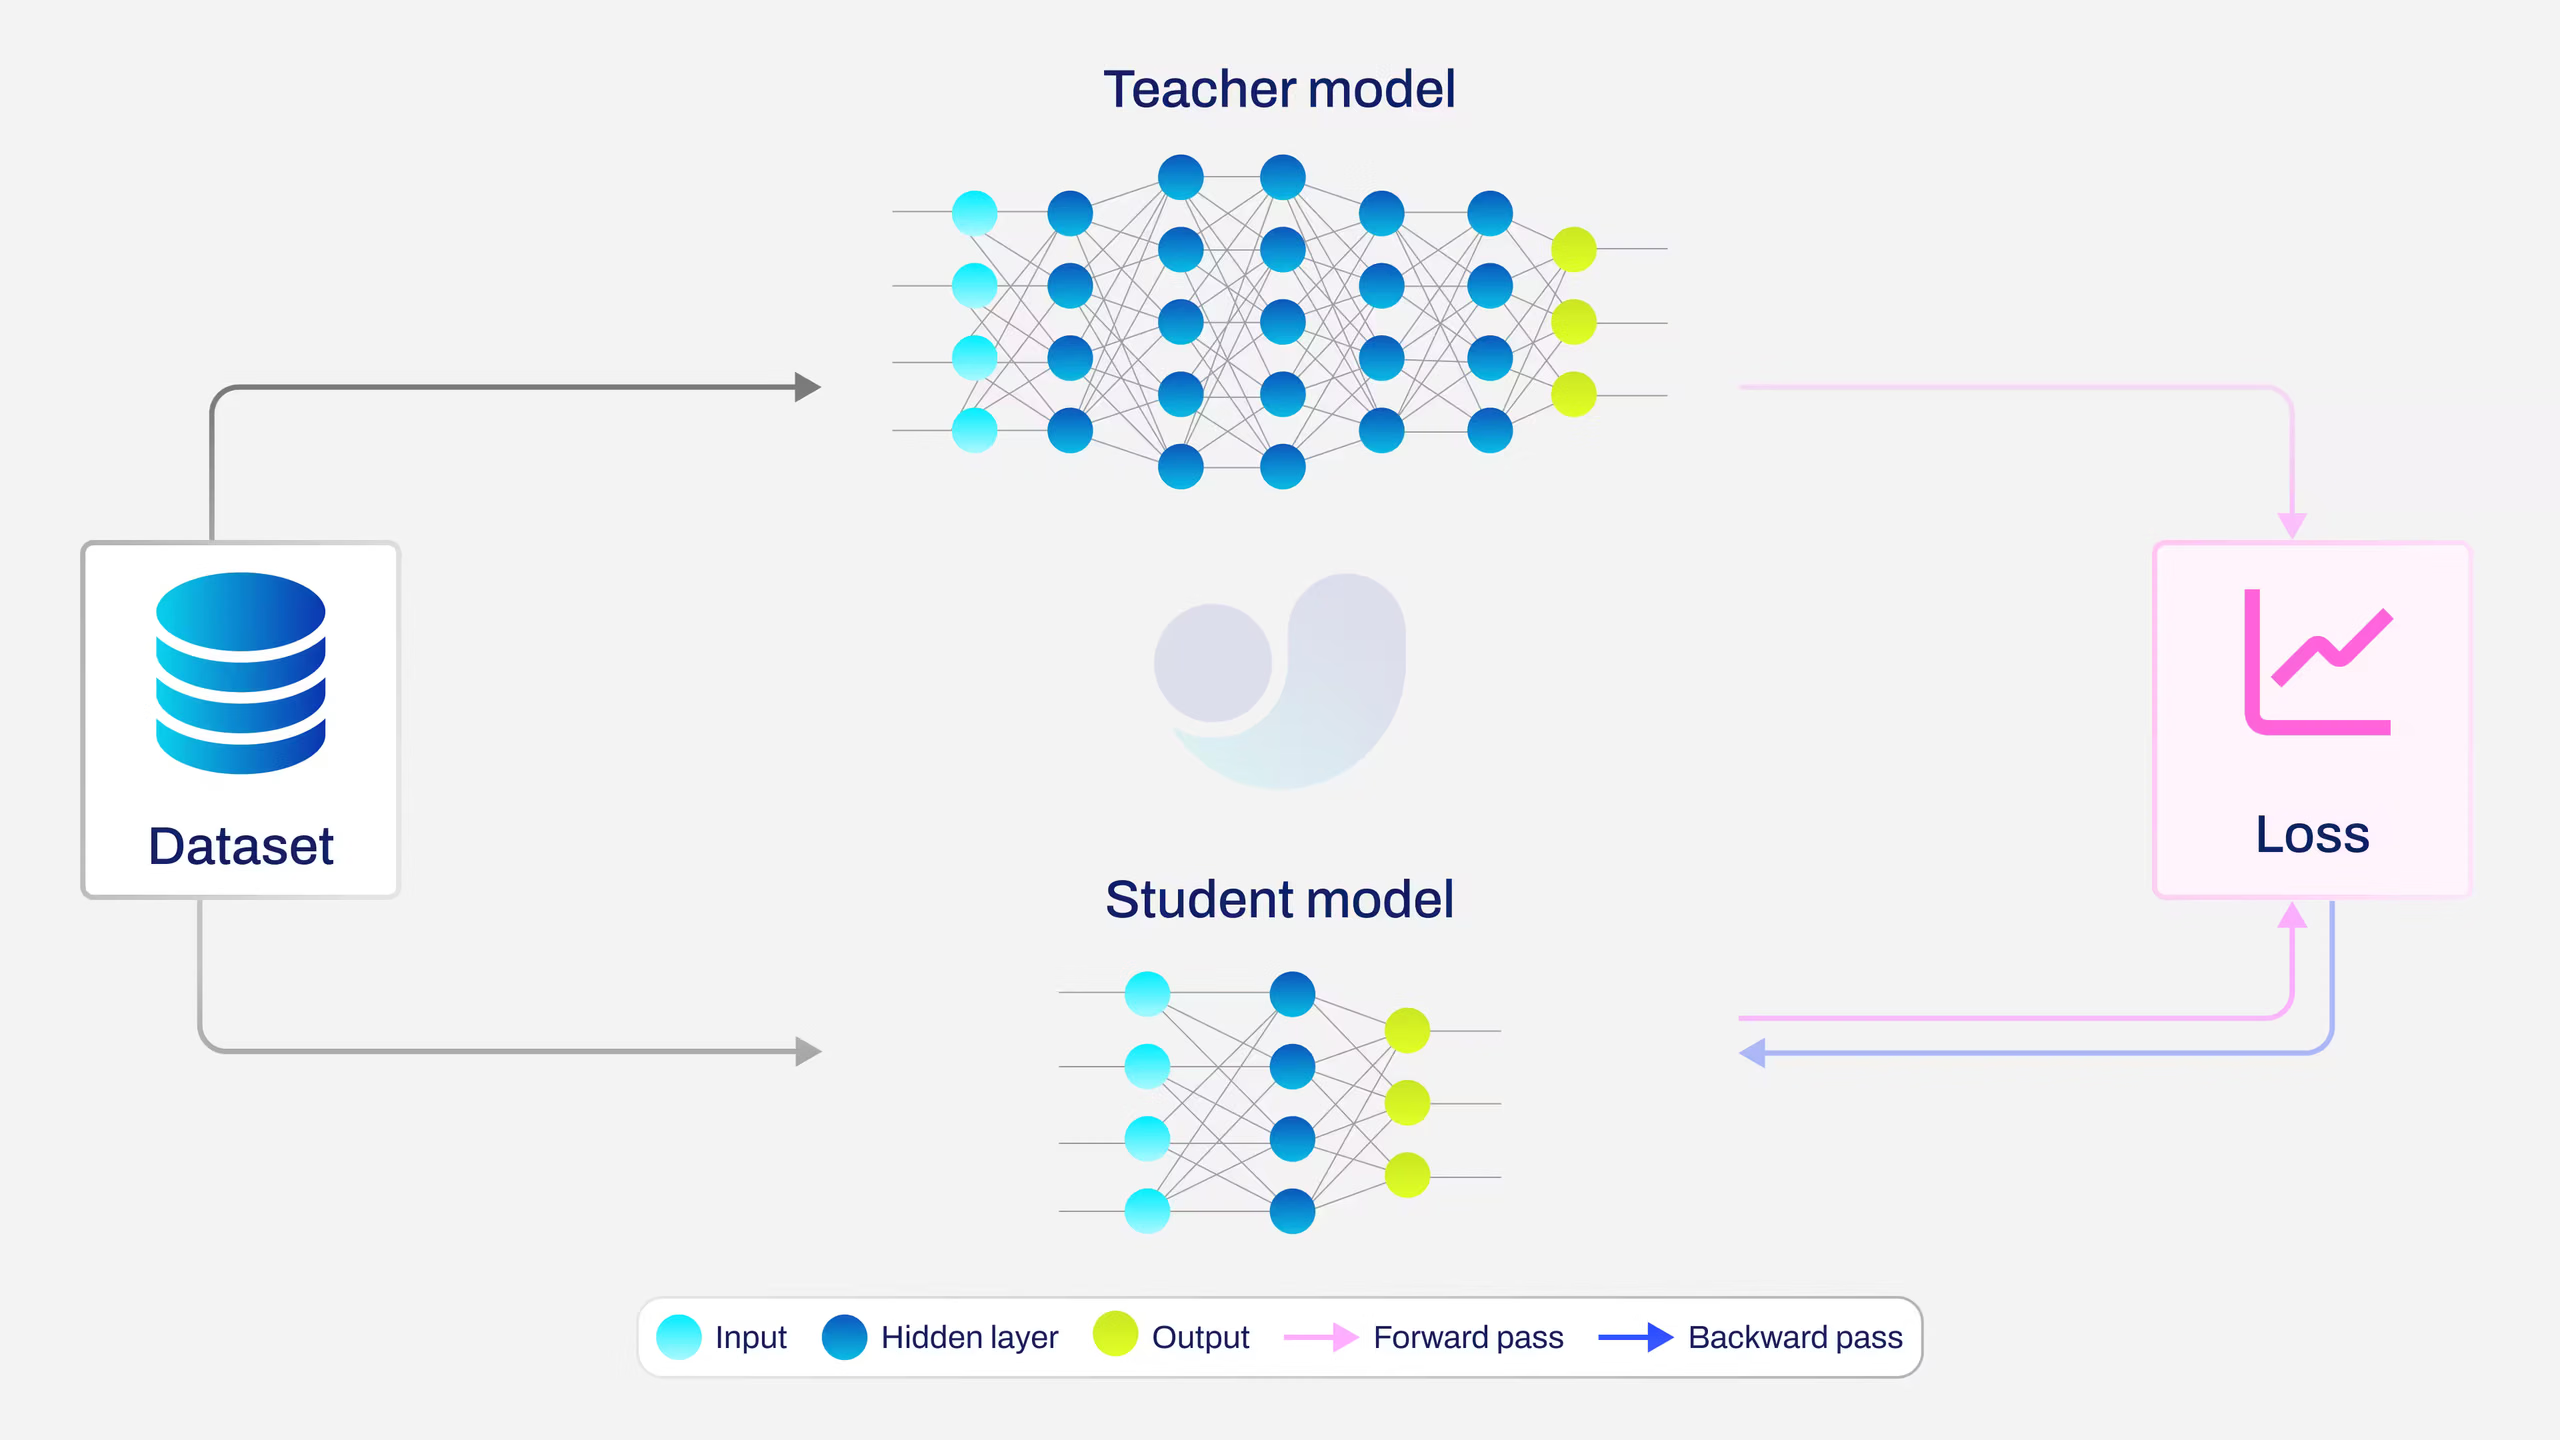
Damıtımı şu durumlarda kullan:
- Dağıtım için daha küçük ve hızlı bir modele ihtiyacın varsa
- Aynı veriler üzerinde eğitilmiş, yüksek doğruluklu bir öğretmen modelin varsa
- Standart eğitimin sağladığından daha yüksek doğruluk istiyorsan
Bilgi damıtımı detect, segment, pose ve obb görevleri için uygulanmıştır. Şimdilik doğruluk iyileştirmeleri deneysel olarak yalnızca detect görevi için doğrulanmıştır.
Performans#
Bilgi damıtımı, COCO üzerinde tüm YOLO26 ailesinde öğrenci modellerin mAP değerini artırır ve çıkarım maliyetini artırmaz. Aşağıdaki tabloda standart YOLO26 modelleri (temel değer), önerilen öğretmenleriyle damıtım kullanılarak eğitilen aynı modellerle karşılaştırılır.
| Model | boyut (piksel) | mAPdoğr50-95 temel | mAPdoğr50-95 damıtılmış | mAPdoğr50-95 (e2e) temel | mAPdoğr50-95 (e2e) damıtılmış |
|---|---|---|---|---|---|
| YOLO26n-distill | 640 | 40.9 | 41.5 | 40.1 | 40.9 |
| YOLO26s-distill | 640 | 48.6 | 49.2 | 47.8 | 48.6 |
| YOLO26m-distill | 640 | 53.1 | 53.9 | 52.5 | 53.3 |
| YOLO26l-distill | 640 | 55.0 | 56.0 | 54.4 | 55.5 |
| YOLO26x-distill | 640 | 57.5 | 57.9 | 56.9 | 57.4 |
- mAPval değerleri, COCO val2017 veri kümesinde tek model ve tek ölçek için verilmiştir.
Damıtılmış bir satırı yeniden üretmek içinyolo val detect model=yolo26n-distill.pt data=coco.yaml device=0kullan; e2e sütunu içinnms=Falseekle. - e2e değerleri NMS içermeyen çıkarım yolunu (
nms=False) kullanır; e2e olmayan değerler varsayılan NMS son işlemesini (nms=None) kullanır. Ayrıntılar için Uçtan Uca Nesne Tespiti bölümüne bak.
Ön koşullar#
Başlamadan önce aşağıdaki gereksinimleri karşıladığından emin ol:
- Eğitilmiş öğretmen modeli: Öğrenciyle aynı YOLO ailesinden bir
.ptkontrol noktası. - Eşleşen görev: Öğrenciyle aynı görevi yapan ve ilgili veriler üzerinde eğitilmiş bir öğretmen kullan.
- GPU kaynakları: Her iki modeli de bellekte tutmaya yetecek kaynak gerekir; öğretmen, gradyanlar veya optimize edici durumu olmadan yalnızca ileri geçiş çalıştırır.
Önerilen Model Eşleşmeleri#
| Öğrenci | Önerilen Öğretmen |
|---|---|
yolo26n.pt | yolo26s.pt |
yolo26s.pt | yolo26m.pt |
yolo26m.pt | yolo26x.pt |
yolo26l.pt | yolo26x.pt |
Farklı aileler arasında damıtım (ör. YOLO11 öğretmeni ile YOLO26 öğrencisi) desteklenmez.
Temel Parametreler#
| Parametre | Tür | Varsayılan | Açıklama |
|---|---|---|---|
distill_model | str | None | Öğretmen model dosyasının yolu (ör. yolo26x.pt). Bu ayar, bilgi damıtımını etkinleştirir. |
dis | float | 6.0 | Damıtma kaybı ağırlığı. Damıtma kaybının toplam eğitim kaybına ne ölçüde katkı sağlayacağını belirler. |
Nasıl Çalışır?#
- Öğretmen model,
evalkipinde sabit kalır ve her yığında çıkarım yapar - Öğrenci model, standart görev kayıplarına ek olarak damıtım rehberliğiyle eğitilir
- Özellikler, Detect ailesi başlığını besleyen üç boyun katmanında her iki modelden de çıkarılır
- İki 1×1 ReLU evrişiminden oluşan bir projektör, her öğrenci özellik haritasını öğretmenin kanallarına uyarlar
- Skor ağırlıklı L2 kaybı, yansıtılmış öğrenci özelliklerini öğretmen özellikleriyle karşılaştırır ve öğretmenin sınıflandırma güvenine göre ağırlıklandırılır
- Damıtma kaybı,
disağırlığı kullanılarak standart kayıplarla birleştirilir
Görev Desteği#
Damıtım uygulaması, modelin Detect ailesi başlığını besleyen üç boyun katmanından özellikler çıkarır. segment, pose ve obb başlıkları aynı Detect mimarisinden türediğinden damıtım bu görevlerle de teknik olarak uyumludur.
Sınıflandırma, anlamsal bölütleme, derinlik kestirimi ve RT-DETR uyumlu bir Detect ailesi başlığı kullanmaz ve desteklenmez.
Deneysel olarak yalnızca detect görevi kıyaslanmış ve doğrulanmıştır. segment, pose veya obb için damıtım çalıştırabilirsin ancak bu görevlerdeki doğruluk iyileştirmeleri henüz doğrulanmamıştır.
from ultralytics import YOLO

# Segment
model = YOLO("yolo26n-seg.pt")
model.train(data="coco8-seg.yaml", epochs=100, distill_model="yolo26s-seg.pt")

# Pose
model = YOLO("yolo26n-pose.pt")
model.train(data="coco8-pose.yaml", epochs=100, distill_model="yolo26s-pose.pt")

# OBB
model = YOLO("yolo26n-obb.pt")
model.train(data="dota8.yaml", epochs=100, distill_model="yolo26s-obb.pt")Eğitim#
Temel Eğitim#
Damıtımla eğitim, standart eğitimle aynıdır. Etkinleştirmek için distill_model yolunu belirt:
from ultralytics import YOLO

# Öğrenci modeli yükle
student = YOLO("yolo26m.pt")

# Daha büyük bir öğretmen modelinden bilgi damıtımı yaparak eğit
results = student.train(data="coco8.yaml", epochs=100, distill_model="yolo26x.pt")
Damıtma Kaybı Ağırlığını Ayarlama#
dis parametresi (varsayılan: 6.0), damıtma kaybının katkısını kontrol eder:
from ultralytics import YOLO

student = YOLO("yolo26n.pt")
results = student.train(data="coco8.yaml", epochs=100, distill_model="yolo26s.pt", dis=10.0)
Damıtım Eğitimine Devam Etme#
Damıtım eğitimi, kontrol noktalarından devam etmeyi destekler. Öğretmen modeli, kontrol noktasında kayıtlı distill_model yolundan otomatik olarak yeniden oluşturulur:
from ultralytics import YOLO

student = YOLO("runs/detect/train/weights/last.pt")
results = student.train(resume=True)
Eğitim Çıktısı#
Damıtım etkinleştirildiğinde eğitim günlüklerinde ek bir dis_loss sütunu görünür:
      Epoch    GPU_mem   box_loss   cls_loss    l1_loss   dis_loss  Instances       Size
      1/80      46.2G      1.566      5.404    0.003249      6.658        231        640
Dışa aktarılan model yalnızca öğrenci ağırlıklarını içerir — dosya boyutu ve çıkarım hızı normal şekilde eğitilmiş bir öğrenci modeliyle aynıdır.
Sık Sorulan Sorular#
- Öğretmen ve öğrencinin aynı YOLO neslinden olduğunu doğrula
distill_modelyolunun doğru olduğunu ve dosyanın yüklendiğini doğrula- Kayıp değeri çok küçükse
disdeğerini artırmayı dene - Öğretmen modelin aynı veri kümesi üzerinde eğitildiğinden emin ol
distill_modelparametresini ekle; geri kalan her şey aynı şekilde çalışır. Eğitim sırasında ek bir damıtma kaybı hesaplanır ancak kaydedilen model, ek yükü olmayan standart bir YOLO modelidir.Evet. Öğretmen her yığın için bir ileri geçiş ekler; bu nedenle zaman ve bellek yükü öğretmen/öğrenci eşleşmesine bağlıdır. Öğretmen, gradyanlar veya optimize edici durumu olmadan
evalkipinde çalışır.Bilgi damıtımı, Detect ailesi başlığını besleyen üç boyun katmanındaki özellikleri damıttığı için detect, segment, pose ve obb görevleriyle çalışır. Classify, semantic, depth ve RT-DETR desteklenmez.
Doğruluk iyileştirmeleri deneysel olarak yalnızca detect için doğrulanmıştır. Segment, pose ve obb teknik olarak uyumludur ancak henüz kıyaslama testlerinden geçirilmemiştir.
Öğretmen ve öğrenci aynı YOLO ailesine ait olmalıdır (ör. YOLOv8, YOLO11 veya YOLO26). Farklı aileler arasında damıtma (ör. YOLO11 öğretmeni ve YOLO26 öğrencisi) desteklenmez.


Yorumlar5
Bir soru sor, sonuçlarını paylaş veya başka birine yardım et.
CharbelMsallem
Cool! If same dataset, can the class mapping or the number of classes differ from parent to student but using the same images and split?
I mean classes of student be a subset of parent classes
 Glenn JocherUltralytics
Same images/splits can be reused, but for the supported distillation path the teacher and student should use the same task and
data.yamlclass configuration (nc,names, and class indices), per the Knowledge Distillation guide. If the student should learn only a subset, create a subset dataset/YAML with labels remapped to contiguous IDs and train or fine-tune a teacher on that same subset/mapping before using it asdistill_model.okat thanks!
andyrey
Very interesting and useful, thank you!