Model Eğitimi için Makine Öğrenimi En İyi Uygulamaları ve İpuçları
Giriş#
Bir bilgisayarlı görü projesinde çalışırken en önemli adımlardan biri model eğitimidir. Bu adıma geçmeden önce hedeflerini tanımlaman ve verilerini toplaman ve etiketlemen gerekir. Verilerin temiz ve tutarlı olduğundan emin olmak için verileri ön işleme tabi tuttuktan sonra modelini eğitmeye geçebilirsin.
Model eğitimi, modeline görsel örüntüleri tanımayı ve verilerinden tahmin yapmayı öğretme sürecidir ve uygulamanın doğruluğunu doğrudan etkiler. Bu kılavuz, bilgisayarlı görü modellerini etkili biçimde eğitmene yardımcı olmak için en iyi uygulamaları, optimizasyon tekniklerini ve sorun giderme ipuçlarını ele alır.
İzle: Model Eğitimi İpuçları | Büyük Veri Kümeleriyle Çalışma | Yığın Boyutu, GPU Kullanımı ve Karma Hassasiyet
Makine Öğrenimi Modeli Nasıl Eğitilir#
Bir bilgisayarlı görü modeli, hataları en aza indirmek için iç parametreleri ayarlanarak eğitilir. Başlangıçta modele büyük bir etiketli görüntü kümesi verilir. Model, bu görüntülerde neler bulunduğuna ilişkin tahminler yapar; hataları hesaplamak için bu tahminler gerçek etiketler veya içeriklerle karşılaştırılır. Hatalar, model tahminlerinin gerçek değerlerden ne kadar saptığını gösterir.
Eğitim sırasında model, geri yayılım adı verilen bir süreçle yinelenecek şekilde tahminler yapar, hataları hesaplar ve parametrelerini günceller. Bu süreçte model, hataları azaltmak için iç parametrelerini (ağırlıklar ve yanlılıklar) ayarlar. Bu döngüyü birçok kez tekrarlayarak doğruluğunu kademeli olarak artırır. Zamanla şekiller, renkler ve dokular gibi karmaşık örüntüleri tanımayı öğrenir.
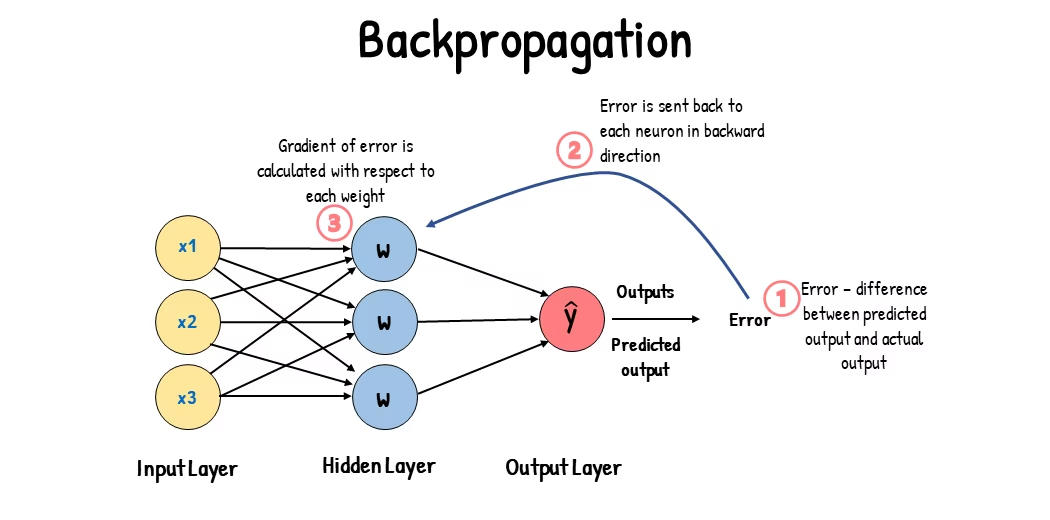
Bu öğrenme süreci, bilgisayarlı görü modelinin nesne algılama, örnek segmentasyonu, anlamsal segmentasyon ve görüntü sınıflandırma dâhil çeşitli görevleri yerine getirmesini mümkün kılar. Nihai hedef, modelin öğrendiklerini daha önce görmediği yeni görüntülere genelleyebilmesini ve böylece gerçek dünyadaki uygulamalarda görsel verileri doğru biçimde anlayabilmesini sağlamaktır.
Bir modeli eğitirken perde arkasında neler olduğunu artık bildiğimize göre, model eğitirken dikkate alınması gereken noktalara bakalım.
Büyük Veri Kümeleriyle Eğitim#
Bir modeli eğitmek için büyük bir veri kümesi kullanmayı planlarken dikkate alınması gereken birkaç farklı nokta vardır. Örneğin toplu iş boyutunu ayarlayabilir, GPU kullanımını denetleyebilir ve çok ölçekli eğitimi tercih edebilirsin. Şimdi bu seçeneklerin her birini ayrıntılı olarak ele alalım.
Toplu İş Boyutu ve GPU Kullanımı#
Büyük veri kümelerinde model eğitirken GPU'nu verimli kullanmak çok önemlidir. Toplu iş boyutu önemli bir etkendir. Bu, bir makine öğrenimi modelinin tek bir eğitim yinelemesinde işlediği veri örneği sayısıdır. GPU'nun desteklediği en yüksek toplu iş boyutunu kullanarak GPU'nun kapasitesinden tam olarak yararlanabilir ve model eğitiminin süresini kısaltabilirsin. Ancak GPU belleğinin tükenmesini önlemelisin. Bellek hatalarıyla karşılaşırsan model sorunsuz eğitilene kadar toplu iş boyutunu kademeli olarak azalt.
İzle: Batch İşleme ile Ultralytics YOLO26 Çıkarımını 2× Hızlandırma | Python ve GPU | MLOps 🚀
YOLO26 için, GPU kapasitenle eşleşmesi amacıyla Eğitim modu bağımsız değişkenleri bölümündeki batch parametresini ayarlayabilirsin. Tek bir hızlandırıcıda batch=-1, modeli profiller ve belleğin yaklaşık %60'ını kullanmayı hedefleyen bir toplu işlem boyutu seçer; batch=0.70 gibi bir kesir, farklı bir kullanım oranını hedefler. Çoklu GPU çalıştırmaları, cihaz sayısından az olmayan açıkça belirtilmiş bir genel toplu işlem boyutu gerektirir. CPU ve Apple silikonunda AutoBatch uyarı verir ve batch=16 değerine geri döner.
Alt Küme Eğitimi#
Alt küme eğitimi, modelini daha büyük veri kümesini temsil eden daha küçük bir veri kümesiyle eğitmeyi içeren pratik bir stratejidir. Özellikle model geliştirmenin ve testlerin ilk aşamalarında zamandan ve kaynaklardan tasarruf sağlayabilir. Zamanın kısıtlıysa veya farklı model yapılandırmalarını deniyorsan alt küme eğitimi iyi bir seçenektir.
YOLO26 söz konusu olduğunda, fraction parametresiyle alt küme üzerinde eğitim uygulayabilirsin. Eğitim verilerinin %10'u için fraction=0.1 gibi bir oran, tam olarak 300 eğitim görüntüsü için fraction=300 gibi bir tam sayı ya da her bölümü sınırlandırıp test görüntülerini atlamak için fraction=[300, 100, 0] gibi bir [train, val, test] listesi kullanabilirsin. [300, 100] gibi iki öğeli listeler test bölümünün tamamını bırakır. NDJSON veri kümeleri, kayıtları indirmeden önce eşit aralıklarla seçer; böylece tekrarlanan çalıştırmalarda aynı alt küme kullanılır. Klasifikasyon için görüntü klasörü veri kümelerinde de eşit aralıklarla örnekler seçilir. Diğer görüntü klasörü veri kümelerinde fraction, rastgele bir örnek seçmek yerine sıralanmış görüntü yolu sırasındaki ilk N görüntüyü seçer; bu nedenle sıralama kaynakları veya sınıfları dışarıda bırakabilecekse alt kümeleri elle düzenle. train/val bölmelerini hazırlarken birbirine çok benzeyen kopya gruplarının tamamını aynı bölümde tut.
Çok Ölçekli Eğitim#
Çok ölçekli eğitim, modelini farklı boyutlardaki görüntüler üzerinde eğiterek genelleme yeteneğini geliştiren bir tekniktir. Modelin farklı ölçek ve uzaklıklardaki nesneleri algılamayı öğrenebilir ve daha dayanıklı hâle gelebilir.
YOLO26'yı eğitirken scale parametresini ayarlayarak ölçek artırmasını etkinleştirebilirsin. Bu parametre, farklı mesafelerdeki nesneleri simüle etmek için eğitim görüntülerinin boyutunu belirli bir katsayıyla değiştirir. Örneğin, scale=0.5 ayarı eğitim sırasında görüntüleri 0,5 ile 1,5 arasında rastgele bir katsayıyla yakınlaştırır veya uzaklaştırır. Bu parametreyi yapılandırarak modelinin çeşitli görüntü ölçekleriyle karşılaşmasını ve farklı nesne boyutlarıyla senaryolardaki algılama becerisini geliştirmesini sağlayabilirsin.
Ultralytics ayrıca multi_scale parametresiyle görüntü boyutuna dayalı çok ölçekli eğitimi destekler. Görüntüleri yakınlaştırıp ardından imgsz boyutuna göre dolduran/kırpan scale parametresinden farklı olarak multi_scale, her toplu işte imgsz değerini değiştirir (model adım boyutuna yuvarlanır). Örneğin imgsz=640 ve multi_scale=0.25 ile eğitim boyutu, adım boyutlarıyla 480'den 800'e kadar örneklenir (ör. 480, 512, 544, ..., 800); multi_scale=0.0 ise sabit boyutu korur.
Önbelleğe Alma#
Önbelleğe alma, makine öğrenimi modellerinin eğitim verimliliğini artırmak için önemli bir tekniktir. Önceden işlenmiş görüntüleri bellekte saklayarak GPU'nun verilerin diskten yüklenmesini beklediği süreyi azaltır. Böylece model, disk G/Ç işlemlerinden kaynaklanan gecikmeler olmadan sürekli veri alabilir.
YOLO26 eğitilirken önbelleğe alma, cache parametresiyle denetlenebilir:
cache=True: Veri kümesi görüntülerini RAM'de saklar; en hızlı erişim hızını sunar ancak bellek kullanımını artırır.cache='disk': Görüntüleri diskte saklar; RAM'den yavaştır ancak her seferinde yeni veriler yüklemekten hızlıdır.cache=False: Önbelleğe almayı devre dışı bırakır ve tamamen disk G/Ç işlemlerine dayanır; bu en yavaş seçenektir.
Karma Hassasiyetli Eğitim#
Karma hassasiyetli eğitim, hem 16 bitlik (FP16) hem de 32 bitlik (FP32) kayan nokta türlerini kullanır: daha hızlı hesaplama için FP16, gerektiğinde hassasiyeti korumak için FP32. Daha hızlı hesaplama ve daha düşük bellek kullanımı avantajlarından yararlanmak amacıyla sinir ağının işlemlerinin çoğu FP16 ile gerçekleştirilir. Ancak ağırlık güncelleme adımlarında doğruluğu sağlamak için model ağırlıklarının ana kopyası FP32 olarak tutulur. Aynı donanım kısıtlamaları içinde daha büyük modelleri veya yığın boyutlarını kullanabilirsin.
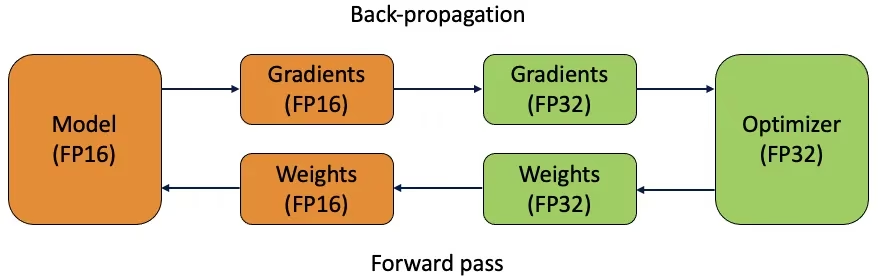
Karma hassasiyetli eğitimi uygulamak için eğitim betiklerini değiştirmen ve donanımının (GPU'lar gibi) bunu desteklediğinden emin olman gerekir. PyTorch ve TensorFlow gibi birçok modern derin öğrenme çerçevesi, karma hassasiyet için yerleşik destek sunar.
YOLO26 ile karma hassasiyetli eğitim kolaydır: AMP varsayılan olarak etkindir (amp=True). CUDA GPU'da YOLO, eğitimin başında bir kez donanım uyumluluğunu kontrol eder ve kontrol başarısız olursa tam FP32'ye döner; CPU ve Apple silicon üzerinde AMP tamamen atlanır. FP32'yi zorunlu kılmak için amp=False, desteklenen GPU'larda bfloat16 ile eğitim yapmak için amp="bf16" ayarını kullan.
Önceden Eğitilmiş Ağırlıklar#
Önceden eğitilmiş ağırlıkları kullanmak, modelinin eğitim sürecini hızlandırmanın etkili bir yoludur. Bu ağırlıklar, büyük veri kümelerinde önceden eğitilmiş modellerden gelir ve modeline avantajlı bir başlangıç sağlar. Aktarım öğrenmesi, önceden eğitilmiş modelleri yeni ve ilişkili görevlere uyarlar. Önceden eğitilmiş bir modele ince ayar yapmak için bu ağırlıklarla başlayıp ardından belirli veri kümen üzerinde eğitime devam edersin. Model temel özellikleri zaten iyi öğrendiği için bu yöntem eğitimi hızlandırır ve çoğu zaman performansı artırır.
Önceden eğitilmiş ağırlıklar model bağımsız değişkeninden gelir; bu nedenle model=yolo26n.pt zaten COCO ağırlıklarıyla başlar. pretrained parametresi bu ağırlıkların korunup korunmayacağını (True, varsayılan), atılıp atılmayacağını (False) veya başka bir kontrol noktasıyla değiştirilip değiştirilmeyeceğini (pretrained=path/to/best.pt) denetler. Bir *.yaml modelinde pretrained=True ayarını yapmak tek başına ağırlıkları indirmez. Aktarım öğrenmesinin tüm iş akışı için YOLO'yu Özel Bir Veri Kümesi Üzerinde İnce Ayarlama bölümüne bak.
Büyük Veri Kümeleriyle Çalışırken Dikkate Alınması Gereken Diğer Teknikler#
Büyük bir veri kümesiyle çalışırken dikkate alınması gereken birkaç teknik daha var:
- Öğrenme oranı zamanlayıcıları: Öğrenme oranı zamanlayıcılarını uygulamak, eğitim sırasında öğrenme oranını dinamik olarak ayarlar. İyi ayarlanmış bir öğrenme oranı, modelin minimum noktaları aşmasını önleyebilir ve kararlılığı artırabilir. YOLO26 eğitilirken
lrfparametresi, son öğrenme oranını başlangıç oranının kesri olarak belirleyerek öğrenme oranı zamanlamasını yönetmeye yardımcı olur. Katman başına öğrenme oranları veya gradyan kırpma gibi hiçbir bağımsız değişkenin sunmadığı davranışlar için eğitici alt sınıfı oluştur. - Dağıtık Eğitim: Büyük veri kümelerini işlerken dağıtık eğitim, iş yükünü birden fazla GPU veya makine arasında paylaştırarak eğitim süresini kısaltır. Bu yaklaşım, özellikle önemli hesaplama kaynaklarına sahip kurumsal ölçekli projeler için değerlidir.
- Channels-last bellek biçimi: NVIDIA CUDA ile eğitim, ölçümlerde daha yavaş olduğu görülen Windows dışında, PyTorch 1.11 ve daha yeni sürümlerde daha hızlı NHWC bellek düzenini otomatik olarak kullanır. AMD ROCm ile eğitim, ölçümlerde daha hızlı olduğu için NCHW biçiminde kalır. Bu biçimi zorlamak için
channels_last=True, NCHW biçimini korumak içinchannels_last=Falsedeğerini ayarla; PyTorch 1.10 ve daha eski sürümler, CPU ve MPS varsayılan olarak NCHW biçiminde kalır.
Eğitim İçin Epoch Sayısı#
Model eğitiminde bir epoch, eğitim veri kümesinin tamamından bir kez geçilmesini ifade eder. Bir epoch sırasında model, eğitim kümesindeki her örneği bir kez işler ve öğrenme algoritmasına göre parametrelerini günceller. Modelin zaman içinde öğrenip parametrelerini iyileştirmesi için genellikle birden fazla epoch gerekir.
Sıkça sorulan sorulardan biri, modelin kaç epoch boyunca eğitileceğinin nasıl belirleneceğidir. 300 epoch, iyi bir başlangıç noktasıdır. Model erken aşırı uyum gösterirse epoch sayısını azaltabilirsin. 300 epoch sonrasında aşırı uyum görülmezse eğitimi 600, 1200 veya daha fazla epoch'a uzatabilirsin.
Ancak ideal epoch sayısı, veri kümesinin boyutuna ve proje hedeflerine göre değişebilir. Daha büyük veri kümelerinde modelin etkili biçimde öğrenmesi için daha fazla epoch gerekebilirken, daha küçük veri kümelerinde aşırı öğrenmeyi önlemek için daha az epoch gerekebilir. YOLO26 için eğitim betiğinde epochs parametresini ayarlayabilirsin.
Erken Durdurma#
Erken durdurma, model eğitimini optimize etmek için değerli bir tekniktir. Doğrulama performansını izleyerek model gelişmeyi bıraktığında eğitimi durdurabilirsin. Böylece hesaplama kaynaklarından tasarruf edebilir ve aşırı öğrenmeyi önleyebilirsin.
Bu süreç, eğitimi durdurmadan önce doğrulama metriklerinde bir iyileşme beklemek üzere kaç epoch bekleneceğini belirleyen bir sabır parametresinin ayarlanmasını içerir. Modelin performansı bu epoch'lar boyunca iyileşmezse zaman ve kaynak israfını önlemek için eğitim durdurulur.
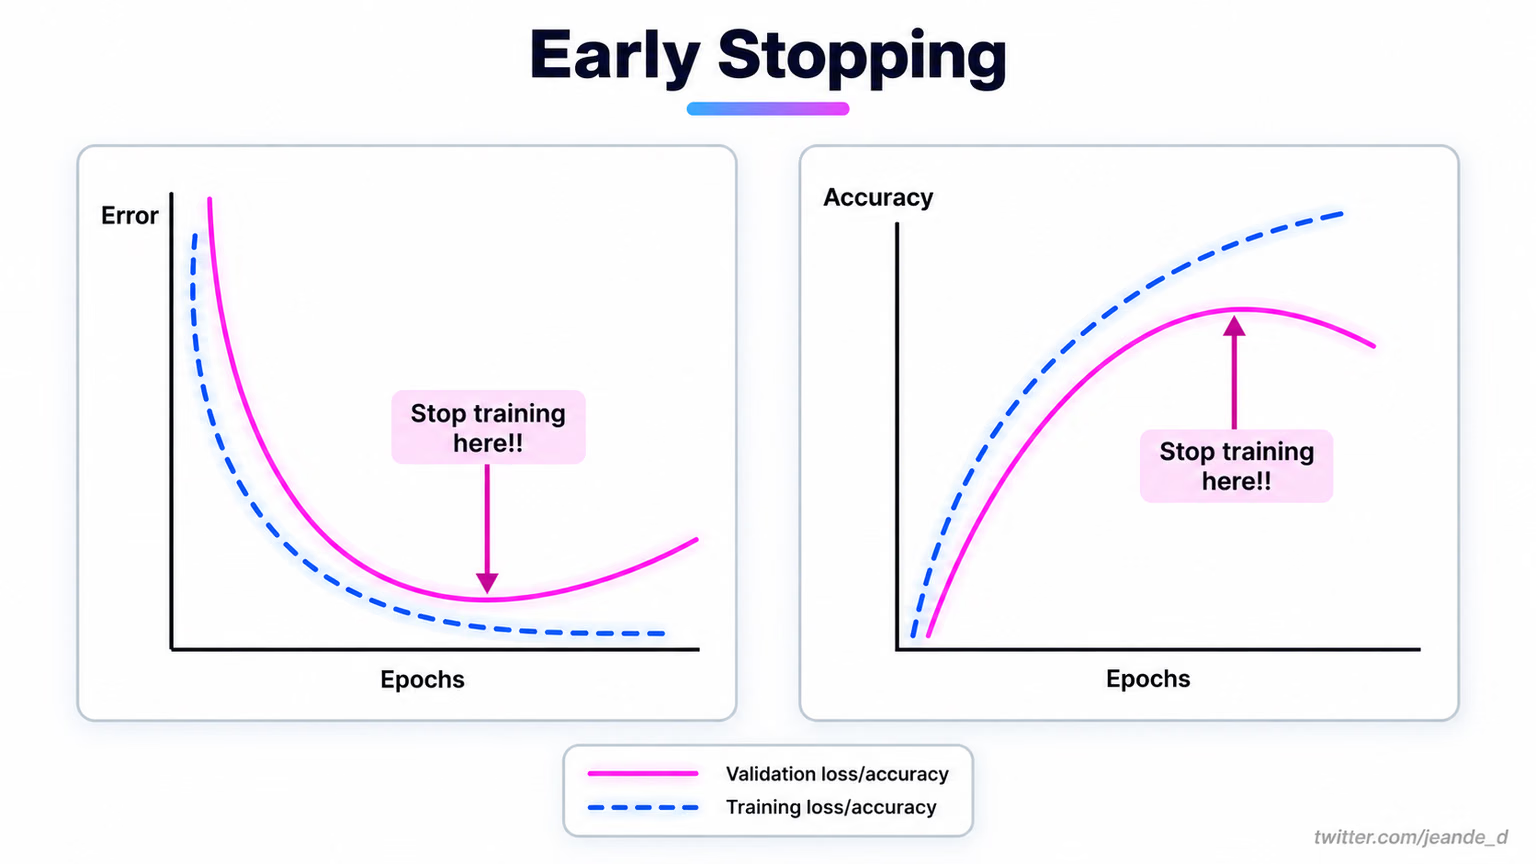
YOLO26 için eğitim yapılandırmandaki sabır parametresini ayarlayarak erken durdurmayı etkinleştirebilirsin. Örneğin, patience=5 değeri, doğrulama metriklerinde art arda 5 dönem boyunca iyileşme olmazsa eğitimin duracağı anlamına gelir. Bu, eğitimi verimli tutar ve gereksiz hesaplamaları önler.
Bulut Eğitimi ile Yerel Eğitim Arasında Seçim Yapma#
Modelini eğitmek için iki seçeneğin var: bulut eğitimi ve yerel eğitim.
Bulut eğitimi ölçeklenebilirlik ve güçlü donanım sunar; büyük veri kümeleri ve karmaşık modeller için idealdir. Google Cloud, AWS ve Azure gibi platformlar, yüksek performanslı GPU'lara ve TPU'lara isteğe bağlı erişim sağlayarak eğitim süresini kısaltır ve daha büyük modellerle deneyler yapmanı mümkün kılar. Ultralytics Platform da YOLO modelleri için yönetilen bulut eğitimi sunar. Ancak bulut eğitimi, özellikle uzun süre kullanıldığında pahalı olabilir; veri aktarımı da maliyeti ve gecikmeyi artırabilir.
Yerel eğitim daha fazla kontrol ve özelleştirme olanağı sunar; ortamını belirli ihtiyaçlara göre düzenlemene ve devam eden bulut maliyetlerinden kaçınmana imkân verir. Uzun vadeli projelerde daha ekonomik olabilir ve verilerin şirket içinde kaldığından daha güvenlidir. Ancak yerel donanım kaynak sınırlamalarına sahip olabilir ve bakım gerektirebilir; bu da büyük modeller için eğitim sürelerinin uzamasına yol açabilir.
Optimizasyon Algoritması Seçimi#
Optimizasyon algoritması, modelin performansını ölçen kayıp fonksiyonunu en aza indirmek için sinir ağının ağırlıklarını ayarlayan bir algoritmadır. Daha basit bir ifadeyle optimizasyon algoritması, hataları azaltmak için parametrelerini düzenleyerek modelin öğrenmesine yardımcı olur. Doğru optimizasyon algoritmasını seçmek, modelin ne kadar hızlı ve doğru öğrendiğini doğrudan etkiler.
Model performansını iyileştirmek için optimizasyon algoritması parametrelerini de hassas ayarlayabilirsin. Öğrenme oranını ayarlamak, parametreleri güncellerken atılan adımların büyüklüğünü belirler. Kararlılık için orta düzeyde bir öğrenme oranıyla başlayıp uzun vadeli öğrenmeyi iyileştirmek amacıyla bu oranı zaman içinde kademeli olarak düşürebilirsin. Ayrıca momentum değerini belirlemek, geçmiş güncellemelerin mevcut güncellemeler üzerindeki etkisini ayarlar. Momentum için yaygın bir değer yaklaşık 0.9'dur. Bu değer genellikle iyi bir denge sağlar.
Yaygın Optimizasyon Algoritmaları#
Farklı optimize edicilerin çeşitli güçlü ve zayıf yönleri vardır. Yaygın optimize edicilerden bazıları şunlardır.
-
SGD (Stokastik Gradyan İnişi):
- Model parametrelerini, kayıp fonksiyonunun parametrelere göre gradyanını kullanarak günceller.
- Basit ve verimlidir; ancak yakınsaması yavaş olabilir ve yerel minimumlarda takılabilir.
-
Adam (Uyarlamalı Moment Tahmini):
- Momentum kullanan SGD ile RMSProp'un avantajlarını bir araya getirir.
- Gradyanların birinci ve ikinci moment tahminlerine göre her parametrenin öğrenme oranını ayarlar.
- Gürültülü veriler ve seyrek gradyanlar için oldukça uygundur.
- Verimlidir ve genellikle daha az ayarlama gerektirir. Daha kısa eğitim çalıştırmalarında YOLO26'nın
optimizer=autoayarı, Adam yerine onunla yakından ilişkili AdamW'yi seçer.
-
RMSProp (Karekök Ortalama Yayılımı):
- Gradyanı, yakın zamandaki gradyan büyüklüklerinin hareketli ortalamasına bölerek her parametrenin öğrenme oranını ayarlar.
- Kaybolan gradyan sorununu ele almaya yardımcı olur ve tekrarlayan sinir ağlarında etkilidir.
-
MuSGD (Muon + SGD hibriti):
- Büyük ölçekli eğitimde kararlılığı artırmak için SGD tarzı güncellemeleri Muon'dan esinlenen davranışlarla birleştirir.
- SGD benzeri genelleme istiyor ancak standart SGD'den daha pürüzsüz bir yakınsamaya ihtiyaç duyuyorsan iyi bir seçenektir.
- YOLO26 eğitim tarifleri için özellikle uygundur; emin değilsen
optimizer=autoile başlayıp veri kümen üzerinde MuSGD ile karşılaştır.
YOLO26'da optimizer parametresi; SGD, MuSGD, Adam, Adamax, AdamW, NAdam, RAdam ve RMSProp gibi çeşitli optimize ediciler arasından seçim yapmanı sağlar. Alternatif olarak, eğitim yineleme sayısına göre otomatik seçim yapmak için parametreyi auto olarak ayarlayabilirsin (kısa çalıştırmalarda AdamW, 10.000 yinelemenin üzerinde MuSGD).
yolo train model=yolo26n.pt data=coco8.yaml optimizer=MuSGDToplulukla Bağlantı Kurma#
Bilgisayarlı görü meraklılarından oluşan bir topluluğun parçası olmak, sorunları çözmene ve daha hızlı öğrenmene yardımcı olabilir. Bağlantı kurmanın, yardım almanın ve fikir paylaşmanın bazı yolları şunlardır.
Topluluk Kaynakları#
- GitHub Issues: YOLO26 GitHub deposunu ziyaret et ve soru sormak, hata bildirmek ve yeni özellikler önermek için Issues sekmesini kullan. Topluluk ve bakım ekibi oldukça aktif ve yardıma hazır.
- Ultralytics Discord Sunucusu: Diğer kullanıcılar ve geliştiricilerle sohbet etmek, destek almak ve deneyimlerini paylaşmak için Ultralytics Discord sunucusuna katıl.
Bu kaynaklar, sorunları çözmene ve bilgisayarlı görü topluluğundaki en yeni trendlerden ve uygulamalardan haberdar olmana yardımcı olur.
Öne Çıkan Noktalar#
Bilgisayarlı görü modellerini eğitmek; iyi uygulamaları izlemeyi, stratejilerini optimize etmeyi ve ortaya çıkan sorunları çözmeyi gerektirir. Yığın boyutlarını ayarlamak, karma hassasiyetli eğitim yapmak ve önceden eğitilmiş ağırlıklarla başlamak gibi teknikler modellerinin daha iyi çalışmasını ve daha hızlı eğitilmesini sağlayabilir. Alt küme eğitimi ve erken durdurma gibi yöntemler zamandan ve kaynaklardan tasarruf etmene yardımcı olur. Toplulukla bağlantıda kalmak ve yeni trendleri takip etmek, model eğitimi becerilerini geliştirmeyi sürdürmeni sağlar.
Sık Sorulan Sorular#
GPU kullanımını artırmak için
batchparametresini GPU'nun desteklediği en büyük değere ayarla. Tek bir hızlandırıcıdabatch=-1, modeli profiller ve belleğin yaklaşık %60'ını kullanmayı hedefler. CPU ve Apple silikonundabatch=16değerine geri döner; çoklu GPU çalıştırmaları ise cihaz sayısından az olmayan açıkça belirtilmiş bir genel toplu işlem boyutu gerektirir. Daha fazla bilgi için Eğitim modu bağımsız değişkenleri bölümüne bak.Karma hassasiyetli eğitim, hesaplama hızı ile hassasiyeti dengelemek için hem 16 bitlik (FP16) hem de 32 bitlik (FP32) kayan nokta türlerini kullanır. YOLO26'da bu özellik
amp=Truearacılığıyla varsayılan olarak etkindir; FP32'yi zorlamak içinamp=Falsedeğerini ayarla. AMP, CPU ve Apple silicon üzerinde devre dışı bırakılır.Çok ölçekli eğitim, farklı boyutlardaki görüntülerle eğitim yaparak modelin farklı ölçeklere ve uzaklıklara daha iyi genelleme yapmasını sağlar ve böylece model performansını artırır. YOLO26 bunun için birbirinden ayrı iki parametre sunar.
scale=0.5, 0.5 ile 1.5 arasında bir yakınlaştırma faktörü örnekler ve ardından sabit birimgszboyutuna geri doldurur veya kırpar;multi_scale=0.25ise her yığındaimgszdeğerinin kendisini adım değerleriyle değiştirir. Ayarlar ve daha fazla ayrıntı için Train modu belgelerine göz at.Önceden eğitilmiş ağırlıkları kullanmak, temel görsel özelliklere zaten aşina olan bir modelden yararlanarak eğitimi büyük ölçüde hızlandırabilir ve model doğruluğunu artırabilir. Ağırlıkları
modelbağımsız değişkeniyle, örneğinmodel=yolo26n.ptbiçiminde yükle; ardındanpretrained, bu ağırlıkların korunmasına mı (True, varsayılan), atılmasına mı (False) yoksa başka bir kontrol noktasındaki ağırlıklarla değiştirilmesine mi (pretrained=path/to/best.pt, ağırlıkları birmodel=*.yamlyapısına aktarma yöntemi) karar verir. Daha fazla bilgi için Train modu belgelerine bak.Epoch sayısı, model eğitimi sırasında eğitim veri kümesinin baştan sona kaç kez işlendiğini belirtir. Genellikle 300 epoch ile başlanabilir. Modelin erken aşamada aşırı öğrenmesi durumunda sayıyı azaltabilirsin. Alternatif olarak, aşırı öğrenme gözlemlenmiyorsa eğitimi 600, 1200 veya daha fazla epoch'a uzatabilirsin. Bunu YOLO26'da ayarlamak için eğitim betiğinde
epochsparametresini kullan. İdeal epoch sayısını belirlemeye yönelik ek öneriler için epoch sayısı bölümüne bak.


Yorumlar12
Bir soru sor, sonuçlarını paylaş veya başka birine yardım et.
puzzlemindgames
Hello
I'm working on a browser-based puzzle solver that uses a custom YOLO model to detect visible objects from game screenshots.
Some examples include: Transparent ice/frost overlays on the lower part of objects Semi-transparent cloth or curtain overlays Small decorative objects inside larger objects (for example, keys inside containers) The visible objects are usually detected correctly, but these overlays often cause false negatives or incorrect class predictions.
At the moment I'm considering a few approaches: Training with many more occlusion-heavy examples Splitting the detection into multiple stages instead of one larger model
python results = model.predict( source="level_512.png", conf=0.25, iou=0.45, imgsz=1280 ) for box in results[0].boxes: print(box.cls, box.conf)
For anyone who has trained YOLO models on UI or game screenshots which approach gave you the biggest improvement? Or is there another strategy that tends to work better for partially occluded objects?
I'd really appreciate hearing about real-world experiences before I spend time retraining the dataset.
 Glenn JocherUltralytics
Start with targeted data: add representative occluded examples, keep annotations consistent for partially visible objects, and synthetically composite the actual frost/cloth overlays at realistic opacity and placement. Measure recall per class on a dedicated occlusion-heavy validation split, then tune
mosaic,mixup, orcutmixconservatively; higherimgszor tiled inference can help nested small objects. A multi-stage pipeline is usually worthwhile only if the first stage can reliably isolate containers or overlay regions. Please continue sharing results and questions here so the Ultralytics team and community can see them.1Thanks! I followed your suggestions and added more occluded samples. The main objects/tubes are much more stable as well as the colors now but I'm still struggling with very small objects.
i cant able to attach model training screenshots here for you to review.
For example, tiny keys or tags inside transparent containers are often missed or detected as the wrong class. For context the screenshots come from a puzzle game with objects similar to these shown in sample pictures embedded at product homepage: https://aimagicsortsolver.com/
results = model.predict( source="level.png", imgsz=1280, conf=0.35, iou=0.45 ) Would you recommend keep improving a single model or train a second YOLO model just for these small objects?
- Glenn JocherUltralytics(düzenlendi)
Keep the single model first: audit tiny-object annotations, add more balanced close-up examples, and test cropped or SAHI tiled inference so keys and tags occupy more pixels; also compare
conf=0.15–0.25, since higher thresholds may suppress weak detections. Train a second specialized model only if the first model reliably detects each container, allowing its crop to be passed to the small-object model at higher effective resolution.1 Thank you for your suggestions. I'll tweak it as per the recommendations.
TSHSLU
What is the minimum Dataset Size required if i use a pretrained model for custom projects. i barely find any sources online which recommend a minimum dataset size.
- Glenn JocherUltralytics
There isn’t a fixed “minimum” dataset size when fine-tuning a pretrained model; if your domain is close to the pretrained data and labels are clean, you can often start getting useful signal with ~50–200 images per class (or a few hundred labeled object instances), but for reliably robust results across different lighting/viewpoints/backgrounds you’ll usually want 500–2000+ images per class with good diversity—one practical way to find your true minimum is to train on a small pilot subset, check validation failures, then add data specifically where the model breaks (the
fractionworkflow in the Model training tips guide helps iterate quickly).from ultralytics import YOLO model = YOLO("yolo26n.pt") model.train(data="data.yaml", epochs=100, fraction=0.1)1
VeeranjaneyuluToka
Hi, I just noticed a thing, looks like the optimizer is getting chosen based on no.of iterations, would you mind telling me the reason for the same? I mean how does iterations matter when we choose optimizer?
Imran-ml
First of all its great to have another powerful model and congratulations. I have fine tuned and trained yolo11x.pt for my custom objects but I'm facing some issues. My images data resolution is around 6000 x 2000 but while trained the model I set the imgsz=(1280, 640). It work well when I adjust the video stream by zoom in-out and detect all my 60 objects well (objects are small) but when there is some zoom or squeezed then it completely dont detect any object or few only.
Please let me know if I'm missing something or I have to do something else? I have labelled the data on my original images so resizing making any issues? any ratio issues? Please guide me properly so I can use this power yolo11 model effectively.
- Glenn JocherUltralytics
@Imran-ml it sounds like the issue might be related to image resizing affecting object detection. Consider enabling multiscale training by adjusting the
scaleparameter to help the model generalize better across different image sizes. This can improve detection performance when objects appear at varying scales. For more detailed guidance, you can refer to our model training tips at https://docs.ultralytics.com/guides/model-training-tips/.
Taufiq-Ahmed
Hi I have a question. I am using Yolov8s for trained a dataset that has four class. fire, smoke, person, animal. all the images has areal view to detect forest fire . In my dataset I have forest fire images from drone so after training it detect fire smoke quite accurately. however, I do not have any dataset that has person or animal in forest fire. so I have to collect some other dataset from roboflow that has person and animal and the n I have merged them with my own dataset ( have changed the label of animal and person accordingly so 0 means smoke, 1 means fire, 2 means person and 3 means animal and also updated the data.yaml file) . this time the problem is it could not detect the animal and person properly some times it can detect them. The main reasons seems to me is that the drone is flying in a high altitude so it does not detect person and animal properly because in the dataset of person and animal the view of the drone is not that much high. is there any technique to solve this problem and detect all the objects as many as possible?
- Glenn JocherUltralytics
@Taufiq-Ahmed it sounds like the altitude difference between your training and test datasets is causing the detection issues. To address this, consider using data augmentation techniques to simulate higher altitude views in your training data. You can also try multiscale training to help the model generalize better across different scales. Additionally, fine-tuning the model with a mix of high-altitude and low-altitude images might improve its performance. For more detailed strategies, you can refer to our model training tips.