YOLO26 Modelleri için TensorRT Dışa Aktarımı
TensorRT, yüksek hızlı derin öğrenme çıkarımı için NVIDIA'nın SDK'sıdır. Bir Ultralytics YOLO26 modelini format="engine" ile dışa aktarmak, oluşturulduğu NVIDIA GPU için FP32, FP16 veya INT8 hassasiyetinde optimize edilmiş bir .engine dosyası oluşturur.
TensorRT, motoru oluşturulduğu GPU için ayarlar. Motoru dağıtım GPU'sunda veya aynı modelden bir GPU'da, aynı TensorRT sürümüyle oluştur; .engine dosyası taşınabilir bir model biçimi değildir. Uç dağıtım için Ultralytics Platform, her biri için fiziksel oluşturma ve doğrulama durumu belgelenmiş sekiz Jetson hedefi seçeneği sunar; istersen hedef cihazda yerel olarak da dışa aktarabilirsin.
Genel Bakış#
| Özellik | Ayrıntılar |
|---|---|
format bağımsız değişkeni | engine (diğer adları: tensorrt, trt) |
| Çıktı | yolo26n.engine, JSON meta veri başlığı (sınıf adları, görev, görüntü boyutu) ile başlayan tek bir dosyadır. Ara yolo26n.onnx dosyası yanında kalır. |
| Çalıştığı ortamlar | Veri merkezi, iş istasyonu ve Jetson dahil NVIDIA GPU'lar; Jetson DLA çekirdekleri de dahildir (TensorRT 11'de değil). |
| Çalışma zamanı | TensorRT 7.0 veya üzeri (10.2.0 desteklenmiyor) |
| Kesinlik | FP32, FP16, INT8 |
| Dışa aktarma ana makinesi | NVIDIA GPU'su ve CUDA bulunan bir makine. Dağıtım GPU'sunda veya aynı modelden bir GPU'da oluştur. |
Ultralytics Platform, NVIDIA Jetson hedefleri dahil seçtiğin GPU türünde senin için TensorRT motoru oluşturabilir; böylece yerel bir dışa aktarma ortamına ihtiyacın olmaz.
Hızlı Başlangıç#
Ultralytics paketini NVIDIA GPU'su ve CUDA bulunan bir makineye yükle. Linux'ta ilk dışa aktarma, eksikse CUDA sürümünle eşleşen TensorRT Python paketini yükler. NVIDIA Jetson'da JetPack ile gelen TensorRT sürümünü kullan. Windows'ta dışa aktarmadan önce TensorRT'yi kendin yükle.
pip install ultralyticsDiğer yükleme yöntemleri için yükleme kılavuzuna bak. Ardından modelini dışa aktar ve çıkarım yapmak veya doğruluğunu doğrulamak için dışa aktarılan motoru yükle. Çıkarım ve doğrulama için NVIDIA GPU gerekir. YOLO26n motorunu oluşturmak, NVIDIA T4'te bir ila üç dakika sürer.
from ultralytics import YOLO

# YOLO26 modelini yükle
model = YOLO("yolo26n.pt")

# Modeli TensorRT biçimine aktar
model.export(format="engine")  # 'yolo26n.engine' oluşturur

# Ya da bunun yerine FP16 motoru dışa aktar
model.export(format="engine", quantize=16) # 'yolo26n.engine' oluştururfrom ultralytics import YOLO
# Dışa aktarılan TensorRT modelini yükle
model = YOLO("yolo26n.engine")
# Çıkarımı çalıştır
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Dışa aktarılan TensorRT modelini yükle
model = YOLO("yolo26n.engine")
# COCO8 veri kümesinde doğruluğu doğrula
metrics = model.val(data="coco8.yaml")Desteklenen Görevler#
TensorRT dışa aktarımı, YOLOv8, YOLO11 ve YOLO26 modelleriyle Ultralytics'ın yedi görevinin tümünü destekler: tespit, segmentasyon, anlamsal segmentasyon, derinlik tahmini, sınıflandırma, poz tahmini ve OBB. Anlamsal segmentasyon ve derinlik tahmini yalnızca bu başlıklarla gelen tek aile olan YOLO26'da kullanılabilir.
Dışa Aktarma Bağımsız Değişkenleri#
| Bağımsız değişken | Tür | Varsayılan | Açıklama |
|---|---|---|---|
format | str | 'engine' | Dışa aktarılan modelin hedef biçimi; çeşitli dağıtım ortamlarıyla uyumluluğu tanımlar. |
imgsz | int veya tuple | 640 | Model girişi için istenen görüntü boyutu. Kare görüntüler için bir tam sayı, belirli boyutlar içinse (height, width) demeti kullanılabilir. |
quantize | int veya str | None | Niceleme hassasiyeti: 16 (FP16) veya 8 (INT8/PTQ; kalibrasyon için data/fraction gerekir); 32/ayarlanmamış değer FP32'dir. quantize=8 ile eğitilmiş bir kontrol noktası, kalibrasyon olmadan, quantize ayarlanmamış olsa bile taşıdığı aralıklardan INT8 dışa aktarır; quantize=16 veya quantize=32 hata verir. Kullanımdan kaldırılan half/int8 bayraklarının yerini alır. |
dynamic | bool | False | 1'den batch değerine kadar toplu iş boyutlarını ve 32 pikselden imgsz değerinin iki katına kadar görüntü boyutlarını kabul eden bir motor oluşturur; eski GPU'lardaki dinamik INT8 motorları için minimum değer daha yüksektir. False kullanıldığında motor yalnızca dışa aktarılan batch ve imgsz değerlerini kabul eder. |
simplify | bool | True | Model grafiğini onnxslim ile sadeleştirerek performansı ve uyumluluğu artırabilir. |
opset | int | None | Ara ONNX grafiği için ONNX opset sürümünü belirtir. Ayarlanmazsa, kurulu onnx sürümüyle sınırlandırılmış 18 opset sürümü kullanılır (PyTorch < 2.4 sürümlerinde daha düşük). |
workspace | float veya None | None | TensorRT'nin motoru oluştururken kullanacağı bellek için GiB cinsinden üst sınır. TensorRT'nin belleği otomatik ayırması için None olarak bırak. |
nms | bool, isteğe bağlı | None | Ham çıktıyı (None, varsayılan), gömülü NMS'yi (True) veya NMS içermeyen başlığı (False) seç. nms=True ile conf (varsayılan 0.25), iou, max_det ve agnostic_nms dışa aktarma sırasında sabitlenir; nms=True anlamsal segmentasyon ve derinlik modellerinde yok sayılır, sınıflandırma modellerinde ise hata verir. |
batch | int | 1 | Motorun toplu iş boyutu veya dynamic=True ile maksimum toplu iş boyutu. INT8 kalibrasyonu için kullanılan toplu iş boyutu da budur. |
data | str | None | INT8 kalibrasyonu için kullanılan veri kümesi YAML dosyasının yolu; sınıflandırmada bunun yerine bir veri kümesi dizini veya yerleşik veri kümesi adı kullanılır. split ayarlanmadığı sürece kalibrasyonda val bölümü kullanılır. quantize=8 ile belirtilmezse Ultralytics, tespit için coco8.yaml gibi model görevinin varsayılan küçük veri kümesini kullanır; quantize=8 ile eğitilmiş bir kontrol noktası için bu gerekmez. |
fraction | float, int veya list | 1.0 | Oran, görüntü sayısı veya [train, val, test] oranları/sayıları olarak kalibrasyon alt kümesi. İki öğeli listelerde test tam kalır; 0 ise onu atlar. |
device | str | None | Dışa aktarma cihazını belirtir: GPU (device=0, ayarlanmadığında kullanılır), NVIDIA Jetson için DLA (device=dla:0 veya device=dla:1, quantize=16 veya quantize=8 ile). |
NVIDIA Jetson'da Ultralytics, JetPack sürümünle gelen TensorRT çalışma zamanını kullanarak dışa aktarır. JetPack 7'de dışa aktarma için TensorRT 10.15 veya üzeri ve 11'den düşük bir sürüm gerekir. TensorRT 11'de device=dla:0 ve device=dla:1 hata verir. NVIDIA, DLA desteği sunan son 10.x sürümünün TensorRT 10.7 olduğunu belirtiyor ve TensorRT 11.4.1, JetPack 7.2.2 desteği ekliyor; Ultralytics henüz bu sürümü kullanmıyor.
Tüm biçimlerde ortak olan bağımsız değişkenler için Dışa aktarma modu belgelerine bak.
INT8 Niceleme ile TensorRT'ye Dışa Aktarma#
quantize=8, eğitim sonrası niceleme (PTQ) ile INT8 motoru oluşturur: dışa aktarma sırasında kalibrasyon görüntüleri modelden geçirilerek her tensörün değer aralığı ölçülür. Niceleme farkındalıklı eğitim yoluyla quantize=8 ile ince ayar yapılmış bir kontrol noktası, INT8 aralıklarını zaten içerdiğinden dışa aktarımda kalibrasyon atlanır.
quantize ve data bağımsız değişkenleri tüm TensorRT sürümlerinde aynıdır; ancak quantize=8 ile eğitilmemiş bir kontrol noktasının dışa aktarımı, arka planda farklı şekilde çalışır:
| TensorRT 7-10 | TensorRT 11 | |
|---|---|---|
| INT8 yöntemi | IInt8Calibrator arayüzüyle örtük niceleme | Açık niceleme: NVIDIA ModelOpt, ONNX grafiğine Q/DQ düğümleri ekler. |
| Kalibrasyon algoritması | GPU'da MINMAX_CALIBRATION, DLA için ENTROPY_CALIBRATION_2 | CPU'da çalışan ModelOpt max |
| Kullanılan kalibrasyon görüntüleri | Bölümdeki her tam toplu iş | Karıştırılmış sırada yaklaşık 512 görüntü veya daha küçük bir bölümün her tam toplu işi |
quantize=8 ile dynamic=True | Testlerle kapsanmıyor; dynamic=True olmadan dışa aktar | Desteklenir |
FP16 (quantize=16) | TensorRT oluşturucu bayrağı | ModelOpt AutoCast karma hassasiyetli dönüştürme |
ModelOpt ilk kullanımda yüklenir. Ultralytics kalibrasyon önbelleğini yeniden kullanmaz; bu nedenle her dışa aktarmada yeniden kalibrasyon yapılır. Her iki yöntemle ilgili ayrıntılar için TensorRT belgelerindeki Niceleme Türleriyle Çalışma bölümüne bak.
quantize=8 ile eğitilmemiş bir kontrol noktası için data ile kalibrasyon görüntüleri sağla; örneğin data="my_dataset.yaml". split ayarlanmadığı sürece kalibrasyonda bu veri kümesinin val bölümü kullanılır; fraction ise görüntü sayısını sınırlar. NVIDIA, dağıtım verilerini temsil eden en az 500 görüntü önerir ve dışa aktarma 300'den az görüntüde bir uyarı kaydeder. data olmadan dışa aktarma bir uyarı kaydeder ve tespit için coco8.yaml gibi model görevinin küçük örnek veri kümesini kullanır. Bu veri kümesinin doğrulama bölümündeki 4 görüntü, dışa aktarmayı test etmek için yeterlidir; ancak modeli dağıtım için kalibre etmeye yetmez.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# COCO doğrulama görüntülerinin %10'u (500 görüntü) üzerinde kalibrasyon yap; coco.yaml dosyasını kendi veri kümenle değiştir
model.export(format="engine", quantize=8, data="coco.yaml", fraction=0.1)

# Dışa aktarılan INT8 motorunu yükle ve çıkarımı çalıştır
model = YOLO("yolo26n.engine")
result = model.predict("https://ultralytics.com/images/bus.jpg")
Kıyaslama GPU'sunda INT8 motorları, FP32 motorlarından 1,04 ila 2,3 kat daha hızlı çalıştı; ancak on modelden yalnızca üçünde FP16 motorlarından daha hızlıydı. INT8, YOLO26n'den YOLO26l'ye kadar 1,7 ila 2,9 mAP kaybettirdi; YOLO26x ve YOLO26n-pose'da kayıp çok daha fazlaydı. YOLO26n INT8 motoru, FP32 motorundan daha büyüktü (11 MB'ye karşı 30 MB); büyük modeller ise küçüldü (YOLO26l için 103 MB'ye karşı 53 MB). INT8 güven değerlerini de kaydırabilir; bu nedenle güven eşiğini INT8 motorunun kendi F1 eğrisinden seç. Her model için kıyaslamalara bak.
Çıktı Biçimi#
Motor images adlı bir girdi alır ve tek bir istisna dışında, oluşturulduğu ONNX dışa aktarımıyla aynı çıktıları döndürür: TensorRT 10'dan eski sürümlerde anlamsal modeller, uint8 sınıf haritası yerine (batch, classes, height, width) şeklinde kayan noktalı sınıf puanları döndürür. Her görev ve nms ayarı için çıktı şekillerine ONNX çıktı biçimi bölümünden bak.
Motoru Ultralytics Dışında Yükleme#
Ultralytics .engine dosyası düz bir TensorRT motoru değildir. Dosya, 4 baytlık little-endian uzunluk değeriyle, ardından bu uzunluk kadar JSON meta verisiyle ve son olarak serileştirilmiş motorla başlar. TensorRT deserialize_cuda_engine, dosyanın tamamı verildiğinde None döndürür. TensorRT API'siyle motoru yüklemek için başlığı atla:
import json

import tensorrt as trt

with open("yolo26n.engine", "rb") as f:
    n = int.from_bytes(f.read(4), byteorder="little")  # meta veri başlığının uzunluğu
    metadata = json.loads(f.read(n))  # sınıf adları, görev, imgsz, batch, dışa aktarma bağımsız değişkenleri
    engine = trt.Runtime(trt.Logger(trt.Logger.WARNING)).deserialize_cuda_engine(f.read())
Başka bir araç düz bir TensorRT motor dosyası bekliyorsa başlıktan sonraki baytları yeni bir dosyaya yaz veya motorun yanında dışa aktarma işleminin bıraktığı yolo26n.onnx dosyasından o araçta motoru oluştur. TensorRT 11'de FP16 ve kalibrasyonlu INT8 dışa aktarımları yolo26n.fp16.onnx ve yolo26n.int8.onnx dosyalarını da bırakır; başka bir araçta INT8 motoru .int8.onnx dosyasından oluştur. quantize=8 ile eğitilmiş bir kontrol noktasında yolo26n.onnx zaten Q/DQ düğümlerini içerir ve .int8.onnx dosyası yazılmaz; TensorRT 11'de bu dışa aktarma, aynı Q/DQ grafiğini diğer katmanları FP16 olarak içeren yolo26n.fp16.onnx dosyasını bırakır.
Dağıt#
YOLO("yolo26n.engine"), motoru TensorRT Python çalışma zamanıyla yükler. device="cpu" değerini versen bile motor varsayılan olarak GPU 0'da çalışır. Aynı modelden başka bir GPU'da çalıştırmak için device=1 değerini ver. device=dla:0 veya device=dla:1 ile dışa aktarılan motor, o DLA çekirdeğinde çalışır.
dynamic=True olmadan dışa aktarılan bir motorun giriş şekli sabittir. Predict ve val, dışa aktarımdaki imgsz değerini kullanır ve farklı bir imgsz bağımsız değişkenini yok sayar. Ultralytics, büyük toplu işleri dışa aktarma boyutundaki toplu işlere böler, küçük olanları ise doldurur; dolayısıyla herhangi bir sayıda görüntü çalışır. dynamic=True ile dışa aktarılan motor, kendi aralığındaki tüm toplu iş ve görüntü boyutlarını kabul eder, aralık dışındaki şekillerde ise ValueError: input size ... is outside the TensorRT optimization profile hatası verir. nms=True ile aralığın üzerindeki bir toplu iş, bunun yerine dışa aktarma boyutundaki toplu işlere bölünür.
Dağıtım Kılavuzları#
-
NVIDIA Triton Inference Server: Sunucu GPU'sunda motor oluşturan Triton TensorRT hızlandırıcısıyla bir ONNX dışa aktarımını sun.
-
NVIDIA Jetson hızlı başlangıç: Jetson cihazlarında Ultralytics'ı kur ve DLA dahil JetPack ile TensorRT motorlarını dışa aktar.
-
NVIDIA DGX Spark hızlı başlangıç: NVIDIA DGX Spark'ta Ultralytics ve TensorRT'yi kur.
-
NVIDIA Jetson'da DeepStream: Dışa aktarılan modelleri NVIDIA DeepStream video işlem hatlarında çalıştır.
-
GitHub'da NVIDIA TensorRT: TensorRT için kaynak kodu, örnekler ve araçlar.
Sınırlamalar ve Sorun Giderme#
- Motorlar taşınabilir değildir: Bir motor, tek bir GPU modeli ve TensorRT sürümü için oluşturulur. GPU'yu, TensorRT sürümünü veya JetPack sürümünü değiştirdiğinde motoru yeniden oluştur. Bir motor yüklenemediğinde Ultralytics
TensorRT model exported with a different version than expectedkaydını tutar. - GPU gerekir:
deviceayarlanmamışsa dışa aktarmadevice=0kullanır vedevice=cpuiçinexport running on CPU but must be on GPUhatası verir. - Motor diğer araçlarda yüklenmiyor:
.enginedosyası bir meta veri başlığıyla başlar, bu nedenle TensorRT API'si dosyayı doğrudan okuyamaz. Motoru Ultralytics Dışında Yükleme bölümüne bak. - TensorRT sürümü: Ultralytics, TensorRT 7.0.0 veya üzerini gerektirir. TensorRT 10.2.0 desteklenmez ve otomatik yükleme bu sürümü atlar. JetPack 7 ve NVIDIA DGX sistemlerinde dışa aktarma için TensorRT 10.15 veya üzeri gerekir (Jetson'da 11'den düşük olmalı) ve yüklü sürüm bu aralığın dışındaysa uygun sürümü yüklemeyi dener.
- Eski TensorRT sürümlerinde NMS içermeyen başlık: TensorRT 8.5.0'dan eski sürümler YOLO26'nın NMS içermeyen başlığını oluşturamaz. Dışa aktarma bir uyarı kaydeder ve NMS gerektiren ham tahminleri yazar.
nms=Falseile dışa aktarmak için TensorRT'yi 8.5.0 veya üzerine yükselt. - JetPack 6'da INT8: JetPack 6'da TensorRT 10.3.0 ile
nms=Truekullanan bir INT8 dışa aktarımı başarısız olur;nms=Falsekullanan INT8 dışa aktarımı ise ham tahminlere geri döner. Çözüm için Jetson kılavuzuna bak. - TensorRT 10.16'da INT8: TensorRT 10.16.1 ile INT8 dışa aktarımı, NVIDIA RTX PRO 6000 Blackwell ve RTX 6000D GPU'larında
Could not find any implementation for nodenedeniyle başarısız oldu. RTX PRO 6000 Blackwell'de TensorRT 10.13, 10.14, 10.15 ve 11.4 INT8 motorunu oluşturdu. - DLA:
device=dla:0vedevice=dla:1yalnızca NVIDIA Jetson'da ve yalnızcaquantize=16veyaquantize=8ile çalışır. TensorRT 11'de dışa aktarma hata verir. DLA'nın desteklemediği katmanlar GPU'da çalışır. - Dinamik şekiller:
dynamic=Trueiçin maksimum toplu iş boyutu gerekir; bu nedenle örneğinbatch=8olacak şekildebatchdeğerini de ayarla. Bu değer verilmezse dışa aktarma bir uyarı kaydeder ve maksimum toplu iş boyutu 1 olur. Motor, 1'denbatchdeğerine kadar toplu işleri ve 32 pikselden dışa aktarmaimgszdeğerinin iki katına kadar görüntü boyutlarını kabul eder. Örneğinimgsz=320 batch=4ile dışa aktarılan bir motor 640 pikselde çalışır; 704 pikseli veya 6'lık toplu işiinput size ... is outside the TensorRT optimization profilehatasıyla reddeder.dynamic=Trueilequantize=8değerlerini yalnızca TensorRT 11'de birlikte kullan. T4 gibi hesaplama yeteneği 7.5 veya daha düşük GPU'larda bu dinamik INT8 motorlarının minimum boyutu 64 pikseldir (P6 modellerinde 128). - Sabit giriş boyutu:
dynamic=Trueolmadan dışa aktarılan bir motor her zaman dışa aktarmaimgszdeğerinde çalışır. Predict veya val komutuna başka birimgszdeğeri vermenin etkisi olmaz; giriş boyutunu değiştirmek için yeniden dışa aktar. dataolmadan INT8 dışa aktarımı: Kontrol noktasıquantize=8ile eğitilmediyse dışa aktarma, tespit için 4 doğrulama görüntüsü içeren görevin varsayılan küçük veri kümesinde kalibrasyon yapar ve bir uyarı kaydeder. Temsilî görüntüler içerendatadeğerini ver; dışa aktarma 300'den az görüntüde uyarı verir.- İlk çıkarımlar yavaş: Yeni bir motorla veya dinamik bir motorda yeni bir
imgszile yapılan ilk birkaç çağrı, sonraki çağrılardan daha uzun sürer.
Diğer hatalar için Yaygın Sorunlar kılavuzuna bak.
Kıyaslamalar#
YOLO26 model sayfasında, anlamsal segmentasyon dışındaki tüm görevler için NVIDIA T4 GPU'da her modelin TensorRT 10 hızı listelenir.
FP32, FP16 ve INT8 Karşılaştırması#
Aşağıdaki tablolar, tüm YOLO26 tespit modellerinin ve diğer beş görev için YOLO26n modelinin PyTorch ile FP32, FP16 ve INT8 TensorRT 11.4 motorlarını karşılaştırır. Tüm değerler tek bir NVIDIA RTX PRO 6000 Blackwell Server Edition GPU'sunda ölçülmüştür.
Görüntü başına milisaniye; düşük değer daha iyidir. Her model için en hızlı biçim kalın gösterilmiştir; doğruluğu kararsız olduğu için YOLO26x INT8 motoru dahil edilmemiştir.
| Model | imgsz | PyTorch | TensorRT FP32 | TensorRT FP16 | TensorRT INT8 |
|---|---|---|---|---|---|
| YOLO26n | 640 | 2.85 | 0.67 | 0.48 | 0.53 |
| YOLO26s | 640 | 2.98 | 1.15 | 0.61 | 0.66 |
| YOLO26m | 640 | 3.29 | 2.22 | 1.03 | 1.08 |
| YOLO26l | 640 | 4.70 | 3.03 | 1.49 | 1.43 |
| YOLO26x | 640 | 5.93 | 4.31 | 2.09 | 1.84 |
| YOLO26n-seg | 640 | 3.18 | 0.93 | 0.65 | 0.72 |
| YOLO26n-sem | 1024 | 1.74 | 0.74 | 0.45 | 0.71 |
| YOLO26n-cls | 224 | 1.75 | 0.29 | 0.24 | 0.20 |
| YOLO26n-pose | 640 | 3.39 | 0.76 | 0.51 | 0.59 |
| YOLO26n-obb | 1024 | 4.55 | 1.03 | 0.64 | 0.88 |
- FP16, tüm modellerde FP32 doğruluğunu 0,1 puan içinde korudu. Algılama modellerinde FP32 motorundan 1,4 ila 2,2 kat, PyTorch'tan ise 2,8 ila 5,9 kat daha hızlı çalıştı.
- INT8, algılama modellerinde FP16 gecikme süresinin %12'si içinde kaldı ve YOLO26n, YOLO26s, YOLO26m ve YOLO26l modellerinde mAP değerinden 1,7 ila 2,9 puan kaybetti. Bu GPU'da FP16'dan yalnızca YOLO26l, YOLO26x ve YOLO26n-cls daha hızlıydı.
- YOLO26x INT8 doğruluğu, üç derlemede 57,5 olan FP32 değerine kıyasla 25,3 ile 38,5 mAP arasına düştü. YOLO26n-pose INT8 ise 56,7 poz mAP değerinden 33,4'e geriledi. Dağıtıma almadan önce her INT8 motorunu kendi verilerinle doğrula.
- TensorRT 10.16 üzerinde YOLO26n ve YOLO26s modellerinin FP32 ve FP16 motorları, TensorRT 11.4 doğruluğuyla eşleşti. FP16 motorları yaklaşık %7 daha hızlı, FP32 motorları ise TensorRT 11.4'tekilerden %4 ila %9 daha yavaştı.
NVIDIA Jetson ve DGX Spark için Jetson kıyaslamalarına ve DGX Spark kılavuzuna bak.
Ölçüm, 13 Kasım 2026'da batch=1 üzerinde ultralytics 8.4.211, TensorRT 11.4.0, PyTorch 2.15.0 ve CUDA 13.2 ile yapıldı. Gecikme süresi, val tarafından bildirilen çıkarım aşamasını ifade eder; ön işleme ve son işlemeyi kapsamaz.
TensorRT hakkında#
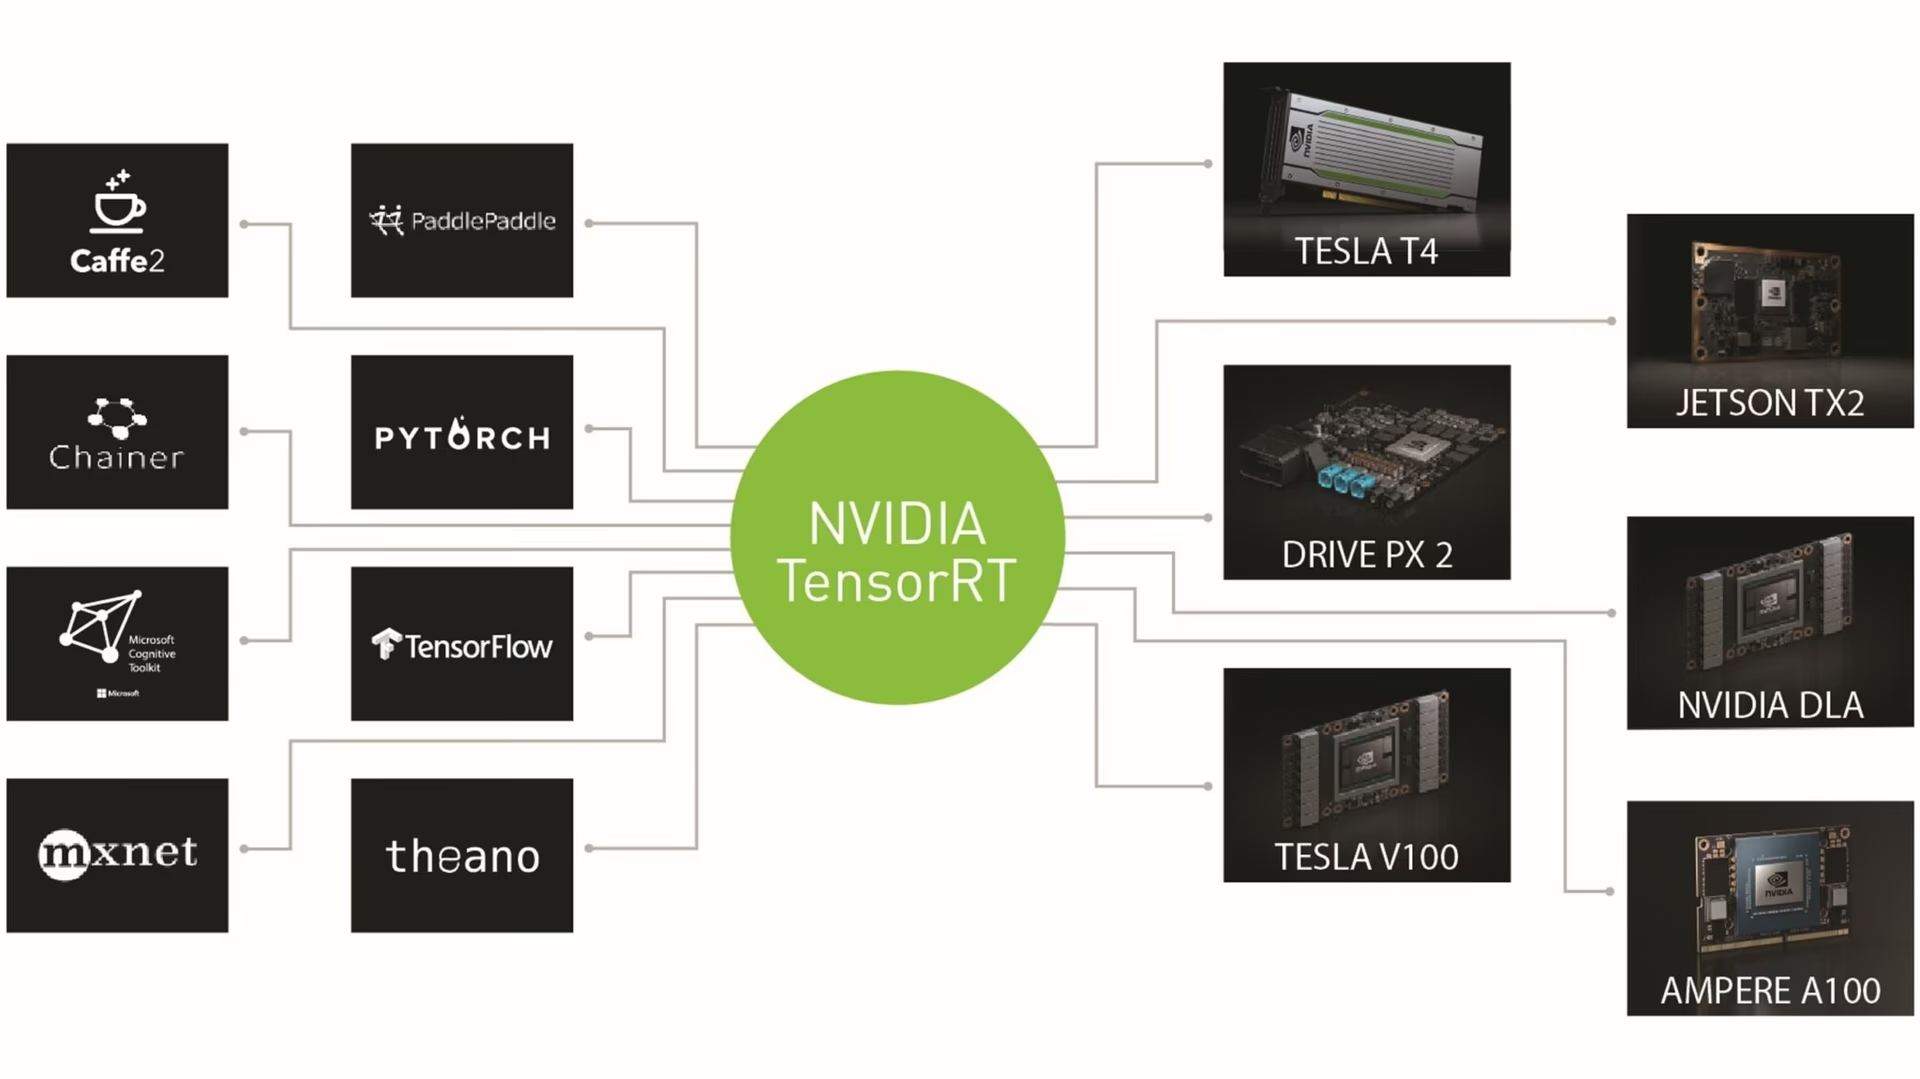
TensorRT, katmanları birleştirerek, derleme GPU'sunda her katman için en hızlı çekirdeği seçerek ve isteğe bağlı olarak hassasiyeti FP16 veya INT8'e düşürerek bir motor oluşturur. Başvuru kaynağının tamamı için TensorRT belgelerine bak.
Sık Sorulan Sorular#
Yalnızca aynı modeldeki ve aynı TensorRT sürümüne sahip bir GPU'da çalıştırabilirsin. Motor, tek bir GPU modeli ve tek bir TensorRT sürümü için oluşturulur. Farklı donanımlarda aynı dosyayı kullanmak için ONNX biçimine aktar ve motoru her cihazda oluştur. NVIDIA Jetson için Ultralytics Platform, sekiz Jetson hedefi için motor oluşturabilir.
FP16 ile başla (
quantize=16). Kalibrasyon verisi gerektirmez ve FP32 doğruluğunu korur. TensorRT 11.4 kullanılan NVIDIA RTX PRO 6000 Blackwell üzerindeki kıyaslamalarda, FP16 aynı 48,5 mAPdoğrulama 50-95 değerinde, YOLO26s gecikmesini görüntü başına 1,15 ms'den 0,61 ms'ye düşürdü. INT8 (quantize=8) 0,66 ms ve 46,3 mAPdoğrulama 50-95 değerinde çalıştı; bu GPU'da FP16'dan daha hızlı değildi ve kontrol noktasıquantize=8ile eğitilmediyse temsili kalibrasyon verileri gerektirir. INT8 başka donanımlarda avantaj sağlayabilir: Jetson kıyaslamalarında gömülü cihazlar için FP16 ve INT8 sonuçları listelenmiştir. INT8'i seçmeden önce dağıtım cihazında her iki hassasiyet düzeyini de ölç.dynamic=Trueile dışa aktar vebatchdeğerini çalıştırmayı planladığın en büyük toplu iş boyutuna ayarla. Böylece motor 1 ilebatcharasındaki toplu iş boyutlarını ve 32 pikselden dışa aktarmaimgszdeğerinin iki katına kadar olan görüntü boyutlarını kabul eder; eski GPU'lardaki dinamik INT8 motorlarında minimum değer daha yüksektir.dynamic=Trueolmadan motorun tek bir sabit giriş şekli olur ve Ultralytics her toplu işi bu şekle uyacak şekilde böler veya doldurur.Dinamik motorfrom ultralytics import YOLO model = YOLO("yolo26n.pt") model.export(format="engine", dynamic=True, batch=8, quantize=16) model = YOLO("yolo26n.engine") results = model(["https://ultralytics.com/images/bus.jpg"] * 4, batch=4) # 4 görüntülük bir toplu işDışa aktarma işlemini Jetson'ın kendisinde, JetPack sürümünle gelen TensorRT sürümünü kullanarak çalıştır. DLA çekirdeği kullanmak için
quantize=16veyaquantize=8iledevice=dla:0ekle. Kurulum ve kıyaslamalar için NVIDIA Jetson kılavuzuna bak.Jetson'da dışa aktarfrom ultralytics import YOLO model = YOLO("yolo26n.pt") model.export(format="engine", quantize=16) # Jetson GPU'sunda FP16 motoru # Veya bunun yerine DLA çekirdeği 0 için FP16 motorunu oluştur model.export(format="engine", quantize=16, device="dla:0")Triton Inference Server kılavuzu, modeli ONNX'e aktarır ve
config.pbtxtiçinde Triton'un TensorRT hızlandırıcısını etkinleştirir. Ardından Triton, ilk yüklemede TensorRT motorunu sunucu GPU'sunda oluşturup önbelleğe alır; böylece motor her zaman sunucunun GPU'su ve TensorRT sürümüyle eşleşir. Kılavuzda model deposu düzeni, sunucu kapsayıcısı ve Ultralytics ile istemci tarafında çıkarım konuları ele alınır.


Yorumlar116
Bir soru sor, sonuçlarını paylaş veya başka birine yardım et.
AgbajeAyomipo
Hi Ultralytics team, I’ve trained a YOLOv11 model on (1024x1024) images from a camera feed and now I’m trying to run real-time inference on live streams using a Jetson Orin Nano. I want to maintain full resolution for inference because of accuracy requirements, but currently I'm getting only 1-2 FPS. When I reduce the input size, the FPS improves significantly, but it's not acceptable due to missed detections at lower resolutions. I attempted to export the model to TensorRT using:
model.export(format="engine", imgsz=(2592, 1944), half=True) but it fails silently. If I use a dynamic=true without specifying the imgsz parameter, the export succeeds and uses (1024, 1024). My questions:
Is TensorRT export for such high-resolution input supported/recommended with YOLOv11? If not, is there any known limitation or workaround? Are there ways to improve performance with high-res inference on Jetson Orin Nano? What hardware would you recommend for real-time inference on 1-3 camera streams with 5MP inputs, assuming we need at least ~15-20 FPS per stream? Device: AAEON BOXER-8621AI Module: NVIDIA® Jetson Orin Nano™ (4GB LPDDR5, Super Mode Enabled) Memory: 4 GB LPDDR5 I/O: USB 3.2 Gen 2, M.2 Expansion Operating System: JetPack 5.1.4 (L4T 35.6.0, Ubuntu 20.04) Use Case: Real-time multi-stream 5MP video inference
1martinmclee
Have you gotten any workaround? Perhaps with the YOLO26?
Hi Ultralytics team, I’ve trained a YOLOv11 model on full-size 5MP (2592x1944) images from a camera feed and now I’m trying to run real-time inference on live streams using a Jetson Orin Nano. I want to maintain full resolution for inference because of accuracy requirements, but currently I'm getting only 1-2 FPS. When I reduce the input size, the FPS improves significantly, but it's not acceptable due to missed detections at lower resolutions. I attempted to export the model to TensorRT using:
model.export(format="engine", imgsz=(2592, 1944), half=True)but it fails silently. If I use a dynamic=true, the export succeeds and uses (1024, 1024). My questions:- Is TensorRT export for such high-resolution input supported/recommended with YOLOv11? If not, is there any known limitation or workaround?
- Are there ways to improve performance with high-res inference on Jetson Orin Nano?
- What hardware would you recommend for real-time inference on 1-3 camera streams with 5MP inputs, assuming we need at least ~15-20 FPS per stream? Device: AAEON BOXER-8621AI Module: NVIDIA® Jetson Orin Nano™ (4GB LPDDR5, Super Mode Enabled) Memory: 4 GB LPDDR5 I/O: USB 3.2 Gen 2, M.2 Expansion Operating System: JetPack 5.1.4 (L4T 35.6.0, Ubuntu 20.04) Use Case: Real-time multi-stream 5MP video inference
1020423lzl
m的模型大小比n大的多,速度也慢了很多,输入图像尺寸越大,越吃显存,速度也越慢
李子乐控制工程 @.***
---Original--- From: @.> Date: Sat, May 9, 2026 10:30 AM To: @.>; Cc: @.@.>; Subject: Re: [ultralytics/ultralytics] zh/integrations/tensorrt/ (Discussion #9868)
现在有一个奇怪的现象,我导出的tensorrt模型的推理速度几乎和原来的.pt几乎没有差别甚至更慢,并且导出的tensorrt模型的推理结果和.pt模型的差别很大。 我的设备是i914900k+64G RAM+RTX A6000 我的环境是cuda12.4.131+tensorrt10.10.0.31+torch2.5.1+ultralytics8.3.252 导出命令: yolo export model=yolo11m.pt imgsz=1280 format='engine 推理代码为: model.predict(stream_path, imgsz=1280, classes=[14], conf=0.2, iou=0.5, stream=True, task='detect')
另外我试了下yolo11n.pt的640输入尺寸导出,推理速度就有明显提升,当然推理结果差别仍然较大。 请问这是什么道理,有什么解决办法?
— Reply to this email directly, view it on GitHub, or unsubscribe. Triage notifications on the go with GitHub Mobile for iOS or Android. You are receiving this because you commented.Message ID: @.***>
 User
能不能读完再说话,肯定是m和m比,n和n比,同样尺寸输入和同样尺寸输入的比啊。 该显卡的RT core算力是普通fp32算力的近两倍。
 Glenn JocherUltralytics
是的,性能应当在同一模型、同一
imgsz、同一batch、同一后处理参数下比较;m比n更大、1280比640更吃显存且更慢是正常现象。对 RTX A6000 来说,FP32的 TensorRT 往往不会比.pt明显更快,建议先按 TensorRT 导出文档 用half=True重新导出,并在相同输入上预热后再统计平均耗时;如果engine与.pt结果仍明显不一致,请贴出!yolo checks、完整控制台日志文本和一个最小可复现示例,我们好继续排查环境或后处理差异。
- User
现在有一个奇怪的现象,我导出的tensorrt模型的推理速度几乎和原来的.pt几乎没有差别甚至更慢,并且导出的tensorrt模型的推理结果和.pt模型的差别很大。 我的设备是i914900k+64G RAM+RTX A6000 我的环境是cuda12.4.131+tensorrt10.10.0.31+torch2.5.1+ultralytics8.3.252 导出命令:
yolo export model=yolo11m.pt imgsz=1280 format='engine推理代码为:model.predict(stream_path, imgsz=1280, classes=[14], conf=0.2, iou=0.5, stream=True, task='detect')另外我试了下yolo11n.pt的640输入尺寸导出,推理速度就有明显提升,当然推理结果差别仍然较大。 请问这是什么道理,有什么解决办法?
etson@yahboom:~/ultralytics/ultralytics$ yolo predict model=best.engine source=0 save=False show WARNING ⚠️ Unable to automatically guess model task, assuming 'task=detect'. Explicitly define task for your model, i.e. 'task=detect', 'segment', 'classify','pose' or 'obb'. Ultralytics 8.3.172 🚀 Python-3.10.12 torch-2.5.0a0+872d972e41.nv24.08 CUDA:0 (Orin, 7620MiB) Loading best.engine for TensorRT inference... [12/18/2025-17:11:05] [TRT] [I] Loaded engine size: 75 MiB [12/18/2025-17:11:05] [TRT] [I] [MS] Running engine with multi stream info [12/18/2025-17:11:05] [TRT] [I] [MS] Number of aux streams is 7 [12/18/2025-17:11:05] [TRT] [I] [MS] Number of total worker streams is 8 [12/18/2025-17:11:05] [TRT] [I] [MS] The main stream provided by execute/enqueue calls is the first worker stream [12/18/2025-17:11:05] [TRT] [I] [MemUsageChange] TensorRT-managed allocation in IExecutionContext creation: CPU +1, GPU +88, now: CPU 1, GPU 158 (MiB)
[ WARN:0@2.771] global cap_gstreamer.cpp:1777 open OpenCV | GStreamer warning: Cannot query video position: status=0, value=-1, duration=-1 1/1: 0... Success ✅ (inf frames of shape 1920x1080 at 5.00 FPS)
Traceback (most recent call last): File "/home/jetson/.local/bin/yolo", line 7, in sys.exit(entrypoint()) File "/home/jetson/Downloads/ultralytics-main/ultralytics/cfg/init.py", line 983, in entrypoint getattr(model, mode)(**overrides) # default args from model File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/model.py", line 555, in predict return self.predictor.predict_cli(source=source) if is_cli else self.predictor(source=source, stream=stream) File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/predictor.py", line 247, in predict_cli for _ in gen: # sourcery skip: remove-empty-nested-block, noqa File "/usr/local/lib/python3.10/dist-packages/torch/utils/_contextlib.py", line 36, in generator_context response = gen.send(None) File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/predictor.py", line 351, in stream_inference s[i] += self.write_results(i, Path(paths[i]), im, s) File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/predictor.py", line 434, in write_results string += f"{result.verbose()}{result.speed['inference']:.1f}ms" File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/results.py", line 694, in verbose return "".join(f"{n} {self.names[i]}{'s' * (n > 1)}, " for i, n in enumerate(counts) if n > 0) File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/results.py", line 694, in return "".join(f"{n} {self.names[i]}{'s' * (n > 1)}, " for i, n in enumerate(counts) if n > 0) KeyError: 171 terminate called without an active exception Aborted (core dumped) jetson@yahboom:~/ultralytics/ultralytics$ How to solve it
- Glenn JocherUltralytics
KeyError: 171表示模型输出了类别171,但当前names里没有这个索引(通常是自定义数据集的标签类别编号不在0..nc-1范围内、data.yaml里的names数量与nc不匹配,或导出/推理用的模型与数据配置不一致导致的元数据错配);请先把所有标注.txt的 class id 修正为连续的0..nc-1,同步修正data.yaml的nc/names,修正后删除数据集labels/下的*.cache,再用同一套环境从best.pt重新导出.engine(参考 TensorRT 导出文档),并在推理时显式加上task=detect。另外请把下面命令的完整输出(文本)贴在这个 discussion 里,以及你当时的导出命令,方便我们确认是否有多环境/路径冲突:yolo checks Thank you for your reply. The issue has been resolved. I was using the RT-DETR model, but I mistakenly used "from ultralytics import YOLO" when exporting
- Glenn JocherUltralytics
Glad you found it — RT-DETR models should be loaded/exported with
RTDETR(...)(mixing them withYOLO(...)can produce mismatched metadata likenames), see the RT-DETR model docs for details:from ultralytics import RTDETR model = RTDETR("best.pt") model.export(format="engine") # creates best.engine
fly2skyToEnjoy
May I ask : The following command exports the file, whether the box and mask are both nmsed at the same time ???
from ultralytics import YOLO
Load the YOLO11 model
model = YOLO("yolo11n.pt")
Export the model to TensorRT format
model.export(format="engine") # creates 'yolo11n.engine'
Load the exported TensorRT model
tensorrt_model = YOLO("yolo11n.engine")
Run inference
results = tensorrt_model("https://ultralytics.com/images/bus.jpg")
AK993
这个方法适用于rt-detr吗
dilanpatel195
I am trying to prediction model for the YOLOv11n-seg, I have exported the .py to .engine to back it run faster but keep getting a KEY error message:
KeyError Traceback (most recent call last) Cell In[4], line 109 106 # Inside the main loop after grabbing a frame 107 if inference_active and not inpainting_active: 108 # Perform YOLO inference --> 109 results = model(rgb_frame)[0] 110 masked_image = rgb_frame.copy() # Make a copy for masking 112 # Process YOLO masks (original functionality remains unchanged)
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\model.py:176, in Model.call(self, source, stream, **kwargs) 147 def call( 148 self, 149 source: Union[str, Path, int, Image.Image, list, tuple, np.ndarray, torch.Tensor] = None, 150 stream: bool = False, 151 **kwargs, 152 ) -> list: 153 """ 154 Alias for the predict method, enabling the model instance to be callable for predictions. 155 (...) 174 ... print(f"Detected {len(r)} objects in image") 175 """ --> 176 return self.predict(source, stream, **kwargs)
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\model.py:554, in Model.predict(self, source, stream, predictor, **kwargs) 552 if prompts and hasattr(self.predictor, "set_prompts"): # for SAM-type models 553 self.predictor.set_prompts(prompts) --> 554 return self.predictor.predict_cli(source=source) if is_cli else self.predictor(source=source, stream=stream)
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\predictor.py:168, in BasePredictor.call(self, source, model, stream, *args, **kwargs) 166 return self.stream_inference(source, model, *args, **kwargs) 167 else: --> 168 return list(self.stream_inference(source, model, *args, **kwargs))
File c:\ProgramData\miniconda3\Lib\site-packages\torch\utils_contextlib.py:36, in _wrap_generator..generator_context(*args, **kwargs) 33 try: 34 # Issuing None to a generator fires it up 35 with ctx_factory(): ---> 36 response = gen.send(None) 38 while True: 39 try: 40 # Forward the response to our caller and get its next request
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\predictor.py:274, in BasePredictor.stream_inference(self, source, model, *args, **kwargs) 268 self.results[i].speed = { 269 "preprocess": profilers[0].dt * 1e3 / n, 270 "inference": profilers[1].dt * 1e3 / n, 271 "postprocess": profilers[2].dt * 1e3 / n, 272 } 273 if self.args.verbose or self.args.save or self.args.save_txt or self.args.show: --> 274 s[i] += self.write_results(i, Path(paths[i]), im, s) 276 # Print batch results 277 if self.args.verbose:
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\predictor.py:334, in BasePredictor.write_results(self, i, p, im, s) 332 result = self.results[i] 333 result.save_dir = self.save_dir.str() # used in other locations --> 334 string += f"{result.verbose()}{result.speed['inference']:.1f}ms" 336 # Add predictions to image 337 if self.args.save or self.args.show:
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\results.py:663, in Results.verbose(self) 661 for c in boxes.cls.unique(): 662 n = (boxes.cls == c).sum() # detections per class --> 663 log_string += f"{n} {self.names[int(c)]}{'s' * (n > 1)}, " 664 return log_string
KeyError: 2
Any help would be greatly appreciated!
Ranjith3436
Now, My TensorRT Sengment model used for track. if any detections not there the processing FPS is 75-80 in jetson. But once the person or people detected suddenly reused to 15-20. processing time going to 40ms. only when the object detected. What's the issue in model.track(), could i run all the tracking thing on GPU.
- Glenn JocherUltralytics(düzenlendi)
@Ranjith3436 the performance drop when objects are detected is expected behavior, as tracking introduces additional computational overhead. When objects are detected, the model.track() method performs several CPU-bound operations including feature extraction, association, and trajectory management.
To improve performance:
- Try using a smaller model variant (like YOLO26n-seg instead of larger variants)
- Consider reducing the image resolution for tracking
- Optimize tracking parameters by setting
persist=Trueand adjustingconfthresholds higher to track fewer objects - Use
half=True(FP16) orint8=Truewhen exporting your model to TensorRT for maximum GPU acceleration
For the tracking components specifically, the BoT-SORT or ByteTrack algorithms used by Ultralytics do have some CPU-bound operations, but you can minimize their impact with the above optimizations. For more details on tracking optimization, check our tracking documentation.
1
I convert Classification model that i retrained. But it throw the error "amax(): Expected reduction dim 1 to have non-zero size."
- Glenn JocherUltralytics
@Ranjith3436 this error typically occurs when TensorRT encounters an empty dimension during model conversion. For classification models, this could happen if:
- Your model architecture was modified or if you're using a custom architecture
- There might be an issue with batch normalization layers during export
- The class count in your retrained model might be causing dimension mismatches
Try these solutions:
- Ensure your model's forward pass works correctly before export
- Try exporting with
simplify=Falseto preserve the original graph structure - Check if your classification model has the correct output dimension for your number of classes
If the issue persists, share more details about your model architecture and export command for better assistance. For more guidance, refer to our TensorRT integration documentation.
The model trained use yolov8l-cls.pt and the error come from jetson device.
(model): ClassificationModel( (model): Sequential( (0): Conv( (conv): Conv2d(3, 64, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (1): Conv( (conv): Conv2d(64, 128, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (2): C2f( (cv1): Conv( (conv): Conv2d(128, 128, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(320, 128, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (m): ModuleList( (0-2): 3 x Bottleneck( (cv1): Conv( (conv): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) ) ) ) (3): Conv( (conv): Conv2d(128, 256, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (4): C2f( (cv1): Conv( (conv): Conv2d(256, 256, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(1024, 256, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (m): ModuleList( (0-5): 6 x Bottleneck( (cv1): Conv( (conv): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) ) ) ) (5): Conv( (conv): Conv2d(256, 512, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (6): C2f( (cv1): Conv( (conv): Conv2d(512, 512, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(2048, 512, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (m): ModuleList( (0-5): 6 x Bottleneck( (cv1): Conv( (conv): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) ) ) ) (7): Conv( (conv): Conv2d(512, 1024, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(1024, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (8): C2f( (cv1): Conv( (conv): Conv2d(1024, 1024, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(1024, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(2560, 1024, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(1024, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (m): ModuleList( (0-2): 3 x Bottleneck( (cv1): Conv( (conv): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) ) ) ) (9): Classify( (conv): Conv( (conv): Conv2d(1024, 1280, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(1280, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (pool): AdaptiveAvgPool2d(output_size=1) (drop): Dropout(p=0.0, inplace=True) (linear): Linear(in_features=1280, out_features=2, bias=True) ) ) ) )
model architecture
This error sorted out