YOLOE: Gerçek Zamanlı Açık Kelime Dağarcıklı Algılama ve Segmentasyon
Ultralytics YOLOE (Gerçek Zamanlı Her Şeyi Görme), bir açık kelime dağarcıklı algılama ve örnek segmentasyonu modelidir: eğitim sırasında sabitlenen bir sınıf listesi yerine, çıkarım sırasında istediğin kategorileri metin istemi, görsel örnek veya yerleşik 4.585 adlık kelime dağarcığı olarak alır. Ultralytics YOLO mimarileri (YOLOv8, YOLO11 ve YOLO26) üzerine kurulu ve YOLO-World'den ilham alan YOLOE, kapalı küme YOLO hızına yakın bir hızla yüksek sıfır atışlı doğruluk sunar.
İzle: Ultralytics YOLOE-26 (Yeni) Nasıl Kullanılır | Açık Kelime Dağarcığı ve Gerçek Zamanlı Her Şeyi Görme
Hızlı Başlangıç#
İstediğin sınıfları adlandır ve çalıştır. YOLOE-26, hiç eğitilmediği kategoriler için kutular ve örnek segmentasyon maskeleri döndürür.
from ultralytics import YOLOE

model = YOLOE("yoloe-26s-seg.pt")

# "double-decker bus" bir COCO sınıfı değildir; YOLOE bunu yalnızca sözcüklerden belirler
model.set_classes(["double-decker bus", "person"])

results = model.predict("https://ultralytics.com/images/bus.jpg")
results[0].show()
İlk set_classes() çağrısı bir metin kodlayıcı indirir; ağ erişimi olmayan bir makineye dağıtım yapmadan önce Kurulum ve Gereksinimler bölümüne bak.
İstem Modunu Seçme#
YOLOE üç istem modunu destekler; seçimin hangi kontrol noktasını yükleyeceğini ve sınıf etiketlerinin nasıl görüneceğini belirler. Çıkarım sırasında sağlayabileceklerine uyan satırı seç.
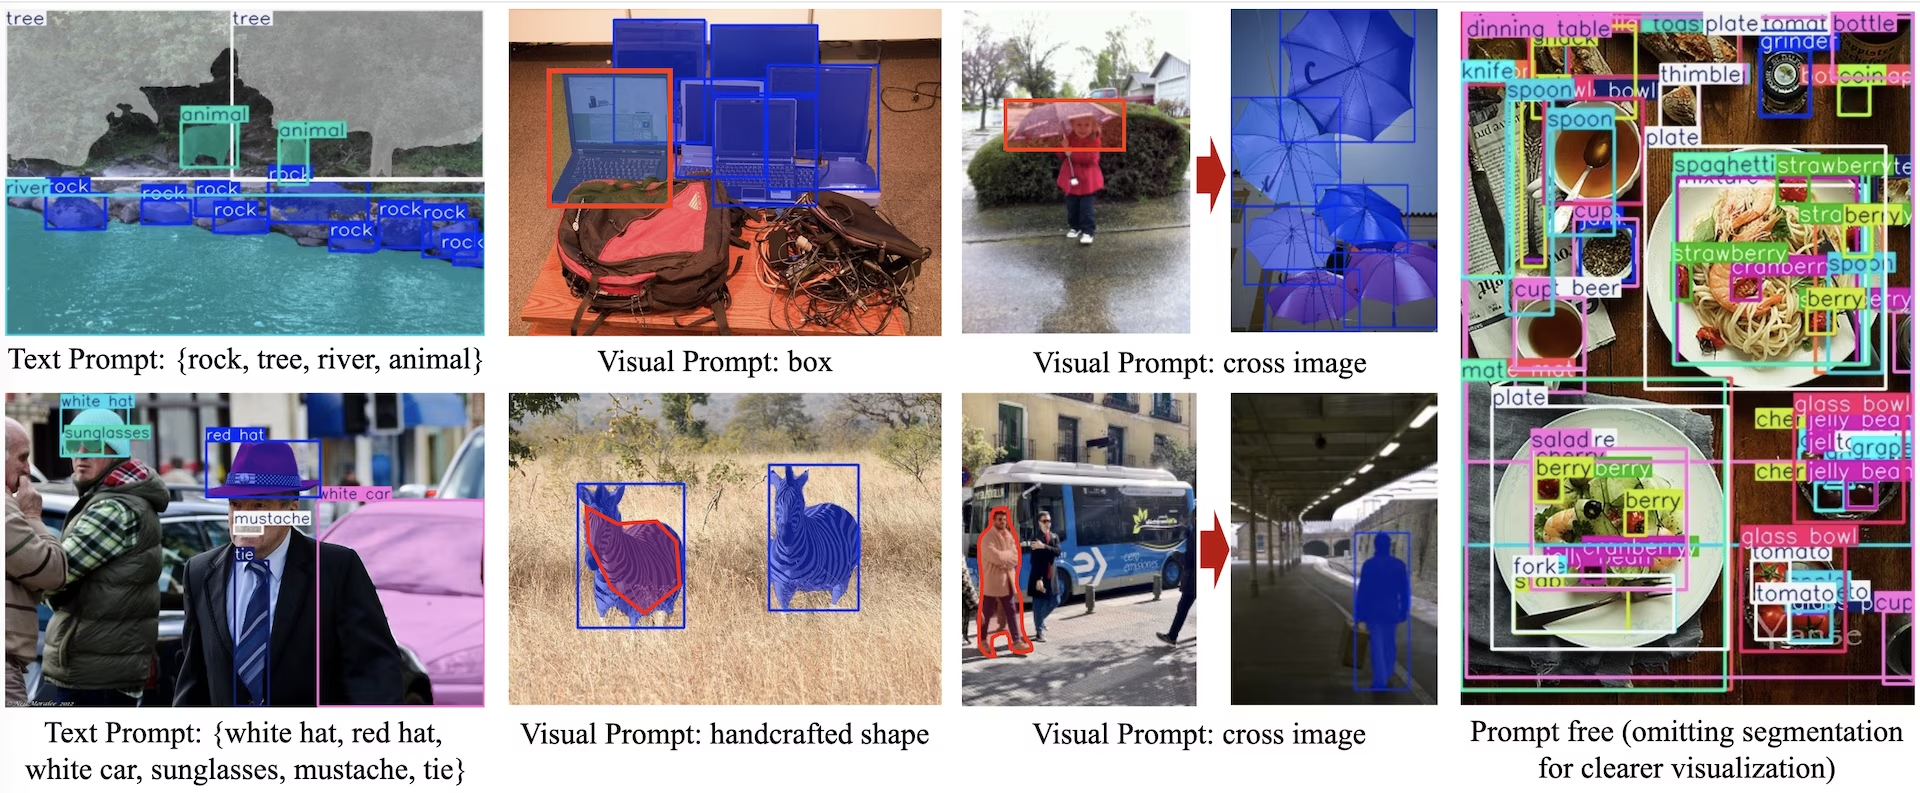
| Mod | Kontrol noktası | Sağladığın girdi | Sonuçlardaki sınıf adları | Şu durumda kullan |
|---|---|---|---|---|
| Metin istemi | *-seg.pt | Dizeler olarak sınıf adları | Girdiğin adların aynısı | Hedefi sözcüklerle tarif edebiliyorsan — genellikle tercih edilen seçenek |
| Görsel istem | *-seg.pt | Referans görüntü üzerindeki örnek kutular | Genel object0, object1, … | Hedefi sözcüklerle ifade edemiyorsan: belirli bir parça, logo veya kusur |
| İstemsiz | *-seg-pf.pt | Hiçbir şey | Yerleşik 4.585 adlık söz varlığındaki adlar | Katalog oluşturuyor veya keşif yapıyorsan ve önceden ne arayacağını bilmiyorsan |
- Görsel istemler etiketlerini taşımaz.
visual_promptsiçindeki sınıf kimlikleri örnekleri gruplandırır; model bunlarıobject0,object1vb. olarak raporlar. Bunları kendi adlarınla kendin eşleştir. - İstemsiz kontrol noktaları
set_classes()girdisini kabul etmez. Bunu bir*-seg-pf.ptmodeli üzerinde çağırmakAssertionError: Prompt-free model does not support setting classes. Please try with Text/Visual prompt models.hatasına yol açar. Kendi sınıflarına ihtiyaç duyduğunda bunun yerine bir*-seg.ptkontrol noktası yükle.
Kurulum ve Gereksinimler#
YOLOE, ana Ultralytics paketinde sunulur:
pip install -U ultralyticsMetinle istem vermek için buna ek olarak bir metin kodlayıcı gerekir; bu kodlayıcı kurulum sırasında değil, ilk kullanımda indirilir:
- İlk
set_classes()çağrısı,pipile (belirteçleyiciyi sağlar) GitHub'dan ultralytics/CLIP yükler ve bir TorchScript metin kodlayıcısını geçerli çalışma dizinine indirir. YOLOE-26, yaklaşık 254 MB olanmobileclip2_b.tsdosyasını; YOLOE-11 ve YOLOE-v8 isemobileclip_blt.tsdosyasını indirir. İndirme işlemini çalıştıracağın dizinden bir kez yap veya dosyayı bu dizine kopyala; aksi takdirde dosya yeniden indirilir. - Her iki adım da ağ erişimi gerektirir; bu nedenle çevrimdışı veya ağ bağlantısı kesilmiş bir makineye dağıtım yapmadan önce istemli bir tahmin çalıştır.
- Görsel istemler ve istemsiz kontrol noktaları hiç metin kodlayıcı gerektirmez.
YOLOE-26 kontrol noktaları için ultralytics 8.4.0 veya daha yeni bir sürüm gerekir; YOLOE-11 ve YOLOE-v8 aileleri daha eski sürümlerde kullanılabilir. Metin istemli tek bir tahmin tüm akışı — kontrol noktasının indirilmesi, CLIP kurulumu, metin kodlayıcı ve çıkarım — çalıştırır:
yolo predict model=yoloe-26s-seg.pt source="https://ultralytics.com/images/bus.jpg" classes="person"Çıkarım sırasında metin kodlayıcıyı indirme adımını tamamen atlamak için istemleri bir kez ağırlıklara göm ve yeniden kullan — İstem gömmelerini yeniden kullanma bölümüne bak.
Mimariye Genel Bakış#

YOLOE, standart YOLO yapısını korur — özellik çıkarımı için evrişimli bir omurga, çok ölçekli birleştirme için bir boyun ve sınıfları ve kutuları tahmin eden çapasız, ayrık bir başlık — ve her istem modu için bir tane olmak üzere üç modül ekler:
- Yeniden Parametrelendirilebilir Bölge-Metin Hizalaması (RepRTA), CLIP metin gömmelerini küçük bir yardımcı ağ aracılığıyla iyileştirir. Bu ağ her
set_classes()çağrısında bir kez çalışır ve dışa aktarma sırasında modele katlanır; dolayısıyla kare başına maliyeti yoktur. Her ileri geçişte çalışan işlem, saklanan istem gömmelerini bölge özellikleriyle karşılaştırmaktır; büyük bir istem kümesinin maliyeti için Sınırlamalar bölümüne bak. - Anlamsal Etkinleştirmeli Görsel İstem Kodlayıcı (SAVPE), örnek bir kutudan anlamsal ve etkinleştirme özellikleri kodlayarak modeli bu kutudakilere benzeyen neslelere göre koşullandırır. Logo veya belirli bir parça gibi adlandırılması zor hedefler için tek örnekli yol budur.
- Tembel Bölge-İstem Karşıtlığı (LRPC), bölge gömmelerini yerleşik 4.585 adlık söz varlığıyla eşleştirir; böylece istemsiz kontrol noktaları herhangi bir harici istem veya metin kodlayıcı olmadan nesneleri tanır.
Örnek segmentasyonu, YOLOv8-Seg'deki gibi algılama başlığındaki bir maske dalından gelir ve her tahmin results[0].masks üzerinde bir maske taşır. Model dışa aktarıldıktan sonra açık dünya modülleri standart bir YOLO başlığına yeniden parametrelendirilir; böylece dışa aktarılan dosya olağan algılama/segmentasyon yolunu çalıştırır.
Kullanılabilir Modeller#
Aşağıdaki her kontrol noktası bir örnek segmentasyon modelidir ve val, predict, export ve track modlarını destekler. Metin veya görsel istemi için *-seg.pt dosyasını, istemsiz çıkarım için *-seg-pf.pt dosyasını yükle; bu dosyalar birbirinin yerine kullanılamaz. Ayrıntılar için İstem Modu Seçimi bölümüne bak. Yalnızca *-seg.pt dosyaları train modunu destekler; istemsiz kontrol noktası, metin istemli eğitilmiş bir modelden üretilir. Ayrıntılar için Resmî Modelleri Sıfırdan Eğitme bölümüne bak.
| Model | Metin/görsel istem | İstemsiz |
|---|---|---|
| YOLOE-26n | yoloe-26n-seg.pt | yoloe-26n-seg-pf.pt |
| YOLOE-26s | yoloe-26s-seg.pt | yoloe-26s-seg-pf.pt |
| YOLOE-26m | yoloe-26m-seg.pt | yoloe-26m-seg-pf.pt |
| YOLOE-26l | yoloe-26l-seg.pt | yoloe-26l-seg-pf.pt |
| YOLOE-26x | yoloe-26x-seg.pt | yoloe-26x-seg-pf.pt |
| YOLOE-11s | yoloe-11s-seg.pt | yoloe-11s-seg-pf.pt |
| YOLOE-11m | yoloe-11m-seg.pt | yoloe-11m-seg-pf.pt |
| YOLOE-11l | yoloe-11l-seg.pt | yoloe-11l-seg-pf.pt |
| YOLOE-v8s | yoloe-v8s-seg.pt | yoloe-v8s-seg-pf.pt |
| YOLOE-v8m | yoloe-v8m-seg.pt | yoloe-v8m-seg-pf.pt |
| YOLOE-v8l | yoloe-v8l-seg.pt | yoloe-v8l-seg-pf.pt |
YOLOE'nin LVIS üzerindeki performansı#
640 pikselde LVIS minival üzerindeki sıfır örnekli sonuçlar, Ultralytics YOLO26 makalesinden alınmıştır.
Metin ve görsel istemler#
Her doğruluk ve parametre hücresi metin istemi / görsel istem biçimindedir; FLOP değeri bir kez verilir. Parametre ve FLOP değerleri, makalenin değerlendirdiği algılama yapılandırmasına aittir. Doğruluk, karşılaştırmadaki her model için raporlanan tek protokol olan makalenin Non-E2E değeridir; YOLOE-26 uçtan uca başlığının doğruluğu, metin istemlerinde en fazla 1.1 AP, görsel istemlerde ise 2.6 AP daha düşüktür.
| Model | mAP50-95 | mAPr | mAPc | mAPf | parametre (M) | FLOPs (B) |
|---|---|---|---|---|---|---|
| YOLOE-26n | 24.7 / 21.9 | 20.5 / 17.6 | 24.1 / 22.3 | 26.1 / 22.4 | 3.9 / 3.1 | 6.1 |
| YOLOE-26s | 30.8 / 28.6 | 23.9 / 25.1 | 29.6 / 27.8 | 33.0 / 29.9 | 10.7 / 11.0 | 21.9 |
| YOLOE-26m | 35.4 / 33.9 | 31.1 / 33.4 | 34.7 / 34.0 | 36.9 / 33.8 | 21.3 / 25.1 | 70.6 |
| YOLOE-26l | 37.8 / 36.3 | 35.1 / 37.6 | 37.6 / 36.2 | 38.5 / 36.1 | 25.5 / 29.3 | 89.0 |
| YOLOE-26x | 40.6 / 38.5 | 37.4 / 35.3 | 40.9 / 38.8 | 41.0 / 38.8 | 55.2 / 65.2 | 197.7 |
| YOLOE-11s | 27.5 / 26.3 | 21.4 / 22.5 | 26.8 / 27.1 | 29.3 / 26.4 | 10.7 / 10.9 | 22.7 |
| YOLOE-11m | 33.0 / 31.4 | 26.9 / 27.1 | 32.5 / 31.9 | 34.5 / 31.7 | 21.0 / 24.8 | 70.4 |
| YOLOE-11l | 35.2 / 33.7 | 29.1 / 28.1 | 35.0 / 34.6 | 36.5 / 33.8 | 26.0 / 29.8 | 89.5 |
| YOLOE-v8s | 27.9 / 26.2 | 22.3 / 21.3 | 27.8 / 27.7 | 29.0 / 25.7 | 12.3 / 12.6 | 29.8 |
| YOLOE-v8m | 32.6 / 31.0 | 26.9 / 27.0 | 31.9 / 31.7 | 34.4 / 31.1 | 26.4 / 28.4 | 80.7 |
| YOLOE-v8l | 35.9 / 34.2 | 33.2 / 33.2 | 34.8 / 34.6 | 37.3 / 34.1 | 43.5 / 47.3 | 167.6 |
İstemsiz#
İstemsiz kontrol noktaları, herhangi bir istem sağlanmadan yerleşik söz varlıklarından yanıt verir. Her doğruluk hücresi uçtan uca / Non-E2E biçimindedir; makale YOLOE-26'yı bu iki protokole göre puanlar. YOLO26 sayfasında Non-E2E sütunu alıntılanır.
| Model | mAP50-95 | mAPr | mAPc | mAPf | parametre (M) | FLOPs (B) |
|---|---|---|---|---|---|---|
| YOLOE-26n-pf | 16.6 / 17.7 | 15.7 / 15.8 | 15.3 / 16.4 | 17.9 / 19.2 | 2.3 | 5.3 |
| YOLOE-26s-pf | 21.4 / 22.6 | 16.2 / 20.2 | 20.1 / 20.9 | 23.5 / 24.5 | 9.0 | 20.8 |
| YOLOE-26m-pf | 25.7 / 26.4 | 26.7 / 24.5 | 24.0 / 25.0 | 26.9 / 27.9 | 19.4 | 68.4 |
| YOLOE-26l-pf | 27.2 / 28.0 | 26.3 / 25.7 | 25.7 / 26.8 | 28.7 / 29.5 | 23.6 | 86.8 |
| YOLOE-26x-pf | 29.9 / 31.1 | 27.5 / 28.9 | 29.1 / 30.7 | 31.1 / 31.7 | 53.1 | 194.4 |
Metin ve görsel istemlerde YOLOE-26 modelleri, mAP50-95 metriğinde eşleşen her ölçekte YOLOE-11 ve YOLOE-v8 karşılıklarından daha iyi sonuç verirken parametre ve FLOP sayıları v8 serisinin altında kalır. Makale aynı veri bölünmesinde YOLO-Worldv2 için S ölçeğinde 24.4, M ölçeğinde 32.4 ve L ölçeğinde 35.5; Transformer tabanlı algılayıcılar GLIP-T için 26.0, GDINO-T için 27.4 ve DetCLIP-T için 34.4 sonuçlarını bildiriyor; bu modellerin her biri 155 ila 232 M parametre içeriyor. Orijinal YOLOE makalesi, tanıttığı v8 ölçeğindeki modeller için iki sonuç daha sunuyor. LVIS'te YOLOE-v8s, YOLO-Worldv2-S'yi eğitim maliyetinin üçte biriyle ve 1.4× çıkarım hızıyla 3.5 AP farkla geçiyor. COCO'ya aktarıldığında YOLOE-v8l, kapalı küme YOLOv8-L modeline kıyasla 0.6 box AP ve 0.4 mask AP artışı sağlıyor ve eğitim süresi neredeyse 4× daha kısa oluyor.
YOLO26 makalesi bir algılama yapılandırmasını değerlendiriyor. Yayımlanan ağırlıklar segmentasyon kontrol noktalarıdır ve üstüne bir maske dalı, SAVPE ve metin projeksiyonu eklenmiştir; bu nedenle yüklenen bir yoloe-26l-seg.pt 25.5 M ve 89.0 B yerine 35.4 M ve 142.0 B bildirir. Her iki durumda da FLOP değeri bölge-metin benzerliğini dışarıda bırakır; bu yüzden sütundaki değer değişmese de gerçek maliyet istem kümesinin boyutuna göre artar. Sınırlamalar bölümüne bak.
Kullanım Örnekleri#
Aşağıdaki YOLOE örneklerinin tümü Python API üzerinden çalışır. Metin istemiyle tahmin, doğrulama, dışa aktarma, izleme ve standart eğitim CLI üzerinden de yapılabilir; ince ayar tariflerinde bir eğitici sınıfı, görsel istem tariflerinde ise yalnızca Python API'nin kabul ettiği NumPy istem dizileri kullanılır.
Eğitim Kullanımı#
Yayımlanmış herhangi bir *-seg.pt kontrol noktasını kendi YOLO veri kümenle ince ayarla. Bu işlem büyük ölçüde standart YOLO eğitim prosedürünü izler; fark, hangi eğiticiyi aktardığındır. YOLOEPESegTrainer, sınıf adlarını başlığa birleştirir ve buradan ince ayar yapar; kendi etiketlerin için istediğin yöntem budur. Varsayılan eğitici, sınıf adlarınla eğitim yapmaz. Ortaya çıkan kontrol noktası, veri kümenin sınıflarını doğrudan tahmin eder: başlığı artık istemleri okumaz. Bu nedenle sınıflar değişirse set_classes() hata verir; görsel istemler de aynı şekilde hata verir. Diğer sınıflar için özgün kontrol noktasını kullanarak istem ver.
İzle: YOLOE'yi Araç Parçaları Segmentasyonu Veri Kümesinde Eğitme | Açık Kelime Dağarcıklı Model, Tahmin ve Dışa Aktarma
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOEPESegTrainer

model = YOLOE("yoloe-26s-seg.pt")

results = model.train(
    data="coco128-seg.yaml",
    epochs=80,
    patience=10,
    trainer=YOLOEPESegTrainer,  # <- Önemli: varsayılan eğitici değil, ince ayar eğiticisi
)Yayımlanan her kontrol noktası bir segmentasyon modelidir. Bir algılayıcı eğitmek için modeli eşleşen YAML'den oluştur, aynı ölçekteki segmentasyon ağırlıklarını yükle ve algılama eğiticisini kullan. Diğer her şey aynı kalır.
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOEPETrainer

model = YOLOE("yoloe-26s.yaml").load("yoloe-26s-seg.pt")

results = model.train(data="coco128.yaml", epochs=80, patience=10, trainer=YOLOEPETrainer)
Tahmin Kullanımı#
Metin istemiyle yapılan çağrı, Hızlı Başlangıç bölümünde gösterilendir. Görsel isteme visual_prompts bağımsız değişkeni eklenir; istem içermeyen tahmin ise bunun yerine -pf kontrol noktasını yükler:
Görsel istemler, modeli bir şeyi tarif etmek yerine ona örneğini gösterir. visual_prompts, örnek kutulardan oluşan bir bboxes dizisi ve her kutu için bir sınıf kimliği içeren cls dizisi alır. Kimlikler etiket değil, geçici gruplamalardır; 0'dan başlayarak sıralı olmalıdır ve sonuçlar seçtiğin adlarla değil, object0, object1, … biçiminde döner.
Örnek kutular, tahmin yaptığın görüntünün üzerinde olabilir:
import numpy as np

from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")

# Her hedef için bir örnek kutu; her kutunun kendi sınıf kimliği var
visual_prompts = {
    "bboxes": np.array([[221.52, 405.8, 344.98, 857.54], [120, 425, 160, 445]]),  # kişi, gözlük
    "cls": np.array([0, 1]),
}

results = model.predict(
    "ultralytics/assets/bus.jpg",
    visual_prompts=visual_prompts,
)
results[0].show()
Ya da refer_image olarak geçirilen ayrı bir referans görüntüde olabilir. Bu durumda bboxes ve cls, hedefteki değil referanstaki nesneleri tanımlar:
import numpy as np

from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")

visual_prompts = {"bboxes": np.array([[221.52, 405.8, 344.98, 857.54]]), "cls": np.array([0])}  # person

results = model.predict(
    "ultralytics/assets/zidane.jpg",  # Hedef görüntü
    refer_image="ultralytics/assets/bus.jpg",  # Örnek kutuların bulunduğu yer
    visual_prompts=visual_prompts,
)
results[0].show()

# refer_image sınıfları kalıcı olarak da ayarlar; böylece sonraki çağrılarda hiç istem gerekmez
results = model("ultralytics/assets/bus.jpg")
model.export(format="onnx") # Dışa aktarma da sınıfları korursource bir video veya akış olduğunda ilk kare otomatik olarak refer_image olur; böylece ilettiğin istemler o kareye uygulanır ve videonun geri kalanında da kullanılır. Farklı bir kare seçmek için refer_image değerini açıkça ilet.
Hem source hem de refer_image, torch tensörlerini doğrudan kabul eder; bu, görüntüler zaten mevcut bir işlem hattından geliyorsa kullanışlıdır. Kutuları tensörün kendi piksel koordinatlarında ver:
import numpy as np
import torch

from ultralytics import YOLOE

model = YOLOE("yoloe-11l-seg.pt")

img_tensor = torch.rand(1, 3, 480, 480)  # (1, 3, H, W) [0, 1] aralığında float tensörü
visual_prompts = {"bboxes": np.array([[10, 10, 50, 50]]), "cls": np.array([0])}

results = model.predict(
    img_tensor,
    refer_image=img_tensor,
    visual_prompts=visual_prompts,
    imgsz=640,
)
Aynı anda birkaç görüntü üzerinde tahmin yapmak için istemleri bir seviye daha iç içe yerleştir: kaynaklarla aynı sırada olmak üzere her kaynak görüntü için bir bboxes dizisi ve bir cls dizisi kullan.
import numpy as np

from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")

visual_prompts = {
    "bboxes": [
        np.array([[221.52, 405.8, 344.98, 857.54], [120, 425, 160, 445]]),  # bus.jpg: kişi, gözlük
        np.array([[150, 200, 1150, 700]]),  # zidane.jpg: kişi
    ],
    "cls": [np.array([0, 1]), np.array([0])],
}

results = model.predict(
    ["ultralytics/assets/bus.jpg", "ultralytics/assets/zidane.jpg"],
    visual_prompts=visual_prompts,
)
results[0].show()
Doğrulama Kullanımı#
Doğrulama, segmentasyon veri kümesindeki diğer modellerde olduğu gibi çalışır:
from ultralytics import YOLOE

model = YOLOE("yoloe-26l-seg.pt")  # veya diğer boyutlar için yoloe-26s/m-seg.pt

metrics = model.val(data="coco128-seg.yaml")
data bir NDJSON dosyası veya Platform ul:// veri kümesi URI'si de olabilir; metin veya görsel istemler oluşturulmadan önce YOLO biçimine dönüştürülür.
Aynı çağrının iki çeşidi diğer istemleme modlarını kapsar:
- Görsel istemler —
model.val(data="coco128-seg.yaml", load_vp=True), veri kümesinin kendisinden her kategori için bir görsel gömme çıkarır. Gömme vektörlerini, tam olarak aynı kategorileri içermesi gereken farklı bir veri kümesinden almak içinrefer_data="coco.yaml"ekle. - İstemsiz — bir
*-seg-pf.ptkontrol noktası yükle vesingle_cls=Truedeğerini ilet.
Dışa Aktarma Kullanımı#
İstem gömmeleri bir kez kaydedilip ONNX, OpenVINO, TensorRT, CoreML, LiteRT ve RKNN gibi statik dışa aktarımlar oluşturulurken yeniden kullanılabilir. NPZ profili, dışa aktarmadan önce özgün PyTorch modeli tarafından yüklenir; ek bir çalışma zamanı girdisi değildir ve dışa aktarılan model NPZ dosyasını gerektirmez.
set_classes() ile (veya görsel istemler için refer_image üzerinden) yapılandırılan sınıflar dışa aktarılan ağırlıklara işlenir. Dışa aktarıldıktan sonra model yeni istemleri artık kabul edemez: yüklü bir dışa aktarım üzerinde set_classes() çağrısı yapmak veya predict() işlevine visual_prompts=... geçirmek başarısız olur. Algılanan sınıfları değiştirmek için yeni istemler yapılandırılmış halde özgün .pt kontrol noktasından yeniden dışa aktar. Dışa aktarılan dosya standart bir YOLO modeli gibi davranır ve YOLOE() yerine YOLO() ile de yüklenebilir.
from ultralytics import YOLOE

model = YOLOE("yoloe-26n-seg.pt")
model.set_classes(["person", "bus"])
model.save_prompt_embeddings("person-bus.npz")

# Profil kaynak kontrol noktasına bağlıdır ve sonraki dışa aktarımlarda yeniden kullanılabilir.
model = YOLOE("yoloe-26n-seg.pt")
model.load_prompt_embeddings("person-bus.npz")
model.export(format="onnx")
Aynı istem profili, eşleşen YOLOE mimarisinden oluşturulmuş yalnızca algılama yapan bir modeli de yapılandırabilir. Böylece istem verilen sınıflar korunurken maske dalı kaldırılır:
from ultralytics import YOLOE

model = YOLOE("yoloe-26n.yaml").load("yoloe-26n-seg.pt")
model.load_prompt_embeddings("person-bus.npz")
model.export(format="rknn", name="rk3588", quantize=16)
Takip Kullanımı#
İstem verilen sınıflar doğrudan izlemeye aktarılır; böylece izleyicinin eğitim sırasında hiç görmediği nesneleri takip edebilirsin:
from ultralytics import YOLOE

model = YOLOE("yoloe-26s-seg.pt")
model.set_classes(["forklift", "pallet"])

# persist=True kareler arasında izleme kimliklerini sabit tutar
for result in model.track("path/to/video.mp4", stream=True, persist=True):
    print(result.boxes.id)
YOLOE Karşılaştırması#
YOLOE, kapalı küme bir algılayıcıyla ağır, açık sözcük dağarcıklı bir model arasında yer alır. Senin için doğru seçim olup olmadığına üç karşılaştırma karar verir:
- Kapalı küme bir YOLO'ya kıyasla. İstemler ayarlandıktan sonra YOLOE, sıradan algılama/segmentasyon yolundan tahmin yapar ve diğer modeller gibi dışa aktarılır. Eklediği özellik, yeniden eğitim yerine çıkarım sırasında sınıf listesini değiştirebilmendir; bunun bedeli ise kendi sınıfların üzerinde eğitilmiş bir modelden çok daha düşük sıfır örnekli doğruluktur.
- Önceki YOLOE ailelerine kıyasla. YOLOE-26, YOLO26 modelinin NMS içermeyen uçtan uca başlığını devralır ve önceki üç ölçeğe (s/m/l) karşılık beş ölçeği (n/s/m/l/x) kapsar; ayrıca Performans bölümünde eşleşen her ölçekte daha iyi sonuç verir.
- Transformer tabanlı açık sözcük dağarcıklı algılayıcılara kıyasla. GLIP ve OWL-ViT çıkarım sırasında görsel-dil Transformer'ı çalıştırır. YOLOE ise istemleri bir kez kodlar ve ardından evrişimli bir başlığın içindeki bölge özellikleriyle karşılaştırır.
En yakın alternatiflerin tümü metin istemi alır; ancak maske döndürenler yalnızca YOLOE ve SAM 3'tür ve bu üç model farklı soruları yanıtlar:
| YOLOE | SAM 3 | YOLO-World | |
|---|---|---|---|
| Kullanım amacı | Adlandırılmış sınıfların gerçek zamanlı algılanması ve segmentasyonu | Kavram segmentasyonu ve istemlenebilir izleme | Gerçek zamanlı, açık sözcük dağarcıklı algılama |
| Maskeler | Evet, *-seg.pt kontrol noktalarıyla | Evet | Hayır, yalnızca kutular |
| Görsel istemler | Evet (SAVPE) | Evet | Hayır |
| İstemsiz mod | Evet, 4.585 adlı sözcük dağarcığı | Hayır | Hayır |
| Şu durumda seç | Yüksek verime ihtiyacın varsa ve sınıfları adlandırabiliyorsan | En güçlü kavram segmentasyonuna ihtiyacın varsa ve hesaplama maliyetini karşılayabiliyorsan | Zaten kullanıyorsan — aşağıdaki geçiş notuna bak |
YOLO-World'den mi geçiyorsun? API'nin yapısı aynı: YOLOWorld yerine YOLOE kullan, bir *-seg.pt kontrol noktası yükle ve set_classes() çağrını değiştirme. Maske ve görsel istemler kazanırsın; sabitlenmiş sınıflarla ilgili dışa aktarma notu her ikisi için de geçerlidir.
Kullanım Alanları ve Uygulamalar#
Açık sözcük dağarcıklı algılama, her sınıf için yeniden eğitim adımını ortadan kaldırır; bu, özellikle hedef listesinin önceden bilinmediği durumlarda önemlidir:
- Açık dünya algılama — eğitim sırasında kimsenin listelemediği nesnelerle karşılaşan robotik ve güvenlik sistemleri.
- Örnekten tek atışlı algılama — görsel istemler, tek bir referans kutusundan belirli bir parçayı, logoyu veya kusuru bulur; bu özellik endüstriyel denetimde kullanışlıdır.
- Uzun kuyruklu kataloglama — yerleşik 4.585 adlı sözcük dağarcığı, biyoçeşitlilik izleme veya perakende envanter taramaları için yeterince kapsamlıdır.
- Veri kümesini başlatma — görüntüleri insan incelemesinden önce kutular ve maskelerle önceden etiketle, ardından sonuç üzerinde hızlı bir kapalı küme modeli eğit.
- İstenen herhangi bir hedefi segmentasyon — yayımlanan
*-seg.ptkontrol noktaları her tahminle birlikte maske döndürür; böylece tıbbi görüntüleme ve uydu analizi, ikinci bir modele gerek kalmadan piksel hassasiyetinde çıktı alır.
Yaygın bir yöntem iki modu birleştirir: önce mevcut olanları keşfetmek için bir kez istemsiz modu çalıştır, ardından önemli kategoriler için metin istemlerine geç.
Sınırlamalar#
YOLOE, çıkarım sırasında sınıfları değiştirebilme karşılığında doğruluktan ödün verir. Karar vermeden önce bilmen gereken sonuçlar şunlardır:
- Sıfır örnekli doğruluk, kendi sınıfların üzerinde eğitilmiş bir modelden çok daha düşüktür. İstem verilen kontrol noktaları LVIS minival'de yaklaşık 22-40 mAP aralığında sonuç verir; kendi verilerinde eğitilmiş kapalı küme bir YOLO bu sınıflarda daha iyi sonuç alır. Eğitemediğin sınıfları kapsamak için YOLOE'yi kullan, eğitimin yerine değil.
- Nadir kategoriler zayıf noktadır. Performans bölümündeki mAPr sütunu, özellikle LVIS'in nadir sınıflarındaki doğruluğu bildirir; metin istemlerinde her satırda yaygın ve sık görülen sınıflara ait sütunların altında kalır. Hedeflerin alışılmadıksa, manşet mAP yerine bu değeri kontrol et.
- İstem, ilişkileri değil görünüşü tarif eder. Algılama, bölge özelliklerinin istem gömmesiyle karşılaştırılmasıyla çalışır; bu nedenle duruma, bağlama veya kıyaslamaya bağlı olan “hasarlı”, “en soldaki” ya da “taşınan nesne” gibi istemlerin eşleştirilecek güvenilir bir dayanağı yoktur. Günlük kategori adlarına yakın ifadeleri tercih et.
- Büyük istem kümeleri gecikmeyi artırır. İstem gömmeleri bir kez hesaplanır, ancak her ileri geçişte bölge özellikleriyle karşılaştırılır. CPU üzerinde
yoloe-26s-seg.ptile ölçüldüğünde, 80 sınıftan 1,203 sınıfa geçişte ileri geçiş süresi yaklaşık %19, 4,585 adlı tam sözcük dağarcığında ise yaklaşık %89 artar. Bölge-metin benzerliği hesaba katılmadığı için bildirilen FLOP değeri hiç değişmez; bu nedenle profil bu konuda seni uyarmaz. - İstem verene kadar sınıf adları yer tutucudur. Yeni yüklenmiş bir
*-seg.ptkontrol noktası, sayısal adlara sahipnc=80değerini ("0","1", …) bildirir; bu yüzden etiketleri okumadan önceset_classes()çağrısını yap. İstemsiz kontrol noktalarında sözcük dağarcığının tamamı önceden doldurulmuştur.
Dağıtım Notları#
- Donanım. Çıkarım için 4-8 GB VRAM'e sahip bir NVIDIA GPU gerekir;
nvesölçekleri Jetson gibi uç GPU'larda veya daha düşük çözünürlükte CPU üzerinde çalışır. İnce ayar için tek bir GPU gerekir. - NMS varsayılan olarak sınıftan bağımsızdır. YOLOE,
agnostic_nms=Trueile tahmin yapar. Varsayılan olarak bu yöntem, yalnızca aynı sınıftaki kutuları değil, farklı sınıflar arasında üst üste binen düşük puanlı kutuları da bastırır; böylece bir nesne birkaç kategoriyle eşleştiğinde yinelenen sonuçlar önlenir.nms=Falseile YOLOE-26 IoU bastırması uygulamaz; sınıftan bağımsız mod, tek bir bağlantının birden fazla sınıf etiketi üretmesine izin vermek yerine her bağlantı için yalnızca en iyi sınıfı tutar. Bu davranışı geçersiz kılmak içinagnostic_nms=Falsedeğerini ilet. - Görsel istemler varsayılan olarak
conf=0.05değerini kullanır. Görsel istem kutuları, puanlarının düşündürdüğünden daha sık doğru sonuç verir: LVIS minival'de, istem olarak bir sınıfın tek bir örneği kullanıldığındaconf=0.25, YOLOE-26'nınconf=0.05değerinde bulduğu diğer örneklerin %44 ila %55'ini kaçırır. Perakende rafları veya hücreler gibi birbirine çok benzeyen nesnelerin bulunduğu yoğun sahnelerde daha düşük değerler gerekebilir;nms=Falseile YOLOE-26'nın bire bir başlığı daha da düşük puan alır ve en iyi eşik değeri0.01civarındadır. Daha sonraki çağrılar, kaydedilmiş gömmeler verefer_imageile ayarlanan sınıfları yeniden kullanan dışa aktarımlar dâhil, diğer tüm çağrılarconf=0.25değerini kullanır. Bu değeri değiştirmek içinconfdeğerini ilet. - Toplu işleme. Toplu çıkarım doğrudan çalışır ve aynı çağrıda her görüntü için farklı görsel istemler kullanabilirsin.
Resmî Modelleri Sıfırdan Eğitme#
Okuyucuların çoğunun buna ihtiyacı olmaz. Bu işlem, Objects365, GQA ve Flickr30k veri kümelerindeki yayımlanmış açık sözcük dağarcıklı kontrol noktalarını yeniden üretir — 8× RTX 4090 üzerinde yaklaşık 1.4 M eğitim örneği — ve yukarıdaki Eğitim Kullanımı bölümünde ele alınan kendi verilerinle ince ayar yapmayla ilgili değildir.
YOLOETrainer sınıfından miras alan her eğitici, varsayılan YOLOESegTrainer ve aşağıdaki tüm sıfırdan eğitim eğiticileri dâhil, compile=True değerini reddeder. compile=False değerini ilet (varsayılan). Yukarıda kullanılan iki ince ayar eğiticisi YOLOEPESegTrainer ve YOLOEPETrainer bu kısıtlamaya tabi değildir.
Eğitim için segment açıklamaları gerekir. Aşağıdaki işlenmiş dosyaları indirebilir veya resmî ekibin sağladığı betiği kullanarak kendi açıklamalarını oluşturabilirsin; bu betik SAM 2.1 kullanır. Doğrulamada LVIS minival kullanılır.
| Veri kümesi | Tür | Örnekler | Kutular | İşlenmiş segment açıklamaları |
|---|---|---|---|---|
| Objects365v1 | Algılama | 609k | 9621k | objects365_train_segm.json |
| GQA | Grounding | 621k | 3681k | final_mixed_train_no_coco_segm.json |
| Flickr30k | Grounding | 149k | 641k | final_flickr_separateGT_train_segm.json |
Önce metin istemli model eğitilir; diğer iki istemleme modu bu modelin iyileştirilmiş sürümleridir:
from ultralytics import YOLOE
from ultralytics.models.yolo.yoloe import YOLOESegTrainerFromScratch

data = {
    "train": {
        "yolo_data": ["Objects365.yaml"],
        "grounding_data": [
            {
                "img_path": "flickr/full_images/",
                "json_file": "flickr/annotations/final_flickr_separateGT_train_segm.json",
            },
            {
                "img_path": "mixed_grounding/gqa/images",
                "json_file": "mixed_grounding/annotations/final_mixed_train_no_coco_segm.json",
            },
        ],
    },
    "val": {"yolo_data": ["lvis.yaml"]},
}

model = YOLOE("yoloe-26l-seg.yaml")
model.train(
    data=data,  # veya aynı yapıyı içeren bir YAML dosyasının yolu
    batch=128,
    epochs=30,
    close_mosaic=2,
    optimizer="AdamW",
    lr0=2e-3,
    warmup_bias_lr=0.0,
    weight_decay=0.025,
    momentum=0.9,
    workers=4,
    trainer=YOLOESegTrainerFromScratch,
    device="0,1,2,3,4,5,6,7",
)
Görsel istemli ve istemsiz kontrol noktaları, eğitilmiş metin istemli modelden başlar ve her biri bir modülü günceller. YOLOESegVPTrainer, görsel istem tarifidir; YOLOEPEFreeTrainer ise istemsiz tarifidir, ancak bu sınıflardan hiçbiri tek başına herhangi bir şeyi dondurmaz: seçici eğitim, yanında ilettiğin ve savpe dışındaki her başlık alt modülünü (sırasıyla her sınıflandırma kulesini) belirten freeze listesinden gelir; istemsiz çalıştırma ayrıca single_cls=True gerektirir. YOLOE'nin üst kaynak deposu, v8 ölçeğindeki modeller için tariflerin tamamını içerir.
Tamamlanmış istemsiz çalıştırma, çıkarım sırasında adlarını istem olmadan bildiren bir kontrol noktasına yeniden parametrelendirilir; bunun için get_vocab ve set_vocab kullanılır:
from ultralytics import YOLOE

# İstemsiz çalıştırmanın ve onun başlangıç noktası olan metin istemli çalıştırmanın yazdığı ağırlıklar. Her
# yeniden çalıştırma yeni bir dizin oluşturur (train-2, train-3, ...); bu nedenle çalıştırmaların yazdırdığı yolları kullan.
model = YOLOE("runs/segment/train-2/weights/best.pt")  # istemsiz çalıştırma; başlığı zaten birleştirilmiş durumda
text_model = YOLOE("runs/segment/train/weights/best.pt")  # metin istemli çalıştırma; başlığı henüz birleştirilmemiş durumda

names = list(YOLOE("yoloe-26l-seg-pf.pt").model.names.values())  # 4.585 adlık söz varlığı veya kendi listen
vocab = text_model.get_vocab(names)

model.set_vocab(vocab, names)
model.save("yoloe-26l-seg-pf-custom.pt") # yayımlanan kontrol noktasının üzerine asla yazmaget_vocab, modelin end2end bayrağının seçtiği dalı döndürür; set_vocab ise bu dalı yeniden parametrelendirir. Yayımlanan YOLOE-26 dosyalarında bunun yerine her dal için ayrı bir söz varlığı bulunur; böylece nms bu dallar arasında seçim yapabilir. Bunu yeniden üretmek için metin istemli modelin başka bir kopyasından ikinci söz varlığını al. YOLOE-11 ve YOLOE-v8 tek bir dala sahip olduğundan yukarıdaki çağrıyı değiştirmeden kullanırlar.
one2one_model = YOLOE("runs/segment/train/weights/best.pt")  # get_vocab okuduğu başlığı birleştirir; bu nedenle ikinci bir kopya yükle
one2one_model.model.end2end = True  # NMS içermeyen dalı oku

model.set_vocab(vocab, names, one2one_vocab=one2one_model.get_vocab(names))
Atıflar ve Teşekkürler#
YOLOE araştırmana veya projenize katkıda bulunduysa lütfen Tsinghua Üniversitesi'nden Ao Wang, Lihao Liu, Hui Chen, Zijia Lin, Jungong Han ve Guiguang Ding'in özgün makalesine atıfta bulun:
@misc{wang2025yoloerealtimeseeing,
      title={YOLOE: Real-Time Seeing Anything},
      author={Ao Wang and Lihao Liu and Hui Chen and Zijia Lin and Jungong Han and Guiguang Ding},
      year={2025},
      eprint={2503.07465},
      archivePrefix={arXiv},
      primaryClass={cs.CV},
      url={https://arxiv.org/abs/2503.07465},
}
Daha fazla bilgi için özgün YOLOE makalesine arXiv üzerinden ulaşabilirsin. Projenin kaynak koduna ve ek kaynaklara GitHub deposundan erişebilirsin.
Sık Sorulan Sorular#
Ultralytics YOLOE, YOLO-World'de bulunmayan iki özellik sunar: sınıf adının yerine örnek bir kutunun kullanıldığı görsel istemler ve hiçbir istem olmadan yerleşik 4.585 adlık söz varlığından yanıt veren istemsiz kontrol noktaları. Yayımlanan
*-seg.ptkontrol noktalarından gelen her tahmin ayrıca bir örnek segmentasyonu maskesi taşır. Doğruluk açısından özgün YOLOE makalesi, YOLOE-v8s'nin LVIS üzerinde YOLO-Worldv2-S'den 3,5 AP daha yüksek sonuç verdiğini, eğitim maliyetinin üçte biriyle eğitildiğini ve çıkarım hızının 1,4 katı olduğunu bildiriyor. Geçiş tek satırlık bir değişiklik gerektirir — YOLOE Karşılaştırması bölümüne bak.Ultralytics YOLOE üç istem modunu destekler. Metin istemi,
*-seg.ptkontrol noktasında dizeler olarak verilen sınıf adlarıdır ve genellikle tercih edilen seçenektir. Görsel istem, sözcüklerle ifade etmesi zor hedefler için referans görüntüdeki bir veya daha fazla örnek kutudur. İstemsiz çıkarım, dışarıdan hiçbir şey verilmeden yerleşik 4.585 adlık söz varlığından yanıt veren ayrı bir*-seg-pf.ptkontrol noktasını kullanır. Metin ve görsel istemler aynı kontrol noktalarını paylaşır; istemsiz mod için farklı dosyalar kullanılır ve bu dosyalarset_classes()öğesini kabul etmez. Karşılaştırmanın tamamı için İstem Modu Seçimi bölümüne bak.yoloe-26s-seg.ptile başla: YOLOE-26 ailesi her eşleşen ölçekte YOLOE-11 ve YOLOE-v8'in önünde yer alır;sölçeği ise LVIS minival üzerinde 30 mAP değerini aşan en küçük ölçektir. Nadir kategorilerde doğruluk gecikmeden daha önemliysem,lveyaxölçeğine geç — karşılaştırman gereken sütun Performans bölümündeki mAPr sütunudur.nölçeğine yalnızca uç dağıtımı için in. Kendi sınıf adların yerine yerleşik söz varlığını kullanmak istiyorsan aynı ölçeğin*-seg-pf.ptdosyasını yükle.object0veobject1gibi etiketler, tahminin görsel istemden geldiğini gösterir; bu durumda örnek kutular adlarını taşımak yerine geçici numaralı sınıflar altında gruplanır.visual_prompts["cls"]içinde verdiğin sınıf kimlikleri yalnızca bu gruplamayı yapar. Model bunları, atadığın kimliklerin sırasına göreobject0,object1ve devamı şeklinde bildirir; bu nedenle sonuçtaki kimlikleri kendi etiketlerinle eşleştir. Çıktıda kendi adlarının görünmesini istiyorsan bunun yerine metin istemi kullan.İstemsiz kontrol noktaları (
*-seg-pf.pt), sınıfları kendi yerleşik söz varlığı üzerinden belirler veset_classes()öğesiniAssertionError: Prompt-free model does not support setting classes. Please try with Text/Visual prompt models.ile reddeder. Görsel istemlerAssertionError: Visual prompts need an unfused YOLOE model.hatasına yol açar. Kendi sınıf listene ihtiyaç duyduğunda bir*-seg.ptkontrol noktası yükle. İstem Modunu Seçme bölümüne bak.İlk metin istemi, Ultralytics YOLOE'nin GitHub'dan ultralytics/CLIP yüklemesini ve
pipile geçerli çalışma dizinine bir TorchScript metin kodlayıcısı indirmesini sağlar — YOLOE-26 için yaklaşık 254 MB; her model ailesine ait tam varlık bilgisi için Kurulum ve Gereksinimler bölümüne bak. Görsel istemler ve istemsiz kontrol noktaları bunların hiçbirine ihtiyaç duymaz. Hedef makinede indirmeyi önlemek için istemleri bir kez ayarla vesave_prompt_embeddings()ile kaydet ya da modeli sınıflar önceden yapılandırılmış şekilde dışa aktar.Hayır — YOLOE, istemle belirtilen sınıfları dışa aktarma sırasında ağırlıklara işler; bu nedenle yüklenen bir dışa aktarım hem
set_classes()hem devisual_prompts=öğesini reddeder. Yeni istemleri yapılandırarak özgün.ptkontrol noktasından yeniden dışa aktar. Dışa aktarılan dosya standart bir YOLO modeli gibi davranır veYOLO()ileYOLOE()kullanılarak yüklenebilir.Gerçek zamanlı aktarım hızına ihtiyacın varsa ve sınıfları adlandırabiliyorsan YOLOE'yi; bir kavram üzerindeki segmentasyon kalitesi hızdan daha önemliyse SAM 3 kullan. İkisi de görsel örnekleri kabul eder; istemsiz modu yalnızca YOLOE sunar. Karşılaştırmanın tamamı YOLOE Karşılaştırması bölümündedir.


Yorumlar60
Bir soru sor, sonuçlarını paylaş veya başka birine yardım et.
daiyangyang945
I converted YOLOE to ONNX, but it only supports single-image input. How can I implement visual prompts?
1cyt1990cyt1990-dev
你好,请问怎么利用yoloe的视觉提示(结合SAM)功能进行自动标注(auto_annotate)?
 Glenn JocherUltralytics
你好,目前 YOLOE 的视觉提示能力是通过
model.predict(..., visual_prompts=..., refer_image=..., predictor=YOLOEVPSegPredictor)使用的,文档里还没有auto_annotate()直接接入这套流程的现成示例;另外yoloe-26*-seg.pt本身就会输出分割掩码,所以这类自动标注场景通常不需要再额外叠加 SAM,你可以先按 YOLOE 文档 和YOLOE.predict()参考 跑出提示式分割结果再保存为标签;如果你愿意,也欢迎把你的目标流程和样例数据贴在这个讨论里,方便团队一起看。
zhangxiancai
你好,请问yoloe如何使用多张图片里的视觉对象作为参考进行推理。因为一张图片不能全面反映要检测对象的特征,容易漏检。
 User
我也有想过建立一个供yoloe提取多角度多图片特征的小型数据库,但是发现效果并不好。官方通道似乎不支持多特征融合成一个标签。
q9card
Hello, I would like to ask about training YOLOE with a custom grounding dataset.
My current goal is to use YOLOE for open-vocabulary detection on remote-sensing small objects, and I am trying to integrate my own dataset, AI-TOD-v2, into the open-text / grounding training pipeline.
So far, I have completed the following steps:
- Converted AI-TOD-v2 from standard COCO detection annotations into a grounding-style JSON added caption for each image added tokens_positive for each instance
- Successfully ran generate_grounding_cache.py so the custom grounding JSON / cache generation itself seems to work
However, when I try to continue with the official open-text / from-scratch training pipeline, I run into many issues, for example:
(1)hard-coded checks in GroundingDataset.verify_labels() for official dataset names / instance counts (2)mismatch between yolo_data and grounding_data text slot / tensor shapes (3)later shape mismatch again in training loss / bbox decode
So I would like to ask:
Has anyone successfully trained YOLOE open-text / text-prompt models with a custom grounding dataset (not only the official Flickr/GQA/Objects365 data)? If yes, is there any recommended dataset organization or minimal working setup? Does the official pipeline currently support mixing custom grounding data with official grounding datasets such as Flickr/GQA? For a case like mine, would you recommend: continuing to adapt the current from-scratch training pipeline, or switching to another route based on official pretrained weights? If possible, could you share a minimal working example for training with a custom grounding dataset, even a very small toy example?
My current impression is that the main difficulty may not be the grounding JSON / cache generation itself, but rather that the current training code has strong assumptions about the official data pipeline. If there is any official recommendation or similar community experience, I would really appreciate it.
Thank you very much!
- Glenn JocherUltralytics
Thanks for the detailed report — the current public YOLOE from-scratch open-text pipeline is mainly validated around the official
Objects365/Flickr/GQArecipe shown in the YOLOE training docs, so a fully custom grounding dataset is not yet a documented plug-and-play path; for AI-TOD-v2, the safer route is usually to start from pretrainedyoloe-26*-seg.ptweights and the supported fine-tuning flow in the YOLOE usage docs rather than continuing from scratch. Please open a new issue with a minimal reproducible example, full traceback,yolo checks, and a tiny sample of the grounding JSON/cache so the team can check the dataset verification and shape assumptions directly. 我按照你说的用yoloe-s26-seg.pt进行微调,出现AttributeError: Can't get attribute 'YOLOESegment26' on <module 'ultralytics.nn.modules.head' from '/mnt/workspace/projects/yoloe/ultralytics/nn/modules/head.py'>错误,改用最新版 pip 安装的 Ultralytics 再试仍然存在这个问题。 目前我的yolo check输出如下: OS Linux-5.10.134-18.0.9.lifsea8.x86_64-x86_64-with-glibc2.35 Environment Linux Python 3.10.19 Install pip Path /root/miniconda3/envs/yoloe/lib/python3.10/site-packages/ultralytics RAM 31.34 GB Disk 94.8/97.9 GB CPU Intel Xeon Platinum 8163 CPU @ 2.50GHz CPU count 8 GPU Tesla V100-SXM2-16GB, 16144MiB GPU count 1 CUDA 12.8
numpy ✅ 2.2.6>=1.23.0 matplotlib ✅ 3.10.8>=3.3.0 opencv-python ✅ 4.13.0.92>=4.6.0 pillow ✅ 12.1.1>=7.1.2 pyyaml ✅ 6.0.3>=5.3.1 requests ✅ 2.32.5>=2.23.0 scipy ✅ 1.15.3>=1.4.1 torch ✅ 2.10.0>=1.8.0 torch ✅ 2.10.0!=2.4.0,>=1.8.0; sys_platform == "win32" torchvision ✅ 0.25.0>=0.9.0 psutil ✅ 7.2.2>=5.8.0 polars ✅ 1.39.3>=0.20.0 ultralytics-thop ✅ 2.0.18>=2.0.18
- Glenn JocherUltralytics
这个报错基本就是“权重版本和实际导入的代码版本不一致”:
yolo checks显示你用的是site-packages,但异常却来自/mnt/workspace/projects/yoloe/ultralytics/...,说明本地仓库覆盖了 pip 安装;而YOLOESegment26在当前head.py文档里是存在的,所以请先移除或重命名该本地ultralytics目录并重启 Python/Notebook 会话,确认ultralytics.__file__指向同一环境后再试;如果还报错,请贴完整 traceback 和精确训练命令。
- User
视觉提示只能支持一种类型吗,当我使用视觉提示进行检测之后,再次设置新的类别就会出现shape '[1, 66, -1]' is invalid for input of size 416000
- Glenn JocherUltralytics
视觉提示不只支持一种类别,
visual_prompts里可以给多组bboxes/cls(要求cls从0..N-1连续且与框数量一致),细节见中文 YOLOE 文档;你这个shape '[1, 66, -1]' is invalid...通常是跑过视觉提示(尤其用过refer_image)后又set_classes()切新类别导致旧的 prompt/embedding 状态残留,建议直接重新初始化一个新YOLOE(...)实例(Notebook 里也请重启 kernel)再设置新类别/新视觉提示。若仍复现,请把最小可复现代码、完整 traceback(文本)以及yolo checks输出贴在这里我们才能定位。 - User
好的,问题可以解决。不过衍生出相机模式下,反复创建销毁yoloe()实例,同时相机推理的帧率也很低。我会继续进行优化
- User
感谢,已经将初始化逻辑改成文本/视觉提示发送改变时触发,同时开启GPU加速,问题基本解决,再次感谢答疑
- Glenn JocherUltralytics
很好,感谢你回报进展;相机/视频场景下建议始终复用同一个
YOLOE实例,只在提示词变化时才更新set_classes()或visual_prompts,且注意传了visual_prompts时视频/流会自动用第一帧作为refer_image(详见 中文 YOLOE 文档),这样能避免反复构建带来的卡顿并提升 FPS。from ultralytics import YOLOE model = YOLOE("yoloe-26s-seg.pt") # 可按需求换更小尺度提升速度 # 仅在提示变化时调用:model.set_classes(...) 或传 visual_prompts for r in model.predict(source=0, stream=True, device=0, half=True, imgsz=640): pass # 在这里处理 r(不要每帧重新初始化模型) - User
在使用yoloe-26模型时出现模型加载错误Can't get attribute 'YOLOESegment26' on <module 'ultralytics.nn.modules.head' from 'd:\YOLO E\yoloe-main\ultralytics\nn\modules\head.py' YOLOE的库有进行开源更新吗
- Glenn JocherUltralytics
这个报错基本就是“权重文件里引用的模块/类名”和你当前导入的本地
ultralytics代码不一致导致的;从路径看你现在加载的是d:\YOLO E\yoloe-main\ultralytics\...这份源码,它不包含权重所需的YOLOESegment26,建议先排除本地目录把包“遮住”了的情况,改用最新版pip安装的 Ultralytics 再试(用法见中文 YOLOE 文档)。pip uninstall -y ultralytics pip install -U ultralytics yolo checks如果仍复现,请把“完整 traceback(文本)”、你是如何加载模型的最小代码(例如
YOLOE("yoloe-26s-seg.pt")/YOLO("yoloe-26s-seg.pt"))、以及上面yolo checks的输出贴出来;如果你刚升级过包且在 Notebook 里运行,也请先重启 kernel 再测。
qbig
Hello,
Can I ask why the exported Core ML model doesn't have labels metadata like normal YOLO or even exported YOLO-World models?
from ultralytics import YOLOE, YOLO from pathlib import Path from ultralytics.utils import YAML model_name = "yoloe-11m-seg.pt" file_name = "lvis.yaml" model = YOLOE(model_name) model.eval() # Please replace names with yours data = YAML.load(file_name) names = [n.split('/')[0] for n in data["names"].values()] model.set_classes(names, model.get_text_pe(names)) coreml_path = model.export(format='coreml', half=True, nms=False)- Glenn JocherUltralytics
That’s expected right now: YOLOE’s classes are prompt-defined (and can be changed via
set_classes()), so the CoreML exporter doesn’t reliably embed a fixed label list in the model metadata—especially when exporting “raw” outputs withnms=False; if you need labels inside the.mlmodel/.mlpackage, either export withnms=Trueor post-edit the CoreML package metadata after export (see the YOLOE export notes and theYOLOEAPI).
gstrat88
Is there any example to use it as a zero-shot logo detection?
tomer196
Hi, Is there a way to get the embeddings of each detection when I use model.predict? Similar to the way I can get the embeddings of the visual and text prompts.
ratom
I want to perform semantic segmentation with 6 classes (multi-class semantic segmentation task) using YOLOv8, YOLOv11, and YOLOe. My questions are is this possible with existing YOLO models? If yes, how can I create the data for YOLO format? I have the segmentation data with images in one folder and their respective masks in another format. @glenn-jocher
Hi @glenn-jocher, I want to perform semantic segmentation with 6 classes (multi-class semantic segmentation task) using YOLOv8, YOLOv11, and YOLOe. My questions are is this possible with existing YOLO models? If yes, how can I create the data for YOLO format? I have the segmentation data with images in one folder and their respective masks in another format.
- Glenn JocherUltralytics(düzenlendi)
@tomer196 Fine-tuning and open-vocabulary prompting are mutually exclusive in the current implementation: after fine-tuning with
YOLOEPESegTrainer, the checkpoint predicts your dataset’s classes directly andset_classes()raises an error, so keep the original checkpoint for prompting. Details are under Train Usage in the YOLOE docs; we can’t share timelines for other changes.@ram-from-tvl For production use you’ll need to choose between AGPL-3.0 compliance (open‑source your entire derivative) or an Enterprise License for proprietary deployment; see options and terms at the Ultralytics License page. For deployment hardening, benchmark and export to your target runtime (ONNX/TensorRT/CoreML/etc.) per the Export section in the YOLOE docs.
@ram-from-tvl To convert a UNet-style binary mask dataset to YOLO segmentation format, create one TXT per image with polygon coordinates per instance (normalized x,y). Format and examples are in the Segmentation task data format. Minimal conversion example for a single-class binary mask:
import cv2, numpy as np, os

def mask_to_yolo_segments(mask):
    h, w = mask.shape[:2]
    contours, _ = cv2.findContours(mask, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
    segs = []
    for c in contours:
        if len(c) < 3:
            continue
        pts = c.squeeze(1).astype(float)
        pts[:, 0] /= w
        pts[:, 1] /= h
        segs.append(pts.reshape(-1))
    return segs

mask = cv2.imread("mask.png", 0) > 0
segs = mask_to_yolo_segments(mask.astype(np.uint8))
os.makedirs("labels", exist_ok=True)
with open("labels/image.txt", "w") as f:
    for seg in segs:
        f.write("0 " + " ".join(f"{v:.6f}" for v in seg.tolist()) + "\n")
@Swetha4545 YOLOE isn’t limited to 80 classes—text prompts are open‑vocab, and the prompt‑free variants use a large vocabulary; for harder concepts like “cotton” try synonyms (e.g., “cotton plant”, “cotton bale”, “fabric”) or switch to visual prompts with a clear reference exemplar; see Text/Visual/Prompt‑free usage in the YOLOE docs and the predictor API for visual prompts: YOLOEVPSegPredictor.
@ratom For per-pixel class maps (semantic segmentation), YOLO26 provides dedicated
-semmodels such asyolo26n-sem.pt(task=semantic); see the Semantic Segmentation docs. YOLOv8/YOLO11/YOLOE are instance segmentation models: if you use them, convert your masks to per‑instance polygons and save in YOLO segmentation TXT format (one line per instance:cls x1 y1 x2 y2 ..., normalized); the expected structure and examples are in the Segmentation task data format.
beichen2012
May I ask how to replace the YOLO11 backbone with DINOV3 distilled? Thanks.
- Glenn JocherUltralytics(düzenlendi)
@daiyangyang945 ONNX runtime doesn’t support passing visual prompts at inference; bake them before export by running one PyTorch pass with
refer_image(which fixes classes), then export the fused model; this preserves the same classes in ONNX and you can still use dynamic batch input: see Visual Prompting and Export sections in the YOLOE docs for details. Example:from ultralytics import YOLOE from ultralytics.models.yolo.yoloe import YOLOEVPSegPredictor m = YOLOE("yoloe-11l-seg.pt") visual_prompts = {"bboxes": ..., "cls": ...} # your examples m.predict("img.jpg", refer_image="ref.jpg", visual_prompts=visual_prompts, predictor=YOLOEVPSegPredictor) m.export(format="onnx", dynamic=True, simplify=True)For guidance see the YOLOE page under Predict and Export usage. Refer: YOLOE: Real‑Time Seeing Anything, YOLOEVPSegPredictor API.
@Chappie123 With bbox-only data, convert to YOLO detection TXT labels and train a detection model. Convert each box from
{minx,miny,maxx,maxy}to normalizedxc,yc,w,h:def to_yolo(minx, miny, maxx, maxy, W, H): xc = (minx + maxx) / 2 / W yc = (miny + maxy) / 2 / H w = (maxx - minx) / W h = (maxy - miny) / H return xc, yc, w, hDataset YAML (minimal):
path: /data/myset
train: images/train
val: images/val
names: {0: class0, 1: class1}
Train:
from ultralytics import YOLOE
model = YOLOE("yoloe-11s.yaml")
model.train(data="data.yaml", epochs=100, imgsz=640)
More in Train mode and Detection task.
@HLHSM The error is from installing the wrong
clippackage. Uninstall the PyPIclipand install the official CLIP (per its README), or use a compatible wheel likeclip-anytorch, then restart Python:pip uninstall -y clip pip install clip-anytorchIf it persists, please run
yolo checksand paste the full text output. Reference for the APIs you’re calling: YOLOE API reference.@Maya7991 Current ONNX exports accept a single
imagesinput; runtime text/visual prompts aren’t exposed as additional ONNX inputs. Use offline prompts: set and fuse classes before export, or use the prompt‑free path.from ultralytics import YOLOE m = YOLOE("yoloe-11s-seg.pt") names = ["person", "bus"] m.set_classes(names, m.get_text_pe(names)) # fuse prompts m.export(format="onnx", dynamic=True, simplify=True)With
dynamic=True, you can pass[N,3,H,W]batches in onnxruntime even though the input name is justimages. See Export mode and YOLOE Export examples on the docs page: YOLOE docs.@beichen2012 Swapping YOLO11’s CNN backbone for a DINOv3‑distilled ViT isn’t supported and would require a custom backbone module plus shape/plumbing changes; we recommend using YOLO26 as‑is or a transformer model like RT‑DETR. If you prototype this, please keep any PR minimal, well‑tested, and scoped to the new backbone only.