YOLO26 模型的 TensorRT 导出#
在高性能环境中部署计算机视觉模型时,可能需要一种能够最大限度提升速度和效率的格式。将模型部署到 NVIDIA GPU 上时,这一点尤为重要。
使用 TensorRT 导出格式,可以优化Ultralytics YOLO26模型,使其在 NVIDIA 硬件上实现快速、高效的推理。本指南将提供易于遵循的转换步骤,帮助你在深度学习项目中充分利用 NVIDIA 的先进技术。
TensorRT#
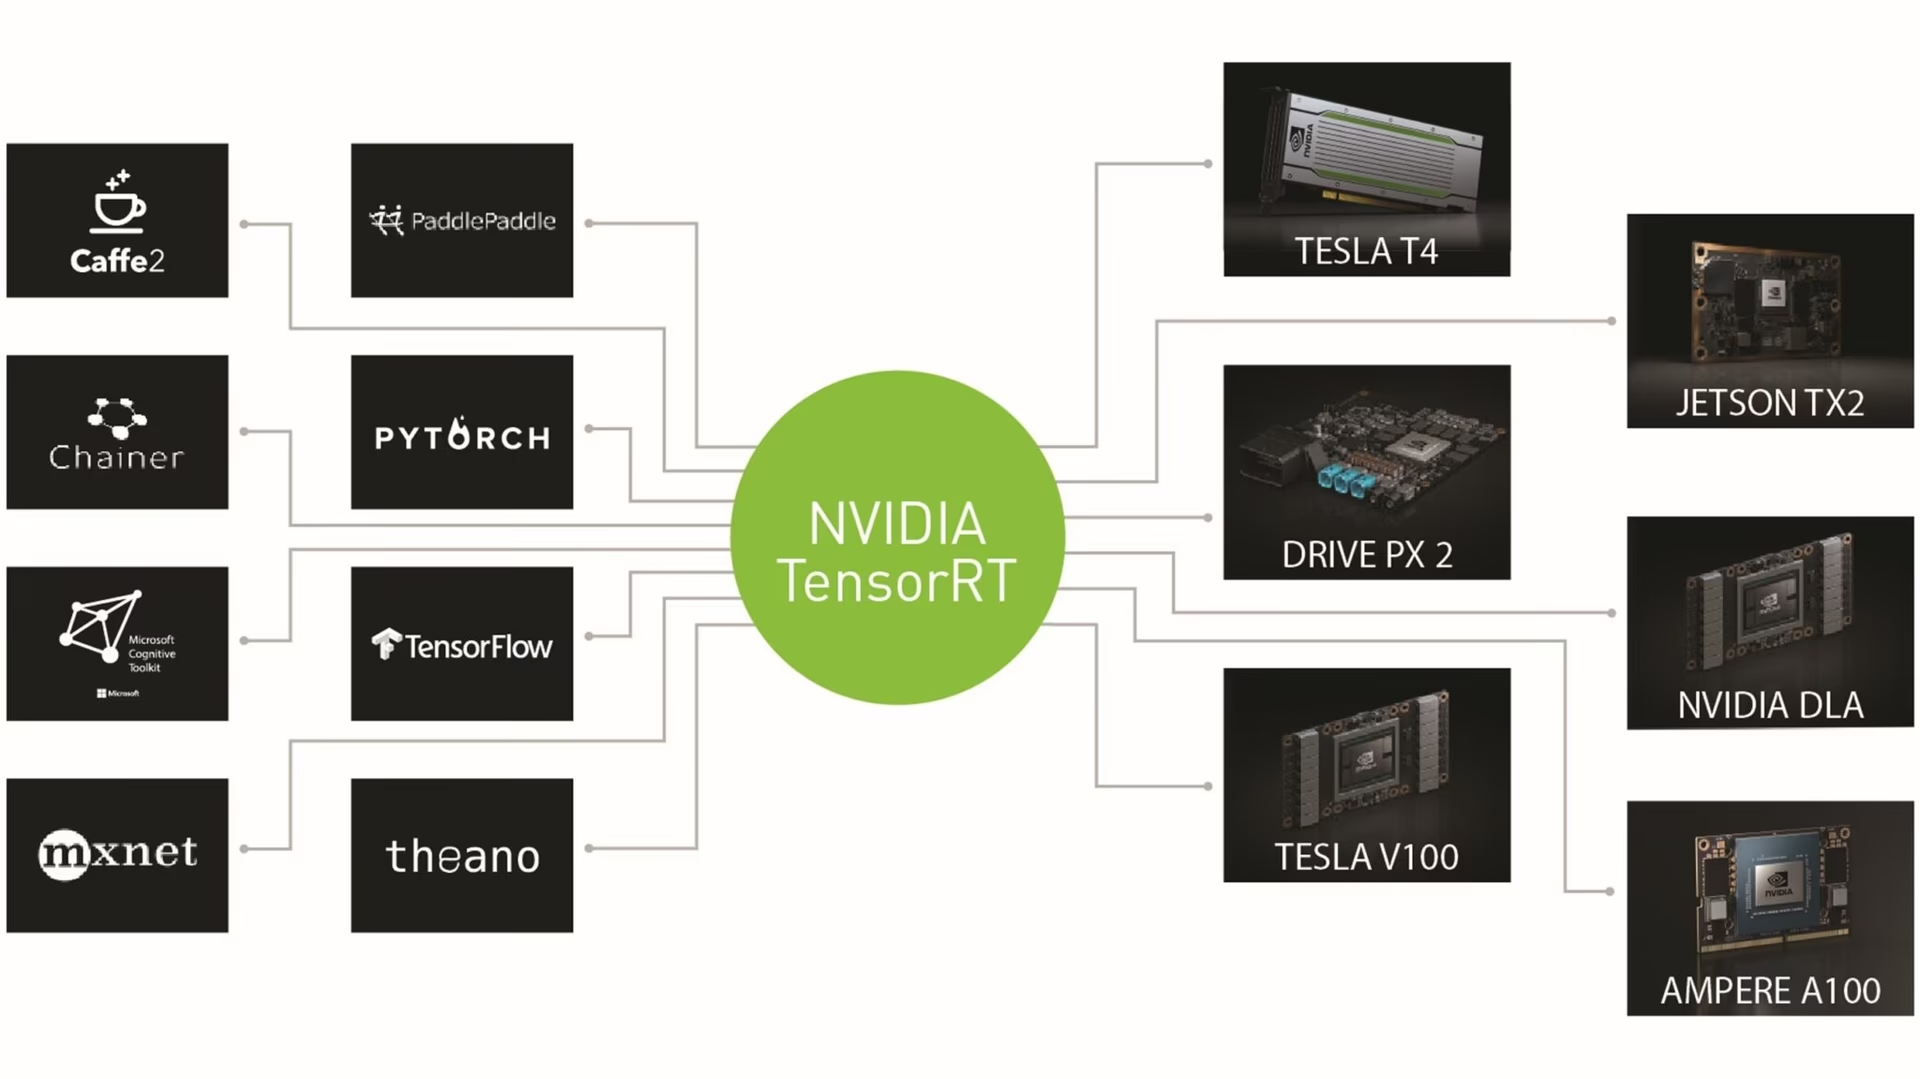
TensorRT由 NVIDIA 开发,是一款先进的软件开发套件 (SDK),专为高速深度学习推理而设计。它非常适用于目标检测等实时应用。
这个工具包可优化适用于 NVIDIA GPU 的深度学习模型,从而实现更快速、更高效的运行。TensorRT 模型会经过 TensorRT 优化,其中包括层融合、精度校准(INT8 和 FP16)、动态张量内存管理和内核自动调优等技术。将深度学习模型转换为 TensorRT 格式,可以让开发者充分发挥 NVIDIA GPU 的潜力。
TensorRT 以兼容多种模型格式而著称,包括 TensorFlow、PyTorch 和 ONNX,为开发者提供灵活的解决方案,以便集成和优化来自不同框架的模型。这种多功能性支持在各种硬件和软件环境中高效部署模型。
TensorRT 会在用于构建引擎的 GPU 上对引擎进行配置和调优。请针对部署所用的 GPU 架构构建引擎,并确保 TensorRT/CUDA 运行时匹配;不要将 .engine 文件视为可移植的模型格式。对于边缘部署,Ultralytics Platform提供八种 Jetson 目标设备选项,并分别记录了实际构建和验证状态;你也可以在目标设备上本地导出。
TensorRT 模型的主要功能#
TensorRT 模型具备多种主要功能,有助于提升高速深度学习推理的效率和效果:
-
精度校准:TensorRT 支持精度校准,可针对特定准确率要求微调模型。TensorRT 还支持 INT8 和 FP16 等低精度格式,在保持可接受准确率的同时进一步提升推理速度。
-
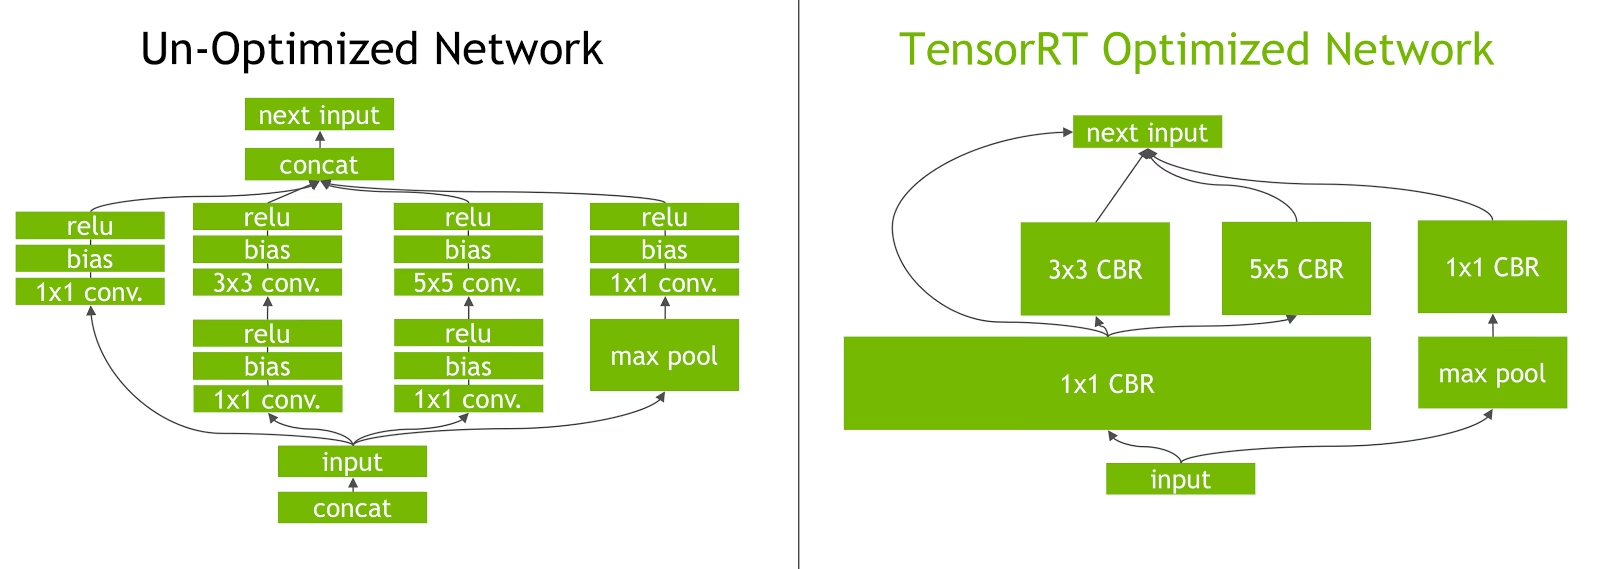
层融合:TensorRT 优化过程包含层融合,即将神经网络的多个层合并为一个运算。这可以减少计算开销,并通过最大限度地减少内存访问和计算来提升推理速度。
-
动态张量内存管理:TensorRT 可在推理过程中高效管理张量内存使用情况,减少内存开销并优化内存分配,从而更高效地利用 GPU 内存。
-
内核自动调优:TensorRT 会自动调优内核,为模型的每一层选择最优的 GPU 内核。这种自适应方法可确保模型充分利用 GPU 的计算能力。
TensorRT 部署选项#
在查看将 YOLO26 模型导出为 TensorRT 格式的代码之前,我们先来了解 TensorRT 模型通常用于哪些场景。
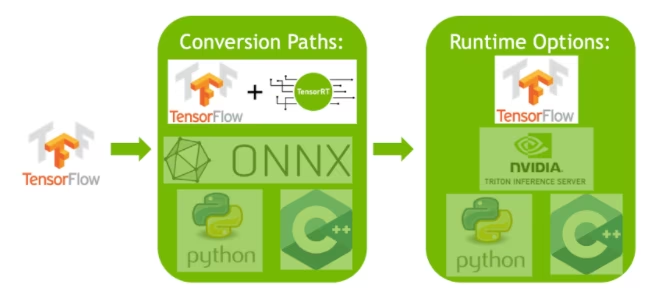
TensorRT 提供多种部署选项,各选项在易于集成、性能优化和灵活性之间各有侧重:
- 在 TensorFlow 中部署:此方法将 TensorRT 集成到 TensorFlow 中,使优化后的模型能够在熟悉的 TensorFlow 环境中运行。对于包含受支持层和不受支持层的模型,此方法很有用,因为 TF-TRT 能够高效处理这些层。
-
独立 TensorRT Runtime API:提供细粒度控制,非常适合对性能要求极高的应用。该方式较为复杂,但支持自定义实现不受支持的算子。
-
NVIDIA Triton Inference Server:支持来自各种框架的模型,特别适用于云端或边缘推理,并提供并发模型执行和模型分析等功能。
支持的任务#
TensorRT 导出支持 Ultralytics 的全部七种任务。语义分割和深度估计仅适用于 YOLO26,因为只有 YOLO26 系列提供这两种预测头。
将 YOLO26 模型导出为 TensorRT#
将 YOLO26 模型转换为 TensorRT 格式,可以提高执行效率并优化性能。
安装#
要安装所需软件包,请运行:
# Install the required package for YOLO26
pip install ultralytics
有关安装流程的详细说明和最佳实践,请查看我们的 YOLO26 安装指南。安装 YOLO26 所需软件包时,如果遇到困难,请参阅我们的常见问题指南,获取解决方案和建议。
用法#
开始阅读使用说明前,请务必了解 Ultralytics 提供的 YOLO26 模型,以便根据项目需求选择最合适的模型。
TensorRT 格式支持导出、预测和验证模式。推理和验证需要 NVIDIA GPU。导出模型后,加载导出的模型即可运行推理或验证其准确率。
from ultralytics import YOLO

# 加载 YOLO26 模型
model = YOLO("yolo26n.pt")

# 将模型导出为 TensorRT 格式
model.export(format="engine") # 创建 'yolo26n.engine'from ultralytics import YOLO
# 加载导出的 TensorRT 模型
model = YOLO("yolo26n.engine")
# 运行推理
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# 加载导出的 TensorRT 模型
model = YOLO("yolo26n.engine")
# 在 COCO8 数据集上验证准确率
metrics = model.val(data="coco8.yaml")导出参数#
| 参数 | 类型 | 默认值 | 说明 |
|---|---|---|---|
format | str | 'engine' | 导出模型的目标格式,用于定义与各种部署环境的兼容性。 |
imgsz | int 或 tuple | 640 | 模型输入所需的图像尺寸。正方形图像可使用整数;若要指定具体尺寸,则可使用元组 (height, width)。 |
quantize | int 或 str | None | 量化精度:16 (FP16) 或 8 (INT8/PTQ;需要校准 data/fraction);32/未设置表示 FP32。使用 quantize=8 训练的检查点始终会根据其携带的范围导出为 INT8,无需校准。此设置取代了已弃用的 half/int8 标志。 |
dynamic | bool | False | 允许使用动态输入尺寸,从而更灵活地处理不同图像尺寸。 |
simplify | bool | True | 使用 onnxslim 简化模型图,可能提升性能和兼容性。 |
opset | int | None | 指定中间 ONNX 图的 ONNX opset 版本。若未设置,则使用最新的受支持版本。 |
workspace | float 或 None | None | 设置用于 TensorRT 优化的最大工作空间大小(单位为 GiB),以平衡内存使用和性能;使用 None 可让 TensorRT 自动分配内存,分配上限为设备最大容量。 |
nms | bool,可选 | None | 选择原始输出(None,默认)、嵌入式 NMS(True)或无 NMS 检测头(False)。 |
batch | int | 1 | 指定导出模型的批量推理大小,或导出模型在 predict 模式下可同时处理的最大图像数。 |
data | str | None | 数据集 YAML 文件的路径,是量化所必需的;分类任务则需要数据集目录或内置数据集名称。如果使用 quantize=8 但未指定此项,Ultralytics 会为该模型任务选择默认校准数据集;使用 quantize=8 训练的检查点则不需要此项。 |
fraction | float、int 或 list | 1.0 | 校准子集,可按比例、图像数量或 [train, val, test] 比例/数量指定。包含两个项目的列表会让 test 保持完整,而 0 会跳过它。 |
device | str | None | 指定导出设备:GPU(device=0),或 NVIDIA Jetson 的 DLA(device=dla:0 或 device=dla:1)。 |
请确保导出为 TensorRT 时使用支持 CUDA 的 GPU。
TensorRT 11.2.1 不支持 JetPack,包括 Thor;请使用 JetPack 版本支持的 TensorRT 10.x 运行时。对于 device=dla:0 或 device=dla:1,NVIDIA 指出 TensorRT 10.7 是最后一个支持 DLA的版本。TensorRT 11.0、11.1 和 11.2 均不支持 DLA。
有关导出流程的更多详情,请访问 Ultralytics 导出文档页面。
使用 INT8 量化导出 TensorRT#
使用 TensorRT 将 Ultralytics YOLO 模型以 INT8精度导出时,会执行训练后量化 (PTQ)。TensorRT 会对 PTQ 执行校准:在 YOLO 模型使用具有代表性的输入数据进行推理时,测量每个激活张量中激活值的分布,然后据此估算各张量的缩放值。每个适合量化的激活张量都有关联的缩放值,该值由校准过程推导得出。通过 quantize=8 和量化感知训练微调的检查点已携带 INT8 范围,因此导出时会使用这些范围并跳过校准。
TensorRT 11 移除了隐式量化和 IInt8Calibrator 接口。在 TensorRT 11 及更高版本中,Ultralytics 使用 NVIDIA ModelOpt 显式量化执行 INT8 量化:在构建强类型引擎之前,将 Q/DQ 节点插入 ONNX 计算图;FP16 则通过 ModelOpt AutoCast 混合精度转换实现。quantize=8、quantize=16 和 data 参数的工作方式不变;首次使用时会自动安装 ModelOpt。TensorRT 7-10 则使用下文介绍的旧版校准器。
处理采用隐式量化的网络时,TensorRT 会按需使用 INT8 来优化层的执行时间。如果某一层使用 INT8 运行更快,且其数据输入和输出已分配量化缩放值,TensorRT 就会为该层分配 INT8 精度内核;否则,TensorRT 会根据哪种精度能让该层运行得更快,为内核选择 FP32 或 FP16。
至关重要的一点是,必须使用与部署时运行 TensorRT 模型权重相同的设备,以 INT8 精度进行导出,因为不同设备的校准结果可能有所不同。
配置 INT8 导出#
使用 Ultralytics YOLO 模型的导出功能时提供的参数会对导出模型的性能产生显著影响。你还需要根据设备可用资源选择参数,不过默认参数应该适用于大多数 Ampere(或更新架构)的 NVIDIA 独立 GPU。GPU 导出使用的校准算法为 "MINMAX_CALIBRATION",NVIDIA Jetson 上的 DLA 导出则使用 "ENTROPY_CALIBRATION_2"。你可以在 TensorRT 开发者指南中详细了解可用选项。Ultralytics 的测试发现,"MINMAX_CALIBRATION" 是 GPU 导出的最佳选择,系统会根据导出设备自动选择该算法。
-
workspace:控制转换模型权重时分配的设备内存大小(单位为 GiB)。-
根据校准需求和可用资源调整
workspace的值。较大的workspace可能会延长校准时间,但可以让 TensorRT 探索更多优化策略,从而可能提升模型性能和准确率。相反,较小的workspace可以缩短校准时间,但可能限制优化策略,影响量化模型的质量。 -
默认值为
workspace=None,这会让 TensorRT 自动分配内存。手动配置时,如果校准发生崩溃(无警告退出),可能需要增大此值。 -
如果
workspace的值大于设备可用内存,TensorRT 会在导出期间报告UNSUPPORTED_STATE,这意味着应降低workspace的值或将其设为None。 -
如果
workspace设为最大值后校准失败或崩溃,请考虑使用None自动分配内存,或减小imgsz和batch的值以降低内存需求。 -
请记住,INT8 校准针对每台设备分别进行。借用“高端”GPU进行校准,可能会导致模型在另一台设备上推理时性能不佳。
-
-
batch:推理时使用的最大批次大小。使用dynamic=True时,推理可以使用更小的批次,但不接受大于指定大小的批次。
使用较小的批次可能导致 INT8 校准时的缩放不准确,因为校准过程会根据所见数据进行调整。较小的批次可能无法覆盖完整的取值范围,进而影响最终校准效果。使用较大的批次大小有助于获得更具代表性的校准结果。
NVIDIA 通过实验建议,使用 INT8 量化校准时,至少使用 500 张能够代表模型数据的校准图像。这只是一个指导建议,并非硬性要求,而且你需要通过实验确定哪些设置适合你的数据集。由于 TensorRT 的 INT8 校准需要校准数据,导出未经 quantize=8(训练后量化)训练的检查点时,请务必使用 data 参数,并将其设置为 TensorRT 的 quantize=8,再使用 data="my_dataset.yaml",以便利用验证图像进行校准。使用 quantize=8 训练的检查点会跳过校准,因此无需设置 data。使用 INT8 量化导出 TensorRT 时,如果未为 data 传入值,系统会默认使用根据模型任务选择的某个“小型”示例数据集,而不会报错。
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.export(
    format="engine",
    dynamic=True,  # (1)!
    batch=8,  # (2)!
    workspace=4,  # (3)!
    quantize=8,
    data="coco.yaml",  # (4)!
)

# 加载导出的 TensorRT INT8 模型
model = YOLO("yolo26n.engine", task="detect")

# 运行推理
result = model.predict("https://ultralytics.com/images/bus.jpg")使用 YOLO 与 TensorRT INT8 的优势#
-
减小模型体积: 将 FP32 量化为 INT8 可将模型体积缩小至原来的 1/4(无论是在磁盘上还是内存中),从而加快下载速度、降低存储需求,并减少部署模型时的内存占用。
-
降低功耗: 使用 INT8 导出的 YOLO 模型执行低精度运算时,功耗可能低于 FP32 模型,尤其适用于电池供电的设备。
-
提升推理速度: TensorRT 会针对目标硬件优化模型,从而可能提升 GPU、嵌入式设备和加速器上的推理速度。
关于推理速度的说明
使用导出为 TensorRT INT8 的模型进行推理时,前几次调用的预处理、推理和/或后处理时间可能会比平常更长。推理期间更改 imgsz 时也可能出现这种情况,尤其是在 imgsz 与导出时指定的值不同时(导出 imgsz 被设置为 TensorRT“optimal”配置文件)。
使用 YOLO 与 TensorRT INT8 的缺点#
-
评估指标下降: 使用较低精度意味着
mAP、Precision、Recall或任何用于评估模型性能的其他指标都可能有所下降。Sigmoid 层会保持较高精度,以保留分数校准效果,但 INT8 仍可能改变置信度值,因此应根据 INT8 模型自身的 F1 曲线选择运行阈值。请参阅性能结果部分,比较在各种设备的小样本上使用 INT8 导出时mAP50和mAP50-95的差异。 -
增加开发时间: 为数据集和设备找到 INT8 校准的“optimal”设置,可能需要进行大量测试。
-
依赖硬件: 校准和性能提升可能高度依赖硬件,模型权重的可迁移性也会降低。
Ultralytics YOLO TensorRT 导出性能#
NVIDIA A100#
测试环境:Ubuntu 22.04.3 LTS、python 3.10.12、ultralytics==8.2.4、tensorrt==8.6.1.post1
这些模型在 COCO 上训练,包含 80 个预训练类别;使用示例请参阅检测文档。
对于每项测试,显示使用预训练权重 yolov8n.engine 时 mean、min(最快)和 max(最慢)的推理时间
| 精确率 | 评估测试 | 平均 (毫秒) | 最小值 | 最大值 (毫秒) | mAP验证 50(B) | mAP验证 50-95(B) | batch | 尺寸 (像素) |
|---|---|---|---|---|---|---|---|
| FP32 | 预测 | 0.52 | 0.51 | 0.56 | 8 | 640 | ||
| FP32 | COCO验证 | 0.52 | 0.52 | 0.37 | 1 | 640 | |
| FP16 | 预测 | 0.34 | 0.34 | 0.41 | 8 | 640 | ||
| FP16 | COCO验证 | 0.33 | 0.52 | 0.37 | 1 | 640 | |
| INT8 | 预测 | 0.28 | 0.27 | 0.31 | 8 | 640 | ||
| INT8 | COCO验证 | 0.29 | 0.47 | 0.33 | 1 | 640 |
消费级 GPU#
测试环境:Windows 10.0.19045、python 3.10.9、ultralytics==8.2.4、tensorrt==10.0.0b6
对于每项测试,显示使用预训练权重 yolov8n.engine 时 mean、min(最快)和 max(最慢)的推理时间
| 精确率 | 评估测试 | 平均 (毫秒) | 最小值 | 最大值 (毫秒) | mAP验证 50(B) | mAP验证 50-95(B) | batch | 尺寸 (像素) |
|---|---|---|---|---|---|---|---|
| FP32 | 预测 | 1.06 | 0.75 | 1.88 | 8 | 640 | ||
| FP32 | COCO验证 | 1.37 | 0.52 | 0.37 | 1 | 640 | |
| FP16 | 预测 | 0.62 | 0.75 | 1.13 | 8 | 640 | ||
| FP16 | COCO验证 | 0.85 | 0.52 | 0.37 | 1 | 640 | |
| INT8 | 预测 | 0.52 | 0.38 | 1.00 | 8 | 640 | ||
| INT8 | COCO验证 | 0.74 | 0.47 | 0.33 | 1 | 640 |
嵌入式设备#
测试环境:JetPack 6.0 (L4T 36.3) Ubuntu 22.04.4 LTS、python 3.10.12、ultralytics==8.2.16、tensorrt==10.0.1
对于每项测试,显示使用预训练权重 yolov8n.engine 时 mean、min(最快)和 max(最慢)的推理时间
| 精确率 | 评估测试 | 平均 (毫秒) | 最小值 | 最大值 (毫秒) | mAP验证 50(B) | mAP验证 50-95(B) | batch | 尺寸 (像素) |
|---|---|---|---|---|---|---|---|
| FP32 | 预测 | 6.11 | 6.10 | 6.29 | 8 | 640 | ||
| FP32 | COCO验证 | 6.17 | 0.52 | 0.37 | 1 | 640 | |
| FP16 | 预测 | 3.18 | 3.18 | 3.20 | 8 | 640 | ||
| FP16 | COCO验证 | 3.19 | 0.52 | 0.37 | 1 | 640 | |
| INT8 | 预测 | 2.30 | 2.29 | 2.35 | 8 | 640 | ||
| INT8 | COCO验证 | 2.32 | 0.46 | 0.32 | 1 | 640 |
请参阅我们的 NVIDIA Jetson 搭配 Ultralytics YOLO 快速入门指南,详细了解设置和配置。
请参阅我们的 NVIDIA DGX Spark 搭配 Ultralytics YOLO 快速入门指南,详细了解设置和配置。
评估方法#
展开以下各部分,了解这些模型的导出和测试方式。
导出配置
有关导出配置参数的详细信息,请参阅导出模式。
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# TensorRT FP32
out = model.export(format="engine", imgsz=640, dynamic=True, verbose=False, batch=8, workspace=2)

# TensorRT FP16
out = model.export(format="engine", imgsz=640, dynamic=True, verbose=False, batch=8, workspace=2, quantize=16)

# TensorRT INT8,使用校准 `data`(即适用于相应模型任务的 COCO、ImageNet 或 DOTAv1)
out = model.export(
    format="engine", imgsz=640, dynamic=True, verbose=False, batch=8, workspace=2, quantize=8, data="coco8.yaml"
)
预测循环
如需了解更多信息,请参阅预测模式。
import cv2

from ultralytics import YOLO

model = YOLO("yolo26n.engine")
img = cv2.imread("path/to/image.jpg")

for _ in range(100):
    result = model.predict(
        [img] * 8,  # 同一图像的 batch=8
        verbose=False,
        device="cuda",
    )
验证配置
如需详细了解验证配置参数,请参阅 val 模式。
from ultralytics import YOLO

model = YOLO("yolo26n.engine")
results = model.val(
    data="data.yaml",  # 适用于相应模型任务的 COCO、ImageNet 或 DOTAv1
    batch=1,
    imgsz=640,
    verbose=False,
    device="cuda",
)
部署导出的 YOLO26 TensorRT 模型#
成功将 Ultralytics YOLO26 模型导出为 TensorRT 格式后,就可以开始部署了。如需了解在各种环境中部署 TensorRT 模型的详细说明,请参阅以下资源:
-
使用 Triton Server 部署 Ultralytics:本指南介绍如何将 NVIDIA Triton Inference Server(原 TensorRT Inference Server)专门用于 Ultralytics YOLO 模型。
-
使用 NVIDIA TensorRT 部署深度神经网络:本文介绍如何使用 NVIDIA TensorRT,在基于 GPU 的部署平台上高效部署深度神经网络。
-
面向 NVIDIA PC 的端到端 AI:NVIDIA TensorRT 部署:这篇博客文章介绍如何使用 NVIDIA TensorRT 优化模型,并将 AI 模型部署到基于 NVIDIA 的 PC 上。
-
NVIDIA TensorRT 的 GitHub 仓库:这是 NVIDIA TensorRT 的官方 GitHub 仓库,其中包含源代码和文档。
总结#
本指南重点介绍了如何将 Ultralytics YOLO26 模型转换为 NVIDIA TensorRT 模型格式。这一步转换对于提升 YOLO26 模型的效率和速度至关重要,可使模型更有效,并适用于各种部署环境。
如需了解更多使用详情,请参阅 TensorRT 官方文档。
如果你想了解更多 Ultralytics YOLO26 集成方案,请查看我们的集成指南页面,其中提供了大量实用资源和见解。
常见问题#
按照以下步骤,将 Ultralytics YOLO26 模型转换为 TensorRT 格式,以便在 NVIDIA GPU 上实现优化推理:
-
安装所需的软件包:
pip install ultralytics -
导出 YOLO26 模型:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.export(format="engine")  # 创建 'yolo26n.engine'

# 运行推理
model = YOLO("yolo26n.engine")
results = model("https://ultralytics.com/images/bus.jpg")
如需了解更多详情,请参阅 YOLO26 安装指南和导出文档。
-
使用 TensorRT 优化 YOLO26 模型有以下几项优势:
- 更快的推理速度:TensorRT 会优化模型层,并使用精度校准(INT8 和 FP16)来加快推理,同时不会明显降低准确率。
- 内存效率:TensorRT 会动态管理张量内存,减少开销并提高 GPU 内存利用率。
- 层融合:将多个层合并为单个运算,从而降低计算复杂度。
- 内核自动调优:自动为每个模型层选择经过优化的 GPU 内核,确保发挥最佳性能。
如需了解更多信息,请参阅 NVIDIA TensorRT 官方文档和我们的 TensorRT 深度概览。
可以,你可以使用 TensorRT 和 INT8 量化来导出 YOLO26 模型。此过程包含训练后量化 (PTQ) 和校准;如果检查点是使用
quantize=8(量化感知训练)训练的,则会直接导出检查点中包含的范围,无需校准:-
使用 INT8 导出:
from ultralytics import YOLO model = YOLO("yolo26n.pt") model.export(format="engine", batch=8, workspace=4, quantize=8, data="coco.yaml") -
运行推理:
from ultralytics import YOLO

model = YOLO("yolo26n.engine", task="detect")
result = model.predict("https://ultralytics.com/images/bus.jpg")
如需了解更多详情,请参阅使用 INT8 量化导出 TensorRT 部分。
-
你可以参考以下资源,在 NVIDIA Triton Inference Server 上部署 YOLO26 TensorRT 模型:
- 使用 Triton Server 部署 Ultralytics YOLO26:介绍如何设置和使用 Triton Inference Server 的分步指南。
- 使用 NVIDIA TensorRT 部署深度神经网络:NVIDIA 提供的指南,介绍如何使用 TensorRT 部署深度学习模型,并详细说明各种部署选项和配置。
这些指南将帮助你在各种部署环境中高效集成 YOLO26 模型。
TensorRT 带来的性能提升会因模型和所用硬件而异。以下是使用 YOLOv8n 测得的典型基准数据,展示了不同精度带来的相对提升:
-
NVIDIA A100:
- FP32 推理:~0.52 毫秒 / 图像
- FP16 推理:~0.34 毫秒 / 图像
- INT8 推理:~0.28 毫秒 / 图像
- INT8 精度下 mAP 略有下降,但速度显著提升。
-
消费级 GPU(例如 RTX 3080):
- FP32 推理:~1.06 毫秒 / 图像
- FP16 推理:~0.62 毫秒 / 图像
- INT8 推理:~0.52 毫秒 / 图像
不同硬件配置的详细性能基准测试结果,请参阅性能部分。
如需全面了解 TensorRT 性能,请参阅 Ultralytics 文档和我们的性能分析报告。
-