SAM 3:基于概念的万物分割
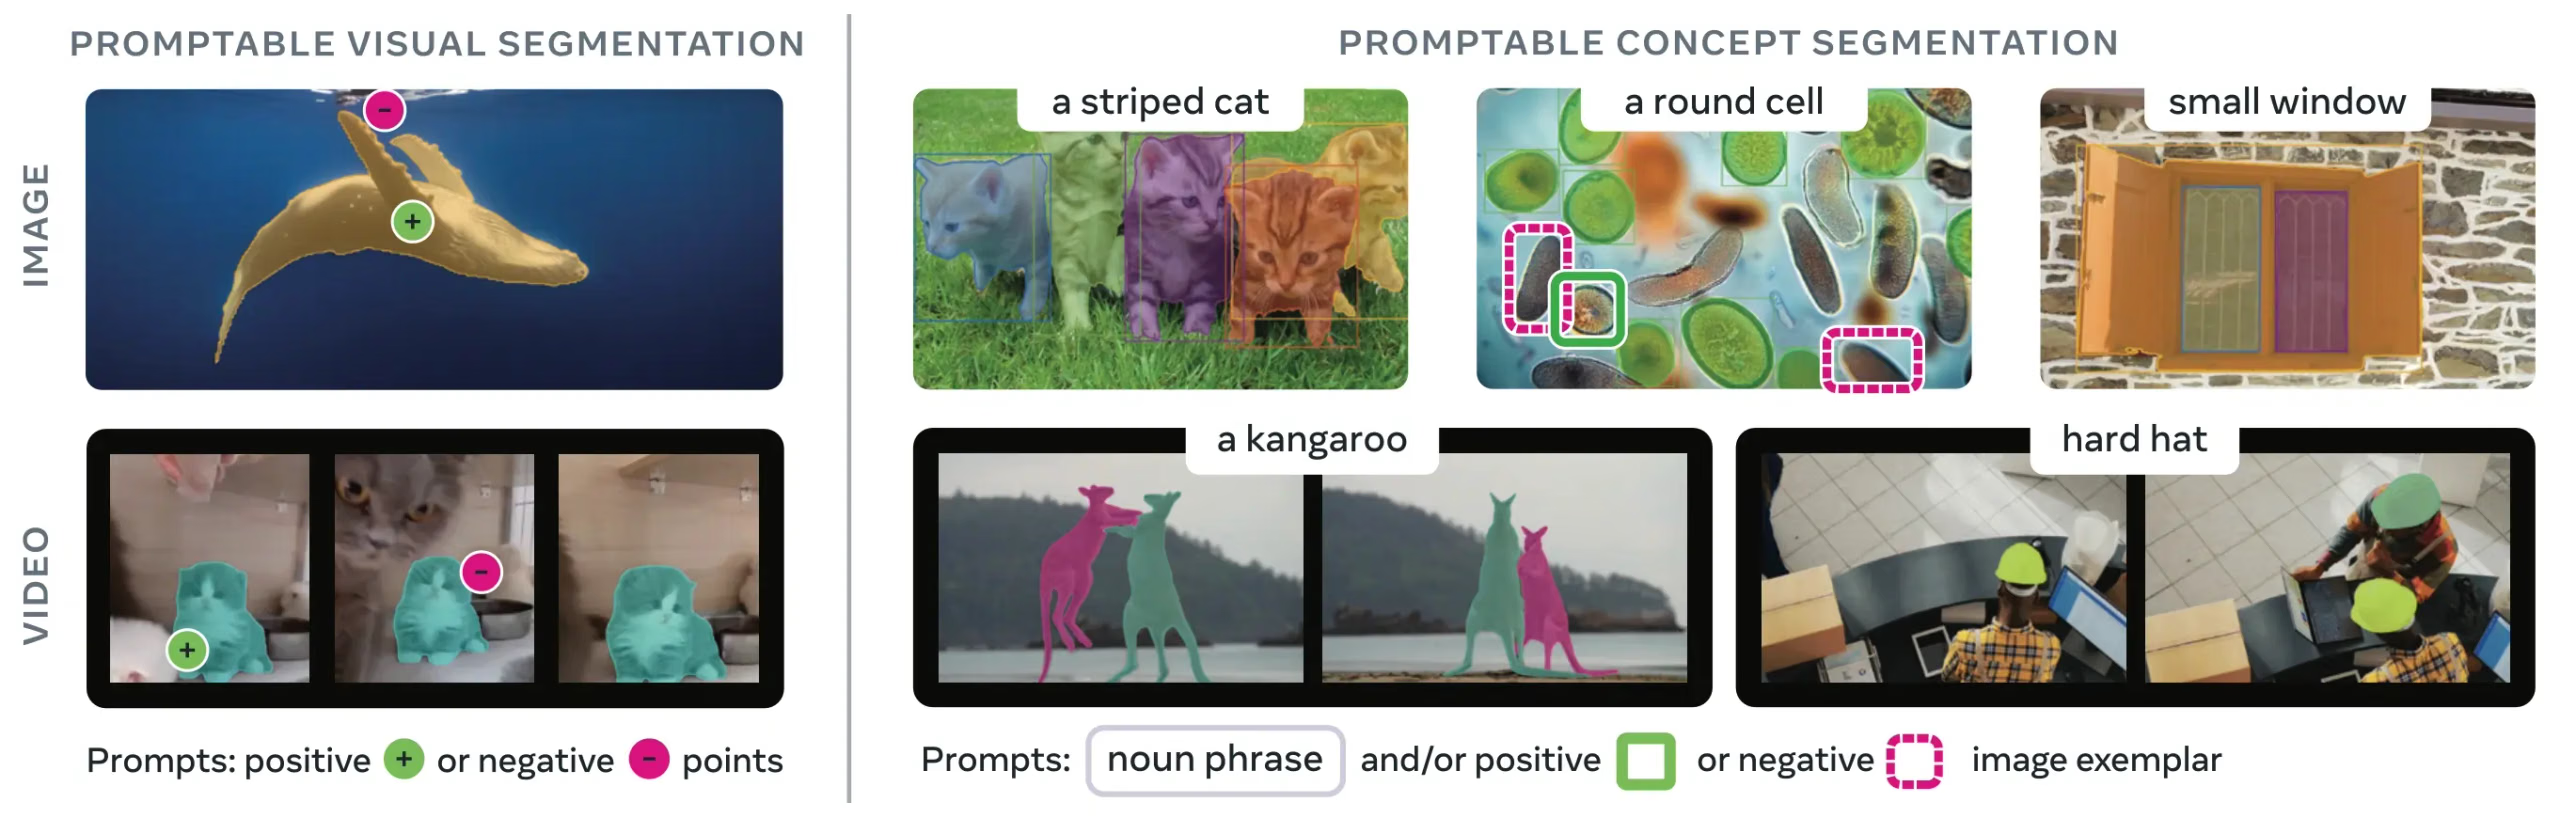
SAM 3(Segment Anything Model 3(万物分割模型 3))是 Meta 面向可提示概念分割(PCS)的基础模型。SAM 3 基于 SAM 2,新增了一项能力:通过文本提示、图像示例或两者结合,检测、分割并跟踪视觉概念的所有实例。以往 SAM 版本每个提示只能分割单个目标,而 SAM 3 可以在图像或视频中的任意位置查找并分割某个概念的所有实例,符合现代实例分割的开放词汇目标。
观看: 如何将 Meta Segment Anything 3 与 Ultralytics 配合使用 | 对图像和视频进行文本提示分割
SAM 3 已全面集成到 ultralytics 包中,可原生支持基于文本提示、图像示例提示的概念分割,以及视频跟踪。该包还支持较新的 SAM 3.1 检查点进行图像预测。
概述#
SAM 3 在可提示概念分割方面的性能比现有系统提升 2 倍,同时保持并增强了 SAM 2 的交互式视觉分割能力。该模型擅长开放词汇分割,用户可以通过简单的名词短语(例如“黄色校车”“条纹猫”)或提供目标对象的示例图像来指定概念。在 Ultralytics 中,SAM 3 通过predict模式运行,并提供专用的视频预测器进行跟踪。
什么是可提示概念分割(PCS)?#
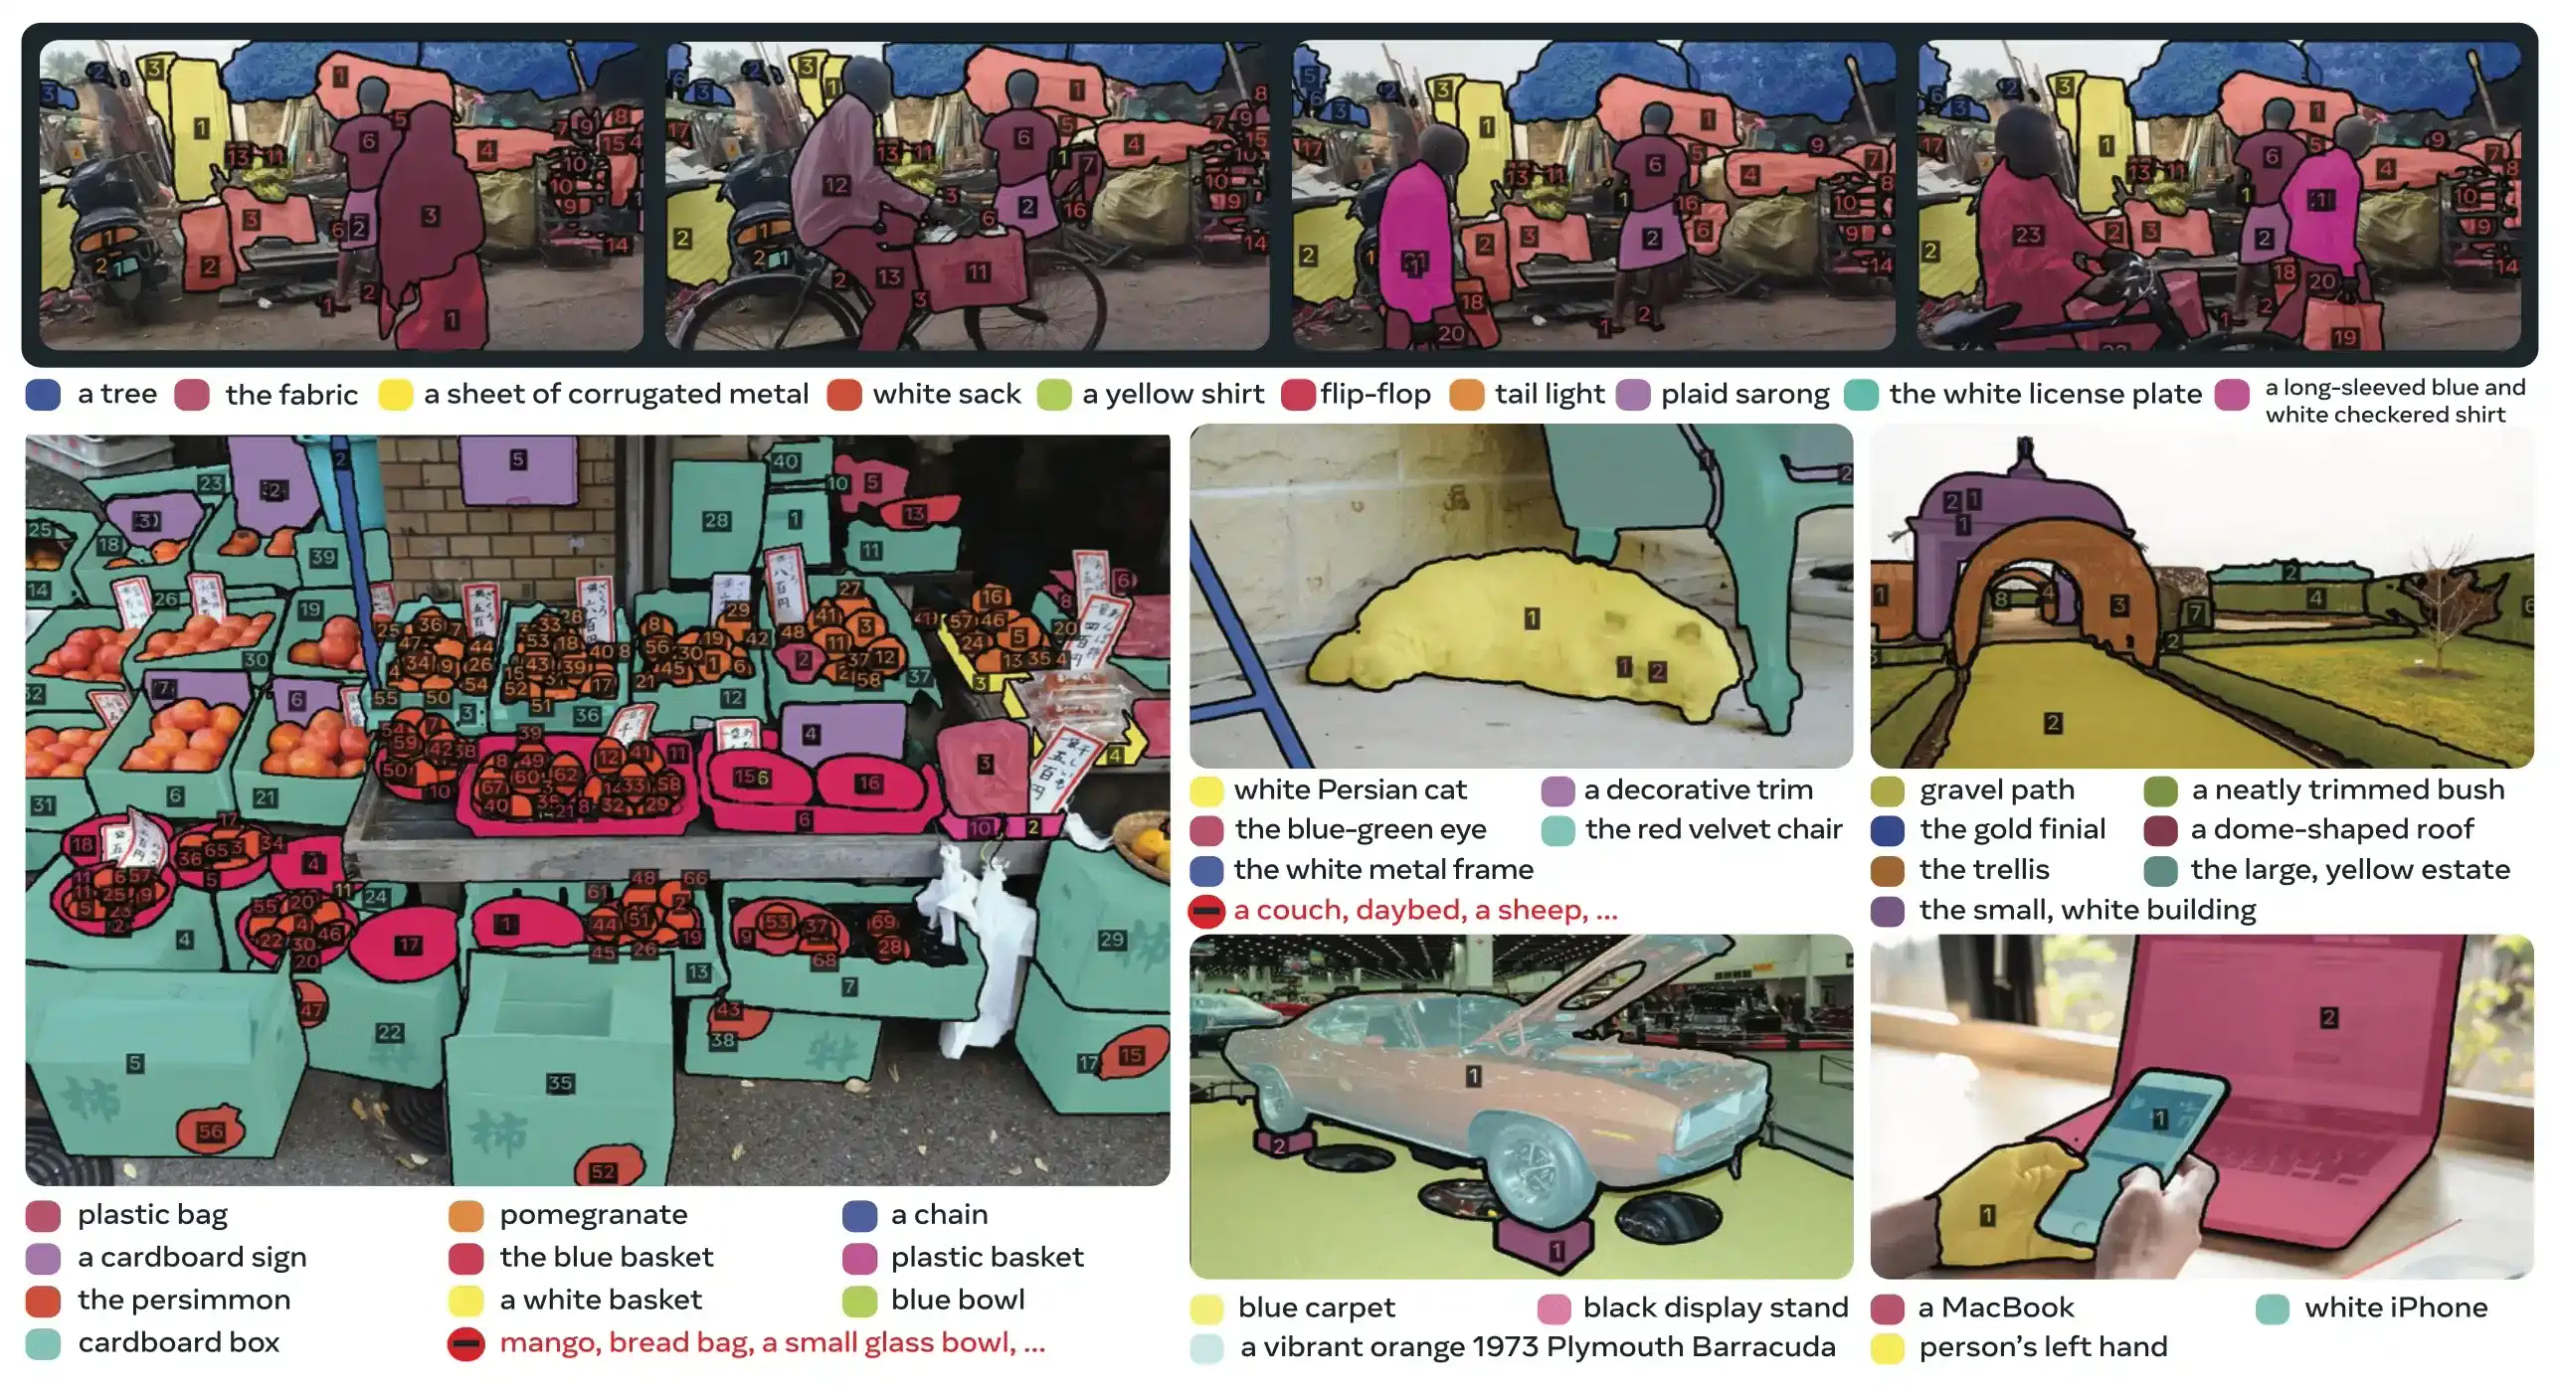
PCS 任务以概念提示作为输入,并为所有匹配的目标实例返回具有唯一标识的分割掩码。概念提示可以是:
- 文本:简单的名词短语,例如“红苹果”或“戴帽子的人”,类似于零样本学习
- 图像示例:在示例物体周围绘制边界框(正向或负向),以便快速泛化
- 组合:同时使用文本和图像示例,实现精确控制
这与传统视觉提示(点、框、掩码)不同,传统视觉提示只分割单个特定物体实例;这一做法最初由 SAM 系列推广。
关键性能指标#
| 指标 | SAM 3 成绩 |
|---|---|
| LVIS 零样本掩码 AP | 47.0(此前最佳为 38.5,提升 22%) |
| SA-Co 基准 | 比现有系统表现好 2 倍 |
| 推理速度(H200 GPU) | 每张图像 30 ms,可检测 100 多个物体 |
| 视频性能 | 约 5 个并发物体时接近实时 |
| MOSEv2 VOS 基准 | 60.1 J&F(比 SAM 2.1 高 25.5%,比此前 SOTA 高 17%) |
| 交互式细化 | 使用 3 个示例提示后,CGF1 提升 +18.6 |
| 与人类表现的差距 | 达到 SA-Co/Gold 估计下界的 88% |
如需了解模型指标及其在生产环境中的权衡,请参阅模型评估见解和 YOLO 性能指标。
SAM 3.1#
Meta 于 2026 年 3 月 27 日发布了 SAM 3.1,这是一个新增对象复用(Object Multiplex)功能的 SAM 3 检查点,该功能采用共享内存方式进行多物体视频跟踪。SAM 3.1 不再独立处理每个跟踪物体,而是将物体分组到固定容量的桶中并联合处理。据 Meta 报告,在单个 H100 GPU 上跟踪 128 个物体时,速度可提升 ~7 倍。图像检测器和交互式点提示头仍采用 SAM 3 架构。
| 基准测试 | 指标 | SAM 3 | SAM 3.1 |
|---|---|---|---|
| SA-Co/VEval SA-V(测试集) | cgF1 | 30.3 | 30.5 |
| SA-Co/VEval YT-Temporal-1B(测试集) | cgF1 | 50.8 | 52.9 |
| SA-Co/VEval SmartGlasses(测试集) | cgF1 | 36.4 | 36.3 |
| MOSEv1(验证集) | J&F | 78.4 | 79.6 |
| DAVIS17(验证集) | J&F | 92.2 | 92.7 |
| SA-V(测试集) | J&F | 84.4 | 85.1 |
| YTVOS19(验证集) | G | 89.7 | 89.3 |
| MOSEv2(验证集) | J&Ḟ | 60.3 | 62.3 |
Ultralytics 会将 SAM 3.1 检查点(sam3.1_multiplex.pt)加载到 SAM 3 图像预测器中:SAM("sam3.1_multiplex.pt") 用于点和框提示,SAM3SemanticPredictor 用于文本和示例提示。目前尚不支持 Object Multiplex 视频跟踪,因此请继续将 sam3.pt 与 SAM3VideoPredictor 和 SAM3VideoSemanticPredictor 搭配使用。
架构#
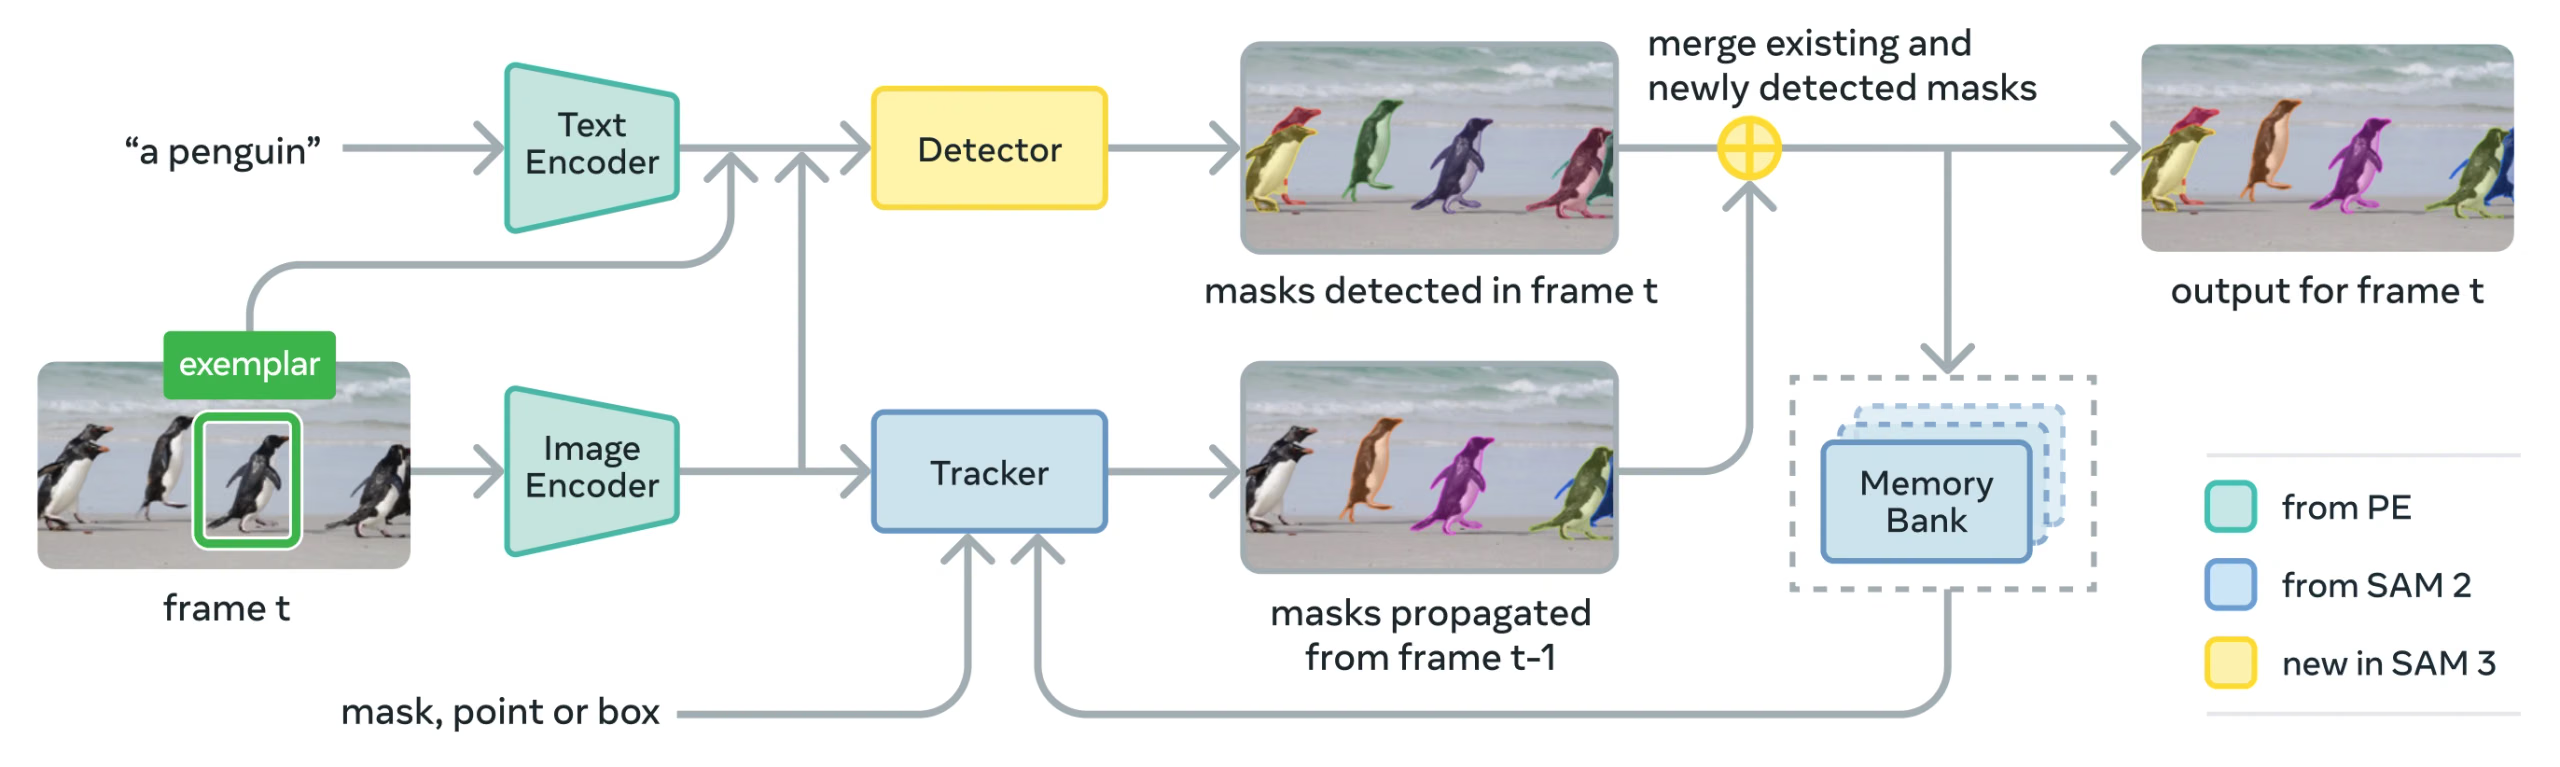
SAM 3 由检测器和跟踪器组成,两者共用 Perception Encoder(PE)视觉主干网络。这种解耦设计避免了任务冲突,同时支持图像级检测和视频级跟踪,并提供兼容 Ultralytics Python 用法和 CLI 用法的接口。
核心组件#
-
检测器:基于 DETR 的架构,用于图像级概念检测
- 用于名词短语提示的文本编码器
- 用于基于图像提示的示例编码器
- 用于根据提示调整图像特征的融合编码器
- 新颖的存在性检测头,将识别(“是什么”)与定位(“在哪里”)解耦
- 用于生成实例分割掩码的掩码头
-
跟踪器:继承自 SAM 2、基于记忆的视频分割
- 提示编码器、掩码解码器、记忆编码器
- 用于存储物体在各帧中外观信息的记忆库
-
存在性令牌:一个经过学习的全局令牌,用于预测目标概念是否出现在图像/帧中,通过将识别与定位分离来提升检测效果。
关键创新#
- 识别与定位解耦:存在性预测头全局预测概念是否存在,而提议查询仅关注定位,从而避免目标冲突。
- 统一概念提示与视觉提示:在单个模型中同时支持 PCS(概念提示)和 PVS(如 SAM 2 的点击/框等视觉提示)。
- 交互式示例优化:用户可以添加正面或负面图像示例,迭代优化结果;模型能够泛化到相似物体,而不只是修正单个实例。
- 时间消歧:使用掩码片段检测分数和定期重新提示来处理视频中的遮挡、拥挤场景和跟踪失败,符合实例分割与跟踪的最佳实践。
SA-Co 数据集#
SAM 3 使用 Segment Anything with Concepts (SA-Co) 进行训练,这是 Meta 迄今规模最大、最多样化的分割数据集,其范围超越了 COCO 和 LVIS 等常见基准。
训练数据#
| 数据集组成部分 | 说明 | 规模 |
|---|---|---|
| SA-Co/HQ | 由四阶段数据引擎生成的高质量人工标注图像数据 | 520 万张图像,400 万个独特名词短语 |
| SA-Co/SYN | 由 AI 标注、无需人工参与的合成数据集 | 3800 万个名词短语,14 亿个掩码 |
| SA-Co/EXT | 15 个经过难负样本扩充的外部数据集 | 因来源而异 |
| SA-Co/VIDEO | 带有时间跟踪标注的视频 | 5.25 万个视频,2.48 万个独特名词短语 |
基准数据#
SA-Co 评估基准包含 21.4 万个独特短语,涵盖 12.6 万张图像和视频,概念数量超过现有基准的 50 倍。其中包括:
- SA-Co/Gold:涵盖 7 个领域,采用三重标注,用于衡量人类表现上限
- SA-Co/Silver:涵盖 10 个领域,采用单人标注
- SA-Co/Bronze 和 SA-Co/Bio:改编自 9 个现有数据集,用于概念分割
- SA-Co/VEval:包含 3 个领域的视频基准(SA-V、YT-Temporal-1B、SmartGlasses)
数据引擎创新#
SAM 3 可扩展的人类与模型协同数据引擎通过以下方式实现 2 倍标注吞吐量:
- AI 标注器:基于 Llama 的模型会提出多样的名词短语,包括难负样本
- AI 验证器:经过微调的多模态 LLM 以接近人类的表现验证掩码质量和完整性
- 主动挖掘:将人工精力集中在 AI 难以应对的棘手失败案例上
- 由本体驱动:使用基于 Wikidata 构建的大型本体来覆盖各类概念
安装#
安装或升级 ultralytics 包:
pip install -U ultralytics与其他 Ultralytics 模型不同,SAM 3 权重(sam3.pt)不会自动下载。你必须先在 Hugging Face 上的 SAM 3 模型页面申请模型权重访问权限,然后在获批后从该页面下载 sam3.pt。将下载的 sam3.pt 文件放在工作目录中,或在加载模型时指定完整路径。
SAM 3.1 权重(sam3.1_multiplex.pt)也采用相同的访问限制,请前往 SAM 3.1 模型页面申请访问。在下方图像示例中使用 sam3.pt 的任何位置,都可以传入 sam3.1_multiplex.pt。
如果你在预测时遇到上述错误,说明你安装了错误的 clip 包。运行以下命令安装正确的 clip 包:
pip uninstall clip -y
pip install git+https://github.com/ultralytics/CLIP.git
如何使用 SAM 3:概念分割的多功能性#
SAM 3 通过不同的预测器接口支持可提示概念分割(PCS)和可提示视觉分割(PVS)任务:
支持的任务和模型#
| 任务类型 | 提示类型 | 输出 |
|---|---|---|
| 概念分割(PCS) | 文本(名词短语)、图像示例 | 与该概念匹配的所有实例 |
| 视觉分割(PVS) | 点、框、掩码 | 单个物体实例(SAM 2 风格) |
| 交互式细化 | 迭代添加/移除示例或点击 | 精度更高的优化分割结果 |
概念分割示例#
使用文本提示进行分割#
使用文本描述查找并分割某个概念的所有实例。文本提示需要使用 SAM3SemanticPredictor 接口。
from ultralytics.models.sam import SAM3SemanticPredictor

# 使用配置初始化预测器
overrides = {
    "conf": 0.25,
    "task": "segment",
    "mode": "predict",
    "model": "sam3.pt",
    "quantize": 16,  # 使用 FP16 加快推理
    "save": True,
}
predictor = SAM3SemanticPredictor(overrides=overrides)

# 设置一次图像以供多次查询
predictor.set_image("path/to/image.jpg")

# 使用多个文本提示进行查询
results = predictor(text=["person", "bus", "glasses"])

# 适用于描述性短语
results = predictor(text=["person with red cloth", "person with blue cloth"])

# 使用单个概念进行查询
results = predictor(text=["a person"])使用图像示例进行分割#
将边界框用作视觉提示,以查找所有相似实例。基于概念的匹配同样需要使用 SAM3SemanticPredictor。
from ultralytics.models.sam import SAM3SemanticPredictor

# 初始化预测器
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "model": "sam3.pt", "quantize": 16, "save": True}
predictor = SAM3SemanticPredictor(overrides=overrides)

# 设置图像
predictor.set_image("path/to/image.jpg")

# 提供边界框示例以分割相似物体
results = predictor(bboxes=[[480.0, 290.0, 590.0, 650.0]])

# 使用多个边界框作为同一视觉概念的示例
results = predictor(bboxes=[[539, 599, 589, 639], [343, 267, 499, 662]])基于特征的高效推理#
只需提取一次图像特征,即可在多次分割查询中重复利用,从而提升效率。
import cv2

from ultralytics.models.sam import SAM3SemanticPredictor
from ultralytics.utils.plotting import Annotator, colors

# 初始化预测器
overrides = {"conf": 0.50, "task": "segment", "mode": "predict", "model": "sam3.pt", "verbose": False}
predictor = SAM3SemanticPredictor(overrides=overrides)
predictor2 = SAM3SemanticPredictor(overrides=overrides)

# 从第一个预测器提取特征
source = "path/to/image.jpg"
predictor.set_image(source)
src_shape = cv2.imread(source).shape[:2]

# 设置第二个预测器并重复利用特征
predictor2.setup_model()

# 使用共享特征和文本提示执行推理
masks, boxes = predictor2.inference_features(predictor.features, src_shape=src_shape, text=["person"])

# 使用共享特征和边界框提示执行推理
masks, boxes = predictor2.inference_features(predictor.features, src_shape=src_shape, bboxes=[[439, 437, 524, 709]])

# 可视化结果
if masks is not None:
    masks, boxes = masks.cpu().numpy(), boxes.cpu().numpy()
    im = cv2.imread(source)
    annotator = Annotator(im, pil=False)
    annotator.masks(masks, [colors(x, True) for x in range(len(masks))])

    cv2.imshow("result", annotator.result())
cv2.waitKey(0)视频概念分割#
使用边界框跨视频跟踪概念#
使用边界框提示检测并跟踪视频帧中的物体实例。
from ultralytics.models.sam import SAM3VideoPredictor

# 创建视频预测器
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "model": "sam3.pt", "quantize": 16}
predictor = SAM3VideoPredictor(overrides=overrides)

# 使用边界框提示跟踪物体
results = predictor(source="path/to/video.mp4", bboxes=[[706.5, 442.5, 905.25, 555], [598, 635, 725, 750]], stream=True)

# 处理并显示结果
for r in results:
r.show() # 显示带有分割掩码的帧使用文本提示跟踪概念#
跨视频帧跟踪文本指定概念的所有实例。
from ultralytics.models.sam import SAM3VideoSemanticPredictor

# 初始化语义视频预测器
overrides = {
    "conf": 0.25,
    "task": "segment",
    "mode": "predict",
    "imgsz": 640,
    "model": "sam3.pt",
    "quantize": 16,
    "save": True,
}
predictor = SAM3VideoSemanticPredictor(overrides=overrides)

# 使用文本提示跟踪概念
results = predictor(source="path/to/video.mp4", text=["person", "bicycle"], stream=True)

# 处理结果
for r in results:
    r.show()  # 显示带有跟踪对象的帧

# 替代方案:使用边界框提示进行跟踪
results = predictor(
    source="path/to/video.mp4",
    bboxes=[[864, 383, 975, 620], [705, 229, 782, 402]],
    labels=[1, 1],  # 正标签
    stream=True,
)
视觉提示(兼容 SAM 2)#
SAM 3 与 SAM 2 的单物体分割视觉提示完全向后兼容:
基础 SAM 接口的行为与 SAM 2 完全相同,只分割视觉提示(点、框或掩码)所指示的特定区域。
from ultralytics import SAM

model = SAM("sam3.pt")

# 单点提示 - 在指定位置分割对象
results = model.predict(source="path/to/image.jpg", points=[900, 370], labels=[1])
results[0].show()

# 多点提示 - 根据多个点提示分割单个对象
results = model.predict(source="path/to/image.jpg", points=[[400, 370], [900, 370]], labels=[1, 1])

# 框提示 - 分割边界框内的对象
results = model.predict(source="path/to/image.jpg", bboxes=[100, 150, 300, 400])
results[0].show()使用 SAM("sam3.pt") 搭配视觉提示(点/框/掩码),只会分割该位置的特定对象,与 SAM 2 的效果相同。要分割某个概念的所有实例,请使用 SAM3SemanticPredictor 搭配文本或示例提示,如上所示。
性能基准测试#
图像分割#
SAM 3 在多个基准测试中取得了最先进的结果,其中包括 LVIS 和用于分割的 COCO等真实世界数据集:
| 基准测试 | 指标 | SAM 3 | 此前最佳 | 提升幅度 |
|---|---|---|---|---|
| LVIS(零样本) | 掩码 AP | 47.0 | 38.5 | +22.1% |
| SA-Co/Gold | CGF1 | 65.0 | 34.3(OWLv2) | +89.5% |
| COCO(零样本) | 框 AP | 53.5 | 52.2 (T-Rex2) | +2.5% |
| ADE-847(语义分割) | mIoU | 14.7 | 9.2 (APE-D) | +59.8% |
| PascalConcept-59 | mIoU | 59.4 | 58.5 (APE-D) | +1.5% |
| Cityscapes(语义分割) | mIoU | 65.1 | 44.2 (APE-D) | +47.3% |
在 Ultralytics 数据集中探索数据集选项,快速开展实验。
视频分割性能#
与 SAM 2 和此前的最先进模型相比,SAM 3 在 DAVIS 2017 和 YouTube-VOS 等视频基准测试中表现出显著提升:
| 基准测试 | 指标 | SAM 3 | SAM 2.1 L | 提升幅度 |
|---|---|---|---|---|
| MOSEv2 | J&F | 60.1 | 47.9 | +25.5% |
| DAVIS 2017 | J&F | 92.0 | 90.7 | +1.4% |
| LVOSv2 | J&F | 88.2 | 79.6 | +10.8% |
| SA-V | J&F | 84.6 | 78.4 | +7.9% |
| YTVOS19 | J&F | 89.6 | 89.3 | +0.3% |
少样本适配#
SAM 3 可通过少量示例适应新领域,这对于以数据为中心的 AI工作流很有帮助:
| 基准测试 | 零样本 AP | 10 样本 AP | 此前最佳(10 样本) |
|---|---|---|---|
| ODinW13 | 59.9 | 71.6 | 67.9 (gDino1.5-Pro) |
| RF100-VL | 14.3 | 35.7 | 33.7 (gDino-T) |
交互式优化效果#
SAM 3 基于概念的示例提示比视觉提示收敛快得多:
| 添加的提示 | CGF1 分数 | 相较于仅文本提示的提升 | 相较于 PVS 基线的提升 |
|---|---|---|---|
| 仅文本 | 46.4 | 基线 | 基线 |
| +1 个示例 | 57.6 | +11.2 | +6.7 |
| +2 个示例 | 62.2 | +15.8 | +9.7 |
| +3 个示例 | 65.0 | +18.6 | +11.2 |
| +4 个示例 | 65.7 | +19.3 | +11.5(趋于平稳) |
对象计数准确率#
SAM 3 通过分割所有实例实现准确计数,这是对象计数中的常见需求:
| 基准测试 | 准确率 | MAE | 相较于最佳 MLLM |
|---|---|---|---|
| CountBench | 95.6% | 0.11 | 92.4% (Gemini 2.5) |
| PixMo-Count | 87.3% | 0.22 | 88.8% (Molmo-72B) |
SAM 3、SAM 2 与 YOLO 对比#
这里将 SAM 3 的能力与 SAM 2 和 YOLO26 模型进行比较:
| 能力 | SAM 3 | SAM 2 | YOLO26n-seg |
|---|---|---|---|
| 概念分割 | ✅ 根据文本/示例分割所有实例 | ❌ 不支持 | ❌ 不支持 |
| 视觉分割 | ✅ 单个实例(兼容 SAM 2) | ✅ 单个实例 | ✅ 所有实例 |
| 零样本能力 | ✅ 开放词汇 | ✅ 几何提示 | ❌ 封闭集 |
| 交互式细化 | ✅ 示例 + 点击 | ✅ 仅点击 | ❌ 不支持 |
| 视频跟踪 | ✅ 多目标并带有身份标识 | ✅ 多目标 | ✅ 多目标 |
| LVIS 掩码 AP(零样本) | 47.0 | 不适用 | 不适用 |
| MOSEv2 J&F | 60.1 | 47.9 | 不适用 |
| 速度(GPU,毫秒/图像) | 2921 | 857 | 8.4 |
| 模型大小 | 3.45 GB | 162 MB(基础版) | 6.4 MB |
速度基准测试使用 NVIDIA RTX PRO 6000,搭配 torch==2.9.1 和 ultralytics==8.4.19 进行。
要点:
- SAM 3:最适合开放词汇概念分割,通过文本或示例提示查找某个概念的所有实例
- SAM 2:最适合使用几何提示对图像和视频中的单个对象进行交互式分割
- YOLO26:最适合实时高速分割,并可选择采用无 NMS 的端到端推理;可导出为多种格式,以便部署到 GPU、CPU 和边缘设备上
- YOLOE:最适合使用文本或视觉提示进行实时开放词汇检测和分割
SAM 与 YOLO 对比#
从模型大小、参数量和 GPU 推理速度方面,对比 SAM 3、SAM 2、SAM、MobileSAM 和 FastSAM 与 Ultralytics YOLO 分割模型(YOLOv8、YOLO11、YOLO26):
| 模型 | 大小 (MB) | 参数 (M) | 速度(GPU) (ms/im) |
|---|---|---|---|
| Meta SAM-b | 375 | 93.7 | 1306 |
| Meta SAM2-b | 162 | 80.8 | 857 |
| Meta SAM2-t | 78.1 | 38.9 | 668 |
| Meta SAM3 | 3450 | 473.6 | 2921 |
| MobileSAM | 40.7 | 10.1 | 605 |
| FastSAM-s 搭配 YOLOv8 主干网络 | 23.7 | 11.8 | 55.9 |
| Ultralytics YOLOv8n-seg | 6.7(小 515 倍) | 3.4(少 139.1 倍) | 17.4(快 167 倍) |
| Ultralytics YOLO11n-seg | 5.9(小 585 倍) | 2.9(少 163.1 倍) | 12.6(快 231 倍) |
| Ultralytics YOLO26n-seg | 6.4(小 539 倍) | 2.7(少 175.2 倍) | 8.4(快 347 倍) |
这项比较展示了 SAM 各变体与 YOLO 分割模型在模型大小和速度方面的显著差异。SAM 具备独特的自动分割能力,而 YOLO 模型,尤其是 YOLOv8n-seg、YOLO11n-seg 和 YOLO26n-seg,则更小、更快,计算效率也更高。
测试使用 NVIDIA RTX PRO 6000 和 96GB VRAM 运行 torch==2.9.1 和 ultralytics==8.4.19。要复现此测试:
from ultralytics import ASSETS, SAM, YOLO, FastSAM

# 分析 SAM3、SAM2-t、SAM2-b、SAM-b、MobileSAM 的性能
for file in ["sam_b.pt", "sam2_b.pt", "sam2_t.pt", "mobile_sam.pt", "sam3.pt"]:
    model = SAM(file)
    model.info()
    model(ASSETS)

# 分析 FastSAM-s 的性能
model = FastSAM("FastSAM-s.pt")
model.info()
model(ASSETS)

# 分析 YOLO 模型的性能
for file_name in ["yolov8n-seg.pt", "yolo11n-seg.pt", "yolo26n-seg.pt"]:
    model = YOLO(file_name)
    model.info()
model(ASSETS, nms=False) # YOLO26 的 NMS-free 头;对 YOLOv8/YOLO11 无操作评估指标#
SAM 3 引入了针对 PCS 任务的新指标,并补充了常见的 F1 分数、精确率和召回率等指标。
分类门控 F1(CGF1)#
结合定位与分类的主要指标:
CGF1 = 100 × pmF1 × IL_MCC
其中:
- pmF1(正类宏平均 F1):衡量正样本的定位质量
- IL_MCC(图像级马修斯相关系数):衡量二元分类准确率(“是否存在该概念?”)
为什么采用这些指标?#
传统 AP 指标没有考虑校准情况,因此模型在实际应用中难以使用。SAM 3 仅评估置信度高于 0.5 的预测,从而通过指标要求良好的校准效果,并模拟交互式预测和跟踪循环中的真实使用模式。
关键消融实验与见解#
存在性分支的影响#
存在性分支将识别与定位解耦,带来了显著提升:
| 配置 | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| 不使用存在性分支 | 57.6 | 0.77 | 74.7 |
| 使用存在性分支 | 63.3 | 0.82 | 77.1 |
存在性分支带来了 +5.7 的 CGF1 提升(+9.9%),主要改善了识别能力(IL_MCC +6.5%)。
困难负样本的影响#
| 每张图像中的困难负样本数 | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| 0 | 31.8 | 0.44 | 70.2 |
| 5 | 44.8 | 0.62 | 71.9 |
| 30 | 49.2 | 0.68 | 72.3 |
困难负样本对开放词汇识别至关重要,可将 IL_MCC 提高 54.5%(0.44 → 0.68)。
训练数据规模扩展#
| 数据来源 | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| 仅外部数据 | 30.9 | 0.46 | 66.3 |
| 外部数据 + 合成数据 | 39.7 | 0.57 | 70.6 |
| 外部数据 + 高质量数据 | 51.8 | 0.71 | 73.2 |
| 全部三种 | 54.3 | 0.74 | 73.5 |
高质量人工标注比单独使用合成数据或外部数据能带来更大的提升。有关数据质量实践的背景信息,请参阅数据收集与标注。
应用场景#
SAM 3 的概念分割能力支持以下新应用场景:
- 内容审核:在媒体库中查找特定类型内容的所有实例
- 电子商务:在商品目录图像中分割某一类型的所有商品,支持自动标注
- 医学影像:识别特定组织类型或异常的所有实例
- 自动驾驶系统:按类别跟踪所有交通标志、行人或车辆实例
- 视频分析:统计并跟踪所有穿着特定服装或执行特定动作的人
- 数据集标注:快速标注所有罕见物体类别的实例
- 科学研究:量化并分析符合特定标准的所有样本
SAM 3 Agent:扩展语言推理#
SAM 3 可与多模态大语言模型(MLLM)结合,以处理需要推理的复杂查询,其理念类似于 OWLv2 和 T-Rex 等开放词汇系统。
推理任务上的性能#
| 基准测试 | 指标 | SAM 3 Agent(Gemini 2.5 Pro) | 此前最佳 |
|---|---|---|---|
| ReasonSeg(验证集) | gIoU | 76.0 | 65.0(SoTA) |
| ReasonSeg(测试集) | gIoU | 73.8 | 61.3(SoTA) |
| OmniLabel(验证集) | AP | 46.7 | 36.5(REAL) |
| RefCOCO+ | Acc | 91.2 | 89.3(LISA) |
复杂查询示例#
SAM 3 Agent 能处理需要推理的查询:
- “坐着但手里没有拿礼品盒的人”
- “离摄像机最近且没有戴项圈的狗”
- “比人的手还大的红色物体”
MLLM 向 SAM 3 提出简单的名词短语查询,分析返回的掩码,并不断迭代直到满意为止。
局限性#
SAM 3 存在以下局限:
- 短语复杂度:最适合简单的名词短语;较长的指代表达或复杂推理可能需要集成 MLLM
- 歧义处理:某些概念本身仍存在歧义(例如“很小的窗户”“舒适的房间”)
- 计算需求:比 YOLO 等专用检测模型更大、速度更慢
- 词汇范围:专注于原子级视觉概念;没有 MLLM 协助时,组合推理能力有限
- 罕见概念:对于训练数据中代表性不足的极罕见或细粒度概念,性能可能下降
引用#
@misc{carion2025sam3,
  title         = {SAM 3: Segment Anything with Concepts},
  author        = {Nicolas Carion and Laura Gustafson and Yuan-Ting Hu and Shoubhik Debnath and Ronghang Hu and Didac Suris and Chaitanya Ryali and Kalyan Vasudev Alwala and Haitham Khedr and Andrew Huang and Jie Lei and Tengyu Ma and Baishan Guo and Arpit Kalla and Markus Marks and Joseph Greer and Meng Wang and Peize Sun and Roman R{\"a}dle and Triantafyllos Afouras and Effrosyni Mavroudi and Katherine Xu and Tsung-Han Wu and Yu Zhou and Liliane Momeni and Rishi Hazra and Shuangrui Ding and Sagar Vaze and Francois Porcher and Feng Li and Siyuan Li and Aishwarya Kamath and Ho Kei Cheng and Piotr Doll{\'a}r and Nikhila Ravi and Kate Saenko and Pengchuan Zhang and Christoph Feichtenhofer},
  year          = {2025},
  eprint        = {2511.16719},
  archivePrefix = {arXiv},
  primaryClass  = {cs.CV},
  url           = {https://arxiv.org/abs/2511.16719}
}常见问题#
SAM 3 由 Meta 于 2025 年 11 月 19 日发布,并已全面集成到
ultralytics软件包中,支持图像预测和通过专用预测器进行视频跟踪。是。SAM 3 已全面集成到 Ultralytics Python 软件包中,包括概念分割、SAM 2 风格的视觉提示和多目标视频跟踪。SAM 3 和 SAM 3.1 还为 Ultralytics Platform上的智能标注功能提供支持,其中 SAM 3.1 是默认模型,你只需点击几下即可标注图像。对于包含 1–200 个类别的检测数据集,SAM 3 Text和 SAM 3.1 Text还可以根据类别名称自动标注,VLM Leaderboard则会比较它们与视觉语言模型的精度。
支持图像预测。在本页的图像示例中,将
sam3.pt替换为sam3.1_multiplex.pt:点和框提示使用SAM("sam3.1_multiplex.pt"),文本和示例提示使用SAM3SemanticPredictor。目前尚不支持 Object Multiplex 视频跟踪,因此视频预测器仍需使用sam3.pt。Meta 的基准测试请参阅 SAM 3.1。PCS 是 SAM 3 引入的一项新任务,可分割图像或视频中某个视觉概念的所有实例。传统分割针对特定物体实例,而 PCS 会查找某个类别的每一次出现。例如:
- 文本提示:“黄色校车” → 分割场景中的所有黄色校车
- 图像示例:框选一只狗 → 分割图像中的所有狗
- 组合方式:"条纹猫" + 示例框 → 分割所有与示例匹配的条纹猫
特性 SAM 2 SAM 3 任务 每个提示对应一个对象 某个概念的所有实例 提示类型 点、框、掩码 + 文本短语、图像示例 检测能力 需要外部检测器 内置开放词汇检测器 识别 仅基于几何信息 文本和视觉识别 架构 仅跟踪器 检测器 + 带有存在性预测头的跟踪器 零样本性能 不适用(需要视觉提示) 在 LVIS 上达到 47.0 AP,在 SA-Co 上性能提升 2 倍 交互式细化 仅点击 点击 + 示例泛化 SAM 3 保持了与 SAM 2视觉提示的向后兼容性,同时新增了基于概念的能力。
SAM 3 使用万物皆可分割概念数据集(SA-Co)进行训练:
训练数据:
- 520 万张图像,包含400 万个独特名词短语(SA-Co/HQ)——高质量人工标注
- 5.25 万段视频,包含2.48 万个独特名词短语(SA-Co/VIDEO)
- 14 亿个合成掩码,涵盖3800 万个名词短语(SA-Co/SYN)
- 15 个外部数据集,经过难负样本扩充(SA-Co/EXT)
基准数据:
- 21.4 万个独特概念,涵盖12.6 万张图像/段视频
- 概念数量是现有基准的50 倍(例如,LVIS 包含约 4K 个概念)
- SA-Co/Gold 上的三重标注,用于衡量人类表现的上下界
这种规模和多样性支撑了 SAM 3 对开放词汇概念的零样本泛化能力。
SAM 3 和 YOLO26 适用于不同的使用场景:
SAM 3 的优势:
- 开放词汇:无需训练,通过文本提示即可分割任意概念
- 零样本:可立即处理新的类别
- 交互式:基于示例的细化可泛化到相似对象
- 基于概念:自动查找某个类别的所有实例
- 准确率:在 LVIS 零样本实例分割任务上达到 47.0 AP
YOLO26 的优势:
- 速度:推理速度快几个数量级,并可选用无需 NMS 的端到端预测头
- 效率:模型体积缩小 539 倍(6.4MB,相比 3.45GB)
- 资源友好:可在边缘设备和移动设备上运行
- 实时:针对生产环境部署进行了优化
建议:
- 如果你需要通过文本或示例描述的概念查找所有实例,请使用 SAM 3 进行灵活的开放词汇分割
- 如果类别预先已知,且需要高速生产环境部署,请使用 YOLO26
- 如果你需要使用几何提示进行交互式单对象分割,请使用 SAM 2
SAM 3 专为简单名词短语设计(例如,"红苹果"、"戴帽子的人")。对于需要推理的复杂查询,可将 SAM 3 与 MLLM 结合,构建 SAM 3 Agent:
简单查询(原生 SAM 3):
- "黄色校车"
- "条纹猫"
- "戴红帽子的人"
复杂查询(使用 MLLM 的 SAM 3 Agent):
- "坐着但没有拿礼盒的人"
- "离摄像机最近且没有戴项圈的狗"
- “比人的手还大的红色物体”
SAM 3 Agent 结合 SAM 3 的分割能力与 MLLM 的推理能力,在 ReasonSeg 验证集上达到 76.0 gIoU(此前最佳成绩为 65.0,提升 +16.9%)。
在采用三重人工标注的 SA-Co/Gold 基准上:
- 人类表现下界:74.2 CGF1(最保守的标注者)
- SAM 3 的表现:65.0 CGF1
- 达成水平:达到估算的人类表现下界的 88%
- 人类表现上界:81.4 CGF1(最宽松的标注者)
SAM 3 在开放词汇概念分割任务上的表现出色,接近人类准确度;差距主要体现在含糊或主观的概念上(例如,"小窗户"、"温馨的房间")。


评论105
提出问题、分享结果,或帮助其他人。
 Glenn JocherUltralytics(已编辑)
SAM 3 looks like a big step forward for open-vocabulary segmentation, and it is now supported natively in
ultralytics. This page covers text, exemplar and video prompts; thesam3.ptweights are gated and must be requested from Meta on Hugging Face first.Feel free to drop questions or comments for the team below!
7koolfox
Incredible, when you think it’s available for use?
2- Glenn JocherUltralytics(已编辑)
SAM 3 is available now in
ultralytics: runpip install -U ultralyticsand see this page for usage. Thesam3.ptweights must be requested from Meta first. Abdulhady-WITCo
Appreciate the effort, and can't wait for your implementation. It's resource heavy already but I'm sure your optimisation will make a difference. Best of luck.
- Glenn JocherUltralytics(已编辑)
Thanks for the kind words—most of the credit goes to the Meta SAM team and the Ultralytics community. SAM 3 is now available in
ultralytics, and this page covers exactly those trade-offs, so you can balance its open-vocabulary power against lighter options like YOLO26 or SAM 2 on your hardware.
mishaogui
sam3如何把預訓練模型導出onnx進行推理,目前官方好像還不支持導出,求導出和推理。
1- Glenn JocherUltralytics(已编辑)
目前
ultralytics里 SAM 3 只支持predict/track推理,还没有提供把sam3.pt导出 ONNX 的官方流程(yolo export主要面向 YOLO 等可部署导出管线的模型);建议先按 SAM 3 使用文档 用 PyTorch 方式部署推理。如果你的目标是 ONNX 部署分割(固定类别/已知类别),更推荐直接用可导出的 YOLO26 分割 并参考 Export 模式;若你这边是“必须 SAM3→ONNX”的需求,麻烦在 Ultralytics 新建 Issue 说明场景并附上
yolo checks和最小复现脚本,方便我们评估支持路径。
tomer196
Hi, thanks for the great work. I am trying to use sam3.1. Is it supported? I tried using sam3.1 weights, and it seems to work, but each frame the objects get new IDs. Am I doing something wrong? Thanks
- Glenn JocherUltralytics(已编辑)
SAM 3.1 is supported for image prediction: load
sam3.1_multiplex.ptwherever the image examples usesam3.pt(SAM("sam3.1_multiplex.pt")for point and box prompts,SAM3SemanticPredictorfor text and exemplar prompts). Object Multiplex video tracking is not supported yet, so usesam3.ptwithSAM3VideoPredictororSAM3VideoSemanticPredictor. For stable identities across frames, run a video predictor on the full video rather than image inference frame-by-frame, since per-frame inference assigns fresh IDs each time. See the SAM 3 docs and the SAM predictor reference, and if you’re already doing that please drop a minimal repro plusyolo checksoutput here so the team can take a closer look.
yccckid
你好,我测试下来输入的常见的类别的提示词(包括一些限定词)都是可以分割的。不过提示词输入得越多确实MLLM时间会更长,sam分割倒是挺快的。你说的这个“ 只有在单点(正负样本)和掩码提示(精细化粗糙掩码)是会出现分割源码出现零碎和空洞现象 ”是在分割什么物体?物体的表面纹理是不是比较sparsely textured?怎么解决的?谢谢
On Thu, 23 Apr 2026 at 09:11, Yiwang2333 @.***> wrote:
我之前使用MLLM与SAM3结合起来成为SAM 3 Agent进行测试并没有发现分割的掩码出现空洞问题,他们都是完整的,只不过会出现分割不了提示词中的内容,而且耗时这方面会增加,这也正常。只有在单点(正负样本)和掩码提示(精细化粗糙掩码)是会出现分割源码出现零碎和空洞现象
— Reply to this email directly, view it on GitHub https://github.com/orgs/ultralytics/discussions/22441?email_source=notifications&email_token=APKLLPPMDYK4F36HG6B3BOL4XFUUJA5CNFSNUABIM5UWIORPF5TWS5BNNB2WEL2ENFZWG5LTONUW63SDN5WW2ZLOOQXTCNRWG43TCMBVUZZGKYLTN5XKOY3PNVWWK3TUUVSXMZLOOSWGM33PORSXEX3DNRUWG2Y#discussioncomment-16677105, or unsubscribe https://github.com/notifications/unsubscribe-auth/APKLLPKUZ2OAWS3Y672TETD4XFUUJAVCNFSM6AAAAACJTVH7HGVHI2DSMVQWIX3LMV43URDJONRXK43TNFXW4Q3PNVWWK3TUHMYTMNRXG4YTANI . You are receiving this because you commented.Message ID: @.*** com>
- Glenn JocherUltralytics
这种情况更像是
SAM("sam3.pt")的视觉提示分割问题而不是概念分割本身:单点或粗掩码在细长边界、低对比度或稀疏纹理目标上更容易出现碎片和空洞,通常可通过增加正负点、改用更紧的框提示,或直接用SAM3SemanticPredictor做文本/示例提示来改善,相关用法见 SAM 3 文档;如果你愿意,也欢迎把一张示例图和最小复现代码直接发在这个讨论里,我们可以按你的具体 case 看看。 Yiwang2333
其实我也想把示例和代码文件展示出来,但是可能我太蠢了不知道怎么发在这个讨论中,我已急哭😭
- Glenn JocherUltralytics
没关系,直接发在这里就可以:图片可直接拖到评论框上传,代码按 GitHub Markdown 写法 用代码块贴出;如果文件太大,就先发一个最小复现示例,只保留
model初始化、输入图像、提示词和实际输出即可,例如:from ultralytics import SAM model = SAM("sam3.pt") results = model.predict("test.jpg", points=[900, 370], labels=[1]) print(results[0].masks.data.shape if results[0].masks is not None else None)如果暂时不方便传图,也可以先把异常现象和文字版输出贴出来,我们继续帮你看。
一、单点分割 import numpy as np import torch from PIL import Image from sam3.model_builder import build_sam3_image_model from sam3.model.sam3_image_processor import Sam3Processor
device = "cuda" if torch.cuda.is_available() else "cpu" sam3_pt_path = "sam3_model/sam3.pt"
model = build_sam3_image_model( bpe_path=None, checkpoint_path=sam3_pt_path, device=device, enable_inst_interactivity=True, load_from_HF=False, ) processor = Sam3Processor(model) model.eval()
pil_image = Image.open("test.jpg").convert("RGB") inference_state = processor.set_image(pil_image)
正样本(1) + 负样本(0),点数与标签一一对应
point_coords = np.array([ [900.0, 370.0], # 前景点:点在目标上 [800.0, 400.0], # 背景点:点在要排除的区域 ]) point_labels = np.array([1, 0])
masks, scores, logits = model.predict_inst( inference_state, point_coords=point_coords, point_labels=point_labels, multimask_output=True, ) best = masks[int(np.argmax(scores))] mask_np = best.cpu().numpy() if isinstance(best, torch.Tensor) else np.asarray(best) print(mask_np.shape)
二、交互式细化 import numpy as np import torch from PIL import Image from sam3.model_builder import build_sam3_image_model from sam3.model.sam3_image_processor import Sam3Processor
device = "cuda" if torch.cuda.is_available() else "cpu" sam3_pt_path = "sam3_model/sam3.pt"
model = build_sam3_image_model( bpe_path=None, checkpoint_path=sam3_pt_path, device=device, enable_inst_interactivity=True, load_from_HF=False, ) processor = Sam3Processor(model) model.eval()
pil_image = Image.open("test.jpg").convert("RGB") inference_state = processor.set_image(pil_image)
若需要文本提示(与 demo 一致):
inference_state = processor.set_text_prompt(state=inference_state, prompt="your english prompt")
init_x = 900.0 init_y = 370.0 refinement_points = [[910.0, 380.0], [920.0, 360.0]] refinement_labels = [1, 0]
all_points = [[init_x, init_y]] + refinement_points all_labels = [1] + refinement_labels
masks, scores, logits = model.predict_inst( inference_state, point_coords=np.array(all_points), point_labels=np.array(all_labels), multimask_output=True, ) best = masks[int(np.argmax(scores))] mask_np = best.cpu().numpy() if isinstance(best, torch.Tensor) else np.asarray(best) print(mask_np.shape)
测试使用的是同一张图片,分割的内容是图中汽车,在单点分割和交互式细化中正负样本点结合使用会出现分割车辆边缘出现参差不齐零碎现象
- Glenn JocherUltralytics
感谢把代码贴出来,这更像是交互式点提示的行为而不是“汽车”这个类别本身:车窗反光、轮胎空隙和细长边界会让负点一旦靠近车身就容易把掩码边缘切碎或挖空,而且
multimask_output=True返回的最高分候选也不一定是最平滑的那个;建议先把负点移到目标外更远的位置、在断裂边缘补几个正点,或直接改用框/示例提示,如果你的目标是稳定分割整辆车,SAM3SemanticPredictor的文本/示例提示通常比稀疏点提示更稳,相关接口可参考 SAM 3 文档里的视觉提示与概念分割说明。 感谢您的回答,我还有一个问题,就是文本提示分割时,文本提示词可以对多张图片起作用,能做输入一个文本可以对所有图片进行分割,这一个功能已经实现。 但是有一个我实在是难以实现,就是比如有多张图片A、B、C、D...,在纯框选示例提示分割下,能不能做到只在A图上进行框选,然后进行纯框选示例提示分割时可以对A、B、C、D...多张图片进行分割呢。也就是实现一批图片中,只在一张图片上进行框选就能进行所有图片的分割,类似于图片搜索一样,在一批图片中随机挑一张图片,在这张挑选的图片中框选出汽车然后所有图片中的汽车都能被分割出来(类似在一批图片中框选后搜索出有汽车的图片进行分割)。我不知道这个功能是否能做到。 目前我使用的方法是在框选时将框选的目标进行切块,然后拼接在每一张待搜索图片上,最后根据拼接图片中的小目标切块进行示例提示分割,来实现一张图中框选能对所有图片进行分割,不过这种方法的效果有些一般,有时候分割不到东西或者是遗漏一些需要分割的目标。 还有一种方法是评论区向我提供的思路,将几何特征缓存下来,然后再另一张图片上应用这个几何特征,参考https://github.com/leon0514/trt-sam3,但是这位先生也提到了效果不好,目前我也正在尝试实现这种方法。 或者是理解在单图时框选示例提示分割到底在做什么,然后将这个行为重复作用于其他图片,这样是否也能实现呢?
- Glenn JocherUltralytics
目前原生
SAM3SemanticPredictor还不支持“在 A 图框一次,然后直接对 B/C/D 这类独立图片做纯示例检索+分割”;bboxes示例提示是作用在当前set_image()的那张图上,而文档里的inference_features()也是复用同一张图的特征、不是跨图迁移,所以更可靠的做法还是先用文本提示或检索/检测筛出候选图,再逐张做 SAM 3 分割,接口细节可参考 SAM3SemanticPredictor 参考。 好的,谢谢您的回复
shspc
ultralytics支持从其他图像中抽取特征作为视觉提示吗
在SAM3中
- Glenn JocherUltralytics
目前公开接口里,SAM 3 支持用
SAM3SemanticPredictor的bboxes做 exemplar 式视觉提示,也支持用inference_features()复用已提取特征,但文档里的用法主要是对当前图像做特征复用,不是直接把“另一张图像”的特征当作 prompt 传入;你可以先参考 SAM 3 文档 和 predictor API,如果你的目标是跨图像 exemplar prompting,欢迎把最小复现流程贴在这里,团队会继续看。 aoaoy288-oss
想知道,sam3是否能导成ONNX等格式
ZePequeno25
gostei bastante da para integrar diferentes modelos
SWTZJD
想请问SAM3最低支持的python版本和pytorch版本
- Glenn JocherUltralytics
欢迎直接把环境信息贴在这里,团队会看到;按目前公开信息,
SAM 3自ultralytics>=8.3.237起已集成,而ultralytics的基础要求是 Python>=3.8、PyTorch>=1.8,所以SAM 3目前至少按这组版本起步,参考 SAM 3 文档 和 Ultralytics PyPI 安装说明。 (docs.ultralytics.com)
cyt1990cyt1990-dev
运行环境为:Ultralytics 8.4.21 Python-3.11.8 torch-2.5.1+cu121 CUDA:0 (NVIDIA GeForce RTX 4070, 12282MiB) 运行使用掩码提示的概念分割的示例程序报错如下:WARNING imgsz=[640] must be multiple of max stride 14, updating to [644] Traceback (most recent call last): File "C:\Users\admin\PycharmProjects\PythonProject\testMasks.py", line 12, in results = predictor(source=img_path, masks=[rough]) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\engine\predictor.py", line 225, in call return list(self.stream_inference(source, model, *args, **kwargs)) # merge list of Results into one ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\utils_contextlib.py", line 36, in generator_context response = gen.send(None) ^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\engine\predictor.py", line 330, in stream_inference preds = self.inference(im, *args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 205, in inference return self.prompt_inference(im, bboxes, points, labels, masks, multimask_output) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 236, in prompt_inference return self._inference_features(features, *prompts, multimask_output) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 814, in _inference_features pred_masks, pred_scores, _, _ = self.model.sam_mask_decoder( ^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\nn\modules\module.py", line 1736, in _wrapped_call_impl return self._call_impl(*args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\nn\modules\module.py", line 1747, in _call_impl return forward_call(*args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\modules\decoders.py", line 334, in forward masks, iou_pred, mask_tokens_out, object_score_logits = self.predict_masks( ^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\modules\decoders.py", line 398, in predict_masks src = src + dense_prompt_embeddings ~~~~^~~~~~~~~~~~~~~~~~~~~~~~~ RuntimeError: The size of tensor a (46) must match the size of tensor b (161) at non-singleton dimension 3
运行代码如下所示: import cv2 import numpy as np from ultralytics.models.sam import SAM3Predictor
predictor = SAM3Predictor(overrides=dict(task="segment", mode="predict", model="sam/sam3.pt")) img_path = "测试图片/测试图片1/Out.jpg" rough = cv2.imread("测试图片/测试图片1/rough.jpg", cv2.IMREAD_GRAYSCALE) rough = (rough > 0).astype(np.uint8)
results = predictor(source=img_path, masks=[rough]) for result in results: annotated_img = result.plot() cv2.imshow("SAM with Mask Prompt", annotated_img) cv2.waitKey(0) cv2.destroyAllWindows()
图片Out.jpg,rough.jpg是大小为4024*3036,位深度为8的灰度图片
- Glenn JocherUltralytics
感谢补充代码,这个报错看起来不是图片分辨率本身的问题,而是
SAM3Predictor走masks=提示时出现了特征尺寸不匹配;按 SAM 3 文档 当前概念分割应使用SAM3SemanticPredictor配合text或示例bboxes,而SAM("sam3.pt")/SAM3Predictor主要是单对象视觉提示流程。若你在最新版本下仍需要masks提示,请新开一个 issue 并附上yolo checks输出、完整文本回溯和最小可复现脚本,方便我们确认这是否是 SAM 3 的一个 bug。
max-dev-14
I'd compared facebook/sam3 and ultralytics/sam3. I set up both the models for inference as follow: imgsz=1008, half=True, conf=0.5 and prompts = [ "person", "car", "truck", "tractor", "building", "combine harvester", "power lines", "clear sky", "trees", "crop field", "harvested field", "grassy field", "dark frame edges", "farm lane", "windrow" ] I'd attached scripts I used for inference: ul-sam3.py - ultralytics/sam3 inference. fb-sam3.py - facebook/sam3 inference.
I expected that there would be the same results of inference on the same videos and paramteres above. But I'd got different segments, as it can be seen on the screens below (there are original frame to the left, facebook/sam3 segmentation on the middle and ultralytics/sam3 segmentation to the right).
Can someone explain me why it's happened like this?
- Glenn JocherUltralytics
Thanks for raising it here — exact parity with
facebookresearch/sam3isn’t expected, because the Ultralytics integration uses its own SAM 3 predictor path for resizing/preprocessing and postprocessing, so matchingimgsz,half,conf, and prompts alone won’t guarantee identical masks; see the SAM 3 docs and the predictor reference. If you’d like us to check whether this is a bug rather than an implementation difference, please open a new issue with a minimal reproducible example, confirm both runs use the samesam3.pt, and includeyolo checksplus the full text outputs from both scripts.