تُعد مجموعة بيانات PASCAL VOC (فئات الأجسام المرئية) معيارًا كلاسيكيًا لـالكشف عن الأجسام، وتضم 20 فئة من الأجسام اليومية. يجمع إعداد Ultralytics VOC.yaml تقسيمي trainval لـVOC2007 وVOC2012 في مجموعة تدريب من 16,551 صورة، ويُجري التحقق على صور اختبار VOC2007 الأربع 4,952 المشروحة علنًا، وينزّل كل شيء تلقائيًا (2.8 GB) عند الاستخدام الأول.
شاهد: كيفية تدريب Ultralytics YOLO على مجموعة بيانات Pascal VOC | اكتشاف الكائنات | الرؤية الحاسوبية 🚀
أُجريت تحديات PASCAL VOC من 2005 إلى 2012، وأسهمت في تشكيل أساليب تقييم نماذج الكشف عن الأجسام: إذ يشمل المعيار مهام تصنيف الصور والكشف والتقسيم، وروّج لمقياس متوسط الدقة (mAP) بوصفه مقياس الكشف القياسي. ويستخدم إعداد Ultralytics VOC.yaml تعليقات الكشف التوضيحية، محولًا صناديق الإحاطة الأصلية بصيغة XML إلى تنسيق YOLO أثناء التنزيل.
صور اختبار VOC2007 نفسها — لا يحدد الإعداد تقسيمًا منفصلًا للاحتفاظ به
نُشرت التعليقات التوضيحية لاختبار VOC2007 علنًا بعد تحدي ذلك العام، ما يتيح استخدام هذا التقسيم كمجموعة تحقق موسومة. أما التعليقات التوضيحية لاختبار VOC2012 فما تزال محجوبة؛ ولا يمكن تقييم النتائج عليها إلا عبر خادم تقييم PASCAL الرسمي، لذا فهي غير مشمولة في هذا الإعداد.
استبعاد الأجسام الصعبة
يتخطى المحوّل التلقائي الأجسام الموسومة بـdifficult في تعليقات VOC التوضيحية الأصلية بصيغة XML؛ لذلك تختلف أعداد العينات لكل فئة قليلًا عن إحصاءات VOC الرسمية.
استكشف VOC على منصة Ultralytics لتصفح الصور مع طبقات التعليقات التوضيحية، والاطلاع على توزيع الفئات والخرائط الحرارية لصناديق الإحاطة في علامة التبويب المخططات، واستنساخ مجموعة البيانات لتدريب نموذجك الخاص على السحابة.
كان PASCAL VOC المعيار الأساسي لأبحاث الكشف عن الأجسام قبل ظهور مجموعة بيانات COCO الأكبر حجمًا: فقد نشرت كواشف مثل Faster R-CNN وSSD نتائجها الأصلية عليه، كما تتدرب نماذج Ultralytics YOLO عليه مباشرةً. وما يزال شائعًا اليوم في:
مقارنة بُنى الكشف الجديدة بسجل طويل من النتائج المرجعية المنشورة
التجارب السريعة والمقررات الدراسية — فالتدريب على 16,551 صورة يستغرق وقتًا أقل بكثير من التدريب على COCO
دراسات التعلّم بالنقل على مجموعة مدمجة ومفهومة جيدًا من الفئات اليومية
يُنزل VOC تلقائيًا عند بدء التدريب للمرة الأولى — ثلاثة أرشيفات يبلغ مجموع حجمها 2.8 GB — ويتطلب نحو 6 GB من المساحة الحرة على القرص أثناء فك الضغط والتحويل.
لتدريب نموذج YOLO26n على مجموعة بيانات VOC لمدة 100 حقبة وبحجم صورة 640، يمكنك استخدام مقتطفات الشيفرة التالية.
مثال على التدريب
from ultralytics import YOLO
# تحميل نموذج
model = YOLO("yolo26n.pt") # تحميل نموذج مدرّب مسبقًا (موصى به للتدريب)
# درّب النموذج - ستُنزل مجموعة البيانات تلقائيًا عند التشغيل الأول
results = model.train(data="VOC.yaml", epochs=100, imgsz=640)
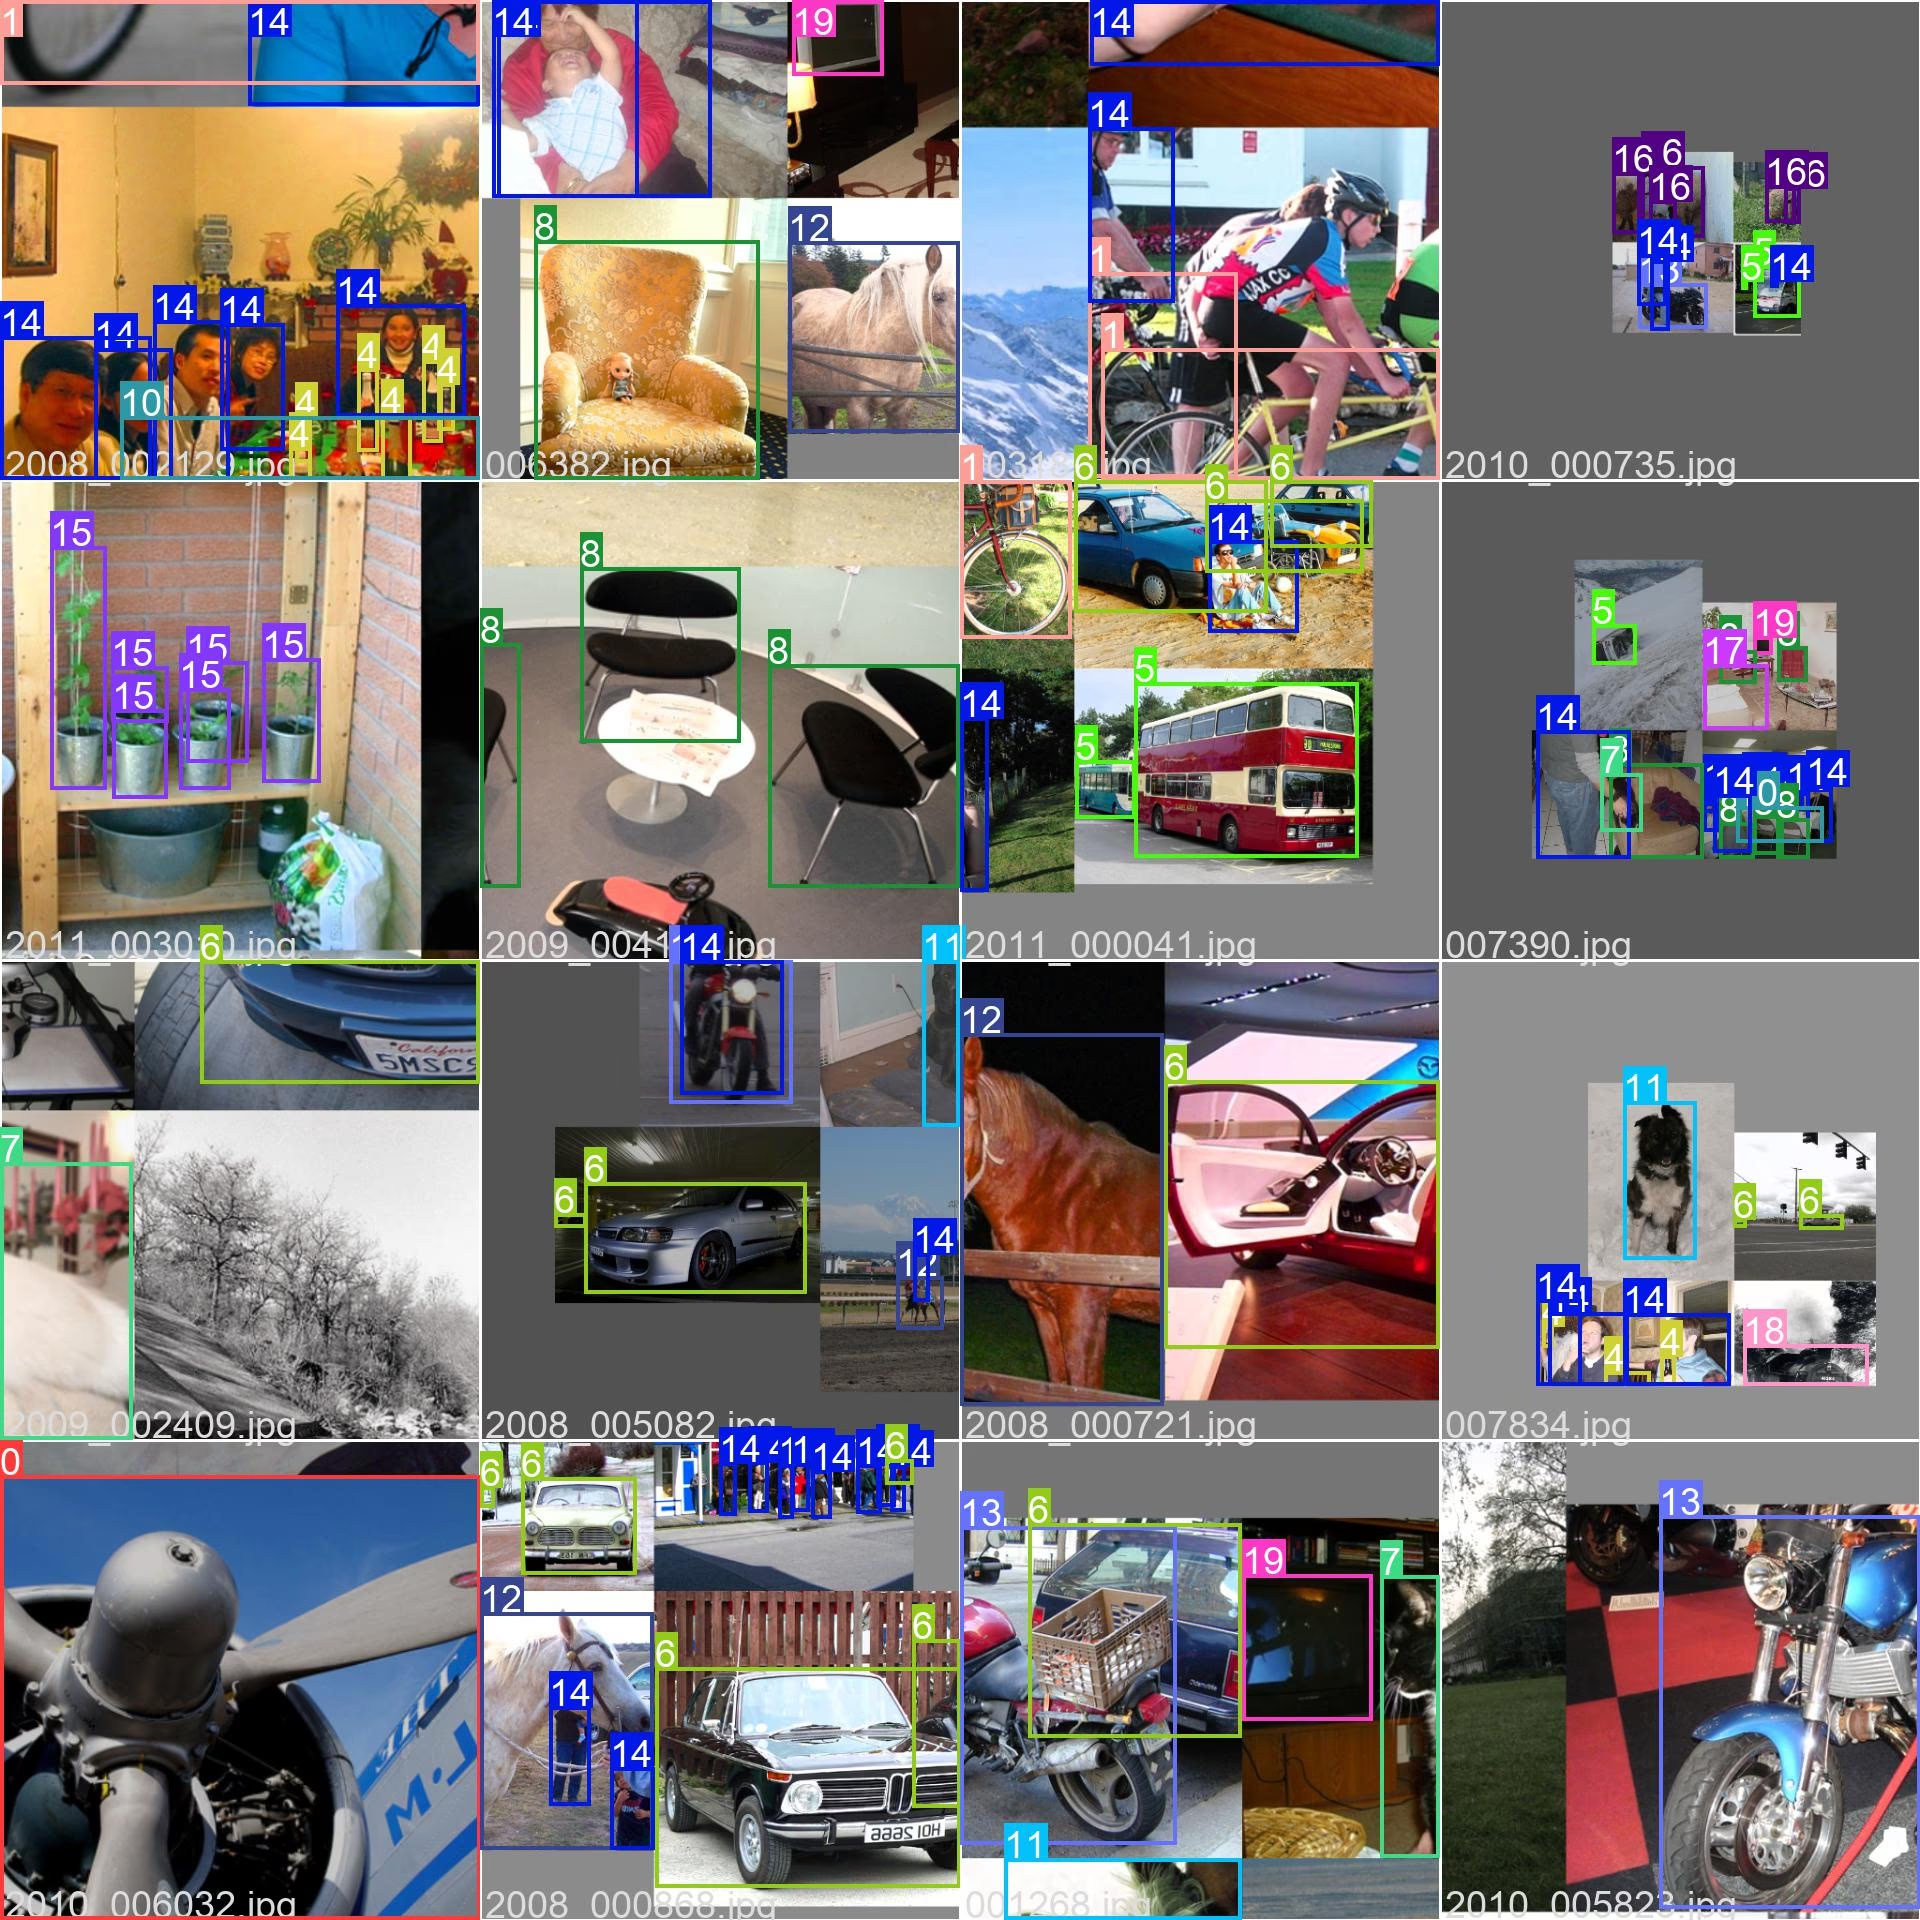
تعرض الصورة أدناه دفعة تدريب مُركّبة من مجموعة بيانات VOC. يجمع التركيب عدة صور في عينة تدريب واحدة، ما يزيد تنوع الكائنات والمقاييس وسياقات المشاهد التي يراها النموذج في كل دفعة — راجع دليل زيادة بيانات YOLO للاطلاع على التفاصيل.
إذا استخدمت مجموعة بيانات VOC في أبحاثك أو أعمال التطوير، فيُرجى الاستشهاد بالورقة البحثية التالية:
الاستشهاد
@article{everingham2010pascal,
  author={Everingham, Mark and Van Gool, Luc and Williams, Christopher K. I. and Winn, John and Zisserman, Andrew},
  journal={International Journal of Computer Vision},
  title={The Pascal Visual Object Classes (VOC) Challenge},
  year={2010},
  volume={88},
  number={2},
  pages={303-338},
  doi={10.1007/s11263-009-0275-4}}
نود أن نشكر اتحاد PASCAL VOC على إنشاء هذا المورد القيّم وصيانته لصالح مجتمع الرؤية الحاسوبية. لمزيد من المعلومات حول مجموعة بيانات VOC والقائمين عليها، تفضل بزيارة موقع مجموعة بيانات PASCAL VOC.
تُستخدم PASCAL VOC لتدريب نماذج اكتشاف الكائنات وقياس أدائها على 20 فئة من الكائنات اليومية، مثل الأشخاص والسيارات والكلاب والكراسي. ولأنها مدمجة وموسومة بالكامل ومدعومة بخطوط أساس منشورة على مدى سنوات، فهي خيار شائع للتحقق من الهياكل الجديدة وإجراء تجارب المقررات الدراسية ودراسات التعلم بالنقل السريعة.
يحتوي إعداد Ultralytics لـ VOC على 21,503 صورة: 16,551 للتدريب (مجموعتا VOC2007 trainval وVOC2012 trainval) و4,952 للتحقق (مجموعة اختبار VOC2007). وتشترك جميع التقسيمات في الفئات العشرين نفسها. راجع بنية مجموعة البيانات للاطلاع على التفاصيل الكاملة.
يُنزل VOC تلقائيًا عند التدريب باستخدام data="VOC.yaml" للمرة الأولى — ولا حاجة إلى أي خطوات يدوية. يجلب البرنامج النصي ثلاثة أرشيفات (2.8 GB) من أصول إصدارات Ultralytics على GitHub، ويحوّل التعليقات التوضيحية بتنسيق XML إلى تنسيق YOLO.
درّب نموذج YOLO26n على VOC لمدة 100 حقبة وبحجم صورة 640:
مثال على التدريب
from ultralytics import YOLO
# تحميل نموذج
model = YOLO("yolo26n.pt") # تحميل نموذج مدرّب مسبقًا (موصى به للتدريب)
# تدريب النموذج
results = model.train(data="VOC.yaml", epochs=100, imgsz=640)
يشترك التحديان في الفئات العشرين نفسها، لكنهما يقدّمان صورًا مختلفة. توفر VOC2007 عدد 5,011 صورة trainval، إضافة إلى مجموعة اختبار تضم 4,952 صورة وتعليقاتها التوضيحية متاحة للعامة؛ أما VOC2012 فتوفّر 11,540 صورة trainval، بينما تُحجب التعليقات التوضيحية لمجموعة الاختبار ولا تُقيّم إلا عبر خادم التقييم الرسمي. يدمج VOC.yaml من Ultralytics مجموعتي trainval للتدريب، ويجري التحقق باستخدام مجموعة اختبار VOC2007.
VOC أصغر وأبسط: 20 فئة و21,503 صورة، مقابل 80 فئة و330K صورة في COCO. ويُبلّغ تقليديًا عن نتائج VOC بمقياس mAP عند 0.5 IoU، بينما يحسب COCO متوسط mAP عبر عتبات IoU من 0.5 إلى 0.95. ويُدرَّب نموذج VOC بسرعة أكبر، ما يجعله مناسبًا للتجارب السريعة؛ أما مجموعة بيانات COCO فهي المعيار لقياس الأداء على نطاق الإنتاج.
لا — VOC.yaml إعداد مخصص للاكتشاف فقط: إذ يستخرج المحوّل صناديق الإحاطة من تعليقات VOC التوضيحية بتنسيق XML، ولا يحوّل أقنعة التجزئة المضمنة في المعيار الأصلي. لتدريب نموذج لتجزئة الكائنات، استخدم مجموعة بيانات ذات تسميات مضلعية مثل COCO-Seg مع نموذج YOLO26n-seg.
raise RuntimeError(emojis(f"Dataset '{clean_url(self.args.data)}' error ❌ {e}")) from e
RuntimeError: Dataset 'VOC.yaml' error ❌ [Errno 2] No such file or directory: '/home/diana/Code/test/datasets/VOC/images/VOCdevkit/VOC2007/ImageSets/Main/train.txt'
Nice find on the root cause. To clean things up, delete the incomplete datasets/VOC folder and run your yolo ... data=VOC.yaml command again so the download/conversion script can fully re-download and unpack everything; if you still hit a path error after that, please share the full command and complete traceback so we can take a closer look.
Respectively, "xmin/ymin" and "xmax/ymax" are the coordinates of the upper-left and lower-right corners of the object.
How can I use this dataset to train the YoloV11 neural network?
@YustasDev to train YOLO26 on your Pascal VOC dataset, you need to convert the XML annotations to YOLO format (class, x_center, y_center, width, height in normalized coordinates). Use the conversion script provided in the VOC.yaml file under the "Download script/URL" section. Once converted, define a custom YAML file for your dataset paths and run the training using:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(data="your_dataset.yaml", epochs=100, imgsz=640)
Respectively, "xmin/ymin" and "xmax/ymax" are the coordinates of the upper-left and lower-right corners of the object.
How can I use this dataset to train the YoloV11 neural network?
@YustasDev to use your Pascal VOC dataset for YOLO26 training, you need to convert the XML annotations to YOLO format (class, x_center, y_center, width, height with normalized coordinates). You can adapt the XML-to-YOLO conversion script from the VOC dataset documentation here: https://docs.ultralytics.com/datasets/detect/voc/. Once converted, create a dataset YAML file similar to VOC.yaml, specifying your paths and classes, and then start training using yolo detect train data=your_dataset.yaml model=yolo26n.pt. Let me know if you encounter any issues!
تساعدنا ملفات تعريف الارتباط على معرفة الوثائق والنماذج والميزات التي تجدها مفيدة، لنواصل تحسينها. اختر ما تشاركه من خلال ، أو اقرأ سياسة الخصوصية.


mengdxiran
 Glenn JocherUltralytics
YustasDev