SAM 3: تقسيم أي شيء باستخدام المفاهيم
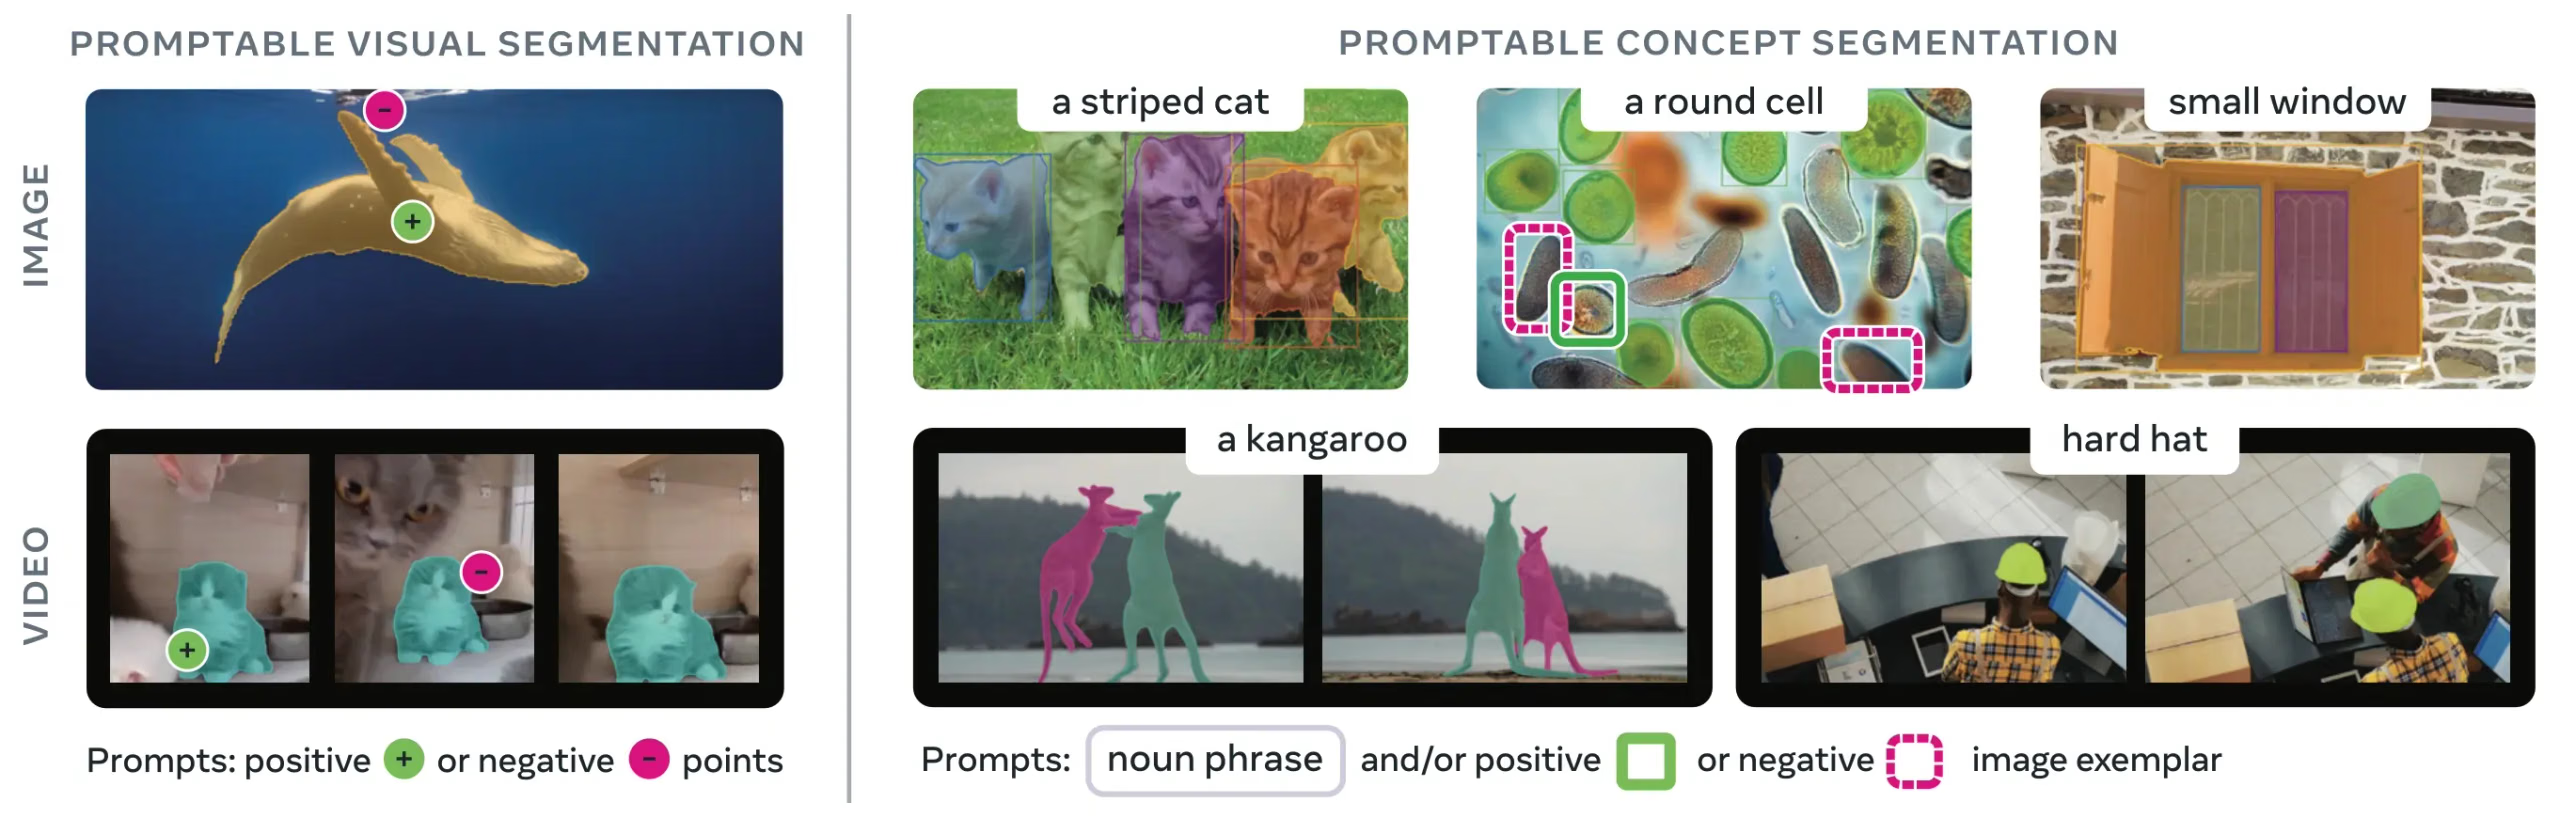
SAM 3 (نموذج تقسيم كل شيء 3) هو نموذج أساسي من Meta لمهمة تقسيم المفاهيم القابل للتوجيه (PCS). واستنادًا إلى SAM 2، يقدم SAM 3 قدرة جديدة: اكتشاف جميع الحالات لمفهوم مرئي تحدده المطالبات النصية أو أمثلة الصور أو كلاهما، وتقسيمها وتتبعها. وعلى خلاف إصدارات SAM السابقة التي تقسّم جسمًا واحدًا لكل مطالبة، يستطيع SAM 3 العثور على كل ظهور لمفهوم ما في الصور أو مقاطع الفيديو وتقسيمه، بما يتوافق مع أهداف المفردات المفتوحة في تقسيم الكائنات الحديث.
شاهد: كيفية استخدام Meta Segment Anything 3 مع Ultralytics | التقسيم بتوجيه نصي على الصور ومقاطع الفيديو
تم دمج SAM 3 بالكامل في الحزمة ultralytics، مع توفير دعم أصلي لتقسيم المفاهيم باستخدام المطالبات النصية ومطالبات أمثلة الصور وتتبع الفيديو. ويدعم النموذج نقطة التحقق الأحدث SAM 3.1 للتنبؤ بالصور.
نظرة عامة#
يحقق SAM 3 تحسنًا في الأداء بمقدار الضعف مقارنةً بالأنظمة الحالية في تقسيم المفاهيم القابل للتوجيه، مع الحفاظ على قدرات SAM 2 في التقسيم المرئي التفاعلي وتحسينها. ويتفوق النموذج في التقسيم ذي المفردات المفتوحة، إذ يتيح للمستخدمين تحديد المفاهيم باستخدام عبارات اسمية بسيطة (مثل «حافلة مدرسية صفراء» أو «قطة مخططة») أو تقديم صور نموذجية للجسم المستهدف. وفي Ultralytics، يعمل SAM 3 عبر وضع التنبؤ، مع متنبئات فيديو مخصصة للتتبع.
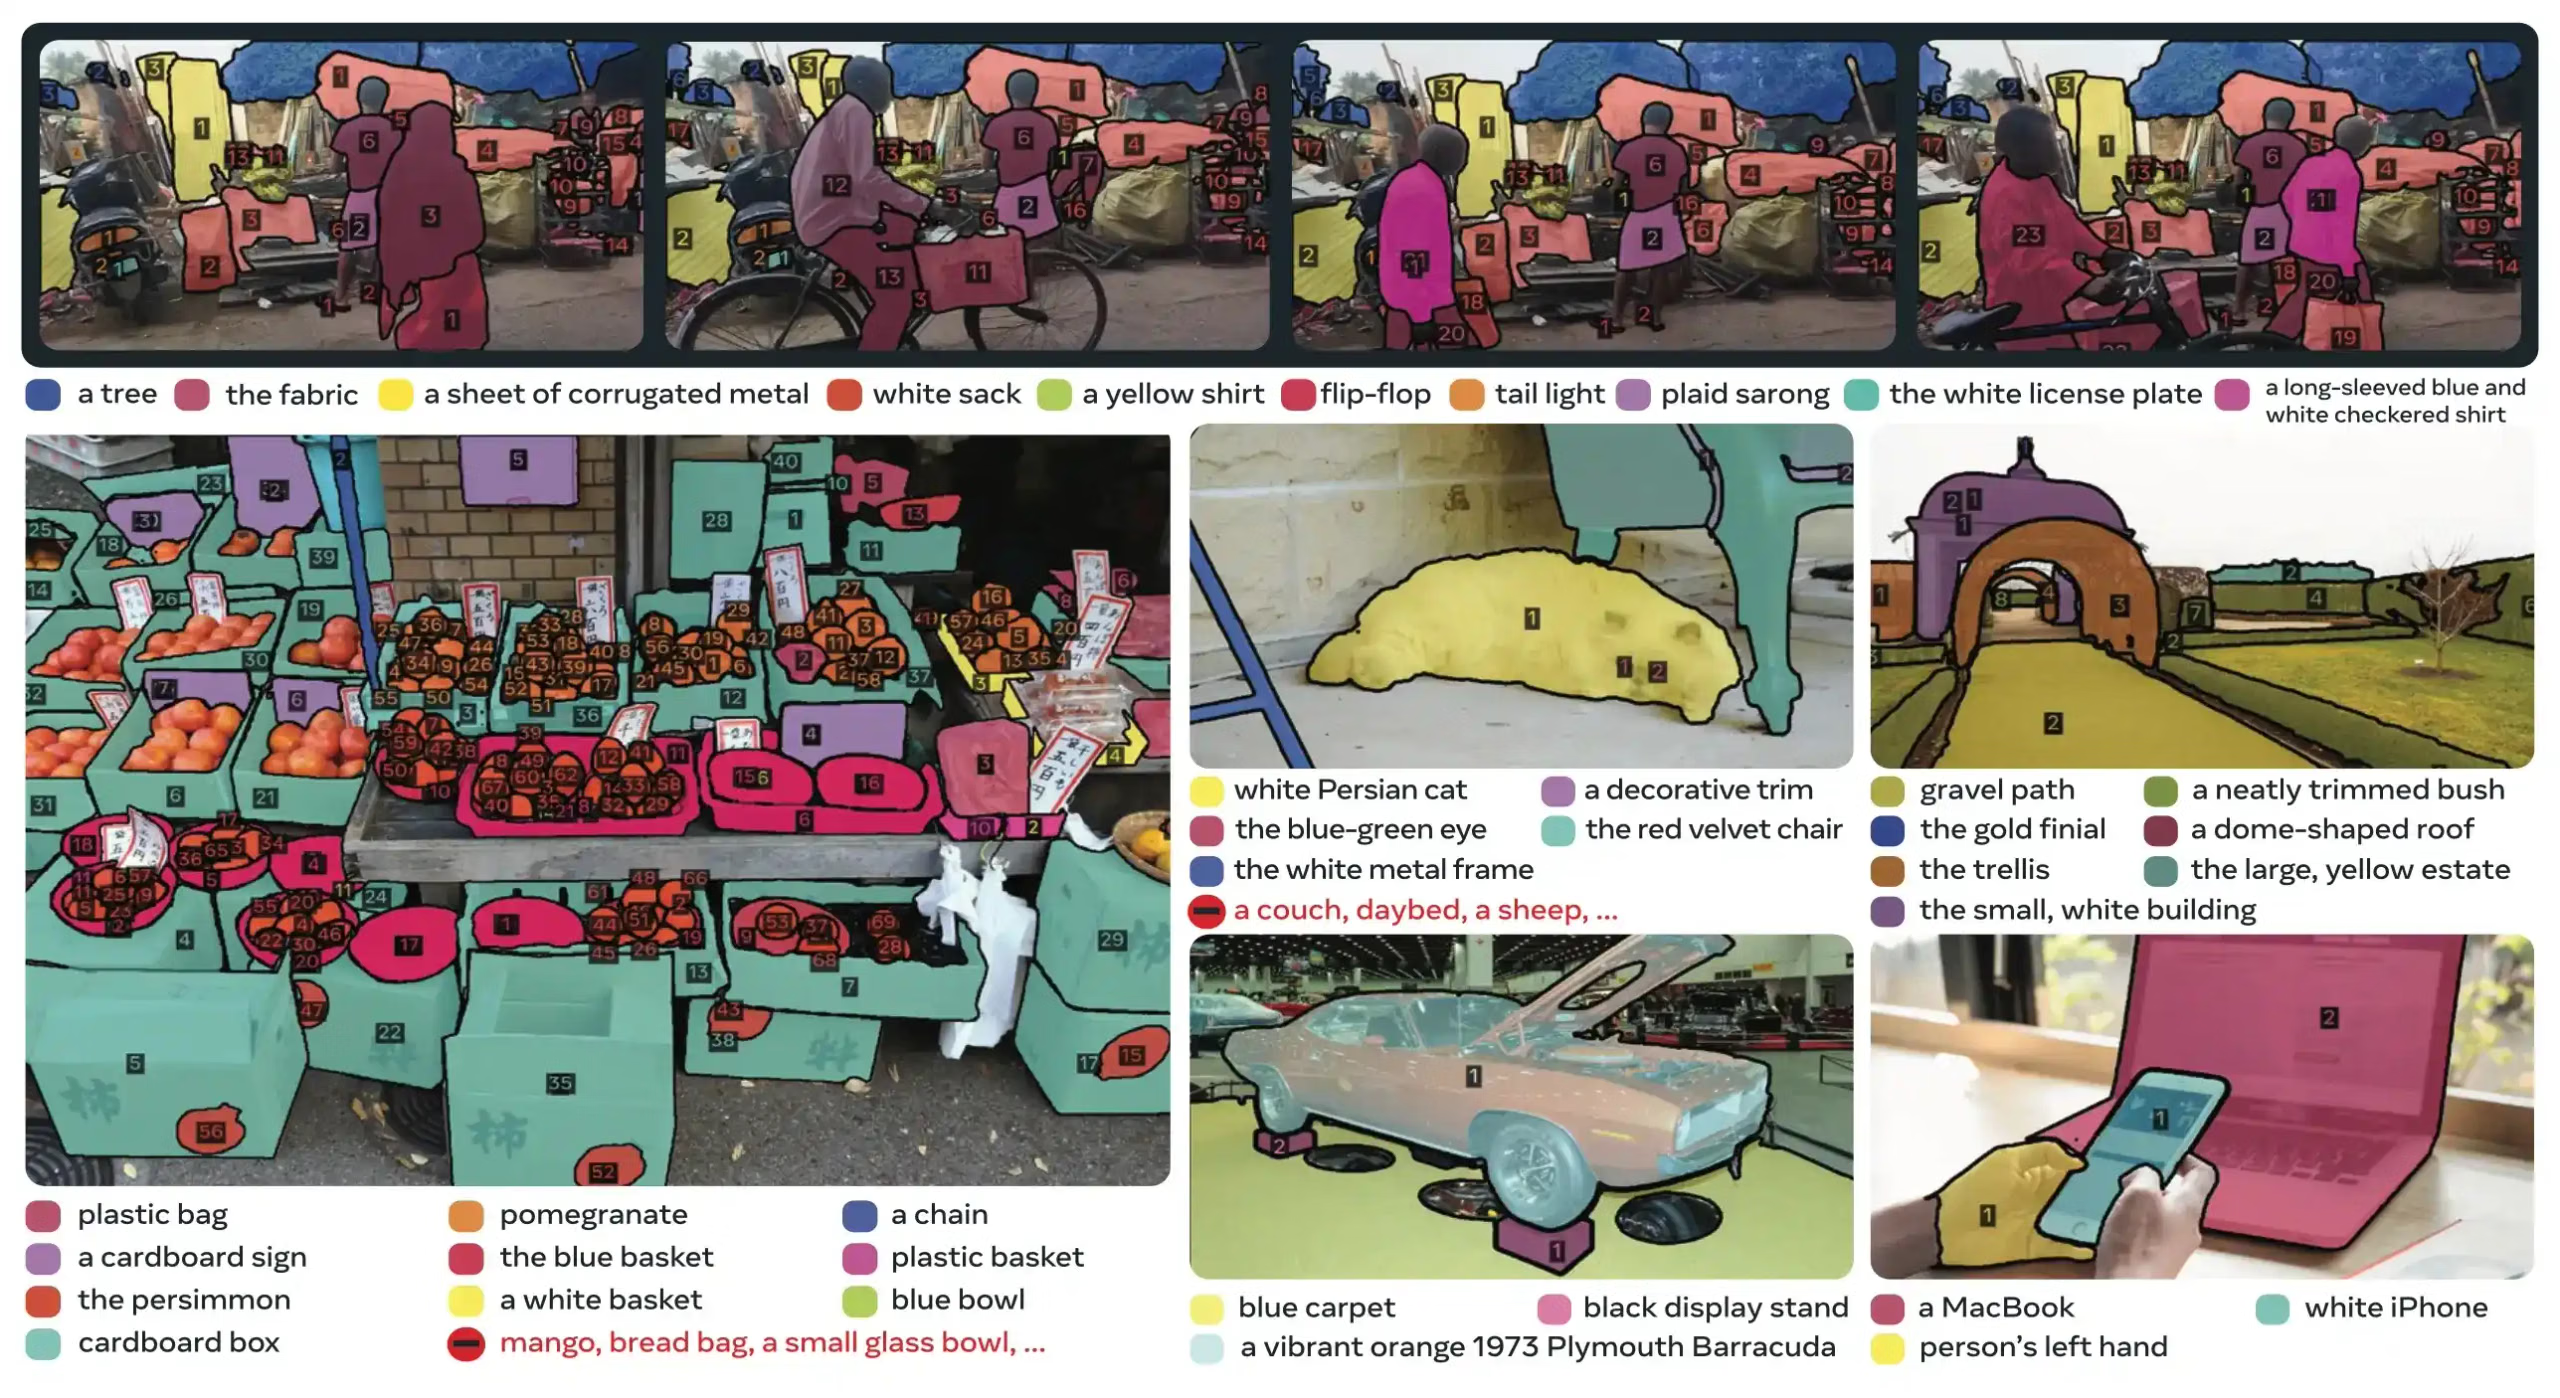
ما تقسيم المفاهيم القابل للتوجيه (PCS)؟#
تستقبل مهمة PCS مطالبة بمفهوم وتُرجع أقنعة تقسيم بمعرّفات فريدة لجميع حالات الأجسام المطابقة. ويمكن أن تكون مطالبات المفاهيم:
- نصية: عبارات اسمية بسيطة مثل «تفاحة حمراء» أو «شخص يرتدي قبعة»، على غرار التعلّم دون أمثلة
- أمثلة صور: مربعات إحاطة حول كائنات نموذجية (إيجابية أو سلبية) للتعميم السريع
- مجتمعة: النص وأمثلة الصور معًا للتحكم الدقيق
يختلف ذلك عن المطالبات المرئية التقليدية (النقاط والمربعات والأقنعة)، التي تقسّم حالة كائن محددة واحدة فقط، كما اشتهرت بها عائلة SAM الأصلية.
مقاييس الأداء الرئيسية#
| المقياس | إنجاز SAM 3 |
|---|---|
| AP للأقنعة دون أمثلة على LVIS | 47.0 (مقابل أفضل نتيجة سابقة 38.5، وتحسن بنسبة +22%) |
| معيار SA-Co | أفضل بمقدار 2× من الأنظمة الحالية |
| سرعة الاستدلال (GPU من طراز H200) | 30 ms لكل صورة مع اكتشاف أكثر من 100 كائن |
| أداء الفيديو | شبه آني لنحو ~5 كائنات متزامنة |
| معيار MOSEv2 VOS | 60.1 J&F (+25.5% مقارنةً بـ SAM 2.1، و+17% مقارنةً بأفضل نتيجة سابقة) |
| التحسين التفاعلي | تحسن +18.6 CGF1 بعد 3 مطالبات بأمثلة |
| الفجوة عن أداء البشر | يحقق 88% من الحد الأدنى المقدّر على SA-Co/Gold |
للاطلاع على سياق مقاييس النماذج والمفاضلات في بيئات الإنتاج، راجع رؤى تقييم النماذج ومقاييس أداء YOLO.
SAM 3.1#
SAM 3.1، الذي أطلقته Meta في 27 مارس 2026، هو نقطة تحقق جديدة لـ SAM 3 تضيف تعدد الكائنات، وهو نهج للذاكرة المشتركة لتتبع كائنات متعددة في الفيديو. وبدلًا من معالجة كل كائن متتبَّع على حدة، يجمع SAM 3.1 الكائنات في مجموعات ذات سعة ثابتة ويعالجها معًا؛ وتفيد Meta بأن ذلك يحقق تسريعًا بنحو ~7× عند تتبع 128 كائنًا على GPU واحد من طراز H100. ويظل كل من كاشف الصور ورأس المطالبات التفاعلية بالنقاط محافظًا على بنية SAM 3.
| قياس الأداء | المقياس | SAM 3 | SAM 3.1 |
|---|---|---|---|
| SA-Co/VEval SA-V (الاختبار) | cgF1 | 30.3 | 30.5 |
| SA-Co/VEval YT-Temporal-1B (الاختبار) | cgF1 | 50.8 | 52.9 |
| SA-Co/VEval SmartGlasses (الاختبار) | cgF1 | 36.4 | 36.3 |
| MOSEv1 (التحقق) | J&F | 78.4 | 79.6 |
| DAVIS17 (التحقق) | J&F | 92.2 | 92.7 |
| SA-V (الاختبار) | J&F | 84.4 | 85.1 |
| YTVOS19 (التحقق) | G | 89.7 | 89.3 |
| MOSEv2 (التحقق) | J&Ḟ | 60.3 | 62.3 |
تحمّل Ultralytics نقطة التحقق SAM 3.1 (sam3.1_multiplex.pt) في متنبئات الصور SAM 3: SAM("sam3.1_multiplex.pt") لمطالبات النقاط والمربعات، وSAM3SemanticPredictor للمطالبات النصية ومطالبات الأمثلة. ولا يُدعم تتبع الفيديو باستخدام تعدد الكائنات بعد، لذا واصل استخدام sam3.pt مع SAM3VideoPredictor وSAM3VideoSemanticPredictor.
البنية#
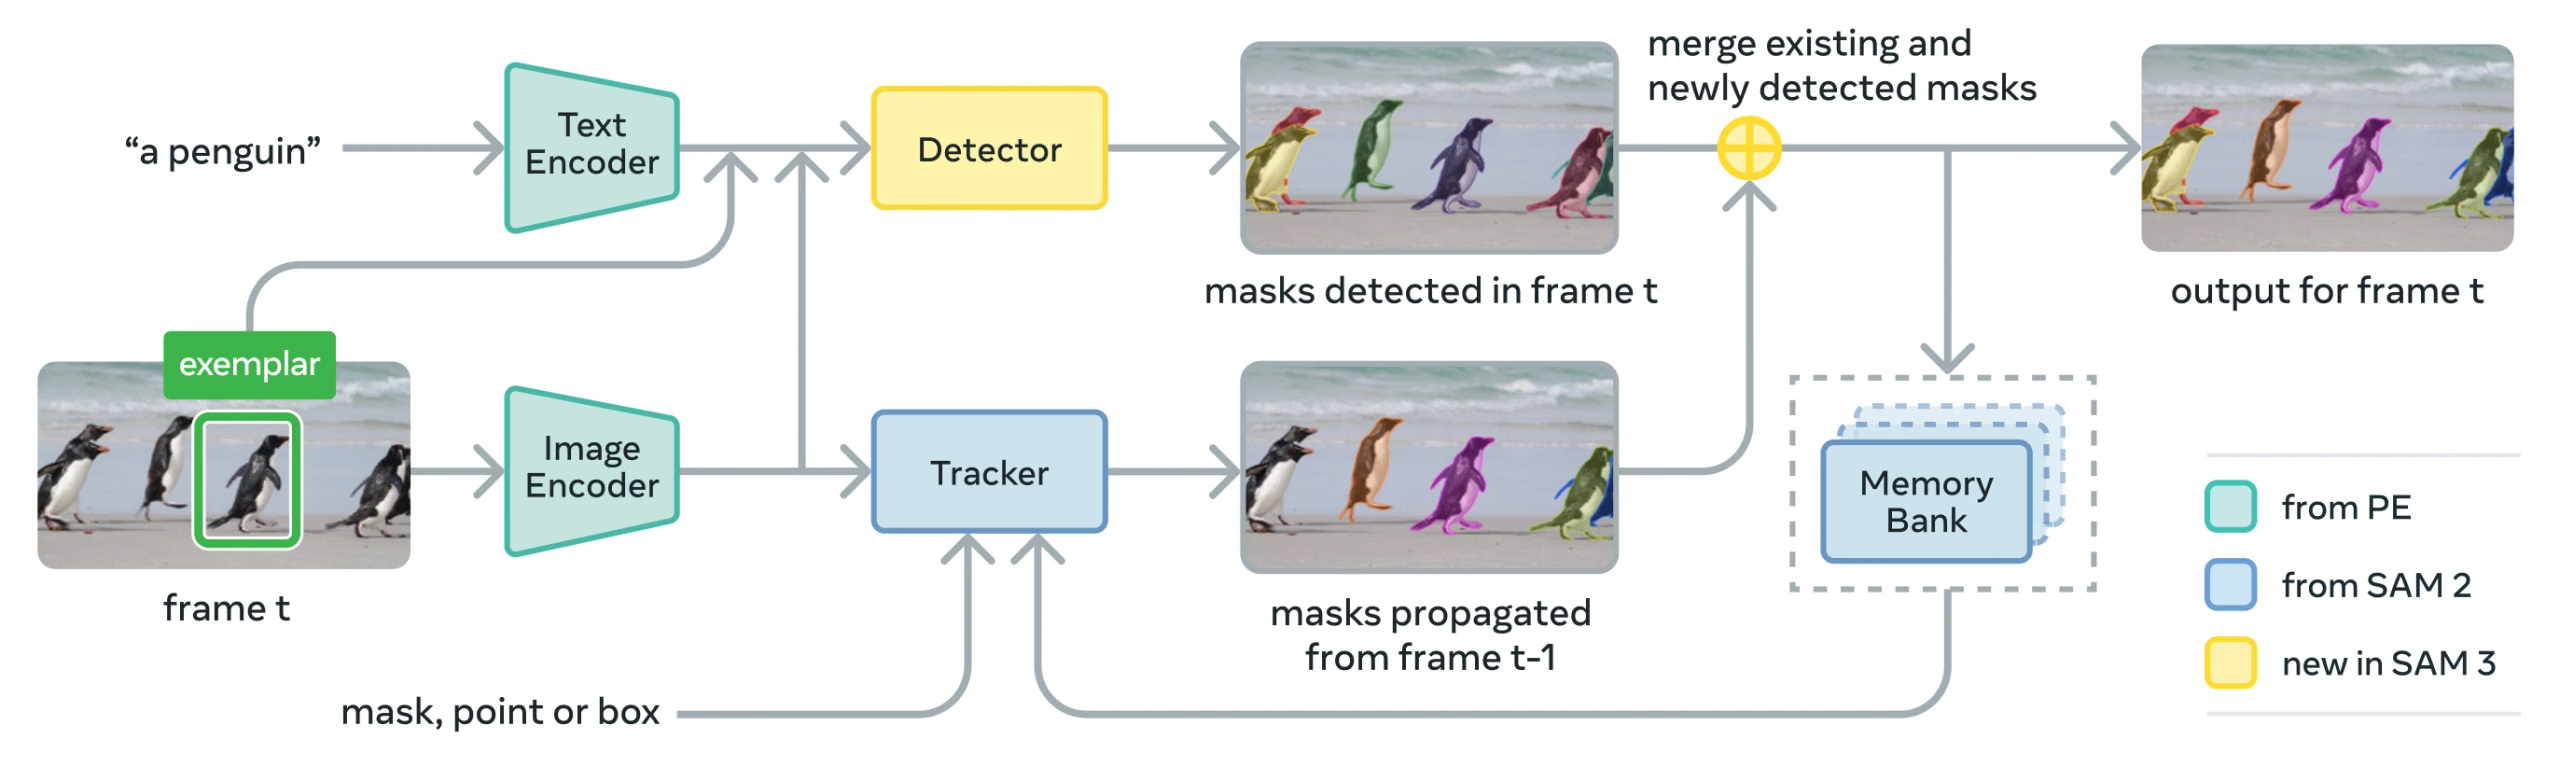
يتألف SAM 3 من كاشف ومتعقّب يشتركان في العمود الفقري المرئي لمشفّر الإدراك (PE). ويتجنب هذا التصميم المفصول تعارض المهام، مع إتاحة الكشف على مستوى الصور والتتبع على مستوى الفيديو، عبر واجهة متوافقة مع استخدام Python واستخدام CLI في Ultralytics.
المكونات الأساسية#
-
الكاشف: بنية قائمة على DETR لكشف المفاهيم على مستوى الصور
- مشفّر نصي لمطالبات العبارات الاسمية
- مشفّر أمثلة لمطالبات الصور
- مشفّر دمج لتكييف ميزات الصور وفقًا للمطالبات
- رأس حضور مبتكر يفصل التعرّف («ما هو؟») عن تحديد الموقع («أين هو؟»)
- رأس أقنعة لإنشاء أقنعة تقسيم الحالات
-
المتعقّب: تقسيم فيديو قائم على الذاكرة، موروث من SAM 2
- مشفّر المطالبات، ومفكّك ترميز الأقنعة، ومشفّر الذاكرة
- بنك ذاكرة لتخزين مظهر الكائن عبر الإطارات
-
رمز الحضور: رمز عالمي متعلّم يتنبأ بوجود المفهوم المستهدف في الصورة/الإطار، ما يحسّن الكشف عبر فصل التعرّف عن تحديد الموقع.
الابتكارات الرئيسية#
- فصل التعرّف عن تحديد الموقع: تتنبأ وحدة رأس الحضور بوجود المفهوم على مستوى الصورة، بينما تركز استعلامات المقترحات على تحديد الموقع فقط، مما يجنب الأهداف المتضاربة.
- توحيد مطالبات المفاهيم والمطالبات البصرية: يدعم كلًا من PCS (مطالبات المفاهيم) وPVS (المطالبات البصرية مثل النقرات/المربعات في SAM 2) في نموذج واحد.
- تحسين الأمثلة التفاعلي: يمكن للمستخدمين إضافة أمثلة صور إيجابية أو سلبية لتحسين النتائج تدريجيًا، مع تعميم النموذج على الكائنات المشابهة بدلًا من تصحيح الحالات الفردية فحسب.
- إزالة الالتباس الزمني: يستخدم درجات اكتشاف masklet وإعادة المطالبة دوريًا للتعامل مع حالات الاحتجاب والمشاهد المزدحمة وإخفاقات التتبع في الفيديو، بما يتماشى مع أفضل ممارسات تقسيم الكائنات الفردية وتتبعها.
مجموعة بيانات SA-Co#
دُرّب SAM 3 على Segment Anything with Concepts (SA-Co)، وهي أكبر مجموعة بيانات للتقسيم وأكثرها تنوعًا لدى Meta حتى الآن، وتتجاوز المعايير الشائعة مثل COCO وLVIS.
بيانات التدريب#
| مكوّن مجموعة البيانات | الوصف | الحجم |
|---|---|---|
| SA-Co/HQ | بيانات صور عالية الجودة مشروحة بشريًا، أُنتجت بواسطة محرك بيانات ذي 4 مراحل | 5.2M صورة، و4M عبارات اسمية فريدة |
| SA-Co/SYN | مجموعة بيانات اصطناعية وسمها الذكاء الاصطناعي دون تدخل بشري | 38M عبارة اسمية، و1.4B قناع |
| SA-Co/EXT | 15 مجموعة بيانات خارجية أُثرِيت بأمثلة سلبية صعبة | يختلف باختلاف المصدر |
| SA-Co/VIDEO | تعليقات توضيحية لمقاطع الفيديو مع تتبع زمني | 52.5K فيديو، و24.8K عبارة اسمية فريدة |
بيانات المعايير#
يحتوي معيار تقييم SA-Co على 214K عبارة فريدة عبر 126K صورة ومقطع فيديو، موفرًا مفاهيم تزيد بأكثر من 50× على المعايير الحالية. ويشمل:
- SA-Co/Gold: 7 مجالات، مع تعليقات توضيحية ثلاثية لقياس حدود الأداء البشري
- SA-Co/Silver: 10 مجالات، مع تعليق توضيحي بشري واحد
- SA-Co/Bronze وSA-Co/Bio: 9 مجموعات بيانات حالية جرى تكييفها لتقسيم المفاهيم
- SA-Co/VEval: معيار لمقاطع الفيديو يضم 3 مجالات (SA-V وYT-Temporal-1B وSmartGlasses)
ابتكارات محرك البيانات#
يحقق محرك بيانات SAM 3 القابل للتوسع، الذي يدمج الإنسان والنموذج في حلقة العمل، زيادة بمقدار 2× في معدل إنجاز التعليقات التوضيحية عبر:
- أدوات التعليق التوضيحي بالذكاء الاصطناعي: تقترح النماذج القائمة على Llama عبارات اسمية متنوعة، تشمل الأمثلة السلبية الصعبة
- أدوات تحقق مدعومة بالذكاء الاصطناعي: تتحقق نماذج اللغة الكبيرة متعددة الوسائط، المضبوطة ضبطًا دقيقًا، من جودة الأقنعة واكتمالها بأداء يقارب أداء البشر
- التنقيب النشط: يركز الجهد البشري على حالات الإخفاق الصعبة التي يواجه فيها الذكاء الاصطناعي صعوبة
- القائم على الأنطولوجيا: يستخدم أنطولوجيا واسعة تستند إلى Wikidata لتغطية المفاهيم
التثبيت#
ثبّت حزمة ultralytics أو حدّثها:
pip install -U ultralyticsعلى خلاف نماذج Ultralytics الأخرى، لا تُنزَّل أوزان SAM 3 (sam3.pt) تلقائيًا. يجب أولًا طلب الوصول إلى أوزان النموذج من صفحة نموذج SAM 3 على Hugging Face، ثم تنزيل sam3.pt من تلك الصفحة بعد الموافقة. ضع ملف sam3.pt الذي نزّلته في دليل العمل، أو حدّد المسار الكامل عند تحميل النموذج.
تخضع أوزان SAM 3.1 (sam3.1_multiplex.pt) لنظام الوصول المقيّد نفسه في صفحة نموذج SAM 3.1. مرّر sam3.1_multiplex.pt في أي موضع تستخدم فيه أمثلة الصور أدناه sam3.pt.
إذا ظهر لك الخطأ أعلاه أثناء التنبؤ، فهذا يعني أن حزمة clip المثبّتة لديك غير صحيحة. ثبّت حزمة clip الصحيحة بتشغيل ما يلي:
pip uninstall clip -y
pip install git+https://github.com/ultralytics/CLIP.git
كيفية استخدام SAM 3: تعدد الاستخدامات في تقسيم المفاهيم#
يدعم SAM 3 مهام تقسيم المفاهيم القابل للمطالبة (PCS) وتقسيم العناصر المرئية القابل للمطالبة (PVS) عبر واجهات مختلفة للمُتنبئ:
المهام والنماذج المدعومة#
| نوع المهمة | أنواع المطالبات | المخرجات |
|---|---|---|
| تقسيم المفاهيم (PCS) | النص (عبارات اسمية)، وأمثلة الصور | كل الحالات المطابقة للمفهوم |
| تقسيم العناصر المرئية (PVS) | النقاط والمربعات والأقنعة | حالة كائن واحدة (بنمط SAM 2) |
| التحسين التفاعلي | إضافة الأمثلة أو النقرات أو إزالتها بصورة تكرارية | تقسيم محسّن بدقة أعلى |
أمثلة على تقسيم المفاهيم#
التقسيم باستخدام المطالبات النصية#
اعثر على جميع حالات المفهوم وقسّمها باستخدام وصف نصي. تتطلب المطالبات النصية واجهة SAM3SemanticPredictor.
from ultralytics.models.sam import SAM3SemanticPredictor
# تهيئة المُتنبئ باستخدام الإعدادات
overrides = {
"conf": 0.25,
"task": "segment",
"mode": "predict",
"model": "sam3.pt",
"quantize": 16, # استخدام FP16 لتسريع الاستدلال
"save": True,
}
predictor = SAM3SemanticPredictor(overrides=overrides)
# تعيين الصورة مرة واحدة لعدة استعلامات
predictor.set_image("path/to/image.jpg")
# إجراء استعلامات باستخدام مطالبات نصية متعددة
results = predictor(text=["person", "bus", "glasses"])
# يعمل مع العبارات الوصفية
results = predictor(text=["person with red cloth", "person with blue cloth"])
# إجراء استعلام باستخدام مفهوم واحد
results = predictor(text=["a person"])التقسيم باستخدام أمثلة الصور#
استخدم المربعات المحيطة كمطالبات بصرية للعثور على جميع الحالات المشابهة. يتطلب ذلك أيضًا SAM3SemanticPredictor لمطابقة المفاهيم.
from ultralytics.models.sam import SAM3SemanticPredictor
# تهيئة المُتنبئ
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "model": "sam3.pt", "quantize": 16, "save": True}
predictor = SAM3SemanticPredictor(overrides=overrides)
# تعيين الصورة
predictor.set_image("path/to/image.jpg")
# تقديم أمثلة بمربعات محيطة لتقسيم الكائنات المشابهة
results = predictor(bboxes=[[480.0, 290.0, 590.0, 650.0]])
# استخدام مربعات محيطة متعددة كأمثلة للمفهوم البصري نفسه
results = predictor(bboxes=[[539, 599, 589, 639], [343, 267, 499, 662]])الاستدلال المستند إلى الميزات لتحقيق الكفاءة#
استخرج ميزات الصورة مرة واحدة وأعِد استخدامها في استعلامات تقسيم متعددة لتحسين الكفاءة.
import cv2
from ultralytics.models.sam import SAM3SemanticPredictor
from ultralytics.utils.plotting import Annotator, colors
# تهيئة المُتنبئات
overrides = {"conf": 0.50, "task": "segment", "mode": "predict", "model": "sam3.pt", "verbose": False}
predictor = SAM3SemanticPredictor(overrides=overrides)
predictor2 = SAM3SemanticPredictor(overrides=overrides)
# استخراج الميزات من المُتنبئ الأول
source = "path/to/image.jpg"
predictor.set_image(source)
src_shape = cv2.imread(source).shape[:2]
# إعداد المُتنبئ الثاني وإعادة استخدام الميزات
predictor2.setup_model()
# إجراء الاستدلال باستخدام الميزات المشتركة مع مطالبة نصية
masks, boxes = predictor2.inference_features(predictor.features, src_shape=src_shape, text=["person"])
# إجراء الاستدلال باستخدام الميزات المشتركة مع مطالبة بمربع محيط
masks, boxes = predictor2.inference_features(predictor.features, src_shape=src_shape, bboxes=[[439, 437, 524, 709]])
# عرض النتائج بصريًا
if masks is not None:
masks, boxes = masks.cpu().numpy(), boxes.cpu().numpy()
im = cv2.imread(source)
annotator = Annotator(im, pil=False)
annotator.masks(masks, [colors(x, True) for x in range(len(masks))])
cv2.imshow("result", annotator.result())
cv2.waitKey(0)تقسيم المفاهيم في الفيديو#
تتبّع المفاهيم عبر الفيديو باستخدام المربعات المحيطة#
اكتشف حالات الكائنات وتتبّعها عبر إطارات الفيديو باستخدام مطالبات المربعات المحيطة.
from ultralytics.models.sam import SAM3VideoPredictor
# إنشاء مُتنبئ الفيديو
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "model": "sam3.pt", "quantize": 16}
predictor = SAM3VideoPredictor(overrides=overrides)
# تتبّع الكائنات باستخدام مطالبات المربعات المحيطة
results = predictor(source="path/to/video.mp4", bboxes=[[706.5, 442.5, 905.25, 555], [598, 635, 725, 750]], stream=True)
# معالجة النتائج وعرضها
for r in results:
r.show() # عرض الإطار مع أقنعة التقسيمتتبّع المفاهيم باستخدام المطالبات النصية#
تتبّع جميع حالات المفاهيم المحددة بالنص عبر إطارات الفيديو.
from ultralytics.models.sam import SAM3VideoSemanticPredictor
# تهيئة مُتنبئ الفيديو الدلالي
overrides = {
"conf": 0.25,
"task": "segment",
"mode": "predict",
"imgsz": 640,
"model": "sam3.pt",
"quantize": 16,
"save": True,
}
predictor = SAM3VideoSemanticPredictor(overrides=overrides)
# تتبّع المفاهيم باستخدام المطالبات النصية
results = predictor(source="path/to/video.mp4", text=["person", "bicycle"], stream=True)
# معالجة النتائج
for r in results:
r.show() # عرض الإطار مع الكائنات المتعقبة
# بديل: التتبّع باستخدام مطالبات المربعات المحيطة
results = predictor(
source="path/to/video.mp4",
bboxes=[[864, 383, 975, 620], [705, 229, 782, 402]],
labels=[1, 1], # التسميات الإيجابية
stream=True,
)المطالبات البصرية (التوافق مع SAM 2)#
يحافظ SAM 3 على توافق كامل مع الإصدارات السابقة فيما يتعلق بالمطالبات البصرية في SAM 2 لتقسيم كائن واحد:
تعمل واجهة SAM الأساسية تمامًا مثل SAM 2، إذ تقسم المنطقة المحددة بالمطالبات البصرية (النقاط أو المربعات أو الأقنعة) فقط.
from ultralytics import SAM
model = SAM("sam3.pt")
# مطالبة بنقطة واحدة - تقسّم الكائن عند موقع محدد
results = model.predict(source="path/to/image.jpg", points=[900, 370], labels=[1])
results[0].show()
# مطالبة بنقاط متعددة - تقسّم كائنًا واحدًا باستخدام تلميحات نقاط متعددة
results = model.predict(source="path/to/image.jpg", points=[[400, 370], [900, 370]], labels=[1, 1])
# مطالبة بمربع - تقسّم الكائن داخل مربع إحاطة
results = model.predict(source="path/to/image.jpg", bboxes=[100, 150, 300, 400])
results[0].show()يؤدي استخدام SAM("sam3.pt") مع المطالبات المرئية (النقاط/المربعات/الأقنعة) إلى تقسيم الكائن المحدد فقط في ذلك الموقع، تمامًا كما في SAM 2. لتقسيم جميع حالات المفهوم، استخدم SAM3SemanticPredictor مع مطالبات نصية أو مطالبات بأمثلة ممثلة كما هو موضح أعلاه.
معايير الأداء#
تقسيم الصور#
يحقق SAM 3 نتائج متقدمة على معايير متعددة، تشمل مجموعات بيانات واقعية مثل LVIS وCOCO للتقسيم:
| قياس الأداء | المقياس | SAM 3 | أفضل نتيجة سابقة | التحسن |
|---|---|---|---|---|
| LVIS (دون تدريب مسبق) | AP للأقنعة | 47.0 | 38.5 | +22.1% |
| SA-Co/Gold | CGF1 | 65.0 | 34.3 (OWLv2) | +89.5% |
| COCO (دون تدريب مسبق) | AP للمربعات | 53.5 | 52.2 (T-Rex2) | +2.5% |
| ADE-847 (التقسيم الدلالي) | mIoU | 14.7 | 9.2 (APE-D) | +59.8% |
| PascalConcept-59 | mIoU | 59.4 | 58.5 (APE-D) | +1.5% |
| Cityscapes (التقسيم الدلالي) | mIoU | 65.1 | 44.2 (APE-D) | +47.3% |
استكشف خيارات مجموعات البيانات لإجراء تجارب سريعة في مجموعات بيانات Ultralytics.
أداء تقسيم الفيديو#
يُظهر SAM 3 تحسينات كبيرة مقارنةً بـ SAM 2 وبأفضل النماذج السابقة عبر معايير الفيديو مثل DAVIS 2017 وYouTube-VOS:
| قياس الأداء | المقياس | SAM 3 | SAM 2.1 L | التحسن |
|---|---|---|---|---|
| MOSEv2 | J&F | 60.1 | 47.9 | +25.5% |
| DAVIS 2017 | J&F | 92.0 | 90.7 | +1.4% |
| LVOSv2 | J&F | 88.2 | 79.6 | +10.8% |
| SA-V | J&F | 84.6 | 78.4 | +7.9% |
| YTVOS19 | J&F | 89.6 | 89.3 | +0.3% |
التكيّف باستخدام أمثلة قليلة#
يتكيف SAM 3 مع المجالات الجديدة باستخدام أمثلة قليلة، وهو أمر مهم لسير عمل الذكاء الاصطناعي المرتكز على البيانات:
| قياس الأداء | AP دون أمثلة | AP باستخدام 10 أمثلة | أفضل نتيجة سابقة (باستخدام 10 أمثلة) |
|---|---|---|---|
| ODinW13 | 59.9 | 71.6 | 67.9 (gDino1.5-Pro) |
| RF100-VL | 14.3 | 35.7 | 33.7 (gDino-T) |
فعالية التحسين التفاعلي#
يتقارب التلقين القائم على المفاهيم في SAM 3 باستخدام الأمثلة الممثلة بوتيرة أسرع بكثير من التلقين المرئي:
| المطالبات المضافة | نتيجة CGF1 | الزيادة مقارنةً باستخدام النص فقط | الزيادة مقارنةً بخط الأساس PVS |
|---|---|---|---|
| النص فقط | 46.4 | خط الأساس | خط الأساس |
| +مثال ممثل واحد | 57.6 | +11.2 | +6.7 |
| +مثالان ممثلان | 62.2 | +15.8 | +9.7 |
| +3 أمثلة ممثلة | 65.0 | +18.6 | +11.2 |
| +4 أمثلة ممثلة | 65.7 | +19.3 | +11.5 (استقرار الأداء) |
دقة عدّ الكائنات#
يوفر SAM 3 عدًّا دقيقًا من خلال تقسيم جميع الحالات، وهو مطلب شائع في عدّ الكائنات:
| قياس الأداء | الدقة | MAE | مقارنةً بأفضل نموذج لغوي كبير متعدد الوسائط |
|---|---|---|---|
| CountBench | 95.6% | 0.11 | 92.4% (Gemini 2.5) |
| PixMo-Count | 87.3% | 0.22 | 88.8% (Molmo-72B) |
مقارنة SAM 3 وSAM 2 وYOLO#
نقارن هنا قدرات SAM 3 بقدرات SAM 2 ونماذج YOLO26:
| القدرة | SAM 3 | SAM 2 | YOLO26n-seg |
|---|---|---|---|
| تقسيم المفاهيم | ✅ جميع الحالات باستخدام النص/الأمثلة الممثلة | ❌ غير مدعوم | ❌ غير مدعوم |
| التقسيم المرئي | ✅ حالة واحدة (متوافق مع SAM 2) | ✅ حالة واحدة | ✅ جميع الحالات |
| القدرة على التعميم دون تدريب مسبق | ✅ مفردات مفتوحة | ✅ مطالبات هندسية | ❌ مجموعة مغلقة |
| التحسين التفاعلي | ✅ أمثلة ممثلة + نقرات | ✅ نقرات فقط | ❌ غير مدعوم |
| تتبّع الفيديو | ✅ كائنات متعددة مع هوياتها | ✅ كائنات متعددة | ✅ كائنات متعددة |
| AP لأقنعة LVIS (دون تدريب مسبق) | 47.0 | غير متاح | غير متاح |
| MOSEv2 J&F | 60.1 | 47.9 | غير متاح |
| السرعة (GPU، مللي ثانية/صورة) | 2921 | 857 | 8.4 |
| حجم النموذج | 3.45 GB | 162 MB (الأساسي) | 6.4 MB |
قِيست السرعة على NVIDIA RTX PRO 6000 باستخدام torch==2.9.1 وultralytics==8.4.19.
أبرز النقاط:
- SAM 3: الأفضل لتقسيم المفاهيم باستخدام مفردات مفتوحة، والعثور على جميع حالات مفهوم ما باستخدام مطالبات نصية أو مطالبات بأمثلة ممثلة
- SAM 2: الأفضل للتقسيم التفاعلي لكائن واحد في الصور ومقاطع الفيديو باستخدام مطالبات هندسية
- YOLO26: الأفضل للتقسيم عالي السرعة في الوقت الفعلي، مع إمكانية اختيار الاستدلال الشامل دون NMS، وتصديره إلى تنسيقات عديدة لنشره على GPU ووحدات CPU والأجهزة الطرفية
- YOLOE: الأفضل للكشف والتجزئة في الوقت الفعلي باستخدام مفردات مفتوحة، عبر المطالبات النصية أو المرئية
مقارنة SAM بنماذج YOLO#
مقارنة SAM 3 وSAM 2 وSAM وMobileSAM وFastSAM بنماذج تقسيم YOLO من Ultralytics (YOLOv8 وYOLO11 وYOLO26) من حيث الحجم وعدد المعلمات وسرعة الاستدلال على GPU:
| النموذج | الحجم (MB) | المعلمات (M) | السرعة (GPU) (ms/im) |
|---|---|---|---|
| Meta SAM-b | 375 | 93.7 | 1306 |
| Meta SAM2-b | 162 | 80.8 | 857 |
| Meta SAM2-t | 78.1 | 38.9 | 668 |
| Meta SAM3 | 3450 | 473.6 | 2921 |
| MobileSAM | 40.7 | 10.1 | 605 |
| FastSAM-s مع البنية الأساسية لـ YOLOv8 | 23.7 | 11.8 | 55.9 |
| Ultralytics YOLOv8n-seg | 6.7 (أصغر بـ 515 مرة) | 3.4 (أقل بـ 139.1 مرة) | 17.4 (أسرع بـ 167 مرة) |
| Ultralytics YOLO11n-seg | 5.9 (أصغر بـ 585 مرة) | 2.9 (أقل بـ 163.1 مرة) | 12.6 (أسرع بـ 231 مرة) |
| Ultralytics YOLO26n-seg | 6.4 (أصغر بـ 539 مرة) | 2.7 (أقل بـ 175.2 مرة) | 8.4 (أسرع بـ 347 مرة) |
تُظهر هذه المقارنة الفروق الكبيرة في أحجام النماذج وسرعاتها بين إصدارات SAM ونماذج تقسيم YOLO. وعلى الرغم من أن SAM يوفر إمكانات فريدة للتقسيم التلقائي، فإن نماذج YOLO، ولا سيما YOLOv8n-seg وYOLO11n-seg وYOLO26n-seg، أصغر وأسرع وأكثر كفاءة حسابيًا بدرجة كبيرة.
أُجريت الاختبارات على NVIDIA RTX PRO 6000 بذاكرة VRAM سعتها 96GB باستخدام torch==2.9.1 وultralytics==8.4.19. لإعادة تنفيذ هذا الاختبار:
from ultralytics import ASSETS, SAM, YOLO, FastSAM
# أنشئ ملفًا تعريفيًا لـ SAM3 وSAM2-t وSAM2-b وSAM-b وMobileSAM
for file in ["sam_b.pt", "sam2_b.pt", "sam2_t.pt", "mobile_sam.pt", "sam3.pt"]:
model = SAM(file)
model.info()
model(ASSETS)
# أنشئ ملفًا تعريفيًا لـ FastSAM-s
model = FastSAM("FastSAM-s.pt")
model.info()
model(ASSETS)
# أنشئ ملفات تعريف لنماذج YOLO
for file_name in ["yolov8n-seg.pt", "yolo11n-seg.pt", "yolo26n-seg.pt"]:
model = YOLO(file_name)
model.info()
model(ASSETS, nms=False) # رأس NMS-free في YOLO26؛ لا إجراء لـ YOLOv8/YOLO11مقاييس التقييم#
يقدم SAM 3 مقاييس جديدة مصممة لمهمة PCS، تكمل المقاييس المعروفة مثل درجة F1 والإحكام والاستدعاء.
درجة F1 المقيّدة بالتصنيف (CGF1)#
المقياس الأساسي الذي يجمع بين تحديد الموقع والتصنيف:
CGF1 = 100 × pmF1 × IL_MCC
حيث:
- pmF1 (متوسط F1 الإيجابي): يقيس جودة تحديد الموقع في الأمثلة الإيجابية
- IL_MCC (معامل ارتباط ماثيوز على مستوى الصورة): يقيس دقة التصنيف الثنائي ("هل المفهوم موجود؟")
لماذا هذه المقاييس؟#
لا تأخذ مقاييس AP التقليدية المعايرة في الحسبان، ما يصعّب استخدام النماذج عمليًا. ومن خلال تقييم التنبؤات التي تتجاوز ثقتها 0.5 فقط، تفرض مقاييس SAM 3 معايرة جيدة وتحاكي أنماط الاستخدام الواقعية في حلقات التنبؤ التفاعلي والتتبع.
أهم دراسات الاستئصال والاستنتاجات#
تأثير رأس الوجود#
يفصل رأس الوجود التعرّف عن تحديد الموقع، ما يحقق تحسينات كبيرة:
| التهيئة | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| من دون الوجود | 57.6 | 0.77 | 74.7 |
| مع الوجود | 63.3 | 0.82 | 77.1 |
يحقق رأس الوجود زيادة قدرها +5.7 في CGF1 (+9.9%)، ويحسن بالدرجة الأولى قدرة التعرّف (IL_MCC بمقدار +6.5%).
تأثير الأمثلة السلبية الصعبة#
| الأمثلة السلبية الصعبة/الصورة | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| 0 | 31.8 | 0.44 | 70.2 |
| 5 | 44.8 | 0.62 | 71.9 |
| 30 | 49.2 | 0.68 | 72.3 |
تُعد الأمثلة السلبية الصعبة ضرورية للتعرّف على المفردات المفتوحة، إذ تحسن IL_MCC بنسبة 54.5% (من 0.44 إلى 0.68).
توسيع نطاق بيانات التدريب#
| مصادر البيانات | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| خارجية فقط | 30.9 | 0.46 | 66.3 |
| خارجية + اصطناعية | 39.7 | 0.57 | 70.6 |
| خارجية + عالية الجودة | 51.8 | 0.71 | 73.2 |
| المصادر الثلاثة كلها | 54.3 | 0.74 | 73.5 |
توفر التعليقات التوضيحية البشرية عالية الجودة مكاسب كبيرة مقارنة بالبيانات الاصطناعية أو الخارجية وحدها. للاطلاع على معلومات أساسية حول ممارسات جودة البيانات، راجع جمع البيانات والتعليق التوضيحي.
التطبيقات#
تتيح قدرة SAM 3 على تقسيم المفاهيم حالات استخدام جديدة:
- إدارة المحتوى: العثور على جميع حالات أنواع محتوى محددة عبر مكتبات الوسائط
- التجارة الإلكترونية: تقسيم جميع المنتجات من نوع معين في صور الكتالوج، مع دعم التعليق التوضيحي التلقائي
- التصوير الطبي: تحديد جميع حالات ظهور أنواع أنسجة معينة أو تشوهات محددة
- الأنظمة الذاتية: تعقّب جميع حالات إشارات المرور أو المشاة أو المركبات حسب الفئة
- تحليلات الفيديو: إحصاء جميع الأشخاص الذين يرتدون ملابس محددة أو يؤدون أفعالًا معينة وتعقّبهم
- التعليق التوضيحي لمجموعات البيانات: وضع تعليقات توضيحية بسرعة على جميع حالات فئات الكائنات النادرة
- البحث العلمي: قياس جميع العينات التي تستوفي معايير محددة وتحليلها
وكيل SAM 3: استدلال لغوي موسّع#
يمكن دمج SAM 3 مع نماذج اللغة الكبيرة متعددة الوسائط (MLLMs) لمعالجة الاستعلامات المعقدة التي تتطلب الاستدلال، على غرار أنظمة المفردات المفتوحة مثل OWLv2 وT-Rex.
الأداء في مهام الاستدلال#
| قياس الأداء | المقياس | وكيل SAM 3 (Gemini 2.5 Pro) | أفضل نتيجة سابقة |
|---|---|---|---|
| ReasonSeg (التحقق) | gIoU | 76.0 | 65.0 (أحدث النتائج) |
| ReasonSeg (الاختبار) | gIoU | 73.8 | 61.3 (أحدث النتائج) |
| OmniLabel (التحقق) | AP | 46.7 | 36.5 (REAL) |
| RefCOCO+ | Acc | 91.2 | 89.3 (LISA) |
أمثلة على الاستعلامات المعقدة#
يمكن لوكيل SAM 3 معالجة الاستعلامات التي تتطلب الاستدلال:
- "أشخاص يجلسون لكنهم لا يمسكون علبة هدايا بأيديهم"
- "الكلب الأقرب إلى الكاميرا الذي لا يرتدي طوقًا"
- "أجسام حمراء أكبر من يد الشخص"
يقترح نموذج MLLM على SAM 3 استعلامات بسيطة بصيغ اسمية، ويحلل الأقنعة المُعادة، ويكرر العملية حتى يصل إلى النتيجة المطلوبة.
القيود#
لدى SAM 3 القيود التالية:
- تعقيد العبارات: يناسب العبارات الاسمية البسيطة على أفضل وجه؛ وقد تتطلب العبارات الإحالية الطويلة أو الاستدلال المعقد دمج نموذج MLLM
- التعامل مع الالتباس: تظل بعض المفاهيم ملتبسة بطبيعتها (مثل "نافذة صغيرة" و"غرفة مريحة")
- المتطلبات الحاسوبية: أكبر وأبطأ من نماذج الكشف المتخصصة مثل YOLO
- نطاق المفردات: يركز على المفاهيم المرئية الأولية؛ ويظل الاستدلال التركيبي محدودًا دون مساعدة نموذج MLLM
- المفاهيم النادرة: قد يتراجع الأداء في المفاهيم النادرة للغاية أو الدقيقة التي لا تمثلها بيانات التدريب تمثيلًا جيدًا
الاستشهاد#
@misc{carion2025sam3,
  title         = {SAM 3: Segment Anything with Concepts},
  author        = {Nicolas Carion and Laura Gustafson and Yuan-Ting Hu and Shoubhik Debnath and Ronghang Hu and Didac Suris and Chaitanya Ryali and Kalyan Vasudev Alwala and Haitham Khedr and Andrew Huang and Jie Lei and Tengyu Ma and Baishan Guo and Arpit Kalla and Markus Marks and Joseph Greer and Meng Wang and Peize Sun and Roman R{\"a}dle and Triantafyllos Afouras and Effrosyni Mavroudi and Katherine Xu and Tsung-Han Wu and Yu Zhou and Liliane Momeni and Rishi Hazra and Shuangrui Ding and Sagar Vaze and Francois Porcher and Feng Li and Siyuan Li and Aishwarya Kamath and Ho Kei Cheng and Piotr Doll{\'a}r and Nikhila Ravi and Kate Saenko and Pengchuan Zhang and Christoph Feichtenhofer},
  year          = {2025},
  eprint        = {2511.16719},
  archivePrefix = {arXiv},
  primaryClass  = {cs.CV},
  url           = {https://arxiv.org/abs/2511.16719}
}
الأسئلة الشائعة#
أصدرت Meta نموذج SAM 3 في 19 نوفمبر 2025، وهو مدمج بالكامل في حزمة
ultralytics، مع دعم التنبؤ بالصور وتتبع الفيديو عبر متنبئات مخصصة.نعم. يتكامل SAM 3 بالكامل مع حزمة Ultralytics لـPython، بما يشمل تقسيم المفاهيم والمطالبات المرئية بأسلوب SAM 2 وتتبع كائنات متعددة في الفيديو. كما يشغّل SAM 3 وSAM 3.1 ميزة التعليق التوضيحي الذكي على منصة Ultralytics، حيث يكون SAM 3.1 النموذج الافتراضي ويمكنك إضافة تعليقات توضيحية إلى الصور ببضع نقرات فقط. وعلى مجموعات بيانات الكشف التي تضم من فئة إلى 200 فئة، يضيف كل من SAM 3 Text وSAM 3.1 Text تعليقات توضيحية تلقائيًا انطلاقًا من أسماء الفئات، كما تقارن لوحة متصدرّي نماذج الرؤية واللغة (VLM) دقتهما بدقة نماذج الرؤية واللغة.
نعم، للتنبؤ بالصور. حمّل
sam3.1_multiplex.ptأينما تستخدم أمثلة الصور في هذه الصفحةsam3.pt: استخدمSAM("sam3.1_multiplex.pt")لمطالبات النقاط والمربعات، وSAM3SemanticPredictorلمطالبات النصوص والأمثلة النموذجية. لا يُدعم تتبع الفيديو باستخدام Object Multiplex بعد، لذا واصل استخدامsam3.ptمع متنبئات الفيديو. راجع SAM 3.1 للاطلاع على معايير Meta.PCS مهمة جديدة قدمها SAM 3، وهي تقسّم جميع الحالات لمفهوم مرئي في صورة أو فيديو. وعلى خلاف التقسيم التقليدي الذي يستهدف حالة كائن محددة، يعثر PCS على كل ظهور لفئة ما. على سبيل المثال:
- مطالبة نصية: "حافلة مدرسية صفراء" ← تقسّم جميع الحافلات المدرسية الصفراء في المشهد
- مثال صوري: مربع حول كلب واحد → تقسيم جميع الكلاب في الصورة
- مجتمعة: «قط مخطط» + مربع المثال → تقسيم جميع القطط المخططة المطابقة للمثال
الميزة SAM 2 SAM 3 المهمة كائن واحد لكل مطالبة جميع حالات المفهوم أنواع المطالبات النقاط والمربعات والأقنعة + عبارات نصية، أمثلة صورية قدرات الكشف يتطلب كاشفًا خارجيًا كاشف مدمج بمفردات مفتوحة التعرّف يعتمد على الهندسة فقط التعرّف النصي والبصري البنية متعقّب فقط كاشف + متعقّب مع رأس للحضور الأداء دون تدريب مسبق لا ينطبق (يتطلب مطالبات بصرية) 47.0 AP على LVIS، وأداء أفضل بمرتين على SA-Co التحسين التفاعلي النقرات فقط النقرات + التعميم انطلاقًا من المثال يحافظ SAM 3 على التوافق العكسي مع المطالبات البصرية في SAM 2، مع إضافة قدرات قائمة على المفاهيم.
يُدرَّب SAM 3 على مجموعة بيانات Segment Anything with Concepts (SA-Co):
بيانات التدريب:
- 5.2M صورة تضم 4M عبارة اسمية فريدة (SA-Co/HQ) - تعليقات توضيحية بشرية عالية الجودة
- 52.5K مقطع فيديو تضم 24.8K عبارة اسمية فريدة (SA-Co/VIDEO)
- 1.4B قناعًا اصطناعيًا عبر 38M عبارة اسمية (SA-Co/SYN)
- 15 مجموعة بيانات خارجية مُثرَاة بأمثلة سلبية صعبة (SA-Co/EXT)
بيانات المعايير:
- 214K مفهومًا فريدًا عبر 126K صورة/مقطع فيديو
- مفاهيم أكثر بـ50× من المعايير الحالية (مثلًا، يضم LVIS نحو ~4K مفهوم)
- تعليقات توضيحية ثلاثية على SA-Co/Gold لقياس حدود الأداء البشري
يدعم هذا الحجم والتنوع قدرة SAM 3 على التعميم دون تدريب مسبق عبر مفاهيم المفردات المفتوحة.
يخدم SAM 3 وYOLO26 حالات استخدام مختلفة:
مزايا SAM 3:
- مفردات مفتوحة: يقسّم أي مفهوم باستخدام مطالبات نصية دون تدريب
- دون تدريب مسبق: يعمل فورًا على الفئات الجديدة
- تفاعلي: يُحسّن التنقيح القائم على الأمثلة التعميم على الكائنات المشابهة
- قائم على المفاهيم: يعثر تلقائيًا على جميع حالات الفئة
- الدقة: 47.0 AP في تقسيم الكائنات الفردية دون تدريب مسبق على LVIS
مزايا YOLO26:
- السرعة: استدلال أسرع بفوارق كبيرة، مع رأس شامل اختياري لا يستخدم NMS
- الكفاءة: نماذج أصغر بـ539× (6.4MB مقابل 3.45GB)
- ملائم للموارد المحدودة: يعمل على الأجهزة الطرفية والهواتف المحمولة
- آني: مُحسَّن للنشر في بيئات الإنتاج
التوصية:
- استخدم SAM 3 للتقسيم المرن ذي المفردات المفتوحة عندما تحتاج إلى العثور على جميع حالات المفاهيم الموصوفة بالنص أو الأمثلة
- استخدم YOLO26 للنشر الإنتاجي عالي السرعة عندما تكون الفئات معروفة مسبقًا
- استخدم SAM 2 لتقسيم كائن واحد تفاعليًا باستخدام مطالبات هندسية
صُمم SAM 3 للتعامل مع العبارات الاسمية البسيطة (مثل «تفاحة حمراء» و«شخص يرتدي قبعة»). أما الاستعلامات المعقدة التي تتطلب استدلالًا، فيمكن التعامل معها بدمج SAM 3 مع نموذج لغوي كبير متعدد الوسائط (MLLM) ضمن SAM 3 Agent:
استعلامات بسيطة (SAM 3 الأصلي):
- «حافلة مدرسية صفراء»
- «قط مخطط»
- «شخص يرتدي قبعة حمراء»
استعلامات معقدة (SAM 3 Agent مع MLLM):
- «أشخاص جالسون لكنهم لا يحملون صندوق هدايا»
- «الكلب الأقرب إلى الكاميرا من دون طوق»
- "أجسام حمراء أكبر من يد الشخص"
يحقق SAM 3 Agent 76.0 gIoU على مجموعة التحقق من ReasonSeg (مقابل أفضل نتيجة سابقة بلغت 65.0، بتحسن قدره +16.9%)، وذلك بدمج قدرات التقسيم في SAM 3 مع قدرات الاستدلال في MLLM.
على معيار SA-Co/Gold الذي يتضمن تعليقات توضيحية بشرية ثلاثية:
- الحد الأدنى البشري: 74.2 CGF1 (المعلّق الأكثر تحفظًا)
- أداء SAM 3: 65.0 CGF1
- الإنجاز: 88% من الحد الأدنى البشري المقدّر
- الحد الأعلى البشري: 81.4 CGF1 (المعلّق الأكثر تساهلًا)
يحقق SAM 3 أداءً قويًا يقترب من دقة البشر في تقسيم المفاهيم ذات المفردات المفتوحة، وتتركز الفجوة أساسًا في المفاهيم الملتبسة أو الذاتية (مثل «نافذة صغيرة» و«غرفة مريحة»).


التعليقات105
اطرح سؤالًا، وشارك نتائجك، أو ساعد شخصًا آخر.
 Glenn JocherUltralytics(تم التعديل)
SAM 3 looks like a big step forward for open-vocabulary segmentation, and it is now supported natively in
ultralytics. This page covers text, exemplar and video prompts; thesam3.ptweights are gated and must be requested from Meta on Hugging Face first.Feel free to drop questions or comments for the team below!
7koolfox
Incredible, when you think it’s available for use?
2- Glenn JocherUltralytics(تم التعديل)
SAM 3 is available now in
ultralytics: runpip install -U ultralyticsand see this page for usage. Thesam3.ptweights must be requested from Meta first. Abdulhady-WITCo
Appreciate the effort, and can't wait for your implementation. It's resource heavy already but I'm sure your optimisation will make a difference. Best of luck.
- Glenn JocherUltralytics(تم التعديل)
Thanks for the kind words—most of the credit goes to the Meta SAM team and the Ultralytics community. SAM 3 is now available in
ultralytics, and this page covers exactly those trade-offs, so you can balance its open-vocabulary power against lighter options like YOLO26 or SAM 2 on your hardware.
mishaogui
sam3如何把預訓練模型導出onnx進行推理,目前官方好像還不支持導出,求導出和推理。
1- Glenn JocherUltralytics(تم التعديل)
目前
ultralytics里 SAM 3 只支持predict/track推理,还没有提供把sam3.pt导出 ONNX 的官方流程(yolo export主要面向 YOLO 等可部署导出管线的模型);建议先按 SAM 3 使用文档 用 PyTorch 方式部署推理。如果你的目标是 ONNX 部署分割(固定类别/已知类别),更推荐直接用可导出的 YOLO26 分割 并参考 Export 模式;若你这边是“必须 SAM3→ONNX”的需求,麻烦在 Ultralytics 新建 Issue 说明场景并附上
yolo checks和最小复现脚本,方便我们评估支持路径。
tomer196
Hi, thanks for the great work. I am trying to use sam3.1. Is it supported? I tried using sam3.1 weights, and it seems to work, but each frame the objects get new IDs. Am I doing something wrong? Thanks
- Glenn JocherUltralytics(تم التعديل)
SAM 3.1 is supported for image prediction: load
sam3.1_multiplex.ptwherever the image examples usesam3.pt(SAM("sam3.1_multiplex.pt")for point and box prompts,SAM3SemanticPredictorfor text and exemplar prompts). Object Multiplex video tracking is not supported yet, so usesam3.ptwithSAM3VideoPredictororSAM3VideoSemanticPredictor. For stable identities across frames, run a video predictor on the full video rather than image inference frame-by-frame, since per-frame inference assigns fresh IDs each time. See the SAM 3 docs and the SAM predictor reference, and if you’re already doing that please drop a minimal repro plusyolo checksoutput here so the team can take a closer look.
yccckid
你好,我测试下来输入的常见的类别的提示词(包括一些限定词)都是可以分割的。不过提示词输入得越多确实MLLM时间会更长,sam分割倒是挺快的。你说的这个“ 只有在单点(正负样本)和掩码提示(精细化粗糙掩码)是会出现分割源码出现零碎和空洞现象 ”是在分割什么物体?物体的表面纹理是不是比较sparsely textured?怎么解决的?谢谢
On Thu, 23 Apr 2026 at 09:11, Yiwang2333 @.***> wrote:
我之前使用MLLM与SAM3结合起来成为SAM 3 Agent进行测试并没有发现分割的掩码出现空洞问题,他们都是完整的,只不过会出现分割不了提示词中的内容,而且耗时这方面会增加,这也正常。只有在单点(正负样本)和掩码提示(精细化粗糙掩码)是会出现分割源码出现零碎和空洞现象
— Reply to this email directly, view it on GitHub https://github.com/orgs/ultralytics/discussions/22441?email_source=notifications&email_token=APKLLPPMDYK4F36HG6B3BOL4XFUUJA5CNFSNUABIM5UWIORPF5TWS5BNNB2WEL2ENFZWG5LTONUW63SDN5WW2ZLOOQXTCNRWG43TCMBVUZZGKYLTN5XKOY3PNVWWK3TUUVSXMZLOOSWGM33PORSXEX3DNRUWG2Y#discussioncomment-16677105, or unsubscribe https://github.com/notifications/unsubscribe-auth/APKLLPKUZ2OAWS3Y672TETD4XFUUJAVCNFSM6AAAAACJTVH7HGVHI2DSMVQWIX3LMV43URDJONRXK43TNFXW4Q3PNVWWK3TUHMYTMNRXG4YTANI . You are receiving this because you commented.Message ID: @.*** com>
- Glenn JocherUltralytics
这种情况更像是
SAM("sam3.pt")的视觉提示分割问题而不是概念分割本身:单点或粗掩码在细长边界、低对比度或稀疏纹理目标上更容易出现碎片和空洞,通常可通过增加正负点、改用更紧的框提示,或直接用SAM3SemanticPredictor做文本/示例提示来改善,相关用法见 SAM 3 文档;如果你愿意,也欢迎把一张示例图和最小复现代码直接发在这个讨论里,我们可以按你的具体 case 看看。 Yiwang2333
其实我也想把示例和代码文件展示出来,但是可能我太蠢了不知道怎么发在这个讨论中,我已急哭😭
- Glenn JocherUltralytics
没关系,直接发在这里就可以:图片可直接拖到评论框上传,代码按 GitHub Markdown 写法 用代码块贴出;如果文件太大,就先发一个最小复现示例,只保留
model初始化、输入图像、提示词和实际输出即可,例如:from ultralytics import SAM model = SAM("sam3.pt") results = model.predict("test.jpg", points=[900, 370], labels=[1]) print(results[0].masks.data.shape if results[0].masks is not None else None)如果暂时不方便传图,也可以先把异常现象和文字版输出贴出来,我们继续帮你看。
一、单点分割 import numpy as np import torch from PIL import Image from sam3.model_builder import build_sam3_image_model from sam3.model.sam3_image_processor import Sam3Processor
device = "cuda" if torch.cuda.is_available() else "cpu" sam3_pt_path = "sam3_model/sam3.pt"
model = build_sam3_image_model( bpe_path=None, checkpoint_path=sam3_pt_path, device=device, enable_inst_interactivity=True, load_from_HF=False, ) processor = Sam3Processor(model) model.eval()
pil_image = Image.open("test.jpg").convert("RGB") inference_state = processor.set_image(pil_image)
正样本(1) + 负样本(0),点数与标签一一对应
point_coords = np.array([ [900.0, 370.0], # 前景点:点在目标上 [800.0, 400.0], # 背景点:点在要排除的区域 ]) point_labels = np.array([1, 0])
masks, scores, logits = model.predict_inst( inference_state, point_coords=point_coords, point_labels=point_labels, multimask_output=True, ) best = masks[int(np.argmax(scores))] mask_np = best.cpu().numpy() if isinstance(best, torch.Tensor) else np.asarray(best) print(mask_np.shape)
二、交互式细化 import numpy as np import torch from PIL import Image from sam3.model_builder import build_sam3_image_model from sam3.model.sam3_image_processor import Sam3Processor
device = "cuda" if torch.cuda.is_available() else "cpu" sam3_pt_path = "sam3_model/sam3.pt"
model = build_sam3_image_model( bpe_path=None, checkpoint_path=sam3_pt_path, device=device, enable_inst_interactivity=True, load_from_HF=False, ) processor = Sam3Processor(model) model.eval()
pil_image = Image.open("test.jpg").convert("RGB") inference_state = processor.set_image(pil_image)
若需要文本提示(与 demo 一致):
inference_state = processor.set_text_prompt(state=inference_state, prompt="your english prompt")
init_x = 900.0 init_y = 370.0 refinement_points = [[910.0, 380.0], [920.0, 360.0]] refinement_labels = [1, 0]
all_points = [[init_x, init_y]] + refinement_points all_labels = [1] + refinement_labels
masks, scores, logits = model.predict_inst( inference_state, point_coords=np.array(all_points), point_labels=np.array(all_labels), multimask_output=True, ) best = masks[int(np.argmax(scores))] mask_np = best.cpu().numpy() if isinstance(best, torch.Tensor) else np.asarray(best) print(mask_np.shape)
测试使用的是同一张图片,分割的内容是图中汽车,在单点分割和交互式细化中正负样本点结合使用会出现分割车辆边缘出现参差不齐零碎现象
- Glenn JocherUltralytics
感谢把代码贴出来,这更像是交互式点提示的行为而不是“汽车”这个类别本身:车窗反光、轮胎空隙和细长边界会让负点一旦靠近车身就容易把掩码边缘切碎或挖空,而且
multimask_output=True返回的最高分候选也不一定是最平滑的那个;建议先把负点移到目标外更远的位置、在断裂边缘补几个正点,或直接改用框/示例提示,如果你的目标是稳定分割整辆车,SAM3SemanticPredictor的文本/示例提示通常比稀疏点提示更稳,相关接口可参考 SAM 3 文档里的视觉提示与概念分割说明。 感谢您的回答,我还有一个问题,就是文本提示分割时,文本提示词可以对多张图片起作用,能做输入一个文本可以对所有图片进行分割,这一个功能已经实现。 但是有一个我实在是难以实现,就是比如有多张图片A、B、C、D...,在纯框选示例提示分割下,能不能做到只在A图上进行框选,然后进行纯框选示例提示分割时可以对A、B、C、D...多张图片进行分割呢。也就是实现一批图片中,只在一张图片上进行框选就能进行所有图片的分割,类似于图片搜索一样,在一批图片中随机挑一张图片,在这张挑选的图片中框选出汽车然后所有图片中的汽车都能被分割出来(类似在一批图片中框选后搜索出有汽车的图片进行分割)。我不知道这个功能是否能做到。 目前我使用的方法是在框选时将框选的目标进行切块,然后拼接在每一张待搜索图片上,最后根据拼接图片中的小目标切块进行示例提示分割,来实现一张图中框选能对所有图片进行分割,不过这种方法的效果有些一般,有时候分割不到东西或者是遗漏一些需要分割的目标。 还有一种方法是评论区向我提供的思路,将几何特征缓存下来,然后再另一张图片上应用这个几何特征,参考https://github.com/leon0514/trt-sam3,但是这位先生也提到了效果不好,目前我也正在尝试实现这种方法。 或者是理解在单图时框选示例提示分割到底在做什么,然后将这个行为重复作用于其他图片,这样是否也能实现呢?
- Glenn JocherUltralytics
目前原生
SAM3SemanticPredictor还不支持“在 A 图框一次,然后直接对 B/C/D 这类独立图片做纯示例检索+分割”;bboxes示例提示是作用在当前set_image()的那张图上,而文档里的inference_features()也是复用同一张图的特征、不是跨图迁移,所以更可靠的做法还是先用文本提示或检索/检测筛出候选图,再逐张做 SAM 3 分割,接口细节可参考 SAM3SemanticPredictor 参考。 好的,谢谢您的回复
shspc
ultralytics支持从其他图像中抽取特征作为视觉提示吗
在SAM3中
- Glenn JocherUltralytics
目前公开接口里,SAM 3 支持用
SAM3SemanticPredictor的bboxes做 exemplar 式视觉提示,也支持用inference_features()复用已提取特征,但文档里的用法主要是对当前图像做特征复用,不是直接把“另一张图像”的特征当作 prompt 传入;你可以先参考 SAM 3 文档 和 predictor API,如果你的目标是跨图像 exemplar prompting,欢迎把最小复现流程贴在这里,团队会继续看。 aoaoy288-oss
想知道,sam3是否能导成ONNX等格式
ZePequeno25
gostei bastante da para integrar diferentes modelos
SWTZJD
想请问SAM3最低支持的python版本和pytorch版本
- Glenn JocherUltralytics
欢迎直接把环境信息贴在这里,团队会看到;按目前公开信息,
SAM 3自ultralytics>=8.3.237起已集成,而ultralytics的基础要求是 Python>=3.8、PyTorch>=1.8,所以SAM 3目前至少按这组版本起步,参考 SAM 3 文档 和 Ultralytics PyPI 安装说明。 (docs.ultralytics.com)
cyt1990cyt1990-dev
运行环境为:Ultralytics 8.4.21 Python-3.11.8 torch-2.5.1+cu121 CUDA:0 (NVIDIA GeForce RTX 4070, 12282MiB) 运行使用掩码提示的概念分割的示例程序报错如下:WARNING imgsz=[640] must be multiple of max stride 14, updating to [644] Traceback (most recent call last): File "C:\Users\admin\PycharmProjects\PythonProject\testMasks.py", line 12, in results = predictor(source=img_path, masks=[rough]) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\engine\predictor.py", line 225, in call return list(self.stream_inference(source, model, *args, **kwargs)) # merge list of Results into one ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\utils_contextlib.py", line 36, in generator_context response = gen.send(None) ^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\engine\predictor.py", line 330, in stream_inference preds = self.inference(im, *args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 205, in inference return self.prompt_inference(im, bboxes, points, labels, masks, multimask_output) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 236, in prompt_inference return self._inference_features(features, *prompts, multimask_output) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 814, in _inference_features pred_masks, pred_scores, _, _ = self.model.sam_mask_decoder( ^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\nn\modules\module.py", line 1736, in _wrapped_call_impl return self._call_impl(*args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\nn\modules\module.py", line 1747, in _call_impl return forward_call(*args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\modules\decoders.py", line 334, in forward masks, iou_pred, mask_tokens_out, object_score_logits = self.predict_masks( ^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\modules\decoders.py", line 398, in predict_masks src = src + dense_prompt_embeddings ~~~~^~~~~~~~~~~~~~~~~~~~~~~~~ RuntimeError: The size of tensor a (46) must match the size of tensor b (161) at non-singleton dimension 3
运行代码如下所示: import cv2 import numpy as np from ultralytics.models.sam import SAM3Predictor
predictor = SAM3Predictor(overrides=dict(task="segment", mode="predict", model="sam/sam3.pt")) img_path = "测试图片/测试图片1/Out.jpg" rough = cv2.imread("测试图片/测试图片1/rough.jpg", cv2.IMREAD_GRAYSCALE) rough = (rough > 0).astype(np.uint8)
results = predictor(source=img_path, masks=[rough]) for result in results: annotated_img = result.plot() cv2.imshow("SAM with Mask Prompt", annotated_img) cv2.waitKey(0) cv2.destroyAllWindows()
图片Out.jpg,rough.jpg是大小为4024*3036,位深度为8的灰度图片
- Glenn JocherUltralytics
感谢补充代码,这个报错看起来不是图片分辨率本身的问题,而是
SAM3Predictor走masks=提示时出现了特征尺寸不匹配;按 SAM 3 文档 当前概念分割应使用SAM3SemanticPredictor配合text或示例bboxes,而SAM("sam3.pt")/SAM3Predictor主要是单对象视觉提示流程。若你在最新版本下仍需要masks提示,请新开一个 issue 并附上yolo checks输出、完整文本回溯和最小可复现脚本,方便我们确认这是否是 SAM 3 的一个 bug。
max-dev-14
I'd compared facebook/sam3 and ultralytics/sam3. I set up both the models for inference as follow: imgsz=1008, half=True, conf=0.5 and prompts = [ "person", "car", "truck", "tractor", "building", "combine harvester", "power lines", "clear sky", "trees", "crop field", "harvested field", "grassy field", "dark frame edges", "farm lane", "windrow" ] I'd attached scripts I used for inference: ul-sam3.py - ultralytics/sam3 inference. fb-sam3.py - facebook/sam3 inference.
I expected that there would be the same results of inference on the same videos and paramteres above. But I'd got different segments, as it can be seen on the screens below (there are original frame to the left, facebook/sam3 segmentation on the middle and ultralytics/sam3 segmentation to the right).
Can someone explain me why it's happened like this?
- Glenn JocherUltralytics
Thanks for raising it here — exact parity with
facebookresearch/sam3isn’t expected, because the Ultralytics integration uses its own SAM 3 predictor path for resizing/preprocessing and postprocessing, so matchingimgsz,half,conf, and prompts alone won’t guarantee identical masks; see the SAM 3 docs and the predictor reference. If you’d like us to check whether this is a bug rather than an implementation difference, please open a new issue with a minimal reproducible example, confirm both runs use the samesam3.pt, and includeyolo checksplus the full text outputs from both scripts.