CIFAR-100-Datensatz#
Der Datensatz CIFAR-100 (Canadian Institute For Advanced Research) ist ein Benchmark für die Bildklassifizierung mit 60.000 farbigen Bildern der Größe 32x32, die gleichmäßig auf 100 feingliedrige Klassen verteilt sind (je 600 Bilder). Diese Klassen sind wiederum in 20 übergeordnete Klassen gruppiert. Der von Alex Krizhevsky erstellte Datensatz wird mit einer vordefinierten Aufteilung in 50.000 Trainings- und 10.000 Testbilder bereitgestellt und ist die anspruchsvollere, feiner gegliederte Entsprechung des Datensatzes CIFAR-10.
Sieh dir CIFAR-100 auf der Ultralytics Platform an, um Beispiele in der Vorschau zu sehen, Datensatzstatistiken zu prüfen und den Datensatz zum Training zu kopieren.
Wichtige Funktionen#
- CIFAR-100 umfasst 60.000 Farbbilder mit jeweils 32x32 Pixeln, gleichmäßig auf 100 Klassen verteilt.
- Jede Klasse umfasst genau 600 Bilder – 500 zum Trainieren und 100 zum Testen. Der Datensatz ist somit perfekt ausgewogen.
- Die 100 feingliedrigen Klassen sind für die Klassifizierung auf höherer Ebene in 20 übergeordnete Klassen gruppiert.
- Der Datensatz wird mit einer vordefinierten Aufteilung in Trainings- und Testdaten bereitgestellt; eine manuelle oder automatische Aufteilung ist daher nicht erforderlich.
- CIFAR-100 ist ein Standardbenchmark für die Forschung zu feingliedriger Bildklassifizierung und Objekterkennung.
Datensatzstruktur#
CIFAR-100 wird mit einer offiziellen, vordefinierten Aufteilung bereitgestellt, sodass weder eine automatische noch eine manuelle Aufteilung erforderlich ist:
- Klassen: 100 feingliedrige Klassen, gruppiert in 20 übergeordnete Klassen
- Bilder insgesamt: 60.000 (32x32, Farbe)
- Trainingsdaten: 50.000 Bilder (500 pro Klasse)
- Testdaten: 10.000 Bilder (100 pro Klasse)
CIFAR-100 hat keinen separaten Validierungsordner. Daher verwendet Ultralytics standardmäßig während des Trainings die 10.000 Testbilder als Validierungsdaten. Beim Training mit data="cifar100" lernt das Modell die 100 feingliedrigen Klassen.
Anwendungsfälle#
CIFAR-100 wird häufig zum Trainieren und Evaluieren von Bildklassifizierungs-Modellen verwendet – von klassischen faltenden neuronalen Netzen (CNNs) und Support-Vektor-Maschinen (SVMs) bis hin zu modernen tiefen Architekturen. Die 100 fein abgestuften Klassen und die geringe Bildgröße machen den Datensatz zu einem anspruchsvollen Benchmark für die maschinelle Lernforschung, den Algorithmusvergleich und Experimente im Bereich Computer Vision.
Verwendung#
Trainiere ein YOLO-Modell auf CIFAR-100 für 100 Epochen mit einer Bildgröße von 32. Eine vollständige Liste der verfügbaren Argumente findest du auf der Seite Training und in der Anleitung zur Aufgabe Bildklassifizierung.
from ultralytics import YOLO

# Ein Modell laden
model = YOLO("yolo26n-cls.pt")  # ein vortrainiertes Modell laden (für das Training empfohlen)

# Das Modell trainieren
results = model.train(data="cifar100", epochs=100, imgsz=32)
Beispielbilder und Annotationen#
Beispielbilder aus dem CIFAR-100-Datensatz:
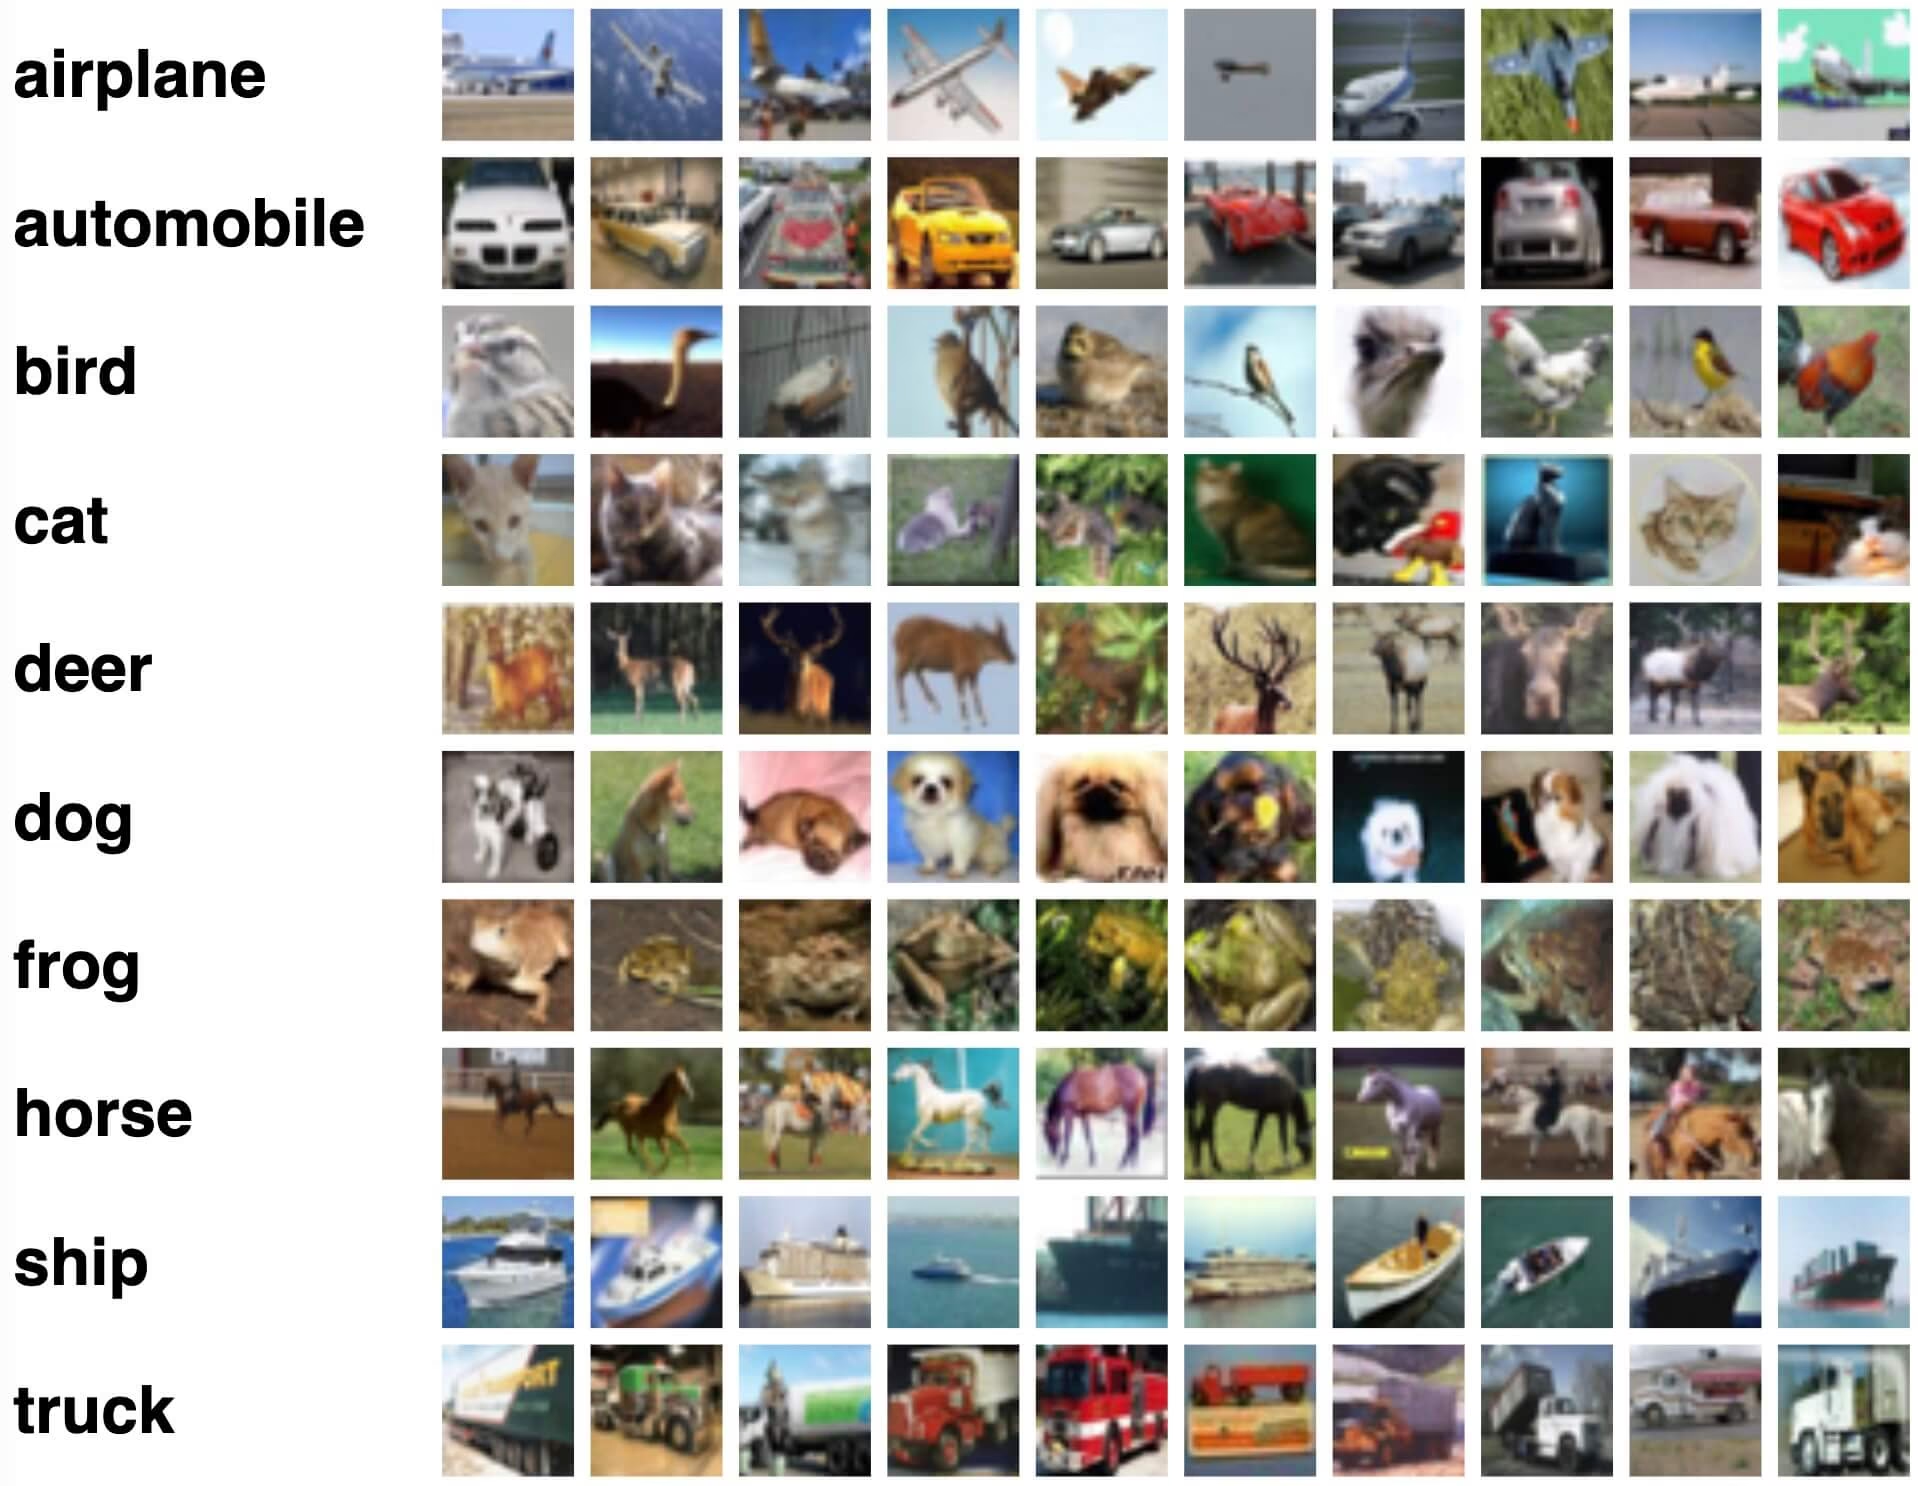
Die Beispiele veranschaulichen die Vielfalt der Objekte im CIFAR-100-Datensatz und zeigen, wie wichtig ein vielfältiger Datensatz für das Training robuster Bildklassifizierungsmodelle ist.
Zitate und Danksagungen#
Wenn du den CIFAR-100-Datensatz für deine Forschungs- oder Entwicklungsarbeit verwendest, zitiere bitte die folgende Veröffentlichung:
@TECHREPORT{Krizhevsky09learningmultiple,
            author={Alex Krizhevsky},
            title={Learning multiple layers of features from tiny images},
            institution={},
            year={2009}
}
Wir möchten Alex Krizhevsky dafür danken, dass er den CIFAR-100-Datensatz erstellt und gepflegt hat und ihn so der Forschungscommunity für maschinelles Lernen und Computer Vision als wertvolle Ressource zur Verfügung stellt. Weitere Informationen zum CIFAR-100-Datensatz und seinem Ersteller findest du auf der CIFAR-100-Datensatzwebsite.
Häufig gestellte Fragen#
Der Datensatz CIFAR-100 wird häufig zum Trainieren und Bewerten fein abgestufter Bildklassifizierungs- und Objekterkennungsmodelle verwendet. Er umfasst 60.000 Farbbilder mit einer Größe von 32x32 Pixeln aus 100 Klassen, die in 20 Oberklassen gruppiert sind. Damit ist er ein anspruchsvollerer Benchmark als CIFAR-10 für Algorithmen wie faltende neuronale Netze (CNNs) und Support-Vektor-Maschinen (SVMs) sowie für die Bewertung von Deep-Learning-Modellen, die mit Ultralytics YOLO erstellt wurden.
Verwende die folgenden Codeausschnitte, um ein Ultralytics-YOLO-Modell auf CIFAR-100 zu trainieren. Beim ersten Aufruf wird der Datensatz automatisch heruntergeladen. Eine vollständige Liste der Argumente findest du auf der Seite Training des Modells.
Trainingsbeispielfrom ultralytics import YOLO # Ein Modell laden model = YOLO("yolo26n-cls.pt") # ein vortrainiertes Modell laden (für das Training empfohlen) # Das Modell trainieren results = model.train(data="cifar100", epochs=100, imgsz=32)CIFAR-100 umfasst 100 fein abgestufte Klassen – etwa Apfel, Delfin, Ahorn, Motorrad und Rakete – mit jeweils genau 600 Bildern, insgesamt also 60.000 Bildern. Diese 100 Klassen sind außerdem in 20 grobe Oberklassen gruppiert (zum Beispiel umfasst die Oberklasse Bäume Ahorn, Eiche, Palme, Kiefer und Weide). Beim Training mit
data="cifar100"werden die 100 fein abgestuften Klassen verwendet.CIFAR-100 enthält eine vordefinierte Aufteilung mit 50.000 Trainingsbildern und 10.000 Testbildern, wobei jede Klasse genau 500 Trainings- und 100 Testbilder umfasst. Anders als bei bildbasierten Klassifizierungsdatensätzen, die Ultralytics automatisch aufteilt, wird die offizielle Aufteilung von CIFAR-100 unverändert verwendet. Standardmäßig dient der Testsatz beim Training als Validierungsaufteilung.
Ja. Mit der Ultralytics Platform kannst du Datensätze verwalten, Bildklassifizierungs-Modelle trainieren und sie ohne großen Programmieraufwand bereitstellen. Sie eignet sich gut für CIFAR-100-Experimente in der Cloud. Weitere Möglichkeiten findest du in unserer Übersicht über Klassifizierungsdatensätze.