DOTA128-Datensatz#


Einführung#
Der DOTA128-Datensatz von Ultralytics ist ein kleiner, aber vielseitiger Datensatz zur orientierten Objekterkennung. Er besteht aus 128 Bildern des DOTAv1-Datensatzes, die sowohl zum Trainieren als auch zur Validierung dienen. Dieser Datensatz eignet sich ideal zum Testen und Debuggen von Modellen mit orientierten Begrenzungsrahmen (OBB) sowie zum Experimentieren mit neuen Erkennungsansätzen. Mit 128 Bildern ist er klein genug, um leicht handhabbar zu sein, und zugleich vielfältig genug, um Trainingspipelines auf Fehler zu prüfen und vor dem Training mit größeren Datensätzen als Plausibilitätsprüfung zu dienen.
Datensatzstruktur#
- Bilder: 128 Luftbildausschnitte aus DOTAv1 (alle im Trainingsordner; sie werden sowohl zum Trainieren als auch zur Validierung verwendet).
- Klassen: Übernimmt die 15 Kategorien von DOTAv1, darunter Flugzeug, Schiff und großes Fahrzeug.
- Labels: YOLO-formatierte orientierte Begrenzungsrahmen, die neben jedem Bild als
.txt-Dateien gespeichert werden. - Download: 34 MB; wird beim ersten Training automatisch von den GitHub-Ressourcen von Ultralytics heruntergeladen.
Dieser Datensatz ist für die Verwendung mit der Ultralytics Platform und YOLO26 vorgesehen.
YAML-Datei des Datensatzes#
Eine YAML-Datei legt die Datensatzkonfiguration fest. Sie enthält Informationen zu den Pfaden, Klassen und weiteren relevanten Angaben des Datensatzes. Beim DOTA128-Datensatz wird die Datei dota128.yaml unter https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/dota128.yaml gepflegt.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# DOTA128 dataset (128 images from the DOTAv1 split) by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/obb/dota128
# Example usage: yolo train model=yolo26n-obb.pt data=dota128.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── dota128 ← downloads here (34 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: dota128 # dataset root dir
train: images/train # train images (relative to 'path') 128 images
val: images/train # val images (relative to 'path') 128 images

# Classes for DOTA 1.0
names:
  0: plane
  1: ship
  2: storage tank
  3: baseball diamond
  4: tennis court
  5: basketball court
  6: ground track field
  7: harbor
  8: bridge
  9: large vehicle
  10: small vehicle
  11: helicopter
  12: roundabout
  13: soccer ball field
  14: swimming pool

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/dota128.zipVerwendung#
Um ein YOLO26n-obb-Modell 100 Epochen lang mit einer Bildgröße von 640 auf dem DOTA128-Datensatz zu trainieren, kannst du die folgenden Codebeispiele verwenden. Eine umfassende Liste der verfügbaren Argumente findest du auf der Seite zum Training des Modells.
from ultralytics import YOLO

# Ein Modell laden
model = YOLO("yolo26n-obb.pt")  # ein vortrainiertes Modell laden (für das Training empfohlen)

# Das Modell trainieren
results = model.train(data="dota128.yaml", epochs=100, imgsz=640)
Beispielbilder und Annotationen#
Hier siehst du einige Beispielbilder aus dem DOTA128-Datensatz mit den zugehörigen Annotationen:
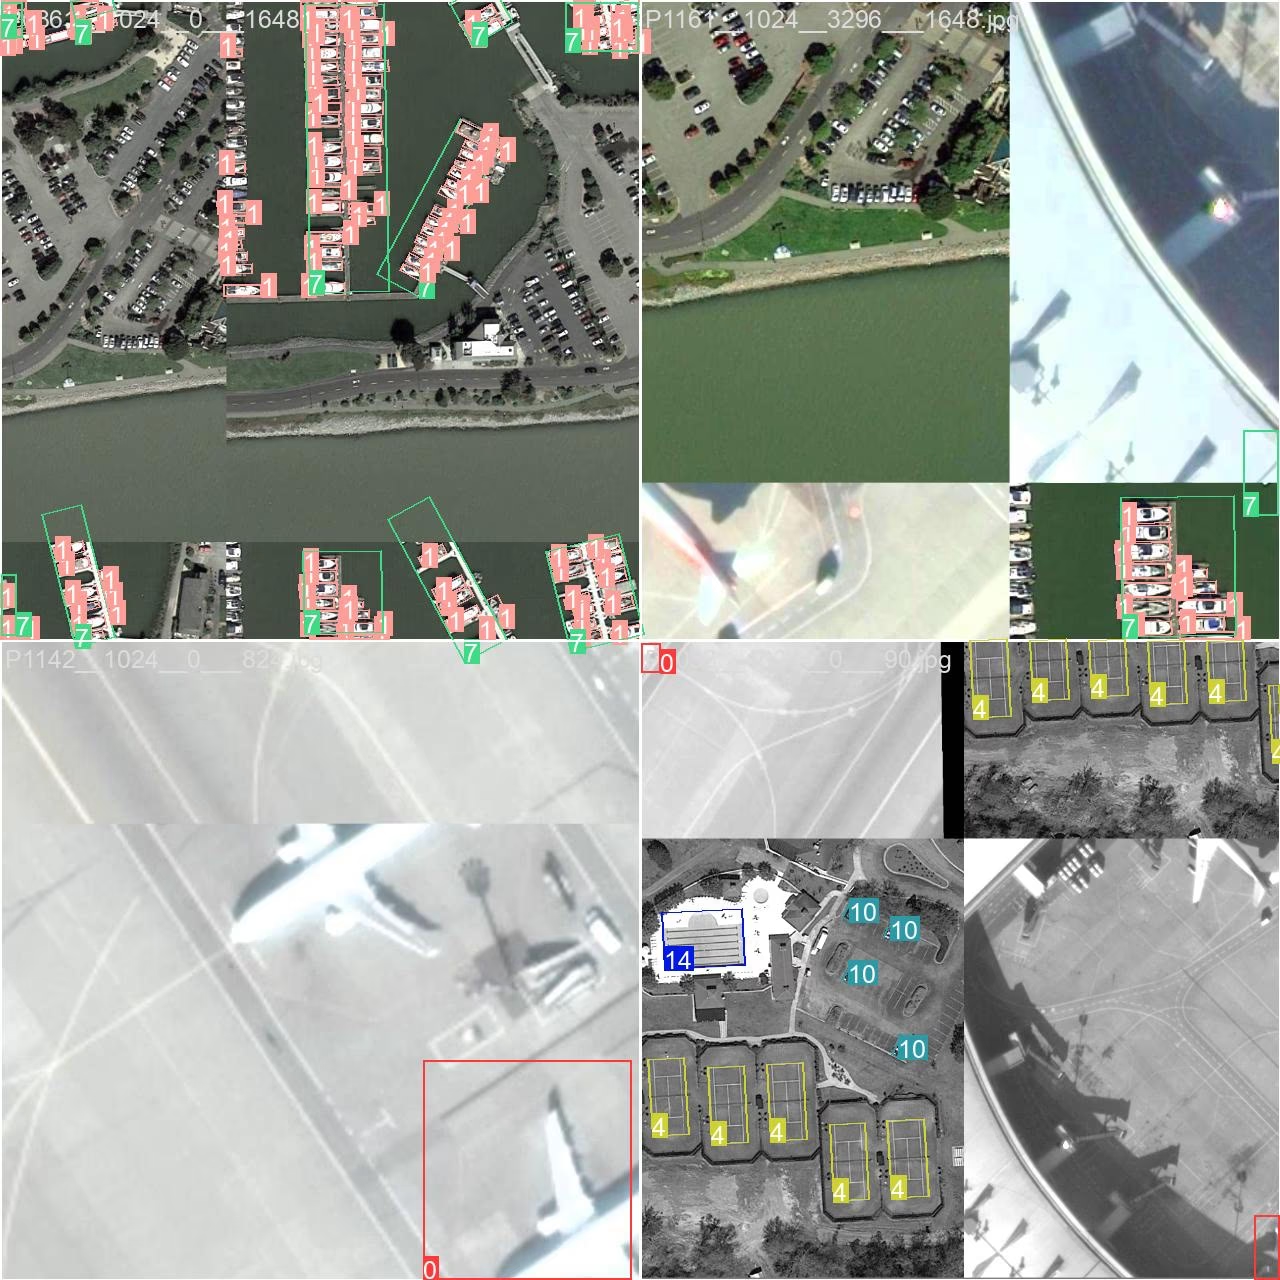
- Mosaikbild: Dieses Bild zeigt einen Trainingsbatch aus mosaikartig kombinierten Datensatzbildern. Beim Mosaikverfahren werden während des Trainings mehrere Bilder zu einem einzigen Bild kombiniert, um die Vielfalt der Objekte und Szenen in jedem Trainingsbatch zu erhöhen. Dadurch kann das Modell besser auf unterschiedliche Objektgrößen, Seitenverhältnisse und Kontexte generalisieren.
Das Beispiel veranschaulicht die Vielfalt und Komplexität der Bilder im DOTA128-Datensatz sowie die Vorteile des Mosaikverfahrens während des Trainings.
Zitate und Danksagungen#
Wenn du den DOTA-Datensatz für deine Forschungs- oder Entwicklungsarbeit verwendest, zitiere bitte die folgende Veröffentlichung:
@article{9560031,
  author={Ding, Jian and Xue, Nan and Xia, Gui-Song and Bai, Xiang and Yang, Wen and Yang, Michael and Belongie, Serge and Luo, Jiebo and Datcu, Mihai and Pelillo, Marcello and Zhang, Liangpei},
  journal={IEEE Transactions on Pattern Analysis and Machine Intelligence},
  title={Object Detection in Aerial Images: A Large-Scale Benchmark and Challenges},
  year={2022},
  volume={44},
  number={11},
  pages={7778-7796},
  doi={10.1109/TPAMI.2021.3117983}
}
Unser besonderer Dank gilt dem Team hinter den DOTA-Datensätzen für die bemerkenswerte Arbeit bei der Zusammenstellung dieses Datensatzes. Eine umfassende Erläuterung des Datensatzes und seiner Besonderheiten findest du auf der offiziellen DOTA-Website.
Häufig gestellte Fragen#
Der DOTA128-Datensatz ist ein vielseitiger Datensatz zur orientierten Objekterkennung. Er besteht aus 128 Bildern des DOTAv1-Datensatzes, die sich alle im Trainingsordner befinden. Zum Trainieren und zur Validierung wird derselbe Bildersatz verwendet. Dadurch eignet er sich ideal zum schnellen Testen und Debuggen von OBB-Modellen wie Ultralytics YOLO26. Dank seiner überschaubaren Größe und Vielfalt hilft er dabei, Fehler in der Pipeline zu finden und Plausibilitätsprüfungen durchzuführen, bevor du mit größeren Datensätzen trainierst. Erfahre mehr über die OBB-Erkennung mit Ultralytics YOLO26.
Um ein YOLO26n-obb-Modell 100 Epochen lang mit einer Bildgröße von 640 auf dem DOTA128-Datensatz zu trainieren, kannst du die folgenden Codebeispiele verwenden. Eine umfassende Übersicht der Argumente findest du auf der Seite zum Training des Modells.
Trainingsbeispielfrom ultralytics import YOLO # Ein Modell laden model = YOLO("yolo26n-obb.pt") # ein vortrainiertes Modell laden (für das Training empfohlen) # Das Modell trainieren results = model.train(data="dota128.yaml", epochs=100, imgsz=640)Der DOTA-Datensatz ist für seinen groß angelegten Benchmark und die Herausforderungen bei der Objekterkennung in Luftbildern bekannt. Die Teilmenge DOTA128 bietet mehr Vielfalt als DOTA8 und bleibt dennoch für erste Tests überschaubar. Die Datei
dota128.yamlmit Pfaden, Klassen und Konfigurationsangaben findest du unter diesem GitHub-Link.DOTA128 (128 Bilder) liegt hinsichtlich der Größe zwischen DOTA8 (8 Bilder) und dem vollständigen DOTA-v1-Datensatz (1.869 beschriftete Trainings- und Validierungsbilder):
- DOTA8: Enthält nur 8 Bilder (4 zum Trainieren, 4 zur Validierung) – ideal für schnelle Tests und zum Debuggen
- DOTA128: Enthält 128 Bilder (alle im Trainingsordner; sie werden sowohl zum Trainieren als auch zur Validierung verwendet) – ein ausgewogenes Verhältnis von Größe und Vielfalt
- Vollständiger DOTA-v1-Datensatz: Enthält 1.869 beschriftete Trainings- und Validierungsbilder – umfassend, aber ressourcenintensiv
DOTA128 bietet einen guten Mittelweg: Der Datensatz ist vielfältiger als DOTA8 und bleibt für Experimente und die anfängliche Modellentwicklung deutlich überschaubarer als der vollständige DOTA-Datensatz.
Beim Mosaikverfahren werden während des Trainings mehrere Bilder zu einem zusammengefügt. Dadurch steigt die Vielfalt der Objekte und Kontexte innerhalb jedes Batches. Das verbessert die Fähigkeit eines Modells, auf unterschiedliche Objektgrößen, Seitenverhältnisse und Szenen zu verallgemeinern. Veranschaulichen lässt sich diese Technik anhand eines Trainings-Batches aus mosaikierten Bildern des DOTA128-Datensatzes, der zur Entwicklung robuster Modelle beiträgt. Weitere Informationen zum Mosaikverfahren und zu Trainingstechniken findest du auf unserer Seite zum Training.
Ultralytics YOLO26 bietet hochmoderne Funktionen zur Objekterkennung in Echtzeit, darunter orientierte Begrenzungsrahmen (OBB), Instanzsegmentierung und eine äußerst vielseitige Trainingspipeline. Das Modell eignet sich für vielfältige Anwendungen und bietet vortrainierte Modelle für eine effiziente Feinabstimmung. Weitere Informationen zu den Vorteilen und zur Verwendung findest du in der Dokumentation zu Ultralytics YOLO26.