DOTA8-Datensatz
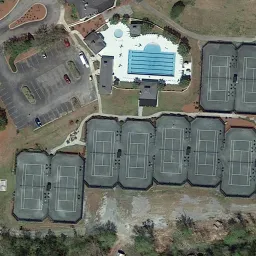
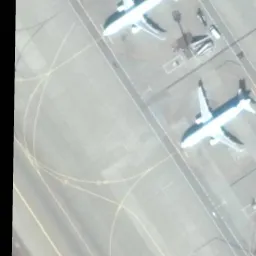
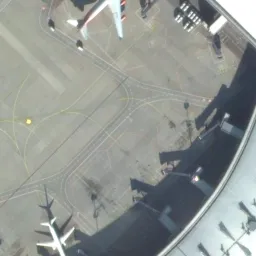
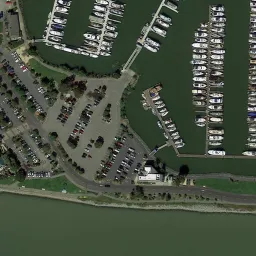
Einführung#
Ultralytics DOTA8 ist ein kleiner Datensatz zur Objekterkennung mit gedrehten Begrenzungsrahmen, der aus den ersten 8 Bildern des aufgeteilten DOTAv1-Datensatzes besteht: 4 für das Training und 4 für die Validierung. Dieser Datensatz eignet sich ideal zum Testen und Debuggen von Modellen zur Objekterkennung oder zum Ausprobieren neuer Erkennungsansätze. Mit 8 Bildern ist der Datensatz klein genug, um sich leicht handhaben zu lassen, und zugleich vielfältig genug, um Trainingsabläufe auf Fehler zu prüfen und vor dem Training mit größeren Datensätzen als Plausibilitätsprüfung zu dienen.
Datensatzstruktur#
-
Bilder: 8 Luftbildausschnitte (4 zum Trainieren, 4 zur Validierung) aus DOTAv1.
-
Klassen: Übernimmt die 15 Kategorien von DOTAv1, darunter Flugzeug, Schiff und großes Fahrzeug.
-
Labels: YOLO-formatierte orientierte Begrenzungsrahmen, die neben jedem Bild als
.txt-Dateien gespeichert werden. -
Download: 1 MB; wird beim ersten Training automatisch von den GitHub-Ressourcen von Ultralytics heruntergeladen.
-
Empfohlene Verzeichnisstruktur:
datasets/dota8/
├── images/
│   ├── train/
│   └── val/
└── labels/
    ├── train/
    └── val/
Sieh dir DOTA8 auf der Ultralytics Platform an, um die Luftbildausschnitte mit eingeblendeten orientierten Begrenzungsrahmen zu durchsuchen, die Klassenverteilung und Annotations-Heatmaps im Tab Charts anzusehen und den Datensatz zu klonen, um dein eigenes Modell in der Cloud zu trainieren.
YAML-Datei des Datensatzes#
Eine YAML-Datei legt die Datensatzkonfiguration fest. Sie enthält Informationen zu den Pfaden, Klassen und weiteren relevanten Angaben des Datensatzes. Beim DOTA8-Datensatz wird die Datei dota8.yaml unter https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/dota8.yaml gepflegt.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# DOTA8 dataset (8 images from the DOTAv1 split) by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/obb/dota8
# Example usage: yolo train model=yolov8n-obb.pt data=dota8.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── dota8 ← downloads here (1 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: dota8 # dataset root dir
train: images/train # train images (relative to 'path') 4 images
val: images/val # val images (relative to 'path') 4 images

# Classes for DOTA 1.0
names:
  0: plane
  1: ship
  2: storage tank
  3: baseball diamond
  4: tennis court
  5: basketball court
  6: ground track field
  7: harbor
  8: bridge
  9: large vehicle
  10: small vehicle
  11: helicopter
  12: roundabout
  13: soccer ball field
  14: swimming pool

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/dota8.zipVerwendung#
Um ein YOLO26n-obb-Modell für 100 Epochen mit einer Bildgröße von 640 auf dem Datensatz DOTA8 zu trainieren, kannst du die folgenden Codebeispiele verwenden.
from ultralytics import YOLO

# Ein Modell laden
model = YOLO("yolo26n-obb.pt")  # ein vortrainiertes Modell laden (für das Training empfohlen)

# Das Modell trainieren
results = model.train(data="dota8.yaml", epochs=100, imgsz=640)
Beispielbilder und Annotationen#
Hier siehst du einige Beispielbilder aus dem DOTA8-Datensatz mit den zugehörigen Annotationen:
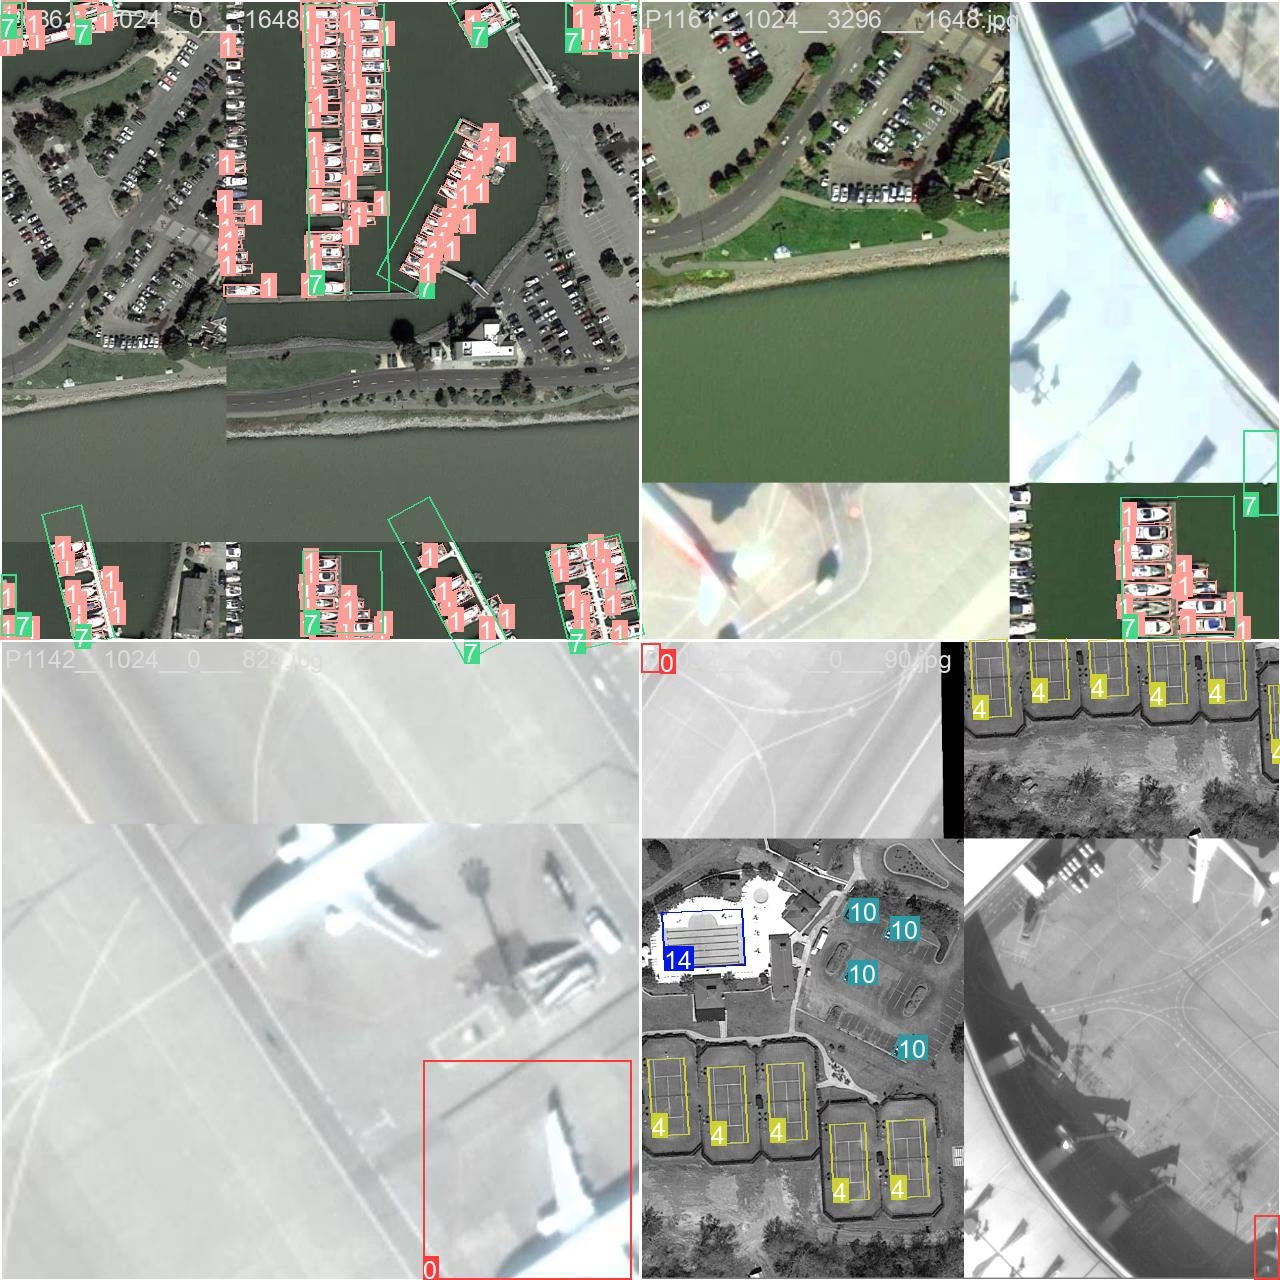
- Mosaikbild: Dieses Bild zeigt einen Trainingsbatch aus mosaikartig kombinierten Datensatzbildern. Beim Mosaikverfahren werden während des Trainings mehrere Bilder zu einem einzigen Bild kombiniert, um die Vielfalt der Objekte und Szenen in jedem Trainingsbatch zu erhöhen. Dadurch kann das Modell besser auf unterschiedliche Objektgrößen, Seitenverhältnisse und Kontexte generalisieren.
Das Beispiel veranschaulicht die Vielfalt und Komplexität der Bilder im DOTA8-Datensatz sowie die Vorteile des Mosaikverfahrens während des Trainings.
Zitate und Danksagungen#
Wenn du den DOTA-Datensatz für deine Forschungs- oder Entwicklungsarbeit verwendest, zitiere bitte die folgende Veröffentlichung:
@article{9560031,
  author={Ding, Jian and Xue, Nan and Xia, Gui-Song and Bai, Xiang and Yang, Wen and Yang, Michael and Belongie, Serge and Luo, Jiebo and Datcu, Mihai and Pelillo, Marcello and Zhang, Liangpei},
  journal={IEEE Transactions on Pattern Analysis and Machine Intelligence},
  title={Object Detection in Aerial Images: A Large-Scale Benchmark and Challenges},
  year={2022},
  volume={44},
  number={11},
  pages={7778-7796},
  doi={10.1109/TPAMI.2021.3117983}
}
Wir danken dem Team hinter den DOTA-Datensätzen für deren Zusammenstellung. Ausführliche Informationen zum Datensatz findest du auf der offiziellen DOTA-Website.
Häufig gestellte Fragen#
Der DOTA8-Datensatz ist ein kleiner Datensatz zur Objekterkennung mit gedrehten Begrenzungsrahmen. Er besteht aus den ersten 8 Bildern der DOTAv1-Aufteilung, von denen 4 für das Training und 4 für die Validierung vorgesehen sind. Er eignet sich ideal zum Testen und Debuggen von Modellen zur Objekterkennung wie Ultralytics YOLO26. Dank seiner überschaubaren Größe und Vielfalt hilft er dabei, Pipelinefehler zu erkennen und Plausibilitätsprüfungen durchzuführen, bevor du mit größeren Datensätzen trainierst.
Um ein YOLO26n-obb-Modell 100 Epochen lang mit einer Bildgröße von 640 auf dem DOTA8-Datensatz zu trainieren, kannst du die folgenden Codebeispiele verwenden. Eine vollständige Übersicht der Argumente findest du auf der Seite zum Training des Modells.
Trainingsbeispielfrom ultralytics import YOLO # Ein Modell laden model = YOLO("yolo26n-obb.pt") # ein vortrainiertes Modell laden (für das Training empfohlen) # Das Modell trainieren results = model.train(data="dota8.yaml", epochs=100, imgsz=640)Der DOTA-Datensatz ist für seinen umfangreichen Benchmark und die Herausforderungen bekannt, die er bei der Objekterkennung in Luftbildern stellt. Die DOTA8-Teilmenge ist ein kleinerer, überschaubarer Datensatz, der sich ideal für erste Tests eignet. Die
dota8.yaml-Konfigurationsdatei, die Pfade, Klassen und Konfigurationsdetails enthält, wird im Ultralytics-GitHub-Repository gepflegt.Beim Mosaikverfahren werden während des Trainings mehrere Bilder zu einem Bild kombiniert. Dadurch steigt die Vielfalt der Objekte und Kontexte in jedem Batch. Das verbessert die Fähigkeit eines Modells, auf unterschiedliche Objektgrößen, Seitenverhältnisse und Szenen zu generalisieren.
Ultralytics YOLO26 unterstützt die Objekterkennung in Echtzeit, einschließlich gedrehter Begrenzungsrahmen (OBB), sowie weitere Aufgaben wie die Instanzsegmentierung – alles über eine einzige Trainingspipeline. Die vortrainierten Modelle ermöglichen ein effizientes Feintuning.


Kommentare2
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.
expen6ve
How do you create a dataset for OBB? can i use the visdrone dataset to train an obb model?
 Glenn JocherUltralytics
@expen6ve yes, you can use VisDrone with YOLO OBB by converting your annotations to YOLO OBB format (four corner points with normalized coordinates). Create a dataset YAML file following our DOTA8 example structure, and ensure annotations match the required
class_index x1 y1 x2 y2 x3 y3 x4 y4format. For conversion tools and format details, see our OBB Dataset Guide.