Risssegmentierungsdatensatz
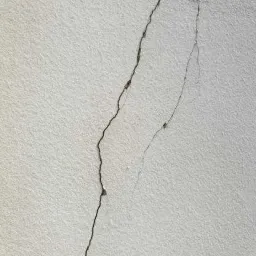
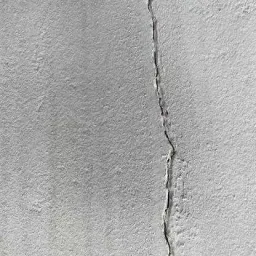
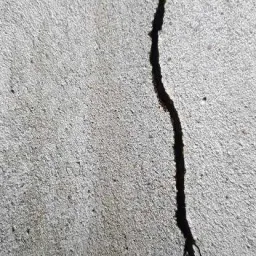
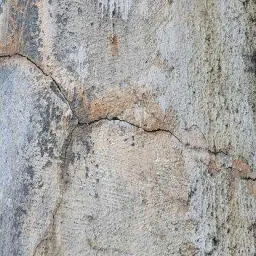

Der Ultralytics-Datensatz zur Risssegmentierung umfasst 4.029 annotierte Bilder von Rissen auf Straßen und an Wänden, die zum Training von Modellen zur Instanzsegmentierung mit einer einzigen Klasse crack dienen. Die Aufnahmen stammen aus vielfältigen Szenarien im Straßen- und Bauwerksbereich; der Datensatz lässt sich direkt mit Ultralytics YOLO für Anwendungsfälle kombinieren, die von der Verkehrssicherheit und der Umfelderkennung beim autonomen Fahren bis zur Instandhaltung von Infrastruktur und zur strukturellen Inspektion mit Computer Vision reichen.
Ansehen: So trainierst du mit Ultralytics YOLO26 ein Modell zur Risssegmentierung | KI im Bauwesen 🎉
Datensatzstruktur#
Der Risssegmentierungsdatensatz ist wie folgt in 4.029 Bilder aufgeteilt:
- Trainingssatz: 3.717 Bilder zum Trainieren des Deep-Learning-Modells.
- Validierungssatz: 200 Bilder, die während des Trainings zur Anpassung der Hyperparameter und zur Vermeidung von Überanpassung verwendet werden.
- Testsatz: 112 zurückgehaltene Bilder zur Bewertung des Modells nach dem Training.
- Klassen: eine einzige Klasse
crack, die alle annotierten Risse auf Straßen und Mauern umfasst. - Downloadgröße: ~91,6 MB.
Anwendungsfälle#
Die Segmentierung von Rissen unterstützt die Instandhaltung von Infrastruktur, indem sie Schäden an Gebäuden, Brücken und Straßen erkennt und bewertet. Sie verbessert außerdem die Straßensicherheit, da automatisierte Systeme Fahrbahnrisse erkennen können, sodass sie rechtzeitig repariert werden.
In der Industrie hilft die Risserkennung mit Modellen wie Ultralytics YOLO26 dabei, die Gebäudeintegrität im Bauwesen zu überprüfen, kostspielige Ausfallzeiten in der Fertigung zu vermeiden und Straßeninspektionen sicherer zu machen. Durch die automatische Klassifizierung von Rissen können Wartungsteams die dringendsten Reparaturen priorisieren.
Der vollständige Datensatz zur Risssegmentierung kann auch auf der Ultralytics Platform durchsucht und verwaltet werden.
YAML-Datei des Datensatzes#
Eine YAML-Datei definiert die Konfiguration des Datensatzes. Sie enthält Angaben zu den Pfaden, Klassen und weiteren relevanten Informationen des Datensatzes. Für den Datensatz zur Risssegmentierung wird die Datei crack-seg.yaml unter https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/crack-seg.yaml verwaltet.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Crack-seg dataset by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/segment/crack-seg
# Example usage: yolo train data=crack-seg.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── crack-seg ← downloads here (91.6 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: crack-seg # dataset root dir
train: images/train # train images (relative to 'path') 3717 images
val: images/val # val images (relative to 'path') 200 images
test: images/test # test images (relative to 'path') 112 images

# Classes
names:
  0: crack

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/crack-seg.zipVerwendung#
Um das Ultralytics-Modell YOLO26n-seg 100 Epochen lang mit Bildgröße 640 auf dem Crack-Segmentierungsdatensatz zu trainieren, verwende die folgenden Python- oder CLI-Codeausschnitte.
from ultralytics import YOLO

# Ein Modell laden
# Für eine schnellere Konvergenz wird ein vortrainiertes Modell wie yolo26n-seg.pt empfohlen
model = YOLO("yolo26n-seg.pt")

# Trainiere das Modell mit dem Datensatz zur Risssegmentierung
# Stelle sicher, dass 'crack-seg.yaml' verfügbar ist, oder gib den vollständigen Pfad an
results = model.train(data="crack-seg.yaml", epochs=100, imgsz=640)

# Nach dem Training kann das Modell für Vorhersagen verwendet oder exportiert werden
# results = model.predict(source='path/to/your/images')
Beispieldaten und Annotationen#
Unten siehst du ein Beispiel aus dem Crack-Segmentation-Datensatz mit überlagerten Instanzsegmentierungsmasken, die erkannte Risse auf Straßen- und Wandflächen umranden:
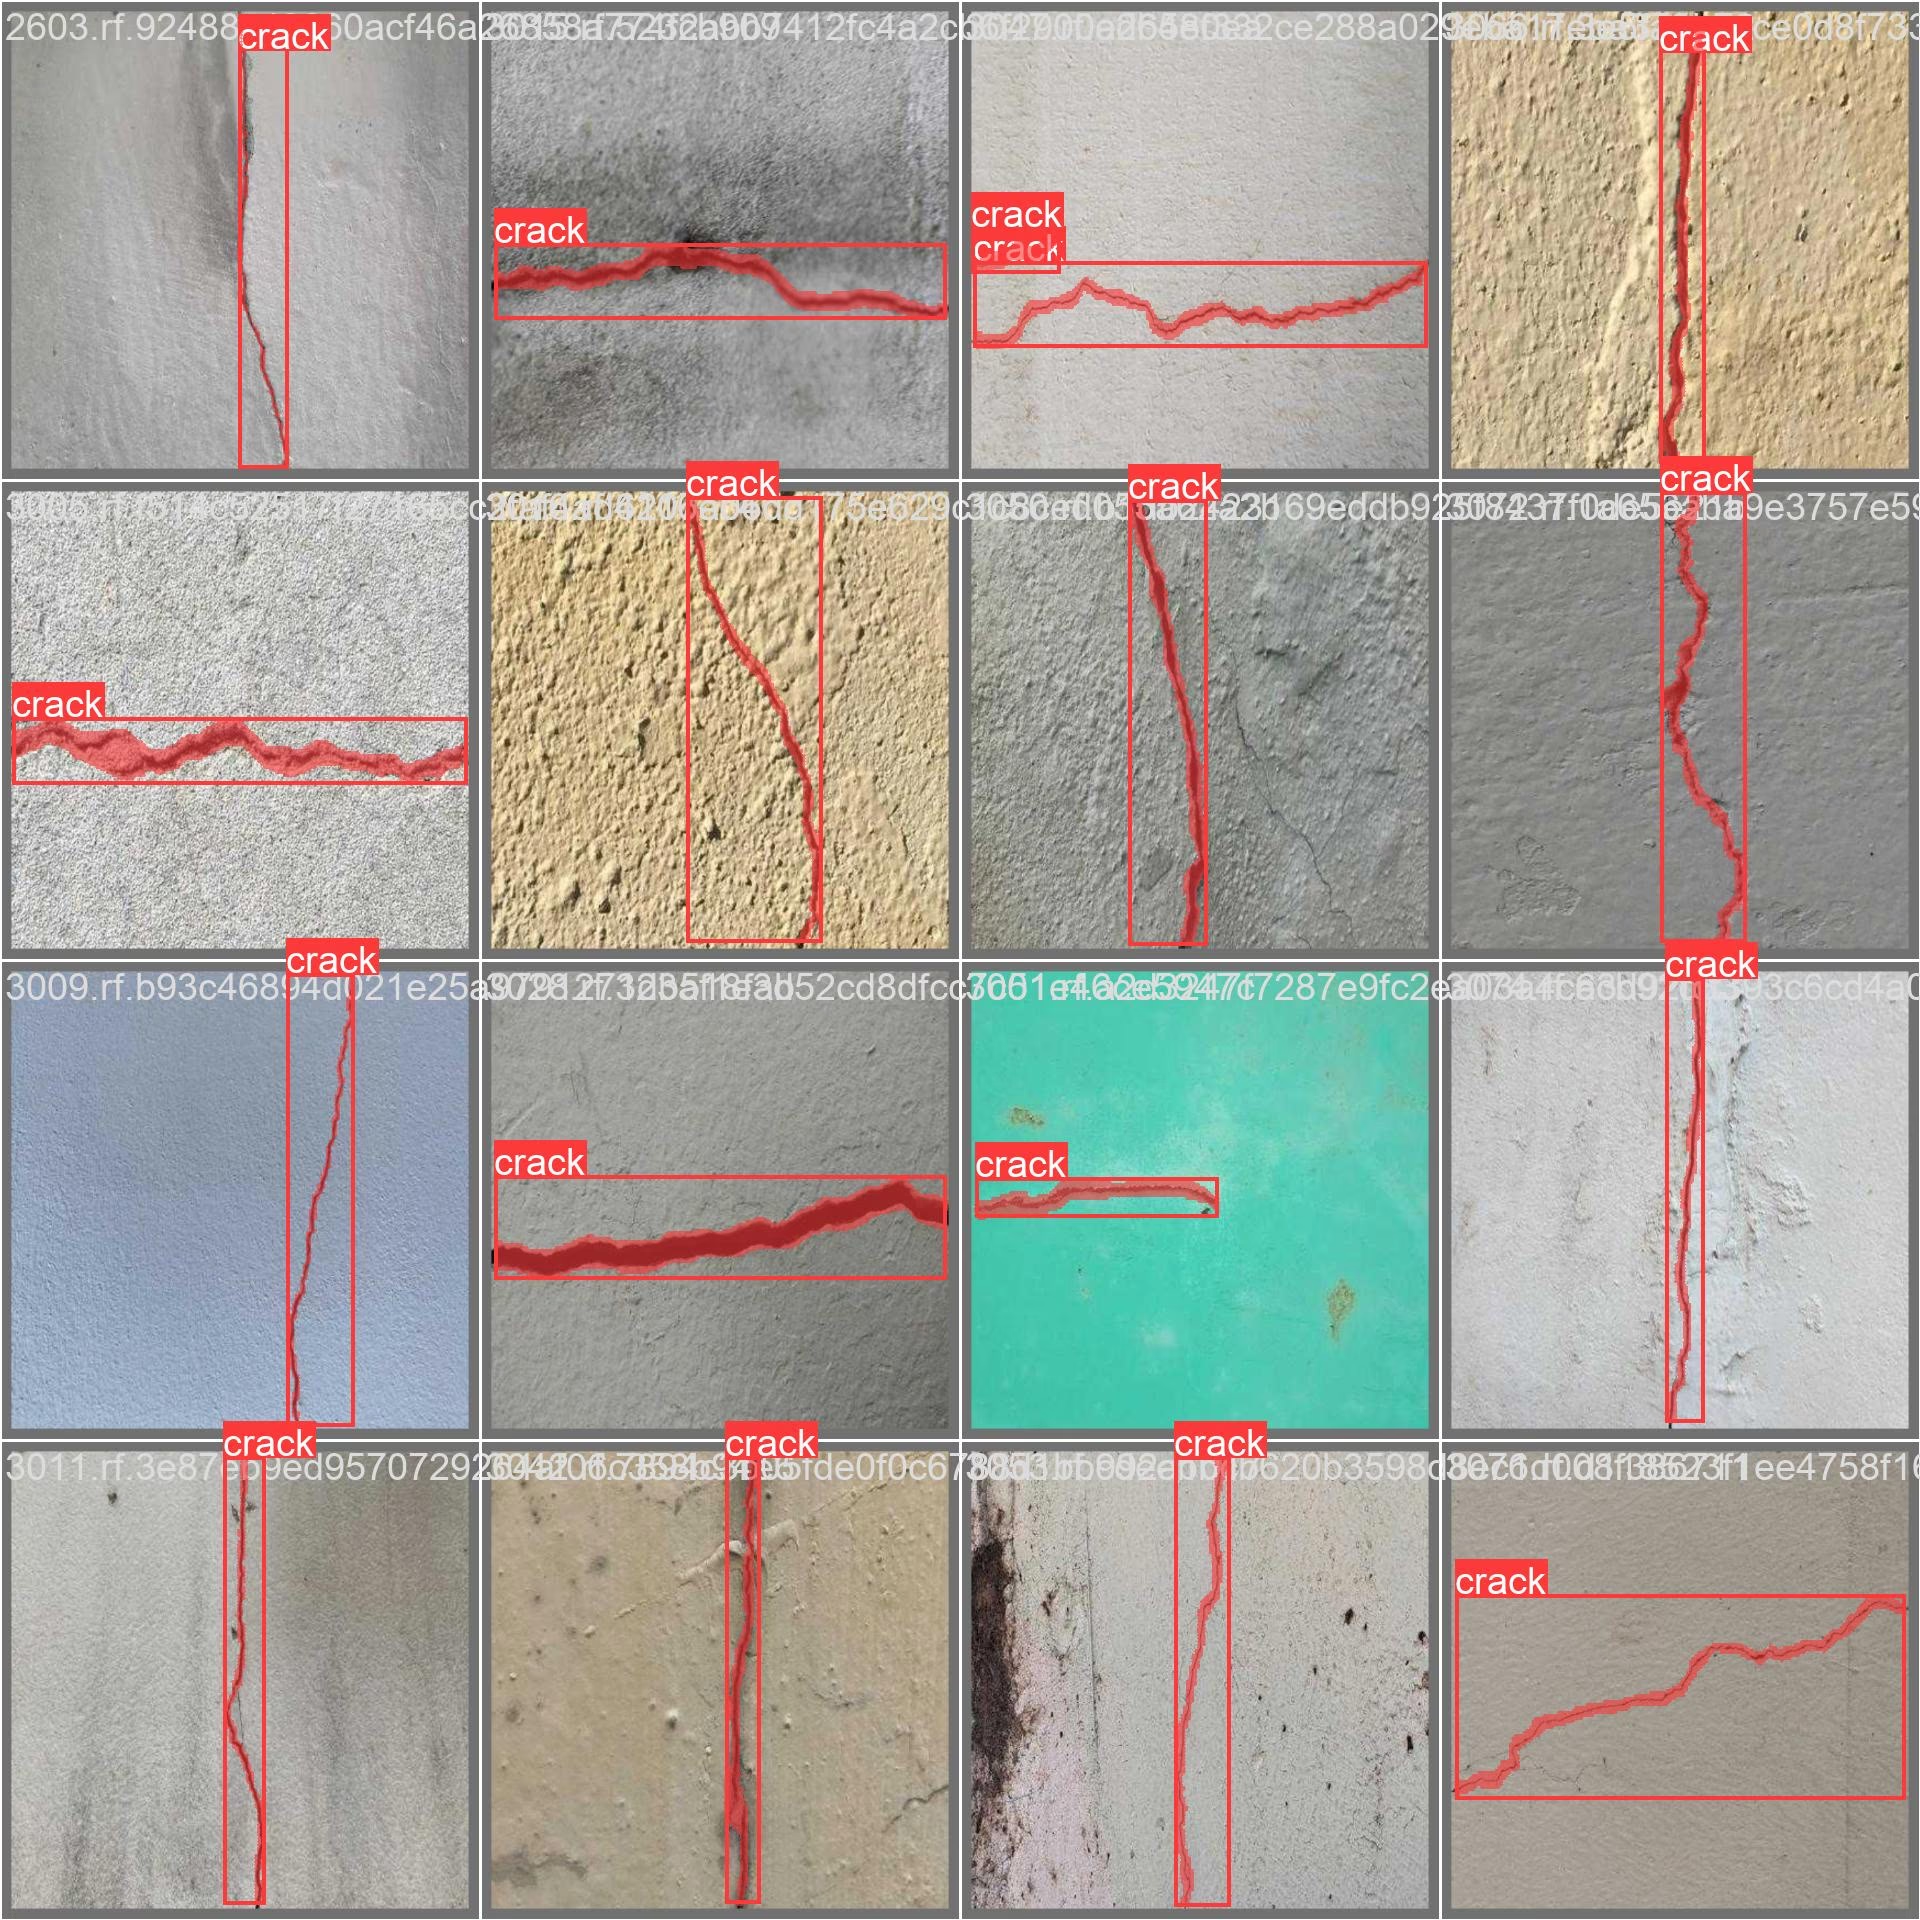
Der Datensatz umfasst verschiedene Standorte, Oberflächen und Lichtverhältnisse. Dadurch lernen die damit trainierten Modelle das Spektrum realer Szenen kennen, auf das sie verallgemeinert werden müssen. Mit Datenerweiterung lässt sich diese Vielfalt noch vergrößern – weitere passende Arbeitsabläufe findest du in unserem Leitfaden zu Instanzsegmentierung und Tracking.
Zitate und Danksagungen#
Wenn du den Datensatz zur Risssegmentierung in deiner Forschung oder Entwicklungsarbeit verwendest, zitiere bitte die Quelle korrekt:
@misc{ crack-bphdr_dataset,
    title = { crack Dataset },
    type = { Open Source Dataset },
    author = { University },
    url = { https://universe.roboflow.com/university-bswxt/crack-bphdr },
    year = { 2022 },
    month = { dec },
    note = { visited on 2024-01-23 },
}
Wir danken dem Team von Roboflow dafür, dass es den Datensatz zur Risssegmentierung bereitgestellt und damit eine wertvolle Ressource für die Computer-Vision-Community geschaffen hat, insbesondere für Projekte rund um Verkehrssicherheit und die Bewertung von Infrastruktur. Weitere Datensätze findest du in der Ultralytics-Datensammlung.
Häufig gestellte Fragen#
Der Datensatz zur Risssegmentierung umfasst 4.029 annotierte Bilder von Rissen auf Straßen und Wänden. Er dient zum Trainieren und Bewerten von Modellen zur Instanzsegmentierung mit einer einzelnen Klasse
crack. Der Datensatz ist für Anwendungen rund um Verkehrssicherheit und Infrastruktur gedacht, etwa für Strukturinspektionen und die Bewertung von Fahrbahnen, und kann über die Konfigurationsdateicrack-seg.yamldirekt mit Ultralytics YOLO26 verwendet werden.Der Datensatz umfasst insgesamt 4.029 Bilder – 3.717 für das Training, 200 für die Validierung und 112 für das Testen. Alle Bilder sind für eine einzelne Klasse
crackannotiert. Bei der ersten Verwendung wird das vollständige Archiv automatisch als.zipmit einer Größe von etwa 91,6 MB heruntergeladen.Lade ein vortrainiertes Segmentierungsmodell (z. B.
yolo26n-seg.pt) und trainiere es mit der Konfigurationcrack-seg.yamlmithilfe der Python- oder CLI-Codebeispiele im obigen Abschnitt Verwendung. Eine vollständige Liste der verfügbaren Argumente findest du in der Trainingsanleitung.Die vielfältigen Rissbilder von Straßen und Wänden decken zahlreiche reale Szenarien ab und verbessern die Robustheit von Modellen, die für die Risserkennung trainiert wurden. Eine präzise Segmentierung unterstützt Systeme für Straßensicherheit und Infrastrukturbeurteilung, die potenzielle Gefahren zuverlässig erkennen müssen.
Die Datei
crack-seg.yaml, in der die Pfade des Datensatzes und die einzelne Klassecrackdefiniert sind, befindet sich im Ultralytics-GitHub-Repository: crack-seg.yaml.


Kommentare2
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.
mzg0108
What was the performance of Yolo 8 on this dataset? What was the mean IOU on test set?
 Glenn JocherUltralytics(bearbeitet)
Hey there!
Thanks for reaching out with your question about performance on the Crack Segmentation dataset. 🚀 We do not publish a mean IOU (Intersection Over Union) for the test set on this dataset.
For an example on how to train a YOLO26 model on the crack segmentation dataset, you might find this snippet useful:
from ultralytics import YOLO

# Load a pretrained model (recommended for training)
model = YOLO('yolo26n-seg.pt')

# Train the model on the crack-seg dataset
results = model.train(data='crack-seg.yaml', epochs=100, imgsz=640)
If you're specifically interested in evaluating the model's performance in terms of mean IOU or any other metrics, you can use the
valmode to validate your model after training (for example withsplit='test'if your dataset YAML defines a test set), which reports mask mAP.Feel free to dive into your own experiments and share your findings. The community and we are always eager to learn about different performance insights across various datasets! 🌟
Happy detecting, and let us know if you have any more questions or if there's anything else we can help you with!
1