Conjunto de datos COCO-Pose#
El conjunto de datos COCO-Pose adapta COCO (objetos comunes en contexto) para la estimación de poses: 58.945 imágenes de COCO Keypoints 2017, anotadas con 156.165 personas mediante un esquema de 17 puntos clave. Es el conjunto estándar para entrenar y evaluar modelos de puntos clave como Ultralytics YOLO26, y el subconjunto de 8 imágenes COCO8-Pose reproduce su formato para realizar comprobaciones básicas rápidamente.
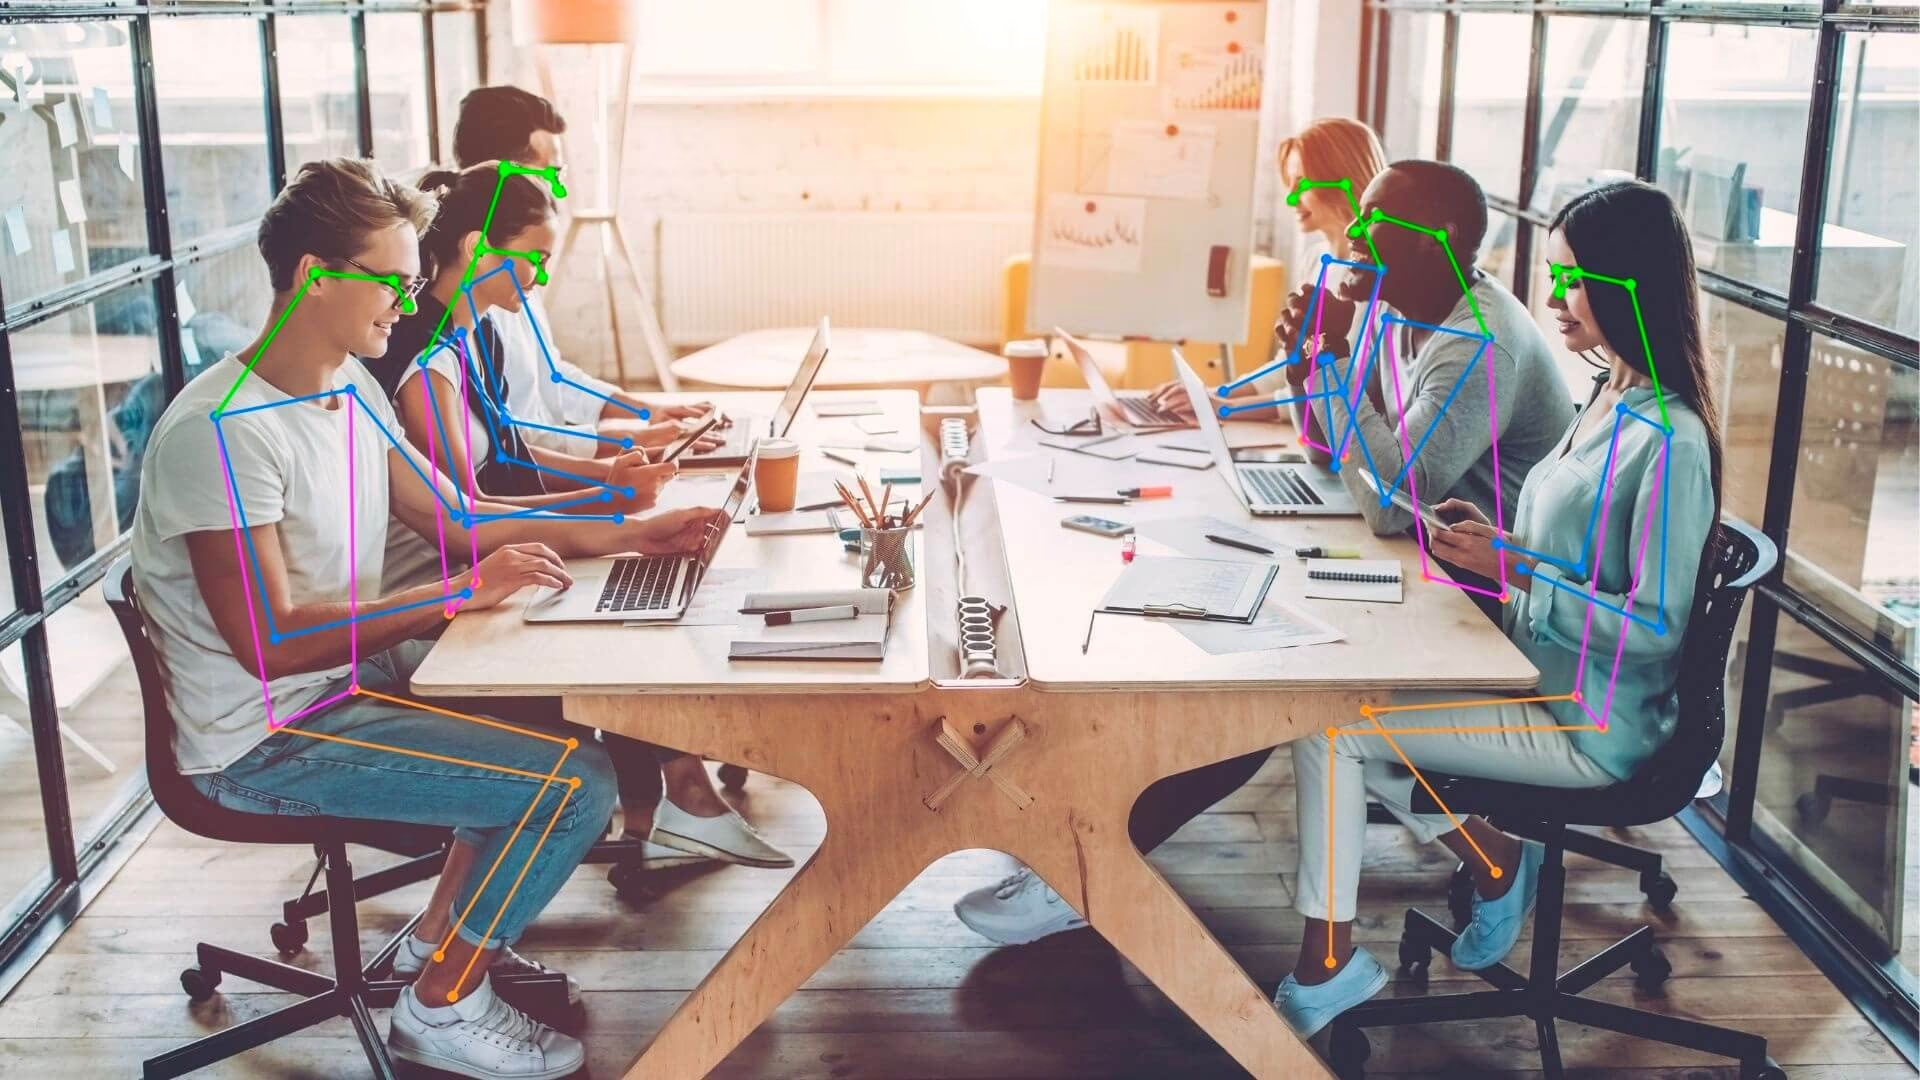
Modelos preentrenados de COCO-Pose#
| Modelo | tamaño (píxeles) | mAPpose 50-95(e2e) | mAPpose 50(e2e) | Velocidad CPU ONNX (ms) | Velocidad T4 TensorRT10 (ms) | parámetros (M) | FLOPs (B) |
|---|---|---|---|---|---|---|---|
| YOLO26n-pose | 640 | 57.2 | 83.3 | 40.3 ± 0.5 | 1.8 ± 0.0 | 2.9 | 7.6 |
| YOLO26s-pose | 640 | 63.0 | 86.6 | 85.3 ± 0.9 | 2.7 ± 0.0 | 10.4 | 24.1 |
| YOLO26m-pose | 640 | 68.8 | 89.6 | 218.0 ± 1.5 | 5.0 ± 0.1 | 21.5 | 73.3 |
| YOLO26l-pose | 640 | 70.4 | 90.5 | 275.4 ± 2.4 | 6.5 ± 0.1 | 25.9 | 91.7 |
| YOLO26x-pose | 640 | 71.6 | 91.6 | 565.4 ± 3.0 | 12.2 ± 0.2 | 57.6 | 202.3 |
Características principales#
- COCO-Pose se basa en el desafío COCO Keypoints 2017, que etiqueta 1.710.498 puntos clave individuales en 156.165 personas anotadas.
- Cada anotación de persona usa 17 tipos de puntos clave —nariz, ojos, orejas, hombros, codos, muñecas, caderas, rodillas y tobillos— almacenados como tripletas
(x, y, visibility). - Al igual que COCO, proporciona métricas de evaluación estandarizadas, incluida la similitud de puntos clave de objetos (OKS) para tareas de estimación de poses, por lo que resulta adecuado para comparar el rendimiento de los modelos.
- Tamaño de la descarga: ~20.2 GB la primera vez que se usa (
train2017.zip+val2017.zip+ etiquetas). Los 7 GB detest2017.zipno se descargan automáticamente, ya que esas imágenes tienen las anotaciones de referencia ocultas y solo se necesitan para enviar resultados a test-dev2017.
Estructura del conjunto de datos#
Para el entrenamiento y la validación, COCO-Pose solo incluye imágenes de COCO 2017 con personas anotadas con puntos clave, por lo que sus particiones etiquetadas son más pequeñas que el COCO completo. Su YAML define tres subconjuntos:
- Train2017: Este subconjunto contiene 56.599 imágenes del conjunto de datos COCO, anotadas para entrenar modelos de estimación de poses.
- Val2017: Este subconjunto contiene 2.346 imágenes que se usan para validar durante el entrenamiento del modelo.
- Test-dev2017: Un subconjunto de 20.288 imágenes del conjunto test2017 completo, que contiene 40.670 imágenes y cuyas anotaciones de referencia están ocultas. El YAML del conjunto de datos vincula esta partición al servidor de evaluación de puntos clave de COCO test-dev.
El entrenamiento a esta escala es donde Ultralytics Platform resulta más útil: gestiona la capacidad de cálculo para que puedas iniciar y supervisar ejecuciones sin tener que aprovisionar tus propias GPU.
Aplicaciones#
El conjunto de datos COCO-Pose se usa específicamente para entrenar y evaluar modelos de aprendizaje profundo en la detección de puntos clave y la estimación de poses. La gran cantidad de imágenes anotadas y las métricas de evaluación estandarizadas hacen de este conjunto un recurso esencial para investigadores y profesionales de la visión artificial que trabajan con poses humanas.
YAML del conjunto de datos#
Se utiliza un archivo YAML para definir la configuración del conjunto de datos. Contiene información sobre las rutas, las clases y otros datos relevantes. En el caso del conjunto de datos COCO-Pose, el archivo coco-pose.yaml se mantiene en https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/coco-pose.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# COCO 2017 Keypoints dataset https://cocodataset.org by Microsoft
# Documentation: https://docs.ultralytics.com/datasets/pose/coco
# Example usage: yolo train data=coco-pose.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── coco-pose ← downloads here (20.2 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco-pose # dataset root dir
train: train2017.txt # train images (relative to 'path') 56599 images
val: val2017.txt # val images (relative to 'path') 2346 images
test: test-dev2017.txt # 20288 of 40670 images, submit to https://codalab.lisn.upsaclay.fr/competitions/7403

# Keypoints
kpt_shape: [17, 3] # number of keypoints, number of dims (2 for x,y or 3 for x,y,visible)
flip_idx: [0, 2, 1, 4, 3, 6, 5, 8, 7, 10, 9, 12, 11, 14, 13, 16, 15]

# Classes
names:
  0: person

# Keypoint names per class
kpt_names:
  0:
    - nose
    - left_eye
    - right_eye
    - left_ear
    - right_ear
    - left_shoulder
    - right_shoulder
    - left_elbow
    - right_elbow
    - left_wrist
    - right_wrist
    - left_hip
    - right_hip
    - left_knee
    - right_knee
    - left_ankle
    - right_ankle

# Download script/URL (optional)
download: |
  from pathlib import Path

  from ultralytics.utils import ASSETS_URL
  from ultralytics.utils.downloads import download

  # Download labels
  dir = Path(yaml["path"])  # dataset root dir

  urls = [f"{ASSETS_URL}/coco2017labels-pose.zip"]
  download(urls, dir=dir.parent)

  # Download data (test2017.zip excluded: ground truth is withheld, only used for the CodaLab test-dev split)
  urls = [
      "http://images.cocodataset.org/zips/train2017.zip",  # 19G, 118k images
      "http://images.cocodataset.org/zips/val2017.zip",  # 1G, 5k images
  ]
download(urls, dir=dir / "images", threads=3)Uso#
Para entrenar un modelo YOLO26n-pose con el conjunto de datos COCO-Pose durante 100 épocas y con un tamaño de imagen de 640, puedes usar los siguientes fragmentos de código. Para consultar la lista completa de argumentos disponibles, visita la página de entrenamiento del modelo.
from ultralytics import YOLO

# Cargar un modelo
model = YOLO("yolo26n-pose.pt")  # Carga un modelo preentrenado (recomendado para el entrenamiento)

# Entrenar el modelo
results = model.train(data="coco-pose.yaml", epochs=100, imgsz=640)
Imágenes de muestra y anotaciones#
El conjunto de datos COCO-Pose contiene una amplia variedad de imágenes con figuras humanas anotadas mediante puntos clave. Aquí tienes algunos ejemplos de imágenes del conjunto de datos junto con sus anotaciones correspondientes:
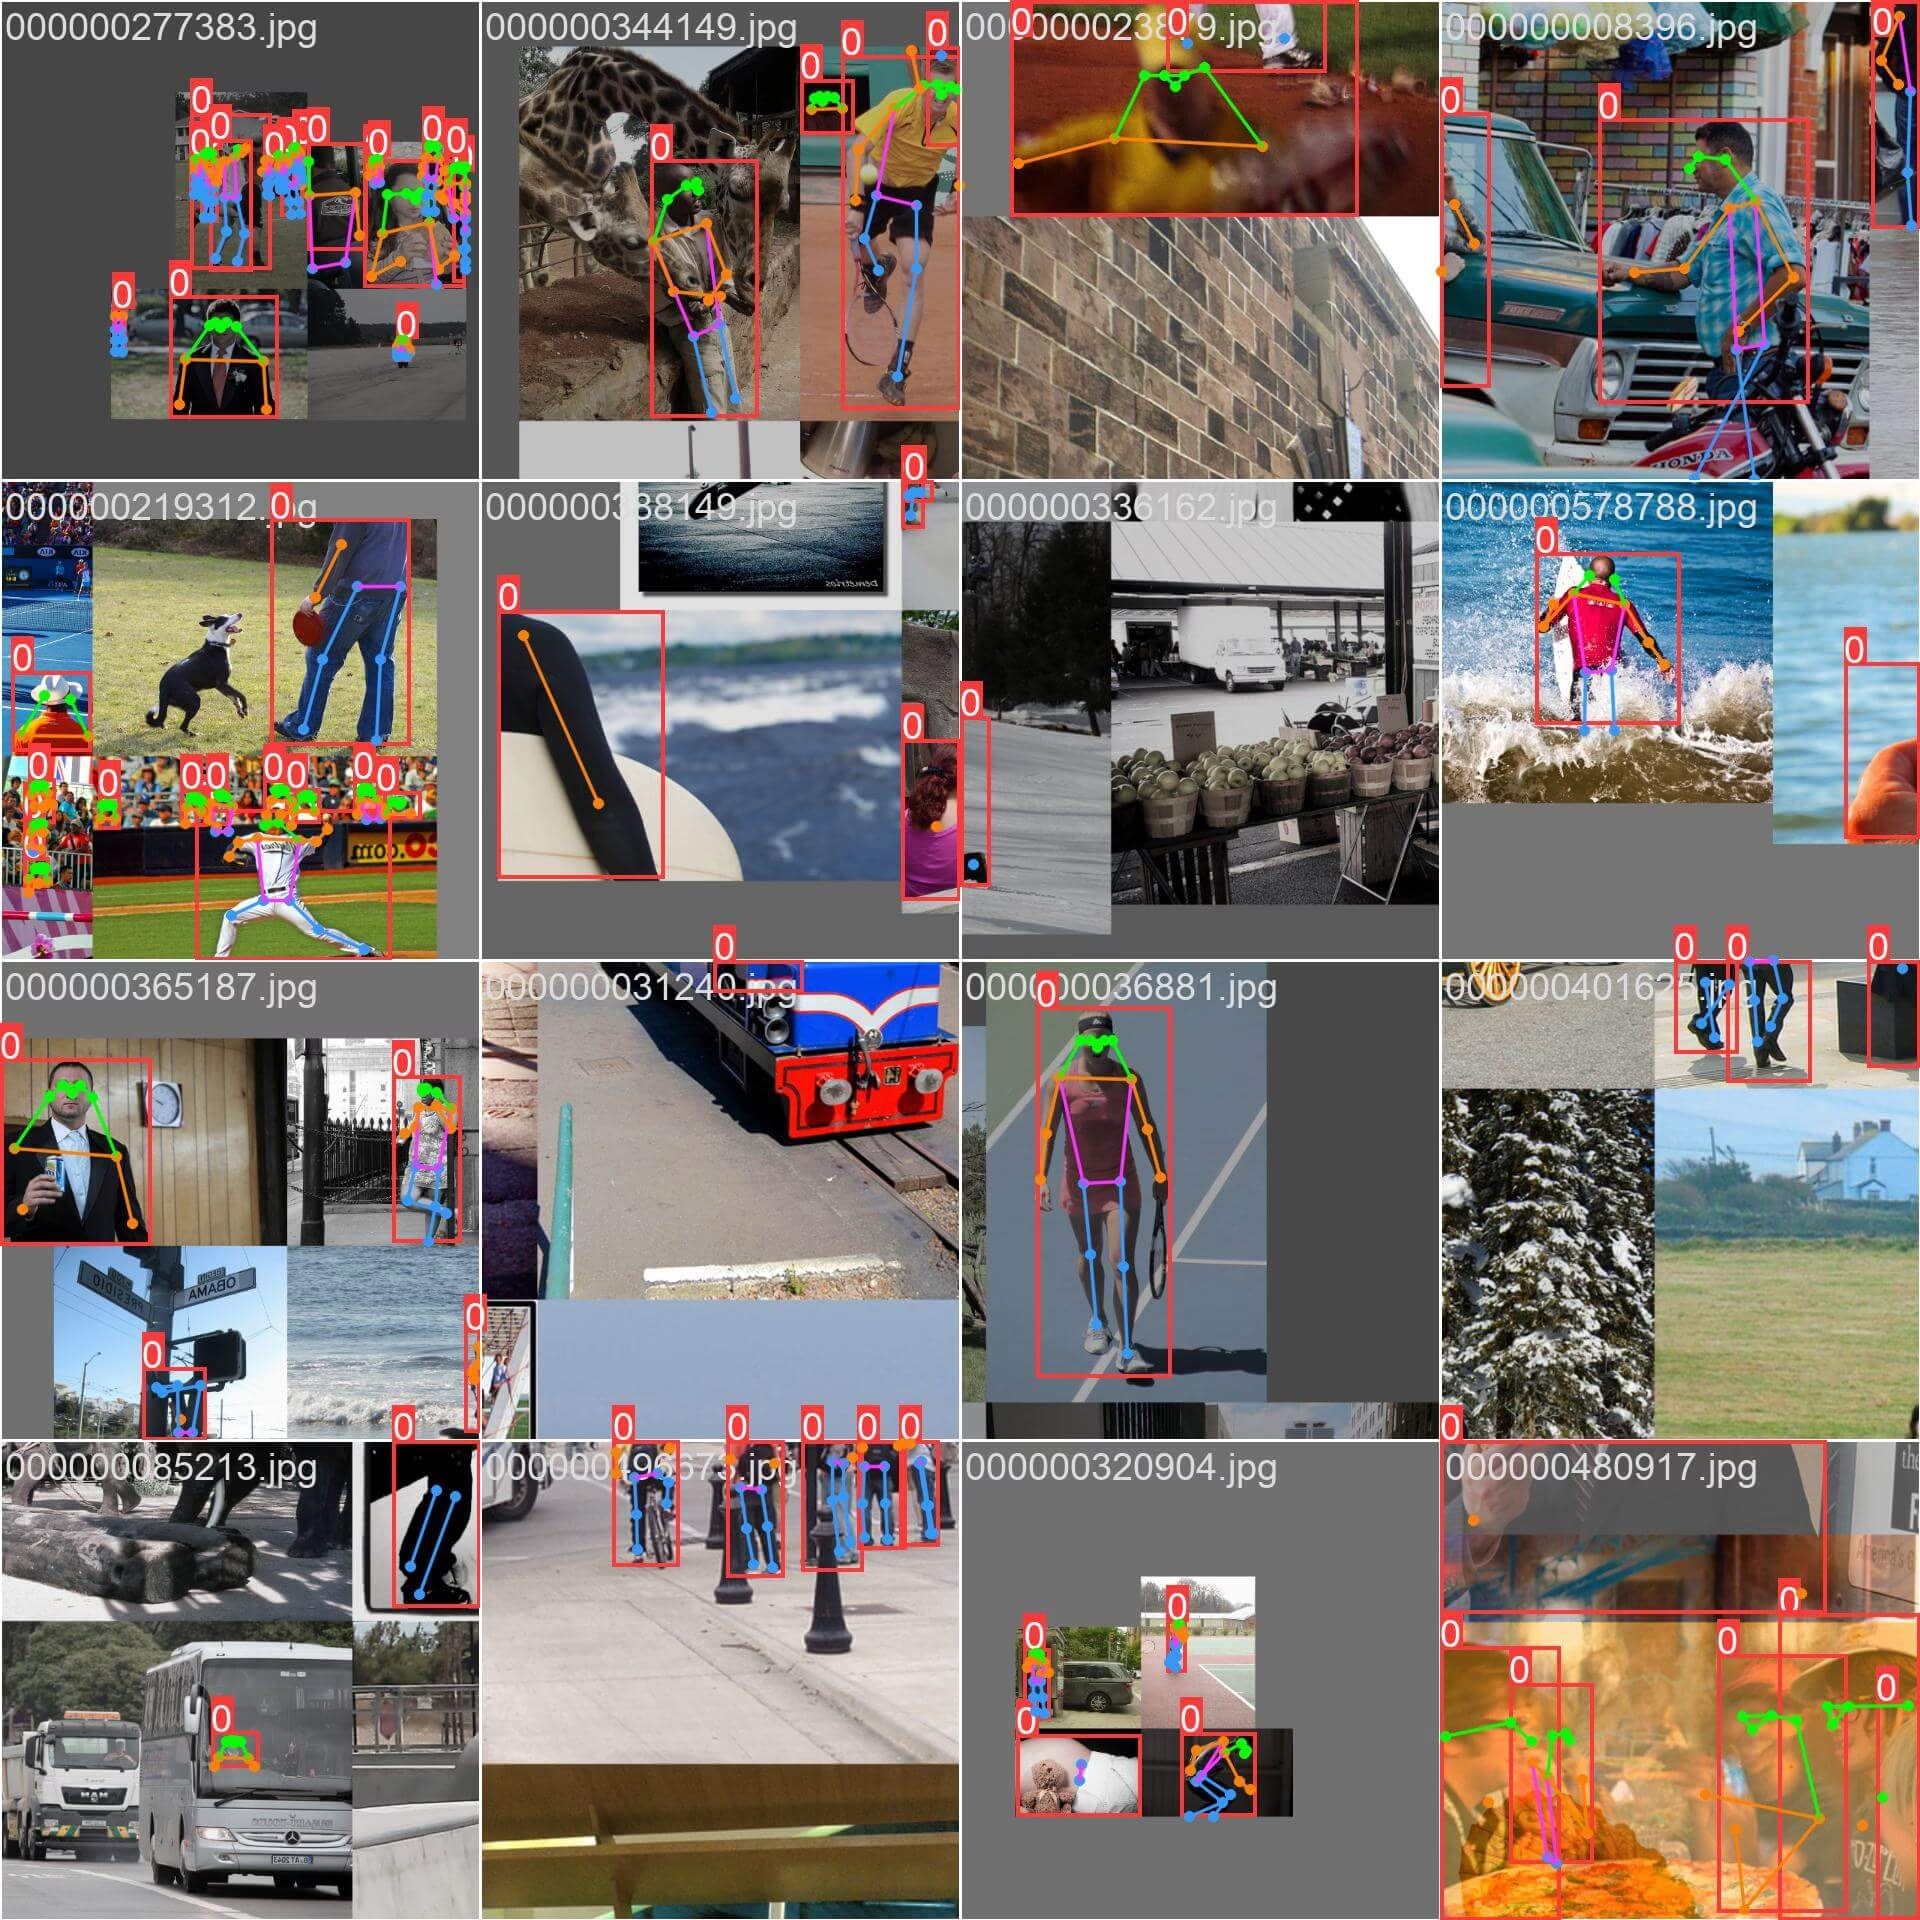
- Imagen en mosaico: Esta imagen muestra un lote de entrenamiento compuesto por imágenes del conjunto de datos dispuestas en mosaico. El mosaico es una técnica que se utiliza durante el entrenamiento para combinar varias imágenes en una sola y aumentar la variedad de objetos y escenas de cada lote de entrenamiento. Esto ayuda a mejorar la capacidad del modelo para generalizar a distintos tamaños de objetos, relaciones de aspecto y contextos.
El ejemplo muestra la variedad y complejidad de las imágenes del conjunto de datos COCO-Pose y las ventajas de usar mosaicos durante el entrenamiento.
Citas y agradecimientos#
Si utilizas el conjunto de datos COCO-Pose en tu investigación o trabajo de desarrollo, cita el siguiente artículo:
@misc{lin2015microsoft,
      title={Microsoft COCO: Common Objects in Context},
      author={Tsung-Yi Lin and Michael Maire and Serge Belongie and Lubomir Bourdev and Ross Girshick and James Hays and Pietro Perona and Deva Ramanan and C. Lawrence Zitnick and Piotr Dollár},
      year={2015},
      eprint={1405.0312},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Queremos reconocer la labor del Consorcio COCO por crear y mantener este valioso recurso para la comunidad de visión artificial. Para obtener más información sobre el conjunto de datos COCO-Pose y sus creadores, visita el sitio web del conjunto de datos COCO.
Preguntas frecuentes#
COCO-Pose proporciona las imágenes y anotaciones de COCO Keypoints 2017 convertidas al formato de puntos clave de YOLO, con un esquema de 17 puntos clave en 58.945 imágenes. Indica a cualquier modelo de pose de Ultralytics YOLO que lo utilice con
data=coco-pose.yaml, y en la página de Entrenamiento encontrarás documentación sobre todos los argumentos que puedes ajustar.Carga
yolo26n-pose.pty llama amodel.train(data="coco-pose.yaml", epochs=100, imgsz=640); consulta el ejemplo de entrenamiento anterior para ver los fragmentos completos de Python y CLI, y la página de entrenamiento para consultar una lista completa de argumentos.El conjunto de datos COCO-Pose ofrece varias métricas de evaluación estandarizadas para tareas de estimación de pose, similares a las del conjunto de datos COCO original. Entre las métricas principales se encuentra la similitud de puntos clave de objetos (OKS), que evalúa la precisión de los puntos clave predichos frente a las anotaciones de referencia. Estas métricas permiten comparar exhaustivamente el rendimiento de distintos modelos. Por ejemplo, los modelos preentrenados con COCO-Pose, como YOLO26n-pose, YOLO26s-pose y otros, tienen métricas de rendimiento específicas indicadas en la documentación, como mAPpose50-95 y mAPpose50.
COCO-Pose incluye dos particiones etiquetadas: 56.599 imágenes train2017 y 2.346 imágenes val2017. Una tercera partición, test-dev2017 (20.288 de las 40.670 imágenes test2017 en total), mantiene privadas sus anotaciones de referencia; el YAML del conjunto de datos la vincula al servidor de evaluación de puntos clave COCO test-dev. Consulta la sección Estructura del conjunto de datos o el archivo
coco-pose.yamlen GitHub para ver las rutas exactas de las particiones.COCO-Pose utiliza 17 tipos de puntos clave humanos y hereda las métricas estandarizadas de COCO, incluida la similitud de puntos clave de objetos (OKS), para comparar modelos. Esta combinación resulta adecuada para aplicaciones de estimación de pose humana, como el análisis deportivo, la atención sanitaria y la interacción persona-ordenador. Encontrarás los pesos preentrenados de YOLO26-pose en Modelos preentrenados con COCO-Pose.
Para obtener más información sobre los modelos de puntos clave, consulta la documentación de la tarea de estimación de pose.