Conjunto de datos de segmentación de grietas
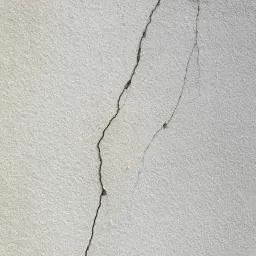
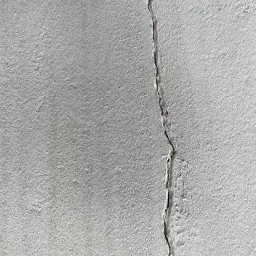
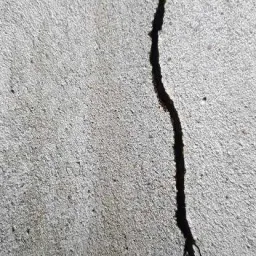
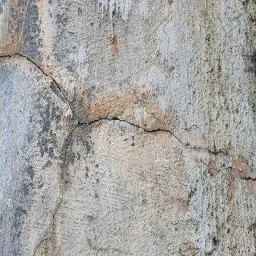

El conjunto de datos de segmentación de grietas de Ultralytics contiene 4.029 imágenes anotadas de grietas en carreteras y paredes para entrenar modelos de segmentación de instancias con una única clase crack. Capturadas en diversos escenarios de pavimento y estructuras, estas imágenes se integran directamente con Ultralytics YOLO para casos de uso que abarcan desde la seguridad del transporte y la percepción de vehículos autónomos hasta el mantenimiento de infraestructuras y la inspección estructural mediante visión artificial.
Ver: Cómo entrenar un modelo de segmentación de grietas con Ultralytics YOLO26 | IA en la construcción 🎉
Estructura del conjunto de datos#
El conjunto de datos de segmentación de grietas divide sus 4.029 imágenes de la siguiente manera:
- Conjunto de entrenamiento: 3.717 imágenes utilizadas para entrenar el modelo de aprendizaje profundo.
- Conjunto de validación: 200 imágenes utilizadas durante el entrenamiento para ajustar los hiperparámetros y evitar el sobreajuste.
- Conjunto de prueba: 112 imágenes reservadas para evaluar el modelo después del entrenamiento.
- Clases: una única clase
crackque abarca todas las grietas anotadas en carreteras y paredes. - Tamaño de la descarga: ~91,6 MB.
Aplicaciones#
La segmentación de grietas facilita el mantenimiento de infraestructuras al identificar y evaluar daños estructurales en edificios, puentes y carreteras. También mejora la seguridad vial, ya que permite que los sistemas automatizados detecten grietas en el pavimento para repararlas a tiempo.
En entornos industriales, la detección de grietas con modelos como Ultralytics YOLO26 ayuda a verificar la integridad de edificios en construcción, evita costosas interrupciones en la fabricación y hace más seguras las inspecciones de carreteras. La clasificación automática de grietas permite a los equipos de mantenimiento dar prioridad a las reparaciones más urgentes.
También puedes explorar y gestionar el conjunto completo de datos Crack Segmentation en Ultralytics Platform.
YAML del conjunto de datos#
Un archivo YAML define la configuración del conjunto de datos. Incluye información sobre las rutas, las clases y otros datos relevantes del conjunto. Para el conjunto de datos Crack Segmentation, el archivo crack-seg.yaml se mantiene en https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/crack-seg.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Crack-seg dataset by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/segment/crack-seg
# Example usage: yolo train data=crack-seg.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── crack-seg ← downloads here (91.6 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: crack-seg # dataset root dir
train: images/train # train images (relative to 'path') 3717 images
val: images/val # val images (relative to 'path') 200 images
test: images/test # test images (relative to 'path') 112 images

# Classes
names:
  0: crack

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/crack-seg.zipUso#
Para entrenar el modelo Ultralytics YOLO26n-seg con el conjunto de datos Crack Segmentation durante 100 épocas y con un tamaño de imagen de 640, utiliza los siguientes fragmentos de código de Python o CLI.
from ultralytics import YOLO

# Cargar un modelo
# Se recomienda usar un modelo preentrenado como yolo26n-seg.pt para acelerar la convergencia
model = YOLO("yolo26n-seg.pt")

# Entrena el modelo con el conjunto de datos Crack Segmentation
# Asegúrate de que 'crack-seg.yaml' esté accesible o indica la ruta completa
results = model.train(data="crack-seg.yaml", epochs=100, imgsz=640)

# Después del entrenamiento, puedes usar el modelo para hacer predicciones o exportarlo
# results = model.predict(source='path/to/your/images')
Datos de ejemplo y anotaciones#
A continuación se muestra un ejemplo del conjunto de datos Crack Segmentation con las máscaras de segmentación de instancias superpuestas, que delimitan las grietas identificadas en superficies de carreteras y paredes:
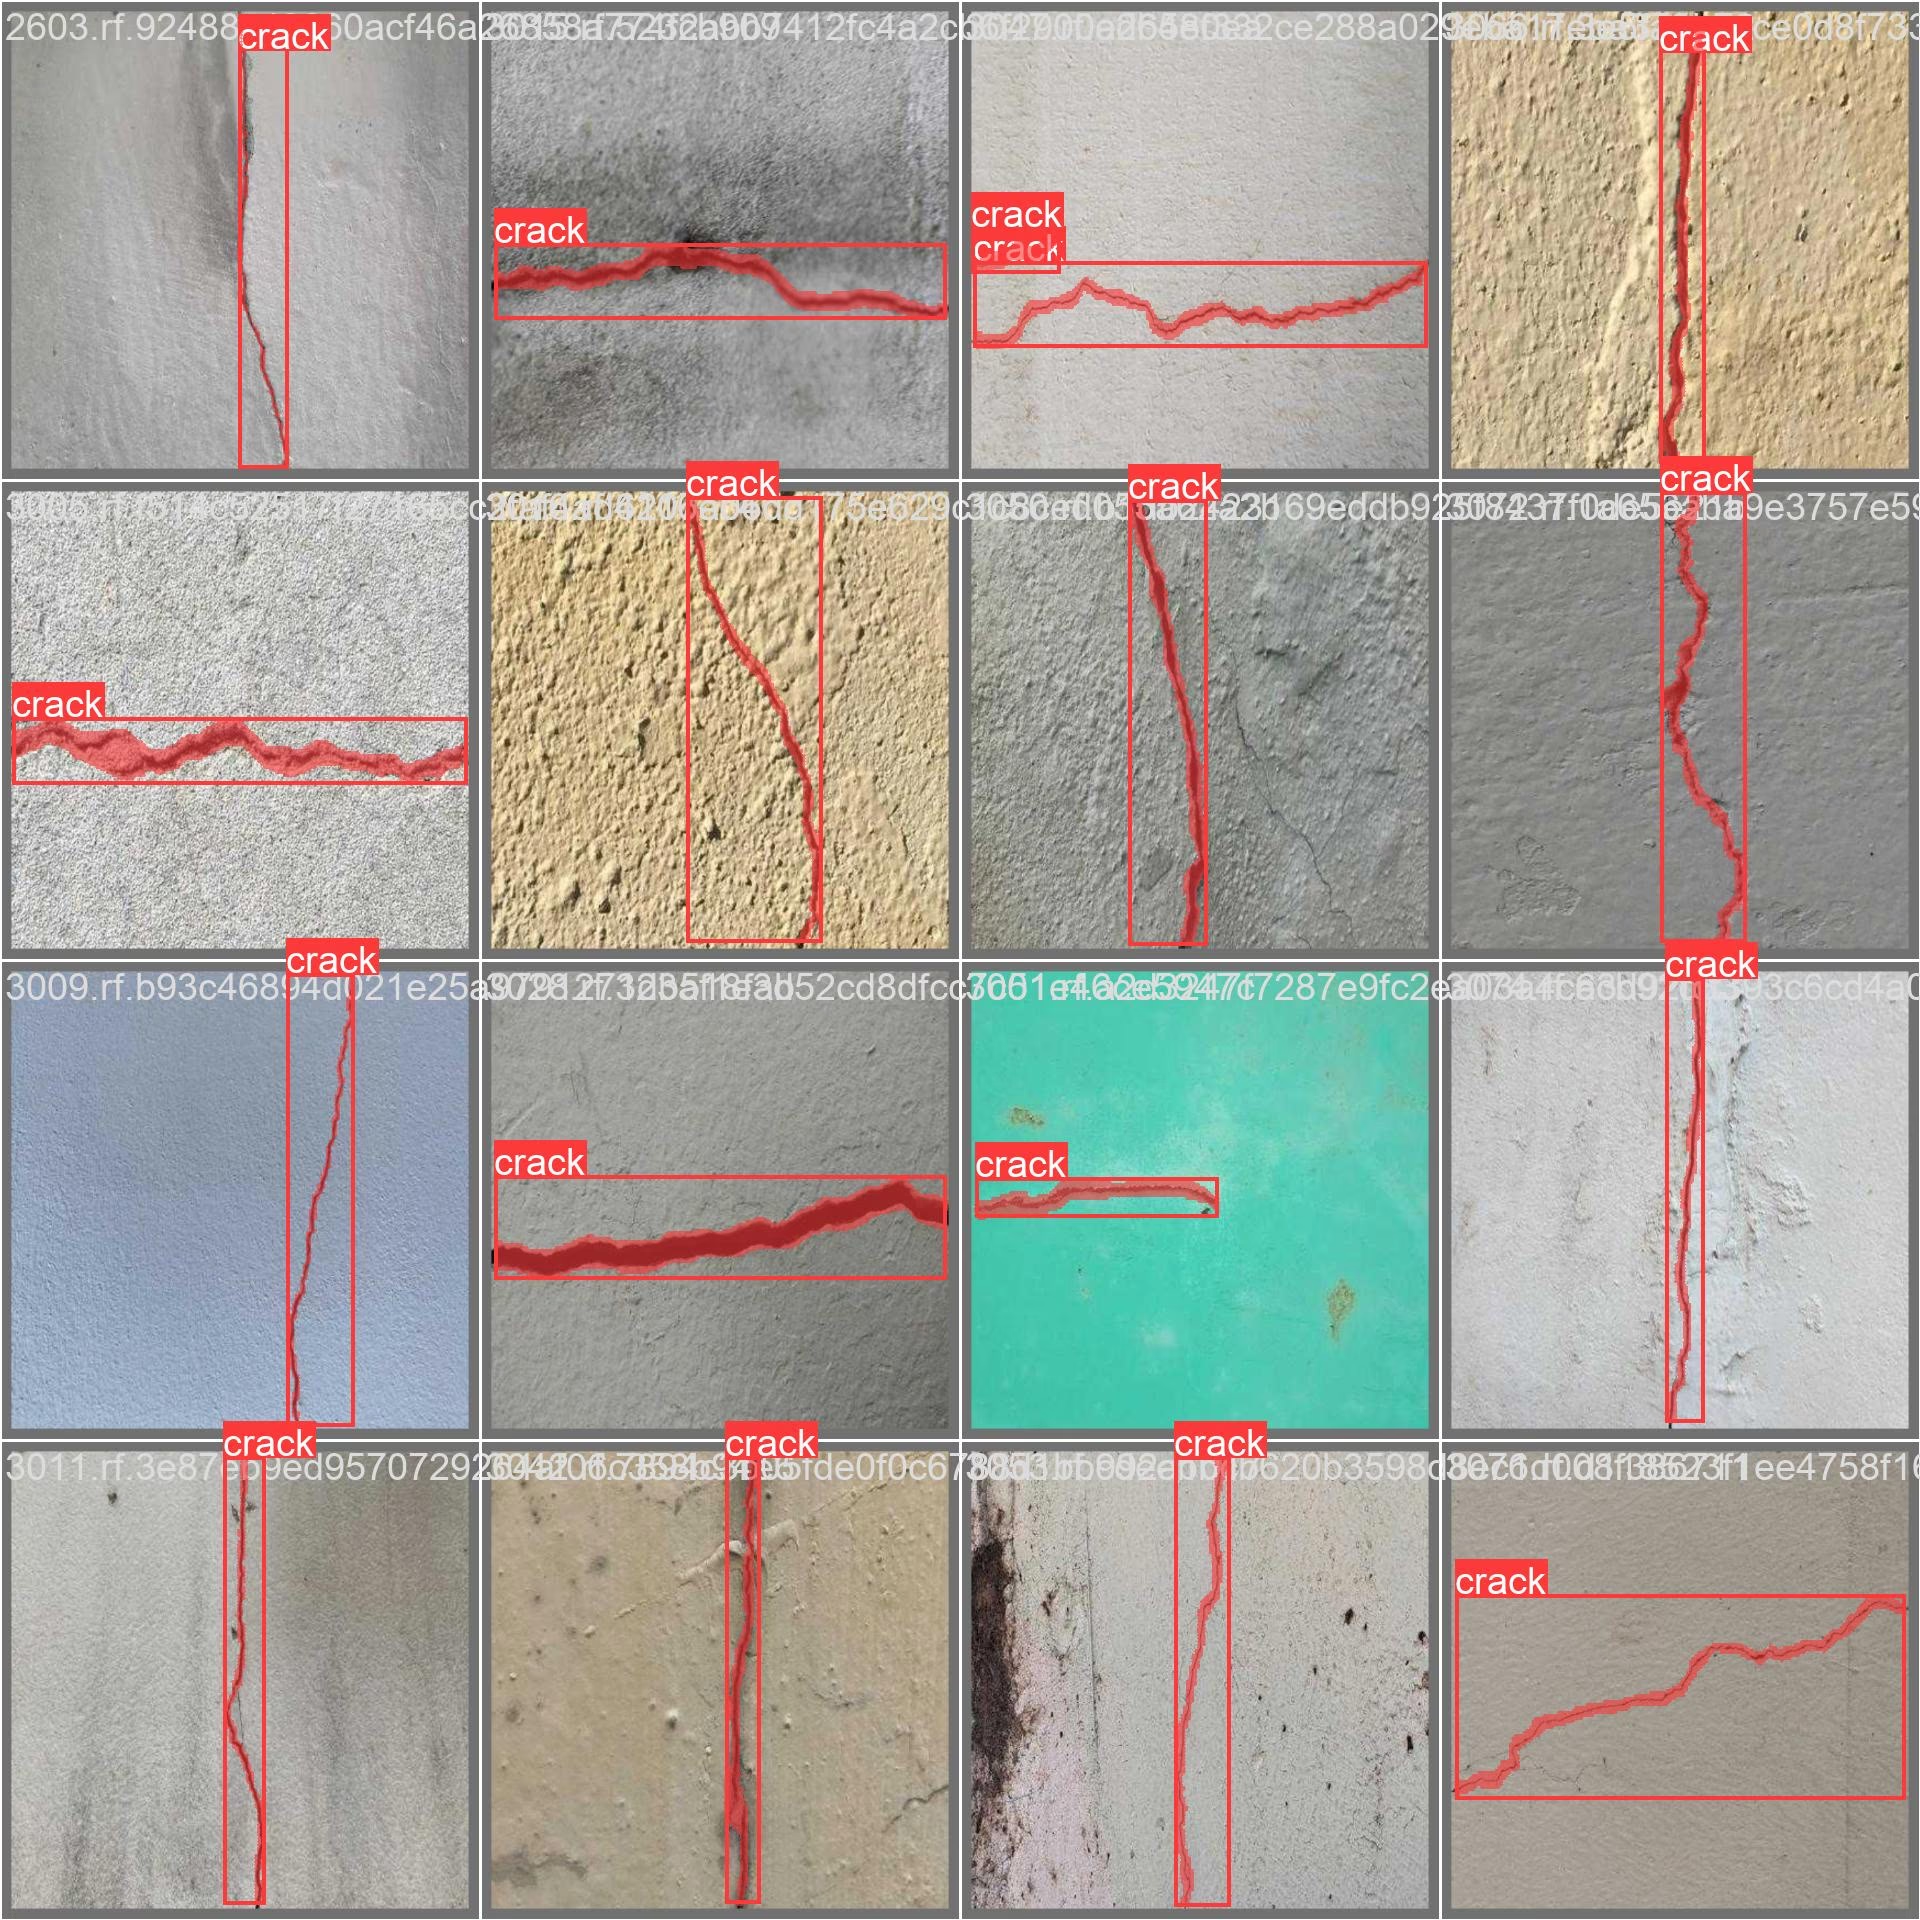
El conjunto de datos abarca distintas ubicaciones, superficies y condiciones de iluminación, por lo que los modelos entrenados con él se exponen a la variedad de escenas del mundo real a las que deben generalizar. La ampliación de datos puede aumentar aún más esa variedad; consulta nuestra guía de segmentación y seguimiento de instancias para conocer flujos de trabajo relacionados.
Citas y agradecimientos#
Si utilizas el conjunto de datos Crack Segmentation en tus trabajos de investigación o desarrollo, cita la fuente adecuadamente:
@misc{ crack-bphdr_dataset,
    title = { crack Dataset },
    type = { Open Source Dataset },
    author = { University },
    url = { https://universe.roboflow.com/university-bswxt/crack-bphdr },
    year = { 2022 },
    month = { dec },
    note = { visited on 2024-01-23 },
}
Agradecemos al equipo de Roboflow que haya puesto a disposición el conjunto de datos Crack Segmentation y haya proporcionado un recurso valioso para la comunidad de visión artificial, en particular para proyectos relacionados con la seguridad vial y la evaluación de infraestructuras. Para consultar más conjuntos de datos, visita la colección de conjuntos de datos de Ultralytics.
Preguntas frecuentes#
El conjunto de datos Crack Segmentation es una colección de 4.029 imágenes anotadas de grietas en carreteras y paredes para entrenar y evaluar modelos de segmentación de instancias con una única clase
crack. Está diseñado para aplicaciones de seguridad del transporte e infraestructuras, como la inspección estructural y la evaluación de pavimentos, y se utiliza directamente con YOLO26 de Ultralytics mediante el archivo de configuracióncrack-seg.yaml.El conjunto de datos contiene 4.029 imágenes: 3.717 para entrenamiento, 200 para validación y 112 para pruebas; todas están anotadas para una única clase
crack. El archivo completo se descarga automáticamente en formato.zipde ~91.6 MB la primera vez que se utiliza.Carga un modelo de segmentación preentrenado (por ejemplo,
yolo26n-seg.pt) y entrénalo con la configuracióncrack-seg.yamlmediante los fragmentos de código de Python o CLI de la sección Uso anterior. Consulta la guía de entrenamiento para ver la lista completa de argumentos disponibles.La diversidad de imágenes de grietas en carreteras y paredes abarca muchos escenarios reales y mejora la robustez de los modelos entrenados para detectarlas. Una segmentación precisa contribuye a la seguridad vial y a los sistemas de evaluación de infraestructuras que deben identificar posibles peligros de forma fiable.
El archivo
crack-seg.yaml, que define las rutas del conjunto de datos y la única clasecrack, está en el repositorio de GitHub de Ultralytics: crack-seg.yaml.


Comentarios2
Haz una pregunta, comparte tus resultados o ayuda a otra persona.
mzg0108
What was the performance of Yolo 8 on this dataset? What was the mean IOU on test set?
 Glenn JocherUltralytics(editado)
Hey there!
Thanks for reaching out with your question about performance on the Crack Segmentation dataset. 🚀 We do not publish a mean IOU (Intersection Over Union) for the test set on this dataset.
For an example on how to train a YOLO26 model on the crack segmentation dataset, you might find this snippet useful:
from ultralytics import YOLO

# Load a pretrained model (recommended for training)
model = YOLO('yolo26n-seg.pt')

# Train the model on the crack-seg dataset
results = model.train(data='crack-seg.yaml', epochs=100, imgsz=640)
If you're specifically interested in evaluating the model's performance in terms of mean IOU or any other metrics, you can use the
valmode to validate your model after training (for example withsplit='test'if your dataset YAML defines a test set), which reports mask mAP.Feel free to dive into your own experiments and share your findings. The community and we are always eager to learn about different performance insights across various datasets! 🌟
Happy detecting, and let us know if you have any more questions or if there's anything else we can help you with!
1