Destilación de conocimiento#
Inicio rápido#
Entrena un modelo estudiante más pequeño con la guía de un modelo profesor más grande añadiendo el argumento distill_model:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(data="coco8.yaml", epochs=100, distill_model="yolo26s.pt")
¿Qué es la destilación de conocimiento?#
La destilación de conocimiento transfiere conocimiento de un modelo profesor grande y preciso a un modelo estudiante más pequeño. El estudiante aprende a imitar las representaciones internas de características del profesor y, a menudo, consigue más precisión que si se entrenara desde cero.
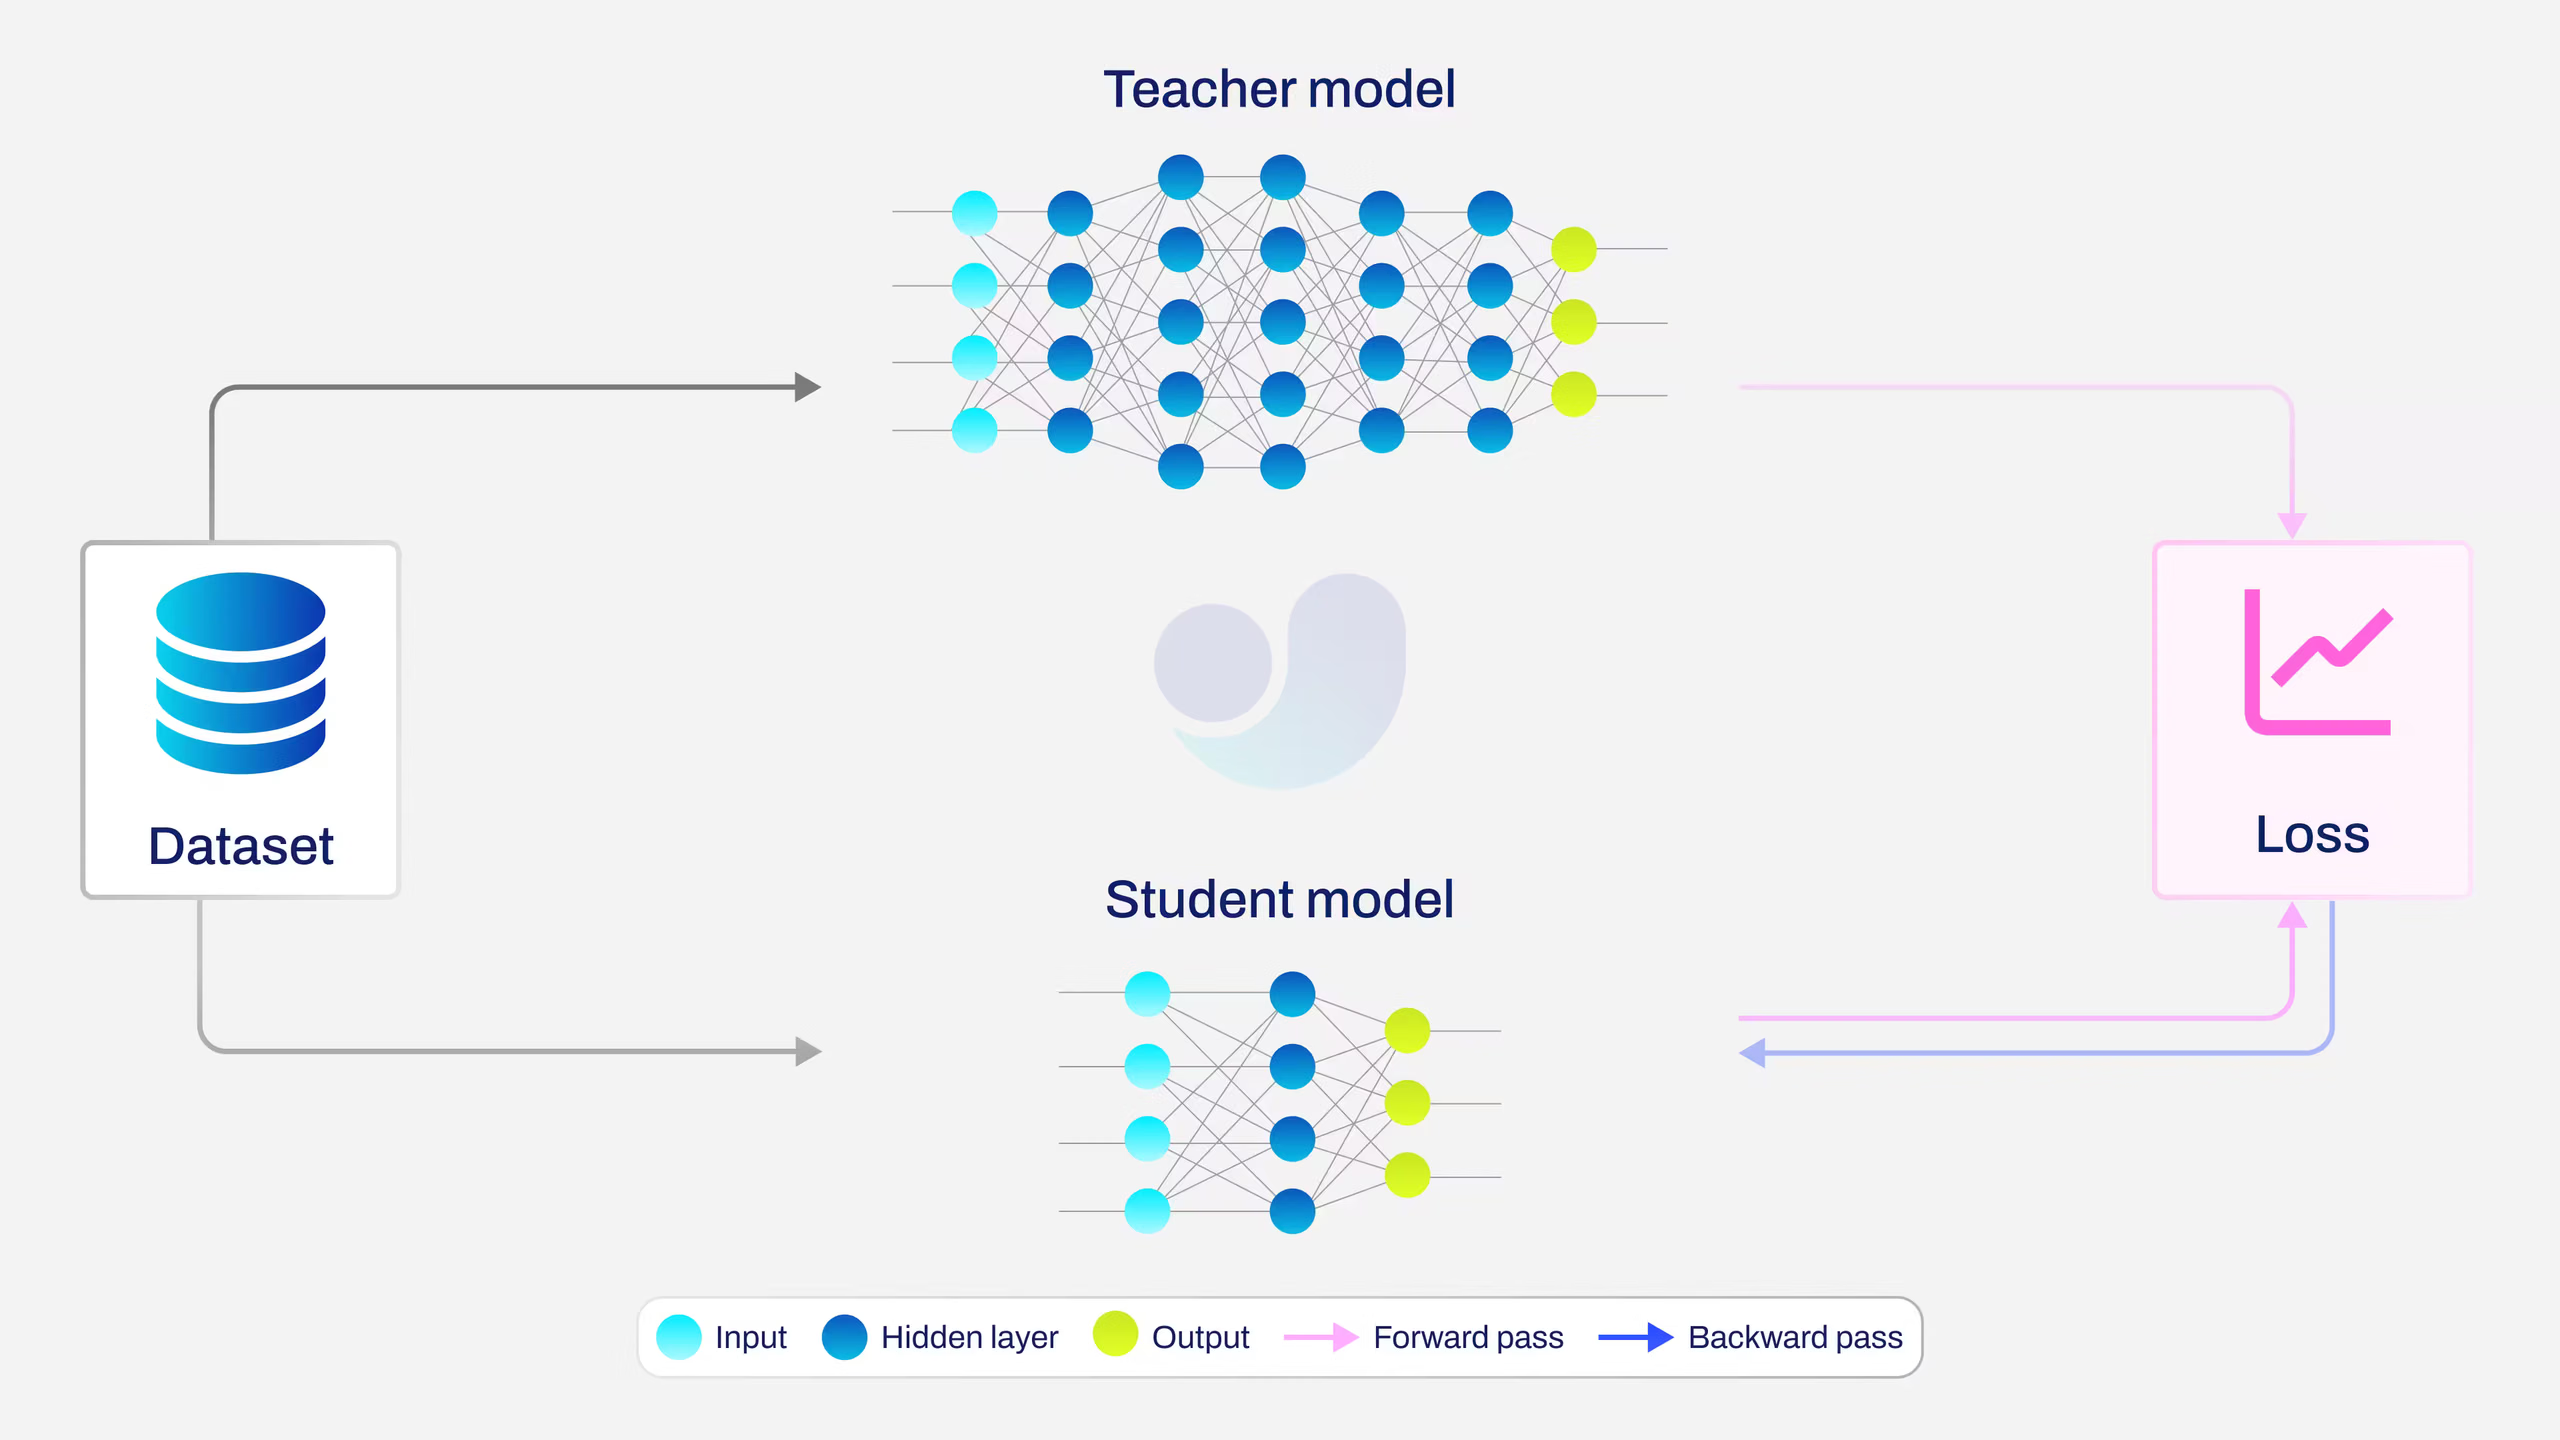
Usa la destilación cuando:
- Necesites un modelo más pequeño y rápido para desplegarlo
- Tengas un modelo profesor de gran precisión entrenado con los mismos datos
- Quieras obtener más precisión de la que ofrece el entrenamiento estándar
La destilación de conocimiento está implementada para las tareas detect, segment, pose y obb. Por ahora, solo se ha verificado experimentalmente que detect mejora la precisión.
Rendimiento#
La destilación de conocimiento mejora el mAP del estudiante en toda la familia YOLO26 en COCO, sin añadir coste de inferencia. La tabla siguiente compara los modelos YOLO26 estándar (referencia) con los mismos modelos entrenados mediante destilación a partir de su profesor recomendado.
| Modelo | tamaño (píxeles) | mAPval 50-95 referencia | mAPval 50-95 destilado | mAPval 50-95 (e2e) referencia | mAPval 50-95 (e2e) destilado |
|---|---|---|---|---|---|
| YOLO26n-distill | 640 | 40.9 | 41.5 | 40.1 | 40.9 |
| YOLO26s-distill | 640 | 48.6 | 49.2 | 47.8 | 48.6 |
| YOLO26m-distill | 640 | 53.1 | 53.9 | 52.5 | 53.3 |
| YOLO26l-distill | 640 | 55.0 | 56.0 | 54.4 | 55.5 |
| YOLO26x-distill | 640 | 57.5 | 57.9 | 56.9 | 57.4 |
- Los valores de mAPval corresponden a una sola escala y un solo modelo en el conjunto de datos COCO val2017.
Reproduce una fila destilada conyolo val detect model=yolo26n-distill.pt data=coco.yaml device=0; añadenms=Falsepara la columna e2e. - Los valores e2e usan la ruta de inferencia sin NMS (
nms=False); los valores que no son e2e usan el posprocesamiento NMS predeterminado (nms=None). Consulta Detección integral para obtener más información.
Requisitos previos#
Antes de empezar, asegúrate de cumplir los siguientes requisitos:
- Modelo profesor entrenado: un punto de control
.ptde la misma familia YOLO que el estudiante. - Tarea coincidente: usa un profesor para la misma tarea que el estudiante y entrénalo con datos pertinentes.
- Recursos de GPU: memoria suficiente para alojar ambos modelos; el profesor solo ejecuta la pasada hacia delante, sin gradientes ni estado del optimizador.
Pares de modelos recomendados#
| Estudiante | Profesor recomendado |
|---|---|
yolo26n.pt | yolo26s.pt |
yolo26s.pt | yolo26m.pt |
yolo26m.pt | yolo26x.pt |
yolo26l.pt | yolo26x.pt |
La destilación entre familias (por ejemplo, un profesor YOLO11 con un estudiante YOLO26) no es compatible.
Parámetros clave#
| Parámetro | Tipo | Predeterminado | Descripción |
|---|---|---|---|
distill_model | str | None | Ruta al archivo del modelo profesor (por ejemplo, yolo26x.pt). Al establecerla, se activa la destilación de conocimiento. |
dis | float | 6.0 | Peso de la pérdida de destilación. Controla cuánto contribuye la pérdida de destilación a la pérdida total del entrenamiento. |
Cómo funciona#
- El modelo profesor permanece congelado en modo
evaly ejecuta la inferencia en cada lote - El modelo estudiante se entrena con las pérdidas estándar de la tarea y la guía de destilación
- Se extraen características de ambos modelos en las tres capas del cuello que alimentan la cabeza de la familia Detect
- Un proyector de dos convoluciones 1×1 con ReLU adapta cada mapa de características del estudiante a los canales del profesor
- Una pérdida L2 ponderada por puntuación compara las características proyectadas del estudiante con las del profesor y las pondera según la confianza de clasificación del profesor
- La pérdida de destilación se combina con las pérdidas estándar mediante el peso
dis
flowchart TD
    A[Input Image Batch]:::start --> T[Teacher Model<br/>frozen, eval mode]:::extern
    A --> S[Student Model<br/>trainable]:::proc

    T --> |Detect head inputs| TF[Teacher Features]:::extern
    S --> |Detect head inputs| SF[Student Features]:::proc

    SF --> P[1×1 Conv Projector<br/>with ReLU]:::decide
    P --> AF[Aligned Student Features]:::proc

    TF --> SW[Score-weighted L2 Loss]:::proc
    AF --> SW

    S --> D[Detection Head]:::proc
    D --> DL[box_loss + cls_loss + l1_loss]:::proc

    SW --> |× dis| DIS[distillation loss]:::proc
    DL --> TOTAL[Total Loss]:::out
    DIS --> TOTAL

    TOTAL --> BP[Backpropagate<br/>Student + Projector only]:::out

    classDef start fill:#4CAF50,color:#fff
    classDef proc fill:#2196F3,color:#fff
    classDef decide fill:#FF9800,color:#fff
    classDef out fill:#9C27B0,color:#fff
    classDef extern fill:#607D8B,color:#fff
Compatibilidad con tareas#
La implementación de destilación extrae características de las tres capas del cuello que alimentan la cabeza de la familia Detect del modelo. Como las cabezas segment, pose y obb heredan de la misma arquitectura Detect, la destilación también es técnicamente compatible con esas tareas.
La clasificación, la segmentación semántica, la estimación de profundidad y RT-DETR no usan una cabeza compatible de la familia Detect y no son compatibles.
Solo detect se ha evaluado y verificado mediante pruebas comparativas experimentales. Puedes ejecutar la destilación para segment, pose u obb, pero todavía no se han validado las mejoras de precisión para esas tareas.
from ultralytics import YOLO

# Segment
model = YOLO("yolo26n-seg.pt")
model.train(data="coco8-seg.yaml", epochs=100, distill_model="yolo26s-seg.pt")

# Pose
model = YOLO("yolo26n-pose.pt")
model.train(data="coco8-pose.yaml", epochs=100, distill_model="yolo26s-pose.pt")

# OBB
model = YOLO("yolo26n-obb.pt")
model.train(data="dota8.yaml", epochs=100, distill_model="yolo26s-obb.pt")Entrenamiento#
Entrenamiento básico#
El entrenamiento con destilación es idéntico al entrenamiento estándar. Proporciona la ruta distill_model para activarlo:
from ultralytics import YOLO

# Cargar un modelo estudiante
student = YOLO("yolo26m.pt")

# Entrenar con destilación de conocimiento a partir de un modelo profesor más grande
results = student.train(data="coco8.yaml", epochs=100, distill_model="yolo26x.pt")
Ajustar el peso de la pérdida de destilación#
El parámetro dis (valor predeterminado: 6.0) controla la contribución de la pérdida de destilación:
from ultralytics import YOLO

student = YOLO("yolo26n.pt")
results = student.train(data="coco8.yaml", epochs=100, distill_model="yolo26s.pt", dis=10.0)
Reanudar el entrenamiento con destilación#
El entrenamiento con destilación permite reanudarse desde puntos de control. El modelo profesor se reconstruye automáticamente a partir de la ruta distill_model registrada en el punto de control:
from ultralytics import YOLO

student = YOLO("runs/detect/train/weights/last.pt")
results = student.train(resume=True)
Resultados del entrenamiento#
Cuando la destilación está activada, aparece una columna adicional dis_loss en los registros de entrenamiento:
      Epoch    GPU_mem   box_loss   cls_loss    l1_loss   dis_loss  Instances       Size
      1/80      46.2G      1.566      5.404    0.003249      6.658        231        640
El modelo exportado contiene solo los pesos del estudiante: el tamaño del archivo y la velocidad de inferencia son iguales a los de un modelo estudiante entrenado normalmente.
Preguntas frecuentes#
- Comprueba que el profesor y el estudiante pertenecen a la misma generación de YOLO
- Confirma que la ruta
distill_modeles correcta y que el archivo se carga - Prueba a aumentar
dissi el valor de la pérdida es muy pequeño - Asegúrate de que el modelo profesor esté entrenado con el mismo conjunto de datos
Añade el parámetro
distill_model: todo lo demás funciona exactamente igual. Durante el entrenamiento se calcula una pérdida de destilación adicional, pero el modelo guardado es un modelo YOLO estándar sin sobrecarga.Sí. El profesor añade una pasada hacia delante por cada lote, así que la sobrecarga de tiempo y memoria depende del par profesor/estudiante. El profesor se ejecuta en modo
eval, sin gradientes ni estado del optimizador.La destilación de conocimiento funciona con las tareas detect, segment, pose y obb, porque destila características de las tres capas del cuello que alimentan la cabeza de la familia Detect. Classify, semantic, depth y RT-DETR no son compatibles.
Solo se ha verificado experimentalmente que detect mejora la precisión. Segment, pose y obb son técnicamente compatibles, pero aún no se han evaluado.
El modelo profesor y el modelo alumno deben pertenecer a la misma familia YOLO (p. ej., YOLOv8, YOLO11 o YOLO26). No se admite la destilación entre familias (p. ej., un modelo profesor YOLO11 con un modelo alumno YOLO26).