Cómo probar modelos de visión artificial#
Introducción#
Las pruebas de modelos comprueban cómo funciona un modelo entrenado con datos reales que no había visto antes —objetos en movimiento, con poca iluminación o parcialmente ocultos—, en lugar de con un conjunto de referencia seleccionado. Mientras que la evaluación del modelo mide métricas en un conjunto de datos etiquetado, las pruebas verifican que el comportamiento aprendido por el modelo se ajuste a los objetivos de tu aplicación antes de implementarlo. Esta guía explica cómo preparar datos de prueba, probar modelos Ultralytics YOLO26 y detectar el sobreajuste, el infraajuste y las fugas de datos.
Ver: Cómo probar modelos de aprendizaje automático | Evita la fuga de datos en visión artificial 🚀
Pruebas de modelos frente a evaluación de modelos#
Las pruebas y la evaluación de modelos son dos pasos distintos en un proyecto de visión artificial. La evaluación mide el rendimiento con métricas en un conjunto de datos etiquetado; las pruebas comprueban si el comportamiento aprendido por el modelo se mantiene en condiciones similares a las de implementación.
Imagina que has entrenado un modelo de visión artificial para reconocer gatos y perros, y quieres implementarlo en una tienda de mascotas para vigilar a los animales. Durante la fase de evaluación del modelo, utilizas un conjunto de datos etiquetado para calcular métricas como la exactitud, la precisión y la exhaustividad. Por ejemplo, el modelo podría tener una exactitud del 98 % al distinguir gatos de perros en un conjunto de datos determinado.
Tras la evaluación, pruebas el modelo con imágenes de una tienda de mascotas para comprobar lo bien que identifica gatos y perros en condiciones más variadas y realistas. Compruebas si puede etiquetar correctamente a gatos y perros cuando están en movimiento, con distintas condiciones de iluminación o parcialmente ocultos por objetos como juguetes o muebles. Las pruebas comprueban que el modelo se comporte como se espera fuera del entorno de evaluación controlado.
Preparación de las pruebas del modelo#
Los conjuntos de datos de visión artificial suelen dividirse en conjuntos de entrenamiento y prueba para simular condiciones reales: los datos de entrenamiento enseñan al modelo, mientras que los datos de prueba verifican su comportamiento con ejemplos que nunca ha visto. La plataforma Ultralytics centraliza la organización y el etiquetado de conjuntos de datos, lo que facilita crear un conjunto de prueba etiquetado.
- Representación realista: Los datos de prueba que el modelo no haya visto deben ser similares a los datos que tratará al implementarlo. Así obtendrás una visión realista de las capacidades del modelo.
- Tamaño suficiente: El conjunto de datos de prueba debe ser lo bastante grande como para ofrecer información fiable sobre el rendimiento del modelo.
Cómo probar un modelo YOLO26#
Probar un modelo YOLO26 entrenado implica dos flujos de trabajo complementarios: validar con una partición de prueba etiquetada para obtener métricas cuantitativas y hacer predicciones sobre imágenes nuevas para inspeccionar cualitativamente su comportamiento.
Validar con una partición de prueba etiquetada#
El modo de validación compara las predicciones del modelo con las etiquetas de referencia e informa de la precisión, la exhaustividad, mAP50 y mAP50-95 en modelos de detección. También guarda recursos visuales, como una matriz de confusión y una curva de precisión-exhaustividad, que te ayudan a detectar áreas concretas en las que el modelo podría no funcionar bien.
from ultralytics import YOLO

# Carga un modelo preentrenado o tu propio punto de control entrenado, por ejemplo, "path/to/best.pt"
model = YOLO("yolo26n.pt")

# Valida; añade split="test" si el YAML de tu conjunto de datos define una partición de prueba
metrics = model.val(data="coco8.yaml")
print(metrics.box.map)  # mAP50-95
De forma predeterminada, la validación se ejecuta en la partición val del conjunto de datos. Para medir el rendimiento en un conjunto de prueba reservado, define una partición test: en el YAML de tu conjunto de datos y pasa split="test".
Hacer predicciones sobre imágenes nuevas#
El modo de predicción ejecuta el modelo con datos nuevos que no ha visto, sin necesidad de etiquetas. No genera métricas de rendimiento, pero si guardas los resultados anotados podrás revisar cómo se comporta el modelo con imágenes reales; por ejemplo, puedes procesar de una vez una carpeta entera de imágenes de prueba.
from ultralytics import YOLO

# Carga un modelo preentrenado o tu propio punto de control entrenado, por ejemplo, "path/to/best.pt"
model = YOLO("yolo26n.pt")

# Ejecutar predicciones en una carpeta de imágenes de prueba y guardar los resultados anotados
results = model.predict(source="path/to/test_images", save=True)Para comprobar si YOLO26 se adapta a tu aplicación antes de invertir en entrenamiento personalizado, ejecuta el modo de predicción con un punto de control preentrenado y tus propias imágenes. Los modelos se preentrenan con conjuntos de datos como COCO, por lo que los resultados te dan una idea rápida del rendimiento que podría tener el modelo en tu contexto específico.
Modo de validación frente a modo de predicción#
| Modo | Finalidad | Requiere etiquetas | Salida |
|---|---|---|---|
| Validación | Cuantificar el rendimiento con respecto a la referencia real | Sí | Precisión, exhaustividad, mAP50, mAP50-95, matriz de confusión, curvas PR |
| Predicción | Inspeccionar el comportamiento del modelo con datos nuevos sin etiquetar | No | Imágenes anotadas y resultados de predicción, sin métricas |
Cómo analizar los resultados de las pruebas#
Una vez que tengas las predicciones y las métricas, analiza dónde y por qué falla el modelo:
- Imágenes mal clasificadas: Identifica y revisa las imágenes que el modelo ha clasificado mal para entender dónde se equivoca.
- Análisis de errores: Realiza un análisis exhaustivo de errores para entender los tipos de errores (por ejemplo, falsos positivos frente a falsos negativos) y sus posibles causas.
- Sesgo e imparcialidad: Comprueba si hay sesgos en las predicciones del modelo. Asegúrate de que el modelo rinde igual de bien en distintos subconjuntos de datos, especialmente si incluyen atributos sensibles como raza, género o edad.
Sobreajuste e infraajuste en aprendizaje automático#
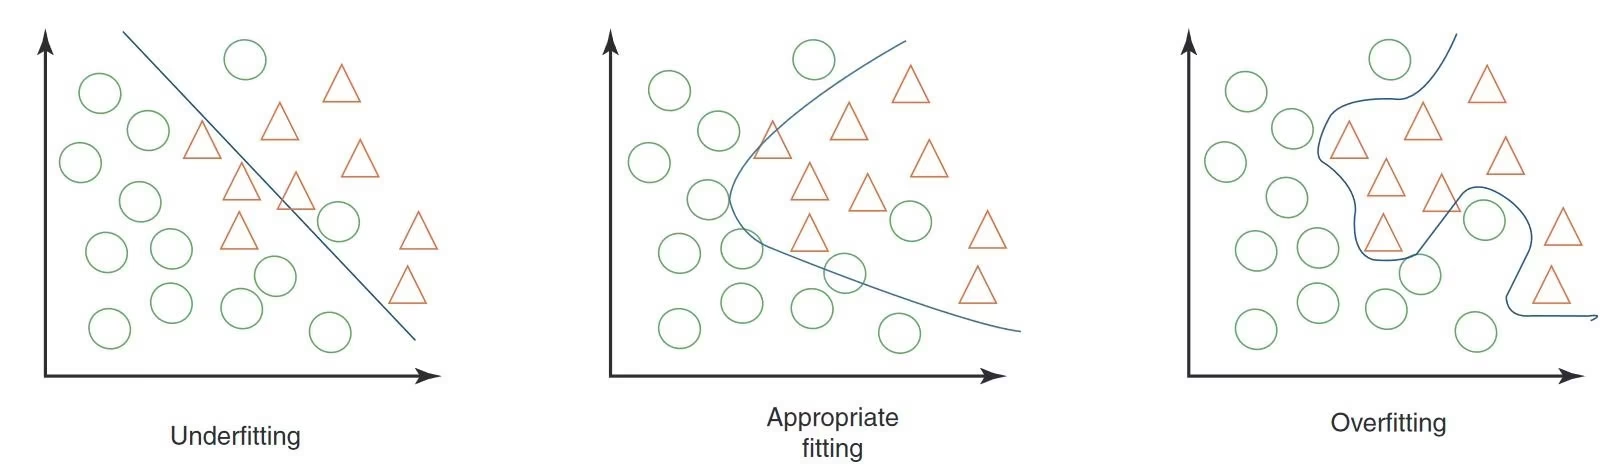
Al probar un modelo de aprendizaje automático, especialmente en visión artificial, es importante prestar atención al sobreajuste y al infraajuste. Estos problemas pueden afectar considerablemente al rendimiento del modelo con datos nuevos.
| Problema | Señales habituales | Cómo abordarlo |
|---|---|---|
| Sobreajuste | Alta exactitud en entrenamiento, pero baja en validación; sensibilidad excesiva a pequeños cambios o detalles irrelevantes en las imágenes | Aplica la regularización, por ejemplo, con dropout; aumenta el tamaño del conjunto de datos de entrenamiento o simplifica la arquitectura del modelo |
| Infraajuste | Baja exactitud incluso en el conjunto de entrenamiento; incapacidad persistente para reconocer características u objetos evidentes | Utiliza un modelo más complejo, proporciona características más relevantes o aumenta las épocas de entrenamiento |
La clave está en encontrar un equilibrio para que el modelo funcione bien tanto con los conjuntos de datos de entrenamiento como con los de validación. Supervisar las métricas con regularidad e inspeccionar visualmente las predicciones durante las pruebas te ayuda a detectar una desviación hacia cualquiera de los dos extremos.
Fuga de datos en visión artificial y cómo evitarla#
La fuga de datos se produce cuando se utiliza accidentalmente información ajena al conjunto de datos de entrenamiento para entrenar el modelo. El modelo puede parecer muy preciso durante el entrenamiento, pero no rendirá bien con datos nuevos que no haya visto si se produce una fuga de datos.
Las fugas pueden ser difíciles de detectar y a menudo proceden de sesgos ocultos en los datos de entrenamiento:
| Tipo de sesgo | En qué consiste |
|---|---|
| Sesgo de cámara | Los distintos ángulos, condiciones de iluminación, sombras y movimientos de cámara introducen patrones no deseados |
| Sesgo de superposición | Los logotipos, las marcas de tiempo u otras superposiciones en las imágenes inducen a error al modelo |
| Sesgo de fuente y objeto | Las fuentes o los objetos específicos que aparecen con frecuencia en determinadas clases distorsionan el aprendizaje del modelo |
| Sesgo espacial | Los desequilibrios entre el primer plano y el fondo, en las distribuciones de cuadros delimitadores y en la ubicación de los objetos afectan al entrenamiento |
| Sesgo de etiquetado y de dominio | Las etiquetas incorrectas o los cambios en los tipos de datos provocan fugas de datos |
Cómo detectar y evitar las fugas de datos#
Para detectar fugas de datos, comprueba si los resultados del modelo son sorprendentemente buenos, observa si una característica es mucho más importante que las demás, verifica que las decisiones del modelo tengan sentido intuitivamente y confirma que los datos se dividieron correctamente antes de cualquier procesamiento.
Para evitarlo, usa un conjunto de datos diverso con imágenes o vídeos de distintas cámaras y entornos, y revisa atentamente los datos para detectar sesgos ocultos, como que todas las muestras positivas se hayan tomado a una hora concreta del día. Evitar las fugas de datos hace que tus modelos de visión artificial sean más fiables en situaciones reales.
Qué hacer después de probar el modelo#
Después de probar el modelo, los siguientes pasos dependerán de los resultados. Si el modelo funciona bien, puedes implementarlo en un entorno real. Si los resultados no son satisfactorios, tendrás que introducir mejoras. Esto puede implicar analizar los errores, recopilar más datos, mejorar la calidad de los datos, ajustar los hiperparámetros y volver a entrenar el modelo.
Conclusión#
Las pruebas rigurosas del modelo —validarlo con una partición de prueba reservada, hacer predicciones con imágenes del mundo real y comprobar si hay sobreajuste y fugas de datos— convierten un modelo bien evaluado en uno fiable. Soluciona los problemas que detecten las pruebas antes de la implementación para que sea mucho más probable que el modelo funcione según lo previsto en producción. Si te surge alguna pregunta, consulta a la comunidad en el repositorio de Ultralytics en GitHub o en el servidor de Discord de Ultralytics.
Preguntas frecuentes#
La evaluación del modelo mide el rendimiento con métricas sobre un conjunto de datos etiquetado, mientras que las pruebas del modelo comprueban cómo se comporta con datos nuevos, no vistos, que se asemejan a las condiciones de implementación. La evaluación genera cifras como la precisión y mAP a partir de un conjunto de datos controlado; las pruebas revelan si el comportamiento aprendido se mantiene con diferentes condiciones de iluminación, movimiento u oclusión. Consulta Pruebas del modelo frente a evaluación del modelo para ver un ejemplo práctico.
Usa el modo de predicción y pasa la ruta de una carpeta como
source: YOLO26 procesa todas las imágenes de la carpeta y puede guardar los resultados anotados para revisarlos. El modo de predicción no calcula métricas; para cuantificar el rendimiento con un conjunto etiquetado, usa el modo de validación. Ambos flujos de trabajo se muestran en Cómo probar un modelo YOLO26.En los modelos de detección, la validación informa de la precisión, la exhaustividad, mAP50 y mAP50-95, y guarda gráficos como una matriz de confusión y una curva de precisión-exhaustividad. Para validar con una partición de prueba específica en lugar de la partición predeterminada
val, definetest:en el YAML del conjunto de datos y pasasplit="test". Consulta la guía de métricas de rendimiento para saber cómo interpretar cada métrica.Para el sobreajuste, aplica técnicas de regularización, como el dropout, aumenta el tamaño del conjunto de datos de entrenamiento o simplifica la arquitectura del modelo. Para el infraajuste, usa un modelo más complejo, proporciona características más relevantes o entrena durante más épocas. Los indicios de cada problema y las soluciones correspondientes se resumen en Sobreajuste e infraajuste en el aprendizaje automático.
Sospecha que hay fugas de datos si el rendimiento en las pruebas es sorprendentemente bueno, una sola característica domina las predicciones o las decisiones del modelo no parecen intuitivas. Evítalas usando conjuntos de datos diversos de distintas cámaras y entornos, revisando los datos para detectar sesgos ocultos y comprobando que la división entre entrenamiento y prueba se hizo antes de cualquier procesamiento. Consulta Fugas de datos en visión artificial para conocer los tipos de sesgo más comunes.
Si los resultados cumplen los objetivos del proyecto, implementa el modelo; si no, mejóralo antes de implementarlo. Esto puede implicar analizar los errores, recopilar datos más diversos, mejorar la calidad de los datos, ajustar los hiperparámetros y volver a entrenar. Repite las pruebas después de cada ronda de cambios para confirmar que las correcciones han funcionado.